没有图片,模型还在“脑内画图”吗?一条视觉轴给出了因果答案
面对一段纯文字导航题:“面向房子北侧,右转走 10 米,再左转走 5 米,现在朝哪?”人往往会在脑中搭一个简陋场景。多模态大模型也会这样吗?
这个问题很容易被问得玄乎。仅靠回答正确率,我们分不清模型是在维护空间状态,还是学到了文字模板;仅靠探针解码,也只能说明隐藏状态里“有信息”,不能说明模型做题时真的用了它。arXiv:2611.14942 的价值,就在于把这件事变成了一项可以干预、可以证伪的实验。
核心摘要
这篇论文研究一个很有意思的问题:多模态训练留下的视觉表示,会不会在完全没有图片的文本推理中继续参与计算?作者跨 6 个模型家族、10 种配置寻找视觉—语言方向,并在推理时删除隐藏状态在该方向上的投影。Chameleon-7B 的空间导航准确率下降 27.6 个百分点,布尔表达式反而提高 5.6 个百分点,形成 33.2 个百分点的双重分离。我的判断是,这不是“模型脑内生成图片”的证明,而是一组相当扎实的因果证据:多模态训练确实会改写纯文本推理所使用的表示几何;同时,论文对探针与因果使用为何不一致的分析,比 EVT 这个新名词本身更值得复用。
论文信息
- 英文标题:Emergent Vision-Shaped Thinking in Text-Only Reasoning through Multimodal Training
- 作者:Qi Zhang、Bohan Wang、Qianru Sun、Hanwang Zhang
- 机构:Qi Zhang、Bohan Wang、Hanwang Zhang 来自南洋理工大学;Qianru Sun 来自新加坡管理大学;Qi Zhang 与 Bohan Wang 为共同第一作者
- 提交日期:2026 年 11 月 11 日,v1
- 论文链接:https://arxiv.org/abs/2611.14942
- 研究领域:人工智能、计算机视觉与模式识别
论文真正要排除的,是“看起来像”
假设一个视觉语言模型在纯文本导航题上胜过它的文本骨干模型,我们能得出什么结论?
其实很少。也许是多模态数据让模型学到了更好的空间表示,也许只是指令微调改善了格式遵循,还可能是训练语料里出现了更多类似题目。反过来,如果探针能从隐藏状态里解码出位置、方向或位移,也仍然不够:这些信息可能只是计算的副产品,静静地躺在那里,并没有被后续网络读取。
作者把任务分成两组,试图制造一个干净的对照。
| 任务类型 | 代表任务 | 解题时自然调用的结构 |
|---|---|---|
| 空间意象任务 | navigate、relative_position、心理旋转、折纸、视角转换 | 在内部搭建并更新空间状态 |
| 符号操作任务 | boolean_expressions、web_of_lies | 按形式规则处理符号,不必构造空间场景 |
关键不是“空间题做错了”,而是同一个干预是否选择性打坏空间题,同时保住符号题。如果两类任务一起崩,那可能只是残差流被扰动后模型整体失灵;如果随机方向也能产生同样效果,那视觉—语言轴就没有特殊性;如果所有层都差不多,那也很难说找到了局部机制。
所以论文给 EVT 设了几道门槛:任务选择性、方向特异性、层局部化,再辅以跨任务梯度、反向干预和恢复实验。这个实验纪律挺漂亮。它把“视觉式思维”从一句拟人化描述,压缩成了一组可观测条件。
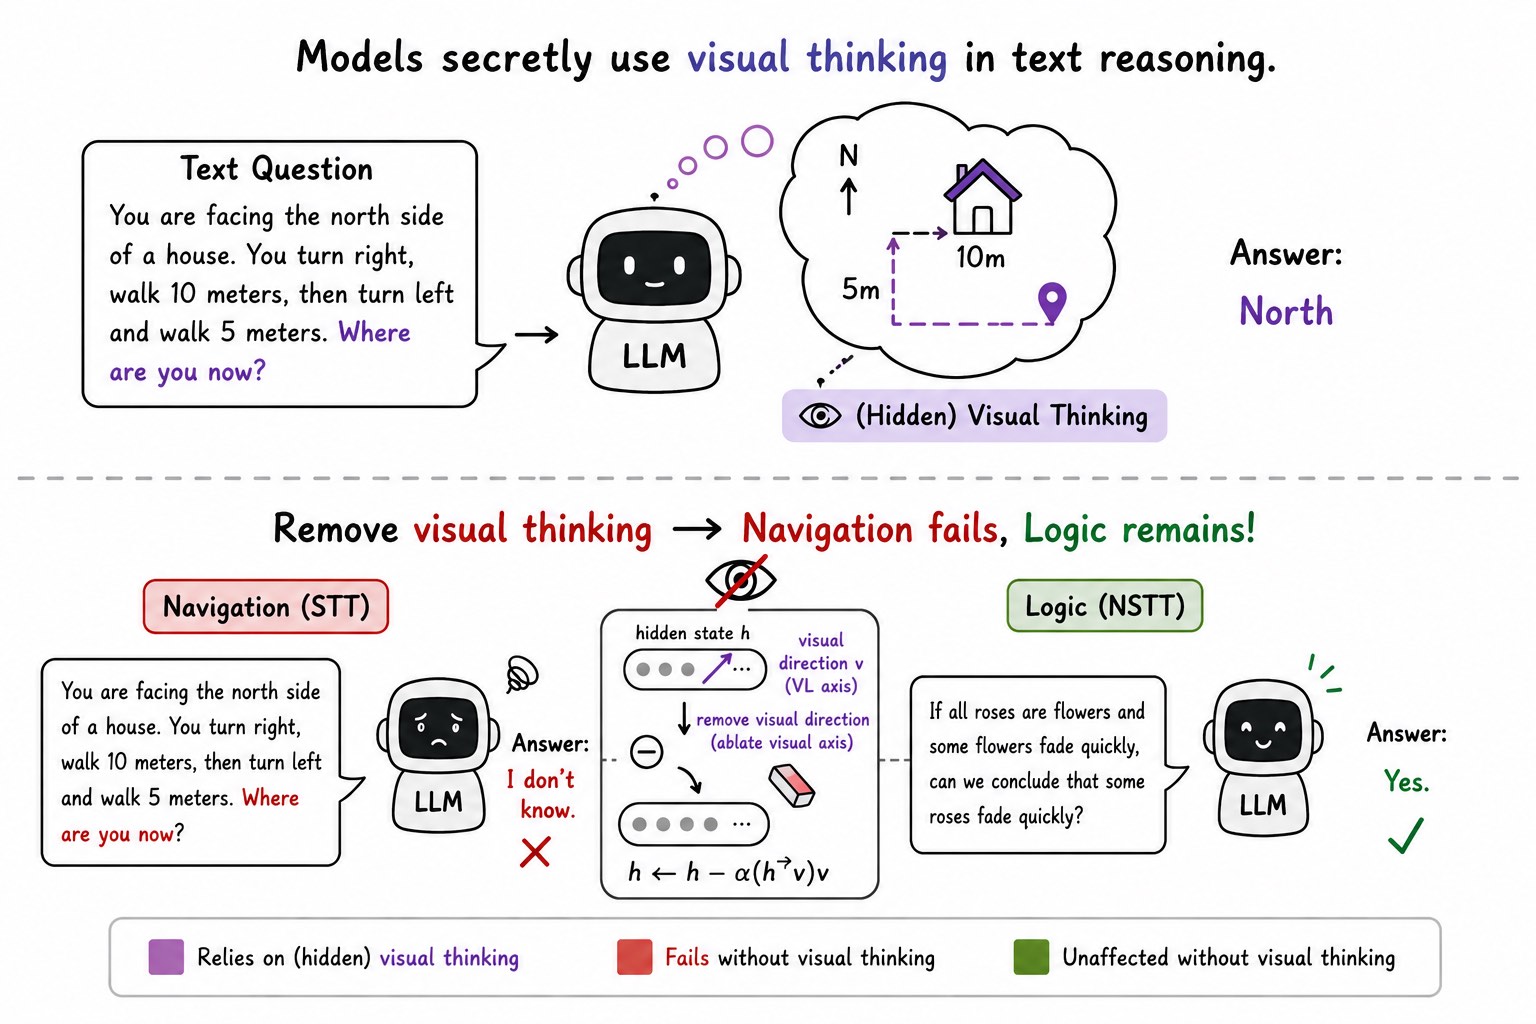
图1:上方用纯文本导航题示意隐藏的空间场景构造;下方展示从隐藏状态 \(h\) 中删除视觉—语言方向 \(v\) 的投影。左侧 Navigation 在消融后失败,右侧 Logic 保持回答能力。图中机器人输出是机制示意,不是一组具体实验样本;真正支撑结论的是后文的选择性干预数据。
EVT 到底在claim什么
论文把 Emergent Vision-Shaped Thinking 拆得很克制。
“Emergent”指因果依赖在多模态训练后出现,或比文本骨干中更强,不是说空间能力凭空诞生。“Vision-shaped”只表示这些表示由视觉—语言训练引入或强化,并在纯文本推理中被调用,不假设内部存在一张图像式的场景。“Thinking”则限定为隐藏状态参与的内部计算。
这个措辞变化很重要。叫“视觉思维”很吸引人,但证据强度会跟不上;叫“空间思维”又太窄,因为 32B 配置里,同一方向还影响颜色、材质等非空间视觉属性绑定。作者选择 vision-shaped,乍听有点绕,实际上是在给结论划边界。
我觉得这篇论文最值钱的地方也在这里:它证明的是功能依赖,不是对人类心理表象的模仿。
方法:找到一条轴,再把它的投影拿掉
1. 视觉—语言方向不是统一配方
一句话讲清方法:找一组文本表示和视觉表示,用两类均值的差定义方向,然后在纯文本推理时删掉这个方向上的分量。
设文本与视觉表示的均值分别为 \(\mu_{\text{text}}\) 和 \(\mu_{\text{visual}}\),归一化后的视觉—语言方向为:
这就是常见的 difference-in-means,也就是 DiffMean。公式本身并不新,难的是在不同架构里找到文本与视觉信号真正可比较的位置。
| 架构 | 代表模型 | 轴的构造位置 | 主实验中的因果枢纽 |
|---|---|---|---|
| 共享离散词表 | Chameleon-7B | 共享 embedding 表中文本 token 与视觉 token 的行均值 | L5 |
| 共享离散词表 | Emu3 | 多模态序列中逐层文本位置与视觉 token 位置的 DiffMean | 早期 L0–7 与末段 L24–31 |
| 视觉微调骨干 | Liquid-V1-7B | 逐层 DiffMean | L27 |
| 连续视觉编码器 | Qwen3-VL | 文本位置与连续视觉特征的逐层 DiffMean | L3–L8,随配置变化 |
| 双通路统一模型 | BAGEL | 理解、生成通路分别构造 DiffMean | 生成通路 L21–27 |
| 双通路统一模型 | Janus-Pro | 理解、生成通路分别构造 DiffMean | 生成通路 L22–28 |
这张表藏着一个很实际的教训:同一个概念方向,不能不看架构就套同一套提取脚本。 Chameleon-7B 的 embedding 质心轴能用,Emu3 上却在预实验里失效;Chameleon-30B 更麻烦,只有让图像经过模型自己的 VQ tokenizer、放在完整多模态序列里构造方向,才恢复了因果效应。
作者还检查了轴的稳定性:DiffMean 轴的 split-half 稳定性均不低于 0.9992;把合成随机像素换成 COCO val2017 真实图片后,多数枢纽层的方向余弦接近 1,并复现相同的空间选择性损伤。这里支撑的是跨架构的定性复现,不是公平的效果大小排行榜,因为各模型的轴、任务配对和干预剂量并不完全一致。
2. 投影消融怎样改变隐藏状态
对选中的 decoder block,作者在后块残差流上施加:
当 \(\alpha=1\) 时,隐藏状态沿 \(v\) 的投影被完整移除;\(0\lt\alpha\lt1\) 是部分移除;\(\alpha\lt0\) 则按每个 token 已有的投影进行乘性放大。这里不是从输入里删图片——所有评测输入本来就只有文本——而是问文本隐藏状态是否还在使用多模态训练写下的方向。
高秩实验把一维投影矩阵 \(vv^{\top}\) 换成 \(BB^{\top}\):
其中 \(B\) 包含样本级文本—视觉均值差矩阵的前 \(k\) 个左奇异向量。作者用它检查空间信息是否分布在更高秩的子空间里,而不是预设所有机制都能被一条直线解释。
剂量按配置选择一次后冻结。10 种配置里有 6 种直接使用 \(\alpha=1\);其余配置选择能产生稳定选择性效应、又不让控制任务整体崩溃的较小剂量。作者另用固定的 125/125 校准—评测划分验证剂量,并把冻结设置直接迁到 27 项 BBH、外部空间基准和心理模拟任务。
3. 双重分离怎样计算
每个任务的变化量定义为:
双重分离分数为:
\(DD\gt0\) 表示空间任务比符号控制任务受损更多。随机方向对照则计算 \(z=(DD_{\text{axis}}-\mu_{\text{rand}})/\sigma_{\text{rand}}\)。这个 \(z\) 只用于判断真实方向是否超出随机分布,不能当成跨模型的效果量,否则 Qwen3-VL-32B 的 262.5 会被误读成“能力强几十倍”。它只是随机零分布的方差太小。
主实验每题使用 250 个样本,采用贪心解码;CoT 格式最多生成 128 个新 token,直接回答格式为 16 个。置信区间采用按样本索引配对的 10,000 次 bootstrap。整套计算预算约 150 GPU 小时,主要使用 H200 级数据中心 GPU、bfloat16 推理。
主结果:空间题掉了,逻辑题没有跟着掉
最有冲击力的一组数字来自 Chameleon-7B 的 L5 单层干预:
- navigate 准确率变化为 下降 27.6 个百分点;
- boolean_expressions 变化为 提高 5.6 个百分点;
- 因而 \(DD=5.6-(-27.6)=33.2\) 个百分点。
一个方向被移除后,空间导航大幅受损,布尔求值却没有付出同样代价。这比“模型总体性能下降 10 个点”有信息量得多,因为一般性损伤解释不了两组任务的分离。
跨架构结果也不是孤例。
| 配置 | 轴与枢纽 | \(\alpha\) | DD | 随机方向特异性 |
|---|---|---|---|---|
| Chameleon-7B | Embedding,L5 | 1.0 | +33.2 pp | \(z=+12.22\);0/101 随机方向达到真实效应 |
| Emu3 | DiffMean,L3+末块 | 0.5/0.5 | +20.8 pp | 0/22 早期及末段随机方向达到真实效应 |
| Liquid | DiffMean,L27 | 1.0 | +21.6 pp | 0/22 |
| BAGEL | 生成通路 DiffMean,L21–27 | 0.5 | +16.8 pp | \(z=+3.19\);0/22 |
| Janus-Pro | 生成通路 VQ DiffMean,L22–28 | 0.7 | +8.0 pp | \(z=+3.58\);0/22 |
| Qwen3-VL-2B | DiffMean,L3 | 1.0 | 主表未报配对 DD | \(z=+27.7\);0/22 |
| Qwen3-VL-8B | DiffMean,L8 | 1.0 | 主表未报配对 DD | \(z=+38.3\);0/100 |
| Qwen3-VL-32B | DiffMean,L8 | 1.0 | 主表未报配对 DD | \(z=+262.5\);0/22 |
| Qwen3-VL-30B-A3B | DiffMean,L6–18 | 1.0 | 主表未报配对 DD | \(z=+48.8\);0/5 |
这里要仔细读表注。Chameleon 的 33.2 来自 L5 单层峰值,而 \(z=12.22\) 和置信区间来自匹配的 L0–7 区块实验,区块 DD 为 32.0 个百分点。Qwen 的 \(z\) 来自 colored_objects 与 web_of_lies 配对,不能把空格补成 navigate 的 DD。论文在这些口径上交代得比较清楚,读二手摘要时却很容易混。
不是“删得多”,而是“删对了地方”
一个朴素质疑是:视觉轴可能恰好对应较大的隐藏状态能量,删它当然更伤。作者做了能量匹配的随机方向控制,让随机方向在每个 token 上移除的 \(L_2\) 范数与真实轴相同。
在 Chameleon-7B 的 L0–7 实验中,真实轴 DD 为 +15.22 个百分点,能量匹配随机方向为 \(-1.88\pm3.56\),对应 \(z=+4.80\)。这组数字与上面的 32.0 不矛盾,它们来自不同控制协议。重点在于:即便删掉同样多的能量,方向仍然重要。
层的位置也有结构性。共享词表或投影式模型的枢纽偏早,Chameleon 在 L5,Qwen3-VL 多在 L3–L8;后验视觉微调和双通路生成模型偏晚,Liquid 在 L27,BAGEL 与 Janus-Pro 在 L21–L28。它们大致贴着视觉信息进入语言骨干的接口,而不是随机散落在网络里。
Emu3 还出现早期和晚期两个载体窗口,两个窗口造成的逐任务下降相关性达到 \(r=0.97\),像是保留了两份冗余空间副本。这个结果提醒我,别把“一维方向”想象成全网唯一的开关;它可以是某个局部、可干预的载体。
空间需求越高,损伤总体越大
作者给 7 项 BBH 任务标注 0–5 分的空间意象需求。navigate 为 5 分,relative_position 为 3.5,colored_objects 为 3,temporal_sequences 为 2,causal_judgement 为 1,boolean_expressions 和 web_of_lies 为 0。评分由四个前沿 LLM 给出,再由两名有 AI 背景的人类做盲检,Kendall’s \(W\approx0.98\)。
控制基线准确率后,7 种配置里有 6 种仍呈负斜率,即空间分数越高,干预后的准确率下降越多,斜率范围约为每分 \(-1.6\) 到 \(-7.3\) 个百分点。Chameleon-7B 的 Spearman \(\rho=-0.83\),\(p=0.042\)。
Qwen3-VL-8B 是例外,斜率为 +1.93。它通过方向特异性检查,却也会伤到低空间分数的控制任务。说实话,这个例外比全绿的结果更可信:现象跨架构成立,不代表每个模型都呈现同样干净的空间谱系。
从导航扩展到心理模拟,但别忽略答案完成率
如果 EVT 真与空间场景构造有关,它不应只对 BBH navigate 生效。作者构造了文字版心理旋转、折纸和视角转换任务,全部是四选一,答案由程序生成并经求解器验证,还加入 SPACE 基准中的原始 MRT、PTT 题目。干预轴和剂量保持冻结,不为新任务重新调参。
| 模型与任务 | 样本数 | 基线 → 干预后 | 变化 |
|---|---|---|---|
| Qwen3-VL-32B,心理旋转 easy | 100 | 78.0% → 23.0% | -55.0 pp |
| Qwen3-VL-32B,心理旋转 hard | 100 | 61.0% → 15.0% | -46.0 pp |
| Qwen3-VL-32B,折纸 easy | 100 | 89.0% → 50.0% | -39.0 pp |
| Qwen3-VL-32B,视角转换 easy | 100 | 54.0% → 32.0% | -22.0 pp |
| Qwen3-VL-32B,视角转换 hard | 100 | 62.0% → 36.0% | -26.0 pp |
| Qwen3-VL-8B,折纸 easy | 150 | 79.3% → 30.7% | -48.7 pp |
| Qwen3-VL-8B,视角转换 easy | 150 | 59.3% → 27.3% | -32.0 pp |
| Qwen3-VL-8B,视角转换 hard | 150 | 68.7% → 26.0% | -42.7 pp |
不过这里有个坑。32B 心理旋转的答案完成率从 77% 降到 40%,折纸从 89% 降到 50%,部分准确率下降其实是没有在生成预算内产出可解析答案。视角转换更干净:完成率约从 100% 变为 99%,错误增加不能被格式崩溃解释。因此,我会把视角转换当作这组扩展实验的锚点,把旋转和折纸看作带有完成率混杂的辅助证据。
Chameleon-7B 在所有心理模拟任务上都处于或低于随机水平,根本无法提供可解释的下降空间。相关证据只来自 Qwen3-VL-8B/32B,不能写成“所有架构都复现了心理旋转效应”。
空间特异,不等于只负责空间
作者用非空间颜色追踪控制顺序更新负担。Qwen3-VL-8B 在 3 次、5 次更新时分别下降 20.7、28.7 个百分点,仍小于零更新的视角转换任务所出现的 32.0、42.7 个百分点下降;可到 8–12 次更新时,非空间追踪也下降 44.0、52.0 个百分点。
所以这条载体还会参与长程状态维护。更准确的描述是空间集中,而非空间独占。
规模还改变了功能范围。非空间视觉属性绑定要求从场景描述中回忆颜色、材质,不包含空间关系:
| 配置 | 基线 → 干预后 | 变化 | 读法 |
|---|---|---|---|
| Chameleon-7B | 38.0% → 44.0% | +6.0 pp | 置信区间包含 0,基本保留 |
| Qwen3-VL-8B | 100.0% → 96.0% | -4.0 pp | 接近保留 |
| Qwen3-VL-32B | 100.0% → 29.0% | -71.0 pp | 严重受损 |
同一配置下,32B 的 web_of_lies 从 58.0% 到 56.0%,boolean_expressions 从 88.0% 到 77.0%。视觉属性绑定明显更敏感。7–8B 上较集中在空间结构,32B 上扩展到非空间视觉属性,这正是作者坚持使用 vision-shaped 而非 spatial 的原因。但 8B 与 32B 的属性任务都从 100% 天花板起步,规模差异仍需要更多非天花板任务验证。
双通路模型:生成通路像“压缩载体”,理解通路像“分布式备份”
BAGEL 和 Janus-Pro 同时具有视觉理解与视觉生成通路,并共享语言骨干。它们给论文提供了一个很漂亮的内部对照:同一模型里,哪条通路写下的表示会在纯文本推理时被使用?
在 BAGEL 的晚期块 L21–27,生成通路的一维 DiffMean 轴产生 +16.8 个百分点的 DD,\(z=+3.19\);理解通路却是 -10.9,不显著且方向略反转。Janus-Pro 也呈现生成通路主导:navigate 下降 28.7 个百分点,boolean_expressions 只下降 7.3 个百分点。
外部空间基准进一步支持这一分工。
| BAGEL 任务 | 生成通路变化 | 理解通路变化 | 损伤比 |
|---|---|---|---|
| bAbI 19,路径寻找 | -12.4 pp | -0.4 pp | 31 倍 |
| bAbI 20,主体动机 | -43.2 pp | -6.8 pp | 6.4 倍 |
| SpartQA | -12.0 pp | -0.4 pp | 30 倍 |
| StepGame,1 hop | -18.4 pp | -2.4 pp | 7.7 倍 |
| StepGame,5 hops | -16.8 pp | -13.2 pp | 1.3 倍 |
| StepGame,9 hops | -4.8 pp | -4.4 pp | 1.1 倍 |
单跳任务几乎由生成通路主导,多跳任务则同时招募两条通路。这个变化很值得做后续研究:当推理链变长,模型可能需要理解通路里的分布式信息一起参与,而不能继续只靠那个紧凑载体。
可解码,不代表可选择性干预
理解通路的 1D 轴没效果,不等于里面没有空间信息。BAGEL 理解通路的 DiffMean 与主 PCA 方向高度对齐,枢纽层平均 \(|\cos|=0.94\),前 1 个主成分解释 52.9% 的方差,前 16 个解释 86.2%;生成通路对应数值只有 0.42、18.9% 和 69.5%。
但删除高秩 PCA 子空间并没有得到更干净的选择性结果:
| BAGEL 通路 | 1D DiffMean | PCA 高秩消融 | 几何解读 |
|---|---|---|---|
| 生成 | DD +16.8 pp,空间选择性 | 所有测试秩下都非选择,控制任务下降 56–74 pp | 紧凑方向偏离主方差,反而能单独取出 |
| 理解 | DD -10.9 pp,不显著 | rank-16 时控制任务 -32.3 pp,空间任务 -19.7 pp | 信息集中却与一般能力纠缠 |
生成通路像是把空间结构压缩进了一个适合驱动视觉 token 生成的低秩载体;理解通路保留了可读取的信息,却没有暴露同样干净的干预手柄。
跨通路恢复也符合这个解释。删除生成载体后,放大理解通路 rank-16 子空间能让空间准确率恢复 6.92 个百分点,但控制任务也恢复 5.07 个百分点。恢复是真的,选择性却不在。叫它“分布式备份”可以帮助理解,不过这是论文给出的机制解释,还不是经过训练消融证明的因果形成过程。要证明“生成训练导致压缩”,仍需对照训练实验。
探针看到的信息,模型未必在用
这部分我觉得比主结果更有通用价值。
Chameleon-7B 的全维探针在每一层都能达到 1.000,但真正的一维因果效应集中在 L5。全层都可解码,显然不等于全层都在使用。BAGEL 理解通路更典型:L27 的一维探针准确率为 0.729,相对随机方向高出 \(2.65\sigma\),沿同一方向干预却得到 DD = -7.3 pp、\(z=-1.25\) 的零结果。
Qwen3-VL-8B 甚至出现了反直觉的错位:在因果枢纽 L8,真实 DiffMean 轴对任务身份的解码准确率只有 0.540,随机一维方向平均反而为 0.825;可真实轴的干预特异性达到 \(z=+38.3\),100 个随机方向没有一个达到真实轴的效果。
最可读的方向,不是最该删的方向;最能改变行为的方向,也未必最适合做线性解码。
作者用三个几何诊断来整理这种分歧:
| 诊断 | 问的问题 | 论文中的例子 |
|---|---|---|
| Concentration,集中度 | 隐藏状态有多少能量落在这条轴上? | Chameleon L5 中心化集中度仅 0.137%,却有选择性的因果效应;低能量不等于不重要 |
| Alignment,对齐度 | 探针读取方向与真实因果方向是否一致? | BAGEL 理解通路的读取方向贴着主 PCA,但因果干预无选择性 |
| Semantic location,语义位置 | 哪一种对比、哪一个表示空间才暴露功能载体? | Chameleon-30B 需要任务对比轴或忠实于真实输入通路的模态轴 |
BAGEL 生成轴的原始集中度在 L21–26 高达 47%–58%,看似很夸张;中心化后只剩 0.43%–3.16%。原始值主要来自层均值与轴对齐,\(|\cos(\mu,a)|\) 为 0.71–0.79。中心化后的值仍是随机方向的 15–118 倍。这个细节很扎实:不区分全局均值偏移与随样本变化的信号,很容易把静态偏置误当成丰富计算。
多模态训练是“新装上来的”,还是“把旧结构磨亮了”?
匹配的文本骨干让作者能进一步追问归因。
Chameleon 的情况更接近引入。同一条轴作用在 LLaMA-7B 上,navigate 只变化 -2.0 个百分点,各任务变化都在 \(\pm3.3\) 内,接近随机方向;作用在 Chameleon-7B 的对应区块实验中,navigate 下降 27.2 个百分点,DD 为 +32.0。多模态训练显然不是只在前端多了一个视觉编码器。
Qwen 则更像放大并纯化已有支架。Qwen2.5-VL 的轴迁到文本预训练的 Qwen2.5-7B 上,仍有 DD = +18.5 个百分点;Qwen3-VL-8B 的轴迁到 Qwen3-8B base 上,DD 约为 +34,但伴随约 5 个百分点的非特异损伤。回到 Qwen3-VL-8B 本身,控制任务更干净,DD 为 +30.0。
也就是说,文本骨干里可能已经有可利用的空间表示雏形,多模态训练让它更强、更集中。这个解释比“视觉训练从无到有创造空间思维”合理得多。只是 Qwen3 的预训练数据构成并未完全公开,Qwen3 系列内部的引入—放大归因仍带不确定性;更干净的锚点是已明确文本预训练的 Qwen2.5-7B。
跨家族迁移大多失败:Janus 到 DeepSeek-LLM-7B 为零结果,BAGEL 到 Qwen2.5-7B 只有非选择性损伤,Liquid 文本模式自迁移甚至符号相反。只有匹配家族的 Qwen 迁移呈阳性。由此不能说存在一条所有模型通用的“视觉方向”。
我对实验证据的几点保留
这篇论文的附录很长,而且作者把失败案例写出来了,这是优点。不过,有几处不能略过。
效应大小不宜跨模型排名。 各配置的轴构造、空间/控制任务、随机方向数量、剂量与层范围并不统一。随机预算从 5 到 100 不等,Qwen3-VL-32B 的 \(z=262.5\) 更不能与 BAGEL 的 3.19 直接比较。论文证明的是多种配置中存在同类现象,不是测出了一条普适的 EVT 强度曲线。
搜索空间不小。 轴类型、层块、剂量都经过扫描,虽然 6/10 配置无需选剂量,作者也做了 125/125 留出验证和冻结迁移,但仍应把主结果视为经过模型内诊断优化后的因果现象,而非完全无选择的单次实验。Chameleon-30B 的经历尤其说明,零结果可能只是轴语义、剂量窗口或目标骨干选错。
恢复实验不能夸大。 Chameleon-7B 的配对恢复实验中,L5 消融让 navigate 从 47.2% 降至 34.0%,L6 重注入后回到 42.0%,恢复 8.0 个百分点;非枢纽 L20 消融则为 +0.8。但 22 个范数匹配随机方向的平均恢复也有 \(6.8\pm6.8\) 个百分点。它支持“枢纽局部、损伤可恢复”,不支持“只有真实视觉轴才能恢复”。方向特异性的主要证据仍在移除端。
外部基准并非全面干净。 BAGEL 生成通路在主剂量下还使 GSM8K 下降 53.6 个百分点、LogiQA 下降 25.2 个百分点。作者把相关单元归为非选择性剂量边界,而不是迁移证据,这种处理诚实;同时也说明“知识与数学不受影响”不是跨模型通则。
任务构念仍有主观成分。 0–5 空间意象分数主要由四个 LLM 标注,人类只承担盲检;7 项任务也很小。控制基线后的 6/7 负斜率应作为描述性证据,不宜包装成精确测量了模型内部的“空间程度”。
干预只证明必要性。 线性或低秩删除可能漏掉非线性、高度分布式和 cross-attention 机制,也没有揭示哪些电路写入、哪些电路读取这条信号。它不能证明模型先构造图像再阅读图像,更不能证明充分的视觉计算算法。
还有一个很现实的边界:Liquid 的选择性效应只出现在狭窄剂量窗口。L21–27 区块在 \(\alpha=0.50\) 时 DD 为 +5.6,0.55 时跳到 +40.0,但 navigate 已接近崩溃;到 1.0 时空间与控制任务一起归零。看到大 DD 之前,必须先看两个任务各自是否还活着。
工程上能带走什么
做可解释性研究时,我会把这篇论文当成一个流程提醒:先用便宜探针定位候选层,再做方向、能量、层位置和任务选择性对照;探针峰值处的零干预不是终点,还应检查高秩子空间、替代语义对比和真实输入通路。反过来,高探针准确率也绝不配单独写成“模型依赖该特征”。
做统一多模态模型时,生成与理解不能只按最终榜单判断关系。两条通路可能把不同几何结构写进同一个语言骨干:一个提供紧凑、可选择性干预的载体,一个保留分布式信息。评估时若只测图片输入,就会漏掉这些结构在纯文本推理里的长期影响。
做模型评测时,也要警惕“纯文本任务”这个标签。输入没有图像,不表示计算与视觉训练无关。对导航、位置追踪、视角转换等任务,多模态模型与其文本骨干的差异,可能既来自能力,也来自内部表示路线不同。若要比较架构,最好增加匹配骨干与因果干预,而不只比准确率。
如果你准备复现,我建议从 Chameleon-7B 的 L5 单层 navigate/boolean 配对开始,再跑能量匹配随机方向;不要一上来就扫所有模型。先确认双重分离,再检查剂量曲线、答案完成率和外部任务。BAGEL 的理解/生成通路对照适合作为第二阶段,因为它更能检验你是否真的分清了“信息存在”与“信息被使用”。
收尾判断
EVT 不是一个新模型,也不是一套提升分数的训练技巧。它是一项机制研究:多模态训练会把视觉相关的表示几何写进语言骨干,而纯文本空间推理会在特定层、特定通路上因果调用这些结构。
这个结论有相当强的实验支撑,但边界同样清楚:一维轴不是完整思维,探针可读不是因果使用,空间集中不是空间独占,单模型恢复也不是方向唯一的证明。
所以,标题里的“脑内画图”只能当问题,不能当答案。论文真正给出的答案更克制,也更有用:模型不看图时,视觉训练留下的痕迹仍可能在工作。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我