大模型只读题、小模型写答案:PLatour 涨分之后,还要过“真伪通信”这一关
你有没有纠结过这样一种部署方案:让 235B 大模型理解题目,再让 1.7B 小模型负责写完整答案,听起来既省显存又省解码时间;可实验分数真的涨上来以后,却很难回答一个更扎心的问题——小模型究竟读懂了大模型传来的信息,还是连接两者的“桥”自己偷偷完成了一次微调?
PLatour 最有意思的地方,不是又造出一座桥,而是作者亲手给这座桥做了拆台实验。把题目相关的信息抽掉,有些任务照样涨分;不让大模型参与,只训练小模型,有些结果甚至更好。说实话,这比单纯刷新一个 benchmark 更值得看。
核心摘要:PACT 让大模型只做 prompt prefill,把隐藏状态交给小模型完成自回归生成。PLatour 用零初始化线性桥和 GRPO 训练,在 Qwen3-235B→1.7B 上把三项生成任务平均分从 65.23 提到 78.95;Qwen3.5-35B→4B 的数学、代码平均分也分别增加 14.42 和 16.86 个点。但 PACT-Check 显示,GSM8K 的通信净余量只有 0.23 个点,MATH500 为负,Qwen3.5 两个领域平均分也都没有超过最强接收端训练对照。我的判断是:PLatour 是很有用的开源基线,PACT-Check 才是这篇论文更值钱的贡献。
论文信息
- 英文标题:On the Opportunities and Challenges of Prefill-to-Autoregressive Cross-Model Transfer
- arXiv:2611.06976,v1,2026 年 11 月 4 日提交
- 作者:Zhenyi Shen、Junru Lu、Wei Liu、Jiangnan Ye、Jiazheng Li、Di Yin、Xing Sun、Tameem Adel、Yali Du、Lin Gui、Yulan He
- 公开机构:King’s College London、Tencent Youtu Lab、National Physical Laboratory
- 论文链接:https://arxiv.org/abs/2611.06976
- 开源代码:https://github.com/zhenyi4/platour
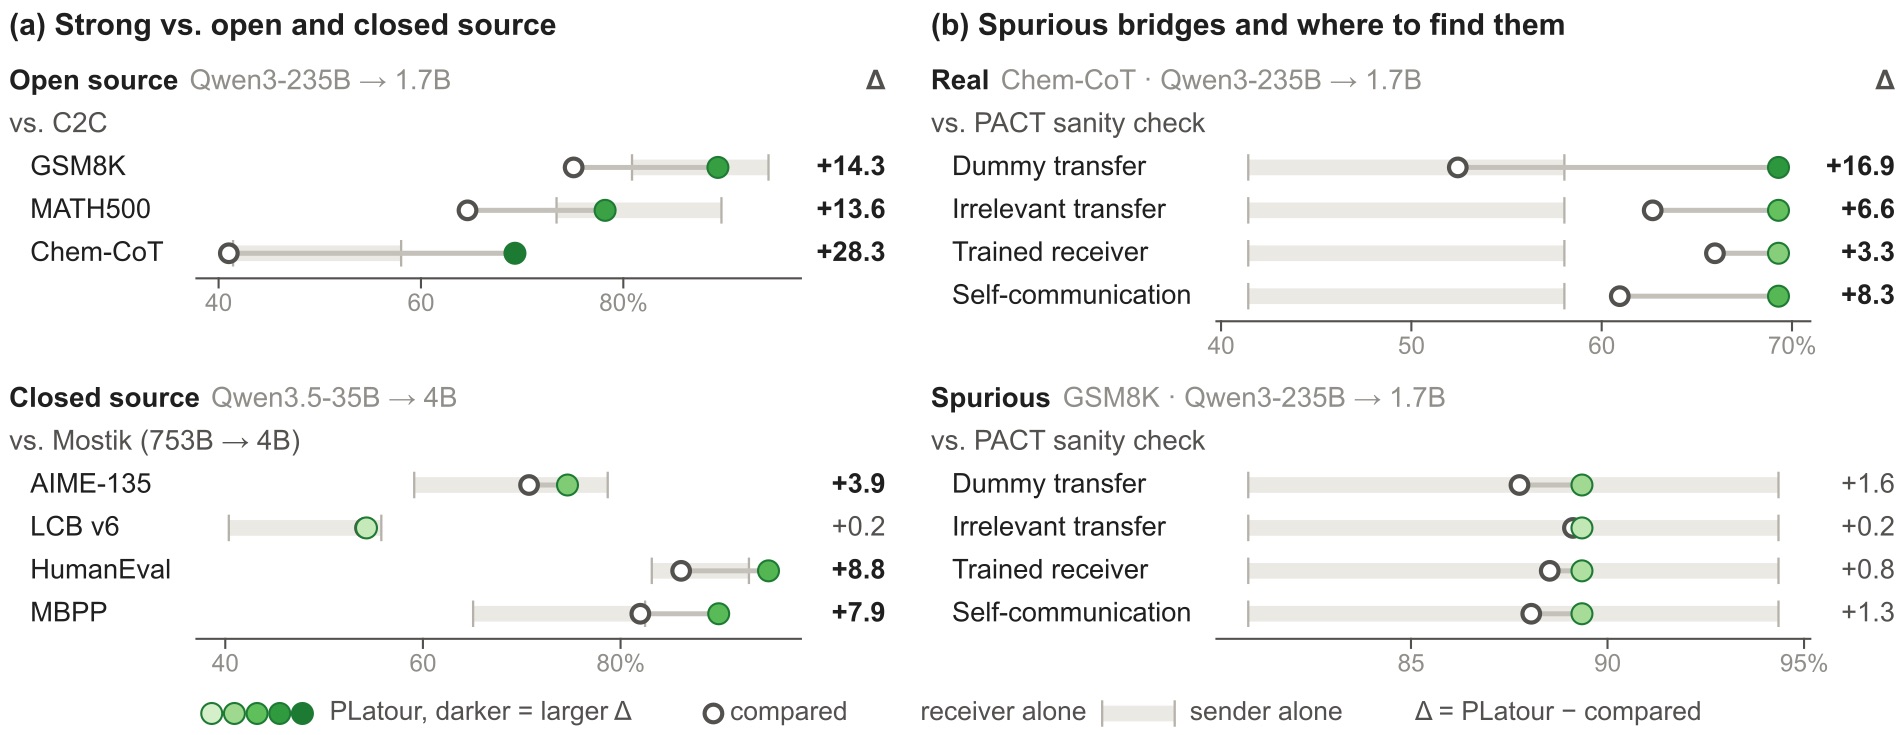
图1把论文的两面放在一起:左侧是性能,右侧是归因。235B→1.7B 时,PLatour 相比 C2C 在 GSM8K、MATH500、Chem-CoT 上分别高 14.3、13.6、28.3 个点;35B→4B 时,它也超过 Mostik 公布的部分结果。右侧却告诉我们,Chem-CoT 在四项对照之后仍有余量,而 GSM8K 的虚拟发送端、无关发送端、接收端训练、自通信都能追得很近。一张图就把“分数高”和“通信真有用”拆成了两件事。
大模型读题、小模型作答,和投机解码不是一回事
PACT 的全称是 Prefill-to-Autoregressive Cross-model Transfer。发送端 sender 通常是较大的模型,只处理输入 prompt;接收端 receiver 通常是较小的模型,拿到发送端的内部表征后,自行生成所有回答 token。
为什么只让大模型 prefill?因为 prompt 可以并行处理,而回答必须一个 token 接一个 token 地解码。长回答场景里,大模型反复参与解码的成本很扎眼。PACT 想把大模型的参与压缩到开头一次,把后面漫长的生成全部交给小模型。
它很容易和投机解码混在一起,但两者的目标与执行方式差别很大:
| 方案 | 大模型何时参与 | 小模型负责什么 | 输出分布与优化目标 |
|---|---|---|---|
| 文本接力 | 先生成指导或答案 | 读取文本后再回答 | 有中间文本生成成本,接口简单 |
| 投机解码 | 多轮验证候选 token | 起草候选 token | 通常追求目标大模型分布下的无损加速 |
| C2C | prefill 时提供 KV cache | 在融合 cache 后生成 | 用 SFT 学习 KV 投影与融合 |
| PACT / PLatour | 只在 prefill 时提供隐藏状态 | 独立完成后续全部解码 | 用任务奖励训练桥,不保证复现大模型输出 |
C2C 的公开论文把 KV cache 当作模型间语义通信介质,通过投影、融合和门控选择受益层。PLatour 改传 hidden state,并把它加到接收端残差流里。这个变化不是换个张量名字那么轻松:接收端仍自己计算 K/V,低层收到的发送端信息还会继续影响高层计算;对于带线性注意力和循环状态的混合架构,也不必强求两边存在一一对应的 KV cache。
还有一个容易被宣传话术带偏的地方:PACT 并不天然比“小模型单独跑”更快。两个模型都要 prefill,首 token 前的开销反而更高。它省钱的前提是发送端不再参与长解码,而且这次额外的 prefill 能被较长的输出摊薄。
PLatour:一座线性桥,训练目标却直接对准最终答案
PLatour 展开为 Prefill-only LATent cOmmUnication for Reasoning。名字有点绕,结构倒很克制:发送端和接收端全部冻结,每个接收层配一个独立、无 bias 的线性投影,只训练这些投影。
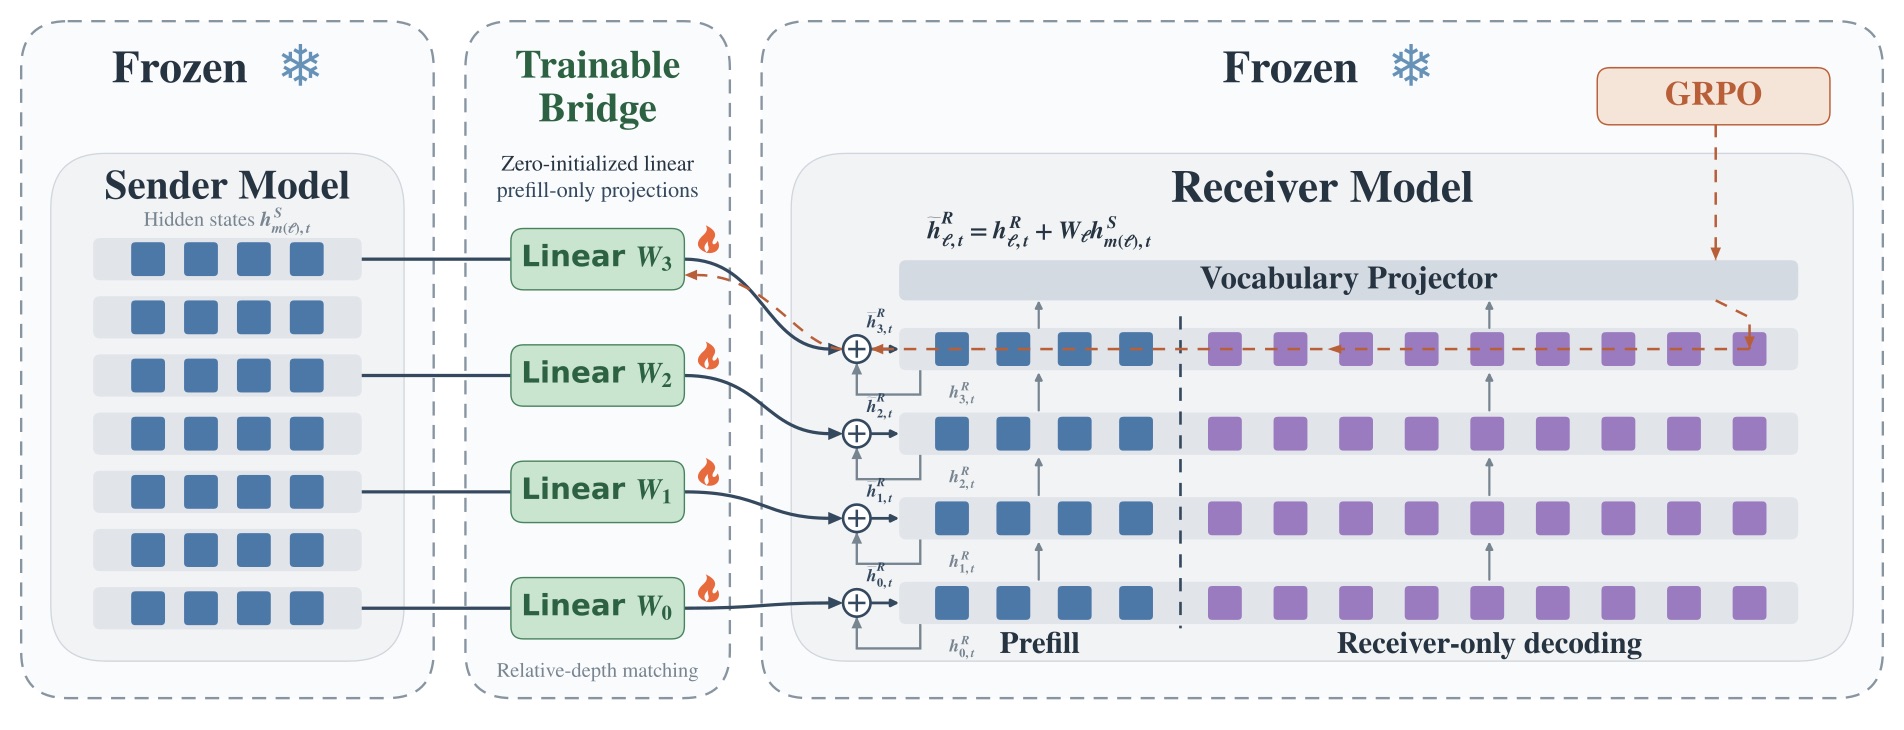
图2中,左侧冻结 sender 的多个层通过相对深度匹配连接到右侧 receiver。绿色 Linear 层是唯一可训练模块,投影结果在 prompt 位置加进 receiver 的残差流;竖直虚线之后完全由 receiver 解码。橙色虚线表示 GRPO 的梯度穿过冻结 receiver 回到投影层,而不是更新两座大模型。
残差相加,而不是把小模型的状态换掉
对第 \(\ell\) 个接收层,核心操作是:
\(h^S\) 是发送端隐藏状态,\(W_\ell\) 把它从发送端维度映射到接收端维度。\(a_t=1\) 只作用于除末尾 token 外的 prompt 位置,生成阶段为 0,因此通信被严格限制在 prefill。
零初始化是个很实在的工程选择。训练前 \(W_\ell=0\),系统等价于原始 receiver,不会刚接上桥就把小模型的表征打坏。训练后再做加法,也比直接替换 receiver hidden state 温和。投影参数和计算保留 FP32,注入前转成 receiver 的 BF16;超过 100B 的发送模型使用 FP8 版本降低显存压力。
层匹配采用相对深度。若两边层数为 \(L_S\) 和 \(L_R\),接收层 \(\ell\) 初始匹配到发送层 \(m(\ell)=\operatorname{round}(\ell(L_S-1)/(L_R-1))\)。混合注意力架构还加了一条不对称约束:全注意力接收层只能匹配全注意力发送层,线性注意力接收层则两者都可以。作者的直觉是,全注意力层更需要全局上下文,而线性注意力有更强的局部偏置。
不做表征对齐,也不逼小模型模仿大模型
PLatour 没有先做一次 SFT 或蒸馏 warm-up,而是直接用 GRPO 最大化任务奖励。数学任务看答案是否正确,代码任务要求全部测试用例通过,训练时被长度截断的回答拿零奖励。
这个选择背后的怀疑很合理:两个投影后的表征余弦相似度高,不代表任务信息真的保留下来了。极端情况下,两边都塌缩成零向量,对齐损失可以很漂亮,通信内容却空空如也。让小模型模仿超大模型的长推理轨迹也可能强人所难,尤其当两边能力差了一百多倍。
GRPO 实现基于 verl,每题采样 8 个回答,组内标准化优势,PPO clipping 为 0.2;Qwen3.5 的桥训练学习率为 \(10^{-5}\),DAPO 和 DeepCoder 分别训练 264、295 个 optimizer step。训练 rollouts 的温度为 1,不做 top-p 或 top-k 截断。这里不是“接两根线零成本训练”:冻结权重省的是反向更新,不省两座模型的加载与前向计算。
主实验:生成任务确实涨得很猛
Qwen3:235B 到 1.7B,生成平均分提高 13.72 个点
Qwen3 实验同时覆盖直接作答和带 CoT 的生成任务。下表保留最关键的 235B→1.7B 配置,数值均为准确率百分比:
| 方法 | Chemistry 直接作答 | Chemistry CoT | GSM8K | MATH500 | 三项生成平均 |
|---|---|---|---|---|---|
| Receiver-Alone | 39.05 | 41.43 | 80.86 | 73.40 | 65.23 |
| C2C | 60.95 | 41.01 | 75.09 | 64.60 | 60.23 |
| KV-Lingo | 40.95 | 40.95 | 17.06 | 11.95 | 23.32 |
| PLatour-SFT | 78.57 | 57.80 | 85.63 | 70.65 | 71.36 |
| TextComm | 38.10 | 40.77 | 90.30 | 76.10 | 69.06 |
| PLatour | – | 69.29 | 89.35 | 78.20 | 78.95 |
| Sender-Alone 235B | 56.19 | 58.04 | 94.35 | 89.70 | 80.70 |
PLatour 的三项生成平均分为 78.95,已经离 235B sender 的 80.70 不远;Chem-CoT 甚至达到 69.29,高于 sender 的 58.04。把发送端换成 8B,PLatour 仍有 77.60 的生成平均分,说明结果并不只依赖一对特殊模型。
但我更关注另外两个细节。C2C 和 KV-Lingo 在生成任务上全部低于 Receiver-Alone,表明“把大模型 cache 搬过去”远不是免费午餐;TextComm 在 GSM8K 上拿到 90.30,反而高于 PLatour 的 89.35,说明文本指导仍是一个不能随手删掉的强基线。PLatour 的优势集中在三项平均和 Chemistry,并非每个数据集都封死其他路线。
Qwen3.5:35B sender 超过 Mostik 公布结果,但不是受控复现
更难的一组实验使用混合注意力 Qwen3.5-4B receiver。数学模型训练于 DAPO-17k,代码模型训练于去重、去污后的 DeepCoder-24k Clean。
| 方法 | Sender | AIME-80 | AIME-135 | 数学平均 | LCB v6 | HumanEval | MBPP | 代码平均 |
|---|---|---|---|---|---|---|---|---|
| Receiver-Alone | – | 59.22 | 59.12 | 48.90 | 40.36 | 83.16 | 65.08 | 62.87 |
| PLatour | 397B | 71.88 | 72.73 | 60.97 | 52.50 | 93.67 | 85.43 | 77.20 |
| PLatour | 35B | 75.63 | 74.63 | 63.32 | 54.29 | 94.97 | 89.93 | 79.73 |
| Mostik 公布值 | 753B | – | 70.74 | – | 54.14 | 86.13 | 82.00 | 74.09 |
| Sender-Alone | 35B | 80.16 | 78.70 | 68.37 | 55.79 | 92.99 | 82.48 | 77.09 |
35B→4B 的 PLatour 在 AIME-135 上比 Mostik 公布值高 3.89 个点,LCB v6 只高 0.15 个点,HumanEval 和 MBPP 分别高 8.84、7.93 个点。发送端从 753B 缩到 35B,这个结果挺能打。
先别急着下“35B 胜过 753B”的结论。Mostik 是闭源系统,训练数据未公开,论文引用的是它公布的结果,不是同环境重跑;Mostik 是否按领域分别训练桥也不清楚,而 PLatour 的数学和代码桥是分开训练的。两边 sender 还来自不同模型家族。这是一组有参考价值的对照,不是严格同条件的擂台赛。
数据去污倒做得比较认真。AIME 全集有 135 题,其中 55 题与准备好的 DAPO 数据池重叠,所以论文同时报告剔除重叠题后的 AIME-80;DeepCoder 最终留下 18,873 条训练题和 201 条验证题,并排除与三项代码测试集的重叠。AIME 单题采样 16 次,回答预算 32K token,评测强度不低。
推理效率:长输出摊薄成本,不等于端到端加速已经坐实
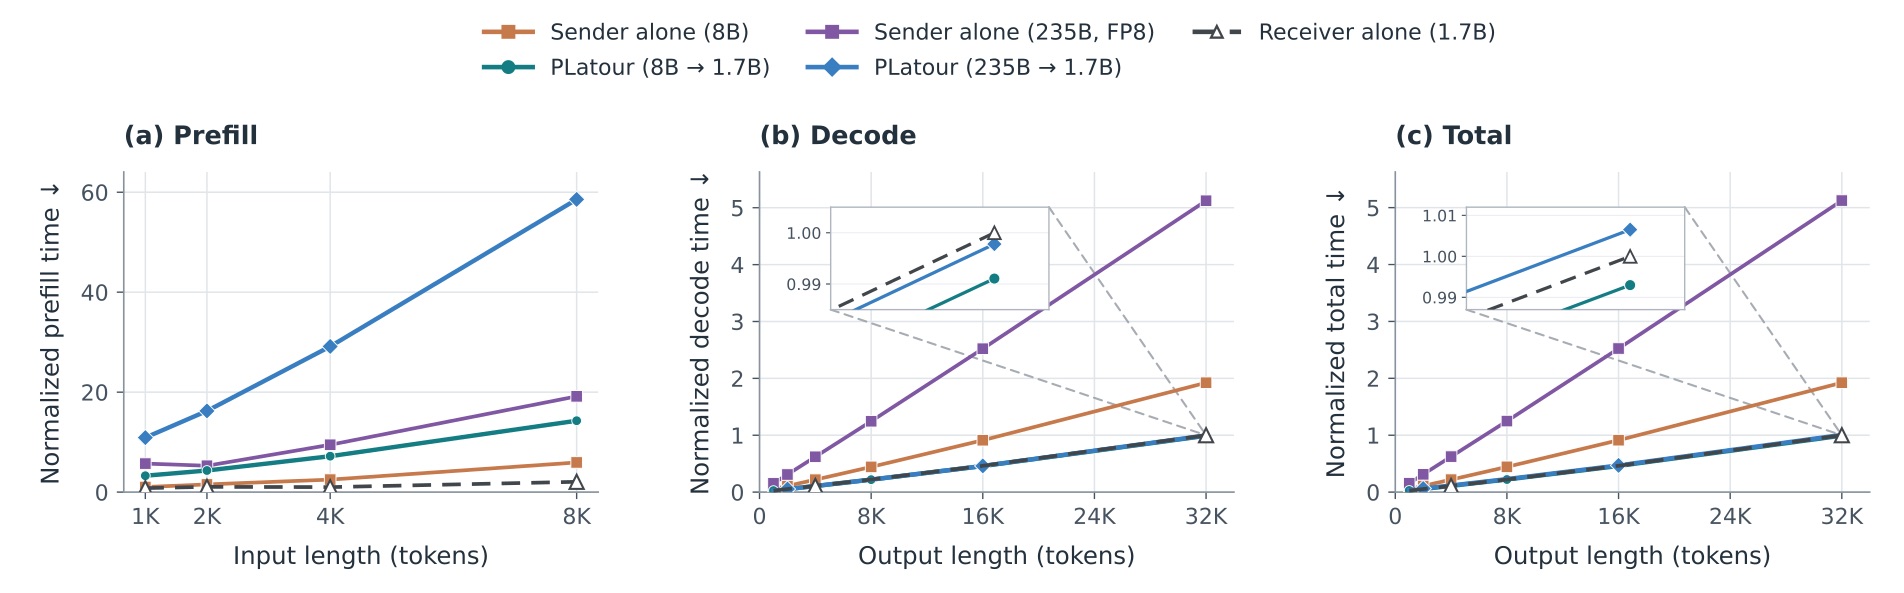
图3左面板显示,输入从 1K 增到 8K 时,235B→1.7B 的 PLatour prefill 开销增长很快,远高于 receiver 单独 prefill。中间与右侧面板把输入固定为 4K:输出越长,235B sender 单独解码的归一化时间越夸张,而 PLatour 的 decode 和 total 曲线贴近 receiver-alone。
这张图支持的是“固定开销可以被长生成摊薄”,不是“PLatour 在所有场景都更快”。短输入、短回答时,额外 prefill 很刺眼;长输出时,总时延接近小模型,自然明显低于大模型逐 token 解码。
还有个评测边界要盯住:纵轴是归一化时间,不是绝对秒数,正文也没给一张完整的生产吞吐、显存和成本表。你想想看,真实服务还要看并发、KV cache 占用、跨卡通信、发送端驻留方式。仅凭图3就推算线上成本会省多少,步子迈得太快。
PACT-Check:把“通信收益”和“接收端适配收益”拆开
如果桥本身能学习,那么它就可能既是翻译器,也是适配器。PACT-Check 用四个对照把这两种角色拉开。
Dummy Transfer,DT:用 500 个训练 prompt 计算固定模板位置的平均 sender 特征。测试时不加载 sender,只传这些与当前题目无关的模板均值,题目位置的直接通信被关闭。如果性能还在,题目特定的信息就不是必需条件。
Irrelevant Transfer,IT:sender 读取另一道无关训练题,receiver 读取原题,再把不匹配的特征传过去。它测试系统是否在意传输内容的相关性。分数暴跌说明系统对分布扰动敏感,却不能单独证明它理解了语义。
Self-Communication,SC:让 receiver 自己当 sender,再独立训练桥。此时投影近似作用在 receiver 自己的隐藏状态上,线性桥就变成一个残差 adapter。没有更大的外部模型,若照样涨分,收益显然可以来自接收端适配。
Trained Receiver,TR:完全不要桥,直接用 LoRA 或全参数 SFT、GRPO 微调 receiver。这是最实在的对照:如果同样训练预算下小模型自己就能学得更好,为什么还要在线上常驻一个 sender?
最终的 PACT-Score 很朴素:
它不是“真实通信占比”,单位是准确率百分点。正数只表示当前 PACT 系统超过所有已测试对照,为 sender 信息带来收益提供证据;零或负数表示至少一个对照已经追平或超过它,不能把全部涨分都记到跨模型通信头上。
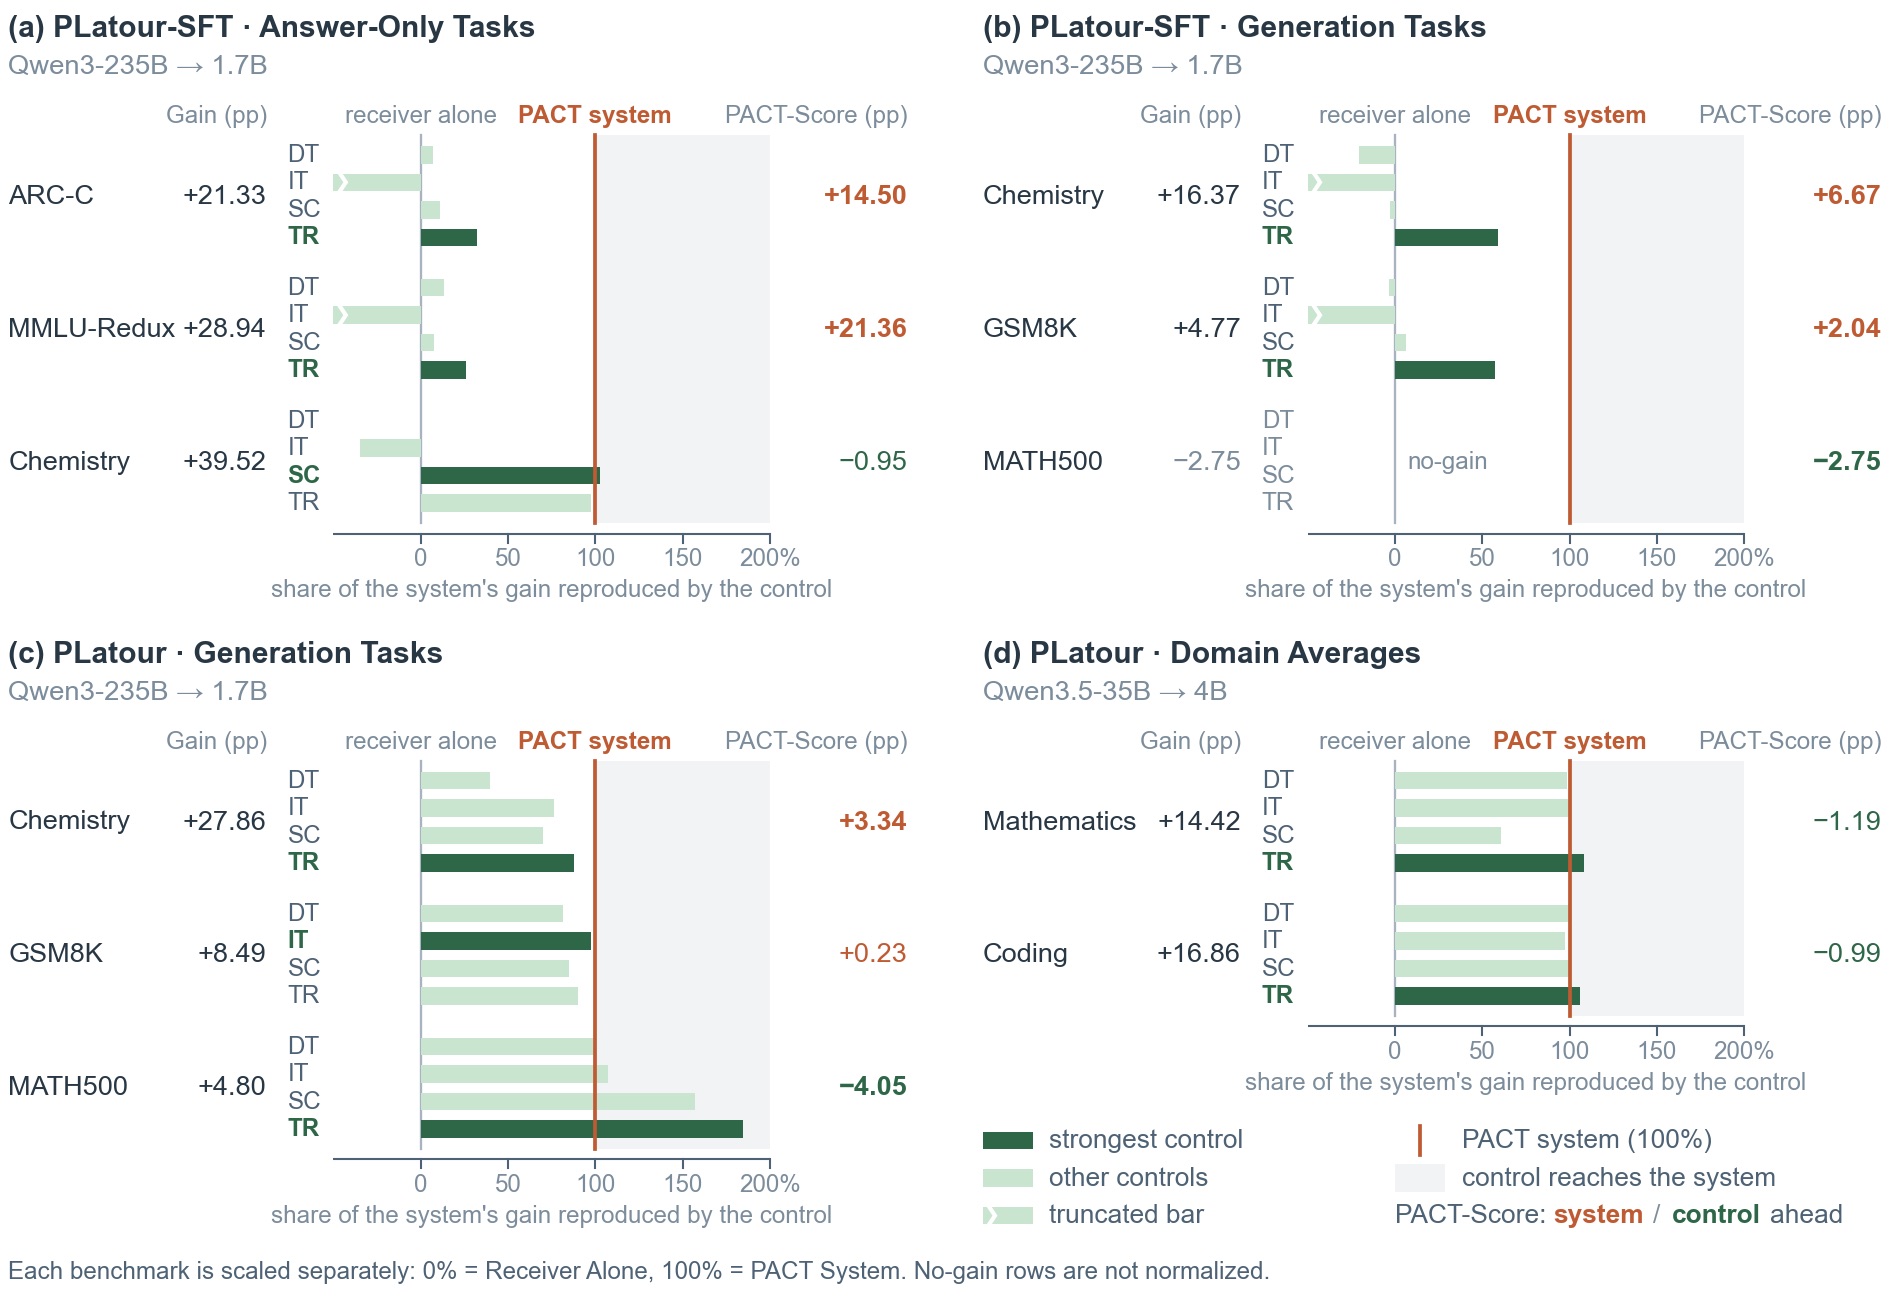
图4把 Receiver-Alone 设为 0%、PACT 系统设为 100%,柱子表示各对照复现了多少原始增益。超过 100% 就是对照更强。右侧 PACT-Score 则是原始准确率差值,不是柱子的百分比。Qwen3.5 的数学和代码平均 Gain 分别为 14.42、16.86 个点,但 PACT-Score 分别为 -1.19、-0.99,正对应 TR 对照超过 PACT 系统。
同一组涨分,换一把尺子就完全变了味道
论文表3给出一组很干净的数字:
| 方法 | ARC-C PACT-Score | MMLU-Redux | Chemistry CoT | GSM8K | MATH500 |
|---|---|---|---|---|---|
| C2C | 11.69 | 22.14 | -24.94 | -12.68 | -14.35 |
| KV-Lingo | 10.15 | 16.34 | -25.00 | -10.18 | -12.40 |
| PLatour-SFT | 14.50 | 21.36 | -8.15 | -2.90 | -10.15 |
| PLatour | – | – | 3.34 | 0.23 | 负 4.05 |
PLatour 在 GSM8K 上从 80.86 涨到 89.35,表面 Gain 是 8.49 个点;可 LoRA-GRPO receiver 能到 88.53,自通信也有 88.06,剩余余量只有 0.23 个点。MATH500 更直接:PLatour 是 78.20,LoRA-GRPO receiver 是 82.25,PACT-Score 为 -4.05。
Chem-CoT 是另一边的故事。PLatour 为 69.29,DT 降到 52.44,IT 为 62.68,SC 为 60.95,最强 TR 为 65.95,仍留下 3.34 个点的正余量。这里至少能说,现有四个对照没有复现全部收益。
Qwen3.5 的结果更值得泼一盆冷水。35B→4B 的数学平均为 63.32,全参数 GRPO receiver 为 64.51;代码平均为 79.73,全参数 GRPO receiver 为 80.72。DT、IT、自通信也都能接近原始系统。大模型花了 prefill 成本,领域平均分却没有赢过直接训练小模型。
图4(b)和表3之间还有一个容易看漏的差别:图4(b)给 PLatour-SFT 配的是 SFT 匹配的 TR,所以 Chemistry、GSM8K 的分数是 6.67、2.04;表3对所有生成方法统一采用更强的全参数或 LoRA GRPO 对照,两个数就变成 -8.15、-2.90。这个变化不是数据打架,而是在提醒我们:所谓通信净收益,高度取决于你愿不愿意把最强适配基线放进来。
消融实验:简单的桥反而更好,训练稳定性却没解决
隐藏状态、残差传播、线性投影和零初始化都在起作用
附录 E 在 MATH500 上做了比较完整的设计拆解,报告 avg@4:
| 设计维度 | 变体 | 准确率 |
|---|---|---|
| 通信介质 | Hidden-state transfer | 88.05 |
| 通信介质 | Hidden-state,不向高层传播 | 86.80 |
| 通信介质 | KV-cache transfer | 86.00 |
| 训练目标 | GRPO | 88.05 |
| 训练目标 | SFT | 83.55 |
| 训练目标 | OPD | 83.20 |
| 投影结构 | 单层 Linear | 88.05 |
| 投影结构 | Two-layer Linear | 85.40 |
| 投影结构 | Two-layer MLP + GELU | 85.80 |
| 初始化 | Zero | 88.05 |
| 初始化 | Random | 85.05 |
这个结果挺反直觉:不是桥越复杂越好,单层线性投影比两层线性和 MLP 都高。作者也选择保留这种容易分析的形式。相对深度层匹配在 hybrid full-to-full 配置下到 91.25,优于普通相对深度的 89.70 和相对 block 的 88.00;零初始化在另一组直接 GRPO 轨迹里,120 step 时为 88.1,随机初始化为 85.1。
不过,“lightweight”要相对看。附录 A18 明确写着,28 个接收层的投影合计 234,881,024 个参数,约 235M。相对 235B sender 很小,相对 1.7B receiver 就不是一个可以省略的零头。每层都做 \(d_R\times d_S\) 的稠密矩阵,发送端维度和接收端层数一上来,桥的参数与显存也会跟着长。
SFT 更依赖发送端内容,GRPO 更稳,却也更容易变成适配器
PLatour-SFT 遇到 IT 时崩得很厉害:235B→1.7B 的 GSM8K 从 85.63 掉到 0.80,MATH500 从 70.65 掉到 0.60。PLatour 在同样干预下分别是 89.12、78.55,几乎不动。
一个可能解释来自投影范数。SFT 学到的投影矩阵总 Frobenius 范数是 GRPO 的 4.32–8.32 倍,对无关发送端特征更敏感。GRPO 的小范数桥更稳,却也更容易在无关信号存在时保留适配收益。这里有个不太舒服的训练目标张力:要求桥强依赖 sender,可能换来脆弱;要求它对扰动稳健,又可能让它忽略 sender。
大 sender 不一定更好,训练崩起来相当直接
397B→4B 在 Qwen3.5 上反而输给 35B→4B。附录训练曲线给出了线索,而不是把原因包装成“规模定律失效”。
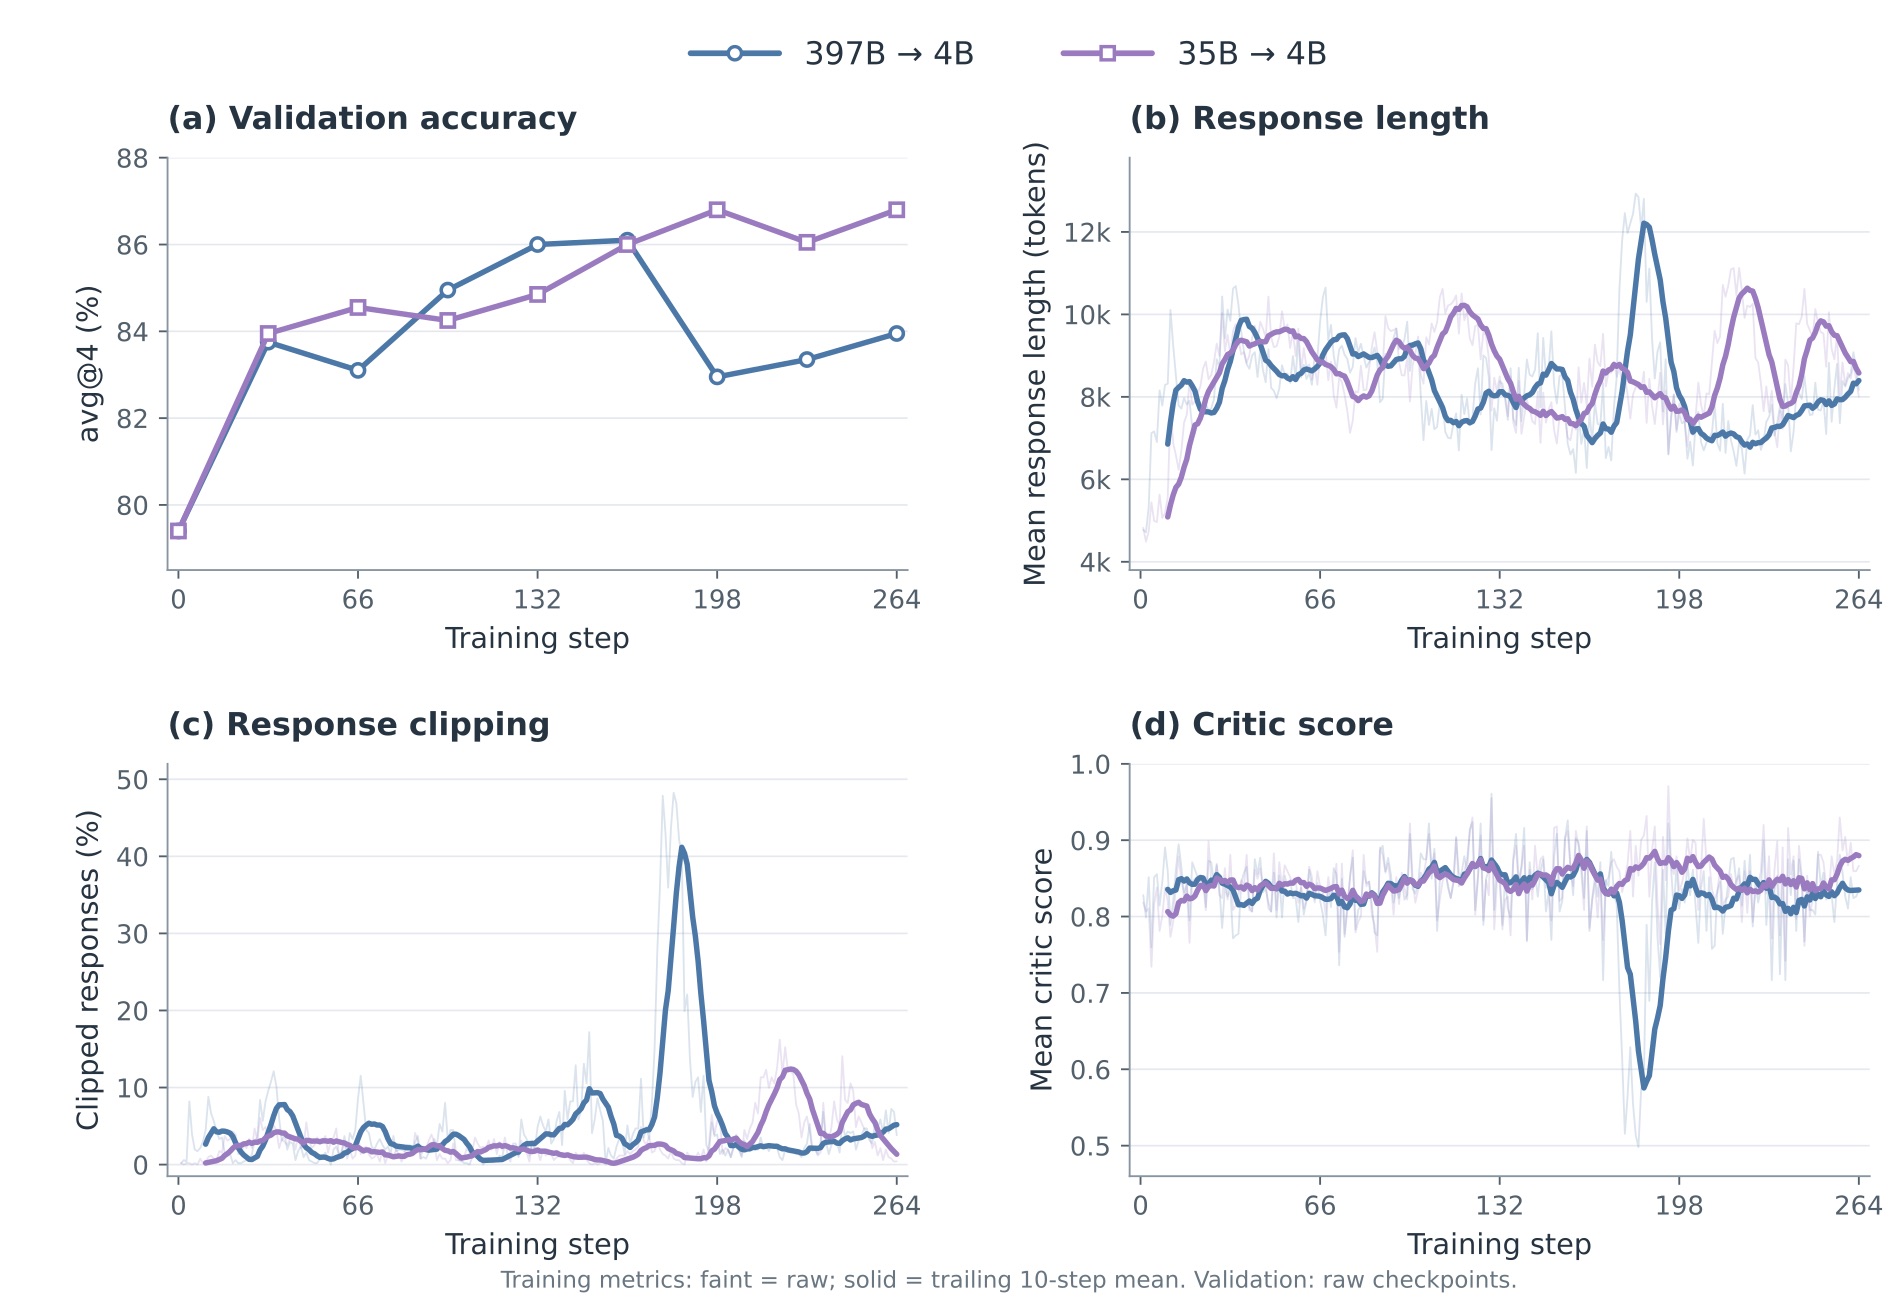
图A1中,397B→4B 在约 180 step 出现回复长度尖峰,截断率冲到约 41%,critic score 跌到约 0.57;验证准确率随后从约 86% 掉到约 83%,恢复有限。35B→4B 的验证准确率后续仍能到约 86.7%。浅色线是原始训练指标,实线是 10 step 滑动平均。
MATH 上更极端:235B→1.7B 的 PLatour 在 177 step 后准确率为 0,平均回复长度涨到 2,438 token,截断率达到 59.40%;同表 LoRA-GRPO 到 295 step 时准确率仍有 82.25。论文最终报告按验证集均值选 checkpoint,因此主表不会呈现这条崩溃后的最差状态。
我不觉得选最佳验证 checkpoint 有问题,这是常规做法;但部署时不能只看主表那个最高分。训练是否经常崩、需要多少次重跑、监控哪些信号,同样属于方法成本。
我的判断:真正被推进的是评测标准,不是“模型心灵感应”
这篇论文有三层价值,分量并不一样。
PLatour 的架构贡献是扎实的工程整合:hidden-state 残差注入、相对深度层匹配、零初始化线性桥,再用 GRPO 直接优化任务奖励。单个设计都有前置脉络,组合后把 PACT 推到 16K 训练生成预算、32K 评测预算、超过 100:1 的 sender–receiver 参数比和混合注意力架构,还开放代码。它很适合成为后续研究的公共基线,但我不喜欢把它包装成全新的底层通信理论。
PACT-Check 的概念贡献更硬。可训练桥位于冻结模型之间,天然同时具有“信息转换”和“参数高效微调”两种身份。DT 对应一种类似可学习 prefix 的固定条件信号,SC 对应线性残差 adapter,TR 则把普通 LoRA 和全参数训练拉进同一座擂台。以后凡是报告 latent communication 涨分的工作,只给 Receiver-Alone 和 Sender-Alone,已经很难有说服力了。
限制也相当清楚。主要受控实验都在 Qwen 同家族模型内,跨家族共享表征的假设没有被真正检验;PACT-Score 只是相对当前对照的余量,不是因果识别出来的“通信百分比”;正分数不能证明桥传的是人类理解的解题知识,负分数也不能证明 sender 完全没用。DT 和 IT 会改变输入分布,TR 与桥训练的参数规模、优化难度也不一样。说实话,这块我也不认为存在一组能一劳永逸排除所有替代解释的对照,PACT-Check 是更严格的起点,不是裁判终锤。
如果要把它放进工程系统,我会先做三件事。把固定系统 prompt 的 sender 表征缓存下来,测试能否摊薄重复 prefill;选一个 sender 明显拥有互补知识、receiver 又能利用这些知识的任务,而不是只在接收端自己就能学好的数据集上冲分;上线前同时跑 TR 和 SC,并记录绝对时延、峰值显存、桥参数量和训练失败率。若 PACT-Score 接近零,直接微调 receiver 往往是更简单的方案。
论文结尾提到“问题理解”和“解答搜索”可以分开扩展:大模型负责理解,小模型用更低成本搜索更长。这个方向值得继续追,但下一步不该只问桥还能传多少,而应该问——怎样训练才能让桥不得不用 sender 的信息,同时又不被无关扰动一打就崩? 这才是 PACT 从漂亮分数走向可信系统的关键。
公开参考资料
- PLatour 论文:https://arxiv.org/abs/2611.06976
- PLatour 代码:https://github.com/zhenyi4/platour
- Cache-to-Cache(C2C):https://arxiv.org/abs/2510.03215
- DeepSeekMath / GRPO:https://arxiv.org/abs/2402.03300
- Prefix-Tuning:https://arxiv.org/abs/2101.00190
- Parameter-Efficient Transfer Learning for NLP(Adapter):https://arxiv.org/abs/1902.00751
- The Platonic Representation Hypothesis:https://arxiv.org/abs/2405.07987
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我