自己只完成 14.7%,却教出 86.8%:不会行动的模型,也能当 Agent 老师?
你让一个 Agent 把加热过的杯子放到桌上。它拿着冷杯子站在桌边,眼前有两个选择:直接把杯子放下,一步完成“放到桌上”;或者先绕去微波炉,加热,再回来。
很多决策模型会选前者。
动作看起来漂亮,任务却失败了。更有意思的是,同一个模型在看完一整段轨迹后,又能认出“先去微波炉”才是真正有帮助的动作。它自己做不对,事后却评得明白,甚至能靠这些评分把另一个小模型教会。
我的第一反应是:这不就是“会批改作业,但不一定会做题”吗?这篇论文把这个直觉拆成了可测量的三件事——Actor、Judge、Teacher,并用同一批模型、同一类任务做了对照。答案很反直觉,也很实用:评估一个监督模型,不能只看他亲自下场能得多少分。
核心摘要
长程 Agent 的结果奖励往往只在回合末尾出现,所有动作共享同一份信用,关键前置步骤很容易被淹没。论文让决策模型分别充当行动者、评判者和教师,发现真正决定监督质量的是“看多少轨迹、问什么问题”。JEV 在 ALFWorld 有依赖子目标上亲自行动只完成 14.7%,但用完整轨迹回答“该动作是否帮助达成目标”,可把 1.5B 策略在这类任务上推到 86.8%;总体成功率也从 GRPO 的 72.8% 提到 82.9%。我觉得它最值钱的不是新 RL 公式,而是一套便宜、可复用的教师筛选方法。
论文信息
- 标题:Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents
- 作者:Haochen Liu、Qianhao Zhu、Zixuan Wang、Dingming Li、Tongbo Chen、Peng Qiu、Yingqi Qu、Weiming Lu、Jun Xiao、Yongliang Shen
- 机构:Zhejiang University、Baidu Inc.(按论文署名页)
- 提交时间:2026 年 11 月 12 日,v1
- 论文链接:https://arxiv.org/abs/2611.17167
- 代码链接:https://github.com/ZJU-REAL/decision-agents
一个回合只给一个奖励,问题出在哪?
GRPO 这类方法很适合拿一组轨迹做相对比较:同一个任务采样多条 rollout,成功的轨迹优势高,失败的轨迹优势低。但到了多步 Agent 任务,一个回合可能有二三十个动作,结果奖励却只有一个。
于是,“打开微波炉”和“重复查看同一件物品”可能拿到完全相同的轨迹级优势。前者是后续加热的必要条件,后者什么也没改变。你想想看,这样的训练信号要怎样告诉策略:两个动作该被区别对待?
传统补救办法是训练过程奖励模型,或者逐步请 LLM 标注。前者需要每个领域的过程标签,后者调用成本高。论文盯上的是另一类模型:decision model。它不自由生成答案,而是对给定问题返回带类型的决策结果——多选时输出选项及概率,是非题则返回 \([0,1]\) 分数。
同一模型可以被问三次,但三次的身份完全不同。
| 角色 | 模型看到什么 | 模型回答什么 | 答案怎么用 |
|---|---|---|---|
| Actor | 当前观察、历史与候选动作 | 下一步选哪个动作 | 直接控制 Agent |
| Judge | 已记录轨迹中的目标动作及可见上下文 | 这个动作有多大价值或贡献 | 衡量逐步判断质量 |
| Teacher | 训练策略生成的 rollout | 每个已执行动作的分数 | 加入 GRPO 优势,更新策略 |
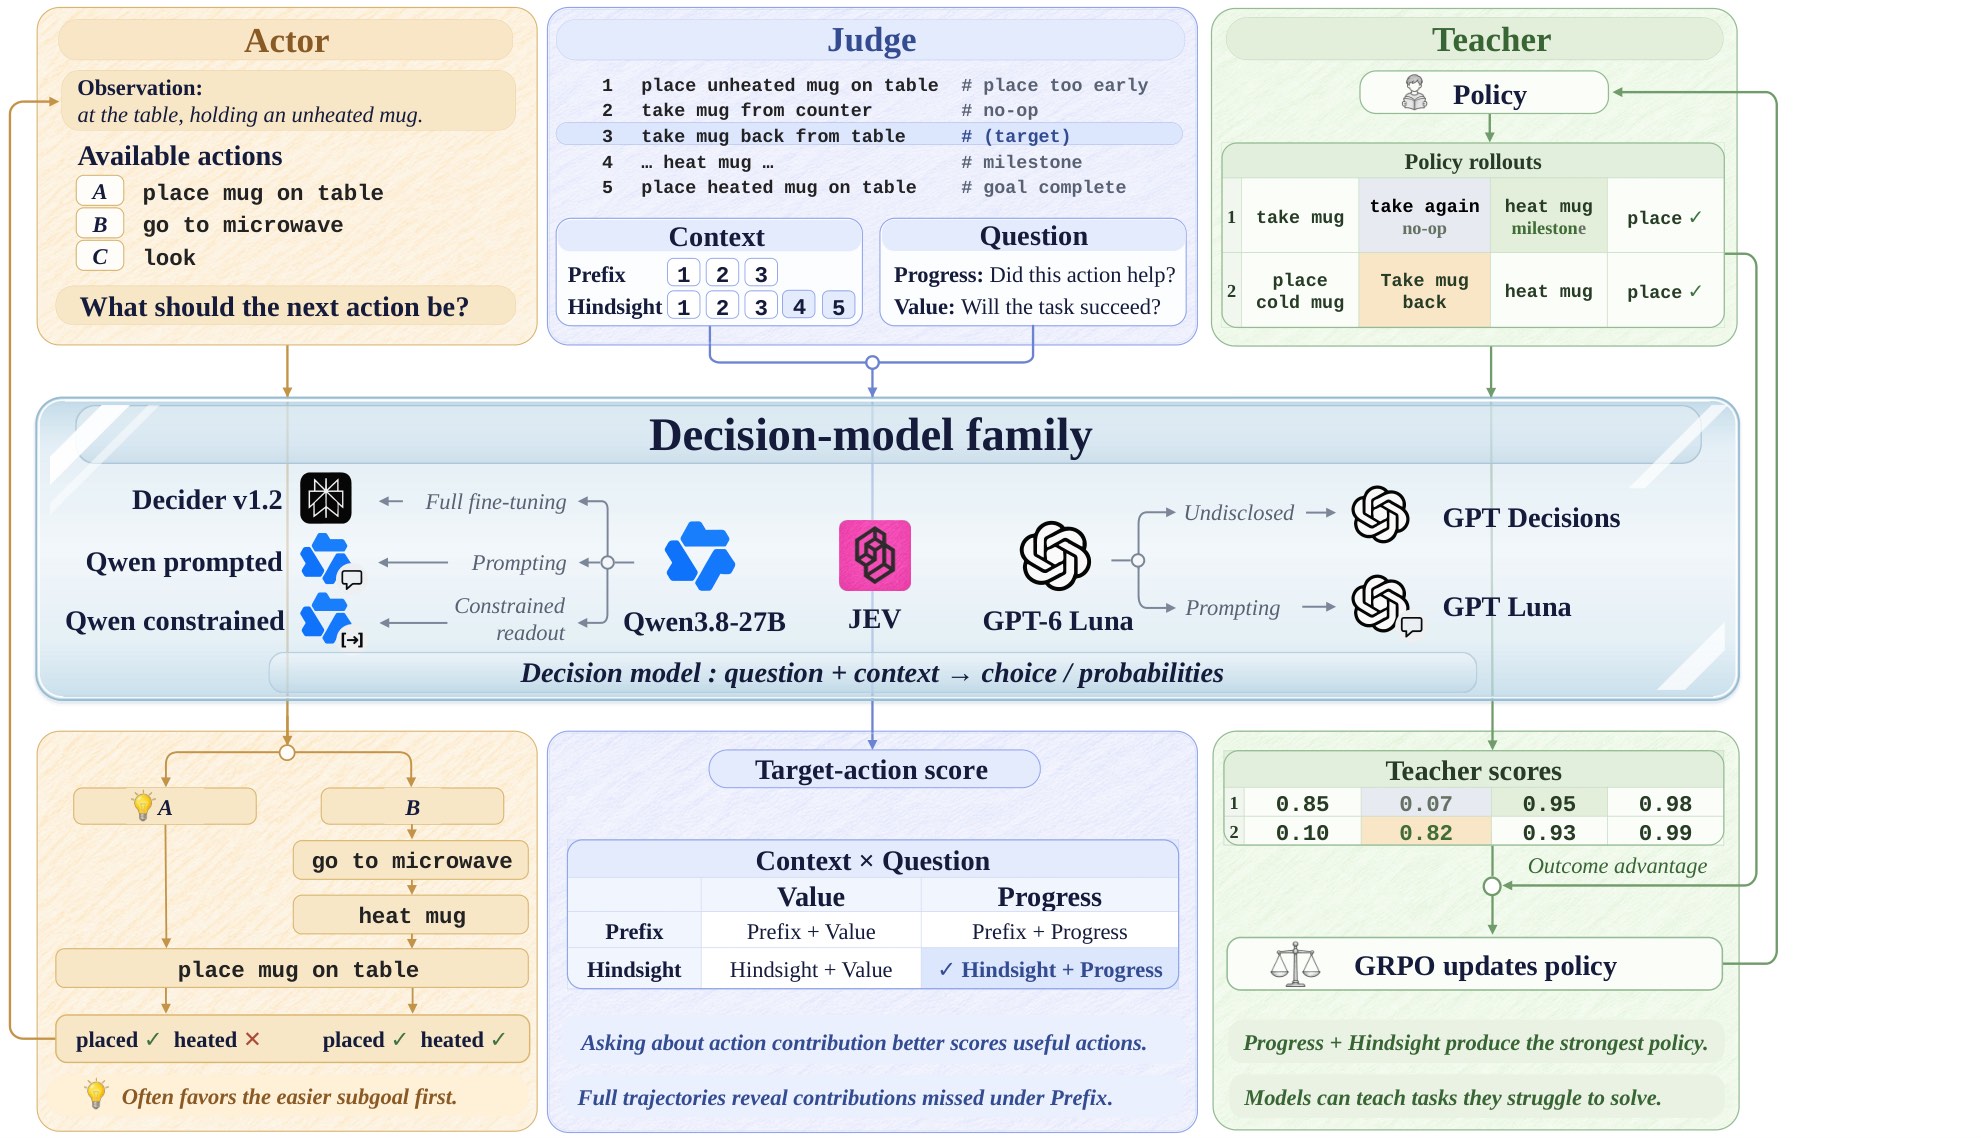
图 1:左侧 Actor 在看到动作后果前做选择;中间 Judge 用 Prefix 或 Hindsight 上下文回答 Value 或 Progress 问题;右侧 Teacher 对策略 rollout 逐步打分,再把中心化分数加到 GRPO 的结果优势上。下方也列出了六个被测模型及其关系。
这里有两个独立开关,别把混在一起:
| 设计轴 | 两种选择 | 真正差别 |
|---|---|---|
| 可见上下文 | Prefix / Hindsight | 只看目标动作之前,还是连后续后果一起看 |
| 提问目标 | Value / Progress | 问“任务会不会成功”,还是问“这个动作有没有帮助” |
这两个开关,后来几乎决定了全部实验结果。
Actor:不是不知道,而是被容易的子目标抢走了注意力
论文用 ALFWorld 把任务拆得很巧。Pick、Look 没有子目标依赖;Pick2 要放两个物体,但顺序任意;Clean、Heat、Cool 则要求先改变物体状态,再放到目标位置。
六个模型里,三个是专用决策模型 JEV、Decider v1.2、GPT Decisions,另外三个是通用 LLM 通过提示或约束读数得到的决策接口。JEV 的基础模型和适配方式未公开;Decider v1.2 从 Qwen3.8-27B 全量微调;GPT Decisions 基于 GPT-6 Luna,适配细节未披露。
亲自下场,全都怕“先处理,再放置”
| Actor | Pick | Look | Pick2 | Clean | Heat | Cool | 总体 |
|---|---|---|---|---|---|---|---|
| JEV | 77.1 | 46.2 | 70.8 | 11.1 | 18.8 | 16.0 | 42.9 |
| Decider v1.2 | 97.1 | 53.8 | 83.3 | 55.6 | 18.8 | 40.0 | 63.6 |
| GPT Decisions | 88.6 | 76.9 | 62.5 | 29.6 | 25.0 | 24.0 | 52.9 |
| Qwen prompted | 77.1 | 53.8 | 79.2 | 22.2 | 31.2 | 20.0 | 49.3 |
| Qwen constrained | 77.1 | 46.2 | 75.0 | 33.3 | 6.2 | 8.0 | 45.0 |
| GPT Luna | 77.1 | 46.2 | 37.5 | 18.5 | 0.0 | 4.0 | 34.3 |
表 1:ALFWorld Actor 成功率,单位为 %。每个 Actor 在每个任务上评估一次;数值来自论文 Table 2。

图 2:无依赖任务与有依赖任务的热图对比。JEV 在 Pick2 上有 70.8%,到了 Clean、Heat、Cool 只剩 11.1%、18.8%、16.0%;总体最强的 Decider v1.2,在 Heat 上也只有 18.8%。
Pick2 和 Heat 都有两个子目标,难度差异却不能简单归因于“步骤更多”。区别就在顺序:两个铅笔谁先放都可以,冷杯子却不能先放再加热。
说实话,这个失败场景我在读的时候很有画面感。模型并不是完全不懂“heat mug”,它只是太喜欢眼前那个一步就能打勾的子目标。
把“放置”从目标里删掉,概率立刻翻盘
作者收集了 116 个诊断状态,来自 66 个任务:Agent 已经拿着尚未清洁、加热或冷却的物体站在目的地,只需一步就能完成较容易的放置子目标,但必要的状态改变还没做。
同一状态、同一历史、同一候选动作,只把完整目标“put a heated mug on the side table”改成“heat a mug”,结果非常直接:
- 完整目标下,JEV 给必要状态改变的概率只有 14.6%,给放置动作 63.8%。
- 删除放置子目标后,必要状态改变升到 77.6%,放置动作降到 2.5%。
- 六个模型都朝同一方向变化。

图 3:左图显示删掉放置子目标后,各模型把更多动作概率转给必要的状态改变;右图比较原始提示、依赖提示、提示加排序示例。示例能帮助部分模型,但并非通用解药,Decider v1.2 还从 89.7% 降到 85.3%。
所以,问题不完全是知识缺失,更像多个目标同时出现时,动作选择被短期可完成的子目标带偏了。
那加一句“请考虑任务要求之间的依赖关系”呢?六个模型的成功率变化只有降 2.8 个点到涨 5.2 个点。再加入 heated-mug 排序示例,Qwen constrained 从 41.7% 到 58.3%,Qwen prompted 从 46.6% 到 58.6%,GPT Decisions 从 20.8% 到 32.1%;JEV 只从 19.0% 到 24.1%,GPT Luna 几乎不动。
一句提醒不太够,一个示例时灵时不灵。这对工程实践挺扎心:提示词里写“注意先后顺序”,远远不等于模型真的学会了依赖规划。
Judge:事后看得明白,但必须问对问题
同一个模型换成 Judge,评价已经发生的动作。这里不需要它预判后果,因为后果就摆在轨迹里。
看见后续,六个模型都改变了判断
作者复用前面的诊断状态,只评估成功续跑中的首个动作,并遮住环境成功标签。Prefix 在目标动作处截断,连动作执行后的观察都不给;Hindsight 则给出完整轨迹。
JEV 对“动作是否有贡献”的平均分从 Prefix 的 0.41 升到 Hindsight 的 0.59,六个模型全部上升。

图 4:六个 Judge 在相同决策点上的评分对比。所有模型的 Hindsight 柱都高于 Prefix,说明后续轨迹会改变它们对早期必要动作的评价。
但这里有个陷阱:看到完整轨迹,模型也可能猜到了任务成败,然后给同一条成功轨迹里的所有动作都打高分。那样只是换个形式复述结果奖励,仍然没有逐步信用。
Progress 和 Value 的分歧就在这里暴露出来。
Value 把动作挤在一起,Progress 把贡献拉开
论文把动作分成三类:milestone 完成一个子目标;no-op 不改变环境和观察,或执行无效命令;其余归入 other。比较使用 462 条 ALFWorld 轨迹,每条至少含一个 milestone 和一个 no-op。
| JEV 提问方式 | Milestone | Other | No-op | Milestone 相对 no-op 的组内分差 |
|---|---|---|---|---|
| Value:任务之后会成功吗 | 0.632 | 0.604 | 0.577 | 0.05 |
| Progress:这个动作帮助达成目标了吗 | 0.659 | 0.440 | 0.298 | 0.36 |

图 5:左面板中,Value 给三类动作的分数很接近,Progress 则明显压低 no-op;中间面板显示,在每条轨迹含 \(R\) 个 milestone 时,取评分最高的 \(R\) 个动作,Progress 的 Recall@\(R\) 在各组都更高;右面板给出相对 no-op 的组内分差。
Progress 的 milestone Recall@\(R\) 比 Value 高 8.0 到 16.0 个点。这个指标很直观:一条轨迹有 \(R\) 个真正完成子目标的动作,就看评分前 \(R\) 名里找回了多少个。
六个模型都呈现同一趋势,不是 JEV 一家的偶然现象。

图 8:所有模型在 Progress 下都拉大了 milestone 与 no-op 的距离。例如 Decider v1.2 的两者分数从 Value 的 0.608、0.439,变成 Progress 的 0.729、0.099;GPT Luna 则从 0.560、0.352 变成 0.531、0.048。
我觉得这张热图比单看 JEV 更有说服力。它说明“问题决定信号粒度”不是某个闭源 API 的怪癖,而是六种接口共享的现象。
后续信息到底改变了什么?
作者又取 167 条轨迹、2,849 个动作,固定 Progress 问题,逐步开放上下文:Prefix、动作后的即时反馈 FB、后续轨迹的 25%、50%、75%,直到完整轨迹。
随着可见内容增加,JEV 的动作排名相对 Prefix 平均移动 1.95 位(只加即时反馈)到 3.30 位(完整轨迹)。

图 6:每条细线是一条轨迹,虚线是平均排名位移,颜色表示轨迹长度。后续信息越多,动作在组内的相对排序变化越大。
单看排名变化还不能证明判断更准,它只能证明模型确实使用了未来信息。真正让我理解这个机制的是 heated-mug 轨迹里的几步:
| 步骤与动作 | Prefix | 即时反馈 | 完整轨迹 |
|---|---|---|---|
| 2:重复 look | 0.25 | 0.25 | 0.23 |
| 6:尚未加热就把杯子放进柜子 | 0.79 | 0.90 | 0.60 |
| 7:把杯子拿回来 | 0.22 | 0.25 | 0.50 |
| 8:去微波炉 | 0.23 | 0.22 | 0.50 |
| 9:打开微波炉 | 0.20 | 0.18 | 0.76 |
| 10:加热杯子 | 0.42 | 0.67 | 0.70 |
| 12:把加热后的杯子放回柜子 | 0.68 | 0.85 | 0.85 |
表 2:论文 Figure 7 与 Table 9 的节选。完整轨迹让“打开微波炉”从 0.20 升到 0.76,因为后续加热动作揭示了它的贡献。
这里就有点反直觉了:即时反馈反而把过早放置抬到 0.90,因为“放置成功”的局部反馈看起来很顺眼;只有看到后面又拿回杯子、加热、重新放置,Judge 才理解前面的打开微波炉不是闲逛。
不过别把这个案例神化。过早放置在完整轨迹下仍有 0.60,谈不上被彻底识破。后见评分更有用,不等于每一步都评得准。
Teacher:把事后判断变成训练信号
Teacher 的算法并不复杂,甚至可以说很克制。JEV 在训练期间保持冻结,对每条 rollout 的每个已执行动作打一次分:
输入只有目标、观察和动作,不含环境奖励、成功标签或隐藏状态。随后在同一个任务的 rollout 组内做均值中心化,加到 GRPO 的结果优势上:
\(\lambda=0.5\)。高于组均值的动作得到额外正调整,低于组均值的动作被压低。每个动作的优势分配给该动作生成的所有 token。
有个细节挺漂亮:中心化后不除以标准差。若 Teacher 对一组动作都给出相近分数,调整幅度自然很小,不会因为组内波动微弱就被归一化强行放大。
策略是 Qwen2.5-1.5B-Instruct 和 Qwen2.5-7B-Instruct。训练 150 步,每批 16 个任务,每任务 8 条 rollout;学习率 \(1\times10^{-6}\),ALFWorld 和 WebShop 的单条 rollout 上限分别是 30 和 15 个动作。Teacher 只在训练时调用,测试阶段不需要它。
四种组合,只有 Hindsight + Progress 全面领先
| 策略与方法 | Pick | Look | Pick2 | Clean | Heat | Cool | ALFWorld 总体 | WebShop Score | WebShop Succ. |
|---|---|---|---|---|---|---|---|---|---|
| 1.5B + GRPO | 85.3 ±1.5 | 53.7 ±8.0 | 53.5 ±5.6 | 84.5 ±6.8 | 78.2 ±7.9 | 59.7 ±5.0 | 72.8 ±3.6 | 75.8 ±3.5 | 56.8 ±3.8 |
| 1.5B + Prefix + Value | 95.2 ±4.4 | 66.7 ±11.8 | 73.6 ±4.8 | 81.5 ±9.8 | 77.1 ±7.2 | 66.7 ±2.3 | 79.0 ±3.6 | 77.2 ±0.3 | 67.7 ±0.5 |
| 1.5B + Prefix + Progress | 87.6 ±1.6 | 56.4 ±4.4 | 72.2 ±4.8 | 81.5 ±3.7 | 83.3 ±7.2 | 76.0 ±4.0 | 78.3 ±0.4 | 78.6 ±0.4 | 66.6 ±0.2 |
| 1.5B + Hindsight + Value | 84.8 ±1.6 | 59.0 ±4.4 | 48.6 ±8.7 | 72.8 ±2.1 | 68.8 ±6.2 | 69.3 ±2.3 | 69.3 ±0.7 | 82.2 ±0.7 | 68.3 ±1.5 |
| 1.5B + Hindsight + Progress | 90.5 ±1.6 | 74.4 ±11.8 | 65.3 ±6.4 | 88.9 ±7.4 | 89.6 ±3.6 | 82.7 ±2.3 | 82.9 ±2.9 | 84.3 ±0.4 | 71.4 ±0.7 |
| 7B + GRPO | 90.8 ±5.1 | 66.1 ±6.7 | 64.7 ±7.3 | 89.3 ±5.4 | 74.7 ±6.9 | 72.5 ±5.4 | 77.6 ±5.2 | 79.3 ±2.8 | 66.1 ±3.7 |
| 7B + Hindsight + Progress | 91.4 ±5.7 | 74.4 ±11.8 | 75.0 ±7.2 | 92.6 ±0.0 | 77.1 ±9.5 | 81.3 ±2.3 | 83.8 ±1.6 | 82.2 ±0.7 | 73.6 ±0.3 |
表 3:策略成功率,单位为 %,三种评估随机种子的均值与波动。ALFWorld 各列均为成功率;WebShop 同时保留商品匹配 Score 和完全匹配 Succ.。GRPO 数值取自 GiGPO 论文,来自原论文 Table 3。
1.5B 策略在 ALFWorld 从 72.8% 到 82.9%,涨 10.1 个点;WebShop 从 56.8% 到 71.4%,涨 14.6 个点。7B 策略也分别从 77.6% 到 83.8%、从 66.1% 到 73.6%。
更有冲击力的是,1.5B + Hindsight + Progress 在两个环境都超过 7B + GRPO。这里的卖点不是“小模型凭空变强”,而是训练时多了逐步信用,推理时并没有背着一个 Teacher。
但 Hindsight + Value 在 ALFWorld 只有 69.3%,比 GRPO 还低 3.5 个点。看到这组数我反而更相信整套分析:稠密奖励不是越多越好,问错问题,额外信号也会拖后腿。
最大收益恰好落在 Teacher 自己最差的任务上
在有子目标依赖的 ALFWorld 任务上,Hindsight + Progress 达到 86.8%,比另外三种教师设置高 6.9 到 16.2 个点。JEV 自己当 Actor 时,同类任务只有 14.7%。
这形成了论文最完整的一条因果链:
行动时,容易的子目标吸引模型提前放置;事后评判时,后续轨迹揭示前置动作的用途;训练时,Progress 把这些用途转成动作间有区分的优势。
它还让策略更快完成任务。
| 1.5B 方法 | ALFWorld ≤20 步 | ALFWorld ≤30 步 | WebShop ≤10 步 | WebShop ≤15 步 |
|---|---|---|---|---|
| Prefix + Value | 69.5 | 79.0 | 60.9 | 67.7 |
| Prefix + Progress | 65.5 | 78.3 | 61.9 | 66.6 |
| Hindsight + Value | 63.6 | 69.3 | 62.2 | 68.3 |
| Hindsight + Progress | 74.5 | 82.9 | 71.1 | 71.4 |
表 4:不同动作截断下的任务完成率,单位为 %。Hindsight + Progress 在 ALFWorld 20 步内已完成 74.5%,在 WebShop 10 步内完成 71.1%,接近各自的最终成绩。
WebShop 的 71.1% 与 71.4% 很接近,说明多数成功任务不需要把 15 步预算耗光。这里不只是“更会成功”,也少走了弯路。
一次训练 22 到 30 美元,便宜在哪里?
| 环境与策略 | 训练步数 | 单回合动作上限 | JEV Teacher API 成本 |
|---|---|---|---|
| ALFWorld 1.5B | 150 | 30 | 30.07 美元 |
| ALFWorld 7B | 150 | 30 | 24.50 美元 |
| WebShop 1.5B | 150 | 15 | 22.21 美元 |
| WebShop 7B | 150 | 15 | 26.83 美元 |
表 5:论文 Table 5 的训练成本。JEV 1.13 的实验价格为每百万输入 token 0.042 美元、输出 token 0 美元;表中不含策略训练 GPU 与环境 rollout 成本。
成本低有几个前提:动作数不长、JEV 单价低、Teacher 不参与测试。不能把这个价格直接外推到任意 LLM Judge。
论文还比较了六个 Judge 在 462 条轨迹上的排序漏判与每千次评分成本。专用决策模型相对自己的通用基础模型更有性价比:
| Judge 对比 | Milestone 漏判率 | No-op 漏判率 | 成本关系 |
|---|---|---|---|
| Decider v1.2 | 36.5% | 57.1% | 比 Qwen prompted 低约 43% |
| Qwen prompted | 49.6% | 80.8% | 较高 |
| GPT Decisions | 50.2% | 61.1% | 比 GPT Luna 低约 28% |
| GPT Luna | 54.1% | 78.4% | 较高 |
| Qwen constrained | 41.8% | 51.3% | 约为 Decider v1.2 的 1.5 倍 |
表 6:Hindsight + Progress 下,milestone 是否漏出评分前 \(R\) 名、no-op 是否漏出评分后 \(R\) 名;越低越好。Qwen constrained 的 no-op 漏判最低,但 milestone 与成本并不占优。
坦率讲,这些漏判率并不低。它们足以提供有用的训练扰动,却离可靠的逐步 verifier 还有距离。
放到已有方法里,它到底新在哪?
| 方法 | 逐步信用从哪里来 | 额外模型或标签 | 主要限制 |
|---|---|---|---|
| GRPO | 同组轨迹的结果奖励相对优势 | 不需要 critic | 同一轨迹内的动作信用较粗 |
| GiGPO | 跨轨迹重复状态形成 anchor-state 分组 | 不依赖外部 Teacher | 状态不重复时,步级分组受限 |
| 过程奖励模型 | 人工或自动标注的中间步骤 | 需要领域过程标签与训练 | 跨环境迁移和标注成本 |
| Hindsight + Progress | 冻结决策模型看完整轨迹后评价动作贡献 | 训练期 Teacher API,无逐步人工标签 | 离线打分,长轨迹上下文成本上升 |
GRPO 来自 DeepSeekMath 的组相对优化思路;GiGPO 则在同一 ALFWorld、WebShop 训练体系里引入 episode-level 与 step-level 两层优势。和它们相比,这篇论文没有发明新的策略更新目标,核心贡献更像一次角色重估加奖励接口设计:把决策模型从“亲自行动”挪到“事后逐步监督”,再用 Prefix/Hindsight 与 Value/Progress 的交叉实验证明怎样问才有用。
它也与 2019 年的 Hindsight Credit Assignment 共享一个直觉:动作的价值可以从后续结果反推。区别在于,这里由冻结决策模型读取轨迹并给出分数,不需要为每个环境训练专门 critic。
至于 weak-to-strong,我觉得要克制一点。学生确实超过了 Teacher 的 Actor 成功率,但学生训练仍保留环境结果奖励,Hindsight + Progress 是加在 GRPO 优势上的增量,不是只靠弱教师标签从头学习。因此,这个结果支持“弱行动能力不妨碍提供监督”,还不足以证明纯粹的弱监督可以替代环境奖励。
我对这篇论文的保留意见
| 疑问 | 我的判断 |
|---|---|
| 是否超过了现有细粒度信用方法 | 还不能下这个结论。主表只有 GRPO,没有与 GiGPO 正面对比;GRPO 数值还沿用 GiGPO 论文。相同划分方便比较,但不能替代同框架 baseline。 |
| 好 Judge 是否一定是好 Teacher | 论文只把 JEV 放进 RL 训练,另外五个模型只做了 Actor/Judge 分析。六种模型都评得更合理,不等于六种模型都能教得更好。 |
| 后见信息会不会泄露答案 | 作者遮住了成功标签,WebShop 还替换终端购买页观察,实验处理是谨慎的。但完整轨迹本身仍会暗示结局,所以它适合离线训练,不适合直接拿去做在线动作过滤。 |
| 能否迁移到真正的长任务 | 我目前不确定。实验只有两个文本环境,每回合最多 30 个动作;软件工程、复杂工具调用的依赖更隐蔽,轨迹也长得多。 |
| 成本是否会一直这么低 | 不会必然如此。若每个动作都重复读取长度为 \(T\) 的完整轨迹,不做缓存或增量编码,总输入量会近似按 \(T^2\) 增长;当前低价还依赖 JEV 的具体 API 定价。 |
| 排名指标是否足够证明判断正确 | Recall@\(R\) 和组内分差只覆盖 milestone/no-op 等粗类别,排名移动本身更不代表变准。案例与训练结果补上了证据,但逐步评分仍有很高漏判率。 |
还有一个实验细节别忽略:Actor 每个任务只评估一次,没有与策略主表相同的三种子波动。模型之间的细微排名不宜过度解读,真正扎实的是六个模型共同呈现的方向性差异。
如果你在做 Agent RL,可以直接拿走这套流程
先筛 Judge,再烧训练。 收集一批已有成功与失败轨迹,标出少量 milestone 和 no-op,用 Recall@\(R\)、组内分差、漏判率和每千次评分成本筛模型。不要先看它当 Actor 的成功率,那个指标回答的是另一个问题。
把“会不会成功”改成“有没有贡献”。 Value 在完整轨迹下容易退化成结局复述;Progress 才能把同一条轨迹里的动作拉开。论文里 0.05 与 0.36 的分差,就是这个问题改写带来的。
只在能合法看到未来的阶段使用 Hindsight。 离线 RL、轨迹重标注、数据清洗都很合适;在线 rerank 只有 Prefix,不能直接复制 82.9% 的结论。若必须在线使用,可以考虑延迟评分、后续修正,或把后见教师蒸馏进一个因果价值模型。
保留结果奖励,不要突然换掉整个训练框架。 这组实验最稳妥的用法正是给 GRPO 加一项中心化动作分数,同时不除以标准差,避免把相似评分中的噪声放大。换用其他 Teacher 时,还要重新检查分数校准,因为固定的 \(\lambda\) 会受不同模型评分尺度影响。
收尾判断
这篇论文最打动我的,不是“弱模型教出强学生”这句漂亮话,而是它把失败与成功放在同一个任务、同一个模型、同一个动作上对照:Actor 在加热前把杯子放下,Judge 看见后续后却给打开微波炉更高分,Teacher 再把这份认识变成训练优势。
所以,别再只问“这个模型能不能自己完成任务”。做 Agent 监督时,更应该问三个问题:它能否分辨关键动作与无效动作?给它多少后续上下文最合适?提问是在预测结局,还是在评价贡献?
答案选对了,一个只完成 14.7% 有序子目标任务的模型,也能把同类任务上的学生教到 86.8%。这不是魔术,是信息条件变了,问题也问对了。
参考资料
- 论文原文:Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents,arXiv:2611.17167,https://arxiv.org/abs/2611.17167
- 代码仓库:https://github.com/ZJU-REAL/decision-agents
- DeepSeekMath / GRPO:https://arxiv.org/abs/2402.03300
- GiGPO:Group-in-Group Policy Optimization for LLM Agent Training,https://arxiv.org/abs/2505.10978
- Hindsight Credit Assignment,NeurIPS 2019:https://proceedings.neurips.cc/paper_files/paper/2019/file/195f15384c2a79cedf293e4a847ce85c-Paper.pdf
- Let’s Verify Step by Step,ICLR 2024:https://arxiv.org/abs/2305.20050
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我