别让 Agent 把整座图书馆搬进上下文:SparseRead 的稀疏阅读与预算闸门
你有没有见过这样的 Agent 执行轨迹:用户只想问日志里的一个报错,工具却返回整份几万行的文件;模型终于定位到两行关键信息,可后面每一次调用,仍要把那份日志重新背一遍。
真正肉疼的地方还不只是第一次读取。无关内容进入轨迹后,会在后续模型调用里反复出现,token、延迟和证据稀释一起找上门。我的第一反应是,接一个 RAG 不就行了?读完 SparseRead 才发现,检索只回答了“去哪里找”,却没有完整回答“现在为什么读、已经读到哪里、还要不要再读、什么时候直接看全文更便宜”。
核心摘要:SparseRead 是一个不改模型参数的阅读控制层,把网页、文档、表格、代码库和工具响应的“整对象读取”改造成按需证据获取。它用 Read Intent Protocol 记录当前需求与来源覆盖,用可替换 Reader Backend 定位或计算证据,再用 Budgeted Read Gate 限制累计原始暴露,并在不合适时回退到完整视图。六个模型、五类场景的实验中,token 最多减少 92.9%,端到端耗时最多减少 89.0%,30 个模型—场景组合里有 29 个保持或提高任务分数。说实话,这不是新的基础模型能力,而是一套很扎实的 Agent 基础设施设计;真正值钱的是读取契约、证据状态和全文回退被放进了同一个控制闭环。
论文信息
- 标题:Read Less, Solve More: Token-Efficient Sparse Reading of External Content for AI Agents
- 作者:Zedong Liu, Jiaan Wu, Xinyang Ma, Le Xu, Kai Wang, Yuanchao Hu, Dingwen Tao, Guangming Tan
- 机构:arXiv 摘要页未标注
- 版本:v1 提交于 2026 年 8 月 23 日;v2 修订于 2026 年 11 月 7 日
- 论文链接:https://arxiv.org/abs/2608.22237
- 代码仓库:https://github.com/Zedong-Liu/SparseReading
1. 问题不是上下文太短,而是读进来的东西太多
Agent 的工具接口通常以“对象”为单位:打开一个网页就返回网页,读取一个文件就返回文件,调用一次 API 就把整个响应塞回来。但模型下一步需要的,往往只是其中一个段落、几行日志、一个字段,或者一次精确计算的结果。
作者把这种错位叫作 over-reading:决策只需要有边界的证据切片,系统却暴露了完整对象。
这件事有多普遍?论文引用的 SWE-Pruner 研究报告称,外部观察占 Agent 轨迹处理 token 的 60%–80%。SparseRead 自己的配对执行里,未修改的 Agent 最多消耗了 17.3 倍 token,任务质量却没有更高。
Figure 2 把“有用证据”和“被暴露但不帮助作答的内容”拆得很直观。长文档问答的有用证据只占暴露阅读预算的 6%,PDF/报告问答为 11%,多文件审计为 15%,结构化分析为 34%。低稀疏度任务则达到 69%,它恰好提醒我们:并不是所有任务都该稀疏读。
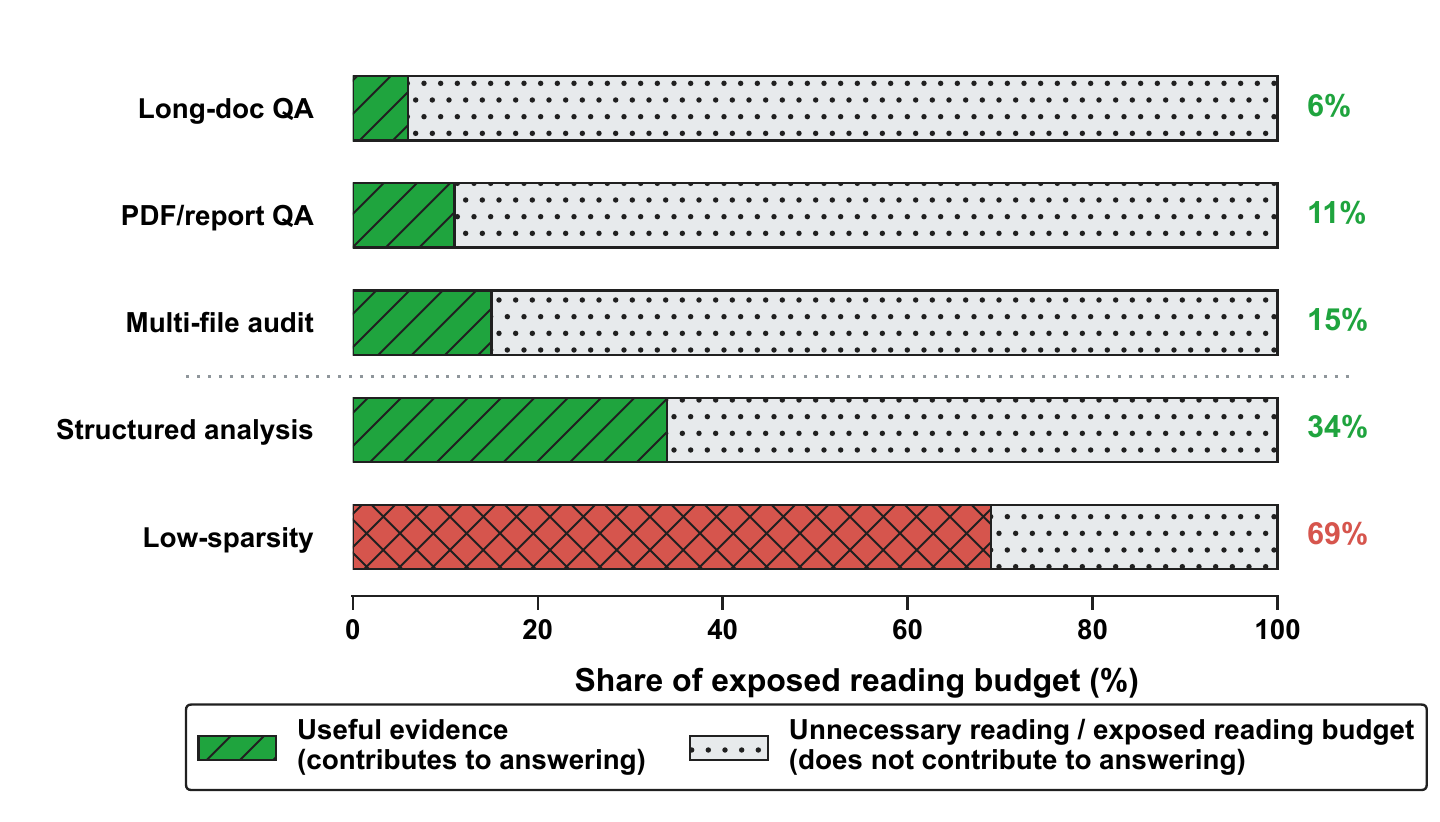
图2:绿色斜线部分是对作答有贡献的证据,点状部分是不贡献答案的暴露内容。这里的比例按字符测量,描述的是“暴露阅读预算”,不能直接当成所有 Agent 任务的平均 token 分布。
论文还给了另一组更细的标注结果:LooGLE 中,单问题对应支撑证据的源 token 占比中位数为 3.17%,同一文档五个问题合并计算为 2.89%;所分析的可回答 Qasper 问题约为 5.8%。这组数和 Figure 2 的暴露占比不是同一个口径,而且标注证据不包含“为了定位和验证证据所需读取的上下文”。作者把口径拆开写,我觉得挺严谨,没有把 3% 直接包装成“只需要读 3% 就能解题”。
这里其实藏着三个经常被混用的量:
| 量 | 它测量什么 | 一个具体例子 |
|---|---|---|
| Processing scope | Reader 在后台检查或计算了多少源内容 | 扫描整张表求和 |
| Model exposure | 有多少内容真正进入模型上下文 | 只返回求和结果、行数和来源 |
| Evidence coverage | 当前需求中的哪些证据槽已有支持,哪些仍空缺 | 已找到收入,尚缺利润和出处 |
全量处理不等于全量暴露。 这是 SparseRead 很关键的一条分界线。检索片段可以少读源文件,精确表格计算也可以读完整个源文件;两者都能只把少量结果交给模型。
还有一次容易被忽略的复利成本。设第 \(i\) 步新暴露内容为 \(e_i\),后续保留它的调用次数为 \(R_i\),论文用 \(C_{\mathrm{exposure}}=\sum_i |e_i|R_i\) 表示重放加权暴露。一次宽泛读取会在多轮里反复计费或占用上下文。不过,这个量只是逻辑重放,不是账单 token,也不是物理 prefill 工作量;prefix caching 能降低边际成本,却不会让保留内容消失。
2. 为什么不能只接检索或压缩
说到上下文优化,常见方案大致落在两端:一端在内容进入前做检索,另一端在内容进入后做压缩。SparseRead 选择的是更靠前的“内容准入控制”,同时把两端都变成可插拔能力。
| 路线 | 能解决什么 | 没解决的读取问题 |
|---|---|---|
| 长上下文、KV Cache 优化 | 降低长序列的计算或显存压力 | 不决定模型应该看源对象的哪部分 |
| Static RAG、Agentic RAG | 按查询定位相关段落,可迭代改查询 | 不天然提供跨对象的覆盖状态、暴露预算和全文回退契约 |
| ACON、观察遮蔽 | 压缩观察与历史,或移除较旧观察 | 重点在获取后的轨迹管理,不统一控制源对象如何准入 |
| SparseRead | 在读入前协调意图、证据获取、覆盖和预算 | 需要额外协议与 Reader 校准,并非所有任务都划算 |
实验里的观察遮蔽基线来自 The Complexity Trap,按固定位置策略保留最近十条观察并遮蔽更早内容;ACON 条件同时开启观察压缩和历史压缩,辅助模型调用也计入总 token 和耗时。这个成本口径挺实在,没有把压缩器自身的开销藏到表外。
Figure 4 是整套方法的动机浓缩版,也是我最喜欢的一张图。
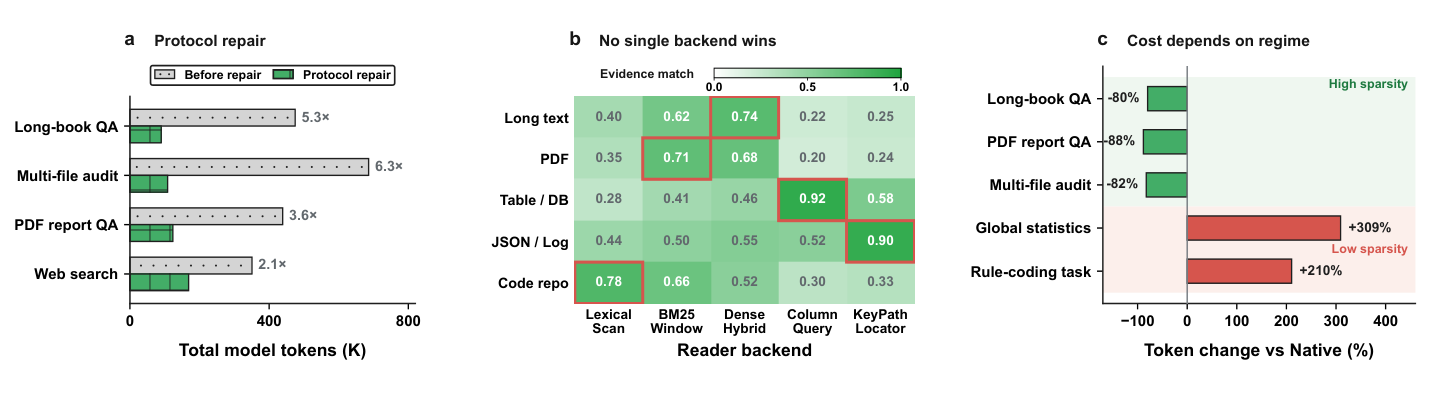
图4:a,协议修复把四类任务的总模型 token 降至原来的约 1/2.1 到 1/6.3;b,不同对象的最佳证据定位方法不同,长文本偏 Dense Hybrid,表格偏 Column Query,JSON/日志偏 KeyPath Locator;c,高稀疏任务节省 token,而全局统计和规则编码被强制稀疏读取后反而增加开销。
左图说明,没有“当前意图 + 已覆盖范围”的记录,Agent 会反复打开同一来源。中图说明,一个检索器打天下并不靠谱:Dense Hybrid 在长文本上的证据匹配为 0.74,Column Query 在表格上为 0.92,KeyPath Locator 在 JSON/日志上为 0.90,Lexical Scan 则在代码仓库上达到 0.78。
右图更重要。高稀疏任务里,稀疏阅读减少约 80%–88% token;到了全局统计和规则编码任务,强制稀疏读分别增加 309% 和 210%。先别急着把“少读”当成新银弹——需要全局视图时,零碎读取就是协议税。
所以,方法真正要回答的不是怎么把每段文本压短,而是三个连贯问题:当前到底要找什么?用哪种方式找最合适?继续局部读和直接看全文,哪个更便宜?
3. SparseRead:给外部内容加一层读取控制面
SparseRead 把系统分成控制面和证据面。控制面负责意图、状态、Reader 选择与预算;证据面负责具体对象上的定位、计算和暴露。Agent 面对的始终是同一份契约:
Read Intent 进入,EvidencePack 返回。
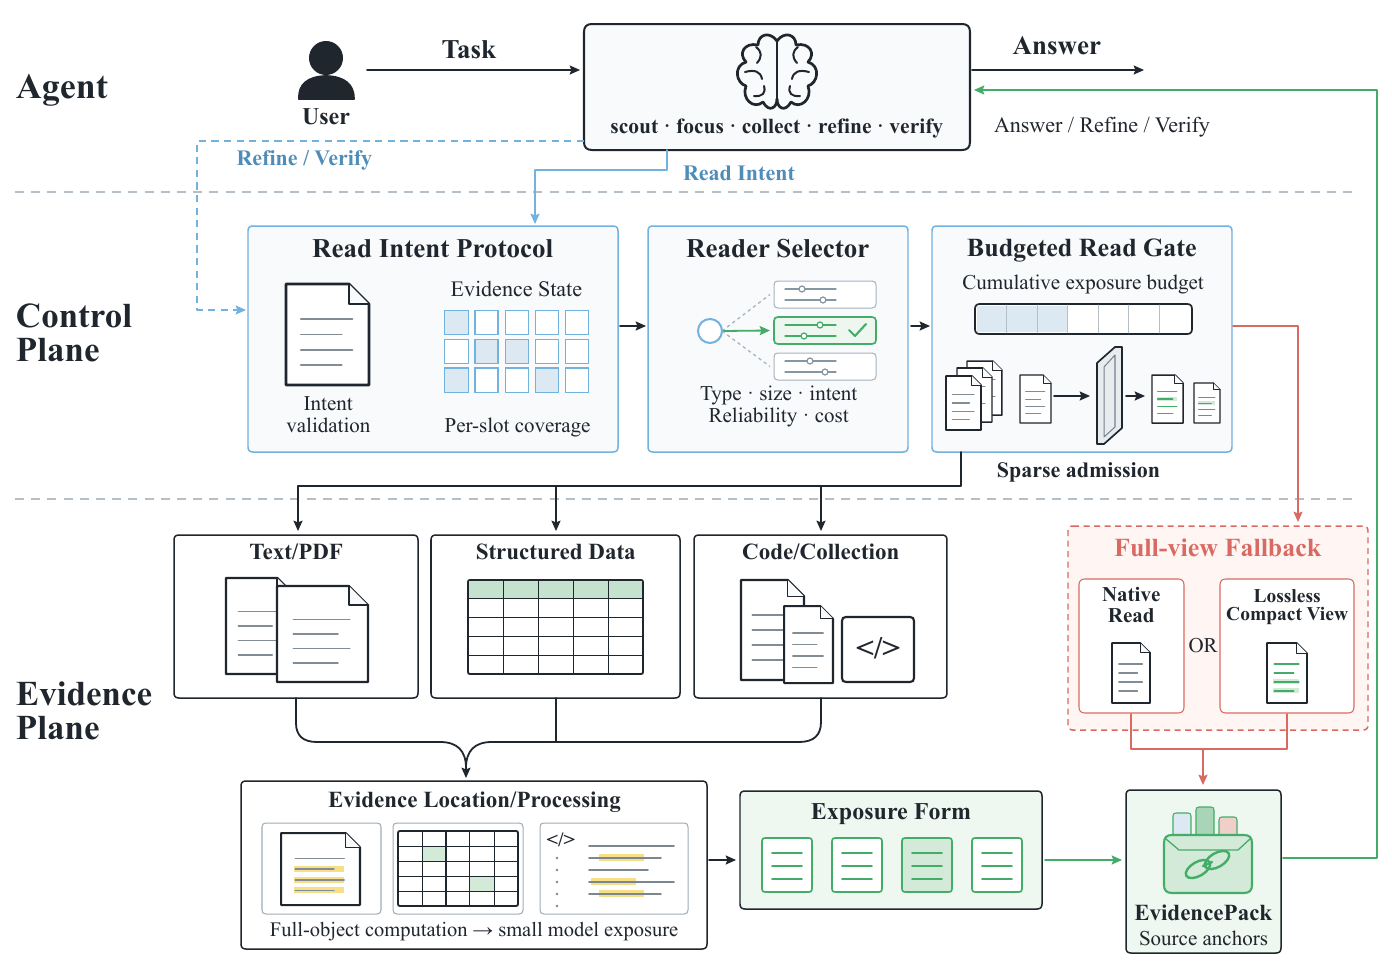
图5:Agent 通过 scout、focus、collect、refine、verify 五个动作发起读取。控制面完成意图校验、逐槽覆盖记录、Reader 选择和预算检查;证据面支持 Text/PDF、Structured Data、Code/Collection 等 Reader,并把带来源锚点的 EvidencePack 返回给 Agent。右侧 Full-view Fallback 可以是原生全文,也可以是满足当前访问需求的无损紧凑全视图。
3.1 Read Intent Protocol:把“我要找什么”变成可维护状态
每次访问可以带一个 access intent,描述下一步决策需要什么;会话开始时还有一个 session intent,来自用户最初目标。当前 access intent 优先,session intent 只补充未指定的背景,不能覆盖后来出现的子目标。
这个优先级设计很符合真实 Agent 轨迹。用户最初说“审计这个项目”,中途模型可能要验证“任务 X 为什么失败”,再后来只核对“配置项 Y 是否为空”。如果一直拿最初的宏大目标指导读取,每一步都会重新摊开整个工作区。
EvidencePack 不只装几段文本,还带来源锚点、已检查或处理的范围、实际暴露量,以及逐证据槽的覆盖情况。注意,覆盖不等于充分。 Reader 只报告哪些需求已有证据、哪些仍 unresolved;是否足够回答、要不要继续验证,仍由 Agent 决定。
五个稳定动作各司其职:
scout:先看对象预览,把模糊意图变具体;focus:把读取集中到当前相关区域;collect:获取带定位信息的证据;refine:沿未解决槽位继续补充;verify:针对已有证据做核查,而不是盲目重读。
协议还记录对象的 SHA-256 指纹。文件版本一旦变化,旧证据和覆盖记录就失效;版本没变时,旧片段仍然有效,但不一定覆盖新意图。这个细节很工程化:来源锚点只能证明“它从哪来”,不能证明“它和当前问题相关”,版本指纹也一样。
3.2 Adaptive Reader Backends:定位方法与暴露形式分开选
Reader 按对象能力注册,而不是按某个评测任务写死。文本/PDF 可以用 Lexical、BM25 Window 或 Dense Hybrid 定位;表格可以选列、做投影或执行精确计算;JSON/日志可以按 key path 查找;集合对象先建立文件清单,再挑候选文件。
更妙的是,怎么找证据和给模型看什么是两个独立选择。一个 Reader 配置 \(r\) 是“已注册 Reader + 定位或处理方法 + 暴露形式”的合法组合。输出可以是锚定片段、无损紧凑全视图,也可以是精确操作的结果与 provenance。
选择器不是单纯挑召回率最高的后端,而是在可靠性达标后挑成本最低者:
这里 \(g\) 是对象类型、大小区间和意图类型组成的请求组,\(\widehat{C}\) 估计证据暴露、Reader 执行和后续读取成本,\(\widehat{p}_{\mathrm{valid}}\) 是逐请求证据成功率的校准值。实现中取 \(\tau=0.6\),可靠性使用二项结果的 95% Wilson 区间下端;少于 20 个校准请求的组不做自适应选择,而是用该对象类型的默认配置,达不到阈值就回退全视图。
校准请求是独立手工设计的,不取自评测任务。评测阶段只更新成本估计,不重新校准可靠性。这套设计避免了直接拿测试题调 Reader,不过我也有一点保留:手工请求的分布能否覆盖真实产品里的奇怪文件和模糊意图,现有实验还回答不了。
3.3 Budgeted Read Gate:允许试错,但不允许无限零碎读
Gate 先定义当前请求可用的最低成本忠实全视图 \(f(o)\),其暴露长度为 \(L\);\(E\) 是本轮 reading episode 已接受的稀疏 payload 总量。两者在实现里统一按字符计,不用磁盘大小,也不混入重放加权 token。
需要模型检查完整内容、没有合适 Reader、或者对象很小时,直接走全视图或原生路径。其他情况先尝试稀疏读取,但每批证据交付前都要检查预算;序列化之后还按实际大小再查一次。下一批如果放不进去,就整批扣住,不截断证据、不破坏来源锚点,转而交付 \(f(o)\)。
简化后的控制逻辑大致是:
if requires_full_view or artifact_is_small or no_suitable_reader:
    return faithful_full_view()

batch = reader.collect(intent, evidence_state)
if serialized_size(batch) > L - E:
    retire_earlier_sparse_observations()
    return faithful_full_view_once()

E += serialized_size(batch)
return EvidencePack(batch, anchors, scope, coverage)
在固定对象版本、固定全视图,且 preview 与协议元数据单独有界的条件下,一个 episode 的原始对象暴露满足:
直觉很朴素:稀疏批次最多送进相当于一份全视图的内容,回退最多再送一份。回退后,早期稀疏观察会从后续 prompt 中退休,避免继续重放;已经花掉的成本当然不会退回来。
这个 2L 不是总 token 不超过原生方案两倍。 它只管单 episode 的累计、未加权原始对象暴露,不保证账单 token、延迟、跨多个 episode 的整个会话成本,更不保证相对“早已知道答案在哪里”的 oracle 读取。作者把这些边界写得清楚,省掉了很多过度解读。
4. 主实验:最高省 92.9%,但别只盯最大值
实验的主平台是 NanoBot v0.2.0,覆盖 Qwen3.6-Plus、DeepSeek-V4-Flash、DeepSeek-V4-Pro、GLM-5.1、Kimi-K2.5 和 Claude Opus 5。五类场景不是单一问答榜单,而是把长文档、工作区、多文件、结构化数据、深度搜索和科学脚本读取放在一起。
| 场景 | 任务来源与适配 | 主要阅读对象 |
|---|---|---|
| Long-context reading | LooGLE、PinchBench、Workspace-Bench-Lite 的相关任务 | 长文档、报告、事实抽取材料 |
| Multi-file audit and diagnosis | QwenClawBench 的跨文件审计与诊断任务 | 配置、日志、工作区文件 |
| Structured analysis | QwenClawBench 与 SpreadsheetBench Verified 的相关任务 | 表格、JSON、统计数据 |
| Web deep search | FRAMES、BrowseComp-Plus | 多文档搜索与证据综合 |
| AI for Science | MDGYM 的 LAMMPS 脚本生成相关任务 | 科学脚本库 |
BrowseComp-Plus 使用固定语料,不是不受限制的实时互联网;AI for Science 评的是脚本生成和读取行为,也没有复现 MDGYM 完整的仿真执行与物理验证。这两个边界会影响结果能外推多远。
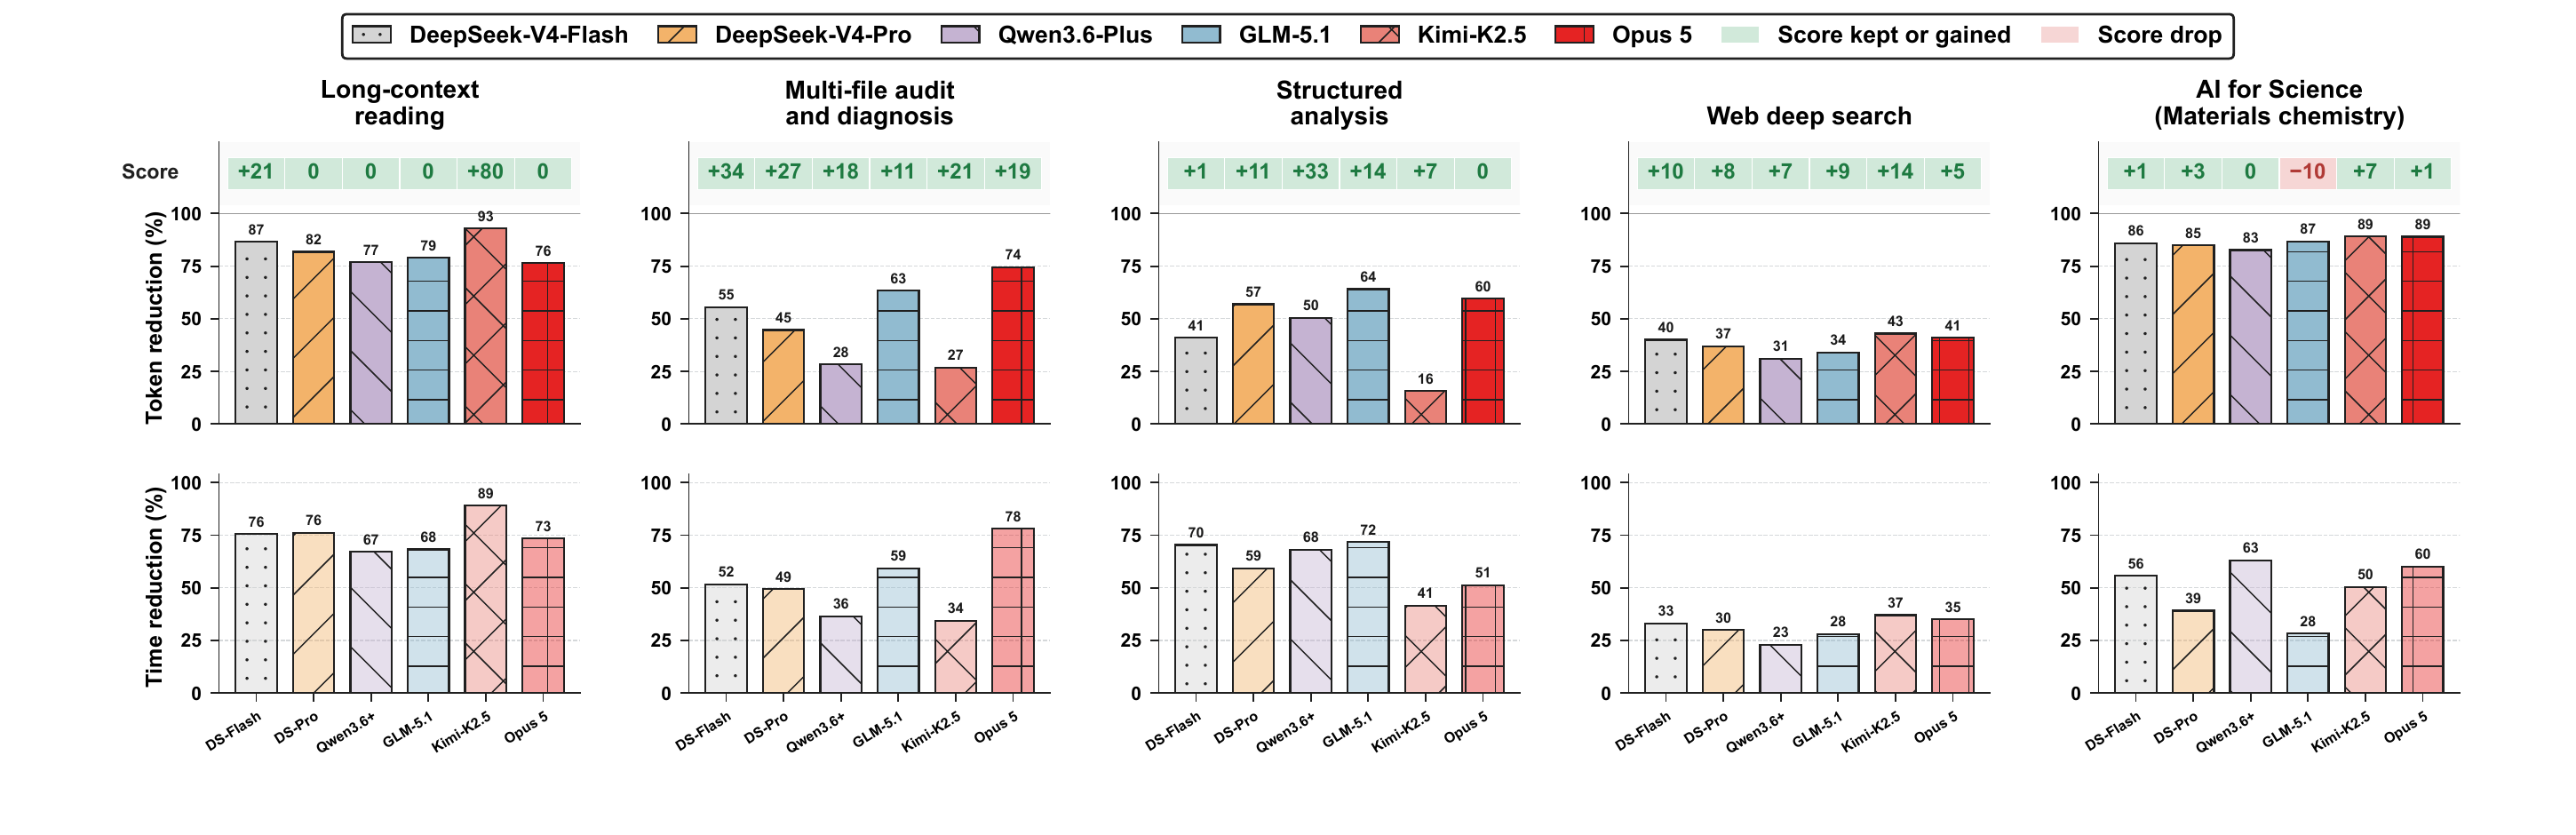
图6:上排是相对 Naive 的总 token 降幅,顶部标记任务分数变化;下排是端到端耗时降幅。柱越高代表成本越低。绿色分数条表示保持或提高,红色表示下降。
把正文里的精确范围整理出来,故事比一句“最多省 92.9%”更完整:
| 场景 | Token 降幅 | 耗时降幅 | 分数表现 |
|---|---|---|---|
| Long-context reading | 76.5%–92.9% | 67.1%–89.0% | 六个模型均保持或提高 |
| Multi-file audit and diagnosis | 26.8%–74.5% | 六个模型均下降 | 六个模型均保持或提高 |
| Structured analysis | 15.7%–64.1% | 六个模型均下降 | 六个模型均保持或提高 |
| Web deep search | 31.0%–43.0% | 23.0%–37.0% | 六个模型均提高 5–14 个百分点 |
| AI for Science | 82.7%–89.1% | 28.3%–63.0% | 五个模型保持或提高,GLM-5.1 下降 10 个百分点 |
30 个组合的总范围是 token 减少 15.7%–92.9%,耗时减少 23.0%–89.0%;更能代表整体水平的是中位数,分别为 61.4% 和 53.7%。29 个组合保持或提高分数,所以摘要写成约 97% 的设置,并不是 30 个全部成功。
我认为最有说服力的不是 Kimi-K2.5 那个 92.9% 极值,而是 Opus 5 也没有因为模型更强就失去收益:在五类场景中,它减少 41.0%–89.0% token 和 35.0%–78.1% 耗时。强模型依然会被无关观察拖慢,阅读控制不是弱模型专用的补丁。
不过,GLM-5.1 在 AI for Science 上掉了 10 个百分点。这个结果没有被藏掉,挺好。它也说明“证据变少后更聚焦”不是普适解释;某些科学脚本任务可能确实需要更宽的上下文,或者当前 Reader 对这类库的覆盖还不够稳。
和 RAG、ACON 正面对比,优势没有最大值那么夸张
Figure 7 选了三种场景、五个模型,共 15 个设置,比较 Naive、Static RAG、RAG Agent、ACON、Observation Masking 和 SparseRead。RAG 两端使用相同的 BGE-M3 检索与 BGE-Reranker-v2-M3 重排服务:512-token chunk、64-token overlap,先取 50 个 dense candidates,每次最多保留 8 个 chunk,序列化证据预算 4,096 token。RAG Agent 可以迭代改查询,并保留原生工具,不是被捆住手脚的一次性检索基线。
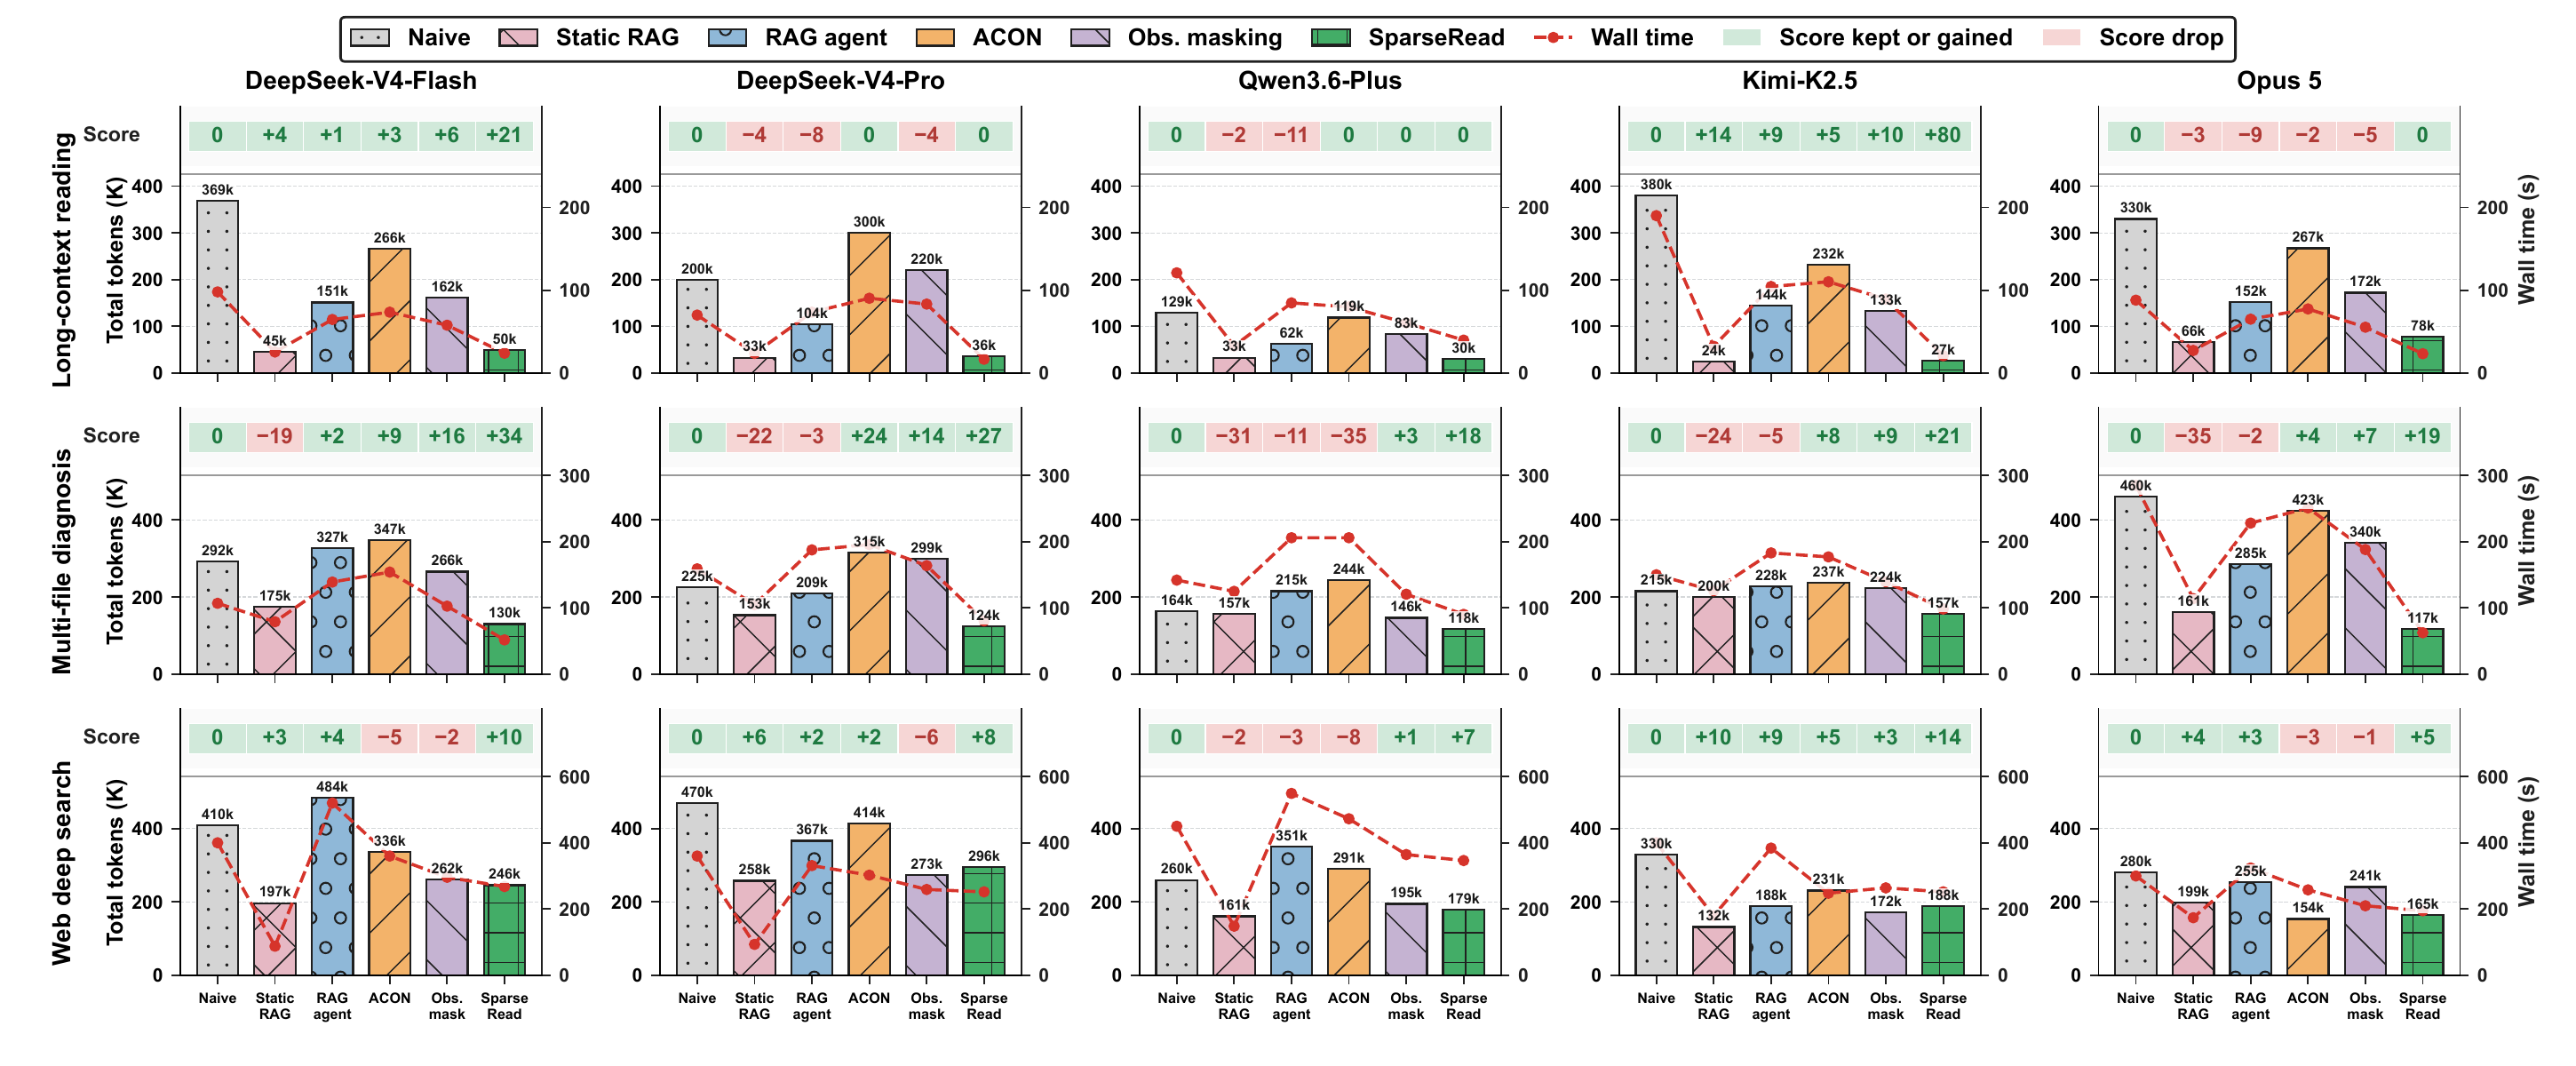
图7:三行依次是长上下文阅读、多文件诊断和 Web 深度搜索,五列对应五个模型。柱子表示总 token,红色虚线表示端到端耗时,顶部为分数变化。所有方法的检索、重排和辅助压缩调用都计入成本。
SparseRead 在 15 个设置里全部保持或提高分数,token 降低 27.0%–92.9%,耗时降低 23.0%–88.9%。它在 6 个设置里 token 最少,在 9 个设置里耗时最短;多文件诊断上,五个模型都同时拿到最低 token 和最低耗时,分数提高 17.8–34.5 个百分点。
这里得给作者一点掌声,也得把话说准确:SparseRead 并不是每一项都拿第一。 Static RAG 在五个 Web 设置里都更快,但它在 15 个设置中的 9 个分数低于 Naive;RAG Agent 有 8 个设置掉分,也有 8 个设置比 Naive 更慢。ACON 有 5 个设置掉分,6 个设置出现 token 和耗时双升;观察遮蔽同样有 5 个设置掉分。
所以,这张图的结论不是“检索不行”,而是单靠检索或事后压缩,未必能同时管住证据覆盖、重复访问和任务质量。SparseRead 的系统边界更完整,代价则是更多控制逻辑。
5. 消融实验:三个模块各自管什么
Figure 8 把协议、Reader 和 Gate 分别拆开,信息量很高。
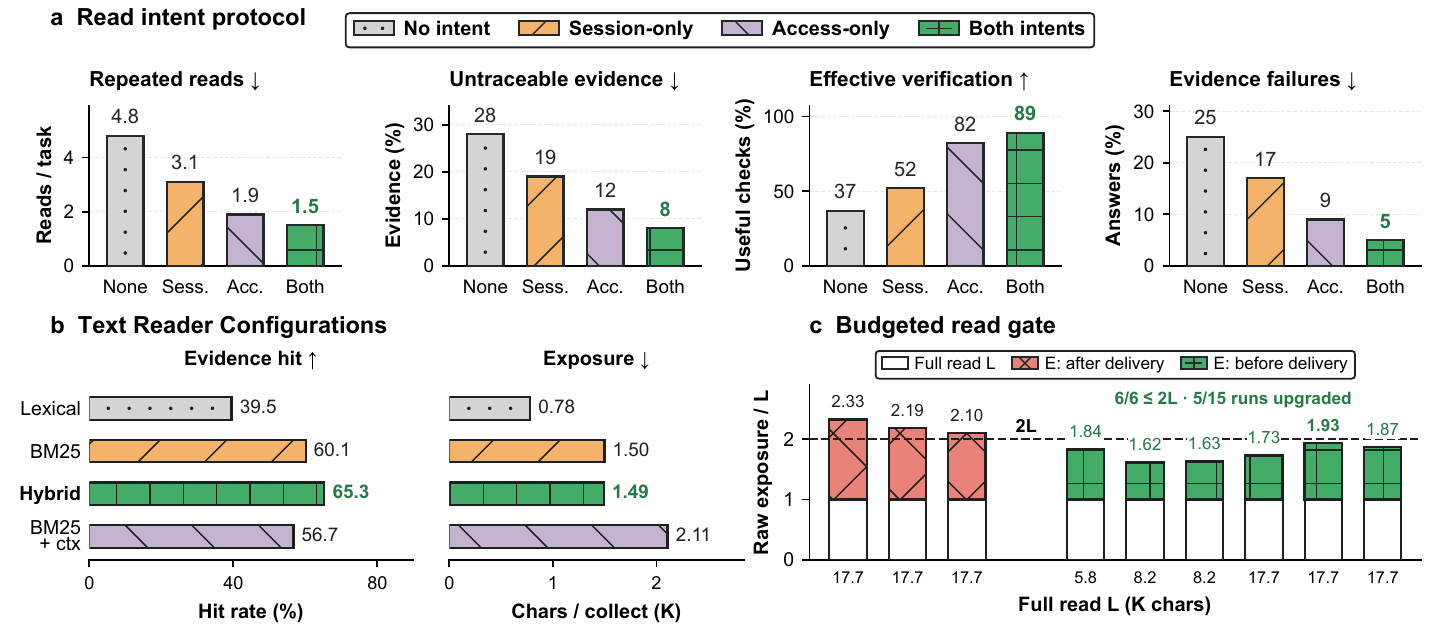
图8:a,不使用意图、只用 session、只用 access、两者共用时的阅读行为;b,47 篇 LooGLE 文档、741 个问题上的文本定位方法与暴露量;c,DeepSeek-V4-Flash 上,交付后检查和交付前检查对原始暴露上限的影响。
协议消融:access intent 是主力,session intent 做补充
| 诊断指标 | 无 intent | Session + Access | 变化 |
|---|---|---|---|
| 每任务重复读取 | 4.8 | 1.5 | 减少 68.8% |
| 无法追溯的证据 | 28% | 8% | 降 20 个百分点 |
| 能解决证据缺口的验证 | 37% | 89% | 升 52 个百分点 |
| 因缺证据而失败的答案 | 25% | 5% | 降 20 个百分点 |
只加 access intent 已经比只加 session intent 更好;两者组合又进一步把重复读取从 1.9 降到 1.5,把有效验证从 82% 提到 89%。这跟前面的设计直觉对上了:大目标提供方向,小目标决定此刻读什么。
Reader 消融:更大的窗口不等于更好的命中
实验把“至少覆盖 80% 标注证据”定义为一次 hit,暴露量取同一文档五个问题中每次 collect 返回字符数的中位数。
| 文本定位方法 | Evidence hit | 每次 collect 暴露字符 |
|---|---|---|
| Lexical | 39.5% | 780 |
| BM25 | 60.1% | 1,497 |
| Hybrid | 65.3% | 1,490 |
| BM25 + 扩展窗口 | 56.7% | 2,106 |
Hybrid 比 BM25 高 5.2 个百分点,暴露量几乎一样。扩展 BM25 窗口反而把命中率压低、把暴露量抬高,这个反例挺醒脑:上下文给得更多,相关证据反而可能被稀释。
但有一句限制必须保留——作者明确说,这组实验只比较定位配置,没有隔离自适应配置选择器相对固定配置的增量收益。它证明 Hybrid 在这套文本任务上更好,不等于已经证明整个自动选择算法优于最佳手工固定配置。
Gate 消融:先送出去再检查,上限就会被穿透
交付后检查的三个升级案例达到全视图的 2.10–2.33 倍,已经越过 2L;改成交付前检查后,六个暴露比例都落在 1.62–1.93 之间,全部守住 2L。两个队列各用五个任务、三次重复,前置检查组有 5/15 次运行触发升级。
附录里的 native-fit 控制也很有必要。面对 DiD 回归、SPARQL 生成、折扣计算这些不适合强行稀疏读的任务,无 Gate 的 forced sparse reading 分别增加 49.0%、309.0%、210.5% token;较早版本的 Gate 则分别节省 45.0%、22.5%、54.0%。这里验证的是准入策略的 token 经济性,而 Figure 8c 验证的是当前 Gate 的字符预算执行,两组实验不能混成同一件事。
6. 跨框架迁移:共享核心,框架只写薄适配层
SparseRead 还接入了 OpenCode v1.17.14 和 OpenClaw v2026.6.11。NanoBot 直接注册工具,另外两个框架通过 plugin 或 bridge 暴露 sro_preview、sro_read,并把本地 read/open 事件翻译到同一个核心运行时。协议、Reader、证据记录和 Gate 不重写,也不需要重训模型。
| 框架 | Token 降幅中位数 | 耗时降幅中位数 |
|---|---|---|
| NanoBot | 65.0% | 59.3% |
| OpenCode | 65.2% | 63.9% |
| OpenClaw | 30.6% | 28.8% |
18 个框架—模型设置的 token 和耗时全部下降,15 个保持或提高分数;三次分数下降的幅度为 0.013–0.031。Opus 5 在这组跨框架实验中减少 32.5%–58.6% token、29.4%–54.2% 耗时,分数提高 0.011–0.024。
OpenClaw 的收益中位数明显小一些,这反而让结果更可信。适配层能复用,不代表不同框架原有的读取策略、工具接口和任务组合会获得同样大的红利。这里的数字也不该和前面 NanoBot 五场景主表逐格硬比,实验矩阵不同。
7. 我的判断:这是阅读协议,不是又一个压缩器
坦率讲,SparseRead 最打动我的地方,是它没有把“稀疏阅读”写成永远正确的口号。作者先承认全文视图有时更合适,再把这种不确定性收进在线 Gate;不是先让所有任务都走一遍 RAG,然后只汇报赢的那部分。
它也不是一个全新的检索算法。BM25、混合检索、结构化查询、历史压缩、前缀缓存都已有大量工作,SparseRead 的位置在它们上面:把证据获取变成可声明、可追踪、可预算、可回退的基础设施。 按这个定位看,它更接近一次扎实的工程整合,而不是底层模型能力突破。
亮点很具体。Read Intent 与 EvidencePack 把“找什么”和“找到哪”分开;Reader 把处理范围和模型暴露分开;Gate 又把“后台可以全量计算”和“前台不必全量阅读”统一起来。三层拼在一起,才覆盖了从需求变化到成本失控的完整链条。
问题也同样具体。可靠性校准依赖手工请求组,少于 20 个样本就退回默认配置,冷启动和跨域稳定性仍需真实流量验证;Reader 选择器的独立收益没有被消融出来;2L 保证只覆盖原始字符暴露,不能直接当成账单或时延保证。回退时退休旧观察还会破坏从编辑点开始的精确 prefix 复用,缓存收益和重放控制之间需要重新权衡。
评测边界也不能省略。Web 搜索是固定语料,不是开放互联网;AI for Science 是 LAMMPS 脚本生成,不等于完成科学仿真并验证物理结果;30 个主设置里仍有一个掉分。SparseRead 展示了很好的广度,但还没有证明任何 Agent、任何工具、任何真实线上分布都适用。
如果要落到工程里,我会先做的不是实现全部五种动作,而是把三个指标打进日志:Reader 实际处理范围、模型实际暴露量、每个证据槽的覆盖状态。没有这三项,团队很容易只看到 token 降了,却不知道省的是无关内容,还是把关键证据也一起省掉。
接着可以挑长文档 QA、跨文件审计和结构化分析做试点,给小对象、全局统计和规则编码保留原生旁路。Reader 返回结果必须带版本指纹与来源锚点,回退必须幂等,不能重复交付全文。质量监控则按模型和任务分别看,别拿一个总平均值掩盖 GLM-5.1 那类局部回退。
这篇论文值得细读的原因,不是 92.9% 这个最大数字,而是它把 Agent 的“读”从一个被动工具返回值,变成了可以设计和治理的决策过程。 如果你正在做长程 Agent,这套抽象很可能比再换一个压缩器更有复用价值;如果你的任务本来就依赖完整视图,它也提醒你别为了省 token 把简单流程绕复杂。
参考资料
- SparseRead 论文摘要页:https://arxiv.org/abs/2608.22237
- SparseRead v2 HTML 正文:https://arxiv.org/html/2608.22237v2
- SparseRead 代码:https://github.com/Zedong-Liu/SparseReading
- The Complexity Trap(Observation Masking 基线):https://arxiv.org/abs/2508.21433
- SWE-Pruner(Agent 外部观察成本背景):https://arxiv.org/abs/2601.16746
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我