选对答案,不等于会做决策:MMDM 拆开了 28 个模型的真实短板
一个 Agent 面对 500 个可用工具,很快就能把某个“看起来合适”的工具排到第一位。这个画面挺美好,但真正上线时还有几道坎:它会不会漏掉另外三个同样可用的工具?会不会选中一个前置条件早已失效的方案?它给出 90% 的置信度时,究竟是真有九成把握,还是只是在嘴上很确定?
MMDM 这篇论文让我感兴趣的地方,就是它没有被“首选答案答对了”这个指标哄过去。作者把长上下文、大选项空间、多选完整性和概率质量放进同一套评测里,结果相当扎眼:28 个决策模型里,多选完整准确率最高只有 36.81%。
核心摘要
MMDM 是一套面向 System-1 决策模型的新基准,包含 5,448 道题、16 类任务,输入最长 64,817 tokens,选项最多 1,024 个。它用新构造、语义重组和带来源依据的改写减少原题复用,同时考察单选、多选和软标签分布。WeMM-JEV 27B 以 76.00% 拿到最高单选准确率,但多选榜首也只有 36.81%;Perplexity Decider-V1.2 的世界知识准确率为 78.75%,到约束规划只剩 47.95%。我觉得它不是训练方法上的底层突破,却是一套很扎实的诊断工具:专门揭穿“会选答案,却不会处理联合约束和概率”的假熟练。
论文信息
- 标题:MMDM: Measuring Massive Multitask Decision Making
- 作者:Junhao Shen、Qing Zong、Yue Guo、Zhanqiu Zhang、Yiwen Guo、Hong Cheng
- 提交日期:2026 年 11 月 10 日,v1
- 机构信息:arXiv 摘要页未集中列出,作者单位见论文正文脚注
- 论文链接:https://arxiv.org/abs/2611.14309
- 项目主页:https://mmdm-benchmark.github.io/
- 数据集:https://huggingface.co/datasets/shenjunhao/mmdm
- 评测工具:https://github.com/mmdm-benchmark/mmdm
不是聊天,而是一次前向传播给出选项概率
System-1 Decision Models 的输入不是一句开放式问题,而是状态 \(s\)、查询 \(q\) 和有序选项集合 \(\mathcal{O}\)。每个选项除了名称,还可以带一条适用条件。模型输出整张选项上的概率分布,不自回归地写推理过程,也不生成一段自然语言解释。
这个接口很像业务系统里的“决策头”:给定当前状态,从请求自带的候选里直接打分。选项数量不必固定在训练词表里,工具目录、审批动作、评分等级都能装进同一格式。
它跟普通聊天模型的差别,不只是少输出几段话。评测目标也变了。你不仅关心排名第一的选项对不对,还关心正确集合有没有整体压过错误集合,以及概率分布能不能直接拿去做阈值控制、期望评分和下游调度。
已有基准已经覆盖了不少判断任务,但论文在 Table 1 中把缺口摆得很清楚:
| 评测集 | 最大选项数 | 最大上下文 | 新实例 | 完整多选 | 软标签 | 评分任务 |
|---|---|---|---|---|---|---|
| JEVal | 255 | 82,678 | 否 | 否 | 否 | 是 |
| DecisionBench 1.0 | 255 | 35,435 | 否 | 否 | 否 | 是 |
| JevBench | 未披露 | 未披露 | 是 | 否 | 是 | 是 |
| DecideBench 1.1 | 6 | 229 | 是 | 否 | 否 | 否 |
| Jev Evaluation | 151 | 未披露 | 否 | 否 | 否 | 是 |
| ReflexBench 1.0 | 255 | 未披露 | 否 | 否 | 否 | 是 |
| MMDM | 1024 | 64817 | 是 | 是 | 是 | 是 |
这张表里的“新实例”不是把旧题换个模板,而是新写或语义重组后的题目;“完整多选”也不是让模型给一个多选字符串,而是仅凭每个选项的概率排序,检查所有正确选项是否都排在错误选项之前。
我认为这个设定很贴近真实工程。线上系统往往拿不到一段可供检查的推理链,只有一组分数。分数本身不可靠,后面再漂亮的工作流也只是把错误包装得更像样。
MMDM 怎么把“决策”拆成三类答案
MMDM 用统一接口装下三种答案语义。它们的差别不是输出格式,而是正确性的定义。
| 类型 | 题目要求 | 参考分布 | 典型场景 |
|---|---|---|---|
| Hard Single-select | 找到唯一正确项 | 全部概率集中在答案 \(y\) | 选择唯一满足条件的工具 |
| Hard Multi-select | 找全所有正确项 | 正确集合 \(G\) 内均分概率 | 找出当前请求下全部可用技能 |
| Soft-label | 匹配结果的不确定性 | 按真实结果概率分配 | 服务成功概率为 0.7、失败为 0.3 |
评分任务也套在这个框架里。确定的得分对应某个离散等级;不确定的得分则是一张等级分布。这个设计挺漂亮,因为“打 3 分还是 4 分”和“有三分之一概率打 3 分、三分之二概率打 4 分”终于不用被塞进同一个粗糙标签里。
多选的判分尤其严格:
最弱的正确项也必须强过最强的干扰项,漏一个、错一个、边界并列,整题都算错。请求失败也计错。这里没有“选对了其中 4 个,给你 80 分”的温柔处理。
但只看这个 0/1 指标,又会把概率排序的细微差别抹掉。因此作者加了 SB-F,把正确集合与错误集合的分离度、正确项之间的概率均衡度结合起来。另一个关键指标是 Soft Brier:
它检查整张分布离参考分布有多远。Score nMAE 则只看期望分数的归一化绝对误差。一个模型可能期望分数很接近,背后各等级的概率却分得一团糟——这两个指标必须一起看。
5,448 道题,难点不只是“数量大”
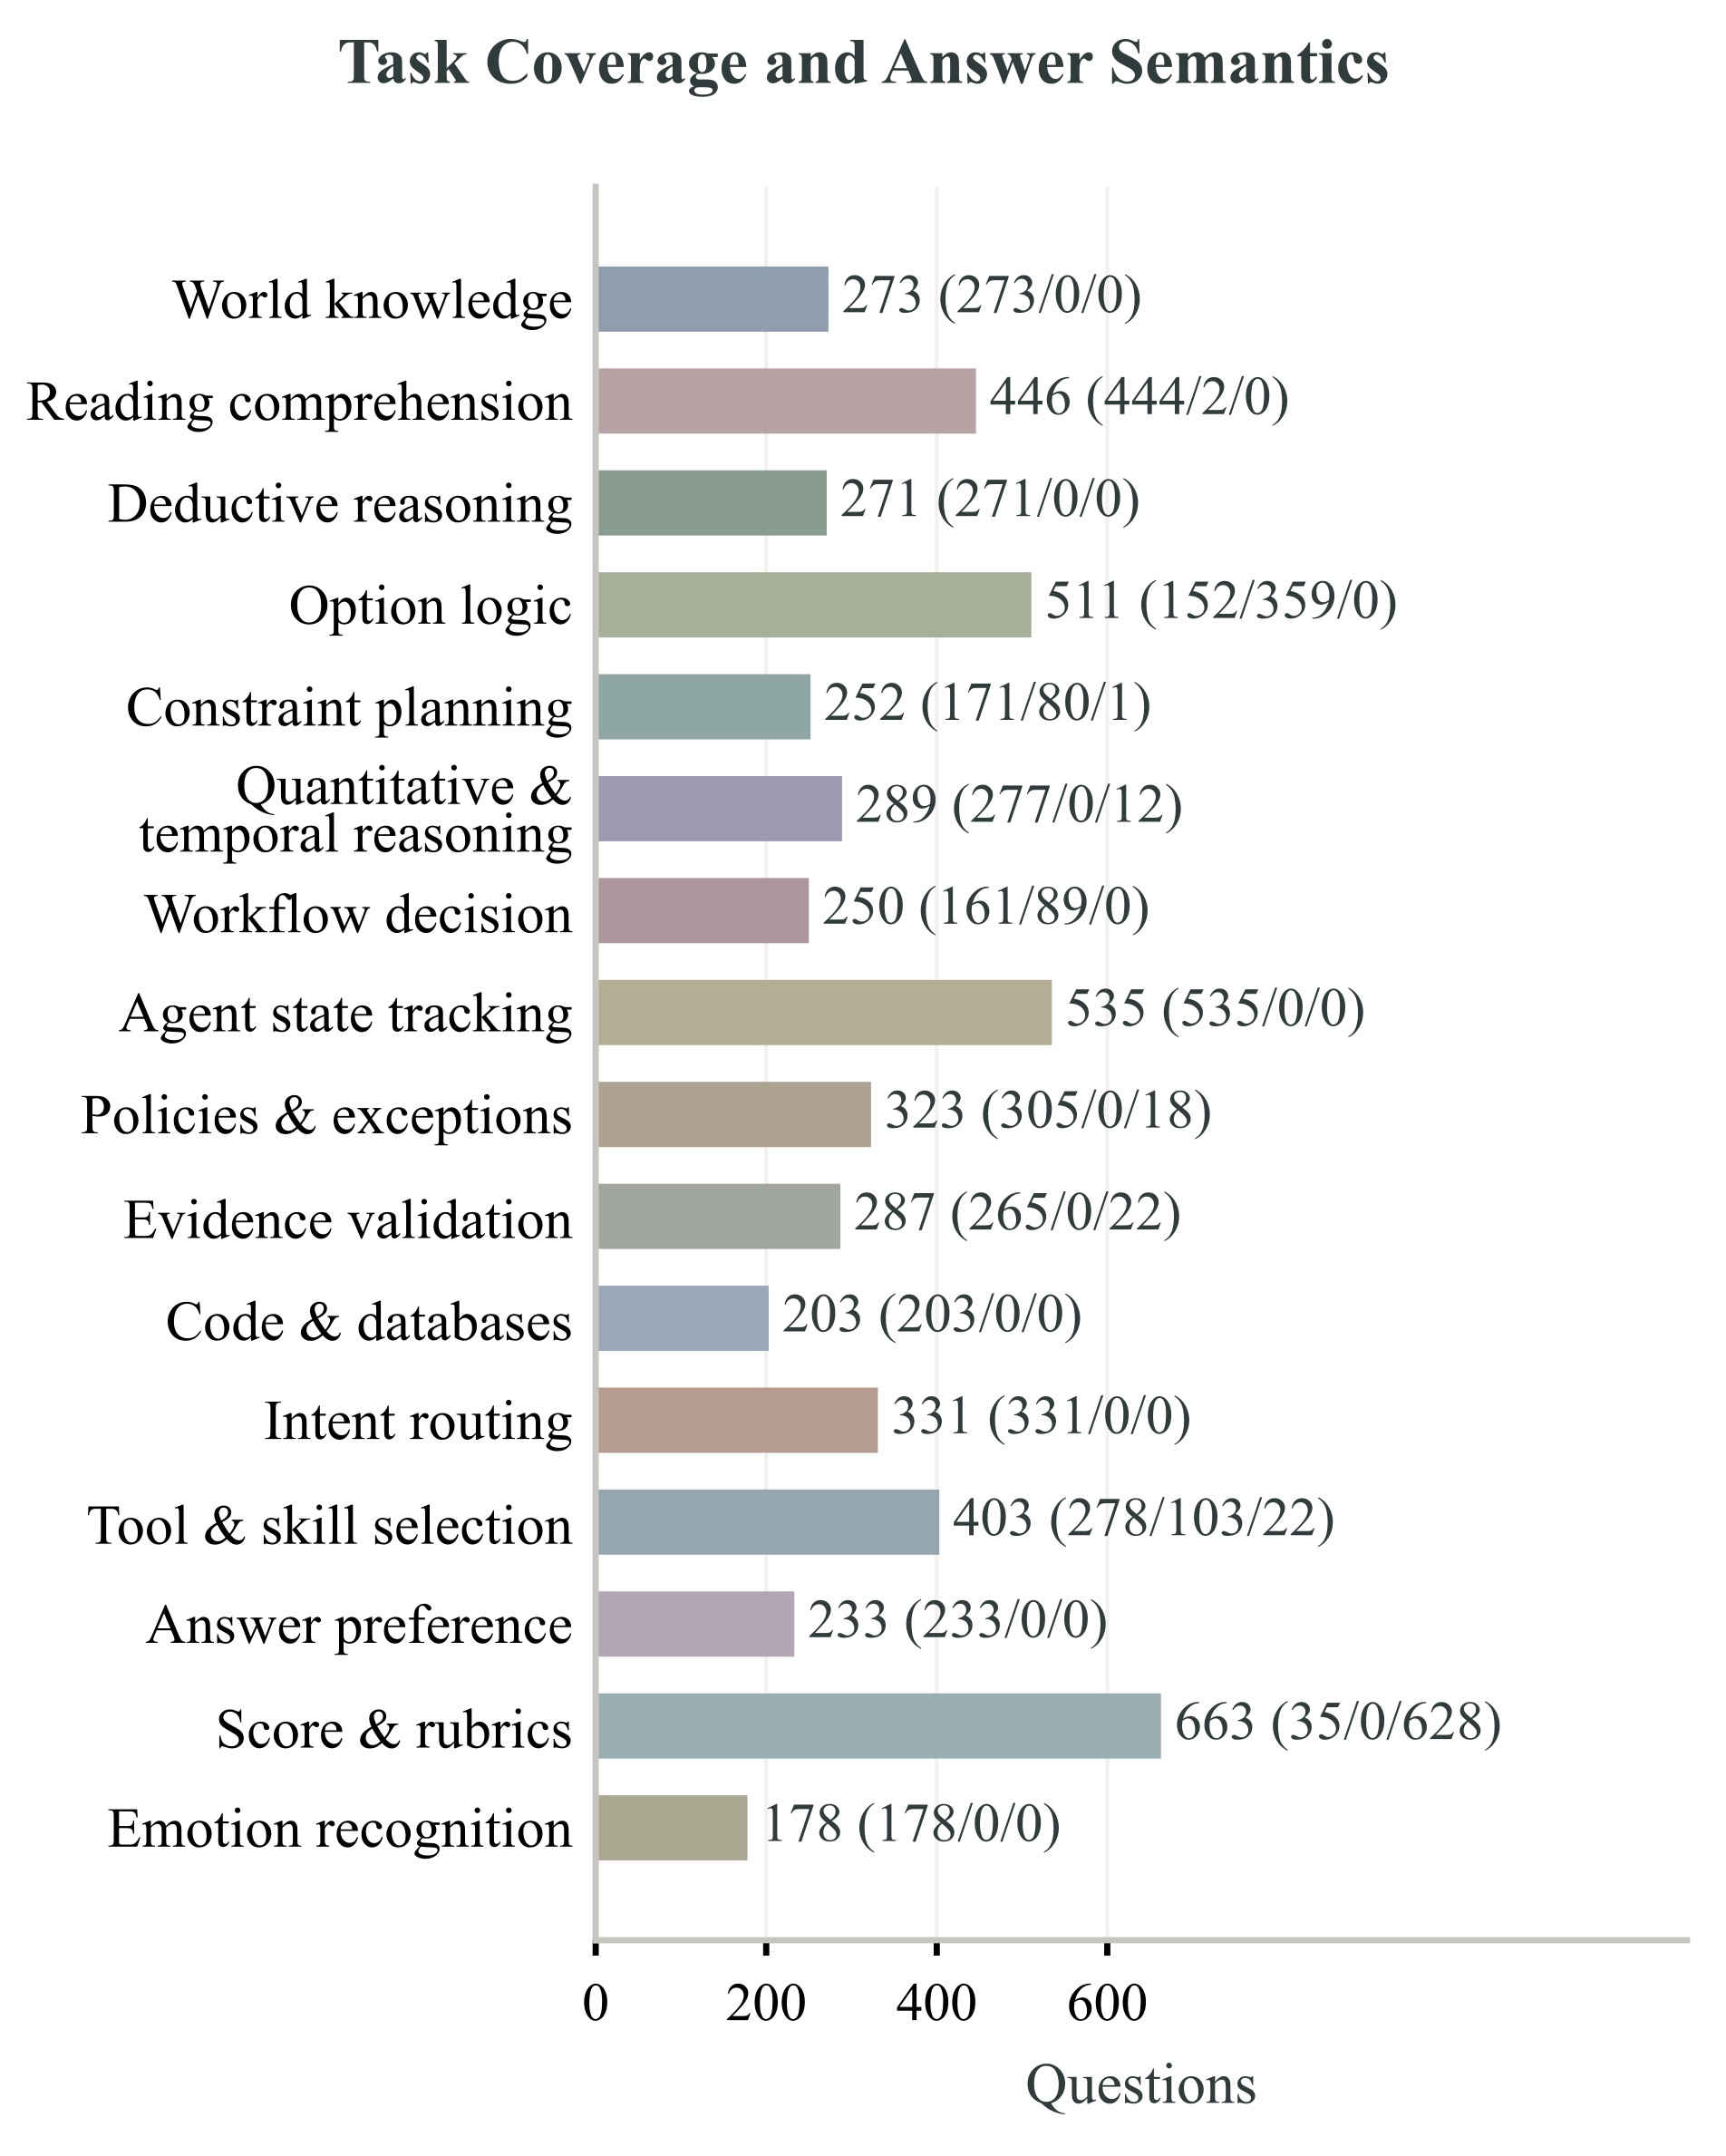
图2:16 类任务的题目数量,括号内依次是 Hard Single-select、Hard Multi-select、Soft-label 数量。Option Logic 有 511 题,其中 359 题是多选;Score & Rubrics 有 663 题,其中 628 题带软标签。多选和软标签并非均匀撒在所有类别里,这一点对解读总分很重要。
整套数据由 4,112 道单选、633 道多选和 703 道软标签题组成,覆盖 62 个注册来源标识和 80 个类别—子类别组合。16 类任务从世界知识、阅读理解一路延伸到 Agent 状态跟踪、工作流决策、工具与技能选择、答案偏好、评分规则和情绪识别。
作者用了三条构造路线。已有公开数据提供答案和证据,改写时重新组织状态、查询与干扰项;重组题则从数据库或 Agent 历史里生成新的决策要求;还有一批完全新构造的任务,用可执行机制生成选项依赖、约束计划、状态转移和评分结果。
干扰项不是随机凑数,而是瞄准具体错误:拿过期规则套当前状态、混淆实体、漏掉前置条件。质量控制也不只靠模型互评。作者先做五模型多数筛选,再让独立人工专家复核边界案例;另有 option-only 探针遮住状态和查询,发现只靠选项就能走捷径的题会被剔除。
说实话,这套流程比“把 MMLU 改个字段名”认真得多。但我也不会把它直接等同于彻底去污染。底层公开来源仍可能进入训练语料,作者自己也承认这一点。新语境能降低原题记忆带来的分数膨胀,却不能证明模型从未见过相关知识或材料;这种改写究竟能阻隔多少训练污染,单靠论文给出的流程我也无法定量判断。
长上下文与大选项空间,是两条不同的难度轴
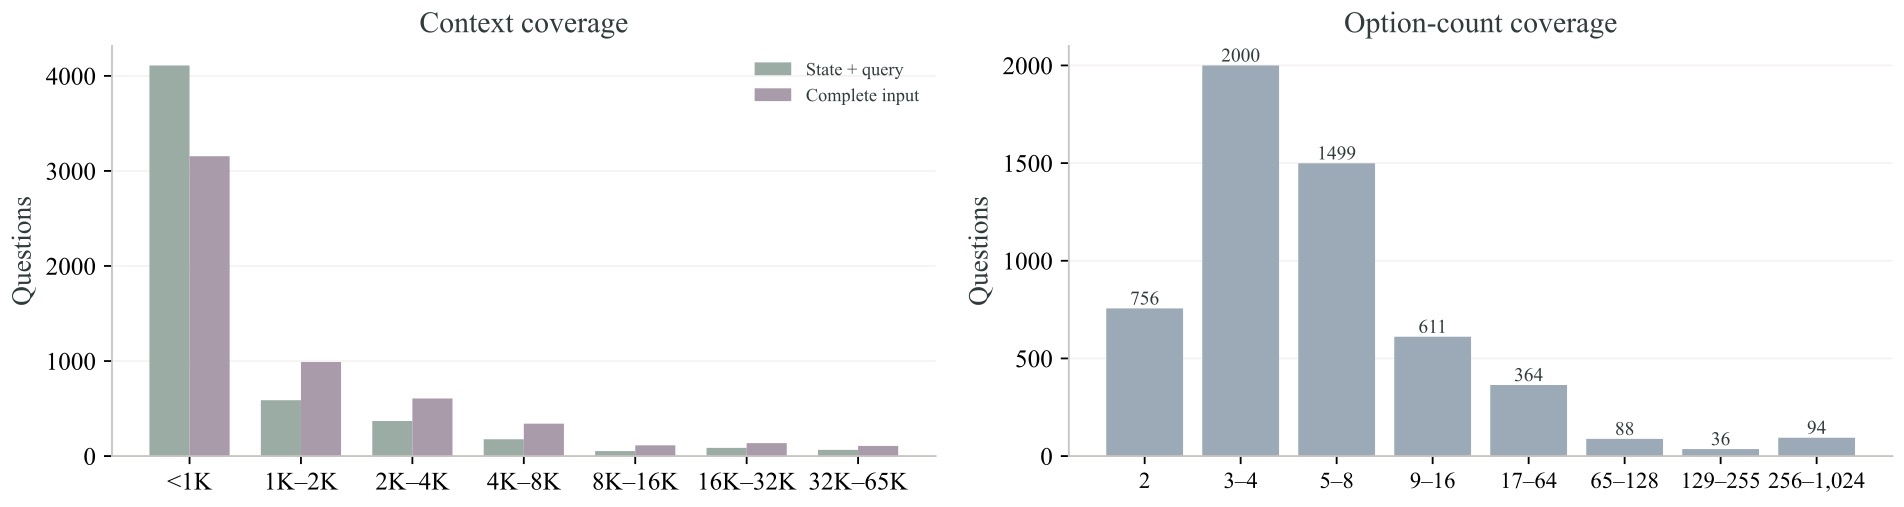
图A1:左面板同时展示 state+query 与完整输入的长度分布,右面板展示选项数量分布。多数题目不长,但长尾很实在:完整输入超过 8K tokens 的样本清晰可见;选项数达到 256–1,024 的题有 94 道。
完整输入包含状态、查询、选项名称和条件,统一用 Qwen3.5-4B tokenizer 统计。中位数只有 827 tokens,95 分位数却到了 13,318,最大值 64,817。选项从 2 个一直到 1,024 个。
这组统计提醒我们,不要只看中位数就判断基准“很简单”。真正麻烦的是尾部:长文档里的证据追踪,以及大目录里的逐项比较,是两种不同负载。一个模型擅长读长文,不代表它能在 500 个相似技能里保持排序稳定。
评测协议也尽量务实。上下文超预算时,保留查询、全部选项和条件,对状态做确定性的中段截断;独立选项超出模型上限时,分组评分,再递归保留高分候选。选项相互依赖或需要完整分布的任务不拆分,超过能力上限直接记容量失败。
这里有个值得皱眉的地方:不同模型的上下文窗口和选项上限不同,主表因此混合了原生处理、截断和分组归约。它更接近“按各自发布能力部署”的横评,不是严格控制的同输入实验。好在作者补充了 matched-cohort 分析,后面能看到结论是否仍然成立。
主结果:单选接近 76 分,多选仍然集体不及格
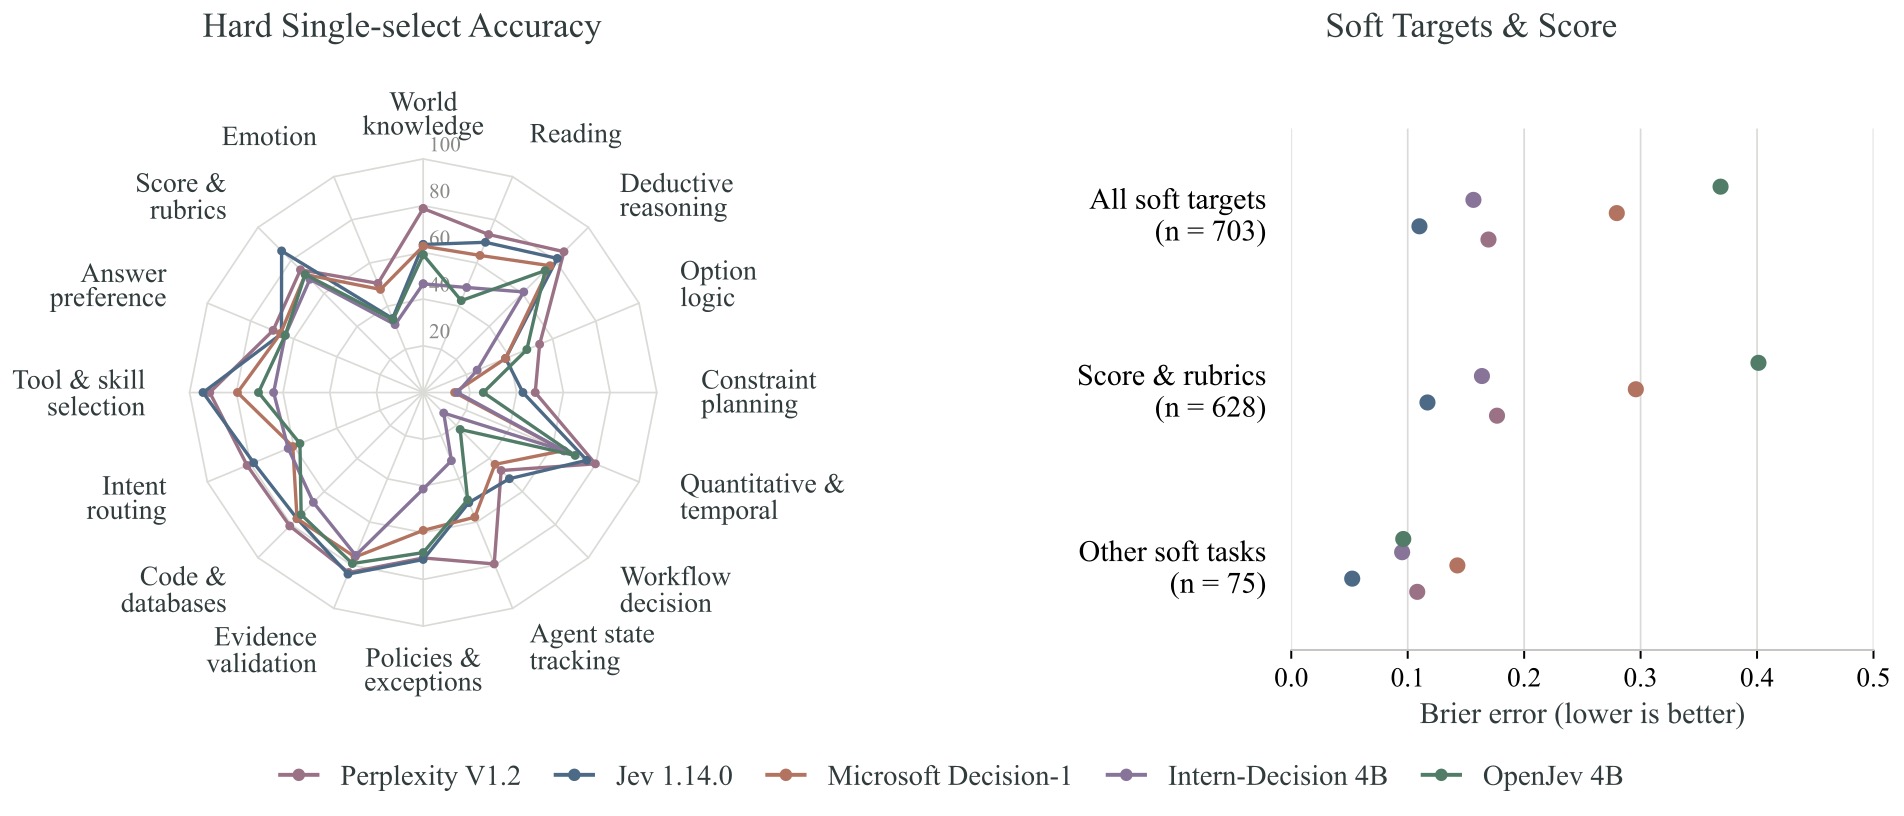
图1:左侧雷达图覆盖 16 类 Hard Single-select 能力,右侧比较 703 个软标签、628 个评分软标签和其余 75 个软任务的 Brier 误差。Perplexity、Jev、Microsoft、Intern-Decision、OpenJev 的曲线形状很不一样,单一总分无法概括这些差异。
Table 2 评测了 28 个决策模型。下面保留最有代表性的几行;准确率单位为百分数,SB-F 越高越好,Soft Brier 和 Score nMAE 越低越好。
| 模型 | 单选准确率 | 多选准确率 | SB-F | Soft Brier | Score nMAE |
|---|---|---|---|---|---|
| WeMM-JEV 27B | 76.00 | 36.81 | 0.1946 | 0.2327 | 0.2203 |
| KnowLine 31B Gen1 | 75.07 | 32.39 | 0.1777 | 0.1233 | 0.0624 |
| Perplexity Decider-V1.2 | 74.42 | 33.81 | 0.1907 | 0.1694 | 0.1641 |
| Liquid-d1-Ultra | 73.32 | 24.33 | 0.1624 | 0.1321 | 0.0883 |
| Jev 1.14.0 | 67.17 | 22.12 | 0.1187 | 0.1101 | 0.0926 |
| Microsoft Decision-1 | 61.36 | 21.96 | 0.1186 | 0.2795 | 0.1836 |
| OpenJev 4B | 57.20 | 17.38 | 0.1085 | 0.3687 | 0.3106 |
| Random uniform | 25.35 | 3.28 | 0.0000 | 0.2051 | 0.1624 |
76.00 和 36.81 摆在一起,反差已经足够大。更值得琢磨的是 WeMM-JEV 与 KnowLine:单选只差 0.93 个点,KnowLine 的 Soft Brier 却几乎只有前者一半,Score nMAE 更不到前者三分之一。
所以,选型时如果只按单选榜排序,很可能把一个“答案经常对、概率却不好用”的模型放进依赖置信度的系统里。Jev 的 Soft Brier 最低,KnowLine 的 Score nMAE 最低,也再次说明期望分数和完整概率分布不是同一件事。
多选更惨。所有模型的主表 SB-F 都低于 0.20。固定 284 道所有模型均有原生多选输出的共同题目后,最高 SB-F 也只有 WeMM-JEV 的 0.1905 和 Perplexity 的 0.1900。模型中位均衡度达到 0.862,分离度中位数却只有 0.113。
这句话翻译过来就是:模型在正确项之间分配概率还挺均匀,真正不会的是把正确项整体推到错误项前面。问题不在“分得均不均”,而在“分得对不对”。
知识题会做,联合约束为什么就掉链子
Table 3 把单选拆到 16 类任务后,论文最核心的冲突浮出来了。
| 模型 | 世界知识 | 演绎推理 | 选项逻辑 | 约束规划 | 工作流决策 | Agent 状态跟踪 |
|---|---|---|---|---|---|---|
| WeMM-JEV 27B | 81.0 | 86.3 | 57.9 | 47.4 | 49.1 | 83.0 |
| KnowLine 31B Gen1 | 71.4 | 86.0 | 54.6 | 48.5 | 65.8 | 81.1 |
| Perplexity Decider-V1.2 | 78.8 | 85.2 | 53.9 | 48.0 | 47.2 | 79.4 |
| Liquid-d1-Ultra | 75.1 | 82.3 | 38.8 | 47.4 | 60.2 | 74.2 |
| Jev 1.14.0 | 63.4 | 81.2 | 38.2 | 42.7 | 52.2 | 51.0 |
Perplexity 在摘要中的未取整数值更直观:世界知识 78.75%,选项逻辑 53.95%,约束规划 47.95%。知识题和演绎题的高分,并没有自动变成“同时满足多个条件”的能力。
这很符合工程直觉。单个选项看起来合理,不代表它与其他选项、历史动作和当前规则兼容。审批通过后再修改文件,单独看每一步都像正常操作,串起来却违反“最终版本必须重新审批”的约束。模型若只给每个选项做局部语义匹配,而不检查全局一致性,就会在这种题上露馅。
路由能力也不能外推成 Agent 决策能力。GPT-6 Luna Decisions 的 Intent Routing 高于 Jev 和 Microsoft Decision-1,但工具与技能选择、Agent 状态跟踪、工作流决策反而更弱。把用户请求分到正确意图,跟从当前状态里选出一个可执行动作,差的不是一点提示词,而是状态与前提条件的联合建模。
没有常规消融,作者用的是诊断拆解
MMDM 是基准论文,没有“去掉模块 A 再去掉模块 B”的训练消融。它提供的是另一组更贴近评测问题的拆解:共同样本、原生与分组推理、概率分离与均衡。
五个代表模型在 shared native、完整状态输入下比较时,Perplexity 的单选准确率为 76.66%,多选为 36.90%,仍然领先;Jev 的 Soft Brier 为 0.1101,依然最低。共同单选题上,Perplexity 比 Jev 高 7.93 个点,95% 置信区间为 6.41 到 9.44;共同软标签题上,Jev 的 Brier 低 0.0592,区间为 0.0515 到 0.0661。区间来自 2,000 次按 source-parent 分组的重采样。
这组补充很重要,因为它说明“选择准确率与概率质量不一致”并不只是不同模型输入处理不同造成的假象。
共同 284 道原生多选题的诊断更细。WeMM-JEV 有 88.7% 的题能把某个正确项排到第一,但完整集合准确率只有 38.7%,正确项覆盖率只有 64.7%。Jev 的对应数字是 63.7%、20.1% 和 38.2%。能认出一个正确项,离找全正确项还差很远。
即便完整集合排序成功,概率优势也经常很薄。WeMM-JEV 的 110 次完整成功中,有 43 次出现“最强错误项至少拿到最弱正确项一半概率”的情况;28 个模型的这一比例中位数为 45.6%。Accuracy 会把这些结果记成满分,SB-F 则继续追问:你真的把边界拉开了吗?
置信度也不能跨任务照搬
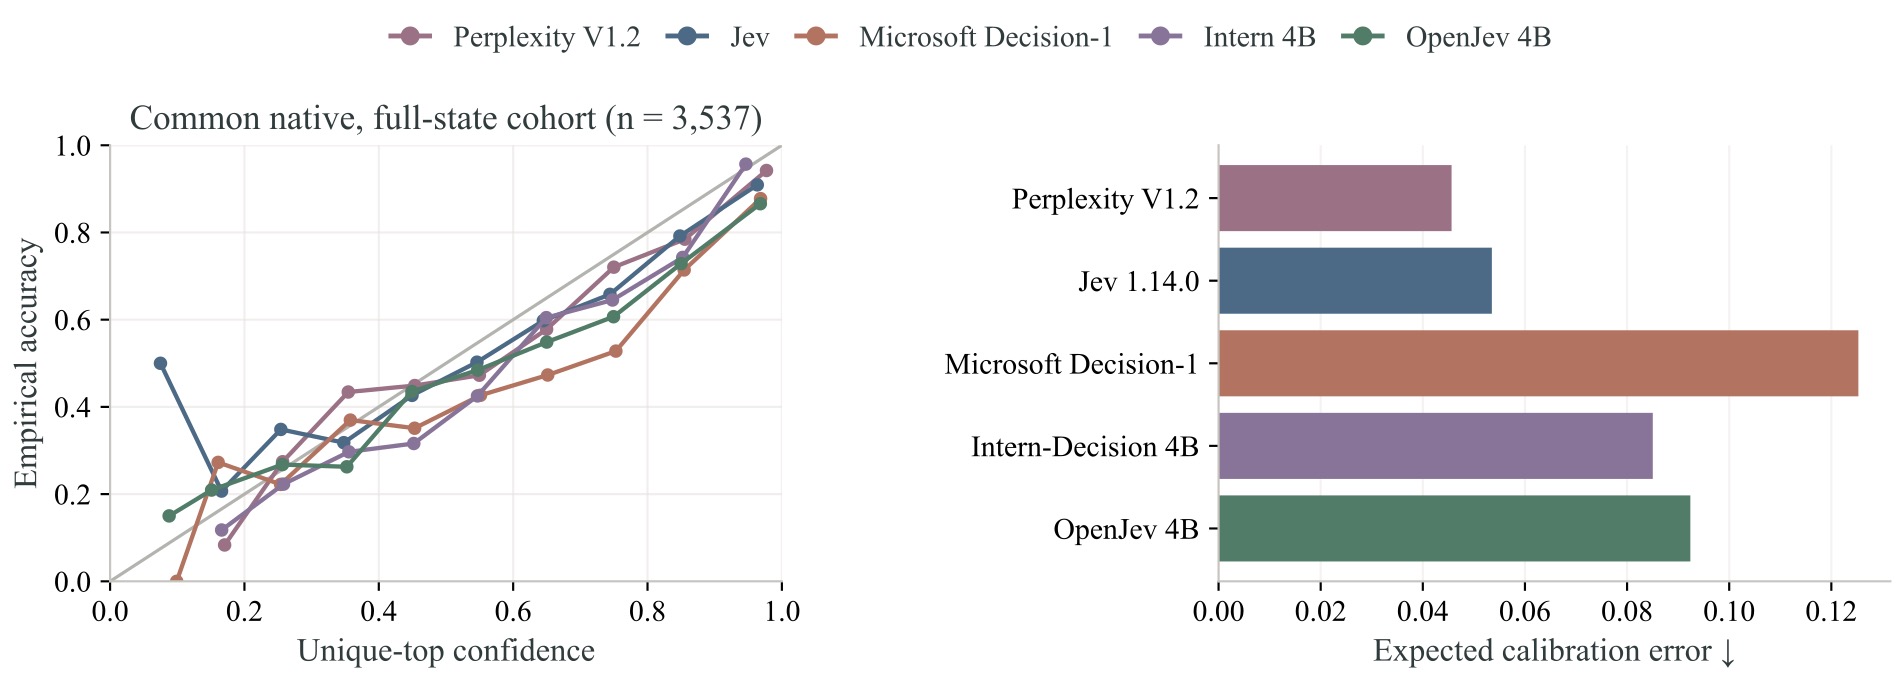
图3:左侧是在 3,537 道共同单选题上的十个置信度分箱,灰色对角线代表完美校准;对角线下方是过自信,上方是欠自信。右侧 ECE 越低越好,Perplexity 和 Jev 最低,Microsoft Decision-1 最高。
OpenJev 的总体单选准确率高于 Intern-Decision,ECE 却更大。它最高置信度分箱的平均置信度约 0.97,实际准确率约 0.87。看起来只差 10 个点,一旦系统拿 0.95 当自动执行阈值,这个差距就直接变成风险敞口。
更麻烦的是,同一个阈值在不同任务上的含义会变。Jev 对检索策略和上下文情绪判断的平均置信度分别约为 0.969 和 0.968,几乎一样;准确率却分别是 97.6% 和 50.0%。OpenJev 的 55 个高置信 SQL 预测全部正确,高置信情绪预测的准确率只有 63.2%。
按任务分别计算 ECE 再按题量加权后,Jev 从 0.054 升到 0.106,Intern-Decision 从 0.085 升到 0.110,OpenJev 从 0.092 升到 0.116。全局校准会把不同任务里的过自信和欠自信互相抵消,看起来比实际更稳。
我的判断很直接:生产系统不要只设一个全局置信度阈值。至少按任务族分别校准,工具选择、情绪识别、评分判断不该共用一把尺子。
输入变长与选项变多,模型排名会反转
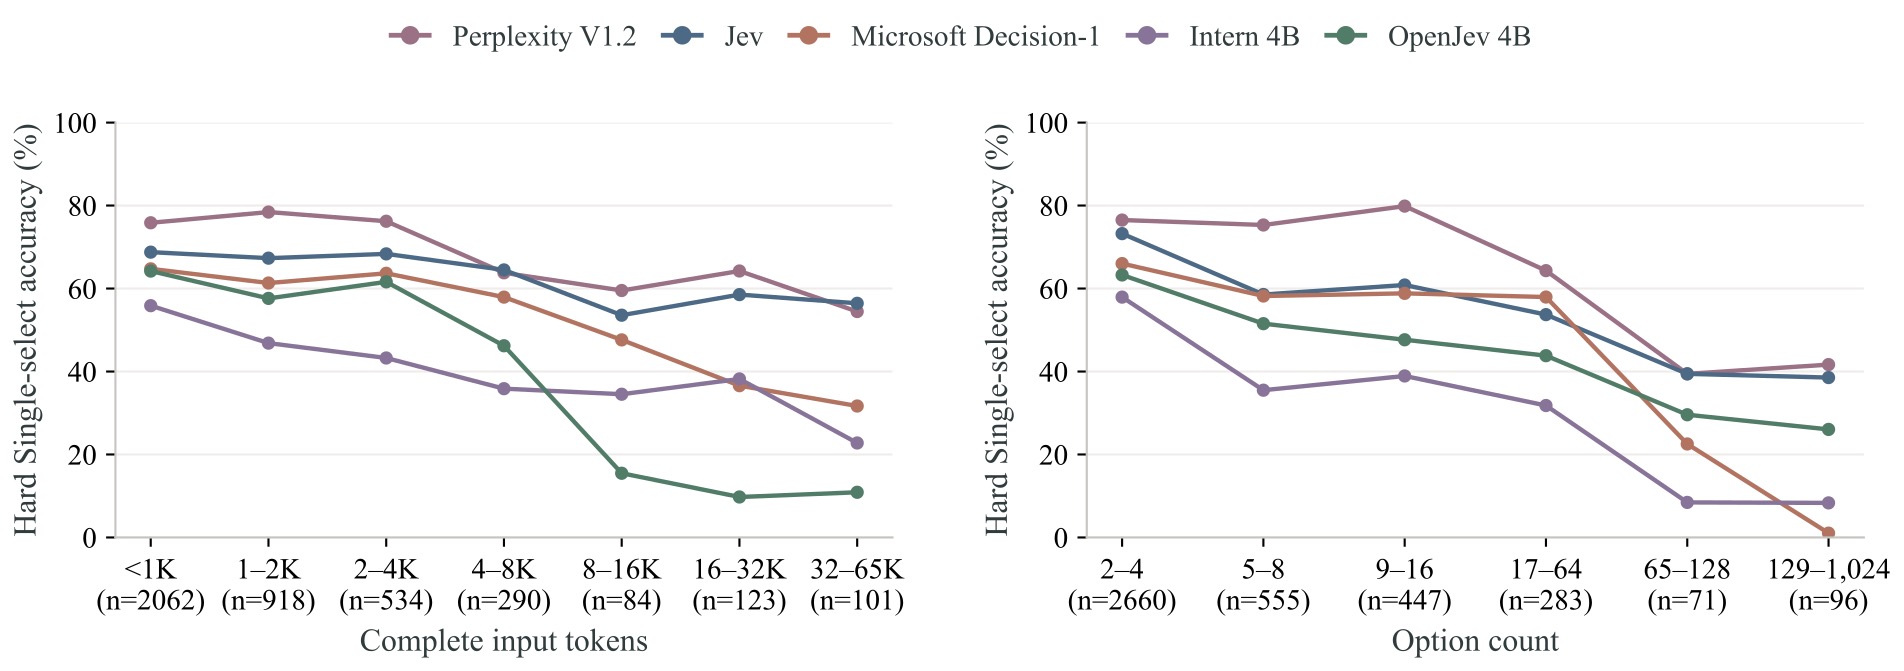
图4:左面板按完整输入长度分箱,右面板按选项数量分箱,括号为各箱题数。OpenJev 在长输入段快速下滑,但在大选项段始终高于 Intern-Decision;Perplexity 在最大选项箱保持最高准确率。
OpenJev 与 Intern-Decision 的反转很典型。8K–16K tokens 上,两者准确率分别是 15.5% 和 34.5%;到了 129–1,024 个选项,数字变成 26.0% 和 8.3%。长上下文能力与大选项能力不能互相代言。
Jev 和 Microsoft Decision-1 在 2–4 个选项时只差约 7 个点,到 129–1,024 个选项时差距超过 37 个点。小目录上的“差不多”,放大到真实工具仓库后可能完全不是一回事。
不过,别把图4直接读成严格的因果曲线。每个长度箱、选项箱保留了原来的任务构成,不同模型还保留各自的截断和分组策略。它展示的是这些部署条件下的表现,不是同一批题只改变一个变量后的受控缩放实验。作者把这一点写在图注里,这个克制我觉得很必要。
附录里的同条件切片更有说服力。512 个选项的技能选择中,Perplexity 和 Jev 都达到 91.7%;同样 512 个选项的约束计划题,两者只有 40.9% 和 18.2%。大目录本身不是唯一难点,题目到底要求“找一个可用技能”还是“验证一整套约束”,差别巨大。
三个案例,比总分更能说明模型怎么错
论文 Figure 5 用 HTML 排版展示保存的模型响应,没有独立位图。我把关键内容整理成下表,不用整页 PDF 截图代替原图。
| 案例 | 明确规则 | 模型表现 | 暴露的问题 |
|---|---|---|---|
| 审批后继续编辑 | 发布必须匹配最终版本的审批 | Perplexity 选择“先审批再编辑”的无效流程,Jev 与 Microsoft 选择正确顺序 | 没把后续动作对前置审批的失效影响串起来 |
| 八份相互引用的报告 | 唯一一致 assignment 中 Hazel 为假,其余七份为真 | 三个模型都把 Hazel 排在至少一个真报告之前 | 局部看似合理,联合一致性排序失败 |
| 九条记录抽三条评分 | 八条完整、一条缺审核章,低分概率应为 \(3/9\) | 这里只列 Score 3/4、省略 0–2 级:参考为 0.333/0.667;Perplexity 为 0.649/0.331,Jev 为 0.590/0.310,Microsoft 为 0.191/0.754 | 两个模型反转主概率,另一个方向对但分布仍不准 |
第三个案例尤其让我停了一下。抽到有缺陷记录的概率就是 \(3/9\),规则没有藏着掖着,模型却仍会颠倒 3 分和 4 分的主次。这里不需要长链推理,也不需要外部知识,错的是把简单随机事件映射成分数分布这一步。
所以 MMDM 抓到的不是单一的“推理不够长”。有些失败恰恰发生在规则很短、答案完全可计算的时候。继续堆推理 token,未必是这类 System-1 模型唯一的解药。
我对这套基准的判断
最值钱的地方不是 5,448 这个数字,而是评测目标终于对齐了决策系统的几种真实失败:漏选、约束冲突、概率失真、置信度误用。尤其是把 Hard Multi-select 与 SB-F 放在一起,既能看集合有没有找全,也能看概率边界是否可靠。
第二个优点是作者没有把主表当成全部故事。共同输入队列、任务切片、置信度分任务校准、原生与分组推理,这些补充实验把不少“榜单差异可能只是协议差异”的疑问追了下去。对基准论文来说,这比多放几个模型 logo 有用得多。
问题也同样清楚。多选主要集中在选项逻辑、约束规划、工作流和工具技能选择,软标签大多来自评分任务,其他主观判断的覆盖还弱。数据改写不能彻底排除来源材料曝光。纯文本、固定状态和固定选项的设定,也没有覆盖多模态输入与交互式轨迹。
还有一点不能越界解读:这里比较的是 28 个 System-1 决策模型,并不证明它们在一切任务上优于或劣于自回归通用大模型。没有相应对照,就不能借这张榜替“小决策头必然取代通用模型”站台。
如果你要把决策模型放进真实系统
选型时先按负载切片,不要从 ALL 一栏直接下单。长文档看长输入段,大工具目录看大选项段,工作流则单独检查前置条件和状态跟踪。总分高 1 个点,可能远不如目标类别高 10 个点重要。
多选业务不要只监控 top-1。至少同时看完整集合准确率、正确项覆盖率和最强错误项与最弱正确项的概率间隔。模型已经能找到一个正确工具时,下一步收益很可能来自集合目标与分离训练,而不是继续优化单选损失。
用到概率的地方,要把“答案正确”和“分布可信”拆成两套验收。期望评分准,不代表各分数档的概率准;全局 ECE 低,也不代表每个任务都能共用一个自动执行阈值。
说到底,MMDM 给我的最大启发是:决策模型不能只在“最好答案是什么”上考试,还得回答“还有哪些答案成立、这些分数能不能信、所有条件是否同时满足”。这套基准没有解决模型能力问题,但它把问题指得足够准。对正在做 Agent 路由、工具选择或自动评分的人,这份榜单值得按任务切片认真读一遍,而不是只看榜首。
参考资料
- Shen, J. et al. MMDM: Measuring Massive Multitask Decision Making,arXiv:2611.14309,2026。https://arxiv.org/abs/2611.14309
- MMDM 项目与榜单:https://mmdm-benchmark.github.io/
- MMDM 数据集与评测工具:https://huggingface.co/datasets/shenjunhao/mmdm ,https://github.com/mmdm-benchmark/mmdm
- Guo, C. et al. On Calibration of Modern Neural Networks,2017。论文用于解释 ECE 的背景来源,MMDM 采用十个等宽置信度分箱。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我