不写思维链,450 个 Agent 直接交换 KV Cache:SwarmEvolve 把一小时搜索压到几分钟
让 AI 自动改进一个数学构造或 PDE 求解器,最耗时的环节可能不是运行程序,而是模型在每次改代码之前写下的长篇“思考过程”。一个候选程序要配一段文本推理;为了维持多样性,还要反复生成几十、几百次。GPU 忙着输出 token,真正接受评估的新程序却没有多少。
SwarmEvolve 抓住的就是这个瓶颈。它让每轮 450 个智能体只在连续隐空间里推理,不把中间想法解码成文字;群体内部再直接传递 KV cache,由总结智能体写出最终程序。这个设计把“思考”和“交流”从文本通道搬到了模型内部。
核心摘要:SwarmEvolve 面向数学发现与科学计算中的程序进化搜索,用 10 个群体、每群 45 个隐空间智能体替代少量文本智能体,并以隐藏状态距离筛选新颖性、以 KV cache 拼接完成思想交叉。在 21 个任务上,它的每小时程序评估量达到文本框架的 5 至 13 倍;达到基线 60 分钟最佳分数所需的中位时间只有 3 至 8 分钟。Qwen3 8B 配置还在三个任务上越过 AlphaEvolve 已发表的构造。我的判断是:这不是新的隐空间推理算法,而是一次很漂亮的系统组合——把 LatentMAS 的隐空间协作、进化搜索和群体多样性筛选接成了一条高吞吐流水线。
论文信息
- 标题:SwarmEvolve: Latent Agent Swarms for Evolutionary Discovery and Optimization
- 作者:Qile Jiang、George Em Karniadakis
- 机构:布朗大学应用数学系(Division of Applied Mathematics, Brown University)
- 提交时间:2026 年 11 月 5 日
- arXiv:2611.08483
- 项目地址:Qile-J/SwarmEvolve
为什么文本会成为进化搜索的堵点
把科学问题转成“搜索一个好程序”,并不算新思路。FunSearch、AlphaEvolve 以及后来的 OpenEvolve、ShinkaEvolve、CodeEvolve,都在做类似的事:从程序档案库挑父代,让 LLM 修改或重组,运行评估器,再把高分后代写回档案库。
这条链路真正昂贵的地方藏在生成端。模型通常先写几千个 token 的文本推理,再输出代码;多个智能体协作时,还要把这些文字重新塞给下一个模型。推理越来越长,上下文越来越鼓,生成速度却越来越慢。更麻烦的是,搜索需要多样性,同一个父代不能只问一次,于是长文本又被重复生产。
SwarmEvolve 问了一个很直接的问题:如果中间推理不必给人看,为什么一定要经过文字?
它的答案不是简单地把思维链截短,而是换掉通信介质。智能体内部用隐藏状态连续推演,智能体之间交换 KV cache,只有最终可执行程序恢复成文本。你可以把它理解成一组研究者在脑内并行探索,最终只由一个人把综合后的方案写下来;当然,这里的“脑内”对应的是模型向量,不应当按字面理解成人类思维。
| 框架路线 | 中间推理与通信 | 搜索组织方式 | 主要瓶颈或特点 |
|---|---|---|---|
| FunSearch / AlphaEvolve 系列 | 文本提示与程序生成 | 岛屿、档案库、变异与交叉 | 搜索能力强,但文本生成成本高 |
| OpenEvolve / ShinkaEvolve / CodeEvolve | 文本推理,部分框架另有代码嵌入或 LLM 判重 | 开源进化框架,采用默认或自适应策略 | 候选程序质量依赖长上下文和模型调用 |
| LatentMAS | 隐空间推理,传递 KV cache | 多智能体协作,本身不是进化搜索系统 | 省去中间文本编解码 |
| SwarmEvolve | 隐空间推理与 KV cache 通信 | 每轮 450 个智能体,加进化档案库与新颖性筛选 | 把隐空间协作扩成高吞吐程序搜索 |
这张关系表很重要。SwarmEvolve 的底层隐空间推理与通信直接建立在 LatentMAS 之上,真正新增的是面向进化搜索的群体编排、隐藏状态新颖性过滤,以及支撑大规模并行的一整套工程实现。
一轮搜索究竟发生了什么
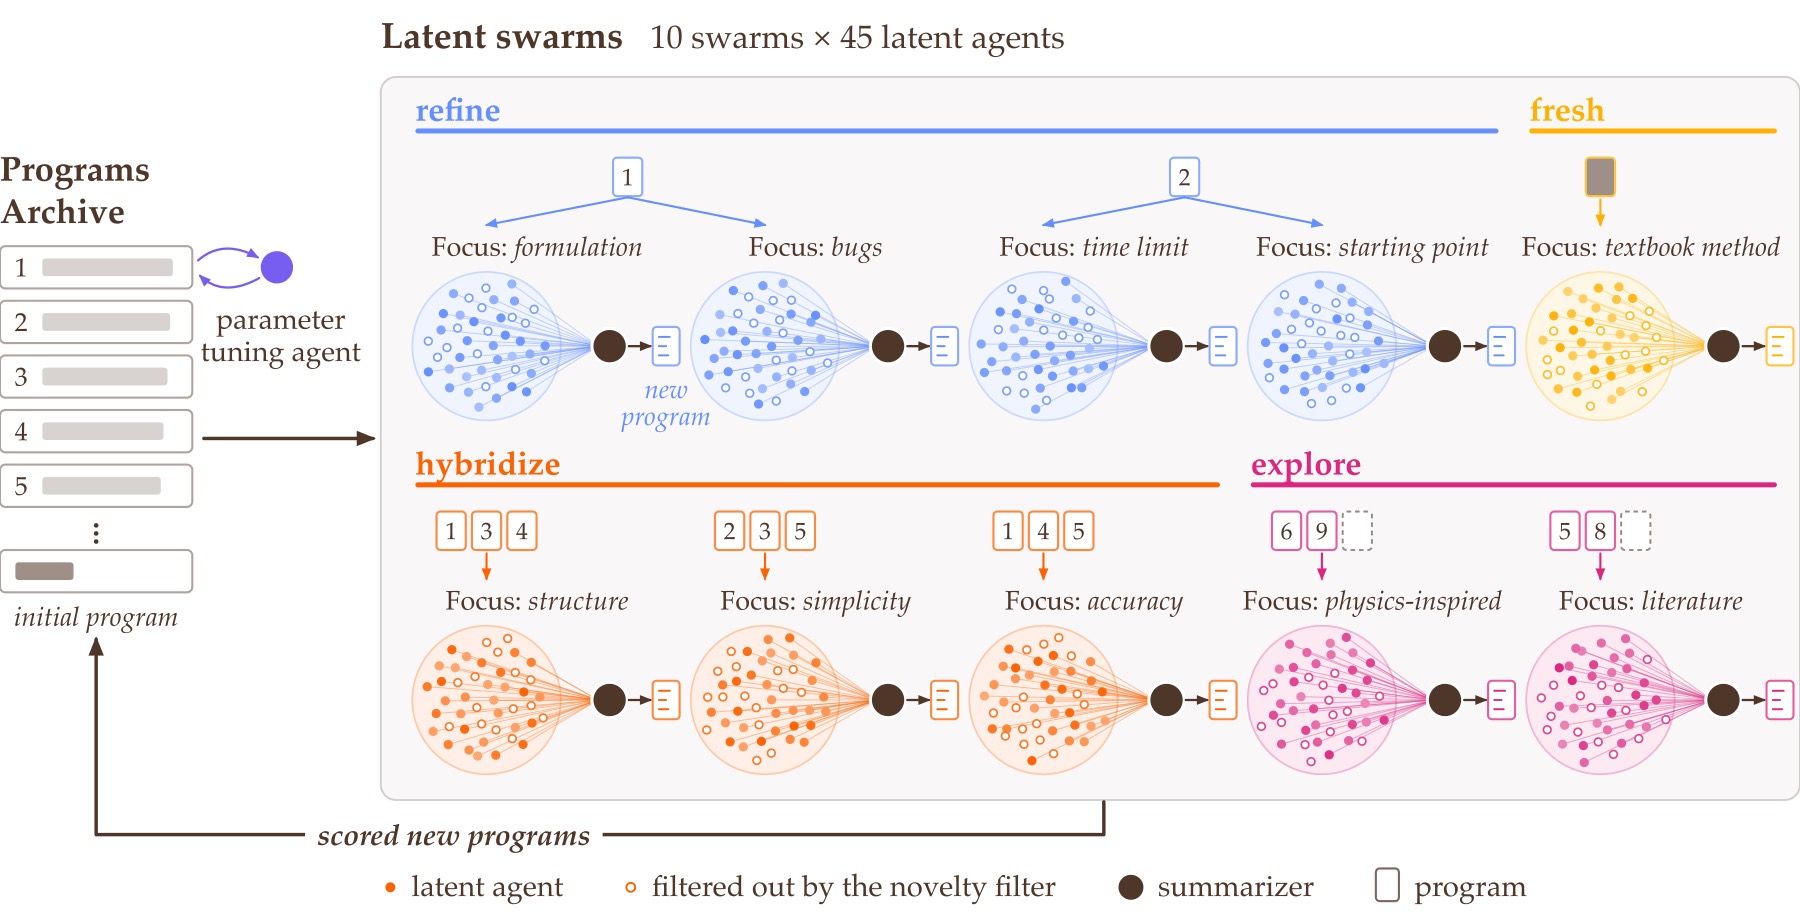
图 1(论文 Figure 2a):程序档案库向 10 个群体提供父代。四群负责精修,三群负责混合,两群负责探索,一群从头开始;每个群体由总结智能体产出一个新程序,评估后再回写档案库。独立的参数调优智能体还会修改最佳程序中的数值参数。
每轮有 10 个群体,每群 45 个智能体,共 450 个。这些智能体不是复制 450 次同一个提示词。一个群体内的 45 份提示,由 5 种关注点表述与 9 种思考方式组合而成,例如从第一性原理出发,或重新审视程序假设。不同群体拿到的父代和任务也不同:
- 4 个精修群体盯住档案库前两名,每个父代交给两群,分别补数学形式、程序缺陷、时间预算等短板;
- 3 个混合群体从前十名中各抽 5 个程序,让 45 个智能体轮流读取,尝试组合不同父代的思路;
- 2 个探索群体从完整档案库各抽 4 个程序,另有 9 个智能体不读父代,只看问题本身;
- 1 个重新开始群体只看初始程序,避免整个搜索被当前高分方案锁死。
这个分配透露出作者很清楚进化搜索的老毛病:只围着最高分程序转,会很快陷入局部最优;完全随机重启,又浪费已经找到的构造。450 个智能体看似夸张,其实是把“利用”和“探索”拆成了固定配比的并行预算。
隐空间推理:40 步连续向量,不产出中间文字
每个智能体读入问题、群体关注点、一份父代程序及评估反馈,然后执行 40 步隐空间推理。普通解码会把最终隐藏状态映射成词表概率,再采样下一个 token;这里不采样,而是把隐藏状态变换回输入嵌入空间,继续下一次前向计算:
\(\mathbf h_t\) 是当前最终隐藏状态,\(\mathbf W_a\) 是用岭回归得到的对齐矩阵,\(\gamma\) 是词表输入嵌入的平均范数。归一化不是装饰:连续向量如果不断偏离正常 token 嵌入的尺度,后续层很容易失稳。整个过程无需额外训练,每一步只向 KV cache 增加一个位置,不生成可读文本。
450 个智能体在一个 batch 内运行。读取同一父代的智能体通过 paged attention 共享父代 KV cache,避免重复保存长程序上下文。这里的收益既来自“少解码”,也来自批量化和前缀复用,不能把所有加速都归给隐空间向量本身。
新颖性过滤:不是删掉离群点,而是让保留点覆盖空间
如果 45 个智能体的想法很接近,把全部 KV cache 交给总结智能体只会增加冗余。SwarmEvolve 每群保留 30 个、丢弃 15 个。它先对智能体 40 步的最终隐藏状态取平均,再减去群体均值并归一化,随后用余弦距离做贪心最远点选择:
这里 \(\mathcal K\) 是已保留集合。集合从最接近群体均值的智能体开始,之后每次加入“离所有已选点都尽可能远”的候选。这和简单保留最离群的点不一样:它先锚定群体主流方向,再逐步补齐覆盖面。
我个人挺喜欢这个设计。代码层面的相似度只能告诉你两份程序长得像不像,隐藏状态距离至少尝试在“想法形成之后、代码写完之后”之前做筛选,而且向量已经在 GPU 里,不需要再调用嵌入模型或 LLM 裁判。只是,余弦距离更远并不自动等于算法思想更有价值,它仍然是一个便宜的代理指标。
KV cache 交叉:总结智能体直接读取 30 份内部状态
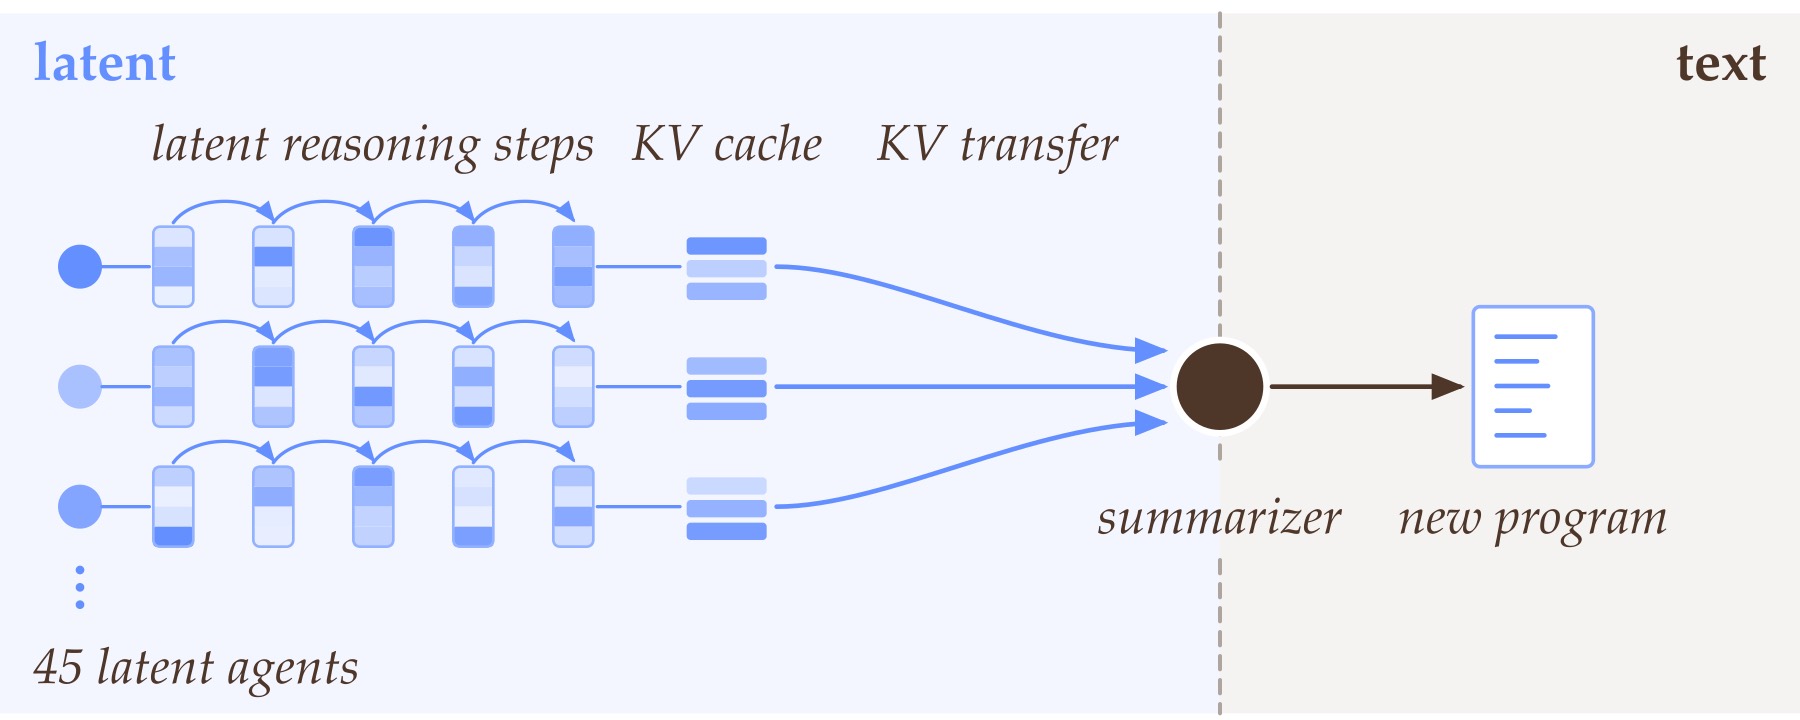
图 2(论文 Figure 2b):左侧多个智能体各自形成隐空间推理轨迹和 KV cache;右侧总结智能体读取拼接后的缓存,再把新程序解码为文本。中间没有“把每份推理写成文字再重新编码”的步骤。
保留下来的 30 个智能体,把关注点和 40 步推理对应的 KV cache 交给总结智能体。总结端还同时拿到问题、该群体的父代程序和输出指令。所有缓存在每个 Transformer 层沿序列维拼接,然后由总结智能体生成一段简短方向说明和一份完整程序。
有个容易忽略的实现细节:并行智能体的缓存都从位置 0 开始,直接拼接会弄乱 RoPE 位置信息。作者按目标块的位置偏移旋转每份缓存里的 key;value 不带位置信息,原样拼接。这件事不浪漫,却是方法能否真正跑起来的关键。
程序写出后,框架去重、检查语法、补标准库 import,再由确定性评估器打分。每轮最多还有 8 次“一次只改一个数值参数”的调优尝试。新程序和评估日志回到档案库,下一轮继续。
实验:速度优势很大,但要看清比较口径
实验覆盖 21 个问题:16 个来自 AlphaEvolve 附录的数学任务,涉及填充、几何、分析和组合;另外 5 个是作者新增的科学计算任务,包括稀疏线性系统、非正规矩阵特征值、Burgers 方程、对流扩散方程和 Helmholtz 方程。
所有框架在同一模型配置下运行 60 分钟,使用一块 GPU 和 8 个 CPU 核并行评估,三个随机种子。模型分别为 Qwen3 8B、14B 和 32B-FP8;对应硬件是 L40S、RTX PRO 6000 和 H100。基线保留默认配置,模型通过 vLLM 提供服务。
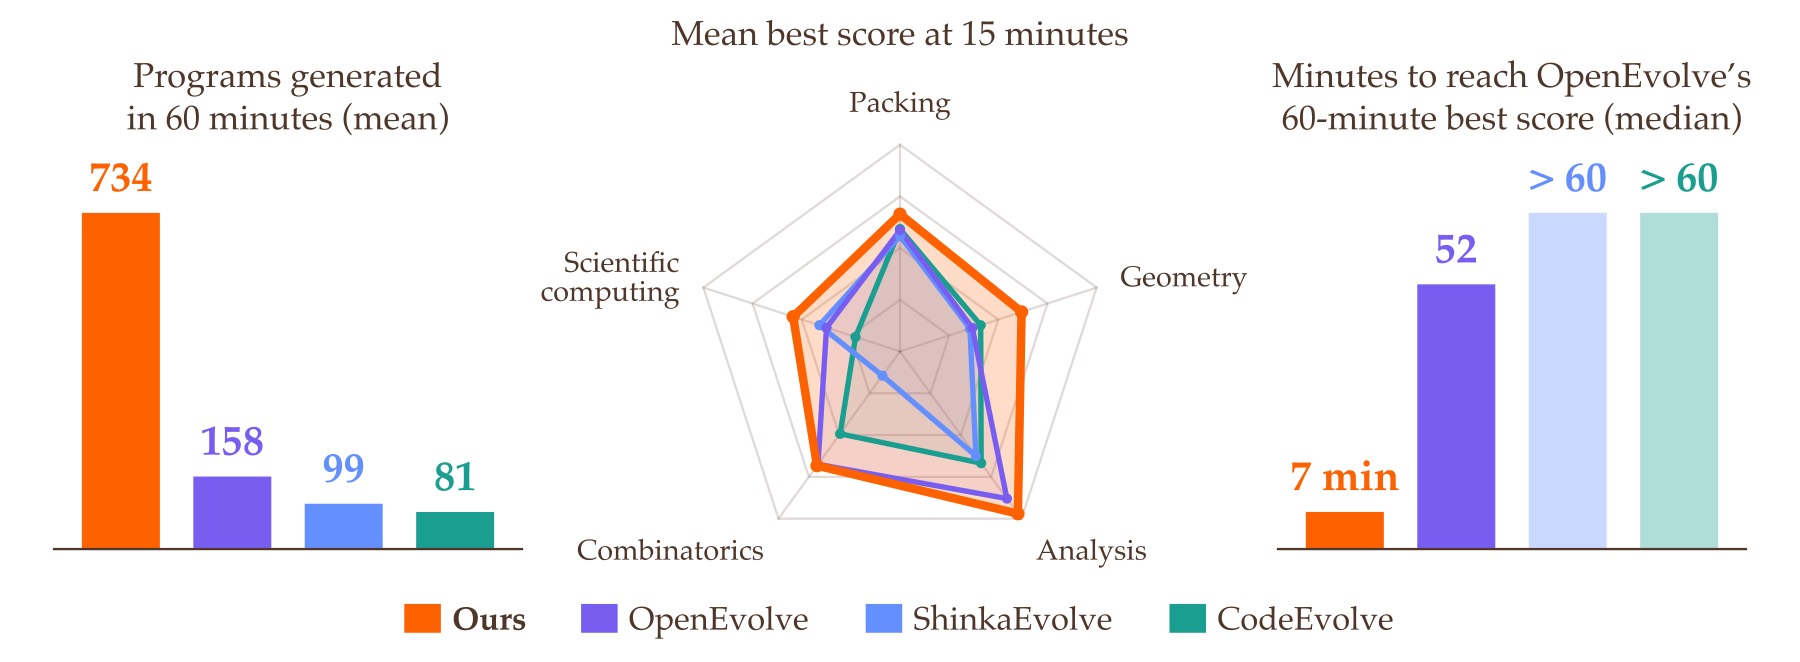
图 3(论文 Figure 1):Qwen3 8B 下,SwarmEvolve 一小时生成 734 个程序,OpenEvolve、ShinkaEvolve、CodeEvolve 分别为 158、99、81 个。中间雷达图展示五类任务在 15 分钟时的平均最佳分数;右图显示追平 OpenEvolve 一小时分数的中位时间为 7 分钟,另外两种基线在该口径下超过 60 分钟。
主结果:8B 的 SwarmEvolve 超过 32B 的文本基线
| Qwen3 配置 | SwarmEvolve | OpenEvolve | ShinkaEvolve | CodeEvolve |
|---|---|---|---|---|
| 8B,60 分钟 | 0.804 | 0.693 | 0.642 | 0.700 |
| 14B,60 分钟 | 0.837 | 0.771 | 0.686 | 0.739 |
| 32B-FP8,60 分钟 | 0.869 | 0.774 | 0.733 | 0.731 |
表格是 21 个任务三次运行的平均分。最抓眼的不是 SwarmEvolve 随模型变大从 0.804 涨到 0.869,而是它的 8B 平均分已经超过所有使用 32B-FP8 的基线。搜索系统的组织方式,在这里确实比单纯扩大模型更划算。
不过,这个平均分不是统一的物理量。16 个数学任务用 AlphaEvolve 已发表构造的目标值做归一化,超过 1 表示改进;科学计算任务则按相对误差对应的正确位数计分并截断。把它们平均适合观察整体趋势,但不能理解成“所有科学发现能力提升了同一个百分比”。
论文还报告,Qwen3 8B 的 SwarmEvolve 在三个任务上超过 AlphaEvolve 的已发表构造:26 个圆装入单位正方形时,半径总和达到目前已知最佳的 2.635983;第二、第三个自相关不等式的阶梯函数界也得到改进。这里比较的是 AlphaEvolve 的公开结果,而不是把 Gemini 和 AlphaEvolve 在完全相同硬件、时间与提示下重跑。因此更稳妥的结论是“小型开放模型配合更好的搜索也能找到强构造”,不是“8B 模型本身胜过前沿模型”。
时间分解:GPU 终于把大头用在写程序上
| GPU 工作阶段,Qwen3 8B | SwarmEvolve | OpenEvolve | ShinkaEvolve | CodeEvolve |
|---|---|---|---|---|
| 文本推理 | 0 | 52.5 分钟 | 34.4 分钟 | 46.8 分钟 |
| 隐空间推理 | 4.1 分钟 | 0 | 0 | 0 |
| 隐空间通信 | 2.6 分钟 | 0 | 0 | 0 |
| 写出程序 | 39.4 分钟 | 6.4 分钟 | 5.7 分钟 | 4.7 分钟 |
| 新颖性检查 | 0.05 分钟 | 0 | 4.5 分钟 | 0 |
| 一小时评估程序数 | 734 | 158 | 99 | 81 |
这张表比单看加速倍数更有说服力。三个基线把 57% 至 87% 的 GPU 时间花在文本推理上,SwarmEvolve 则把 66% 用在真正输出程序。它不是让同一条生成链路快一点,而是重新分配了计算预算。
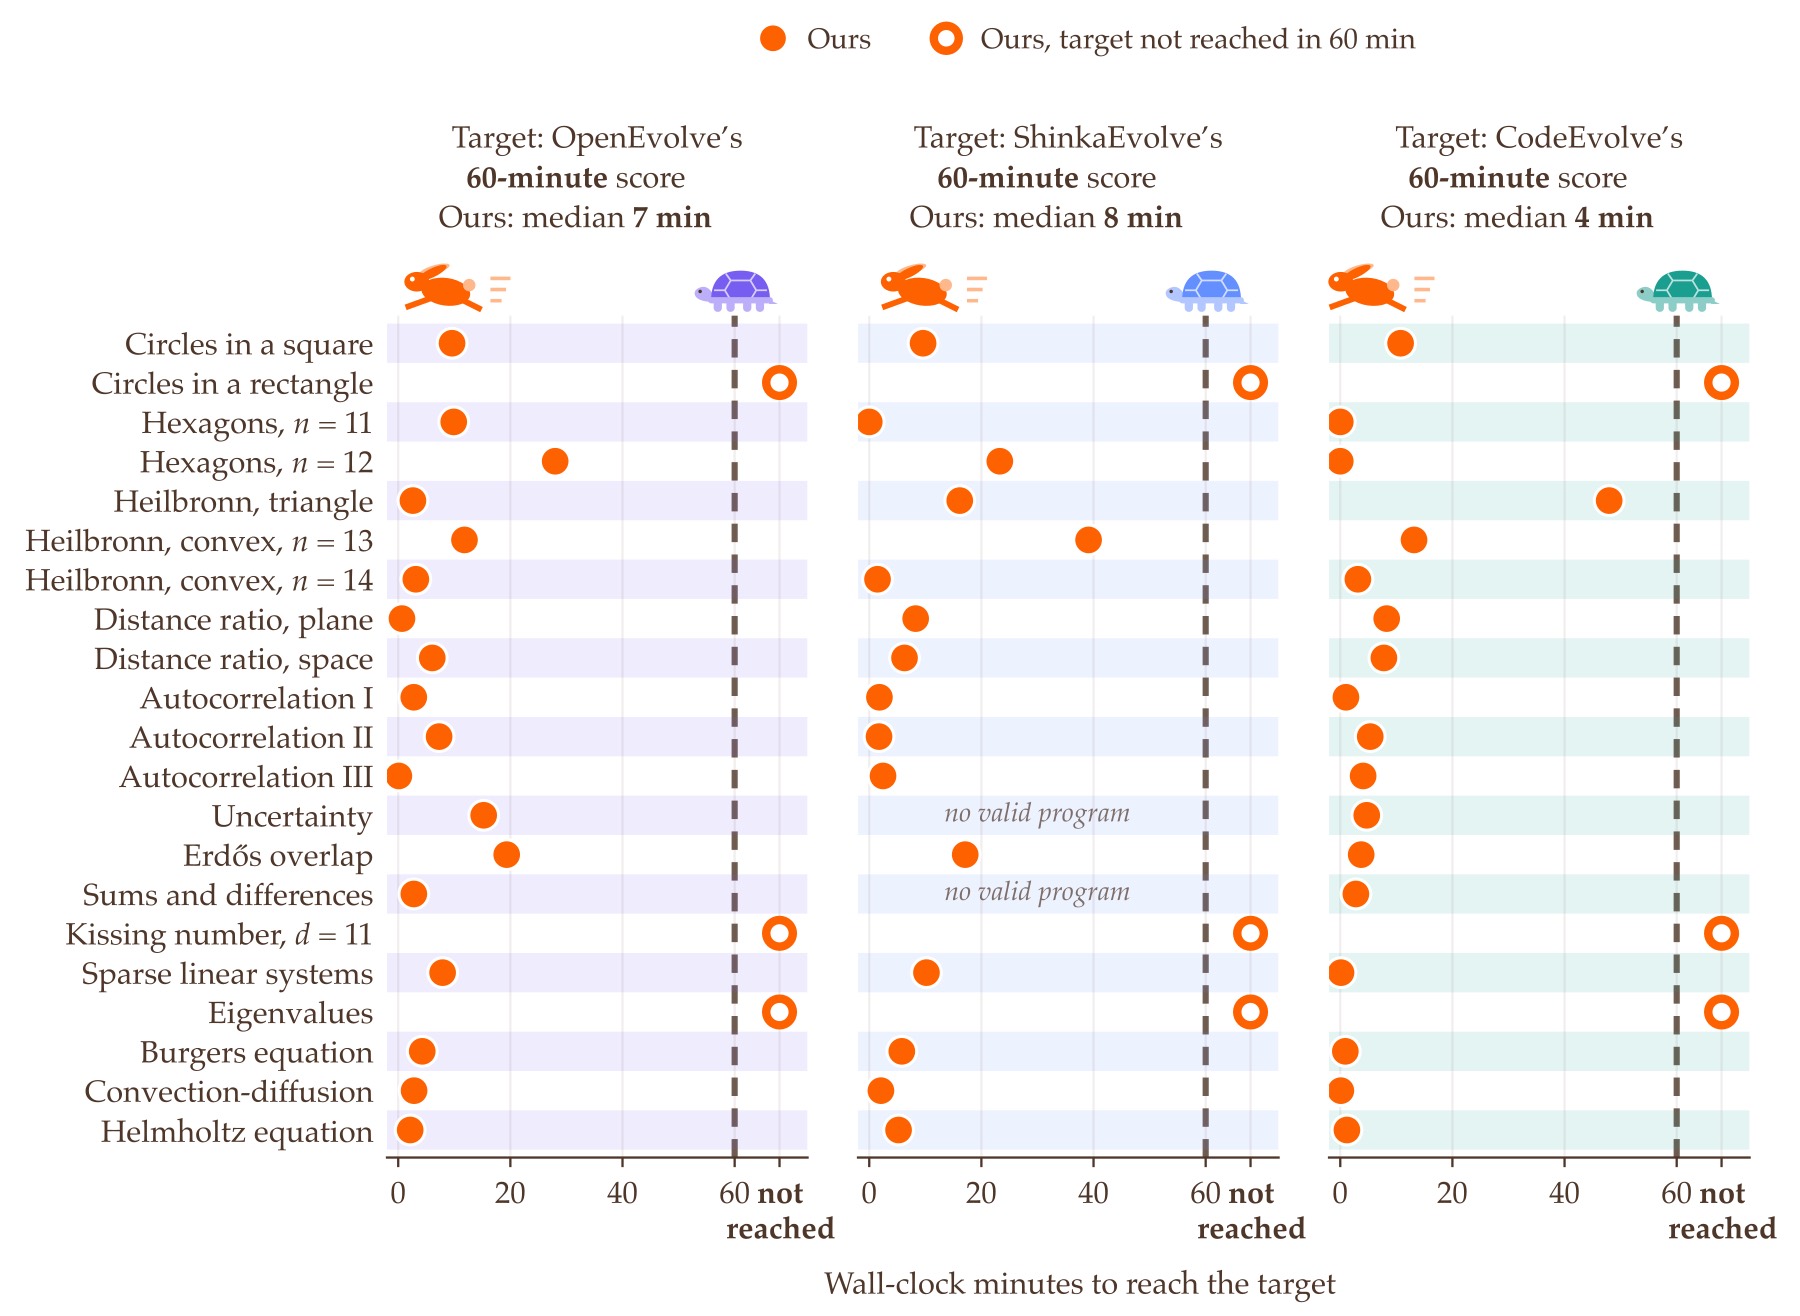
图 4(论文 Figure 4):三个面板分别以 OpenEvolve、ShinkaEvolve、CodeEvolve 的一小时最佳分数为目标,中位追平时间为 7、8、4 分钟。空心圆表示 60 分钟内仍未追平,例如矩形装圆和十一维 kissing number 等任务;ShinkaEvolve 在两个任务上没有有效程序。
也别只盯着中位数。图中确实有若干任务到一小时也没追平,说明“几分钟替代一小时”不是逐任务保证。基线默认配置在个别任务上没有有效程序,也会拉开平均分差距。相同模型、时间和硬件是公平比较的必要条件,但默认超参数是否对每个基线都最合适,论文没有进一步做逐任务调优。
消融与隐空间分析:多样性有用,但不会无限累积
文本推理消融给出了一个挺克制的结论。把 40 步隐空间推理换成最多 40 个文本 token,平均分从 0.804 降到 0.796;换成 256 token,则降到 0.767。对应一小时评估量分别为 734、663、402 个。
| 推理方式 | 60 分钟平均分 | 一小时评估程序数 |
|---|---|---|
| 40 步隐空间推理 | 0.804 | 734 |
| 最多 40 个文本 token | 0.796 | 663 |
| 最多 256 个文本 token | 0.767 | 402 |
说实话,0.804 对 0.796 并不大,单看这个差值还不足以证明隐空间思考天然优于短文本。更扎实的收益来自吞吐:256 token 版本每轮仅智能体文本推理就约需 32 秒,隐空间版本约 4 秒;总结端读入长文本还会增加编码时间。作者也提到,长消息可能挤占总结智能体 32,768 token 的上下文窗口。因此,256 token 的较大降幅混合了通信效率、上下文拥挤和搜索次数变化,不宜全部解释成表示能力的差距。
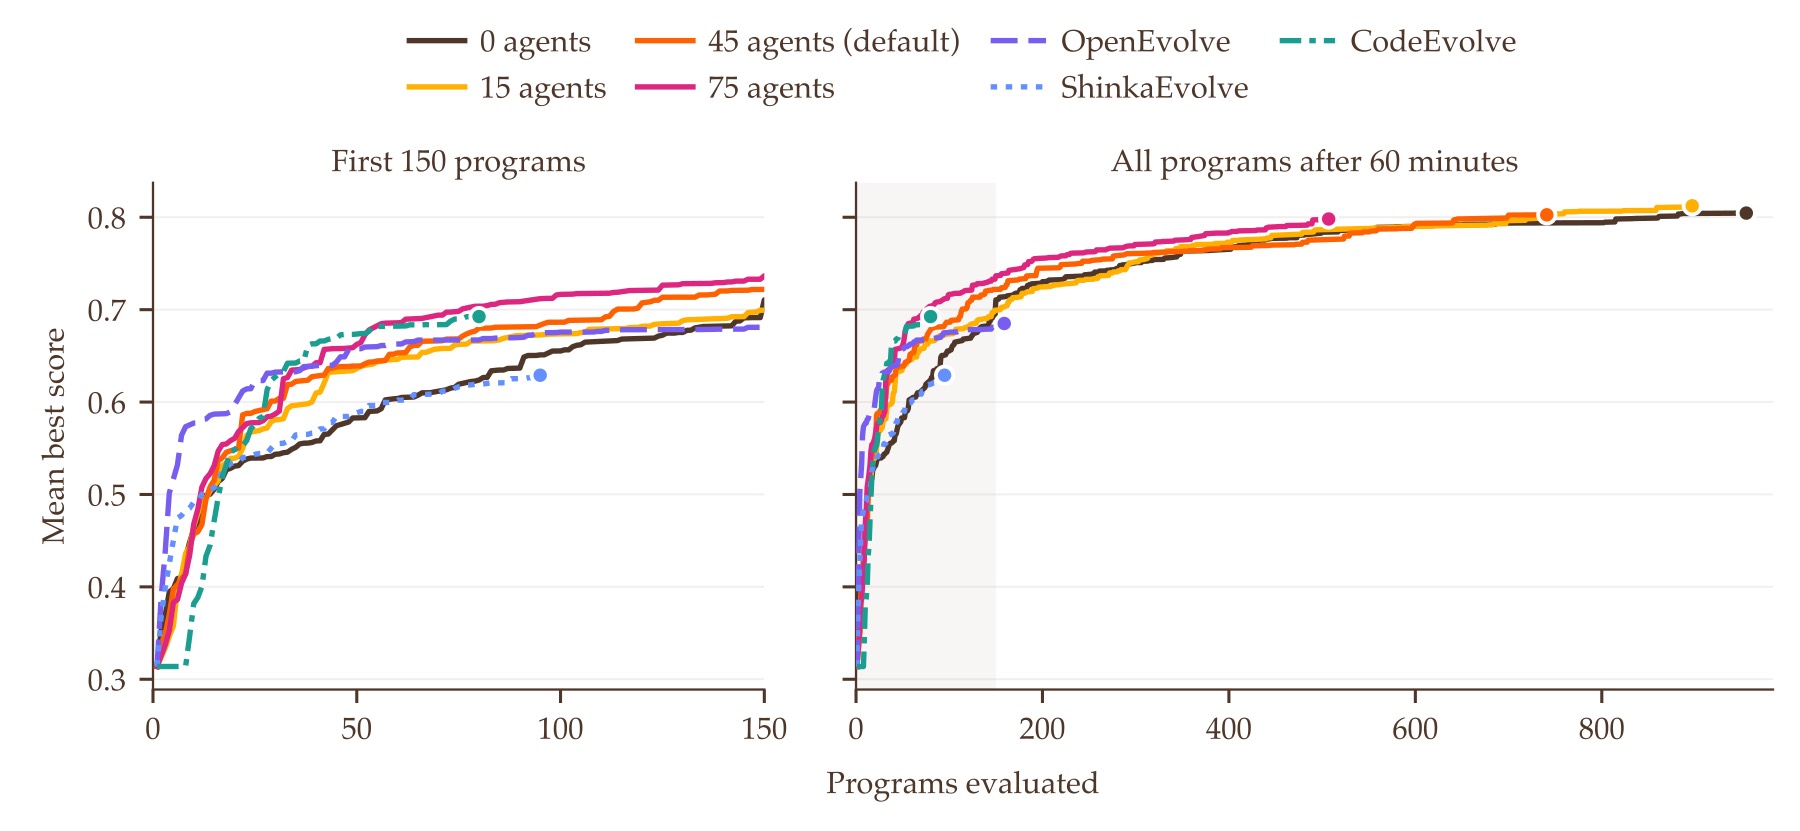
图 5(论文 Supplementary Figure 1):横轴是已评估程序数,纵轴是平均最佳分数。前 150 个程序内,75 智能体群体整体领先;跑满 60 分钟后,0、15、45、75 四种群体大小逐渐接近,主要差别变成各自能完成多少次评估。
这个结果其实给“群体越大越好”踩了刹车。大群体在早期用更多视角看同一父代,样本效率更高;小群体单轮更快,后期能靠更多轮次追上来。作者的解释也合理:所有智能体共享同一个模型的知识,增加副本无法自动填补模型共同的盲区。搜索后半程若想继续抬高上限,换更强的模型仍然更有用。
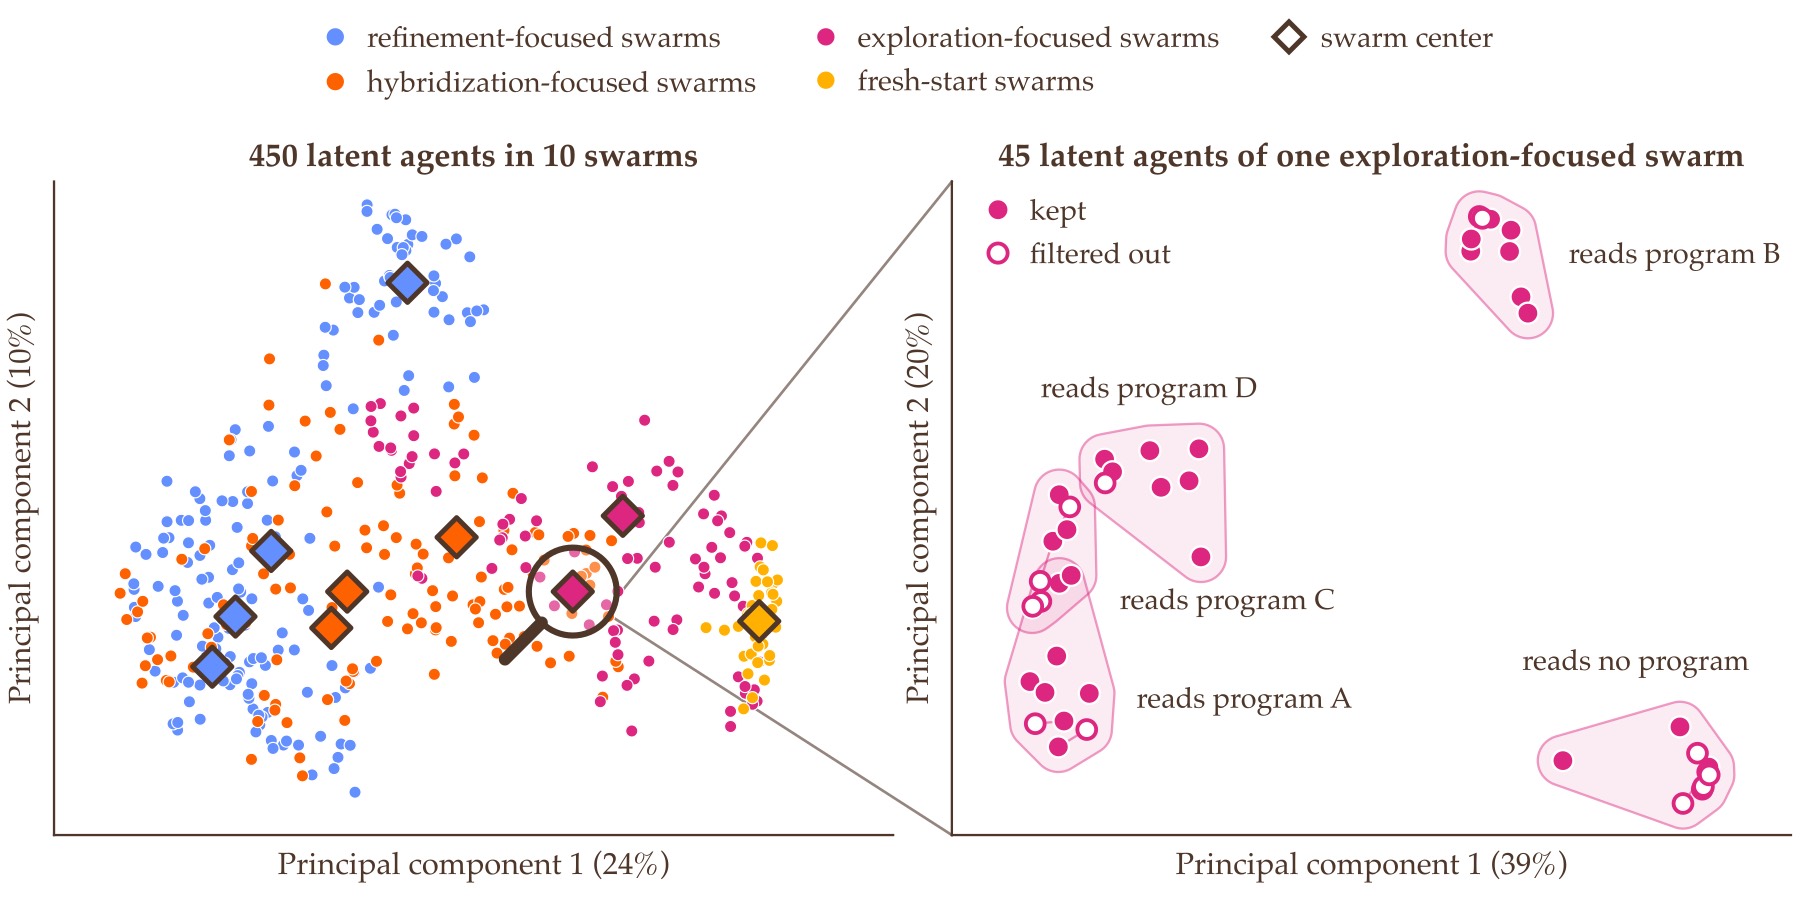
图 6(论文 Figure 5):左图把 10 群的 450 个智能体投影到两个主成分,不同角色形成不同区域;右图放大一个探索群体,读取不同父代程序的智能体各自聚类,新颖性过滤器从多个簇中保留代表。空心点是被过滤的智能体。
这张图支持“关注点与父代确实改变隐空间轨迹”,但还谈不上证明语义多样性。左图前两个主成分只解释 24% 和 10% 的方差,右图是 39% 和 20%。二维投影里分得开,可以当作直观证据;它不能保证高维空间里的距离始终对应有质量的思想差异。说实话,这里我还会想看一个更直接的指标:过滤保留度与最终程序新颖性、评估分数之间的相关性。
我的判断:最值钱的是搜索预算的重新分配
SwarmEvolve 最让我被打动的地方,不是“450 个 Agent”这个大数字,而是它把文本思维链占掉的 GPU 时间夺回来,变成更多可执行、可评估的候选程序。对数学构造、数值算法这类有确定性评估器的问题,多一次真实评估往往比多一段自我解释更有价值。
它也有清楚的边界。
适用任务边界。这套方法需要便宜、可靠、可自动执行的评估器。PDE 求解精度和几何构造天然合适;开放式研究、真实产品设计或评估一次要跑几天仿真的任务,不能照搬这里的吞吐结论。
模型与显存边界。智能体和总结端必须共享同一个 LLM,因为不同模型的 KV cache 不能直接互读。标准注意力是前提,线性注意力和状态空间模型需要另外设计状态合并方式。KV cache 显存还随智能体数、隐空间步数和层数线性增长,所以 32B-FP8 实验需要 H100;隐空间推理省的是解码时间,不是免费抹掉内存成本。
可解释性边界。中间过程不再天然可读,出问题时很难像检查文本思维链那样定位错误。隐藏状态过滤器提供了几何视角,却不能替代程序级因果分析。对科研发现系统而言,最终代码和评估日志仍然必须保留。
比较口径边界。论文与三个开源基线的同模型、同时间对照有说服力,与 AlphaEvolve 的跨系统公开结果比较则应更谨慎。主表只给三次种子的均值,图中提供了部分波动区间,但若要把很小分差当成稳定优势,仍需要更完整的显著性报告。
所以,我不会把它读成“小模型取代前沿模型”的故事。它更像一条工程上很实用的原则:当任务有可靠评估器时,与其让一个模型写更长的思考,不如让许多低成本搜索分支尽快接受真实反馈。隐空间通信在这里不是炫技,而是扩大搜索并行度的一种手段。
如果你在做自动算法设计、科学计算求解器或程序优化,这篇论文值得细读。可以直接借用的未必是完整的 KV cache 拼接,而是三个预算决策:把计算花在可评估产物上,把利用与探索显式分配,把多样性筛选做成便宜的内部操作。至于开放式科学发现能否走同一条路,目前还缺证据。
参考链接
- SwarmEvolve 论文:arXiv:2611.08483
- SwarmEvolve 项目:GitHub
- LatentMAS 前置工作:Latent Collaboration in Multi-Agent Systems
- CodeEvolve 背景:arXiv:2510.14150
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我