HeLM:让机器人用“内心独白”记住做过什么
论文:HeLM: Hierarchical Explicit Language Memory for Non-Markovian Manipulation
作者:Gyeonghun Kim、Donghoon Kim、Minsoo Choi、Suyun Lee(首尔大学)
链接:https://arxiv.org/abs/2611.02660 | https://kimspacehuni.github.io/HeLM/
arXiv ID:2611.02660(v1,2026-11-02)
一句话总结
HeLM 把机器人“已经做过什么”写成一份可读、可更新的语言备忘录:高层 VLM 负责识别事件、维护记忆并下达语义命令,低层 VLA 只负责把命令变成动作。这个看似朴素的设计,在 10 类真实机器人非马尔可夫任务上显著优于无记忆、隐式记忆和视觉关键帧记忆方案。
TL;DR:最值得记住的三点
- 把历史从图像/token 变成语言状态。HeLM 不让策略反复消化整段视觉历史,而是保存“红色按钮已按过”“蓝色、红色按钮是人刚才演示的顺序”这类任务相关事实,既紧凑又容易检查。
- 先检测事件,再按需更新记忆。Detect 与 Update 共用同一个 VLM,但由不同系统提示词区分;没有事件发生且指令没有变化时,记忆和动作命令保持不变,避免每一步都重写状态。
- 不仅记住一个 episode 内的事,还能跨 episode 记住。工作记忆记录当前任务进度,情景上下文保存前序任务摘要。真实机器人上,HeLM 的 episode 内平均子任务成功率为 85.7%,比最强基线高 12.8 个百分点;跨 episode 平均达到 89.2%,而视觉关键帧基线只有 16.6%。
1. 机器人为什么会“看着眼前,却忘了刚才”?
假设桌上的任务很简单:依次按下红、绿、蓝三个按钮。机器人已经按过红色,机械臂也回到了附近。此时摄像头里的按钮位置、机械臂姿态,可能与第一次准备按红色时非常相似。对一个只看当前画面的策略来说,下一步到底是按红还是按绿,并没有写在当前图像里。
这就是论文关注的非马尔可夫操作:当前观测不足以决定正确动作,必须借助历史。类似问题并不只发生在按钮任务中:
- 擦窗户时,已经擦过的区域和没擦过的区域可能看起来几乎一样;
- 找抽屉里的物体时,空抽屉被关上后,画面不会告诉你“这里已经搜过”;
- 按按钮 N 次时,当前画面不会直接显示计数;
- 上一个任务中看到过物体位置,下一个任务开始后,若记忆被清空,机器人就只能重新寻找。
论文用下面的不等式刻画这种信息缺口:
其中,\(o_t\) 是当前观测,\(I\) 是指令,\(s_t\) 是真实环境状态,\(o_{0:t}\) 是截至当前的完整观测历史。两边的条件分布不同,意味着同样的当前画面可以对应不同历史状态,也要求不同动作。标准 VLA 常写成 \(\Pi(a_t\mid o_t,I)\),默认当前观测足够;HeLM 则加入显式文本记忆 \(M_t\),变为:
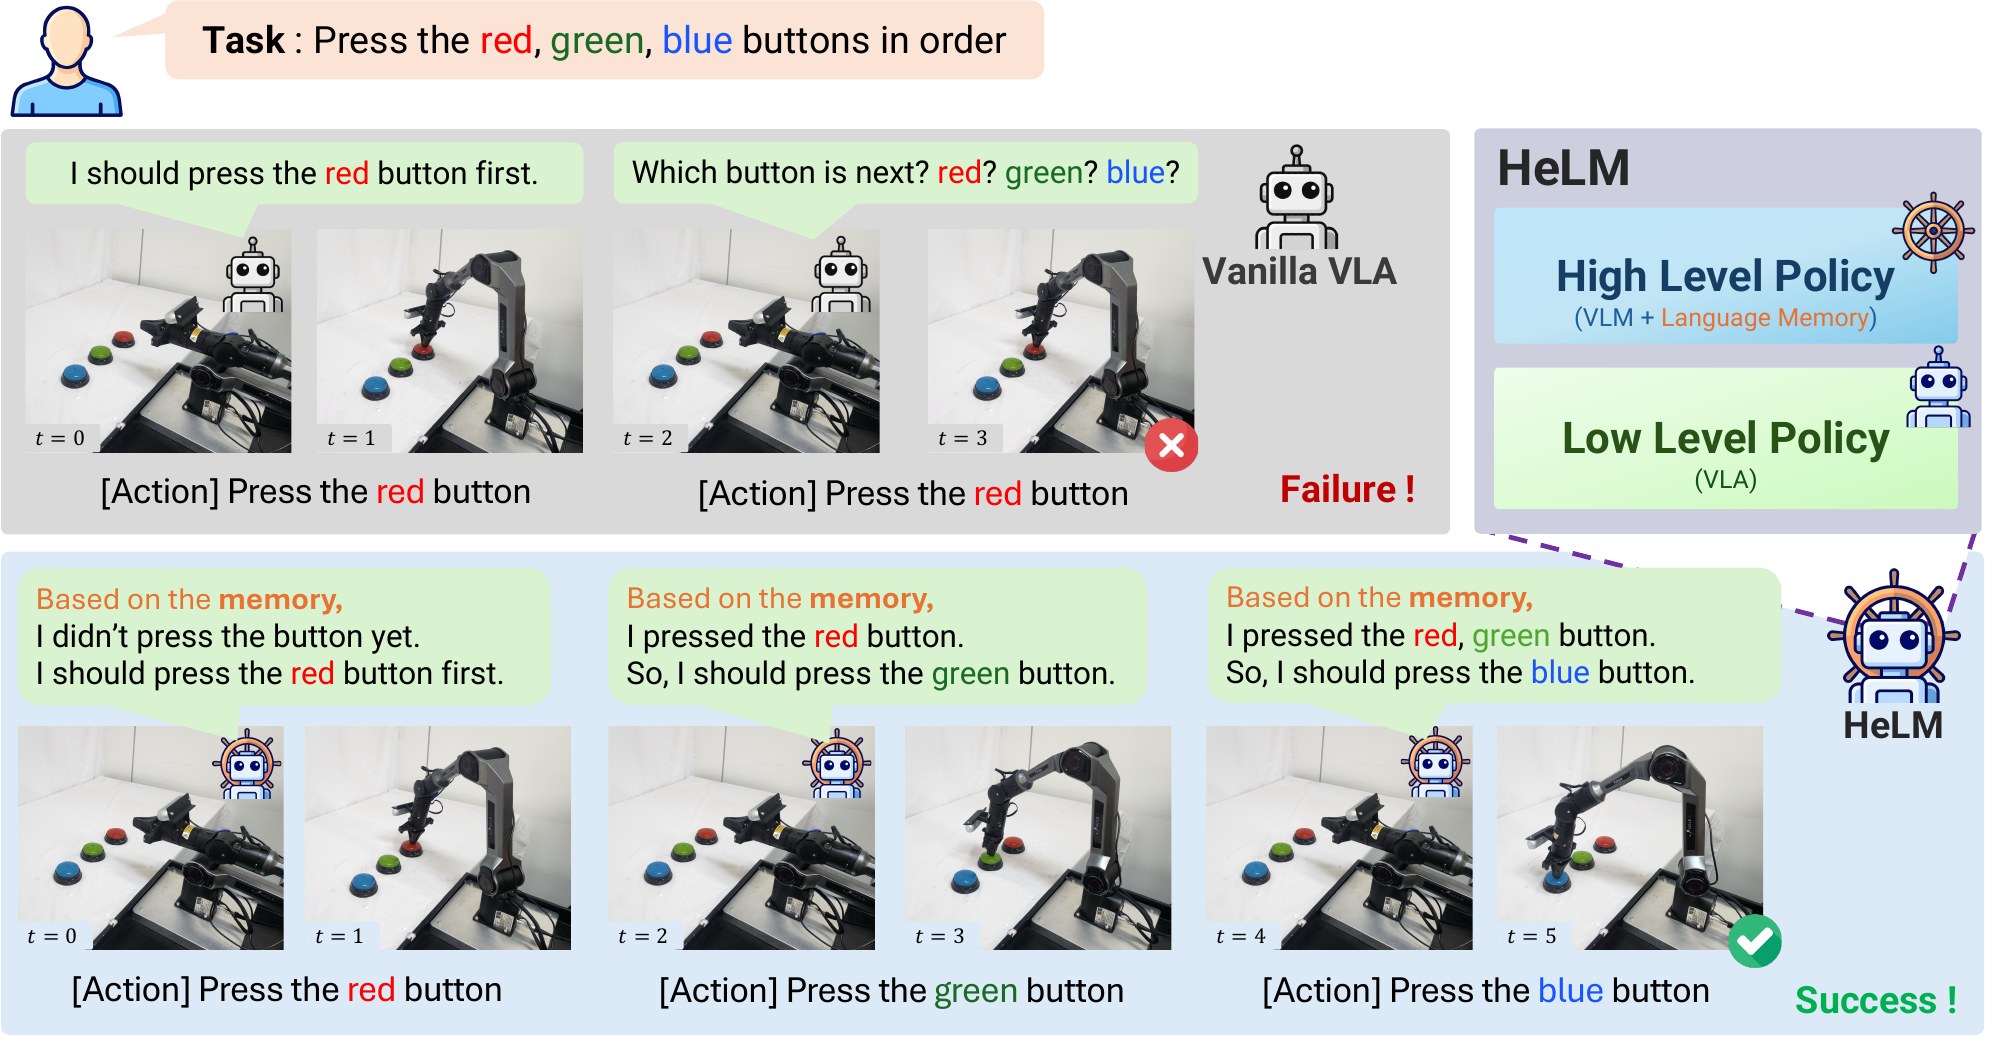
图 1 把问题展示得很直观。Vanilla VLA 按下红色按钮后,开始犹豫“下一个是什么”,最后又按了一次红色;HeLM 则在记忆中依次保留“尚未按按钮”“已按红色”“已按红色和绿色”,因此能继续执行绿色、蓝色并结束。这里真正补齐的不是更强的视觉特征,而是当前画面里已经消失的历史信息。
2. 核心思路:语言不只是指令,也可以成为记忆介质
已有记忆型机器人策略大致有两条路线。一类把历史压缩成 latent embedding 或 memory tokens,计算上紧凑,但内部状态不易解释;另一类直接堆叠历史帧或事件关键帧,保留了视觉证据,却会让图像 token、显存和推理延迟随历史增长。
HeLM 选择第三条路:只保留对任务有用的语义事实。例如,完成两次按钮按压后,不必永久保存两段视频,只需保存 count: 2。语言记忆因此具有三个直接好处:
- 压缩任务历史:背景变化、无关动作和重复画面不会一直占上下文;
- 贴近 VLM 的原生推理方式:高层策略本来就擅长读写结构化文本;
- 可审计:失败时能直接检查计数、进度和事件是否写错,而不是猜测某个隐向量里存了什么。
当然,这不是“语言天然优于视觉”。它依赖一个前提:该记什么能够被预先定义并可靠检测。后文的实验与局限会反复回到这个前提。
3. HeLM 如何工作?
3.1 高低层分工:一个管“做到哪”,一个管“怎么做”
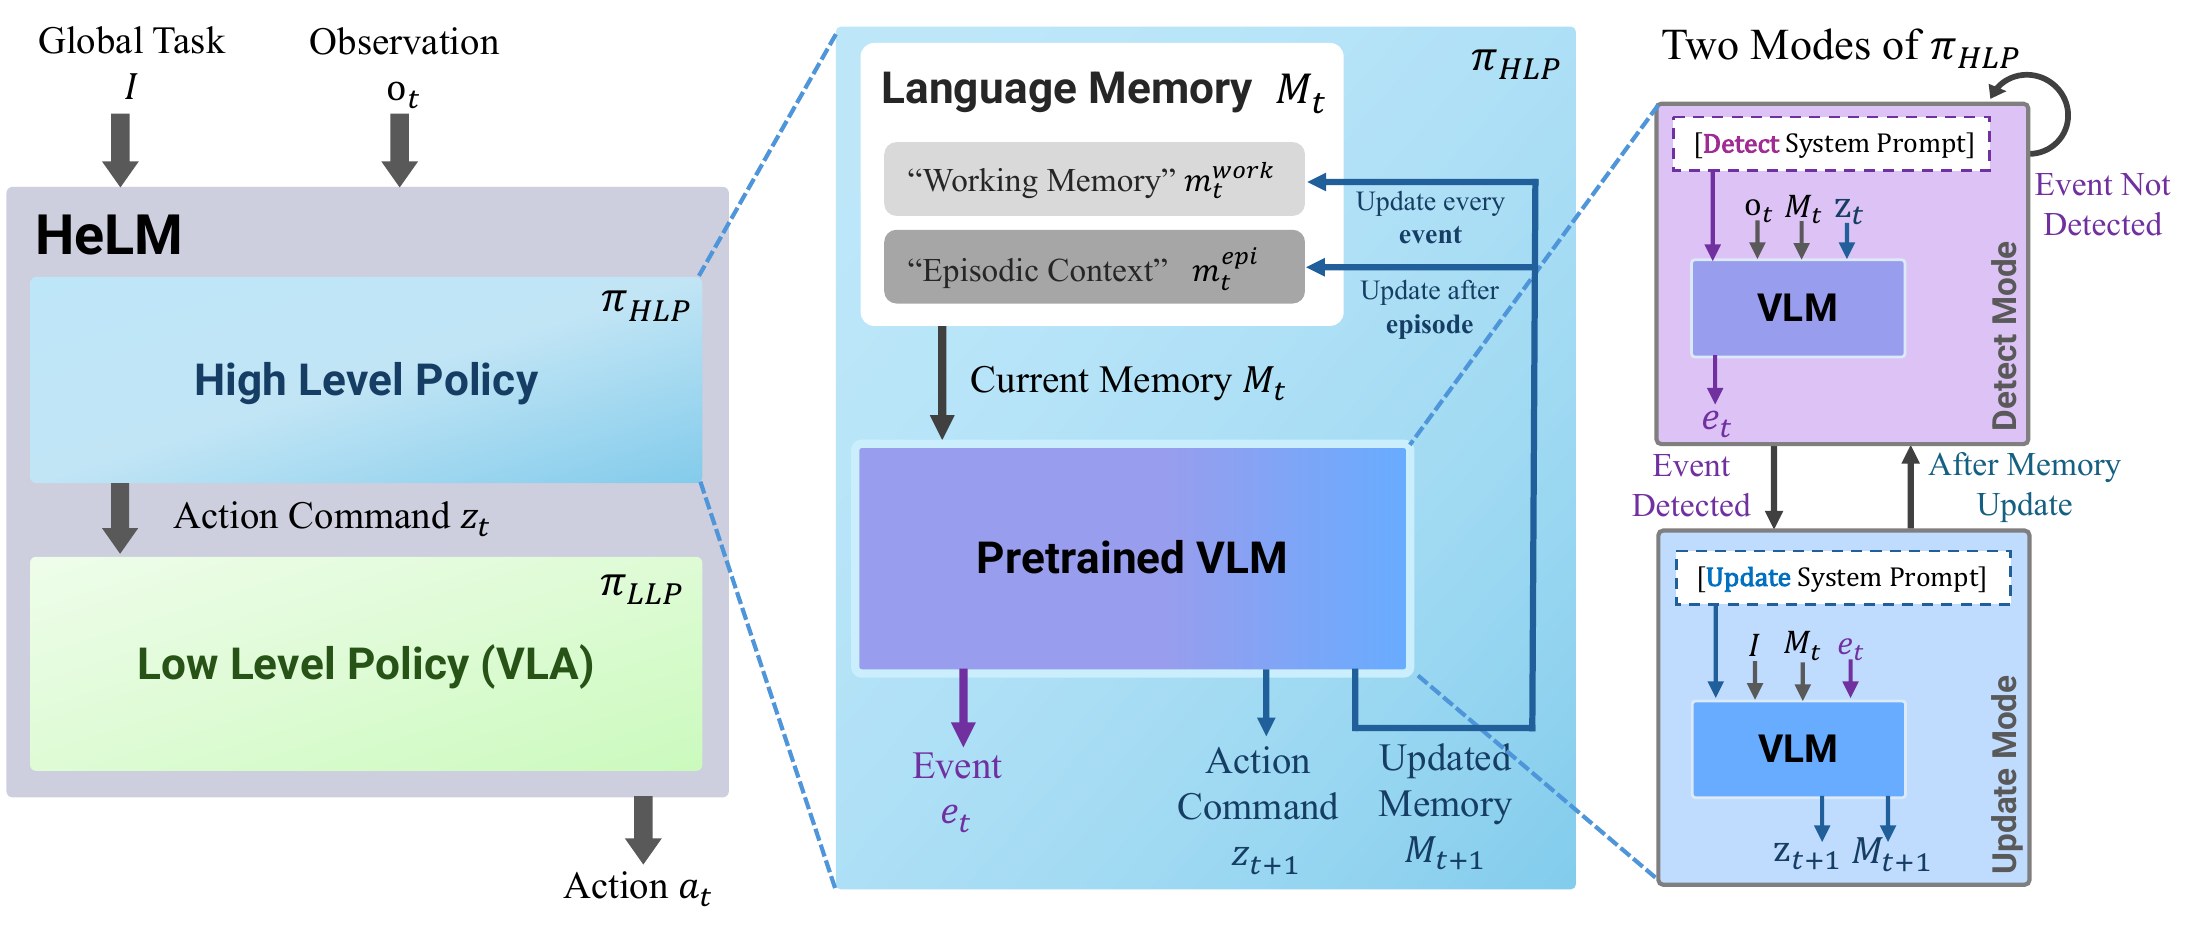
HeLM 将系统拆成两层:
- 高层策略 HLP(High-Level Policy):基于微调的 VLM,接收全局指令 \(I\)、当前观测 \(o_t\) 和语言记忆 \(M_t\),识别任务事件,维护记忆,并生成动作命令 \(z_t\)。
- 低层策略 LLP(Low-Level Policy):基于 VLA,把语义命令 \(z_t\) 与当前观测 \(o_t\) 转成连续机器人动作 \(a_t\)。
例如,HLP 输出“按绿色按钮”,LLP 负责接近、对准、接触和按压。这样分工的关键不是简单多加一个规划器,而是让抽象历史与即时空间 grounding 各归其位:记忆负责“绿色还没按”,当前图像负责“绿色按钮此刻在哪里”。
3.2 两类语言记忆:当前进度与跨任务上下文
HeLM 将记忆组织为:
| 字段 | 保存内容 | 更新时机 | 生命周期 |
|---|---|---|---|
| 工作记忆 \(m_t^{\mathrm{work}}\) | 当前 episode 的计数、已完成步骤、下一目标等 | 检测到任务相关视觉事件时 | 当前指令/episode 内使用,边界处重置 |
| 情景上下文 \(m_t^{\mathrm{epi}}\) | 后续指令仍需要的前序任务摘要 | episode 结束、指令变化时,由工作记忆提升/总结而来 | 跨 episode 保留 |
以“先观察人的按钮顺序,再复现”为例,第一阶段的 Progress: blue, red 不只是当前进度;当观察任务结束时,它被总结为“人之前按过蓝色、红色按钮”,写入情景上下文。第二阶段的工作记忆重新从 none 开始,但 HLP 仍能读取这个历史,因此知道应该先按蓝、再按红。
3.3 两阶段推理:没有事件,就不改写记忆
HLP 不是每一步都同时生成事件、记忆和命令,而是拆成两个功能模式。两者共享同一套 VLM 参数,区别来自系统提示词。
Detect Mode:事件检测。 在每个高层调用点,模型根据当前观测、记忆和正在执行的命令判断是否有预定义任务事件发生:
输出可以是 pressed red button、wiped the top window 等事件,也可以是 none。事件词表来自 TaskSpec,但推理时模型看不到完整 TaskSpec 或真实记忆转移,需要自己根据视觉证据判断。
Update Mode:事件触发的记忆更新。 只有检测到事件,或者全局指令发生变化,才更新记忆和命令:
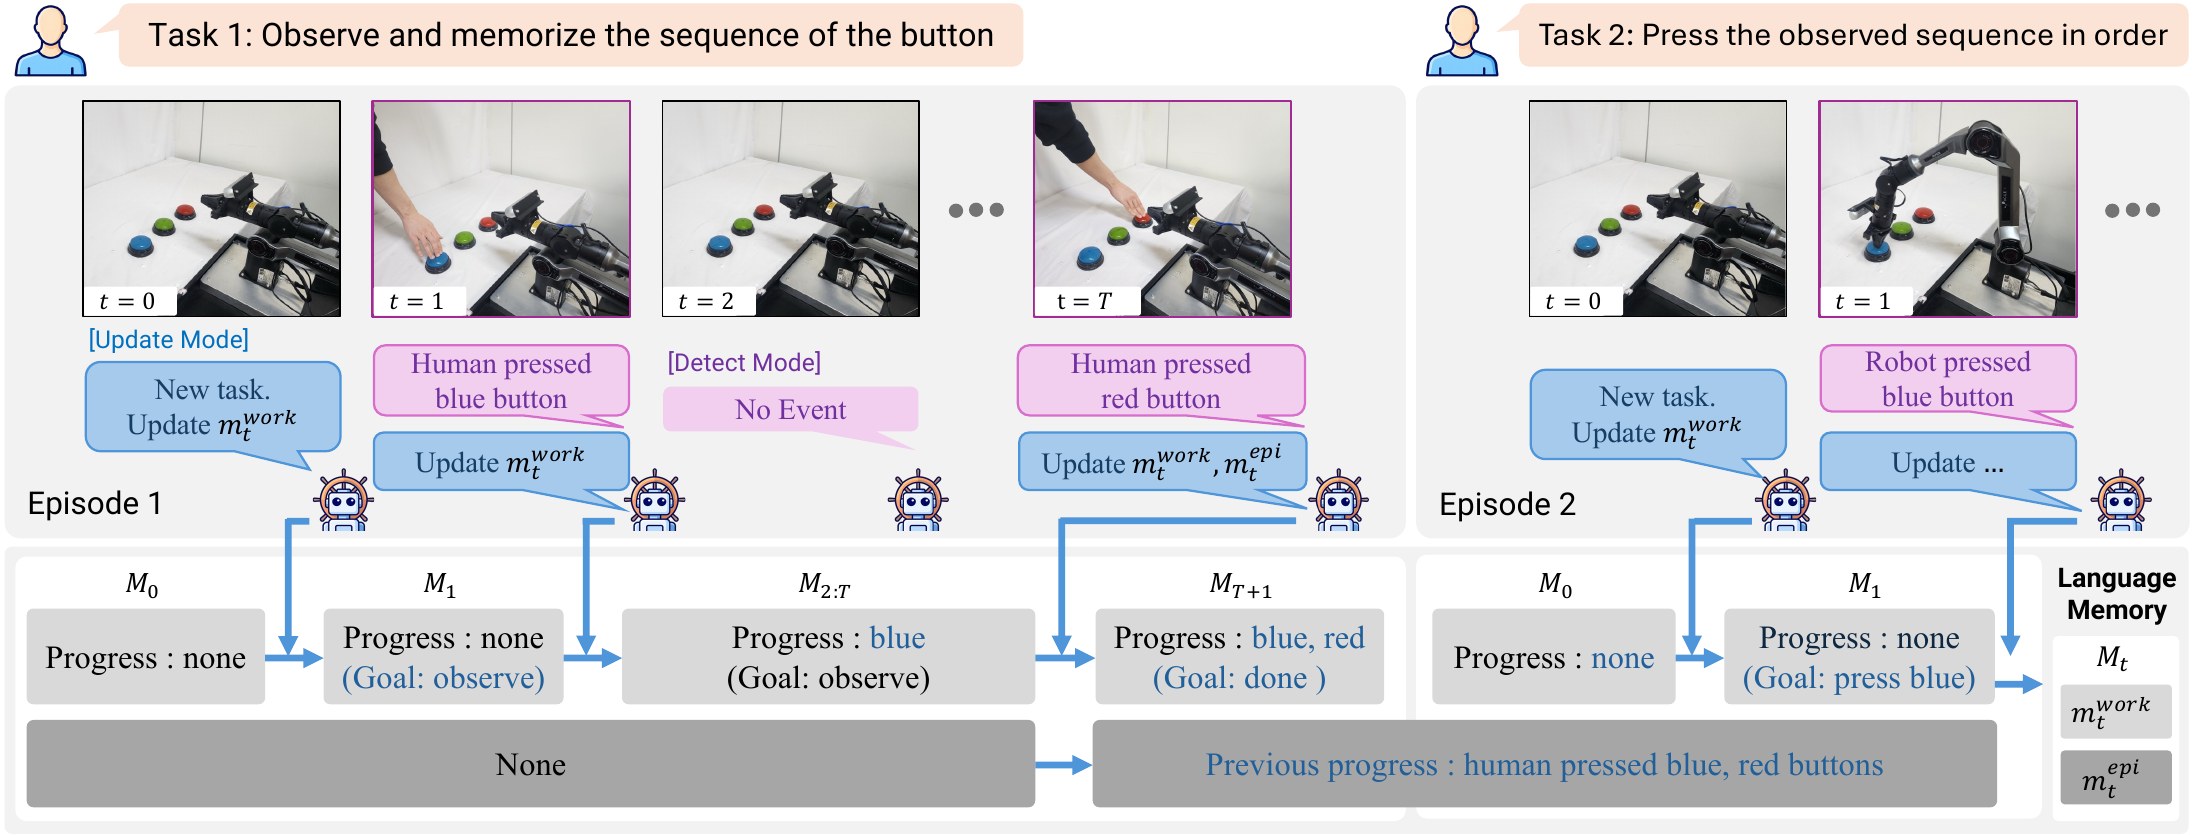
图 3 中,观察任务开始时先初始化工作记忆;检测到“人按蓝色按钮”后更新一次;中间没有事件的帧只运行 Detect,不碰记忆;检测到“人按红色按钮”且任务结束时,再同时更新工作记忆和情景上下文。进入第二个任务后,新指令本身也会触发更新,于是系统切换目标,同时保留上一阶段的顺序。
实现上,LLP 每次生成长度 \(H=10\) 的动作 chunk,HLP 在 chunk 边界同步调用。也就是说,高层更新频率低于低层动作频率,减少不必要的文本生成。但这也是双刃剑:若一个短暂事件完全发生在 chunk 内且边界画面看不出痕迹,检测器可能错过它。
3.4 TaskSpec:把短轨迹变成“观测—记忆”训练样本
HeLM 的 HLP 训练可以写成标准视觉指令微调,而不要求每次输入整段历史视频。核心工具是 TaskSpec:为每类任务定义合法动作命令、任务相关事件、各阶段的记忆状态和转移规则。它不限定唯一动作序列,却规定了“发生什么事件后,记忆应怎样变化”。
数据生成流程可以概括为:
- 从短的子任务示范轨迹中抽取图像帧并标注事件;
- 按 TaskSpec 为帧配对合法的语言记忆;
- 合成 DETECT 正负样本、episode 内 UPDATE 样本和 episode 边界 UPDATE 样本;
- 让 HLP 学习从 \(\langle o_t,M_t\rangle\) 判断事件,或从 \(\langle I_t,M_t,e_t\rangle\) 生成新记忆与命令。
由于历史已被压缩进文本,每个训练样本都可近似独立处理。TaskSpec 模板可以手写,再由 GPT 扩展任务变体并人工检查。主要人工成本是事件帧标注,论文报告约为每个子任务 5 分钟,覆盖约 30 条 episode。
真实机器人实验中,HLP 为 Qwen2.5-VL-7B-Instruct,使用 4-bit NF4 QLoRA,LoRA rank 为 16,训练 3000 步。数据共 166,590 条,约 130k 训练、36k 验证;其中 Detect 负样本占 62.7%,正样本和 episode 内 Update 各占 18.3%,跨 episode 转移样本仅占 0.8%。训练使用单张 RTX A6000,约 15 小时。LLP 为 \(\pi_0\),真实平台是 7-DoF AgileX PiPER 机械臂,配桌面与腕部 RGB 相机。
3.5 把一次完整循环串起来
以 A2 的“红—绿—蓝”为例,系统并不是先一次性规划三条动作再闭眼执行,而是在语义事件与动作 chunk 之间不断闭环:
- 初始化:新指令触发 Update,工作记忆写入目标顺序和
Progress: none,HLP 给出press red; - 执行:LLP 根据当前桌面与腕部图像执行 10 步动作 chunk,HLP 暂不介入每一个低层控制步;
- 检测:chunk 边界处,Detect 同时看到当前画面、旧记忆与
press red。若红色确已按下,就输出对应事件;若只是接近或接触失败,则输出none; - 更新或保持:检测到红色事件时,Update 将进度改为“红色已完成”,下一命令切成绿色;没有事件时,旧记忆与命令原样保留,LLP 可以继续尝试,而不是凭空把任务推进到下一步;
- 终止:蓝色完成事件触发最后一次更新,记忆进入完成状态,不再生成额外操作。
这个流程解释了为什么事件检测是系统的“安全闸门”。低层动作没做好但检测为 none,代价通常是多做几次;检测假阳性却会直接改变高层状态,让后续所有决策建立在错误前提上。两阶段设计把一个开放式生成问题拆成“先判断证据,再修改状态”,比每轮同时自由生成事件、记忆和命令更容易保持稳定。
从数据流看,HeLM 也没有把语言当作低层控制信号的全部来源。\(M_t\) 主要回答离散、抽象的历史问题,\(o_t\) 仍持续向 HLP 与 LLP 提供当前空间信息。因此它更接近“语言状态+视觉伺服”的组合,而不是让一段文本取代视觉。
4. 任务设计:把“记住历史”拆成可测量的问题
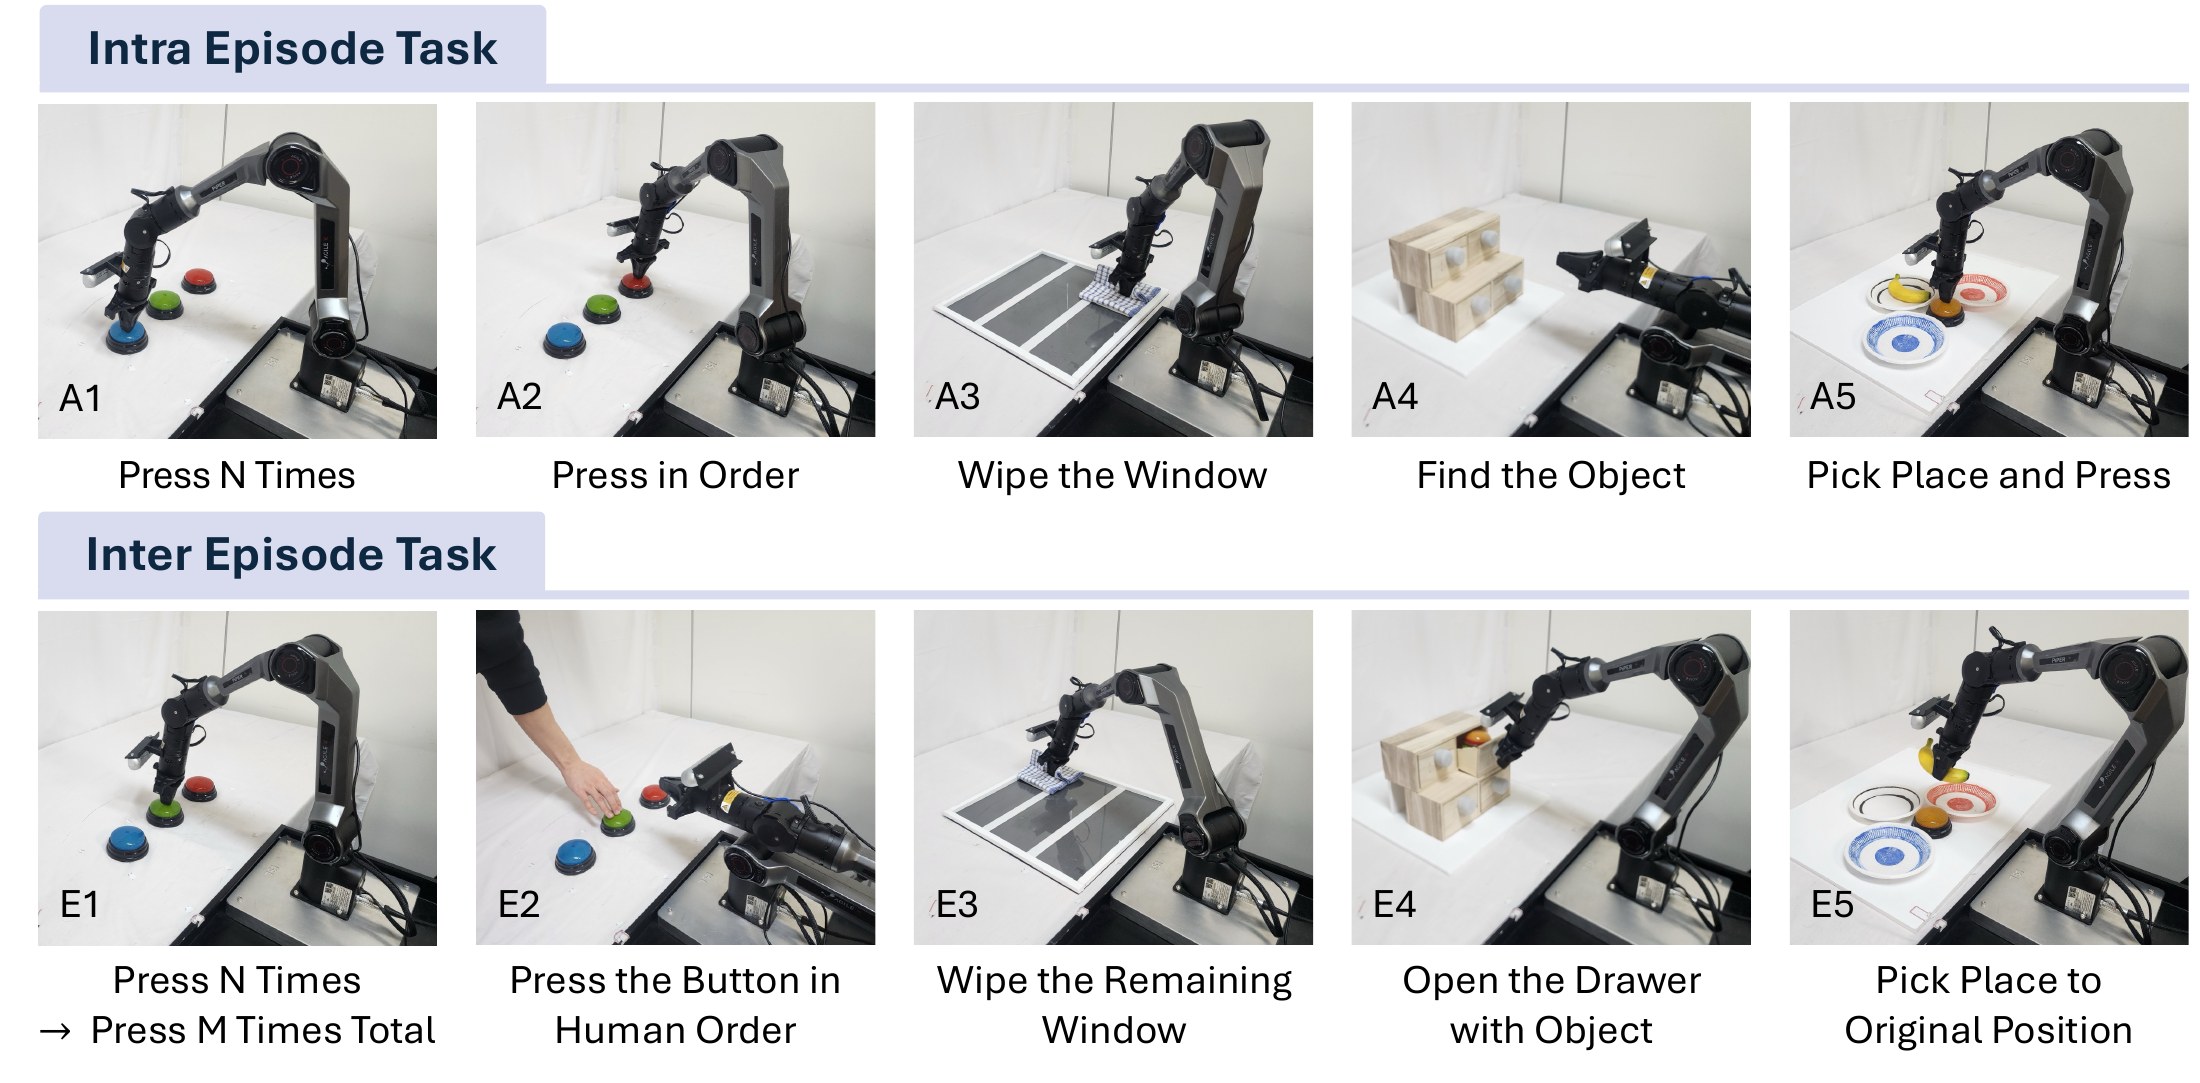
论文构建了 10 类真实任务、56 个变体,覆盖计数、顺序进度、遮挡或位移后的物体信息回忆。更重要的是,它明确区分了两种时间依赖。
4.1 Episode 内:当前指令之下不能忘
- A1 Press N Times:蓝色按钮恰好按 \(N\) 次后停止,\(N\in\{1,2,3\}\)。
- A2 Press in Order:按指定顺序操作红、绿、蓝按钮,覆盖 6 种排列。
- A3 Wipe the Window:依次擦下、中、上三个区域并停止。
- A4 Find the Object:按顺时针固定顺序搜索四个抽屉,直到找到玩具汉堡。
- A5 Pick, Place, and Press:在三个盘子间转移香蕉,中间插入按钮按压,覆盖 6 种路径。
4.2 跨 Episode:换了指令,仍然不能忘
论文将指令变化视为 episode 边界。边界处机器人回到初始姿态、工作记忆清空,但后续任务仍可能需要之前的信息:
- E1:先按 \(N\) 次,再要求“总共按 \(M\) 次”,需要算出还应按 \(M-N\) 次;
- E2:先观察人的按钮顺序,之后按相同顺序复现;
- E3:先擦部分窗格,之后只擦剩余区域;
- E4:先观察人打开有物体的抽屉并关闭,之后直接打开正确抽屉;
- E5:完成物体转移后,再把物体放回原始位置。
其形式化表达为:
其中 \(t_k\) 是当前 episode 的起点。只看当前 episode 的观测和指令不够,必须访问更早的观测与指令历史。HeLM 不必保留完整历史,而是用 \(m_t^{\mathrm{epi}}\) 保存与后续任务有关的摘要。
5. 实验结果:提升来自哪里,又还有什么没证明?
5.1 对比设置与评价指标
三类基线分别代表不同记忆路线:
- Keyframe-HLP:与 HeLM 共用 HLP 骨架和事件监督,但把检测到的原始 RGB 事件帧顺序堆起来,直接对比“文本记忆 vs 视觉记忆”;
- PCMB-\(\pi_0\):将 MemoryVLA 的 Perceptual-Cognitive Memory Bank 移植到 \(\pi_0\),使用 16 个 memory slots、512 维低维记忆和软更新率 \(\beta=0.01\);
- Naïve-\(\pi_0\):无显式记忆的基础 VLA。
所有方法使用相同 \(\pi_0\) 动作骨干,并按任务使用 150–200 条示范微调,以控制低层动作能力。每类任务评测 15–45 次试验,每个变体 5 次。主要指标是子任务成功率 \(N_{\mathrm{succ}}/N_{\mathrm{total}}\);顺序错误与终止错误另作诊断。论文还报告严格任务成功率:所有子任务必须完成、顺序正确且正常终止,才算一次成功。
5.2 Episode 内:不仅完成更多,也更会按顺序停止
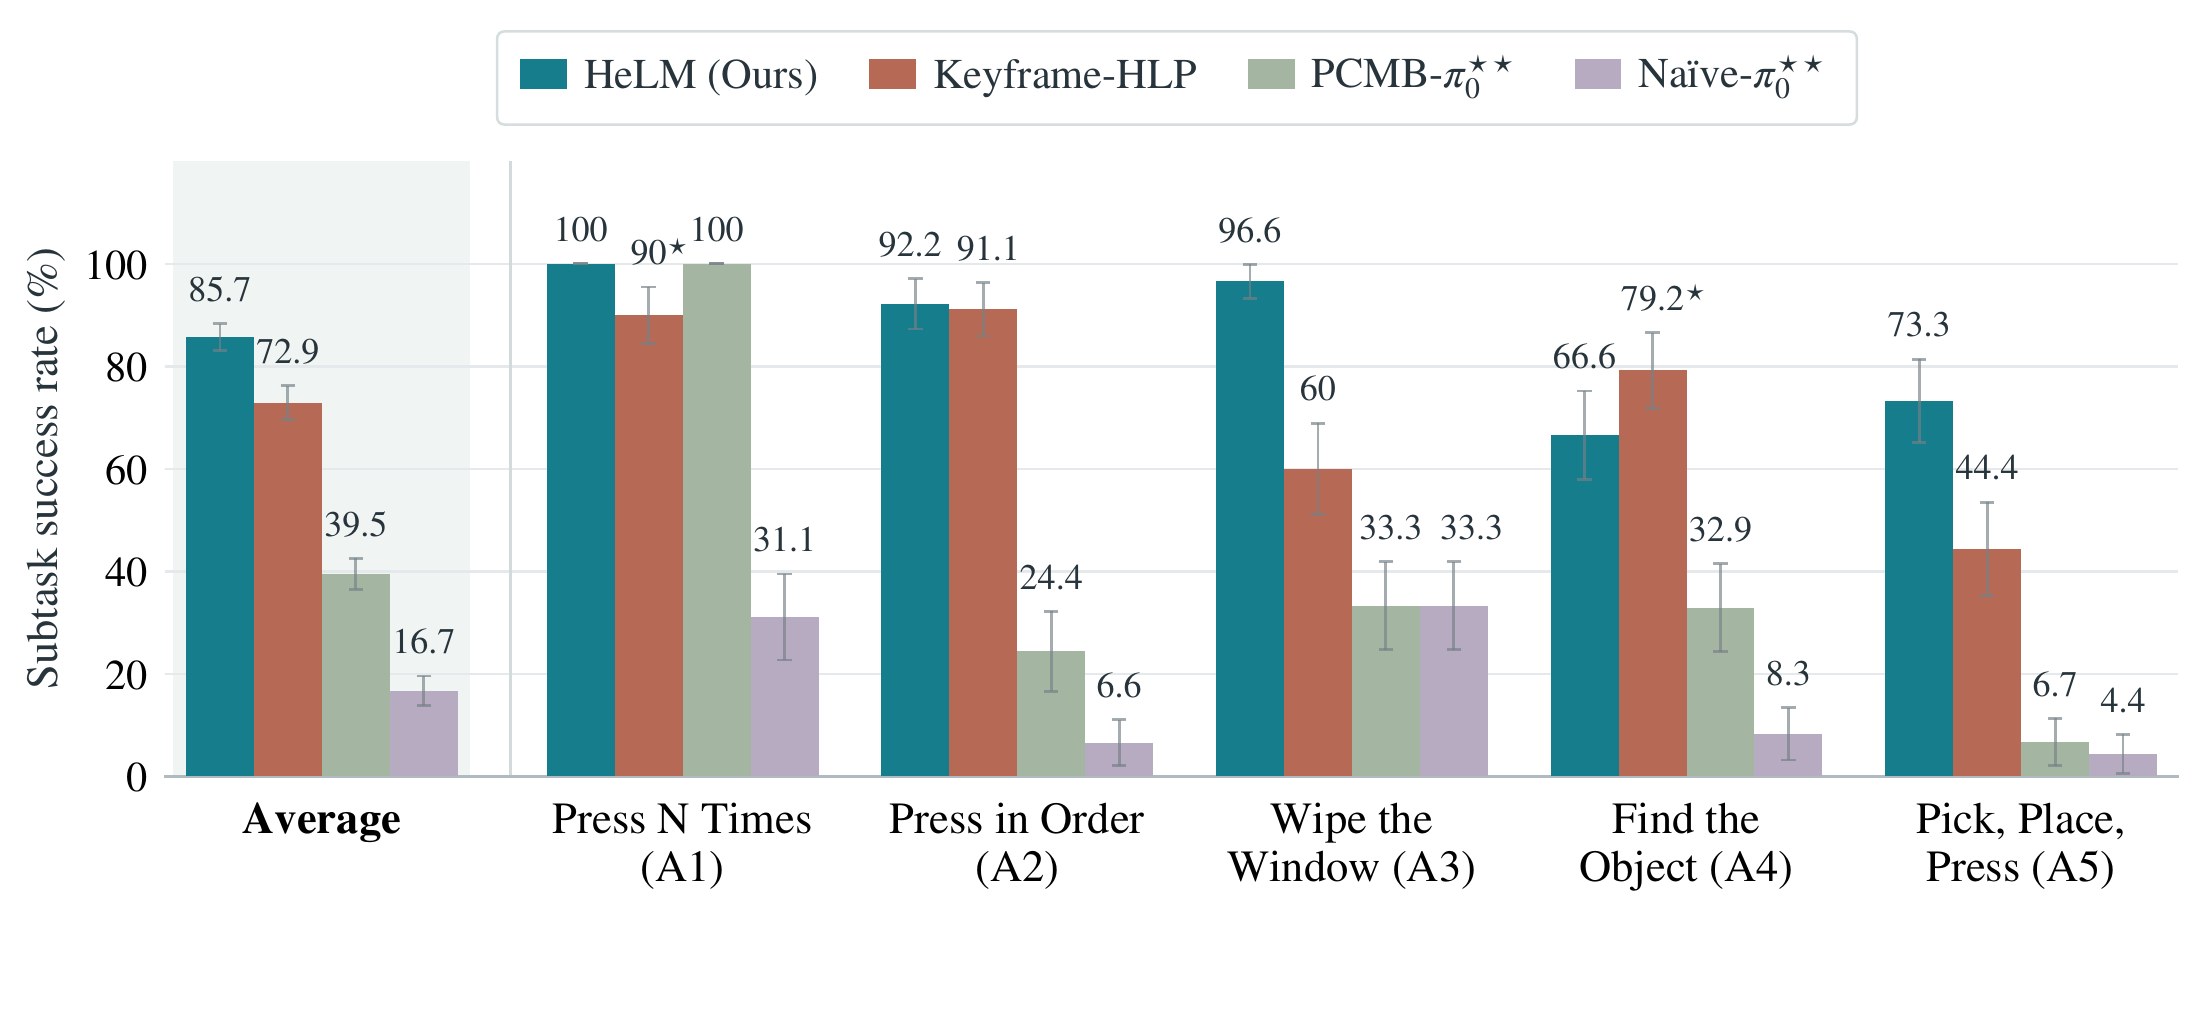
| 方法 | 平均子任务成功率 | 平均严格任务成功率 |
|---|---|---|
| HeLM | 85.7% | 81.3% |
| Keyframe-HLP | 72.9% | 29.3% |
| PCMB-\(\pi_0\) | 39.5% | 0% |
| Naïve-\(\pi_0\) | 16.7% | 0% |
HeLM 相比 Keyframe-HLP 提升 12.8 个百分点。更值得注意的是,它的子任务成功率到严格成功率只下降 4.4 个百分点,而 Keyframe-HLP 下降 43.6 个百分点。这说明视觉关键帧方案常能完成一部分动作,却容易在“顺序是否对、完成后是否停”上失守。
分任务看,HeLM 在 A1、A2、A3 分别为 100%、92.2%、96.6%;A4 和 A5 则为 66.6%、73.3%,仍是明显短板。Keyframe-HLP 在 A4 的子任务分数达到 79.2%,高于 HeLM,但存在终止失败;严格指标下其 A4 为 0%。因此,不能只看部分进度分数判断一个任务是否真正完成。
5.3 跨 Episode:语言摘要远强于不断堆积关键帧
| 方法 | E1 | E2 | E3 | E4 | E5 | 平均 |
|---|---|---|---|---|---|---|
| Keyframe-HLP | 27.6% | 0% | 33.3% | 0% | 22.2% | 16.6% |
| HeLM | 90.5% | 87.7% | 90.0% | 80.0% | 97.7% | 89.2% |
跨 episode 后,Keyframe-HLP 需要解释越来越多的历史图像,性能大幅退化;HeLM 则把旧进度总结成少量情景上下文,平均达到 89.2%。不过,这组结果只有 Keyframe-HLP 一个直接基线。PCMB-\(\pi_0\) 和 Naïve-\(\pi_0\) 因在边界重置内部状态、缺乏跨指令上下文机制而被排除。论文对此解释合理,但也意味着“89.2% 相对所有跨 episode 记忆方法的普遍优势”尚未被充分比较证明。
5.4 失败分析:HeLM 的瓶颈从“记忆逻辑”转向“看错与做错”
论文将失败分为低层执行、事件检测、顺序和终止四类。HeLM 的失败案例中,检测占 64.1%,低层执行占 31.2%,顺序占 4.7%,未观察到终止失败。若按附录的所有 trial 口径统计,检测失败率为 9.1%,低层失败率为 4.4%,顺序失败率为 0.7%;两组数字的分母不同,不应混用。
检测错误主要是假阳性:抽屉其实没开,却被判为已开;擦拭或复合操作尚未完成,却被判为完成。这类错误尤其危险,因为错误事件会立刻写入记忆,系统随后基于错误状态继续行动,缺少自我纠正。相反,低层执行失败若没有产生事件,系统还可能重复尝试。
Keyframe-HLP 的主要问题则是终止失败 33.3% 和检测失败 20.2%;PCMB-\(\pi_0\) 与 Naïve-\(\pi_0\) 主要出现顺序和终止错误。这个对比支持论文的核心判断:显式进度状态确实让长程顺序与停止条件更稳定,但它并未消除视觉感知和接触控制问题。
5.5 消融:不是“多一个高层模型”就能解决记忆
在 LIBERO-Mem 仿真上,所有层级方法都使用 \(\pi_{0.5}\) 作为 LLP,HLP 为 Qwen2.5-VL-7B;每个任务 100 条示范训练,20 次 held-out rollout 评测。
| 方法 | T1–T2 | T3–T8(持续状态跟踪) | T9–T10 | 平均 |
|---|---|---|---|---|
| \(\pi_{0.5}\) | 65.0% | 10.0% | 87.5% | 36.5% |
| HLP,无语言记忆 | 27.5% | 0% | 32.5% | 12.0% |
| HLP+记忆,不做任务微调 | 5.0% | 0% | 37.5% | 8.5% |
| HeLM | 67.5% | 45.8% | 87.5% | 58.5% |
无记忆 HLP 并没有因“层级更强”而获益,反而低于纯 \(\pi_{0.5}\);不微调 HLP 也无法可靠检测完成事件和构造记忆。这说明收益来自记忆接口与任务特定 grounding 的配合,不是简单增加模型容量。
真实任务上的两阶段消融同样明显:每次调用都联合预测事件、记忆和命令的一阶段版本只有 67.7%,两阶段 HeLM 为 85.7%。差距最大是 A3,分别为 22.2% 和 96.6%;一阶段更容易过早预测完成并写错记忆。不过,一阶段在 A4 上达到 86.8%,高于两阶段的 66.6%,说明该设计并非在每个任务上都占优。
5.6 组合泛化与长程效率
在训练配置之外的 A1′–A5′ 上,HLP 不做额外微调,测试更长计数、更长顺序、新物体和已学子任务的新组合。HeLM 平均子任务成功率为 78.0%,Keyframe-HLP 为 65.7%。HeLM 在新顺序 A2′ 上达 95.0%,但新擦拭顺序 A3′、新物体 A4′ 和新复合流程 A5′ 分别只有 67.0%、67.0%、61.0%,说明“能组合”还不等于“稳定泛化”。
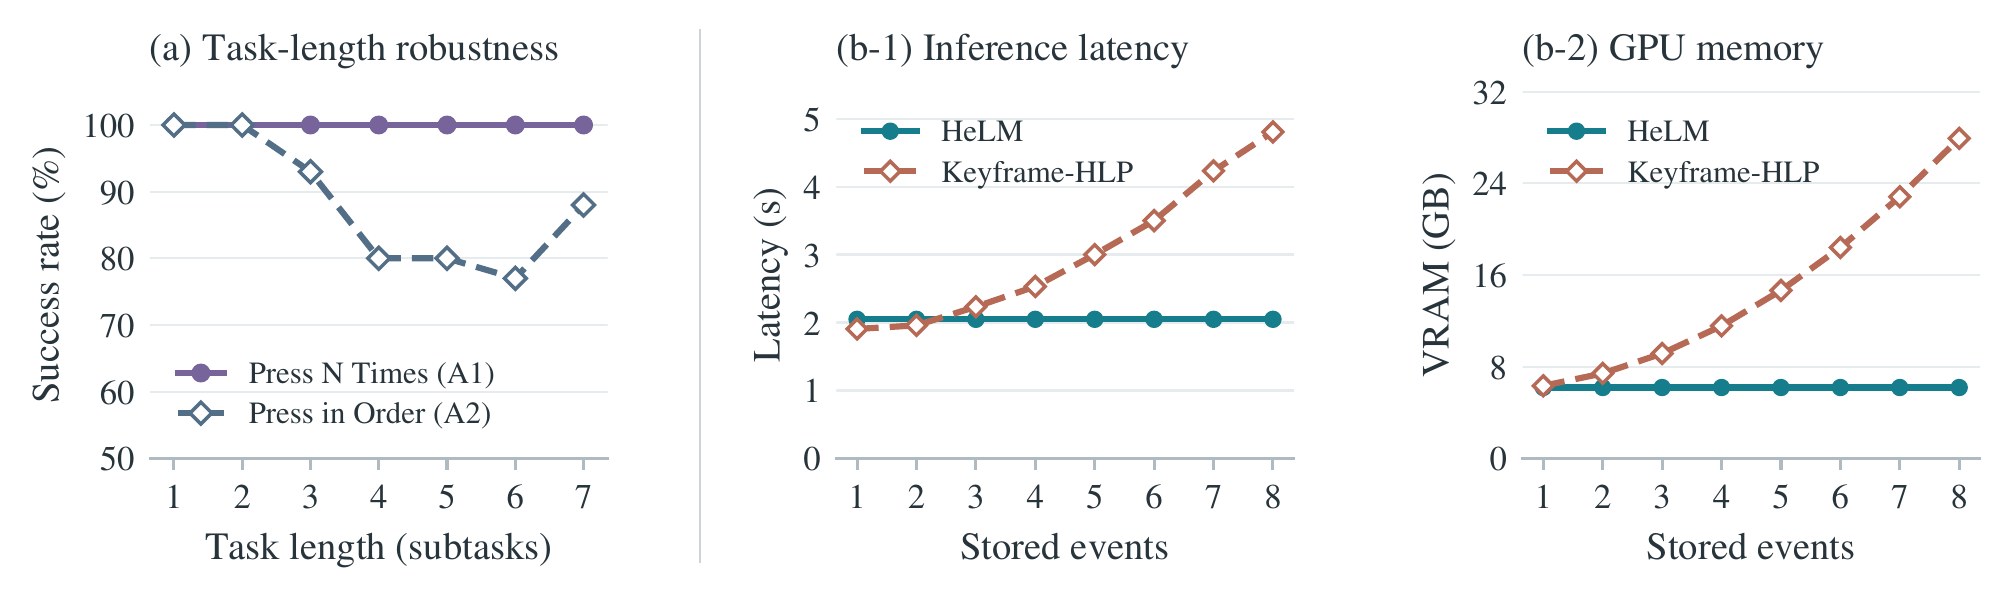
长程实验给出两条清晰趋势:
- A1 扩展到 7 次子任务仍保持 100%;A2 在长度 1–7 上依次为 100%、100%、93%、80%、80%、77%、88%,并非单调变化,但始终不低于 77%。
- 文本记忆的长度近似稳定,视觉关键帧则持续积累。8 个事件时,Keyframe-HLP 峰值显存约 28 GB,HeLM 低于 6 GB;长历史下 HeLM 的推理速度可达其 2.5 倍。
起初 HeLM 因自回归文本生成略慢;随着关键帧增加,视觉方案的延迟和显存近似线性上升,HeLM 曲线则基本平坦。需要注意,论文只测到 7 个子任务和 8 个事件,这证明了该范围内的良好趋势,不等于无限长任务都不会退化。
附录还给出小模型版本:SmolVLM-500M+SmolVLA-450M 将峰值显存从 13.18 GB 降至 2.3 GB,平均端到端延迟从 1.9 秒降至 0.7 秒,但平均成功率从 85.7% 降至 58.7%。主要问题反而是小 HLP 会生成非法 YAML 或一次改多个状态变量,说明语言记忆的可靠性仍依赖模型结构化生成能力。
5.7 仿真结果应该怎样读?
LIBERO-Mem 的分任务结果还揭示了语言记忆的适用边界。T1–T2 只要求回忆上一次动作,记忆负担很轻,HeLM 在 T1 上为 75%、高于 \(\pi_{0.5}\) 的 50%,但 T2 上为 60%、低于后者的 80%;当历史依赖很简单时,增加高层系统未必总是划算。T3–T6 要求跟踪 3、3、5、7 次重复操作,HeLM 的优势明显,但 T3 到 T6 也从 75% 降至 25%,说明即使高层计数正确,低层执行误差仍会随动作数积累。
T7–T8 的碗交换涉及随机初始位置与物体关系,HeLM 分别为 45% 和 10%。这表明“语言记忆+当前视觉”能保留一部分关系推理所需信息,却没有证明纯文本适合表达精细几何状态。T9–T10 的遮挡测试则有基准本身的问题:腕部相机还能看到篮子内部,无记忆 \(\pi_{0.5}\) 因而也能取得 85%–90%。所以,58.5% 的总平均分应被视为补充证据,真正支持核心论点的主要是 T3–T8,而不是所有任务都一致提升。
综合真实与仿真实验,一个更准确的判断是:HeLM 对计数、离散顺序、显式进度最有优势;对短历史任务、精细几何关系和依赖低层接触精度的任务,收益会受到其他瓶颈限制。这也让论文的分层失败分析比单一平均分更有价值。
6. 我的评价:最漂亮的是“状态接口”,最危险的是“错误写入”
HeLM 的贡献不只是又一个记忆模块,而是把机器人历史管理变成了一个显式状态接口:什么已经发生、当前做到哪一步、下一条命令是什么,都能直接读出。对调试真实机器人而言,这比一个不可见的 latent state 友好得多;对长程任务而言,事件摘要也避免了视觉上下文无限膨胀。
但这篇论文也留下了几个很重要的边界:
- 任务事件仍需预先定义。TaskSpec 告诉系统哪些事值得记,尚未解决开放环境中“自动发现该记什么”的问题。
- 离散事件强,连续状态未验证。液位、精确几何轨迹、力接触历史等连续量,未必适合当前文本字段。
- 错误检测会污染记忆。假阳性不是一次普通误判,而会成为后续推理的事实来源;论文没有给出置信度回滚、证据复核或记忆纠错机制。
- 同步 chunk 检测可能漏掉瞬态事件。更高频或异步 HLP 是合理方向,但又会增加成本。
- 双字段记忆本身缺少单独消融。论文明确承认,尚未证明“工作记忆+情景上下文”一定优于单个持久语言记忆。
- 比较范围仍有限。PCMB 是被移植到 \(\pi_0\) 的版本,不是原始 7B MemoryVLA;跨 episode 只与 Keyframe-HLP 做系统比较。LIBERO-Mem 的部分遮挡任务也被腕部相机“看穿”,并不完全是在考记忆。
如果沿这套框架继续往下做,我认为三个工程方向最直接。其一,为 Detect 输出增加置信度与证据复核:低置信事件只保留候选状态,下一帧确认后再提交,避免一次假阳性永久污染记忆。其二,将 Update 写成带模式校验的事务,例如限定每次只能修改哪些字段、计数只能如何变化;小模型出现非法 YAML 和多变量的现象,说明仅靠提示词约束还不够。其三,把同步 chunk 边界检测改成视觉变化驱动的异步调用,在平稳阶段保持低频,在接触、遮挡和指令切换附近提高频率,以兼顾漏检风险与计算成本。
这些改动都围绕同一件事:语言记忆本身只是载体,真正决定系统可靠性的是写入协议。当记忆可读之后,研究者第一次可以像调试数据库状态一样调试机器人任务进度;下一步则应让它具备一致性约束、版本回滚和错误恢复,而不只是生成一段看起来合理的文本。
因此,最稳妥的结论不是“语言记忆已经解决机器人长期记忆”,而是:当任务能被离散成可靠事件,且该记忆的事实可预先定义时,显式语言是一种非常有效的任务状态表示。 HeLM 用真实机器人结果证明了这个条件的实用价值,也把下一步问题清晰地推向了开放事件发现、鲁棒检测和可纠错记忆。
7. 总结
HeLM 用三项设计把 VLA 从“只看现在”推进到“记得过去”:高低层分离,让语义状态与动作执行各司其职;工作记忆与情景上下文分工,让信息既能服务当前进度,也能跨指令保留;Detect/Update 两阶段与事件触发机制,则让记忆只在有语义依据时变化。
它的结果足够有说服力:85.7% 的 episode 内子任务成功率、81.3% 的严格成功率、89.2% 的跨 episode 平均成功率,以及长历史下更低的显存和延迟。同时,A4/A5 的失败、小模型上的结构化更新错误和 TaskSpec 的人工先验也提醒我们:真正难的不是“把历史写成文字”,而是始终写对,并在写错之后能够发现和修正。
本文基于 arXiv:2611.02660 v1 的论文正文、附录与原始图表整理。