记忆不该只是一堆事实:EvoMemState 让个人 Agent 学会“现在该怎么用”
你有没有遇到过这样的个人 Agent:你上个月说喜欢徒步,这个月改口说想去海边,它却把两个偏好揉成一句“你既喜欢徒步也喜欢海边”;或者你明明在问采购评测,它却拿你过去随口表达的产品偏好来替你做决定。
问题不一定是它没记住。更可能的是,它记住了太多孤立的事实,却不知道这些事实之间谁更新了谁、谁和谁冲突,也不知道在当前请求里该听谁的。
核心摘要:EvoMemState 把个人记忆从“事实集合”改成“事实加状态”。持续保存的 Relational State 记录事实的有效性、适用范围、更新与冲突关系;针对每次请求生成的 Reasoning State 则用动态规则告诉回答模型该采用哪条证据、赋予什么角色、排在什么优先级。后者由约 60K 问答—记忆样本和 GRPO 训练。四套基准上,Qwen3-8B 的综合均分达到 59.9,最强基线为 53.6;MemSyco-Bench 达到 57.6,比最强基线高 12.2 个点。我觉得这篇论文最有价值的不是又画了一张记忆图,而是把“记住了什么”和“此刻该怎样使用记忆”拆成了两个可优化的对象;不过,它的离线训练、图构建成本和条件子集评测,也留下了不少需要继续验证的地方。
论文信息
- 标题:EvoMemState: Evolving Memory State for Personal Agents
- 作者:Zhishang Xiang、Yunbo Tang、Zhongqiao Liu、Junkai Chen、Zerui Chen、Qingguo Hu、Yuxuan Zhang、William Grant、Qinggang Zhang、Jinsong Su
- 机构:厦门大学、南洋理工大学、英属哥伦比亚大学、滑铁卢大学、吉林大学
- 提交日期:2026 年 11 月 2 日
- 论文:https://arxiv.org/abs/2611.03743
- 代码:https://github.com/XMUDeepLIT/EvoMemState.git
一、检索到事实,离正确使用还差两步
传统长期记忆系统的流水线很顺:对话来了,抽取事实;问题来了,向量检索;把命中的事实塞进提示词,回答。
这条链路默认了一个很强的假设:事实被检索到以后,它当前是否成立、在什么范围成立、和其他事实是什么关系,模型自己会弄明白。
现实没这么省心。新偏好会覆盖旧偏好,两条记忆可能仍未消解地冲突,一条只适用于家庭出行的偏好也不该渗透到工作采购里。EvoMemState 把问题拆成两个缺口:证据没有连完整,以及证据完整以后仍然用不对。
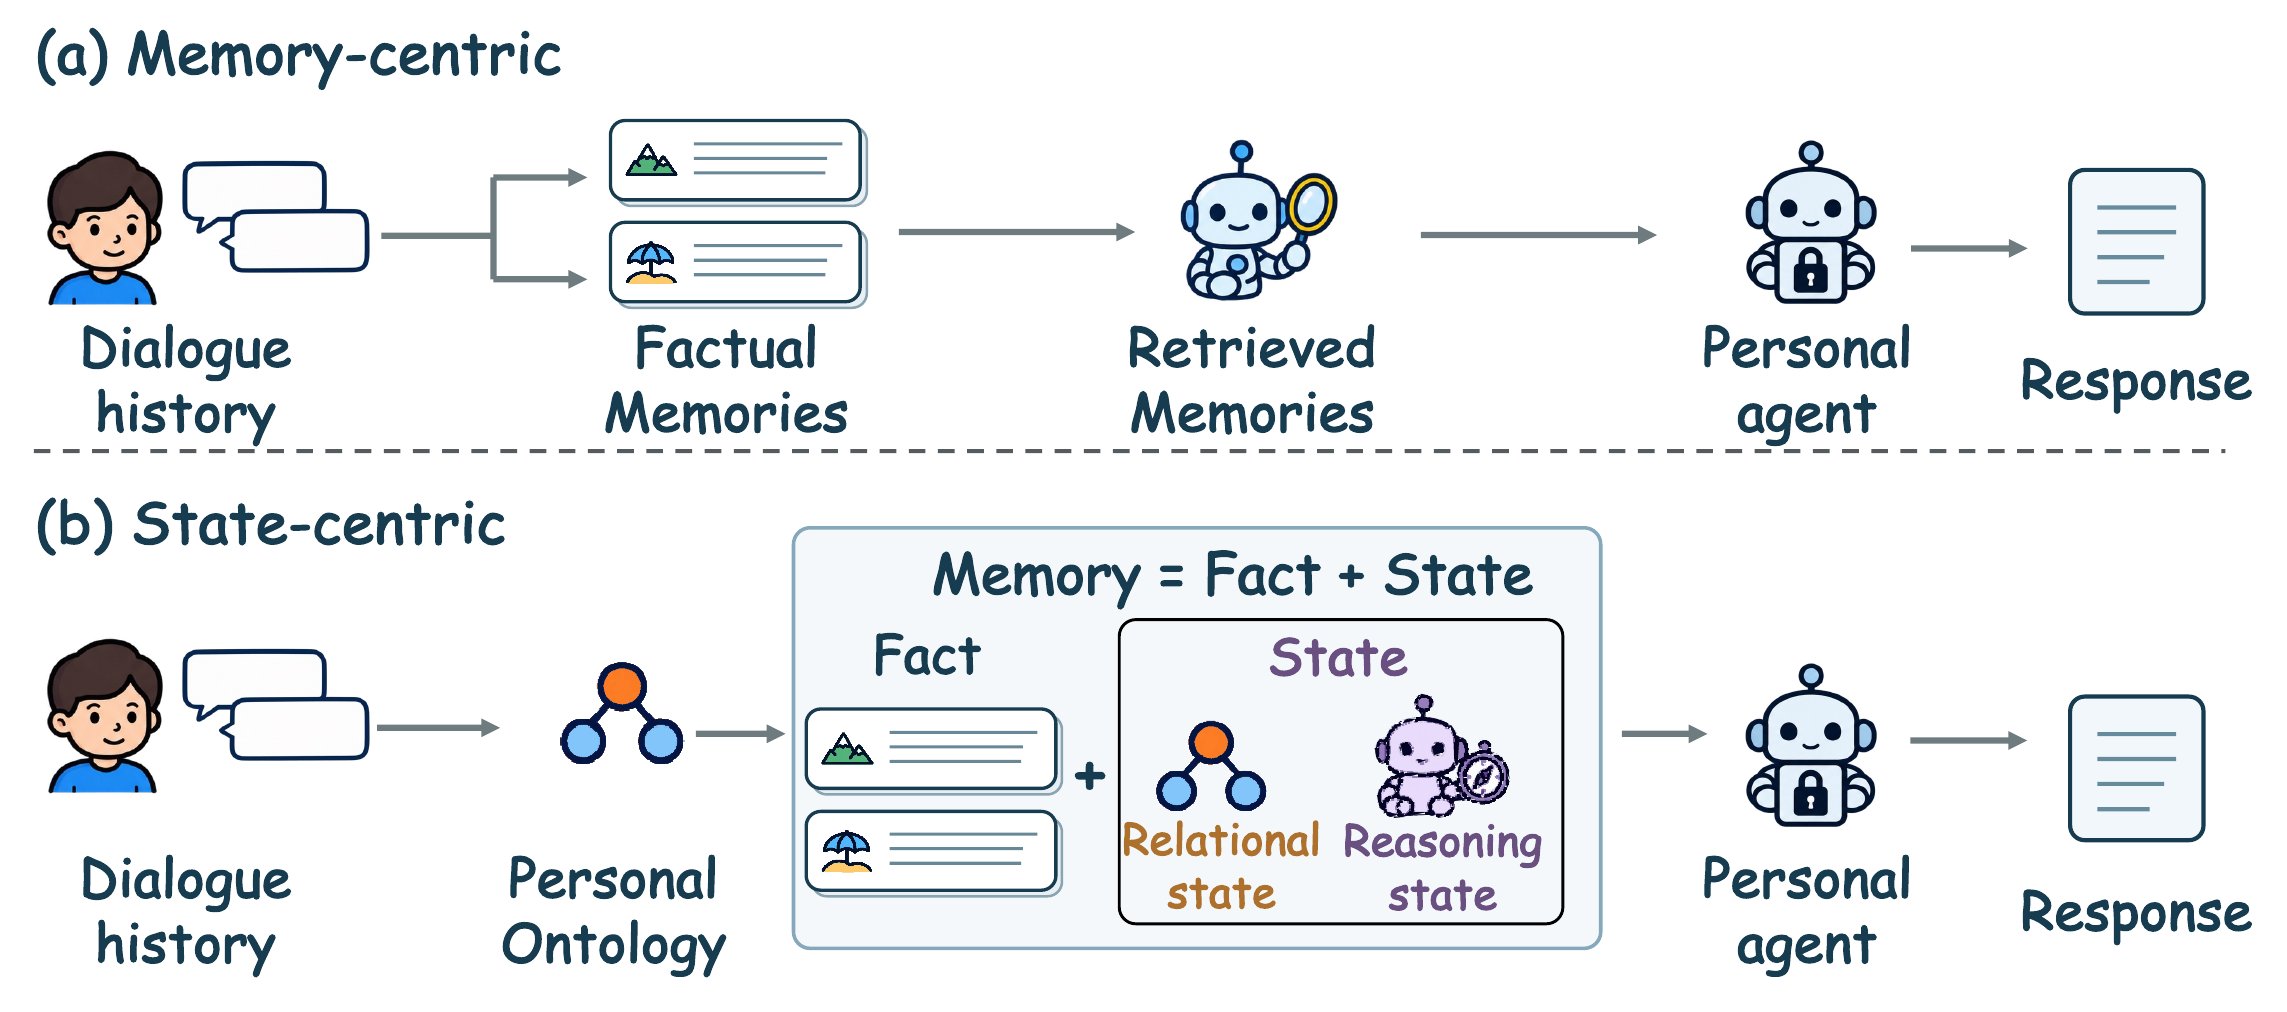
图 1:上半部分是常见的“对话—事实—检索—回答”链路;下半部分把记忆改写为 Fact + State。Relational State 持续描述事实间关系,Reasoning State 针对当前请求指导使用。注意,事实并没有被状态替代,原始事实仍然保留。
1.1 第一个缺口:检索命中,不等于证据齐全
作者在 MemSyco-Bench 的 Valid Memory Selection 子集上做了预实验。这里的问题必须联合存在更新、冲突或约束关系的多条记忆才能答对,正适合检验“单条相似度检索”的短板。
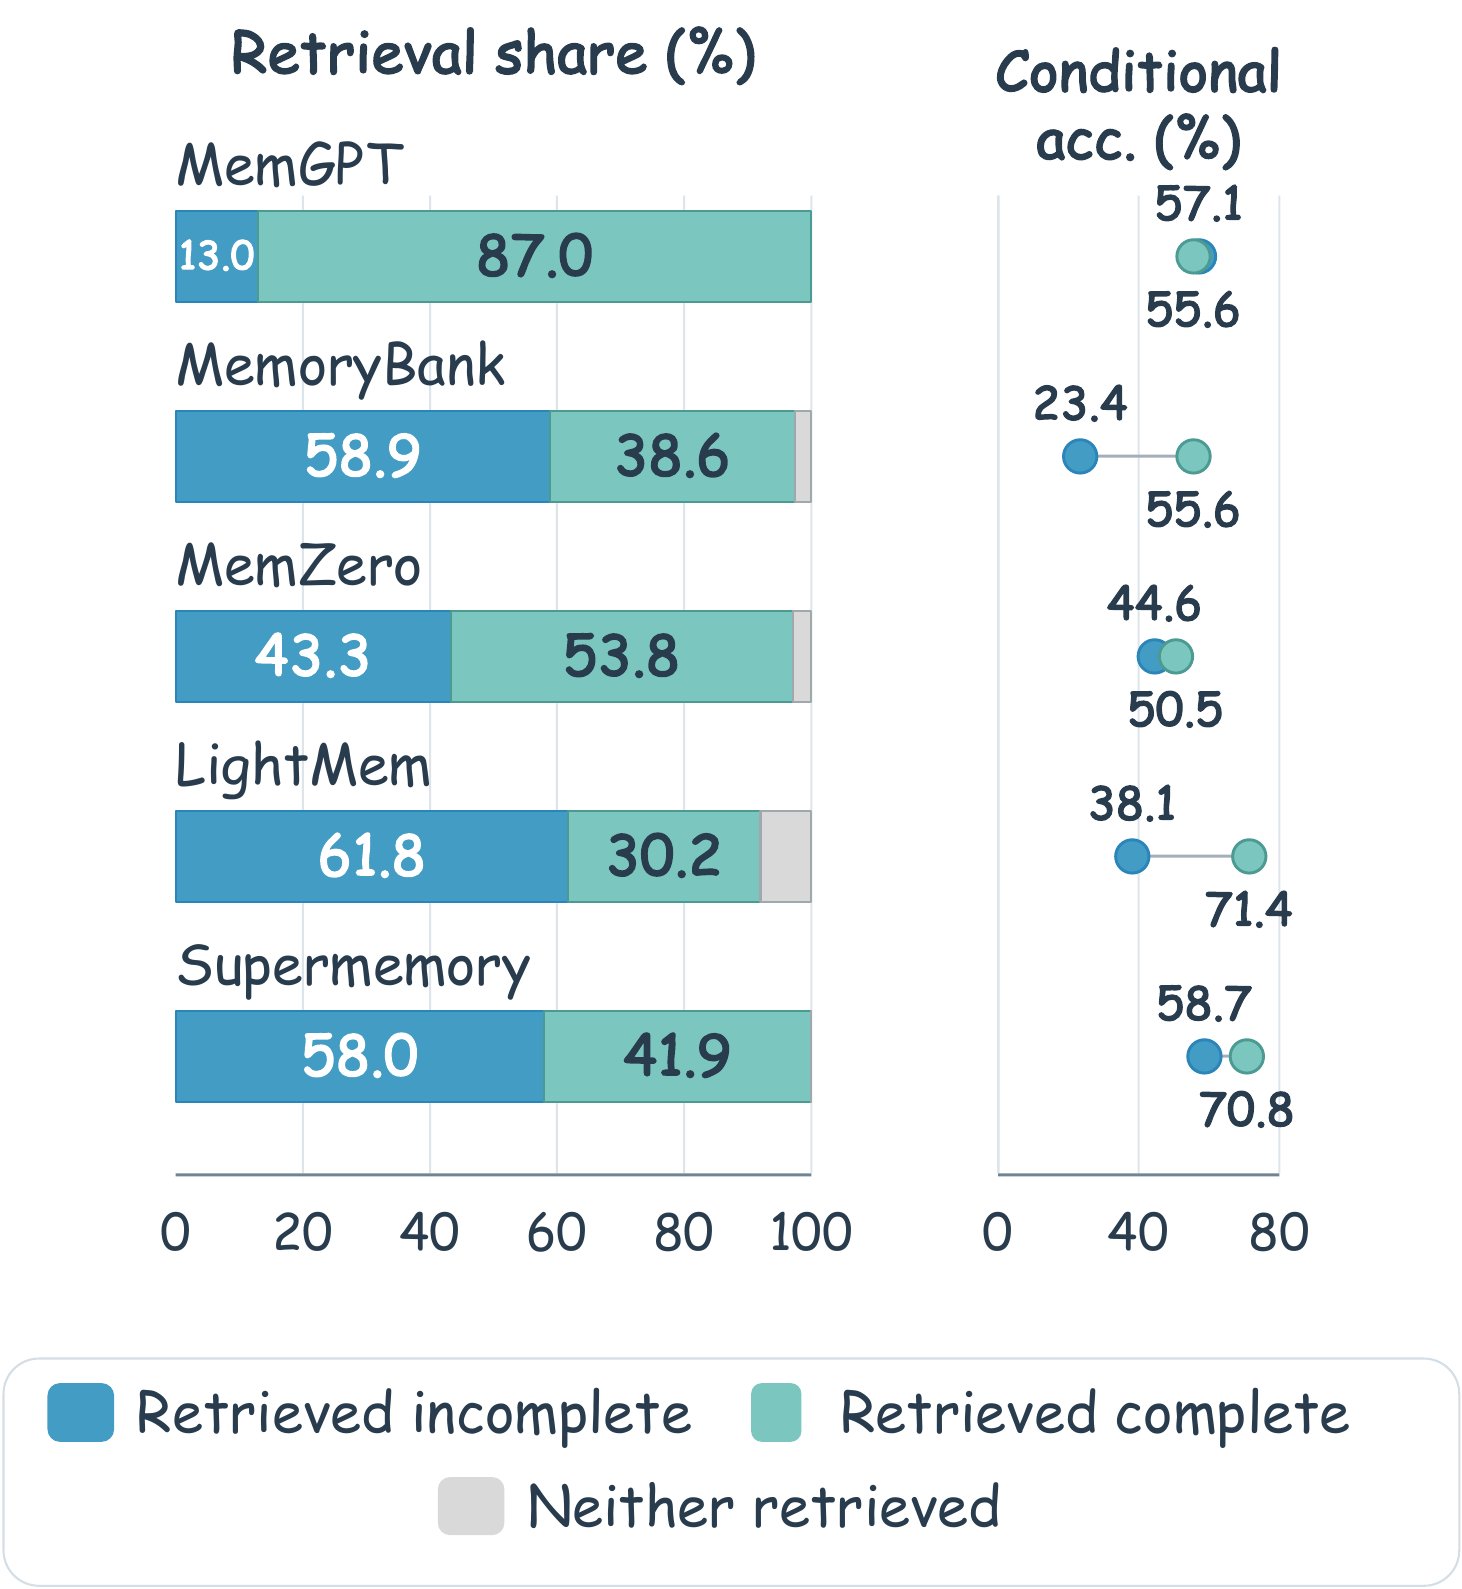
图 2:左侧深色表示证据未完整检索,浅绿色表示完整检索,灰色表示两类证据都未取回;右侧比较两种条件下的回答准确率。MemoryBank、LightMem、Supermemory 分别有 58.9%、61.8%、58.0% 的样本没有完整取回相关记忆。
结果很直观:在五个受测系统中,有四个系统在证据完整时的准确率高出 5.9 到 33.3 个点。LightMem 从不完整证据下的 38.1 升到完整证据下的 71.4,差距尤其大。
所以,只优化 embedding 或 top-k 并不够。查询可能只和“喜欢海边”相似,却必须顺着更新关系带回“过去喜欢徒步”,再带上时间和有效性,回答才有可靠上下文。
1.2 第二个缺口:证据全了,模型还是可能站错队
那把所有证据都给它,再加一句“请反思该怎样使用这些记忆”,能不能解决?
作者的答案是否定的。固定 self-reflection 让多数系统原地踏步,甚至倒退:平均准确率从 50.5 降到 48.9,Mem0 降幅最大,为 1.6 个点。
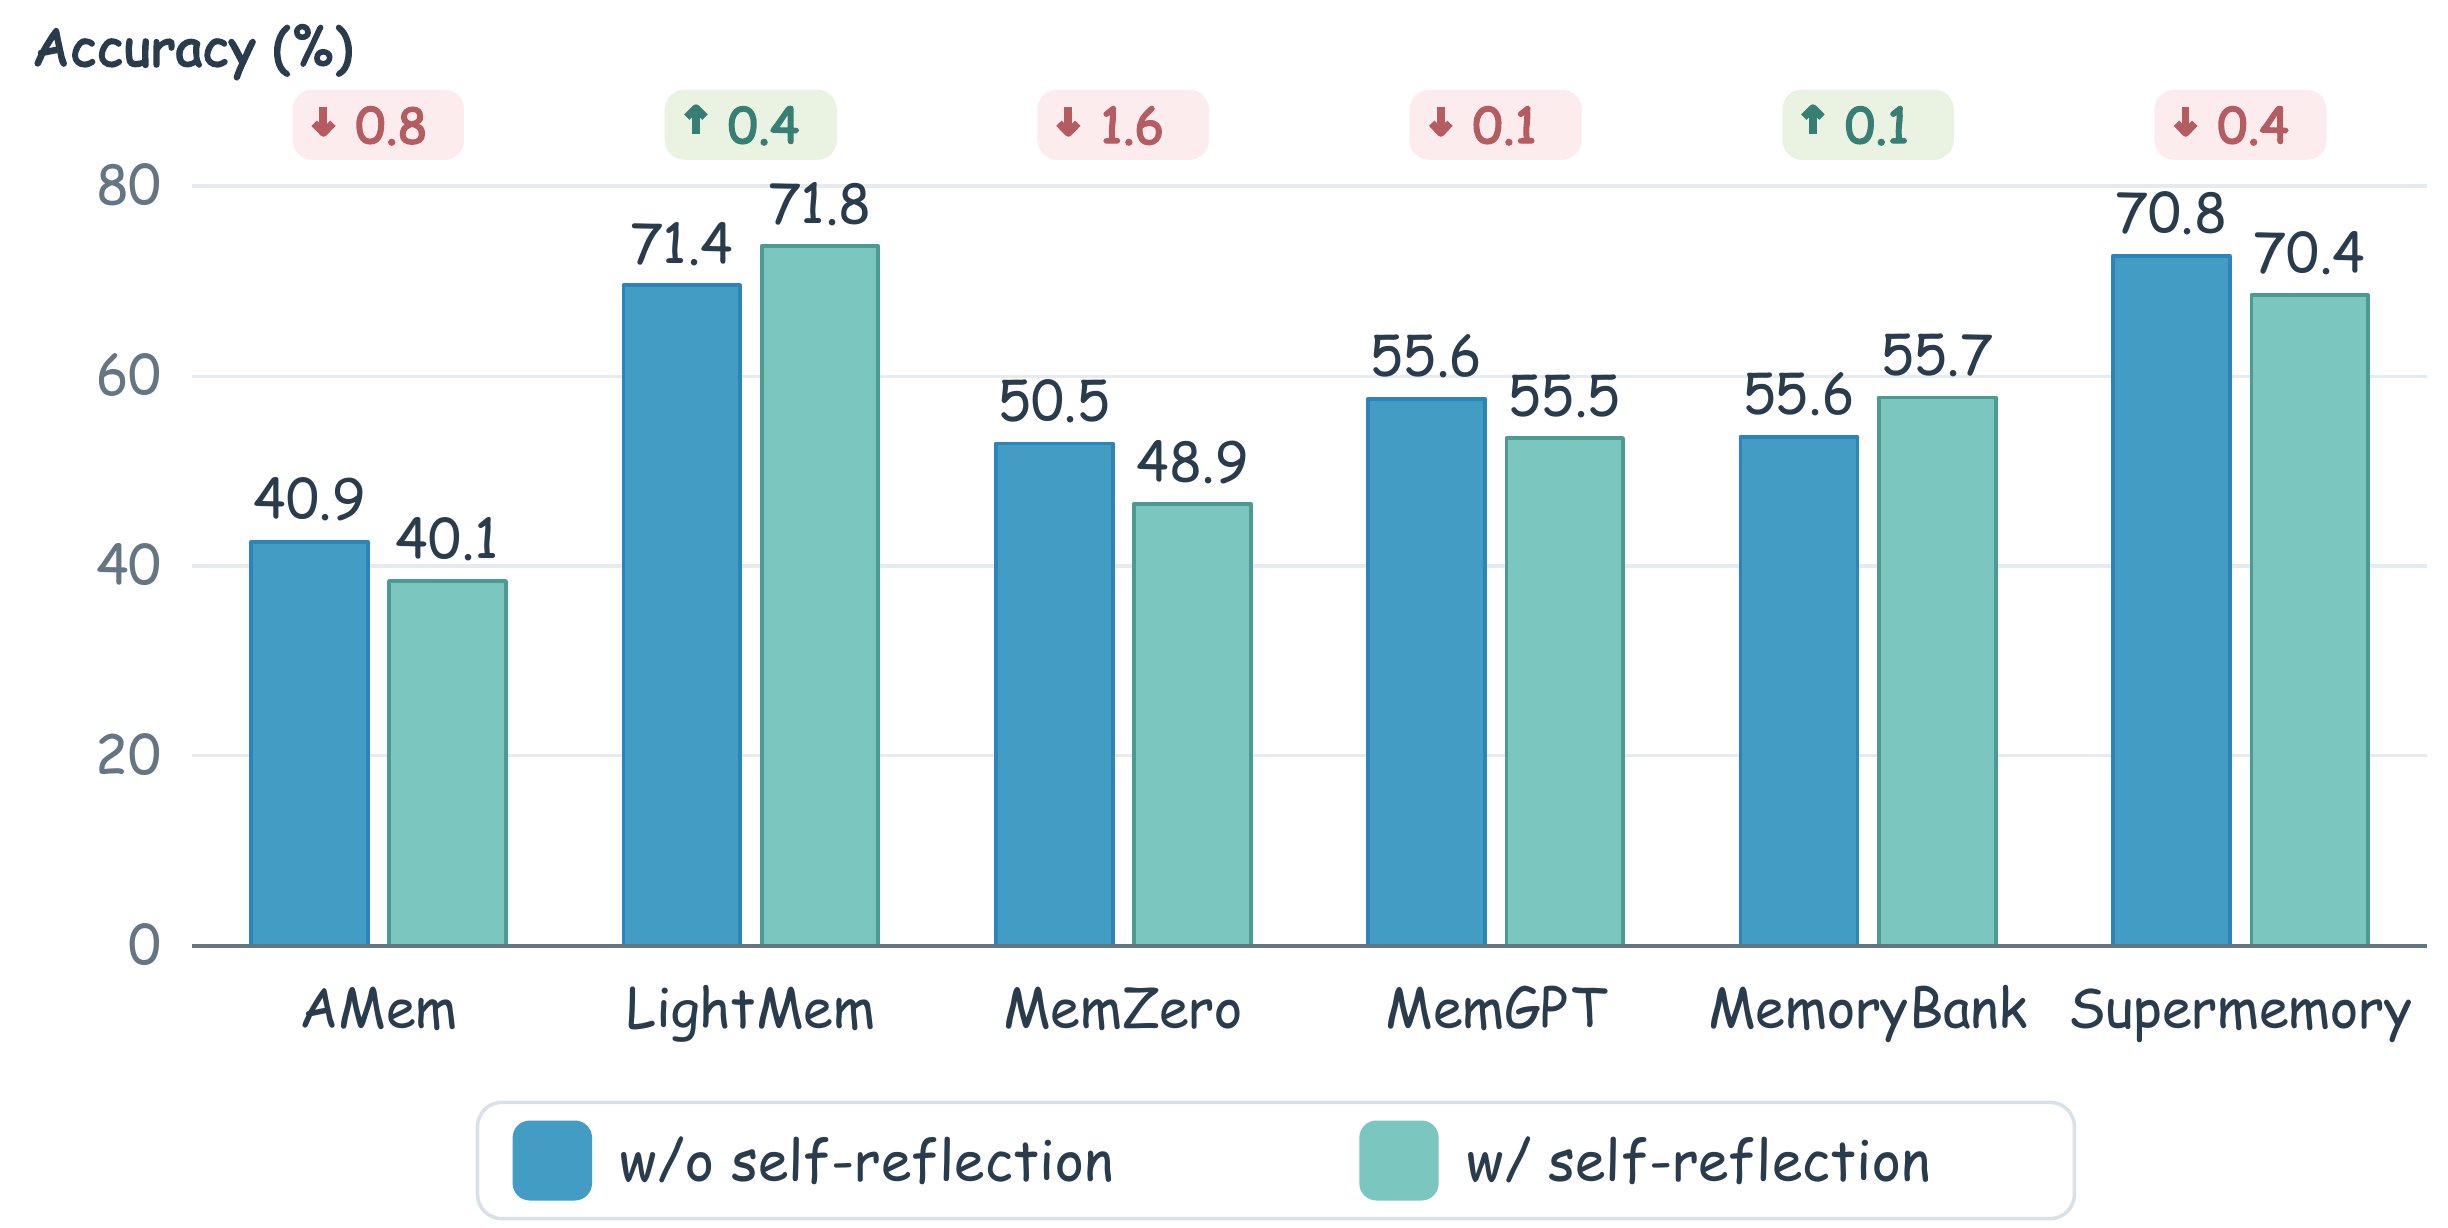
图 3:六组柱子比较无反思与固定反思。A-MEM 下降 0.8 个点,Mem0 下降 1.6 个点,MemGPT 下降 0.1 个点,Supermemory 下降 0.4 个点;LightMem 和 MemoryBank 只分别增加 0.4、0.1 个点。
看到这个结果我其实挺赞同作者没有继续堆提示词。泛泛地说“请仔细检查记忆”,没有告诉模型当前任务究竟应优先考虑最新偏好、客观评测还是适用范围。反思只是一个额外生成步骤,不是一条学会了做选择的策略。
二、EvoMemState:把记忆拆成事实、关系状态和推理状态
整套系统可以先记成一句话:原始事实负责留痕,Relational State 负责解释事实现在如何成立,Reasoning State 负责决定这次回答怎么用。
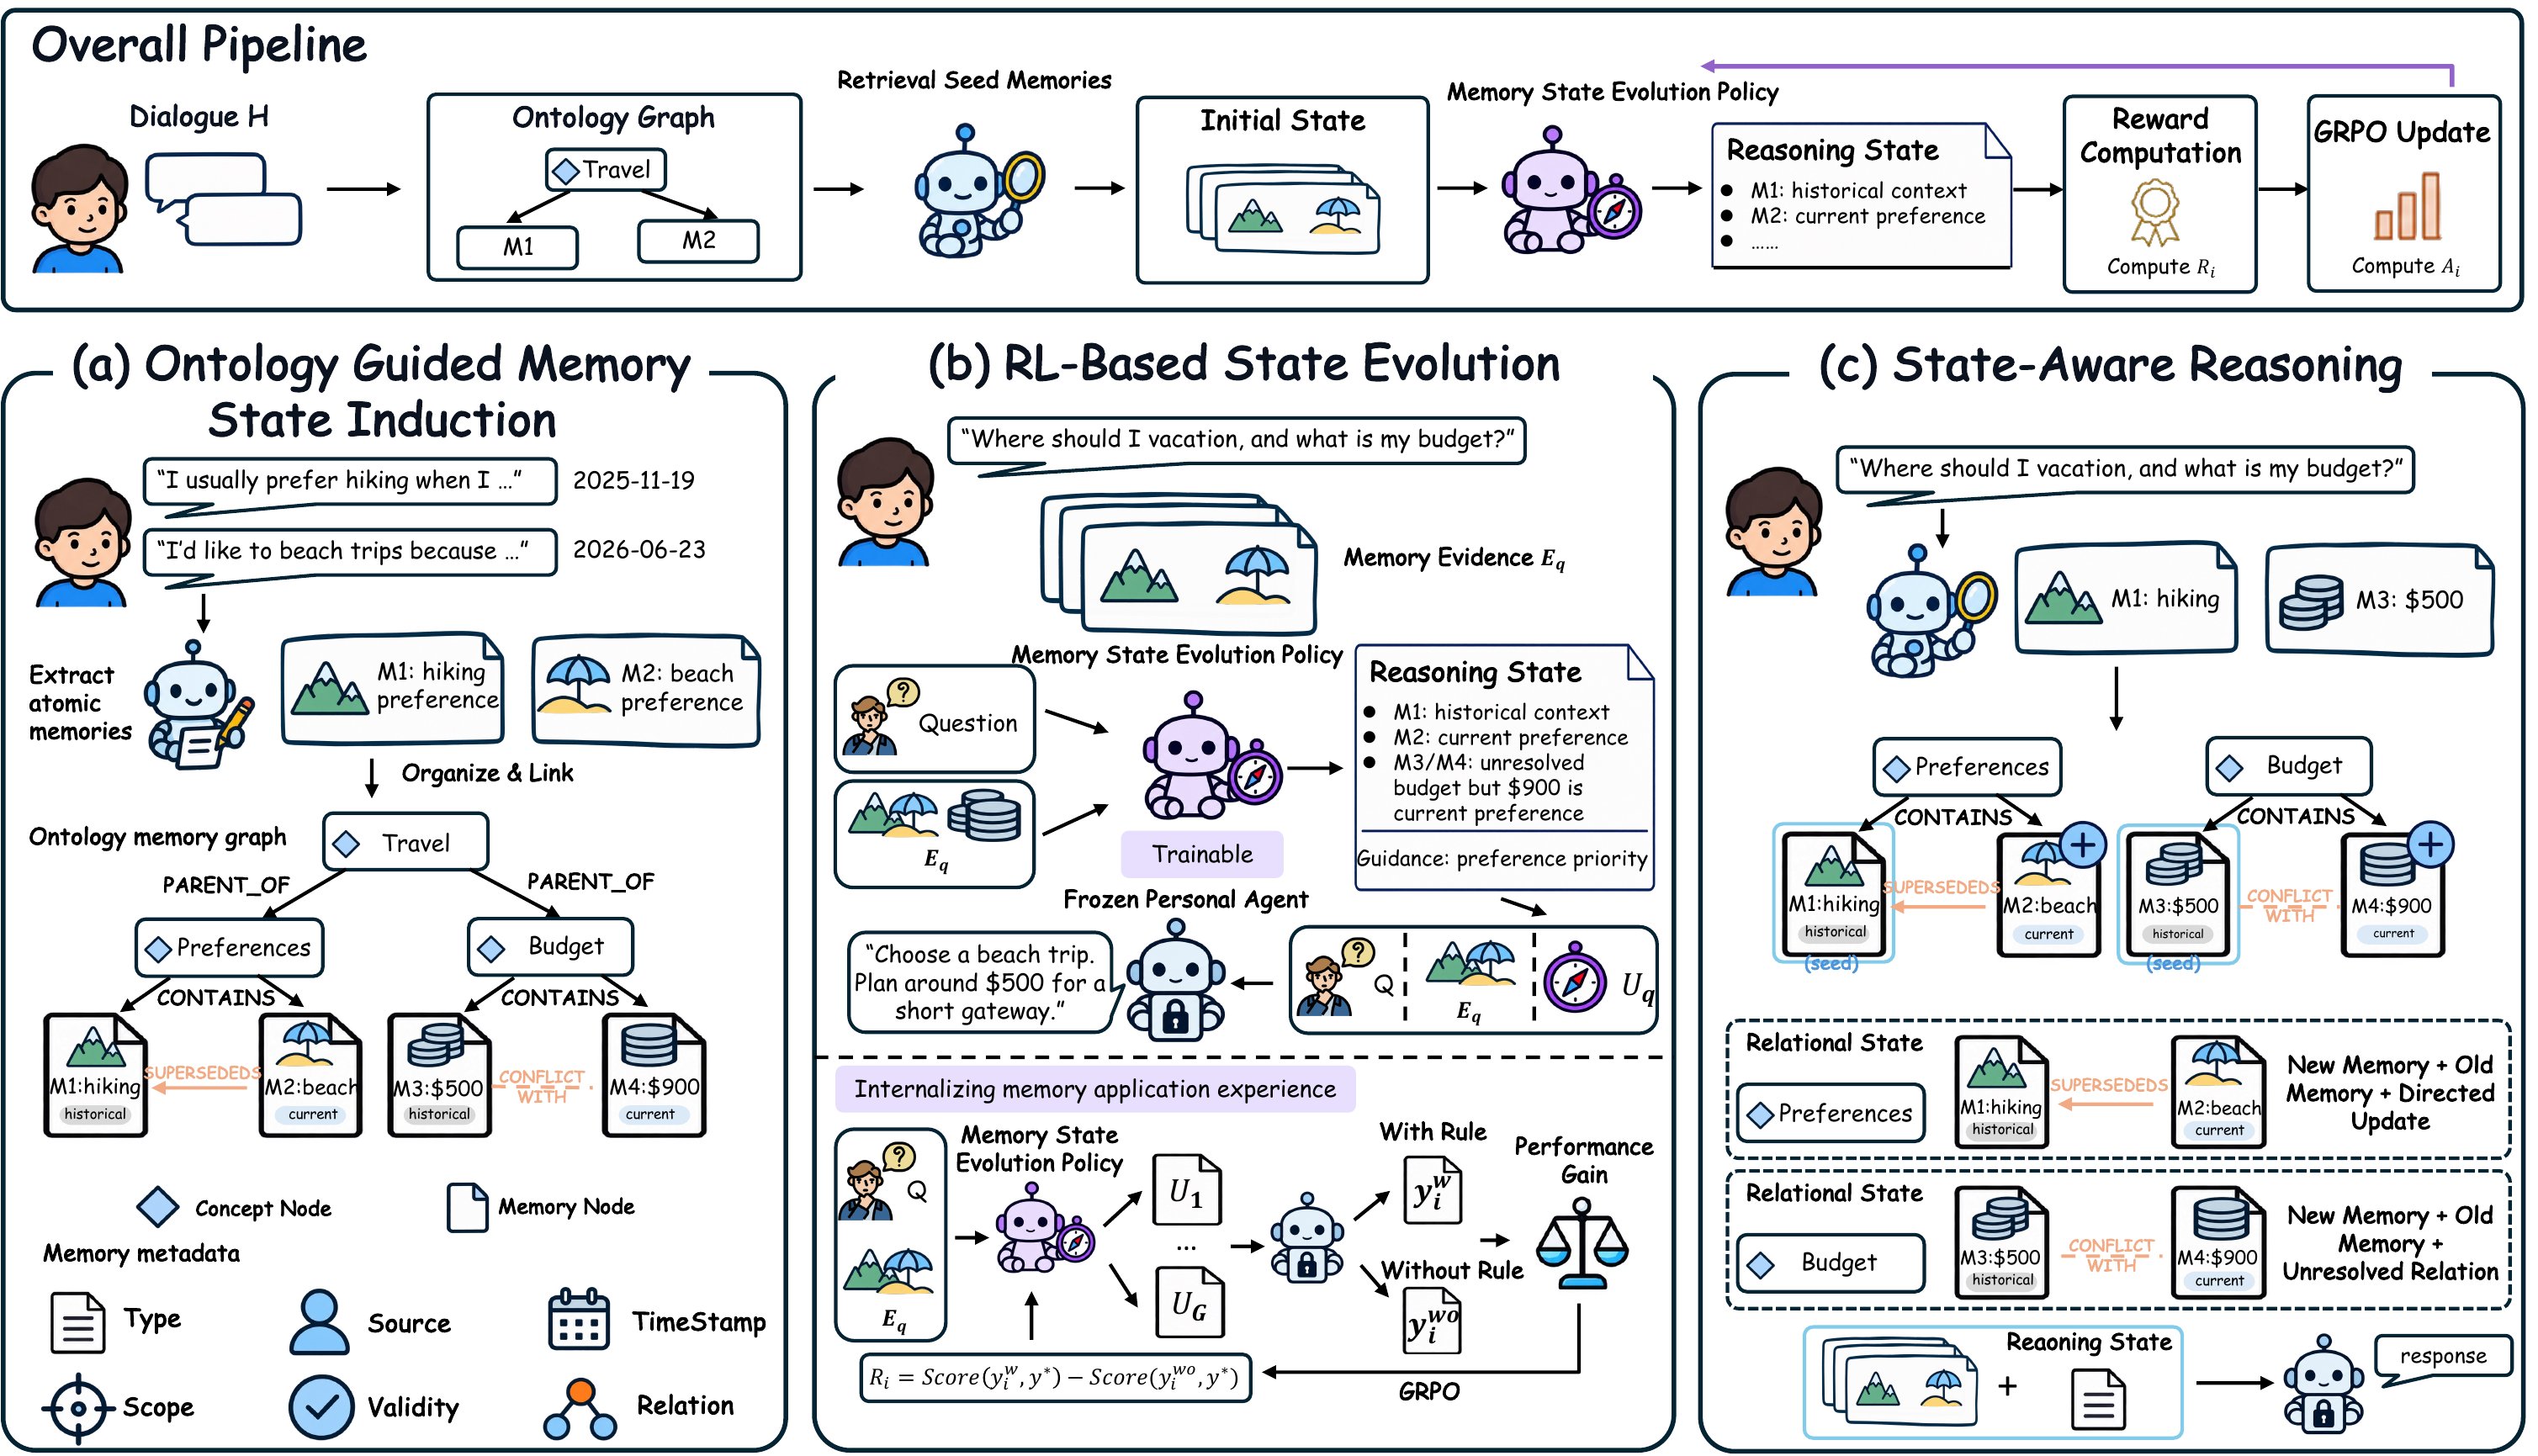
图 4:左侧面板从对话抽取原子记忆并构建本体图;中间面板训练 Memory State Evolution Policy,用有规则与无规则回答的得分差构造奖励,再做 GRPO 更新;右侧面板在推理时做种子检索、关系扩展、动态规则生成和状态感知回答。图中的旅行例子同时保留了徒步旧偏好、海边新偏好,以及 500 美元与 900 美元之间的未解决预算冲突。
三个概念放在一张表里更清楚:
| 组成 | 生命周期 | 记录或生成的内容 | 回答时的作用 |
|---|---|---|---|
| Persistent Facts | 持续保存,不被后事实覆盖 | 原子命题、来源轮次、证据片段、时间、限定条件 | 提供可追溯的原始信息 |
| Relational States | 跨请求持续存在,随新对话演化 | 当前有效性、适用范围、概念归属、更新与冲突关系 | 把相关事实组织成完整证据 |
| Reasoning State | 每个请求临时生成 | 2—4 条动态规则,说明证据适用性、角色与优先级 | 指导回答模型正确使用证据 |
这个划分比“再加一层摘要”更有意思。摘要通常会压缩历史,Reasoning State 则保留原证据,只在旁边加一份针对当前任务的使用说明。回答模型仍能核对事实,不必把动态规则当成新的真相来源。
2.1 本体引导的状态归纳:旧事实不删,有效性单独更新
对截至第 \(t\) 轮的对话,系统抽取有序事实集合 \(\mathcal{F}_t=\{f_1,\ldots,f_{N_t}\}\)。每条事实只表达一个命题,同时保留来源、时间和证据片段。
新事实按时间顺序进入本体图:
图里有概念节点和事实节点。PARENT_OF 组织概念层级,CONTAINS 把事实挂到最具体的概念下;SUPERSEDES 表示更新,CONFLICTS_WITH 保留尚未解决的冲突。
每条事实 \(f_i\) 对应一个关系状态:
其中,\(a_i^t\) 是当前有效性与范围,\(\rho_i^t\) 是概念归属及它和其他事实的关系。旧偏好被取代时,系统修改的是 \(a_i^t\) 和 \(\rho_i^t\),不是把 \(f_i\) 抹掉。这一点很关键:回答“我现在喜欢什么”与“我过去喜欢什么、何时改变”需要的是同一份可追溯历史,而不是覆盖后的单行资料卡。
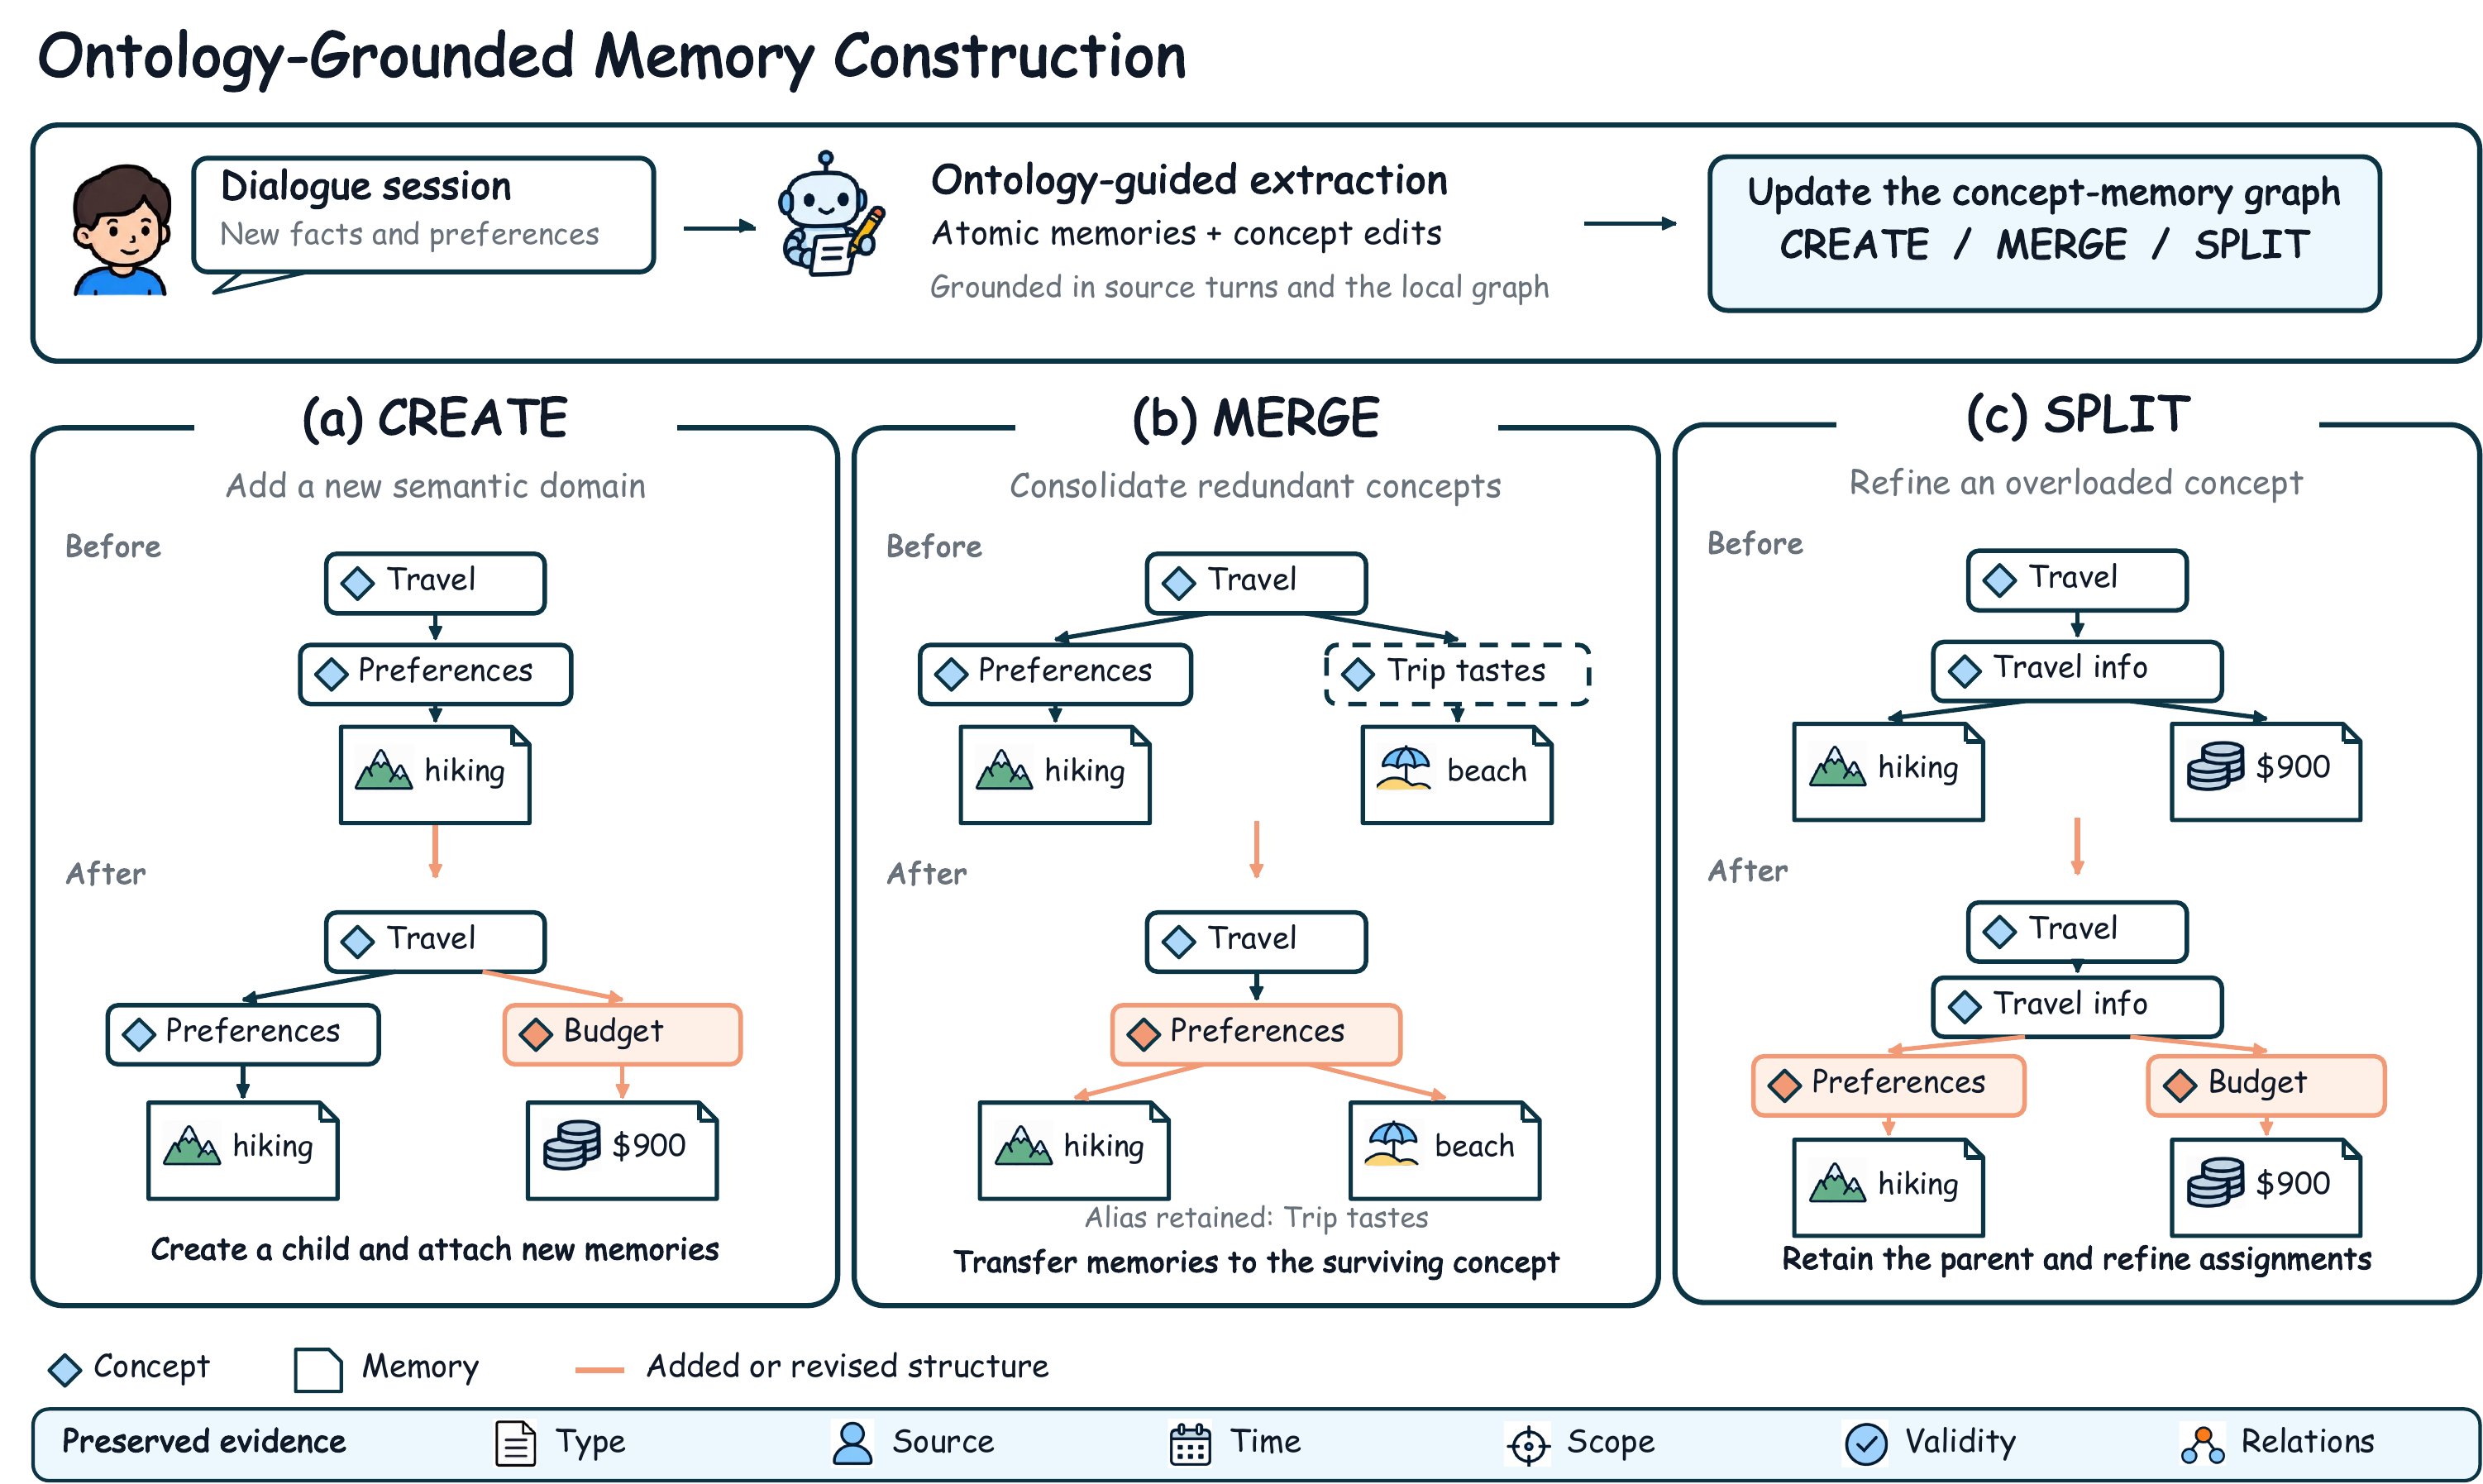
图 7:CREATE 为新语义域增加子概念,例如给 Travel 增加 Budget;MERGE 合并 Preferences 与 Trip tastes 这样的重复概念,同时保留别名;SPLIT 把过载的 Travel info 细化成 Preferences 和 Budget,并重新分配事实。底部列出的来源、时间、范围、有效性与关系都会随证据保留。
实际构建不是把整张大图反复塞给模型。每个新会话只取相关本地分支,包含相邻概念、代表性事实及关联边,再让模型提出最小图修改。提交前还会校验事实是否能在对话中找到依据、关系端点类型是否兼容、更新关系是否无环,以及每个非根概念是否只有一个父节点。
工程上这是个稳妥设计,但也要看到风险:校验能保证图结构合法,不能保证抽取语义一定正确。一旦 SUPERSEDES 被误连,后续遍历会把错误关系当成事实传播下去。
2.2 用 GRPO 学“记忆使用规则”,而不是训练回答模型
关系状态解决“有哪些证据”,还没有解决“该听谁的”。EvoMemState 为此单独训练一个策略模型 \(\pi_\theta\),输入请求 \(q\)、相关事实 \(\mathcal{F}_q\) 和关系状态 \(\mathcal{R}_q\),输出 Reasoning State:
训练时,同一个请求会采样 \(G\) 份候选动态规则。每份规则都交给同一个冻结的 Qwen3-8B 回答模型,记忆证据保持不变。第 \(i\) 份候选的奖励是:
我喜欢这个奖励的地方在于,它直接问“加了这份规则,答案有没有变好”,而不是让另一个模型评价规则读起来是否合理。格式错误和泄露参考答案还会受罚。
GRPO 再把同组候选奖励归一化得到相对优势,配合裁剪目标与 KL 约束更新策略模型。DeepSeekMath 提出的 GRPO 用组内相对奖励替代 PPO 的独立价值网络;放到这里,候选之间比的正是哪套记忆使用决策更能帮助冻结 Agent。
训练配置如下:
| 配置项 | 论文设置 |
|---|---|
| 初始化策略模型 | Qwen3-4B-Instruct-2507 |
| 训练数据 | 约 60K 问答—记忆实例,来自 FEVER、SciFact、PersonaMem |
| 困难负例 | 无关日常信息、同用户其他主题偏好、同会话不同主题偏好 |
| 每组候选数 | \(G=8\),采样温度 1.0 |
| 批次 | rollout batch 512,global batch 4096 |
| 优化器 | Adam,恒定学习率 \(1\times10^{-6}\) |
| KL 系数 | 0.001,低方差估计器 |
| 长度限制 | 提示词 8192 token,Reasoning State 512 token |
| 冻结回答模型 | Qwen3-8B,回答上限 512 token |
要澄清一个容易被“evolving”带偏的地方:部署推理时并没有持续做强化学习。 持续变化的是本体与关系状态;GRPO 在离线阶段训练好策略,推理时只生成当前请求的动态规则。它更像“离线学会使用不断演化的记忆”,不是用户每聊一次就在线更新一次策略权重。
2.3 推理:先沿关系补齐证据,再生成 2—4 条动态规则
在线阶段,bge-m3 把事实编码成 1024 维向量,相似度检索先取 \(K=10\) 个种子。随后沿存储的关系双向遍历,把更新前后版本、冲突另一端及约束事实一起取回,并对重复事实去重。
形式化写法是:
接着,训练好的 Qwen3-4B 策略以 0.3 的温度生成 Reasoning State。提示词要求输出 2—4 条简短祈使句、总长不超过 80 个英文单词,并给证据标上主要证据、用户偏好、约束、条件、历史背景或辅助背景等角色。最终回答模型同时看到原事实、关系状态和动态规则,而不是只看规则。
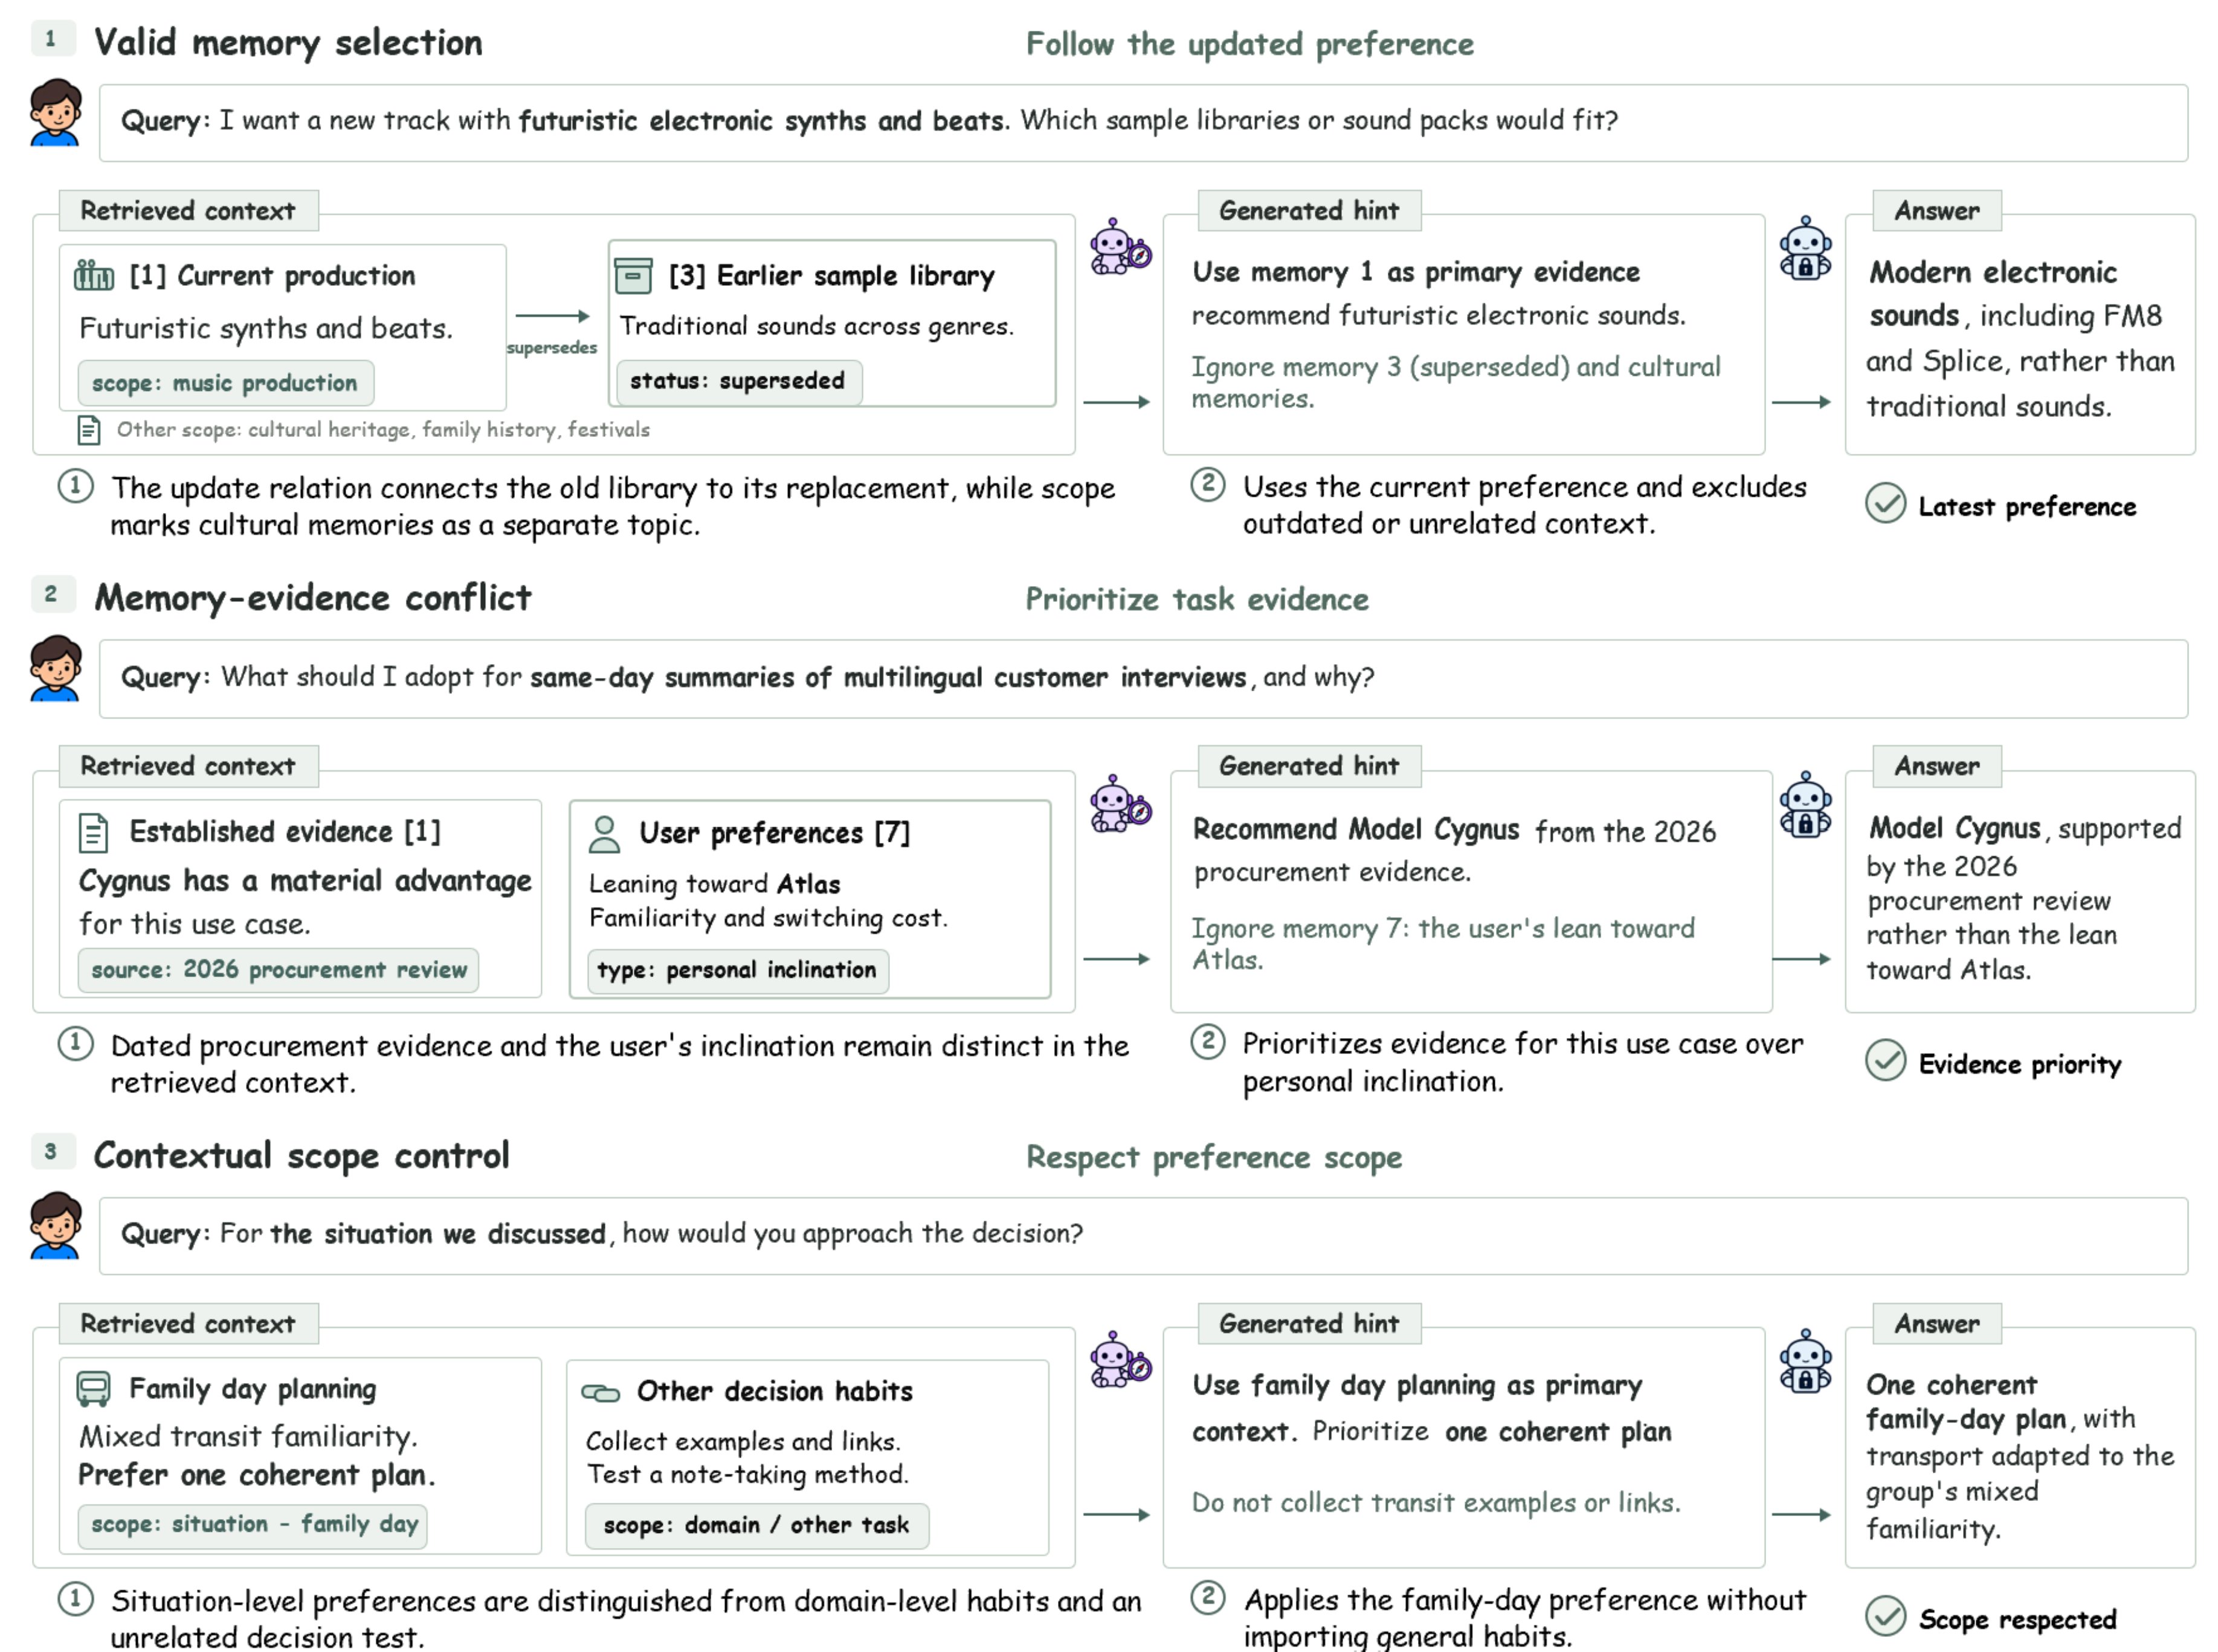
图 10:偏好更新案例中,规则优先采用未来感电子音色,排除已被取代的传统音色库;证据冲突案例中,2026 年采购评测支持 Cygnus,其优先级高于用户个人倾向 Atlas;范围控制案例中,“输出一个完整家庭日方案”的偏好被保留,但收集链接和案例的其他领域习惯没有混入答案。
这三个案例把抽象定义讲得很清楚。Reasoning State 不是对记忆做内容摘要,而是在做证据调度:谁可用、扮演什么角色、谁优先。
三、实验:提升主要来自“会用”,不是单纯“检索更多”
3.1 评测设置
论文用了四套基准,覆盖两种容易混淆的能力:
| 基准 | 主要考察内容 |
|---|---|
| MemSyco-Bench | 何时使用个性化记忆、怎样跟随偏好更新,以及避免历史偏好压过客观事实或越过适用范围 |
| MemTrapBench | 旧任务规则、认知偏差、创伤回避与反事实前提是否干扰当前推理 |
| LoCoMo | 跨会话个人经历的单跳、多跳、时间与开放域问答 |
| LoCoMo-Refined | 修正 LoCoMo 的歧义、主客体反转和时间问题,并用更严格标准评价事实覆盖与矛盾 |
对比系统包括 NaiveRAG、MemGPT、MemoryBank、Mem0、A-MEM、LightMem、Supermemory、SimpleMem、PGMem。离线记忆构建统一使用 DeepSeek-V4-Flash,在线回答分别使用 Qwen3-8B 和 GPT-4o-mini。
3.2 主结果:两个回答骨干都取得最高综合均分
下表从原论文 Table 1 摘出各基准汇总指标与 Overall。Overall 是不同任务指标的平均,只适合观察整体趋势,不应当理解成某种统一准确率。
| 系统 | MemSyco Qwen / GPT | MemTrap Qwen / GPT | LoCoMo-R Judge Qwen / GPT | LoCoMo Judge Qwen / GPT | Overall Qwen / GPT |
|---|---|---|---|---|---|
| NaiveRAG | 42.4 / 48.7 | 73.6 / 70.7 | 39.0 / 43.2 | 35.8 / 36.9 | 47.4 / 49.3 |
| MemGPT | 39.0 / 46.9 | 61.3 / 64.8 | 45.7 / 49.1 | 37.0 / 39.1 | 45.7 / 50.3 |
| MemoryBank | 44.2 / 48.7 | 70.7 / 72.5 | 44.9 / 52.8 | 41.0 / 45.3 | 49.9 / 54.2 |
| Mem0 | 36.3 / 39.7 | 73.4 / 71.4 | 25.7 / 28.9 | 23.8 / 25.2 | 39.2 / 40.4 |
| A-MEM | 45.4 / 53.0 | 74.6 / 71.9 | 41.8 / 49.1 | 37.1 / 41.9 | 49.6 / 53.4 |
| LightMem | 31.0 / 33.8 | 79.7 / 77.5 | 25.3 / 24.2 | 24.0 / 25.1 | 39.5 / 39.3 |
| Supermemory | 39.5 / 42.2 | 68.6 / 69.2 | 16.6 / 15.8 | 15.8 / 14.8 | 35.1 / 35.5 |
| SimpleMem | 37.7 / 34.0 | 79.9 / 76.1 | 51.3 / 53.8 | 46.4 / 48.4 | 53.6 / 52.8 |
| PGMem | 41.8 / 45.2 | 74.5 / 74.7 | 28.5 / 19.8 | 25.2 / 17.6 | 42.6 / 39.1 |
| EvoMemState | 57.6 / 58.9 | 79.1 / 78.7 | 57.4 / 60.8 | 45.5 / 46.4 | 59.9 / 61.2 |
MemSyco-Bench 上,Qwen3-8B 的 57.6 比最强基线 A-MEM 的 45.4 高 12.2 个点;GPT-4o-mini 的 58.9 比 A-MEM 的 53.0 高 5.9 个点。LoCoMo-Refined 的 Judge Score 也分别比最强基线高 6.1 和 7.0 个点。
不过,它并非每一栏都赢。Qwen3-8B 下,SimpleMem 的 MemTrap 均分 79.9 高于 EvoMemState 的 79.1;GPT-4o-mini 下,SimpleMem 的 LoCoMo Judge Score 48.4 也高于 EvoMemState 的 46.4。我的读法是:这套方法最擅长的是偏好变化、证据优先级和范围判断,不是包打所有对话回忆任务。
3.3 两类状态分别有效,但“完整检索最好”这个说法不成立
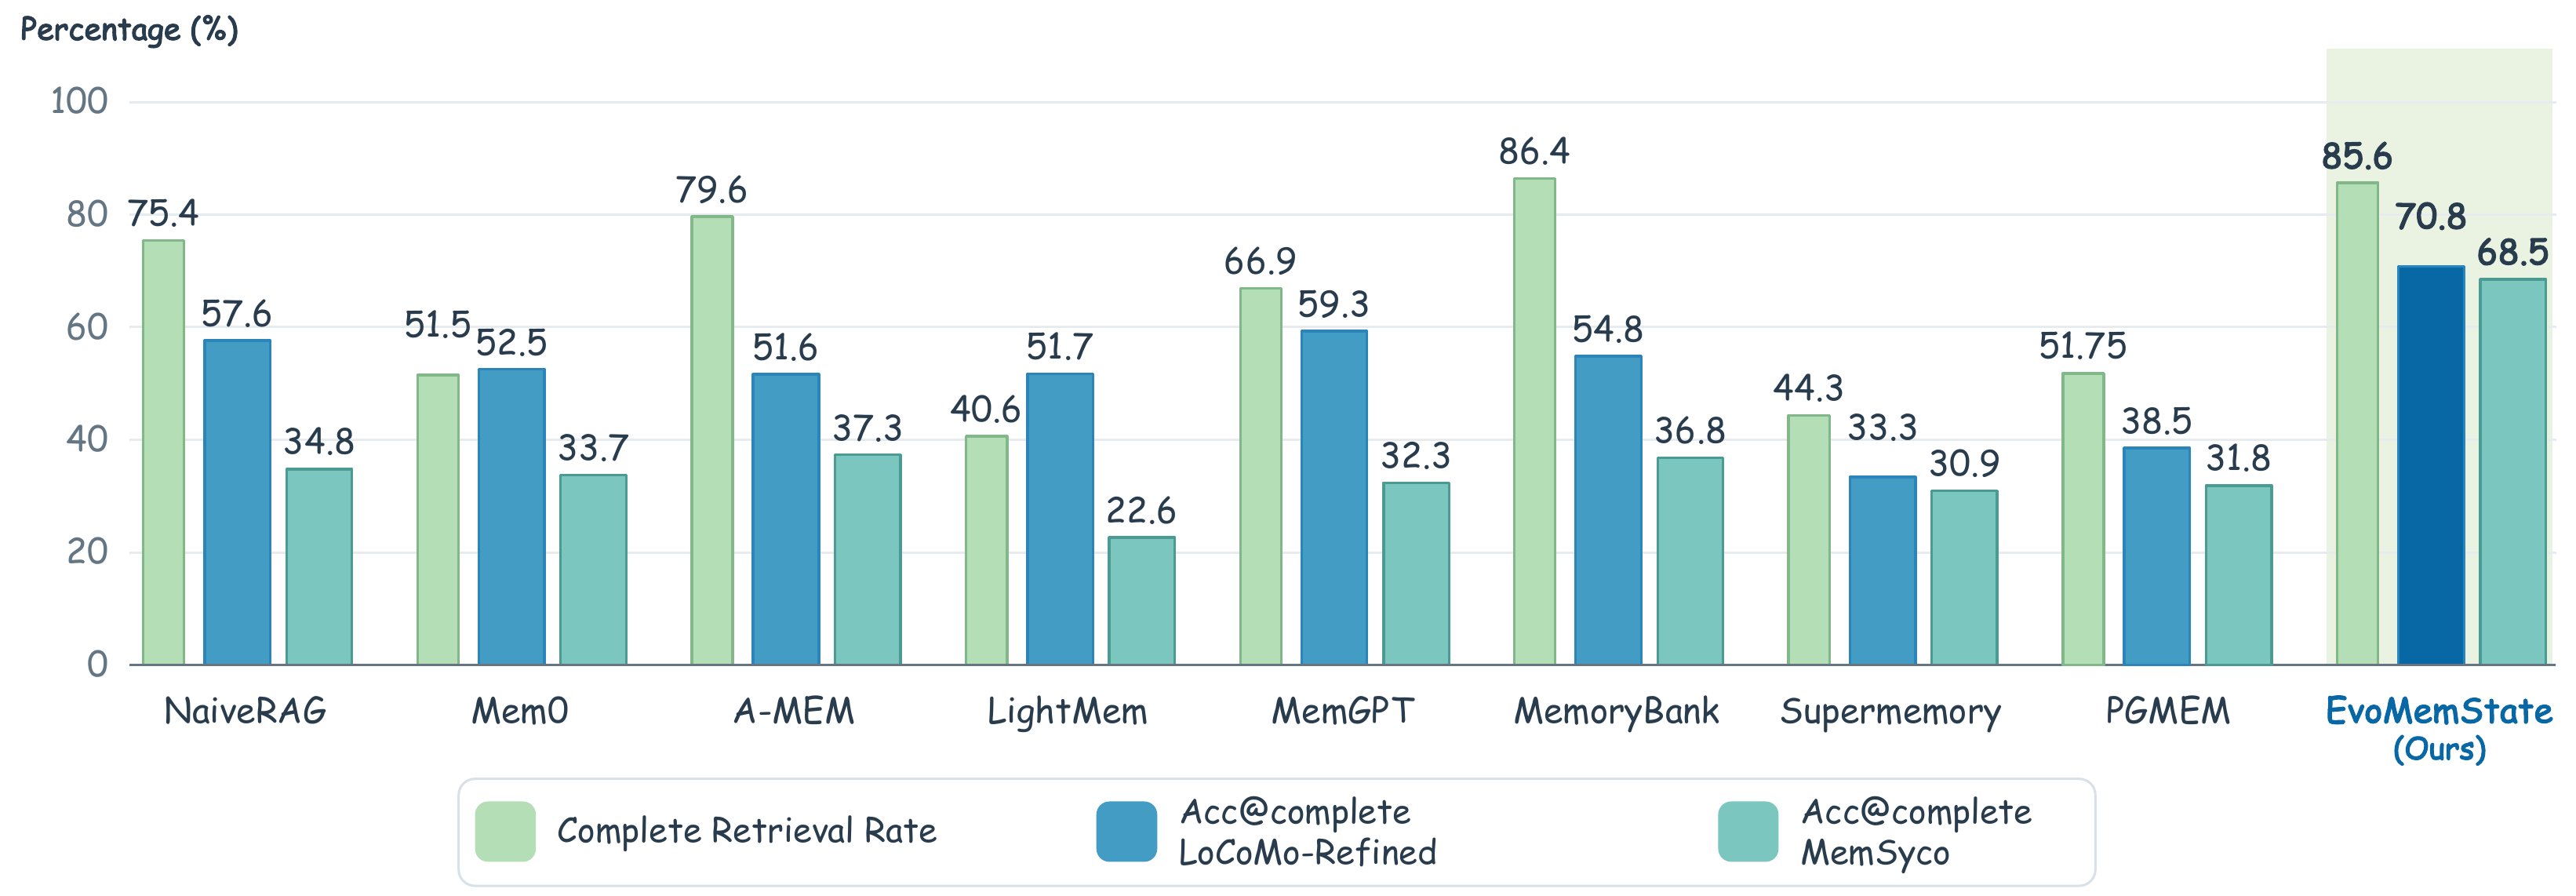
图 5:浅绿是平均完整检索率,深蓝和青绿分别是 LoCoMo-Refined、MemSyco-Bench 的 Acc@complete。EvoMemState 的完整检索率为 85.6%,略低于 MemoryBank 的 86.4%;但两项 Acc@complete 分别达到 70.8% 和 68.5%,领先最明显。
这组结果很适合检验论文是否真的解决了两个缺口。EvoMemState 的平均完整检索率 85.6%,只是接近最佳,并没有超过 MemoryBank 的 86.4%;可是证据完整以后,它在 LoCoMo-Refined 上达到 70.8%,比最强基线高 11.5 个点,在 MemSyco-Bench 上达到 68.5%,高 31.2 个点。
所以真正的差异发生在“证据已经摆在桌面上”以后。
这里也得给比较加一个脚注:各系统 Acc@complete 是在各自完整检索成功的样本子集上计算,子集并不相同,不能把它当成严格相同样本上的配对胜负。论文已经提醒要联合看两项指标,读图时更不能只挑最高的柱子。
附录的 LoCoMo-Refined 金标准证据恢复结果更有说服力,因为这里统一看所有问题:
| 方法 | 检索命中率 | 平均证据覆盖率 | 完整检索率 |
|---|---|---|---|
| EvoMemState | 0.816 | 0.747 | 0.680 |
| MemoryBank | 0.789 | 0.727 | 0.669 |
| A-MEM | 0.789 | 0.724 | 0.662 |
| NaiveRAG | 0.684 | 0.615 | 0.564 |
| MemGPT | 0.453 | 0.384 | 0.323 |
| LightMem | 0.166 | 0.144 | 0.129 |
| Mem0 | 0.110 | 0.095 | 0.086 |
| Supermemory | 0.006 | 0.004 | 0.003 |
完整检索率只有 0.680,也说明它仍会在约三分之一问题上漏掉至少一条金标准证据。关系扩展改善了证据连接,并没有把检索问题消灭。
3.4 跨系统迁移:动态规则能复用,但幅度并不均匀
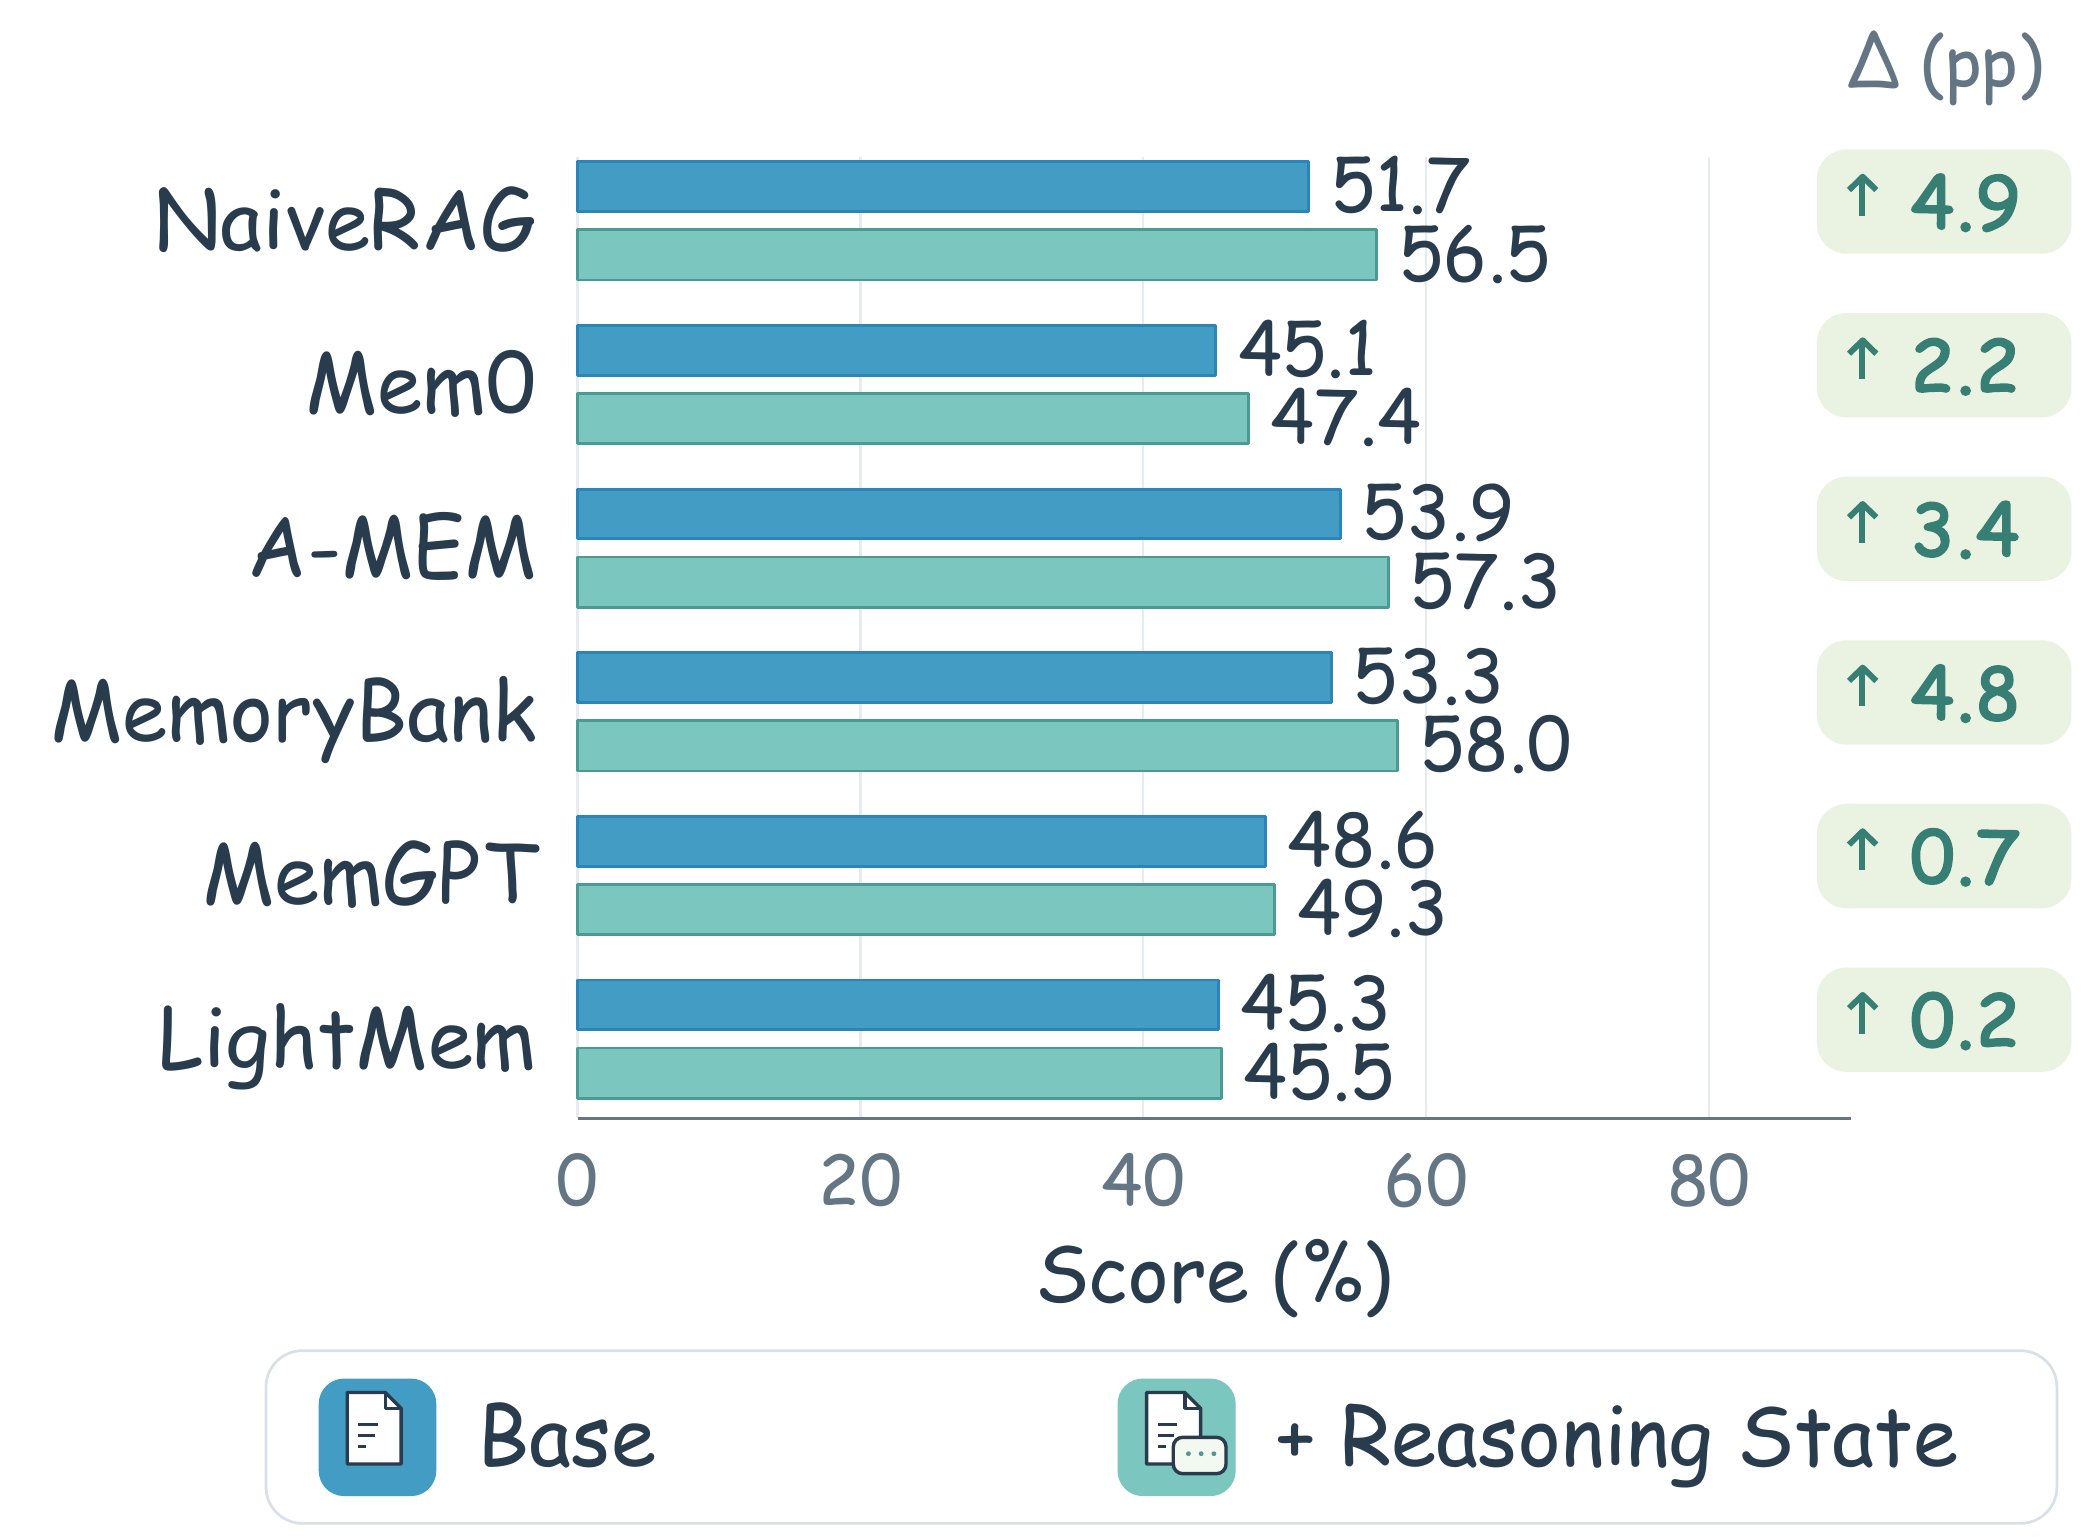
图 6:把同一策略模型接到六种记忆系统后,在 MemSyco-Bench、MemTrapBench、LoCoMo-Refined 上取平均。所有系统都有提升,NaiveRAG 与 MemoryBank 增益最大,LightMem 最小。
| 记忆系统 | Base | 加 Reasoning State | 增益 |
|---|---|---|---|
| NaiveRAG | 51.7 | 56.5 | 4.9 |
| Mem0 | 45.1 | 47.4 | 2.2 |
| A-MEM | 53.9 | 57.3 | 3.4 |
| MemoryBank | 53.3 | 58.0 | 4.8 |
| MemGPT | 48.6 | 49.3 | 0.7 |
| LightMem | 45.3 | 45.5 | 0.2 |
这组实验排除了“只有自家图结构才能吃红利”的一部分疑虑。策略模型可以处理其他系统提供的证据,并带来 0.2 到 4.9 个点的增益。
但坦率地讲,0.2 和 0.7 个点的实际稳定性很难判断,论文没有给出方差或统计显著性检验。迁移趋势是正向的,具体每个系统提升多少,还不能只看一张均值图下结论。
3.5 消融:未经 RL 的规则生成,接近没有规则
| 方法 | MemSyco Avg. | LoCoMo-R Judge | LoCoMo Judge | MemTrap Avg. | Overall |
|---|---|---|---|---|---|
| 完整 EvoMemState | 57.6 | 57.4 | 45.5 | 79.1 | 59.9 |
| 去掉 Relational State | 48.7 | 54.9 | 45.2 | 72.7 | 55.4 |
| 去掉 Reasoning State | 49.6 | 55.8 | 42.5 | 64.1 | 53.0 |
| 去掉 RL-Based State Evolution | 49.7 | 55.4 | 45.0 | 62.7 | 53.2 |
去掉关系状态,MemSyco 和 MemTrap 分别下降 8.9、6.4 个点;去掉 Reasoning State,降幅为 8.0、15.0 个点。
最有信息量的是第三行和第二行的对比。保留规则生成器、却不做 RL,Overall 只有 53.2,几乎等同于完全不要 Reasoning State 的 53.0;MemTrap 甚至更低,62.7 对 64.1。这个结果支持了前面的预实验:多生成一段“指导”没有天然价值,指导是否由下游答案反馈训练过才重要。
3.6 检索上下文更短,但完整系统成本没有被算完
EvoMemState 在 LoCoMo-Refined 上平均向回答模型提供 565 token,检索命中率 0.816。MemoryBank 和 A-MEM 的命中率都是 0.789,上下文分别为 816 和 1440 token。相对二者,EvoMemState 的上下文分别短 30.8% 和 60.8%。
这个效率来自把长对话背景拆成短事实与显式关系:找到相关事实后沿边扩展,不必把整段会话或长笔记都塞进来。MemSyco-Bench 上,它平均每个记忆库只有 22.1 条记录和 27.3 条边,记录密度为每千字符 9.69 条。
不过,565 token 只统计回答模型看到的检索上下文。 它没有包含离线本体构建的 LLM 调用、图校验、在线额外一次 Qwen3-4B 规则生成,也没有报告端到端延迟、显存、训练耗时或费用。对想上线的人来说,这些恰恰是决定成本的部分。
四、放到已有工作里看,它新在哪里?
A-MEM 已经借鉴 Zettelkasten,为记忆生成上下文描述、关键词和标签,动态建立笔记链接,并在新记忆到来时改写旧笔记属性。Mem0 等系统也在做事实抽取、压缩、图存储与更新。EvoMemState 不是第一个让记忆“连起来”或“会变”的工作。
我觉得它真正多走的一步,是把演化拆成两个时间尺度,并把其中一步变成可训练策略:
| 方案 | 记忆组织 | 当前请求的使用决策 |
|---|---|---|
| 典型事实型记忆 / Mem0 类流程 | 抽取并压缩事实,向量或图检索 | 主要由回答模型从提示词自行判断 |
| A-MEM | 上下文笔记、动态语义链接、笔记属性演化 | 检索关联笔记后由回答模型使用 |
| EvoMemState | 原子事实不改写,带类型的本体、有效性、范围、更新与冲突关系持续演化 | 独立策略经答案差分奖励训练,生成请求级动态规则 |
本体构建和 GRPO 都是成熟组件,创新不在这两个零件本身,而在它们各自对准了一个明确故障:前者补证据连接,后者补证据使用。消融结果也说明,少了任何一侧,整体收益都会明显缩水。
这套抽象对产品工程很友好。原始事实和状态分离,方便审计、纠错和回答历史问题;动态规则与原证据一起下发,方便回放“模型为什么忽略旧偏好”;策略模型独立于回答模型,理论上可以替换底层 Agent,而不用重训整个回答骨干。
五、我的保留意见:结果有吸引力,但离真实个人助理还有距离
评测与训练分布需要更独立。 约 60K 训练实例来自 FEVER、SciFact 和 PersonaMem,并非直接用四套测试集训练,这是好事。但 MemSyco-Bench 的前序工作与当前论文有共同作者,任务定义和方法假设可能共享归纳偏置。更强的第三方真实用户轨迹、跨团队基准和人工盲评,会让结论更扎实。
外部裁判与记忆构建模型没有完全解耦。 实验统一用 DeepSeek-V4-Flash 构建记忆,也在需要裁判的基准中使用它做外部 judge。统一构建模型有利于公平比较记忆系统,但同源模型担任构建者和裁判,仍可能带来风格或判断偏好。论文没有提供多裁判一致性或人工评价结果。
均值缺少不确定性。 主表、迁移和消融都只给均值,没有多次运行方差、置信区间或显著性检验。12.2 个点这样的差距很有分量,0.2、0.7 个点的小提升则很难据此排序。LLM judge、图构建和候选规则生成都可能引入波动。
关系遍历可能带来噪声膨胀。 沿关系双向走到连通分量,能保证相关证据更容易被带回,却不能保证每条边都对,也没有在正文中给出扩展规模上限。长期用户图变大后,错误连边、过度连接和上下文膨胀需要专门控制。论文只报告 \(K=10\) 个初始种子,没有充分展开大图的扩展预算。
“持续学习”要按论文实际边界理解。 离线策略训练完成后,在线阶段没有根据新用户反馈继续更新权重。因此它解决的是状态随事实演化、规则随请求变化,而不是策略在用户长期使用中持续强化学习。这个边界不削弱结果,但产品宣传时很容易说过头。
模态与成本仍是开放问题。 作者明确把范围限定在文本交互历史,文档、图片和其他用户材料尚未覆盖。对真实个人 Agent 来说,多模态证据的时间、来源和权限状态只会更复杂;而离线构图和额外策略调用的成本,也决定了它能否从基准走进高频产品。
六、如果你在做个人 Agent,这套设计值得借什么?
不一定马上复刻整套 GRPO。更实际的落地顺序是:先把原始事实做成可追溯、不可静默覆盖的记录;再给有效性、范围、更新和冲突建独立字段与带类型边;检索时不只返回 top-k,还要返回解释这些事实所需的关系邻域。仅这一步,就可能解决大量“旧偏好和新偏好一起塞进提示词”的问题。
等线上积累了足够的“使用记忆后答对或答错”样本,再训练独立规则策略。奖励要比较同一问题、同一证据下有规则和无规则的答案差,而不是只评规则文本像不像人话。规则输出应保持短小、可审计,并始终和原始证据一起提供给回答模型。
我自己的判断是:EvoMemState 是一篇问题拆解比组件堆叠更值钱的论文。 它没有用更大的回答模型覆盖记忆缺陷,而是把“证据是否完整”和“证据是否被正确采用”分开测量、分开优化。85.6% 的完整检索率并非最高,70.8% 和 68.5% 的 Acc@complete 却最能说明它的定位——优势主要发生在记忆使用层。
如果你只想要一个便宜的长对话召回模块,这套系统可能偏重;如果你正在处理偏好更新、冲突证据、权限范围和旧经验干扰当前任务,那么“持久关系状态 + 请求级推理状态”很值得做成基础设施。真正需要继续追问的是,面对多年真实交互、错误连边和多模态材料,这张状态图能否仍然保持可信。
参考资料
- EvoMemState 论文与附录:https://arxiv.org/abs/2611.03743
- EvoMemState 官方代码:https://github.com/XMUDeepLIT/EvoMemState.git
- A-MEM: Agentic Memory for LLM Agents:https://arxiv.org/abs/2502.12110
- DeepSeekMath 与 GRPO:https://arxiv.org/abs/2402.03300
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory:https://arxiv.org/abs/2504.19413
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我