整段视频只发一张奖状,怎么会不奖励复读?TurnWise 把信用拆到每一轮
看一段做菜视频时,智能体在第 112 秒回答“煎黄的鸡肉铺在米饭上”,第 116 秒又补充“鸡肉上能看到绿色香草”。这两句都挺有用。可从第 120 秒开始,它反复说同一句话,直到视频结束。
诡异的地方来了:如果整条轨迹的总奖励高于同组平均水平,普通 GRPO 会给这条轨迹一个正优势,并把这个正数广播给每一次回答。前面答对了,后面的复读也跟着被鼓励。
TurnWise 盯上的就是这个不太合理、却很容易被总奖励掩盖的训练信号。
核心摘要:流式视频智能体不断决定“回答还是继续看”,已有 GRPO 却把整条轨迹的唯一优势广播到每轮,早期成败因此污染后续决策。TurnWise 用沉默补全前缀计算逐轮剩余回报,再让各轮损失等权。Qwen2.5-VL-3B 上,三项 benchmark 分别达 43.56、21.59、49.43;完整方案重复率为 5.98,低于仅用逐轮信用的 15.53。它不是新 RL 范式,而是两处精准的粒度校准,值得细读。
论文信息
| 项目 | 内容 |
|---|---|
| 标题 | Turns Matter: Advancing Streaming Video RL via Turn-Level Credit |
| 作者 | Shuai Dong, Kanghui Tian, Linghan Chen, Wenqi Shao, Hongrui Wu, Haowen Hou, Yongfu Zhu, Xuehui Wang, Ziyue Wang, Wenpu Liu, Weichu Xie, Yuqi Xu, Congcong Wang, Kaiwen Tuo, Caoyuan Ma, Taiqiang Wu, Ji Zhao, Wenzheng Chang, Dianyi Wang, Siyuan Wang, Zhongyu Wei, Yu Qiao, Jiaqi Wang |
| 机构 | Fudan University; Shanghai Innovation Institute; JD.com; Stanford University; Shanghai Artificial Intelligence Laboratory; The Chinese University of Hong Kong; Peking University; The University of Tokyo; The Hong Kong University of Science and Technology; The University of Hong Kong |
| 版本 | arXiv:2611.06728v1,2026 年 11 月 4 日提交 |
| 论文 | https://arxiv.org/abs/2611.06728 |
| 代码 | https://github.com/XD111ds/turn-wise-rl |
| 模型与数据 | https://huggingface.co/shuai22/turns-matter-rl-ckpt ;https://huggingface.co/datasets/shuai22/mmduet2-training-data |
总奖励没问题,问题在它被复制给了每一轮
流式视频理解和普通视频问答有个根本差别:模型不能等整段视频播完再开口。每来一批帧,它都要根据当前证据、用户问题和已经说过的内容,选择输出回复,还是输出“NO REPLY”继续观察。
于是一个片段里会有一串决策,而不是一次回答。好的轨迹里可能混着复读,差的轨迹里也可能有补救得很漂亮的追问。
GRPO 最初在 DeepSeekMath 中用于语言模型推理:同一问题采样一组回答,用组内奖励均值和标准差做归一化,省掉 PPO 的 critic。到了单轮答题场景,把轨迹优势赋给该回答的 token 很自然;到了多轮流式交互,这个“复制粘贴”就开始别扭了。
已有工作更多在改奖励:
| 方法 | 主要优化信号 | 决策信用与损失聚合 |
|---|---|---|
| MMDuet2 | PAUC 奖励结合重复、窗口外回复和前缀惩罚,并用短片段训练缓解奖励稀疏 | 轨迹级 GRPO 优势 |
| ThinkStream | 正确性、格式和回答时机奖励,结合增量推理 | 沿轨迹优化,轮级评分不等于轮级策略信用 |
| StreamPro | 同时考虑单轮回复质量和整条轨迹连贯性 | 多粒度奖励仍不自动产生逐轮优势 |
| TurnWise | 固定 MMDuet2 的轨迹评分器,把信用分配和损失权重作为受控变量 | 剩余回报形成逐轮优势,每轮等权聚合 |
这里有个值得分清的概念:奖励可以按轮计算,信用却未必按轮分配。即使评分器知道哪一句重复了,只要最终仍把所有信号压成一个轨迹优势,后续更新依然可能奖励那句复读。

图 1:上方做菜片段中,前两次回复提供新信息,后四次逐渐变成重复。原始 GRPO 对六个决策都给出 +0.984;TurnWise 记录的优势依次为 +0.984、+0.098、-0.754、-0.529、-1.027、-1.027。要仔细看图注:对话是示意,优势曲线来自记录的训练样例及对应 GRPO 反事实,并不是用这段示意对话现场算出的数值。
说实话,这个例子让我一下看懂了论文的价值。它不是说总奖励设计错了,而是说:一句回复该不该被强化,应该看它从当前轮往后还带来了什么,而不是它前面已经攒了多少分。
TurnWise 的两处改动:信用按轮算,损失也按轮算

图 2:左侧输入流式视频、用户问题、对话历史和共享观察计划,旧策略采样 \(G\) 条对齐轨迹;中间沿用质量与时效、重复、窗口外回复、共享前缀四类评分;右侧先通过沉默补全前缀得到逐轮剩余回报优势,再在策略损失中让每轮获得相同权重。
沉默补全前缀:把以前挣的分从当前轮扣掉
一句话讲清核心操作:保留前 \(t\) 轮已经采样的动作,把后面所有动作替换成沉默,再用同一个轨迹评分器打分。
这个分数记为 \(U_{i,t}\)。它不是新训练的价值网络,也不需要让模型重新生成视频轨迹。由于视频观察计划、决策时间戳、回复窗口和评估终点都保持不变,评分器只需回答一个问题:“如果后面不再说话,目前这些回复能拿多少分?”
第 \(t\) 轮之前已经积累的奖励为 \(C_{i,t-1}=U_{i,t-1}-U_{i,0}\),从第 \(t\) 轮开始的剩余回报为 \(F_{i,t}=R_i-U_{i,t-1}\)。其中 \(U_{i,0}\) 是全程沉默的参考分,它不一定为零;\(U_{i,T_i}=R_i\) 则对应完整轨迹奖励。
TurnWise 在组内对剩余回报做相对化,并写成从全局优势中扣除已积累奖励的形式:
\(A_i^{\mathrm{global}}\) 是普通 GRPO 的轨迹优势,\(\bar C_{t-1}\) 是同组轨迹在第 \(t\) 轮前的平均已积累奖励,\(\sigma_R\) 仍采用组内完整轨迹奖励的样本标准差。实验中优势裁剪阈值 \(a_{\max}=5\),\(\epsilon=10^{-6}\)。
这个公式有两层直觉。
如果一条轨迹靠早期回答已经领先同组,后面的重复回复不能再白拿这份领先;如果一条轨迹早期表现落后,但当前补救带来了高于同组的剩余回报,它仍能得到正优势。第一轮之前没有已积累奖励,所以第一轮修正为零。
\(\alpha\) 控制扣除强度:为 0 时退回共享 GRPO 优势,为 1 时使用完整的剩余回报信用。训练前 10% 的更新中,它从 0 线性升到 1,随后保持为 1。这个热身挺务实,避免模型刚离开 SFT 初始化就面对剧烈变化的信用尺度。
工程上更妙的是,前缀分数可通过对缓存的回复质量、重复判断及其分母做确定性扫描得到。沉默后缀不会改变已保留回复,也不会改变这些回复之前的对话,因此不需要新增 rollout,也不需要新增 judge 调用。注意,这不等于训练完全零额外开销;论文没有给出与基线的墙钟时间对比。
轮内先平均:长回复不能靠字数压住“继续看”
只改优势还不够。普通 token-mean 聚合里,一轮损失在整条轨迹中的权重与 token 数成正比。100 个 token 的长回复和一个很短的等待动作,即便都代表一次决策,对梯度的影响也差得很远。
TurnWise 的第二步是把 token 损失先在每轮内部平均,再把各轮等权平均:
\(L_{i,t}\) 是第 \(i\) 条轨迹第 \(t\) 轮生成的 token 数,\(\ell_{i,t,k}\) 是使用该轮修正优势的 PPO 裁剪损失。这样,每轮在轨迹损失中的权重都是 \(1/T_i\),回复长度不再暗中决定梯度份额。
这两个模块分工很清楚:逐轮信用决定一次决策该被鼓励还是抑制,轮均值聚合决定这次决策在更新中占多大份量。一个管方向,一个管权重。
实验怎样控制变量
训练与评测配置里,有几个数字直接关系到结果能不能复现。
| 项目 | 配置 |
|---|---|
| 骨干模型 | Qwen2.5-VL-3B、Qwen3-VL-4B |
| SFT 数据 | 100,874 条有效指令样本,1% 留作验证;数据来自 EgoExo4D、EgoExoLearn、Live-WhisperX、Tarsier2、LLaVA-Video |
| SFT | 1 个 epoch,学习率 \(10^{-5}\),冻结视觉塔 |
| RL 数据 | 3,983 个流式实例,目标片段 20 秒,每 2 秒采样,最多 90 帧,带初始对话上下文 |
| 采样与优化 | batch size 8,每实例 \(G=4\) 条 rollout,temperature 1.2,top-k 10;AdamW 学习率 \(10^{-6}\),训练 1 个 epoch,每批做 1 次策略优化 epoch |
| 正则与裁剪 | 无 KL、无 entropy 正则;\(\delta=0.2\),dual-clipping 参数 \(c=3\),\(a_{\max}=5\) |
| 奖励评判 | 沿用 MMDuet2 的 PAUC 轨迹奖励,由 gpt-oss-20b 评判;奖励中质量与时效项权重为 3,重复、窗口外回复、共享前缀惩罚权重分别为 2、0.5、2 |
评测覆盖三种互补能力。ProactiveVQA 用 300 个 Ego、TV、VAD、Web 实例衡量回复质量与时效,PAUC 的 \(\omega=0.5\),由 GPT-5.6-luna 评判;OVO-Timing 在 CRR、SSR、REC 上做事件触发回复,以正负 2 秒窗口一对一匹配计算 Timing F1;StreamingBench 同时报告实时视觉理解准确率,以及答案和时机都正确才算命中的 Proactive Output 准确率。所有模型用贪心解码,历史上下文中保留自己此前的回复。
基线 SFT、MMDuet2、ThinkStream、StreamPro 都在同一 streaming GRPO 框架中实现。这个设置有利于控制骨干、数据和训练流程,但它检验的是统一复现框架下的相对表现,不应直接当成各原论文官方配置下的全面复测。
主结果:三项总分都领先,但不是每个子项都赢
下表保留主实验的三个聚合指标,并拆开 StreamingBench 的两项准确率。每个骨干内部,TurnWise 都与同一批非 TurnWise 方法比较。
| 骨干 | 方法 | ProactiveVQA PAUC ↑ | OVO-Timing F1 ↑ | StreamingBench 实时 ↑ | StreamingBench 主动 ↑ | StreamingBench 平均 ↑ |
|---|---|---|---|---|---|---|
| Qwen2.5-VL-3B | Baseline | 22.15 | 1.33 | 69.42 | 22.40 | 45.91 |
| Qwen2.5-VL-3B | SFT | 28.74 | 0.57 | 74.68 | 22.80 | 48.74 |
| Qwen2.5-VL-3B | MMDuet2 | 39.60 | 17.72 | 74.88 | 20.40 | 47.64 |
| Qwen2.5-VL-3B | ThinkStream | 34.63 | 8.08 | 72.52 | 16.40 | 44.46 |
| Qwen2.5-VL-3B | StreamPro | 38.03 | 14.50 | 75.16 | 20.40 | 47.78 |
| Qwen2.5-VL-3B | TurnWise | 43.56 | 21.59 | 75.85 | 23.00 | 49.43 |
| Qwen3-VL-4B | Baseline | 29.83 | 8.48 | 73.57 | 32.80 | 53.19 |
| Qwen3-VL-4B | SFT | 30.24 | 1.60 | 77.56 | 35.60 | 56.58 |
| Qwen3-VL-4B | MMDuet2 | 30.18 | 9.23 | 77.28 | 30.40 | 53.84 |
| Qwen3-VL-4B | ThinkStream | 36.18 | 8.95 | 77.04 | 34.80 | 55.92 |
| Qwen3-VL-4B | StreamPro | 34.67 | 8.50 | 78.24 | 32.80 | 55.52 |
| Qwen3-VL-4B | TurnWise | 42.44 | 11.15 | 79.52 | 38.40 | 58.96 |
在 3B 上,TurnWise 相对各项最强非 TurnWise 结果分别提升 3.96、3.87、0.69 个点;在 4B 上,对应提升为 6.26、1.92、2.38 个点。4B 的 StreamingBench 主动准确率达到 38.40,高于最强基线 SFT 的 35.60,实时准确率也从 StreamPro 的 78.24 提到 79.52。
不过,看到“全部最佳”时我还是会往子项里多看一眼。3B 的 OVO-SSR 上,TurnWise 为 14.61,低于 MMDuet2 的 17.56;4B 的 ProactiveVQA-TV 上,TurnWise 为 37.73,略低于 ThinkStream 的 38.49;4B 的 OVO-CRR 也只有 8.68,低于 MMDuet2 的 11.88。论文领先的是聚合结果,不是逐格横扫。
还有一点让我有点皱眉:3B 的 StreamingBench 平均分只领先 0.69 个点,而主表没有多种子均值、方差或显著性检验。这个差距可以作为积极信号,但还不足以证明训练扰动下始终稳定。反过来,4B 在 StreamingBench 上领先 2.38 个点、ProactiveVQA 上领先 6.26 个点,证据看起来更扎实。
消融最有意思的地方:只改信用,复读反而变多
在 Qwen2.5-VL-3B 上,组件消融把“信用方向”和“损失权重”拆开了。Rep. 是非沉默回复中的重复率,越低越好。
| 方法 | 逐轮信用 | 轮均值 | PAUC ↑ | Rep. ↓ | Timing F1 ↑ | StreamingBench 平均 ↑ |
|---|---|---|---|---|---|---|
| Base | — | — | 22.15 | 65.40 | 1.33 | 45.91 |
| SFT | — | — | 28.74 | 3.79 | 0.57 | 48.74 |
| MMDuet2 | — | — | 39.60 | 6.08 | 17.72 | 47.64 |
| + Turn Mean | — | ✓ | 41.87 | 9.78 | 8.17 | 47.58 |
| + Credit | ✓ | — | 43.12 | 15.53 | 18.63 | 48.94 |
| TurnWise | ✓ | ✓ | 43.56 | 5.98 | 21.59 | 49.43 |
仅用 Credit,PAUC 从 MMDuet2 的 39.60 提到 43.12,StreamingBench 从 47.64 提到 48.94,但重复率从 6.08 升到 15.53。这个数很关键:更合理的逐轮信用并不会自动让最终行为所有维度都变好。
把 Turn Mean 加回来后,重复率降到 5.98,相比 Credit-only 的 15.53 减少 61.5%;Timing F1 同时增加 2.96 个点,StreamingBench 平均分增加 0.49 个点。相比只用 Turn Mean,完整方案的 Timing F1 高出 13.42 个点,重复率降低 38.9%。
所以,TurnWise 不是两个可以互相替代的 trick。信用修正让模型知道哪些轮该压下去,轮均值则避免长回复凭长度重新抢回梯度主导权。只装其中一个,行为可能顾此失彼。
修正强度不是越单调越好
| 配置 | \(\alpha\) | PAUC ↑ | Rep. ↓ | Timing F1 ↑ | StreamingBench 平均 ↑ |
|---|---|---|---|---|---|
| Credit | 0.25 | 44.50 | 16.81 | 19.51 | 47.46 |
| Credit | 0.50 | 43.34 | 18.91 | 19.41 | 48.30 |
| Credit | 0.75 | 44.24 | 25.16 | 12.97 | 46.84 |
| Credit | 1.00 | 43.12 | 15.53 | 18.63 | 48.94 |
| Credit + Turn Mean | 0.25 | 41.37 | 12.49 | 16.68 | 48.05 |
| Credit + Turn Mean | 0.50 | 41.71 | 36.04 | 10.53 | 46.44 |
| Credit + Turn Mean | 0.75 | 42.00 | 12.95 | 9.73 | 46.95 |
| Credit + Turn Mean | 1.00 | 43.56 | 5.98 | 21.59 | 49.43 |
完整 TurnWise 中,\(\alpha=1\) 在四项指标上都是测试范围内的最佳点。但 Credit-only 并不服从这个故事:\(\alpha=0.25\) 的 PAUC 为 44.50,反而高于完整修正的 43.12。不同 \(\alpha\) 下指标也明显波动,尤其 Credit + Turn Mean 在 \(\alpha=0.5\) 时重复率达到 36.04。
我的判断是,完整修正在最终组合里成立,但中间结果没有呈现“修正越多,表现越好”的平滑规律。这里更像存在信用强度与损失聚合的耦合,不宜把 \(\alpha=1\) 当成跨任务通用默认值。
训练曲线与真实轨迹:它确实改变了学习方向
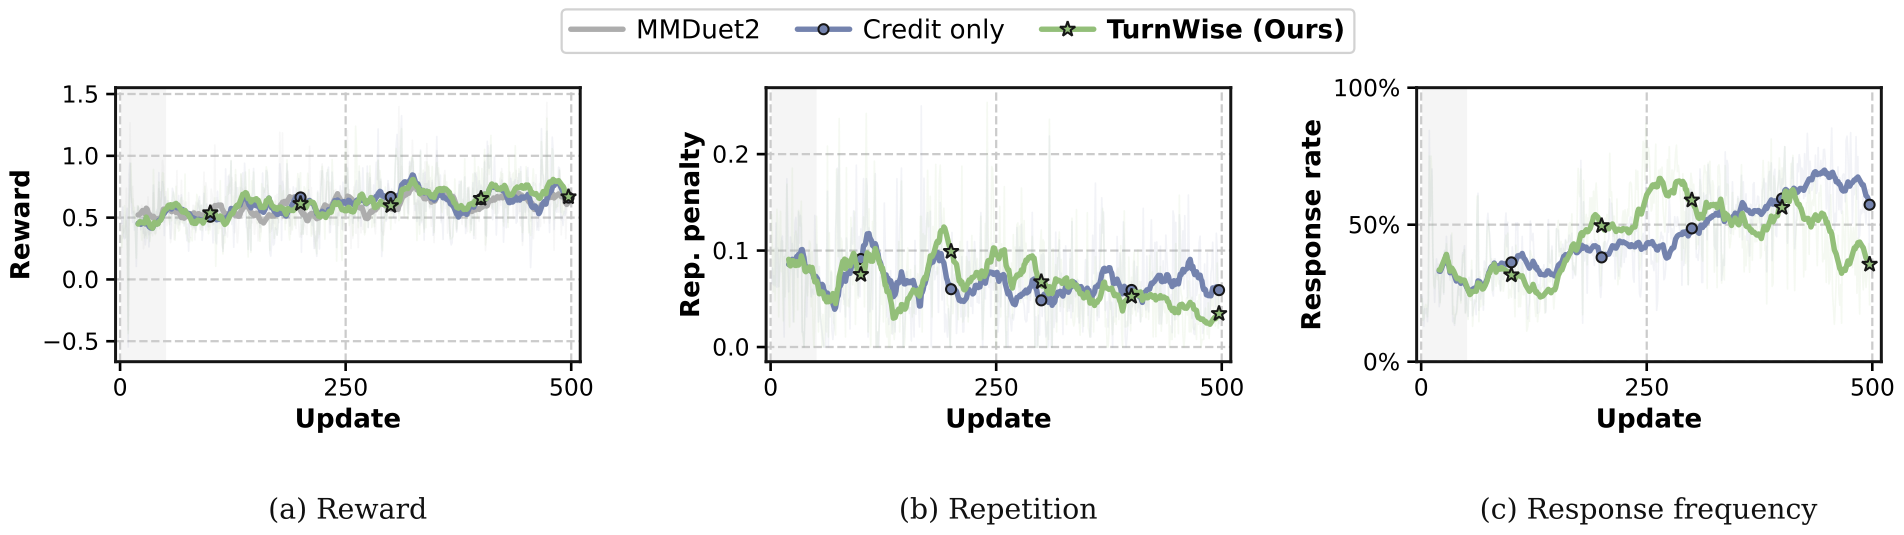
图 3:在相同 Qwen2.5-VL-3B SFT 初始化和逐轮信用规则下,比较 Credit-only 与完整 TurnWise 的 497 次更新。灰色区域是信用热身;浅色轨迹为 batch 均值,实线为 20 次更新的滑动平均。左图是奖励,中图是按回复归一化的重复惩罚幅度,右图是非沉默决策比例。
末尾 50 次更新里,轮均值聚合把平均奖励从 0.657 提到 0.711,把重复惩罚幅度从 0.069 降到 0.036。窗口外回复比例从 0.537 降到 0.289,非沉默决策比例从 62.2% 降到 37.0%。
奖励只多了一点,回复行为却收紧了很多。这条证据比单看终点分数更有说服力:模型不是单纯学会多说话来换 PAUC,而是减少了低价值开口。当然,回复率降低本身不等于越好,还得和 Timing F1、窗口外回复一起读,否则过度沉默也会显得“很乖”。

图 4:左图比较 84,184 个决策的全局优势与逐轮优势,虚线表示分配不变,21.20% 的决策发生符号翻转;右图统计 2,972 条 judge 标记的重复回复,负优势占比从全局分配的 75.7% 增至 TurnWise 的 81.6%,正优势占比从 24.3% 降至 18.4%。
这组分析覆盖 11,116 条完整的 Qwen2.5-VL-3B 训练轨迹,全部采用 \(\alpha=1\) 的完整修正。53.15% 的轨迹内部同时出现正、负逐轮优势,说明同一个整体结果下确实拆出了不同学习方向。
最贴题的一组数是:原本带着正全局优势的 722 条重复回复中,432 条被逐轮信用翻成负优势,占 59.83%。这直接验证了开头的动机,而不只是用最终 benchmark 反推机制可能成立。
但我也想把边界说清楚:右图里重复回复的负优势占比只从 75.7% 到 81.6%,并不是所有重复都被纠正。它提供的是更好的信用方向,不是重复行为的硬约束。
我的判断:最值钱的是把两种粒度对齐了
这篇论文真正打动我的,不是“turn-level”这个词,而是它同时处理了两个容易被混为一谈的问题。
轨迹奖励到逐轮优势的转换,解决的是信用归属;token-mean 到 turn-mean 的转换,解决的是优化权重。很多多轮 RL 工作会盯着前者,却让长文本继续通过 token 数控制后者。TurnWise 把决策轮变成两种计算共享的单位,逻辑很完整。
和 MMDuet2、ThinkStream、StreamPro 相比,它的贡献不在更复杂的奖励,而在固定评分器后重排已有信息。确定性扫描复用已有 judge 结果,不训练 critic,也不增加 rollout,工程接入路径相对短。如果已经在做带显式等待动作的多轮 GRPO,这两处改动值得直接试。
限制也同样清楚。
它依赖显式沉默动作、共享观察计划和组内对齐的决策轮。没有这个结构,沉默补全前缀就不容易定义。实验只覆盖两个 Qwen 骨干和固定的 MMDuet2 PAUC 奖励,能否迁移到其他奖励、其他视频模型或更通用的多轮智能体,还没有证据。评测又使用模型 judge,奖励评判和 ProactiveVQA 评判分别依赖 gpt-oss-20b 与 GPT-5.6-luna,judge 偏差仍可能进入结果。
轮均值等权也不是永远正确的先验。对于回复极稀疏的任务,让海量等待决策和少数关键回复完全等权,是否会把策略压向过度沉默,需要单独验证。论文里 Timing F1 与窗口外回复共同改善,说明当前设置下这个担忧没有成为主要矛盾,却不能外推到所有任务。
如果继续往下做,我最想看到三组实验:多种子和方差,确认较小 benchmark 差距是否稳定;不同回复稀疏度下的轮权重扫描,检验等权假设;以及跨奖励、跨任务的迁移,确认收益来自信用粒度,而不是恰好适配这一套 PAUC 评分器。
回到开头的复读问题,TurnWise 给的答案很朴素:别因为一个孩子前半场考得好,就给他后半场每次举手都发奖状。每一轮,都该为自己的后续贡献负责。
参考资料
- TurnWise 论文:https://arxiv.org/abs/2611.06728
- DeepSeekMath 与 GRPO:https://arxiv.org/abs/2402.03300
- MMDuet2:https://openreview.net/forum?id=rxQnMSNCUs
- ProactiveVideoQA:https://arxiv.org/abs/2507.09313
- StreamPro:https://arxiv.org/abs/2605.16381
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我