别再把整条思维链一刀切:LoCo 教模型在该停的地方停
一道“7 月 3 日是星期三,7 月 14 日是星期几”的题,模型已经用日期差、逐日枚举和模 7 运算验证了三次,答案都是 Sunday。按人的习惯,这时候该落笔了;推理模型却又换参考日期、年份推算和另一种计数方法,继续写了近千 token。
多出来的文字没有增加新信息,却要真实付出解码延迟和显存占用。更麻烦的是,如果训练时只告诉模型“短答案更好”,它可能把难题也草草收尾。压缩推理真正难的地方不是删字,而是知道哪里还能想、哪里该停。
核心摘要:LoCo 把推理压缩从整条轨迹的长度比较,改成固定中间状态下的“继续还是收尾”偏好学习。它用置信度与波动率找候选点,经 judge 复核后,让原模型从同一前缀重新生成更短且正确的后续,再用 DPO 对比新旧后续。只靠数学轨迹训练,LoCo 在五个数学基准上减少 41.7%–45.4% 的输出 token,在三个代码基准上减少 23.4%–36.3%,准确率保持或提升。这个设计不花哨,但问题切得很准;目前证据仍集中在一个 7B 基座上,离“通用的推理压缩方案”还有一段路。
论文信息
- 标题:Think Less, Locally: Local Preference Learning for Reasoning Compression
- 作者:Muyao Yuan、Liyan Xu、Weizhan Zhang、Muyan Jiao、Jiangnan Li、Jinchao Zhang、Jie Zhou
- 机构:MOEKLINNS, School of Computer Science and Technology, Xi’an Jiaotong University;WeChat AI, Tencent Inc.
- 提交日期:2026 年 11 月 3 日,v1
- arXiv:2611.04814,https://arxiv.org/abs/2611.04814
- 代码与模型发布页:https://github.com/MuyaoYuan/LoCo (论文注明将公开)
长思维链的问题,不只是“太长”
Kimi k1.5 的 Long2Short、O1-Pruner 等方法已经证明,同一道题的多条正确解答里,短的那条通常值得偏爱。长度惩罚类强化学习则把 token 开销直接放进奖励。它们都在优化整条轨迹。
这条路线有个别扭之处:两条完整解答可能走不同路线,总长相差 5000 token,并不能告诉你哪一步开始多余。监督信号像一句“整体再简洁点”,却没有指出“在这里已经算完,可以收尾”。
细粒度方法更进一步。TokenSkip 删 token,TokenSqueeze 做深度匹配和步内语言精炼,Step-DPO、ReCUT 等方法比较共享前缀的不同后续。LoCo 与它们最接近,但关注点又挪了一寸:不是单纯找更短的步骤,而是把某个中间状态当成决策点,学习此处是否还需要继续推理。
| 路线 | 偏好或优化对象 | 能回答的问题 | 容易漏掉的信息 |
|---|---|---|---|
| 完整轨迹偏好 | 同一题的长、短完整解答 | 哪条解答整体更好 | 冗余从哪个状态开始 |
| 长度奖励强化学习 | 正确性、长度或预算奖励 | 如何在目标长度内求解 | 每个局部状态是否需要更多计算 |
| 内容级细粒度压缩 | token、句子或单个步骤 | 哪些文字可以删或改写 | 当前状态能否直接收尾 |
| LoCo | 同一冻结前缀下的两条后续 | 此刻该继续还是该结束 | 依赖候选点检测和正确后续采样 |
说实话,我喜欢这个切入点。它把“压缩”从文本编辑问题改写成了序贯决策问题,而且不需要在推理时额外挂一个控制器。
LoCo 的核心:比较后续,不比较不同的人生
LoCo 是 Local Compression 的缩写。一条思维链按段落切成步骤 \(s_0,s_1,\ldots,s_n\),做到第 \(i\) 步时,把题目和此前所有步骤拼成冻结状态 \(P_i\)。从这个状态出发,模型既可以继续写,也可以收尾。
方法总览里,上方红色部分是原始后续,下方绿色部分是重新生成的短后续;两边共享完全相同的蓝色前缀。

图 1:LoCo 的三段式流程。左侧用步骤置信度 \(c_i\) 和置信度波动率 \(v_i\) 筛选候选点,再交给 judge;中间从冻结状态 \(P_i\) 采样并验证新后续;下方把最短的正确新后续 \(y_i^+\) 与原始后续 \(y_i^-\) 组成三元组 \((P_i,y_i^+,y_i^-)\),送入 DPO。灰色是已有步骤,橙色是检测到的过度思考步骤,红色是被替换的冗余步骤,绿色是重新生成的步骤。
关键约束只有一句:正负样本必须从同一个状态出发。
如果正样本是另一条完整解答,模型可能同时学到不同的解题路径、表达风格和长度。固定前缀后,比较范围收窄到“从这里往下怎么走”,监督信号干净得多。
候选点检测:低置信度还不够,得同时不稳定
作者没有直接拿“Wait”“Alternatively”这类词找冗余。词面规则容易误伤正常验算,逐步人工标注又太贵。LoCo 先用模型自己的 next-token 分布做廉价筛选。
对每个 token,取词表中最大的下一个 token 概率 \(p_\tau^{\max}\);一个步骤内的平均值记为 \(c_i\),相邻步骤置信度的波动记为 \(v_i\)。窗口只取最近两步,因此 \(v_i=(c_i-c_{i-1})^2/4\)。候选集合为:
这里,\(q_{25}\) 是步骤置信度的第 25 百分位,\(q_{75}^{v}\) 是波动率的第 75 百分位,分位数在模型自生成轨迹语料上统一校准一次。低置信度可能来自难题,高波动也可能只是正常换思路;两个条件取交集,筛的是“既没把握又不稳定”的状态。
等等,置信度低为什么反而可能接近该停的位置?直觉上确实反过来了。我的理解是,这里并不是把置信度当成答案正确率,而是用它找行为不稳定的片段,再把判断交给更强的 judge。这个代理信号是否跨模型稳定,论文还没有给出充分证据。
judge 会看到题目、冻结前缀、紧接着的步骤和初筛标签,把下一步改判为 overthink、normal 或 final。只有 overthink 被保留。final 单独列出来很实用:思维链末尾重复并框出答案,看起来啰嗦,却常常承担答案提取功能,不能一刀切掉。
整个检测是因果的。\(c_i\) 和 \(v_i\) 只用到第 \(i\) 步结束时的信息,截断从 \(s_{i+1}\) 开始,不偷看被删掉的后续。
短后续生成:不是 judge 代写,而是原模型自己重来
每个保留下来的状态都会冻结前缀,由原模型独立采样 \(k=8\) 条后续。一条后续必须满足两个条件:推理模板完整,最终答案与标准答案符号等价。所有合格后续里选 token 数最短的作为 \(y_i^+\),原始后续则作为 \(y_i^-\)。
采样不到正确后续,就放弃这个点;新后续没有比原后续短,也放弃。进入训练前还有三道门槛:
- 节省量 \(g_i=|y_i^-|-|y_i^+|\) 至少为 300 token;
- 前缀不超过 6k token,每条后续不超过 12k token;
- 每道题最多保留节省量最大的 3 对,避免长轨迹贡献过多样本。
这里有个容易被忽略的细节:judge 只参与离线数据筛选,不参与推理。部署时不需要先跑置信度检测,也不需要让 Qwen3-30B 在旁边盯着。训练完成后,生成流程仍是普通的一次自回归解码。
DPO 学到的不是“短”,而是“此处短后续更值得选”
令 \(x=P_i\),训练采用标准 DPO:
\(\pi_\theta\) 是正在训练的策略,\(\pi_{\mathrm{ref}}\) 是冻结的参考模型,\(\beta\) 控制偏离参考策略时的偏好强度。每条后续的对数似然,是其所有 token 对数概率之和。
因为两个分支共享 \(x\),损失函数直接提高“从这个状态走短且正确后续”的相对概率。它没有显式要求所有题都短,也没有给每一步统一的长度惩罚。难题上若没有被检测出可安全收尾的状态,就不会凭空制造一对“短即正确”的训练样本。
当然,这并不等于模型获得了完美的停止能力。训练数据只覆盖检测器找到、且重新采样成功的地方,分布外的状态仍要靠泛化。
数据与训练:离线构数据不便宜,在线推理不加模块
源数据来自 math14k,共 14,027 道数学题。DeepSeek-R1-Distill-Qwen-7B 每题采样 3 条 rollout,temperature 为 0.6,top-p 为 0.95,保留最短的正确轨迹。检测时通过 vLLM 批量读取 prompt logprobs;Qwen3-30B 负责复核,每条轨迹最多均匀抽取 10 个候选状态,随后再做每状态 8 次后续采样。
训练配置如下,论文给得比较齐:
| 项目 | 配置 |
|---|---|
| 基座与参考策略 | DeepSeek-R1-Distill-Qwen-7B;基座同时作为冻结参考策略 |
| 参数更新 | LoRA,rank 256,\(\alpha=512\),dropout 0.05,作用于 q/k/v/o 注意力投影,基座冻结 |
| 优化 | 2 个 epoch,有效 batch size 64,学习率 \(1\times10^{-5}\),cosine schedule,warmup ratio 0.1 |
| 优化器 | AdamW,weight decay 0.01,梯度裁剪 1.0 |
| DPO | \(\beta=0.1\) |
| 硬件与序列 | 4 张 H20,最大序列长度 14,336 token |
我想特别强调构数据成本:3 次整题 rollout 只是起点,后面还有全轨迹 logprob、judge 复核和候选状态下的 8 次续写。论文没有报告最终偏好对总数、judge 调用量和整段构数据耗时,所以“训练只用 LoRA”不能被理解成“整个方法很轻”。它轻在部署,不一定轻在数据生产。
评测覆盖 MATH-500、AMC 2023、Olympiad、AIME 2024、AIME 2025,以及 MBPP sanitized、LiveCodeBench v5、CodeContests,题量依次为 500、40、675、30、30、257、167、165。每题采样 8 次,temperature 0.6、top-p 0.95,最多新生成 32,768 token。数学答案取末尾的 \boxed{} 并用 math_verify 判断符号等价,代码取末尾的 Python 代码块后沙箱执行。
表里的 AUC 不是分类任务里的 ROC-AUC,而是不断改变最大推理长度后,准确率—token 预算曲线下的面积。它衡量一整段预算上的权衡,不是某一个截断点的运气。
数学结果:难度越高,局部偏好的优势越清楚
下表保留论文 Table 1 的全部方法均值,每格依次为“准确率 % / 平均输出 token / AUC %”;为便于阅读,± 后的波动项暂不展开,完整数值以原表为准。
| 方法 | MATH-500 | AMC23 | Olympiad | AIME24 | AIME25 |
|---|---|---|---|---|---|
| Base | 91.88 / 4015 / 82.64 | 90.31 / 6285 / 76.95 | 61.33 / 8972 / 51.28 | 50.83 / 13493 / 40.33 | 37.92 / 15134 / 30.29 |
| DAST | 91.38 / 3720 / 83.95 | 88.12 / 5981 / 76.89 | 59.91 / 9155 / 51.86 | 50.83 / 14423 / 41.40 | 37.92 / 15652 / 31.66 |
| TokenSqueeze | 91.18 / 2442 / 85.92 | 88.44 / 4350 / 79.42 | 60.98 / 6149 / 54.29 | 48.75 / 10457 / 40.14 | 35.83 / 11055 / 31.20 |
| LoCo | 91.80 / 2243 / 86.56 | 91.56 / 3663 / 83.44 | 62.78 / 4968 / 56.61 | 54.17 / 7364 / 46.82 | 40.42 / 8291 / 34.55 |
MATH-500 上,LoCo 准确率只比 Base 低 0.08 个点,输出从 4015 降到 2243 token,减少 44.1%。AMC23 更漂亮:准确率增加 1.25 个点,token 减少 41.7%,AUC 增加 6.49 个点。
真正让我停下来看的是难题。AIME24 上,LoCo 从 Base 的 50.83% 提到 54.17%,同时把 13,493 token 压到 7364,减少 45.4%;AIME25 也增加 2.50 个准确率点并减少 45.2% token。TokenSqueeze 同样能压缩,但这两个集合上分别损失 2.08 和 2.09 个准确率点。DAST 在难题上反而更长。
这支持论文的判断:无脑缩短轨迹容易伤到难题,状态条件化偏好比全局“越短越好”更能保住必要计算。
不过别把小数点后的胜利看得太死。AIME24 和 AIME25 各只有 30 题,即使每题采样 8 次,原表 ± 后的准确率波动项仍有数个百分点,论文也未进一步说明其统计口径。LoCo 的方向一致、AUC 也同时提升,这是好证据;单次均值差却不能当成精确稳定的能力差。
只用数学训练,代码也变短了
代码实验没有混入代码训练 query,同一个 LoRA 直接拿去生成程序。下表同样依次列出“准确率 % / 平均输出 token / AUC %”。
| 方法 | MBPP | LiveCodeBench | CodeContests |
|---|---|---|---|
| Base | 84.05 / 3403 / 78.42 | 41.77 / 12319 / 32.86 | 18.48 / 14900 / 13.87 |
| DAST | 81.13 / 4097 / 76.32 | 39.82 / 14158 / 31.88 | 16.06 / 17757 / 12.61 |
| TokenSqueeze | 81.37 / 2196 / 77.40 | 41.69 / 9670 / 35.03 | 19.09 / 11677 / 15.54 |
| LoCo | 84.05 / 2167 / 79.95 | 42.51 / 9278 / 35.64 | 20.61 / 11413 / 16.78 |
MBPP 上准确率与 Base 持平,token 减少 36.3%;LiveCodeBench 准确率增加 0.74 个点,token 减少 24.7%;CodeContests 准确率增加 2.13 个点,token 减少 23.4%。三个代码基准的 AUC 都由 LoCo 拿到最高值。
这个结果比单看数学更有意思。若只是记住某类数学题的短模板,代码任务不该普遍受益。更合理的解释是,模型学到了一种跨任务的停止偏好:已有信息足够时,不再反复换角度重述。
但“跨领域”在这里仍特指数学到代码,都是答案可自动验证的推理任务。开放式写作、多轮智能体、工具调用里的停止决策是否也适用,现有实验回答不了。
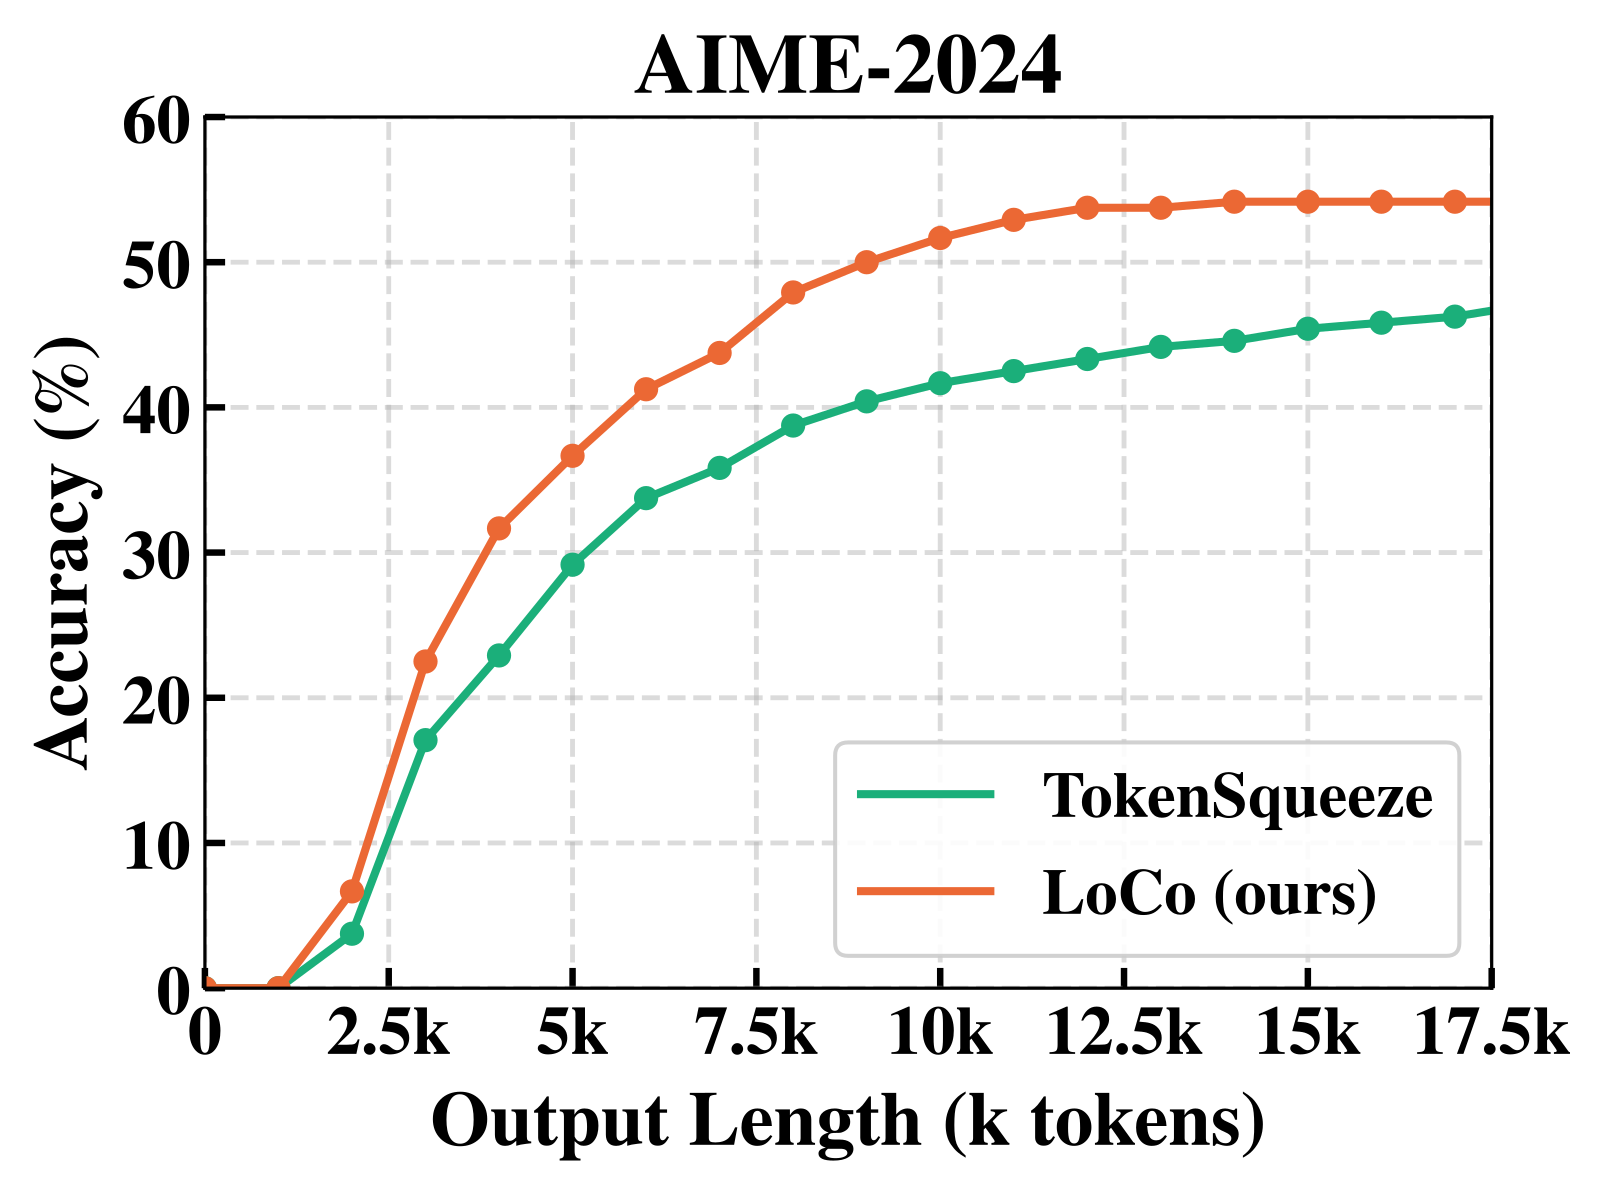
图 2a:横轴是输出长度预算,纵轴是准确率。橙色 LoCo 曲线在绝大多数预算下高于绿色 TokenSqueeze,说明优势不是挑选某一个截断点得到的。
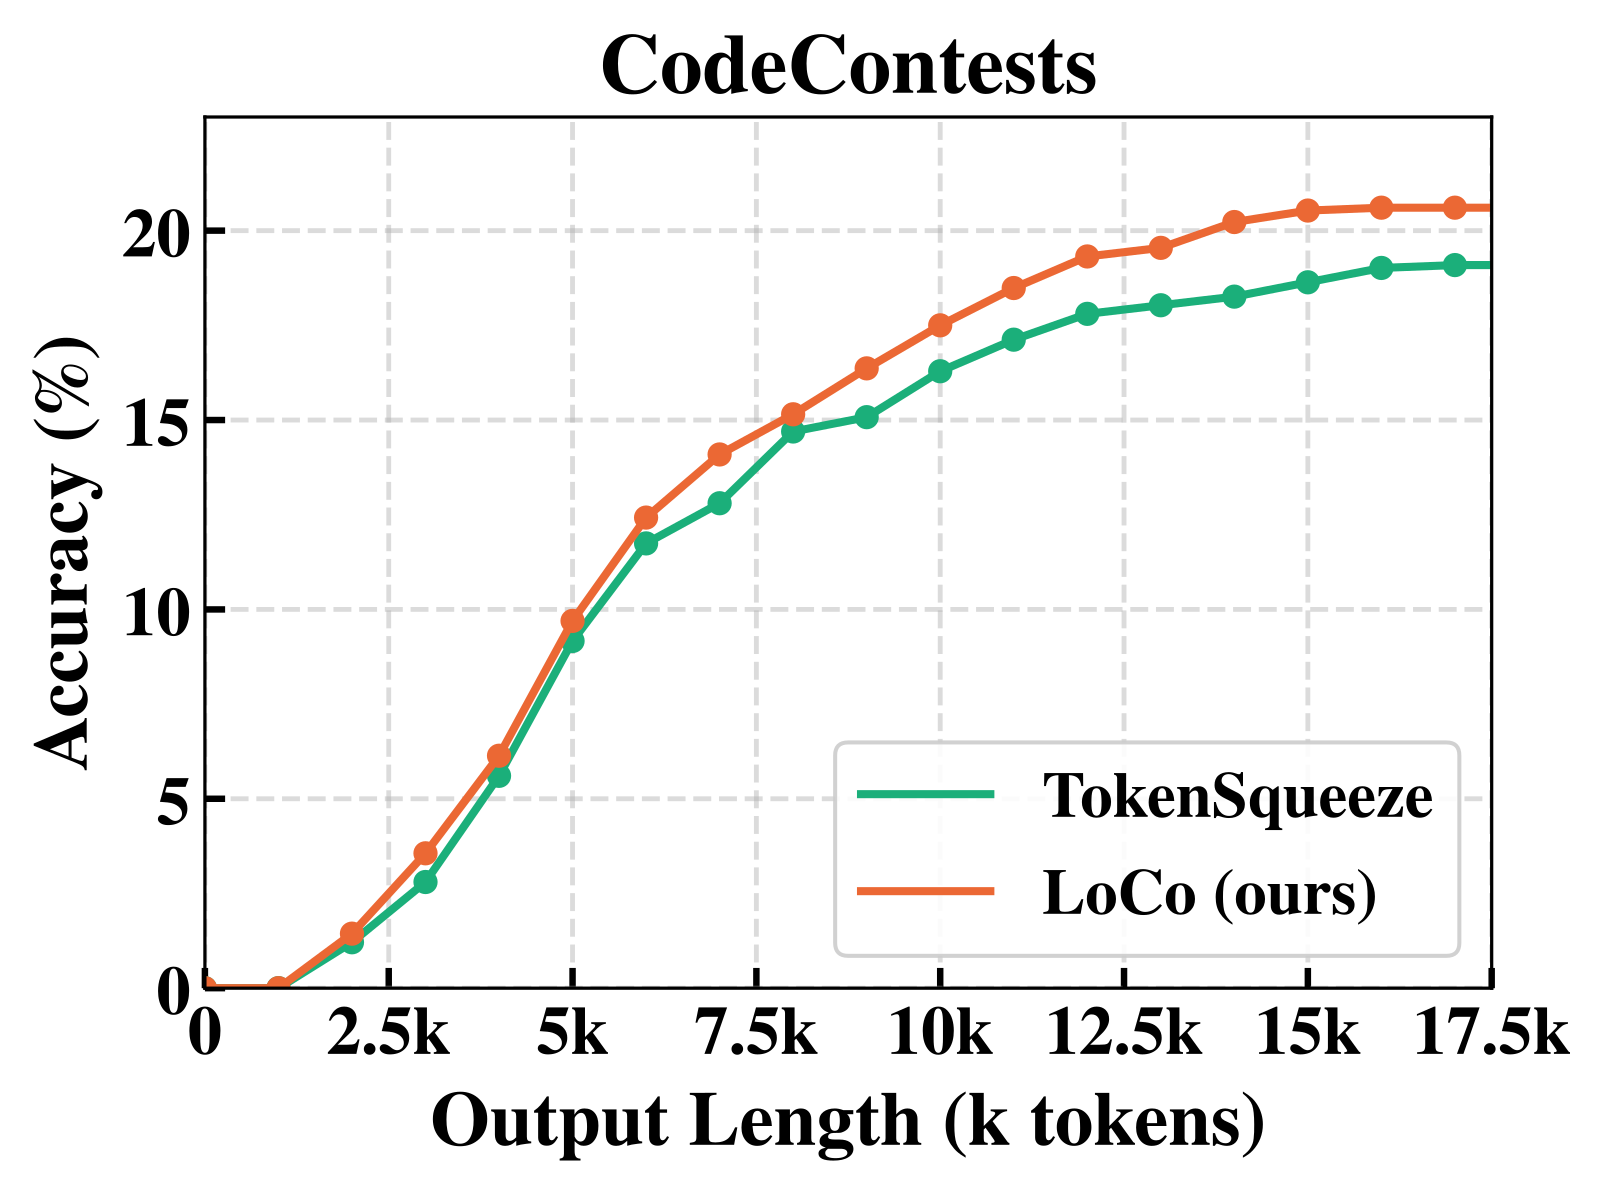
图 2b:代码任务上也出现相同趋势。两条曲线在低预算处接近,预算增加后 LoCo 逐渐拉开差距;这与表中 CodeContests 的 AUC 从 TokenSqueeze 的 15.54 提到 16.78 相互印证。
消融实验:真正起作用的是“在哪里构造偏好”
Table 3 在相同训练设置下改一个变量。每格仍是“准确率 % / 平均输出 token / AUC %”。
| 方法 | AMC23 | AIME24 | AIME25 |
|---|---|---|---|
| Base | 90.31 / 6285 / 76.95 | 50.83 / 13493 / 40.33 | 37.92 / 15134 / 30.29 |
| Global | 90.94 / 5957 / 77.66 | 54.17 / 12002 / 42.57 | 40.42 / 12740 / 32.46 |
| GPT-5.4 Cont. | 90.62 / 4083 / 81.46 | 52.92 / 9204 / 44.11 | 39.58 / 9690 / 33.56 |
| RandCut | 88.44 / 3679 / 80.59 | 48.33 / 7880 / 41.64 | 38.75 / 9151 / 34.06 |
| UniCut | 89.38 / 3573 / 81.17 | 48.75 / 7895 / 42.58 | 36.67 / 8627 / 31.76 |
| LoCo | 91.56 / 3663 / 83.44 | 54.17 / 7364 / 46.82 | 40.42 / 8291 / 34.55 |
Global 去掉冻结状态,只比较同一题最短和最长的正确完整 rollout。它的准确率在部分集合上并不差,AIME24 甚至与 LoCo 同为 54.17%,但 token 只减少 5.2%、11.1%、15.8%,远低于 LoCo 的 41.7%、45.4%、45.2%。这组对照很直接:会选短答案,不等于会在局部停止。
GPT-5.4 Cont. 保留切点和负样本,只把正样本换成外部模型从同一前缀生成的更短正确后续。它也能压 31.8%–36.0% 的 token,但整体 AUC 和压缩幅度不及自生成版本。作者将其归因于分布对齐,这个解释合理,不过外部模型版本、采样条件和生成质量也可能影响结果,不能把差距全归给“风格不一致”。
RandCut 随机选切点,UniCut 均匀选切点,后续流程与 LoCo 相同。两者压得也很短,却在 AIME 上损失更多准确率。附录还给出切点位置:检测器选点的平均相对位置为 0.57,约一半落在轨迹后 40% 的步骤;随机和均匀切点平均位置分别为 0.47 和 0.50,更容易在尚未收敛时提前收尾。
这组消融比主表更能说明方法价值。DPO 本身并不新鲜,自采样短答案也不新鲜,真正值钱的是把合适的局部状态、同源后续和共享前缀组合到一起。
我的判断:漂亮的监督设计,还不是完整答案
我觉得这篇论文最扎实的地方,是问题定义和消融互相咬合。Global 说明局部状态重要,RandCut 与 UniCut 说明切点重要,GPT-5.4 Cont. 说明同源续写有优势。作者没有把收益模糊地归给一个“大框架”,而是拆到了能检验的部件。
工程上还有几件事要冷静看。
评测范围偏窄。 只验证一个 7B 蒸馏基座和 LoRA 设置,没有更大模型、全参数训练或其他模型家族。置信度分位数是否可迁移、检测阈值是否需要重新校准,都没有答案。主表只直接比较 DAST 和 TokenSqueeze,也没有与所有讨论过的步级偏好方法逐一横评。
数据筛选带着成功偏差。 一个状态只有在 8 次采样里出现正确且更短的后续,才会进入训练。这保证了偏好对质量,也让数据偏向“模型本来就能收尾”的位置。真正困难、需要长推理的状态被保留下来是好事;但模型能否学会识别此前没见过的可停止状态,只能间接由下游结果判断。
token 不等于端侧收益。 输出减少约四成通常会降低解码成本,但论文没有报告真实延迟、吞吐、KV cache 峰值或单位任务成本。不同服务框架、批量大小和硬件下,收益不会严格等于 token 比例。
自动验证限制了任务边界。 数据构造需要 gold answer,数学用符号等价,代码用测试执行。换成没有标准答案的任务,怎么验证“短后续仍然足够好”,是这套方法绕不开的问题。
还有一个复现缺口:论文给出了许多阈值,却没有给出最终训练对数量和离线生成预算。对于想复现的人,这往往比 LoRA rank 更决定成本。坦率地讲,这部分我也无法从现有正文补出来,只能等待代码与模型发布后进一步核对。
可以怎么用到自己的系统里
如果你正在做可自动验题的推理模型,LoCo 很值得作为一个数据构造基线。不要从“给所有正确答案加长度惩罚”开始,先保留模型自己的轨迹,找已经有充分答案证据的状态,从同一前缀采样短后续,再验证正确性。即便后续不用 DPO,这种样本也能帮你诊断模型究竟在哪些阶段反复重述。
落地时建议额外记录四组指标:不同难度桶的准确率、输出长度的分位数、真实解码延迟、被过早截断的失败案例。只看平均 token 很危险,少量难题被压坏可能淹死在平均数里。judge 的 normal 与 final 标签也值得保留,它们是在保护必要推进和答案提取,不只是数据清洗的装饰。
对于没有 gold answer 的业务,可以考虑用任务特定的验证器、测试用例或规则约束替代答案等价检查,但那已经是另一套研究问题,不能直接套用论文结论。
回到开头那道星期几的题。LoCo 没有教模型一种更聪明的模 7 算法,它只是告诉模型:同一答案已经用几种方法确认后,再换第五种方法通常没有价值。这个判断很小,却正好发生在 token 被浪费的地方。
这也是我对 LoCo 的定位:不是推理能力的新突破,而是一套问题切得准、证据链较完整的训练数据设计。它值不值得读?做推理压缩、DPO 数据构造或推理部署优化的人,值得;期待一种无需验证器、跨所有任务通用的停止机制,现在还看不到。
参考资料
- LoCo 论文:https://arxiv.org/abs/2611.04814
- LoCo HTML 正文与图表:https://arxiv.org/html/2611.04814v1
- Kimi k1.5 技术报告,Long2Short 背景:https://arxiv.org/abs/2501.12599
- Step-DPO,步级偏好优化前置工作:https://arxiv.org/abs/2406.18629
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我