世界模型最大的浪费,是从不回放:Rollback 让机器人在"想象"里悔棋,8 小时反超人类
你有没有下过这种悔棋——"刚才那步要是不这么走就好了"?
真实世界的机器人没这个福气。一铲子下去,积木塔塌了就是塌了,想重来只能人工摆回去,一次物理交互就是一份真金白银的时间和人力。所以这两年大家一窝蜂去搞世界模型:让机器人在生成的"梦境"里练,别折腾真机。
但说实话,我看到的大多数世界模型 RL 工作,用法都挺憋屈的——把世界模型当成一个只能向前滚的模拟器,rollout 完一条轨迹,中间状态全扔掉,再从初始状态重来。这不还是真实世界那一套玩法吗?
世界模型明明有一个物理环境永远给不了的能力:倒带。回到过去某个决策点,换个动作,看看另一条世界线会发生什么。
arXiv 2610.36068 这篇 Rollback 就是围绕这一个字展开的——"悔"。
核心摘要:世界模型 RL 的痛点在于前向 rollout 把大量算力花在没信息量的探索上,轨迹级奖励又说不出到底哪一步做对了。Rollback 的做法是把世界模型从"被动模拟器"改成"反事实引擎"——回滚到关键决策点、分叉出备选动作、对比兄弟分支的结局,直接提炼出动作粒度的监督信号,全程不需要额外学一个价值网络。在积木抽取、投球入桶、桌面冰壶三个真机任务上,它比最强基线分别高出 10.67、11.11、11.85 个百分点,而且从远低于人类水平的遥操作演示出发,8 小时单机器人训练就在投球和冰壶上反超人类玩家均值。我的判断:这不是一个新世界模型,而是一套把"搜索 + 想象 + 真机反馈"缝在一起的训练范式,工程含量很重,但思路本身是真的漂亮。
📖 论文信息
- 标题:Rollback: Experience Backtracking in World Models for Policy Improvement
- 作者:Jiayi Luo、Yang Zhang、Liliang Chen、Nan Wang、Chen Gao、Boxiang Qiu 等 16 人(Jiayi Luo / Yang Zhang / Liliang Chen 为共同一作,Liliang Chen 为项目负责人,Jianxin Li、Guanghui Ren 为通讯作者)
- 机构:AgiBot(智元机器人)、北京航空航天大学(BUAA)、新加坡国立大学(NUS)
- 链接:https://arxiv.org/abs/2610.36068 (2026 年 10 月 26 日提交)
- 项目主页:https://rollback-wm.github.io/
🎯 问题动机:前向 rollout 的三宗罪
先把现有世界模型 RL 的交互协议摊开看。策略出一个动作块(action chunk),世界模型预测下一帧观测,滚动下去,一条想象轨迹出来,拿个奖励,更新策略。Dreamer 一脉如此,最近的 WMPO、World-Env、RISE 也大致如此。
这个协议有三个结构性问题,论文摆得很清楚:
一,探索预算花错了地方。 一条轨迹上真正决定成败的就那么几个关键决策——投球时的释放瞬间、推积木时发力那一下——其余大部分步骤换不换动作结果都差不多。独立 rollout 认不出这些点,只能均匀撒钱。
二,信用分配稀得可怜。 轨迹最后给一个 0/1 的成败标签,中间几十步谁该背锅?传统解法是再训一个价值网络,但价值网络本身带估计偏差,这是个老坑了。
三,世界模型会被策略"带偏"。 策略在变好,它访问的状态分布必然漂出世界模型的训练分布。预测误差累积起来,优化器就开始钻空子——想象里明明成功了,真机上一塌糊涂。这种 reward hacking 式的幻觉利用,做过 model-based RL 的人应该都深有体会。
这三个问题的共同解法,其实就藏在世界模型的一个被闲置的属性里:它的时序上下文 \(m_t\) 是个显式的数据结构,可以缓存、可以恢复。
恢复一个缓存的上下文,从同一个历史状态分叉出 \(n\) 个不同动作的续推。物理环境做不到这件事——你没法把现实世界 Ctrl+Z。而且想象是从真实观测锚定的状态开始的,不是从某个合成初始帧;共享前缀只生成一次,新分支的成本只跟自己的长度有关。

图1:三种范式的对比。(a) 真实世界 RL 代价高昂,每次失败都要人工复位;(b) 前向 rollout 的世界模型 RL 把大量预算花在低信息量探索上,训练还不稳定;(c) Rollback 通过经验回溯树搜索获得高价值探索和稠密监督,真实反馈同时反哺世界模型。底部是三个真机任务:积木抽取、投球入桶、桌面冰壶。
🧠 方法核心:把"悔棋"做成一套搜索系统
Rollback 由三个部件组成,我一个个拆。
经验回溯树搜索:MCTS 搬进世界模型
整体骨架是 AlphaGo / Expert Iteration 那一套"搜索-蒸馏"循环——策略提议动作,搜索评估动作,策略再从搜索结果里学。区别在于:搜索发生在视频世界模型内部,起点是真实机器人踩过的坑,而不是精确模拟器。

图2:(a) 经验回溯树搜索恢复缓存的世界模型上下文,探索有信息量的分支且不重复生成共享前缀;世界模型同时预测多视角图像和本体感觉状态。(b) 树结构价值估计把兄弟分支的结局聚合成相对质量标签(0.75/0.50/0.00 对应 High/Mid/Low),不需要额外价值网络。(c) 世界模型与策略共进化,真实轨迹通过 test-time physics grounding(LoRA SFT + DMD)持续修正世界模型。
几个关键设计值得单独说。
决策上下文的构建。 世界模型用的是 GE-Sim 2.0(智元自家的视频世界模型),给定动作块,它联合预测三个相机视角的未来帧,还通过一个位姿专家头预测本体感觉(每条臂 7 个关节 + 1 个夹爪)。为什么要预测本体感觉?因为没有它,策略只能从生成图像里硬猜手臂位形——对抽积木、释放球这种精细接触任务来说太粗了。这个细节我觉得是懂机器人的人才会注意到的。
MCTS 引导的探索。 每个节点维护访问次数 \(N(v)\) 和累积回报 \(W(v)\),用经典 PUCT 公式选分支:
前一项利用高成功率分支,后一项照顾访问少的分支。动作块是连续高维的、没法枚举,所以用了 progressive widening 控制每个节点最多展开的子动作数(上限为 \(\lceil c_{pw} \max(1, N(v))^{\alpha} \rceil\)),再加一个零值虚拟子节点跟现有子节点同台竞争,平衡"试新动作"和"深耕旧分支"。
策略引导的扩展。 新分支的动作从哪来?直接从当前策略里采样——具体说是以最高价值 bin 为条件的策略 \(\pi_\theta(\cdot \mid o_v, g, b=K)\),换个噪声种子采一个新动作块。这就是 Sampled MuZero 的路数:搜索只探索策略认为合理的动作,不在整个连续空间里瞎摸。
分歧驱动的细化。 这个设计我很喜欢。兄弟分支只有结局不同时才有训练信号,但一两次 rollout 的差异可能是运气。所以当两个兄弟子树的临时价值落在不同 bin 里时,父节点进优先队列,继续给访问最少的兄弟追加 rollout,直到每个兄弟至少攒够 \(n_{\mathrm{conf}}\) 次访问(积木/投球/冰壶分别是 5/9/5 次)。预算集中在能产生监督的对比上,同时压标签噪声。
树结构价值估计:不训价值网络的信用分配
这是全文我最喜欢的一环。
兄弟分支共享同一个决策上下文——之前的历史一模一样。那么对比它们的下游结局,就把单个动作的因果效应给隔离出来了。这就是天然的对照实验,你还训什么价值网络?
具体做法:动作块 \(\mathbf{a}_i\) 的子树里所有叶子结局取平均,得到块级价值估计:
然后在兄弟组内做相对归一化,离散成 \(K\) 个 bin(\(K=5\)):
等等,这个组内相对归一化是不是有点眼熟?对,就是 GRPO 那套 group-relative 的思路——DeepSeek 的 GRPO 是对同一个 prompt 的多个采样做组内对比,这里的"组"是从同一个恢复上下文里采的多个动作。不同难度的决策上下文贡献可比的监督,全 bin 相同的组直接丢弃(没有偏好信号)。
结局判定用的是 GE-Sim 2.0 的 world judge(一个按任务微调的奖励模型,二分类判断任务是否完成),只判断"完成的 rollout 成不成功",这比从中间状态预测成功率的价值模型好学得多。
优势条件化策略更新
策略用 \(\pi_{0.5}\)(Physical Intelligence 的 VLA 模型),按 RECAP 的方式把 bin 标签编码进 prompt,训 flow matching 目标:
其中 \(\mathbf{x}_s = (1-s)\mathbf{a} + s\bm{\epsilon}\)。训练时以 \(p_{\mathrm{drop}}=0.5\) 的概率随机丢掉优势条件;搜索和部署时条件在最高 bin 上,并用 classifier-free guidance(强度 \(\beta=1.5\))往高质量方向拉一把。成功的真实轨迹拿最高 bin,失败的拿最低 bin,树监督样本和离线演示混在一起成 \(\mathcal{D}_{\mathrm{mix}}\)。
Test-Time Physics Grounding:世界模型的"在用期校准"
这个概念是论文里我觉得最有话语权的提法。
传统物理引擎的动力学是手写的,系统辨识只能调固定模型的参数。而学习型模拟器可以直接吸收新的真实转移——在被当作训练环境使用的同时,它的物理还能被它训练出来的策略所修正。
具体管线很务实:每次适配把新收集的真实轨迹并入回放集,先跑 400 步 LoRA SFT(不动全模型,轻量到可以在训练中反复跑),再跑 100 步 DMD(分布匹配蒸馏)恢复少步采样能力,供搜索高效使用。
为什么非做不可?初始世界模型是在专家数据上微调的,见过遥操作的接触和物体运动,但没见过"以新方式失败或成功的策略"产生的状态。论文举了个例子:积木本该倒的时候预测成没倒——这种错误会被搜索当成"成功"利用,标签直接污染。一个不断变强的策略,恰恰会持续漂向模拟器训练数据覆盖最少的状态。这句话我觉得值得抄下来贴在所有做 world model RL 的人的工位上。
🏗️ 系统:48 块 H200 与 1 台机器人的异步共舞
视频世界模型里跑搜索非常吃算力,真机交互又慢得没法并行。同步循环(采数据→搜索→训练,轮流来)会让每种资源干等另外两种。Rollback 的答案是全异步:机器人执行、世界模型搜索、策略训练、世界模型适配四个进程并发跑,只通过一个共享数据池(Experience Fabric)和版本化快照交换信息,谁也不等谁。

图3:云-边-端三级架构。云端 GPU 跑树搜索并训练策略与世界模型;Experience Fabric 分流传输真实轨迹和树监督;边缘站跑策略推理并缓存权重快照;机器人只负责感知和执行。
实验配置是 48 块 NVIDIA H200——40 块跑世界模型搜索,8 块跑策略训练(DDP)——服务 1 台 AGIBOT Genie-02 机器人。每块搜索 GPU 自带策略副本、世界模型实例和上下文缓存,树的操作全在单卡内完成,网络流量只剩种子分发、监督回传和权重同步。每棵树钉死启动时的模型版本(version-pinned),保证树内所有分支由同一策略提议、同一世界模型模拟,兄弟结局可比。

图4:机器人持续执行最新策略并上传真实轨迹 \(\mathcal{D}_{\mathrm{real}}\);策略用树监督 \(\mathcal{D}_{\mathrm{tree}}\) 持续更新;世界模型经 LoRA SFT + DMD 反复适配真实数据,每棵新搜索树用两个模型的最新版本。
坦率讲,48 块 H200 换 1 台机器人 8 小时的训练——这笔账值得后面专门吐槽。
🧪 实验:数字相当能打
三个真机任务都设在 Genie-02 机器人上:积木抽取(抽叠叠乐积木且塔不倒,考验接触丰富的精细操作)、投球入桶(考验释放时机)、桌面冰壶(人机各投两壶,按最终位置计分,带对抗性)。策略观测三路 RGB(一个头戴 + 两个腕部相机)加本体感觉,输出 16 维动作、30Hz 控制。
主实验
| 方法 | 类别 | 积木抽取 | 投球入桶 | 桌面冰壶 | 平均 |
|---|---|---|---|---|---|
| \(\pi_{0.5}\) + SFT | 模仿学习 | 48.67 | 23.33 | 48.89 | 40.30 |
| \(\pi_{0.5}\) + RECAP | 真机 RL | 56.00 | 25.56 | 51.11 | 44.22 |
| \(\pi_{0.5}\) + RISE w/ GE-Sim2 | 世界模型 RL | 58.67 | 28.89 | 52.59 | 46.72 |
| Rollback(Ours) | 世界模型 RL | 69.33 | 40.00 | 64.44 | 57.93 |
| 相对最强基线增益 | +10.67 | +11.11 | +11.85 | +11.21 |
表1:三个真机任务的成功率(%)。所有方法用同一 \(\pi_{0.5}\) 初始化和可比的算力预算。
有个对比角度论文算得很妙:真机 RL(RECAP)比 SFT 涨 3.92 个点,前向世界模型 rollout(RISE w/ GE-Sim2)再涨 2.49 个点,而经验回溯在同一个世界模型上直接涨 11.21 个点——比前两者加起来还多。增益来自回溯和树监督本身,不是来自更好的世界模型,因为 RISE w/ GE-Sim2 用的是同一个 GE-Sim 2.0,这个对照设计把混杂因素剔得很干净。
投球任务的相对增益最大(比 RISE 高 38.5%),道理也直白:球的成败就在释放那一瞬间,从同一上下文对比兄弟动作,直接把"哪种释放更好"给点出来了。
消融实验
| 变体 | 目标接触率 | 任务成功率 | 连续抽取数 |
|---|---|---|---|
| 冻结世界模型(去掉 physics grounding) | 78.67 | 64.67 | 1.90 |
| 直接奖励监督(去掉子树聚合) | 77.33 | 59.33 | 1.73 |
| Rollback 完整版 | 89.33 | 69.33 | 2.60 |
表2:积木抽取任务上的消融(%)。两个部件拆掉任何一个,三项指标全线下滑。
直接奖励监督掉得最狠(成功率 59.33%)——每个标签只依赖单次随机 rollout,而不是子树平均,方差直接爆炸。冻结世界模型则让连续抽取数从 2.60 掉到 1.90:长序列的接触决策上预测误差累积,练到后来策略在跟一个不准的物理对练。
训练动态与超越人类
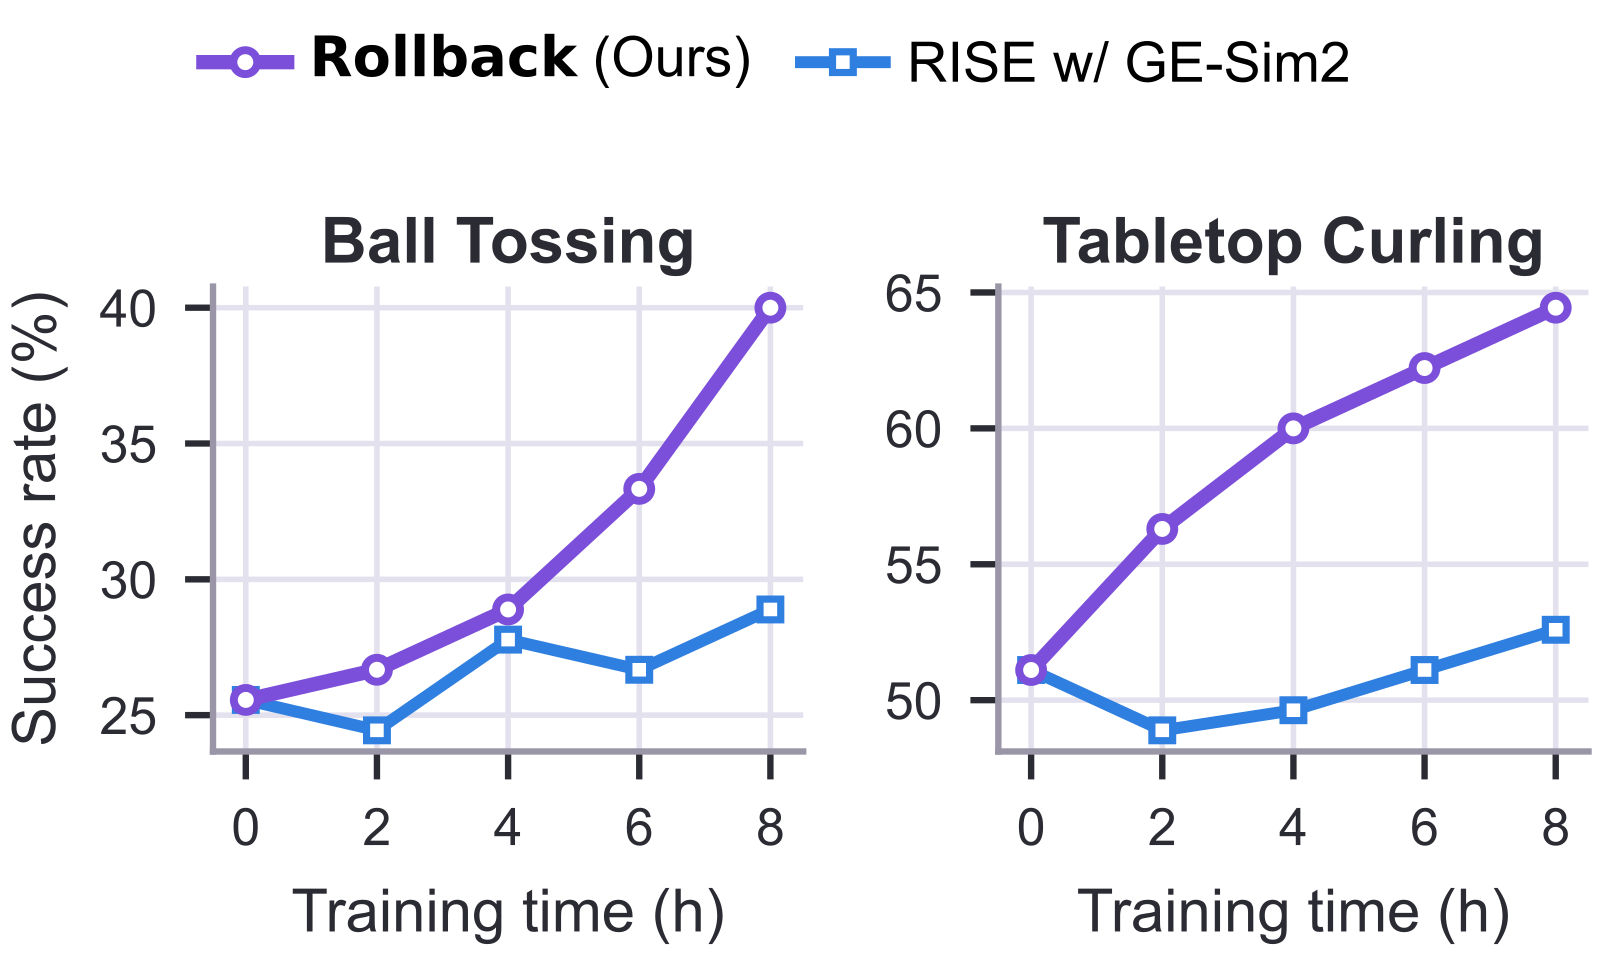
图5:8 小时训练过程中 Rollback 与 RISE w/ GE-Sim2 的真机成功率对比。投球任务上 Rollback 从 25.56% 稳步爬到 40.00%,RISE 前 2 小时反而跌到 24.44%,终值只有 28.89%;冰壶任务上 Rollback 从 51.11% 涨到 64.44%,RISE 几乎原地踏步(52.59%)。两条曲线的差距随训练时间持续拉大。
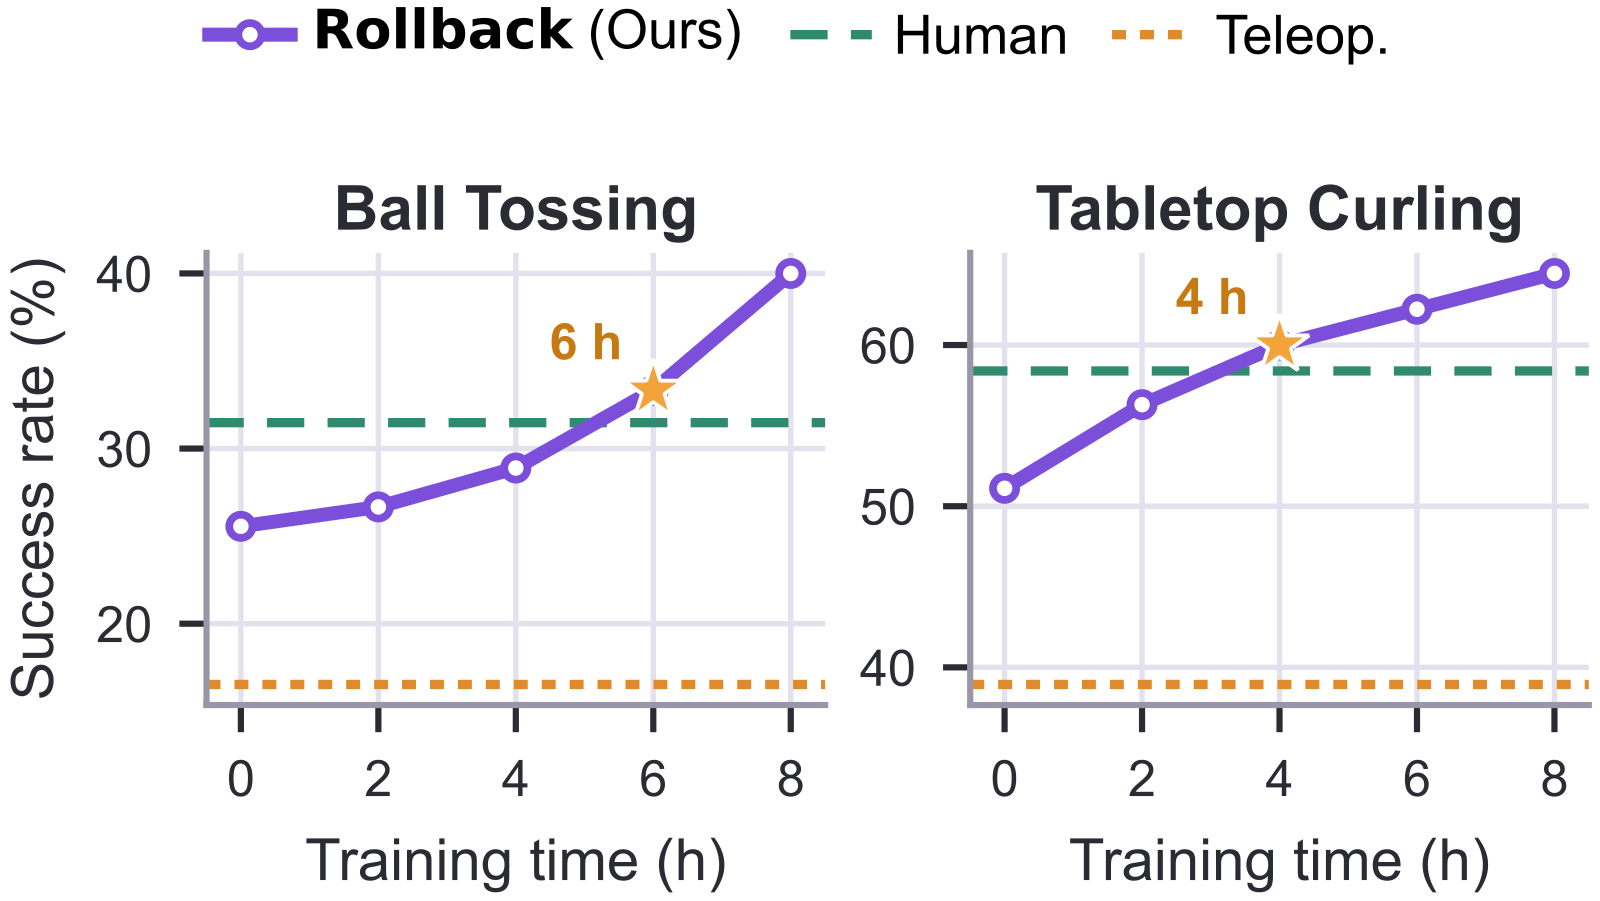
图6:与人类玩家(绿色虚线)和遥操作(橙色虚线)的对比,星星标记 Rollback 首次超过人类均值的时刻。投球:人类 31.48%、遥操作 16.53%,Rollback 第 6 小时反超人类(33.33%),8 小时达 40.00%;冰壶:人类 58.39%、遥操作 38.94%,Rollback 第 4 小时即反超,8 小时达 64.44%。
注意一个细节:Rollback 的起点是遥操作演示训出来的策略,远低于人类水平(投球 25.56% vs 人类 31.48%,而且遥操作本身只有 16.53%)。它从没见过人类玩家打球,超过人类的余量全部来自在想象中对比自己的备选动作。这个叙事在具身智能里挺罕见的——大部分工作还在追逐人类演示的上限。
世界模型保真度

图7:(a) 冰壶任务上的搜索树,蓝色虚线是真实尝试,彩色路径是想象续推,绿/红边表示下游续推全成功/全失败,紫色环标记中间决策点。(b) 想象内部第 50 步的分叉:两条续推第一壶推法相同,但续推 1 第二壶释放够快滑进大本营,续推 2 释放偏慢停在门前。(c) 对真实尝试第 200 步的回溯:记录的推法约 10 步把壶送进大本营,想象的替代动作推得更轻,滑了约 60 步停在大本营外。同一个恢复上下文,两种命运——决策因果被干净地隔离出来。
保真度这块论文做了两组开环评测。积木抽取上回放 8 条失败真实轨迹(每条 5 次共 40 个 rollout),奖励模型零误报(0/40)——误报会把失败的想象分支标成正样本,直接毒化相对价值标签,这个数字相当关键。冰壶上对比冻结与共进化世界模型:
| 世界模型 | PSNR 头部相机(越高越好) | RGB L1 前 1/4 段(越低越好) | RGB L1 末 1/4 段 | 三次 rollout 间离散度 |
|---|---|---|---|---|
| 冻结 | 21.50 | 12.48 | 23.73(1.90 倍增长) | 9.39 |
| 共进化 | 22.27 | 10.50 | 14.47(1.38 倍增长) | 6.12 |
表3:64 个验证 episode 上的开环保真度。共进化模型的平均 RGB L1 误差从 19.52 降到 12.96,降幅 33%,且误差随 rollout 深度的增长明显放缓。

图8:(a) 同一验证 episode 的开环预测:真实记录(上)、冻结模型(中)、共进化模型(下)。冻结模型在第 130 步把停在大本营中心的壶"幻觉"到了边缘(红框标注 stone drifts off center),第 215 步又提前变出了第二颗壶(next stone arrives early);共进化模型则与真实记录一致。(b) RGB L1 误差曲线:共进化模型全程显著更低。
这种幻觉不是无伤大雅的画面瑕疵——它改变想象投壶的得分,进而改变该分支上所有动作的价值标签,最后蒸馏进策略。这就是 test-time physics grounding 存在的理由,用图说话比什么都有说服力。
🤔 我的判断:亮点与泼冷水
亮点是真的亮。 把"回溯"这个世界模型独有、物理环境给不了的能力上升为训练原语,这个视角本身就值一篇文章。而且它不是空谈概念:MCTS + progressive widening + 分歧细化负责把算力砸在关键决策上,兄弟对照 + 子树聚合负责免价值网络的信用分配,LoRA SFT + DMD 负责世界模型的在用期校准,48 卡异步系统负责把这一切跑起来。四层环环相扣,每一层都有消融或保真度实验背书。方法论上,GRPO 的组内相对优势被自然移植到"同一上下文的备选动作"上,这个类比迁移做得漂亮。
冷水也得泼几盆。
第一,算力账要算清楚。48 块 H200 伺候 1 台机器人 8 小时,换来约 11 个点的成功率提升。按市价粗算这一轮的算力成本远超人工采集同等提升所需数据的成本——当然作者的论点是 GPU 可以横向扩、机器人数量扩不了,搜索吞吐随卡数线性涨,这个逻辑成立,但对绝大多数团队来说这个配置不可复制。这套范式目前更像头部玩家的游戏。
第二,奖励模型是任务特定的。world judge 要按任务用标注视频微调,三个任务三个 judge。失败模式分析里也承认短投/超投/碰框这些判定都压在释放窗口的判别上。泛化到开放任务集时,"每个任务训一个判定器"的成本会重新变成瓶颈,作者在 Limitations 里也认了这条。
第三,RISE 基线是作者复现版。所有 RISE 数字来自"RISE w/ GE-Sim2"这个在同世界模型上的复现,而非原论文结果。作为消融这个设计很科学(隔离世界模型质量),但横向对比 RISE 原论文的数字时读者要心里有数。另外每个位置 15-25 次 trial、三个任务的人工评测规模,统计误差条基本没给,曲线的"稳定提升"是基于稀疏评测点的。
第四,单任务单机器人。每个策略只训一个任务,多任务策略、多机器人共享搜索集群都留给了未来工作。
跟同期工作摆在一起看:WoVR 也做世界模型-策略共进化,World-Gymnast 也用真实经验迭代更新世界模型——Rollback 的差异点在于把"回溯 + 树搜索"作为监督的来源,而不仅是把世界模型当前向环境用;它跟 RIPT-VLA、SimpleVLA-RL 这些免价值网络的真机 RL 也是互补关系,一个赢在交互密度,一个赢在工程简单。
📝 收尾
如果你在做世界模型 RL,这篇论文有两样东西可以直接搬走:一是"从同一恢复上下文采样兄弟动作、组内对比出标签"的免价值网络监督范式,实现成本不高,跟 GRPO 的代码骨架几乎同构;二是"学习型模拟器必须在用期持续接地"的警告——冻结的世界模型在变强的策略面前必然失真,LoRA 轻量适配 + 蒸馏恢复采样效率是个够用的工程答案。
还有一个更本质的问题悬着:当世界模型足够好、回溯搜索足够深,机器人训练会不会彻底变成"算力换交互"的生意?8 小时反超人类只是三个受控任务上的结果,但至少方向是清楚的——真实世界的试错成本,正在被可倒带的想象力替代。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我