不到 2% 的注意力头,撑起了多模态模型的"大海捞针"——还能拿来直接训练
核心摘要:Retrieval heads(检索头)这个概念在纯文本大模型里已经被验证过——少数注意力头负责把长上下文里的证据"搬运"到输出端,掐掉它们模型就找不到针了。但模型一路进化到能听、能看、能看视频的全模态形态之后,这套机制还在吗?是每种模态各长一套,还是共用一套?更重要的是,既然知道了是哪些头在干活,能不能直接训练它们?这篇论文把 18 个覆盖语言、视觉语言、全模态的 checkpoint 拉到一起做了解剖:答案是检索头在新模态下依然稀疏、跨模态大面积共享、从 backbone 一路继承,而且共享的那撮头不到全部头的 2%,掐掉它们不光音视频检索归零,连视觉数学、空间感知都跟着崩。最后作者把检索头的注意力当成优化目标,用一个 ranking loss 直接训练,Qwen3-VL-8B 在 MMDocIR 上的页面检索 Recall@1 涨了 6.03 个点。这是我看过的"可解释性发现反哺模型改进"里,链路走得比较完整的一篇。
论文信息
- 标题:A Broader Look into MLLM's Retrieval Heads
- 作者:Jia Wang, Yuqing Li, Jiangnan Li, Zheng Lin, Mo Yu
- arXiv:https://arxiv.org/abs/2610.32411 (2026 年 10 月 23 日提交,cs.CL,标注为 work in progress)
从一个老问题聊起:模型是怎么从 24K token 里找到那串数字的?
做长上下文评测的人都玩过"大海捞针"(Needle-in-a-Haystack):往超长文本里塞一个秘密数字,问模型这个数字是什么。文本场景下,2025 年 Wu 等人的工作找到了答案——模型里存在一小组 检索头(retrieval heads),它们干的就是把问题指向的上下文内容复制到输出的活。消融掉这些头,检索能力直接崩。后来 MMRetHead 把这套分析推广到了视觉语言模型,结论类似。
但说实话,我一直有个疑问没被打消:现在的全模态模型(omni-modal model)输入是音频、视频、文本混着来的,同一个答案可能出现在语音里、也可能打在屏幕上。模型会怎么处理?为每种模态单独演化一套检索机制,还是说检索这件事足够底层,跟模态无关?
这个问题问起来容易,做起来有个坑:正常情况下不同模态的证据内容根本对不齐,你没法判断"头不一样"是因为模态不同还是内容不同。这篇论文的实验设计就是冲着这个坑来的。
AV-NIAH:一个控制变量做得相当干净的实验
作者的解法很直接——构造成对的音视频输入,让同一个答案只在一个维度上变化:它是被"说出来"还是被"显示出来"。
具体做法:取 MLVU 的背景视频,往里面插一个六位数的针。音频条件下,合成语音把数字念出来("three nine eight one six one"),视频画面不动;视觉条件下,数字以横幅形式在屏幕中央显示一秒钟,音轨不动。背景视频、插入位置、问题("What is the secret number?")全部保持一致。背景时长 100 秒和 300 秒两档,大约对应 8K 和 24K 的输入 token。
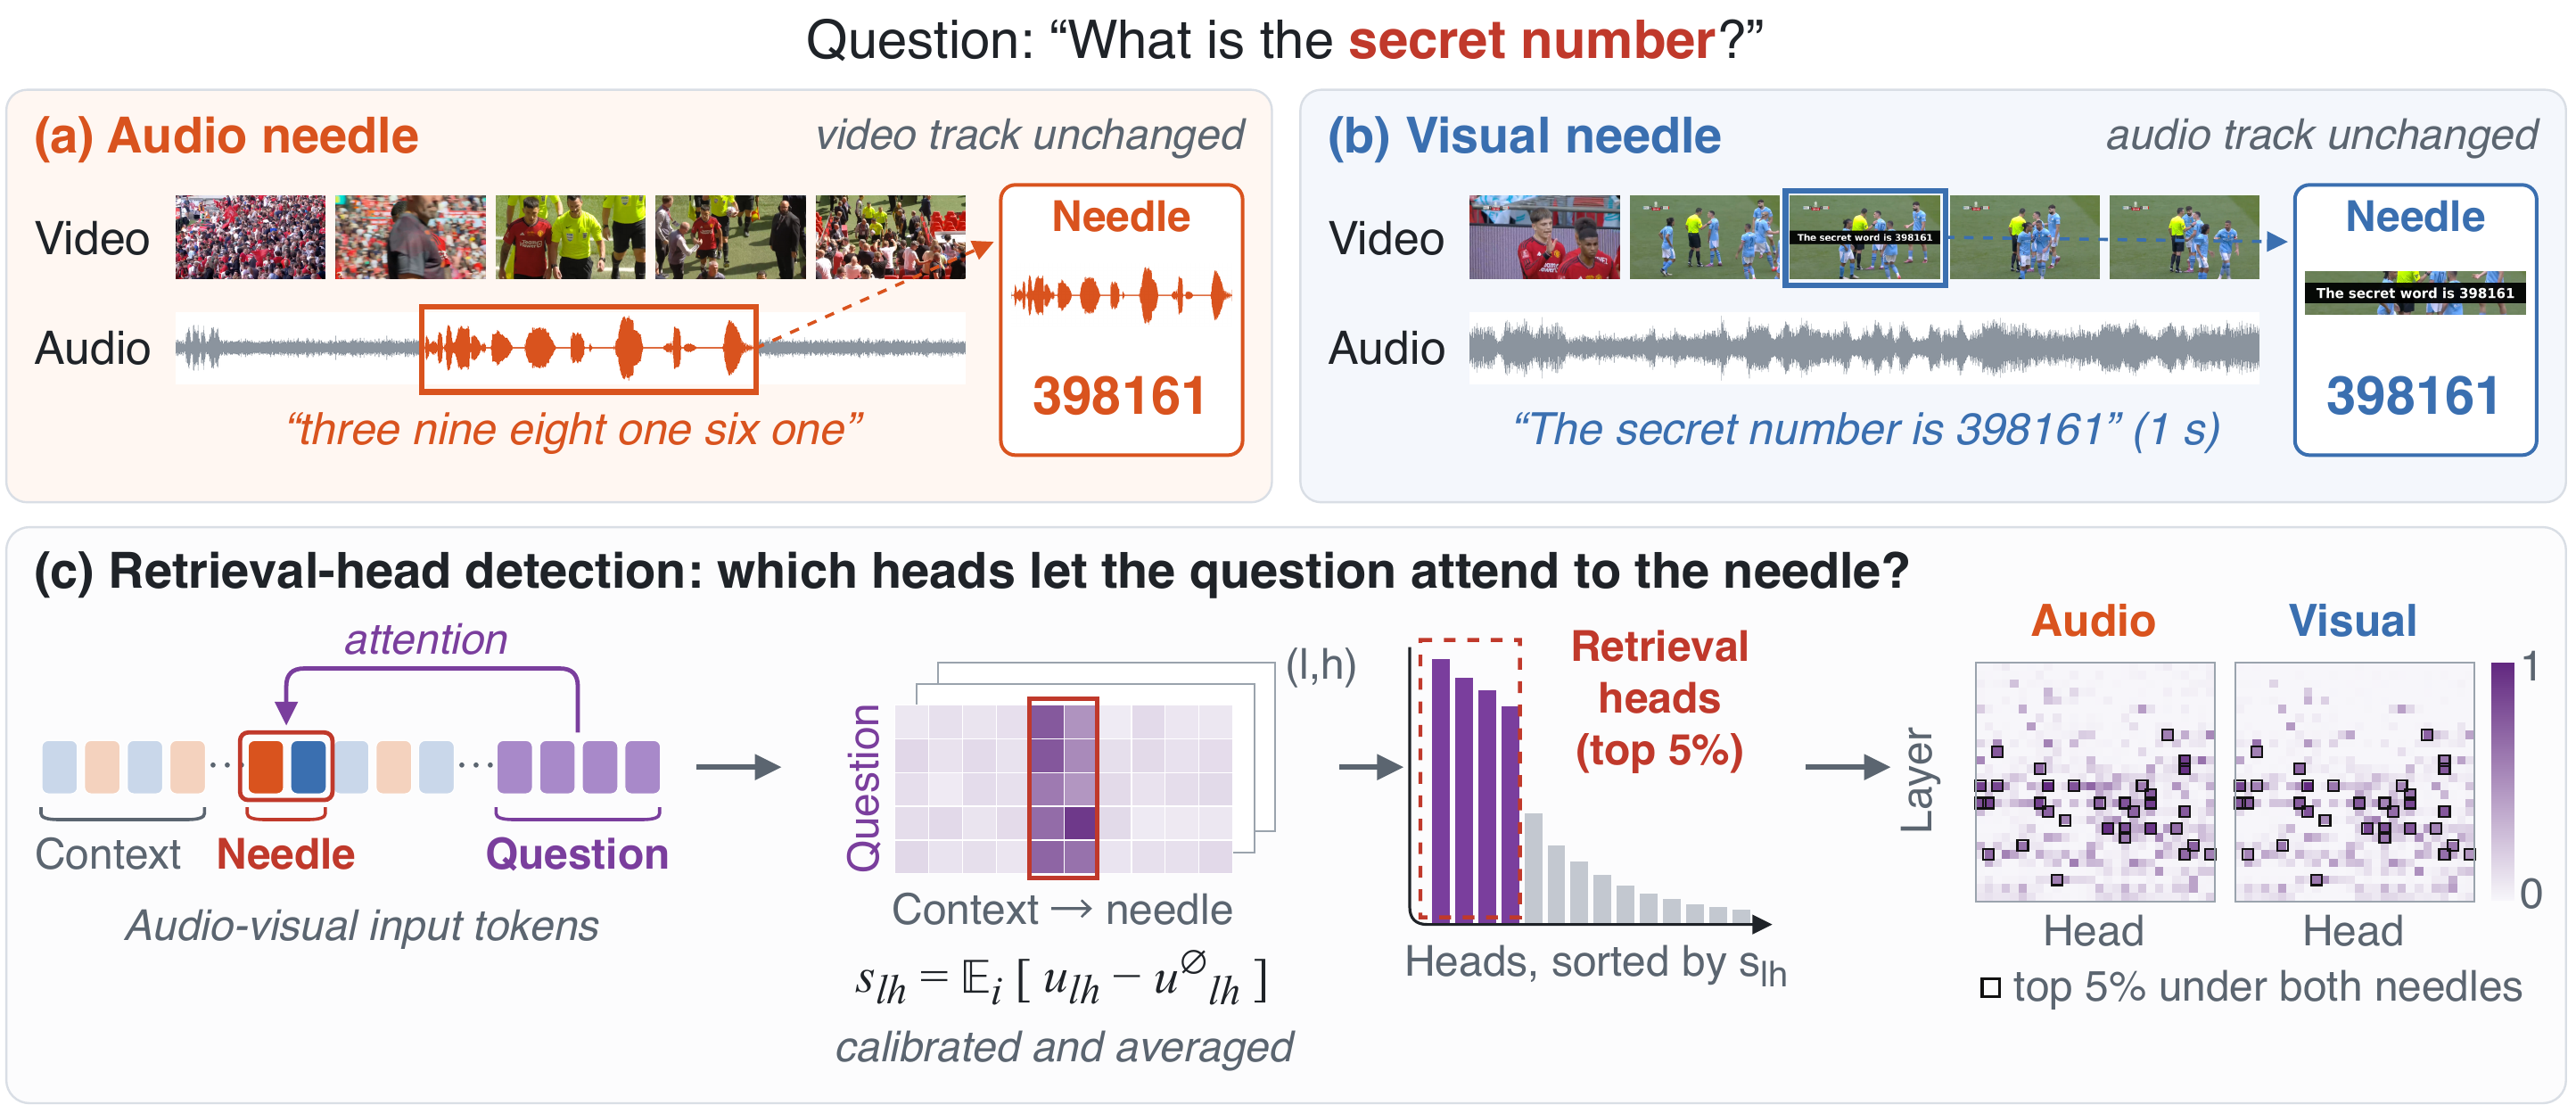
图1:(a)(b) 成对的 AV-NIAH 输入,同一个答案 398161 要么被语音念出、要么以一秒横幅显示在画面中,另一轨保持不变;(c) 检索头检测流程——把针映射到输入 token,测量每个头从问题到针的注意力,减去无信息问题的基线后平均。右侧两张热力图是 Qwen2.5-Omni-7B 的实测分数(行是层、列是头),高分的头寥寥无几,且两种模态下 top 5% 的头大面积重叠。
有了配对数据,检测方法沿用并校准了前人的方案。对每个头,计算问题 token 对证据 token 的平均注意力:
这里有个细节我觉得值得单独说一句:原始注意力里混着跟问题无关的位置偏好和内容偏好(有些头天生就爱注意某些位置),所以作者用同一个上下文配一个无信息问题重算一遍注意力,两者相减得到校准分数:
按 \(s_{lh}\) 排序,默认取 top 5% 作为检索头。这个"减去空问题基线"的校准思路来自 MMRetHead,不是什么新东西,但它是后面所有结论干净与否的关键——不校准的话,你测到的可能只是一堆头的位置癖好。
模型阵容也铺得够广:18 个 checkpoint,涵盖语言模型(Qwen2.5-3B/7B、Qwen3-4B/8B)、视觉语言模型(Qwen2.5-VL-3B/7B、Qwen3-VL-4B/8B、MiniCPM-V-4.5)、统一架构(BAGEL-7B)、全模态模型(Qwen2.5-Omni-3B/7B、MiniCPM-o-2.6/4.5、SALMONN 2+ 3B/7B、SALMONN Pro 4B/8B)。其中不少全模态模型就是从列表里的语言或视觉语言 backbone 适配来的,这个"血缘关系"后面有大用。
四个发现:稀疏、共享、继承、缺一不可
发现一:语音证据面前,检索头依然稀疏
第一个问题:证据变成语音之后,检索行为会不会变得"弥散"——需要很多头一起上?
答案是不会。图2 的热力图一目了然:在音频证据条件下,Qwen2.5-Omni-7B 和 SALMONN Pro 4B 的分数高度集中在中部和中后部的少数坐标上,绝大多数头分数接近零。八个全模态模型、两种证据模态下结论一致:贡献一半正向分数的头不到总数的十分之一。
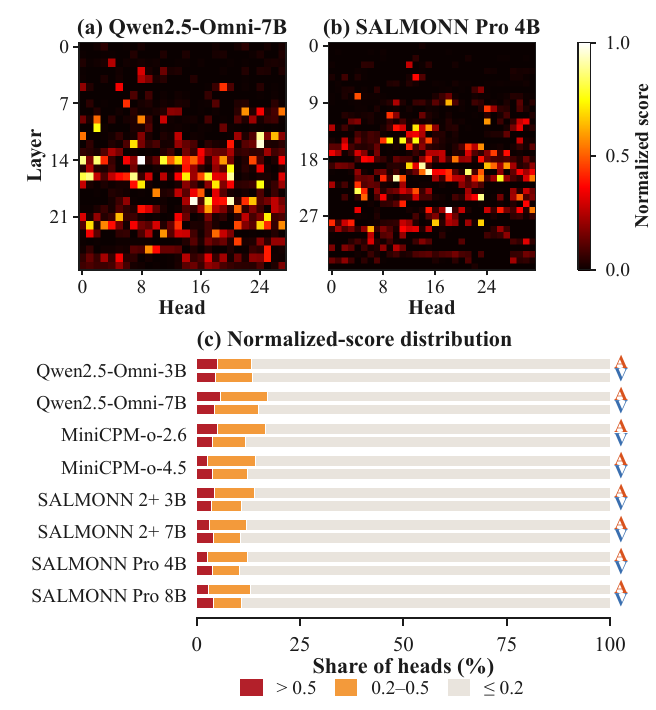
图2:(a)(b) 两个代表性模型在音频证据下的校准分数热力图(按模型归一化到 [0,1]),亮点集中在中部层;(c) 八个全模态模型在音频(A)和视觉(V)证据下的分数分布,超过 0.5 分bin的头(深红色)只占很小一条。
稀疏性这个性质从文本到图像再到语音,一路保持了下来。说实话这不完全出人意料,但有人系统地验证一遍总比大家默认它成立要好。
发现二:说出来和显示出来,用的是同一拨头
这是全文我最喜欢的一个结果。既然证据内容被实验设计钉死了(都是那串六位数字),头集合的差异就只能来自模态本身。
结果:每个模型里,音频和视觉两种条件下选出的 top 5% 检索头,69% 到 83% 是同一批。做个对比——如果两套头是独立随机选的,重叠的头数期望不到 3 个。全排序层面的一致性也很强,Spearman \(\rho\) 在 0.88 到 0.92 之间,而且留一法换检测素材、换 300 秒长背景,结论都稳。
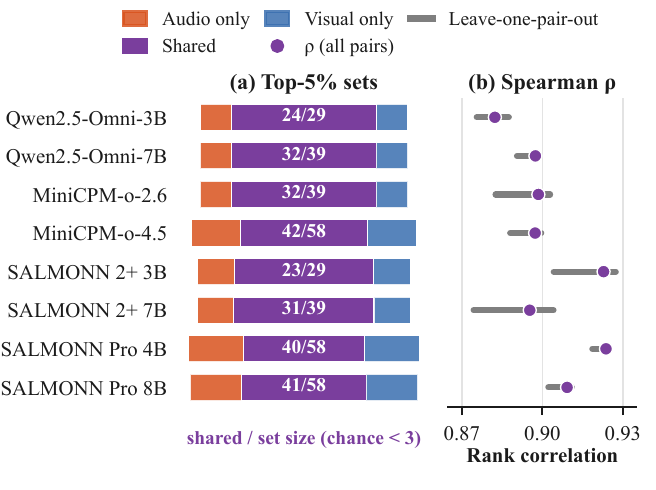
图3:(a) 八个模型中两种条件各自选出的 top 5% 头集合,紫色部分是共享的(数字为共享数/集合大小),随机基线下共享不到 3 个;(b) 两种条件全头分数的 Spearman 相关系数,所有模型都在 0.87 以上。
剩下的那部分不一致来自哪?作者做了个对照:把"语音念数字"跟 MM-NIAH 里"自然图像证据"比,相关性就掉下来了。也就是说,决定头招募的首要因素是检索目标的内容,模态反而排在后面。同一个目标,说出来还是显示出来,模型用同一套电路去捞。
发现三:模态适配不会洗掉 backbone 的检索结构
前面提到模型之间有血缘关系:SALMONN 系列从 Qwen2.5-VL / Qwen3-VL 适配而来,Qwen2.5-Omni 从 Qwen2.5 语言模型适配而来。固定一个文本检索任务,比较适配前后头分数的排序相关性:
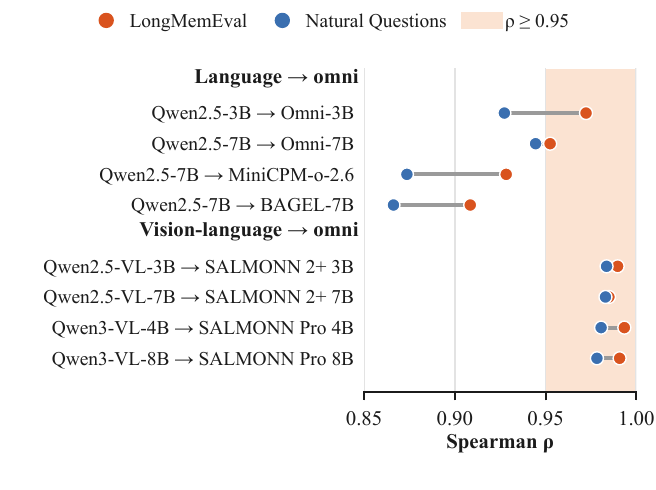
图4:backbone 与适配后 checkpoint 在两个文本检索任务(LongMemEval、Natural Questions)上的头分数 Spearman 相关。阴影区是 \(\rho\geq0.95\)。SALMONN 系列与其视觉语言 backbone 几乎完全一致(\(\rho\geq0.97\)),Qwen2.5-Omni 与其语言 backbone 也保持高度相关。
SALMONN 和它的 VL backbone 之间 \(\rho\geq0.97\)——经历了音视频适配训练之后,检索头基本原封不动。结合发现二,图景就完整了:模态适配不是重造检索机制,而是把 backbone 已有的检索头"延伸"到新模态的证据上。
这个发现对工程其实有含义:如果你想在不破坏检索能力的前提下给模型加模态,这套结果算是给了一个定心丸;反过来,如果你想改进检索,动 backbone 里那些头可能就够了。
发现四:掐掉这些头,音视频检索归零;不到 2% 的共享头还管着别的任务
相关性归相关性,因果性得靠消融。作者在留出样本上做 head ablation(把头的输出在注意力输出投影前置零),并设了一个严格的对照:消融同样数量、同样层分布的随机头,取三个种子。头集合 \(S\) 的真实效应定义为超出随机消融的额外跌幅:
结果相当暴力。以 Qwen2.5-Omni-7B 为例,音频证据下 EM 从 98.3% 直接掉到 0,而匹配的随机消融只让它降到 96.9%。四个被测模型在两种背景长度下,音频检索全部清零或接近清零,视觉检索也大部分被削掉。
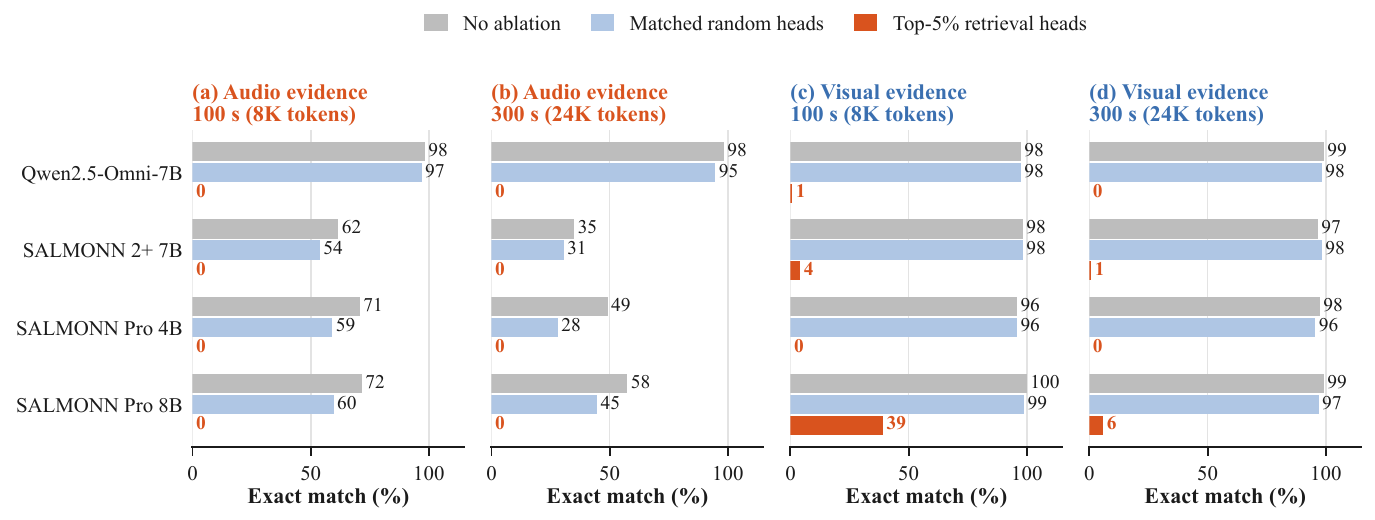
图5:留出 AV-NIAH 样本上的 EM。灰色是不消融,浅蓝是消融同等数量的层匹配随机头,橙/红色是消融 top 5% 检索头。四组分别是音频 100s、音频 300s、视觉 100s、视觉 300s。可以看到随机消融几乎无损,而检索头消融把柱子打到地板上。
这个效应对头集合怎么选也不敏感:top-20 个头已经能干掉大部分音频检索;只消融音频和视觉 top-20 的交集——大约十几个头,占全部头的不到 2%——也能造成远超随机消融的损伤,而且上下文越长损伤越大。
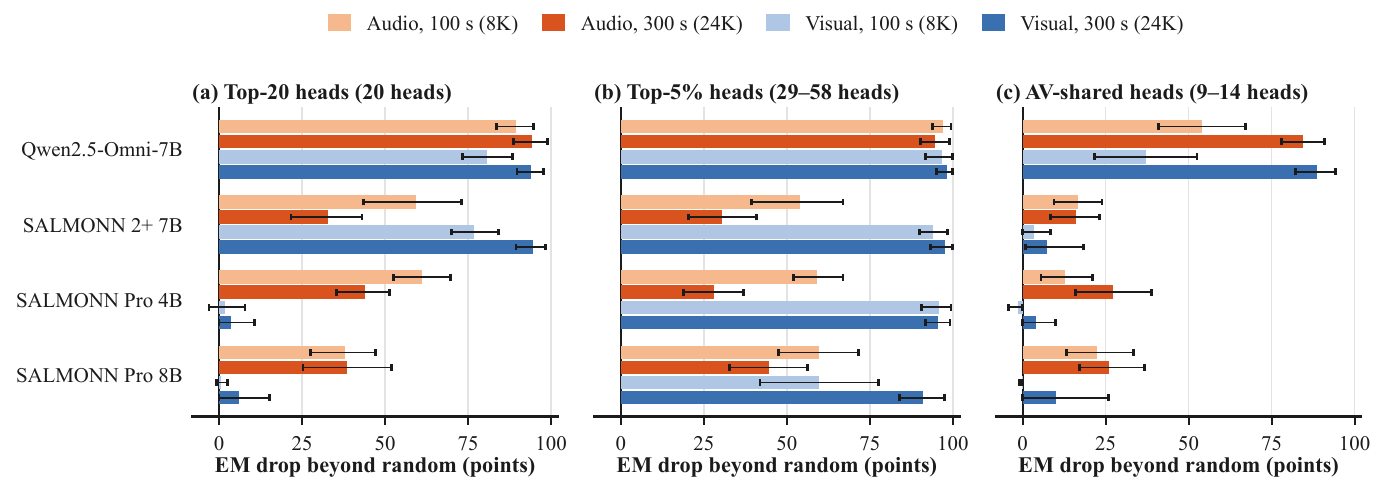
图6:三种头集合(a) 被测模态 top-20 (b) top-5% (c) AV 共享头)下超出随机消融的额外 EM 跌幅,误差棒为 95% 区间。注意 (c) 里 Qwen2.5-Omni-7B 仅靠十几个共享头就造成 50-90 个点的额外跌幅。
更值得注意的是下游迁移。作者把这十几个 AV 共享头掐掉,在八个覆盖文档问答、视觉感知、多学科推理、视觉数学的 benchmark 上测:所有任务都出现了超出随机消融的性能下降,视觉数学和空间感知掉得最狠(Qwen2.5-Omni-7B 上 MathVista 的 \(E\) 高达 22.3 个点,CV-Bench 16.3 个点),且 16 个模型-任务组合里有 15 个,共享头的破坏力超过了同样数量的图像检索头。
| 任务 | Qwen2.5-Omni-7B 基分 | AV共享头额外跌幅 (pp) | 图像检索头额外跌幅 (pp) | SALMONN Pro 4B 基分 | AV共享头额外跌幅 (pp) |
|---|---|---|---|---|---|
| MMLongBench-Doc | 24.1 | 5.8 | 5.3 | 39.6 | 10.0 |
| CV-Bench | 75.5 | 16.3 | 5.7 | 80.5 | 14.8 |
| MMStar | 67.0 | 12.2 | 2.8 | 63.0 | 5.3 |
| CountBenchQA | 83.5 | 9.6 | 3.4 | 87.4 | 2.2 |
| MMMU | 52.5 | 4.0 | 6.2 | 55.5 | 6.7 |
| MMMU-Pro | 39.5 | 8.2 | 4.0 | 39.0 | 3.0 |
| MathVista | 72.5 | 22.3 | 2.5 | 70.5 | 12.2 |
| MathVision | 29.5 | 8.2 | 3.0 | 49.5 | 18.8 |
表1:消融 AV 共享头(Qwen2.5-Omni-7B 中 14 个、SALMONN Pro 4B 中 10 个)对下游多模态任务的影响。加粗为 Holm 校正后显著。AV 共享头在每个模型 8 个任务中的 4 个上效应显著,而图像检索头最多 1 个。
十几个头管着文档理解、空间感知、视觉数学——这个头集合更像是模型里的"证据使用枢纽",而不是某个任务的专用电路。
反过来用:把检索头的注意力直接训练了
分析做到这一步,顺理成章的问题来了:既然这撮头的注意力分数天然就是"问题对证据的相关性打分",能不能把它当检索器用,再把它训得更好?
作者选了多模态文档检索这个天然有监督信号的场景。MMDocIR 给文档页面和版面区域(段落、表格、图)标注了相关性。方法分三步:
选头:在基模型上用四种多模态检测条件 pooling 出检索头,取分数最高的 \(k\) 个(默认 \(k=16\)),训练和推理期间固定不变。
打分与归一化:候选文档 \(d_j\) 的分数就是选中头上问题对候选区域视觉 token 的注意力之和:
原始注意力分数的量级又小又飘,直接拿来做 softmax 会很难训。作者在每个样本内做 min-max 式 rescale,但端点用 stop-gradient 钉住:\(z_j=\gamma\,(r_j-b)/\Delta\),其中 \(b=\operatorname{sg}(\min_j r_j)\),\(\Delta=\operatorname{sg}(\max_j r_j-\min_j r_j)\)。这个设计挺讲究的——把 logit 范围固定在 \([0,\gamma]\),同时梯度还能流过每个 \(r_j\)。
排序损失:每个训练样本取一个正例页面加一个同文档的难负例,最小化
损失只定义在选中的头上,但通过 LoRA 更新注意力投影的参数。推理时跟检测一样,再减去无信息问题的分数做校准。
实验结果
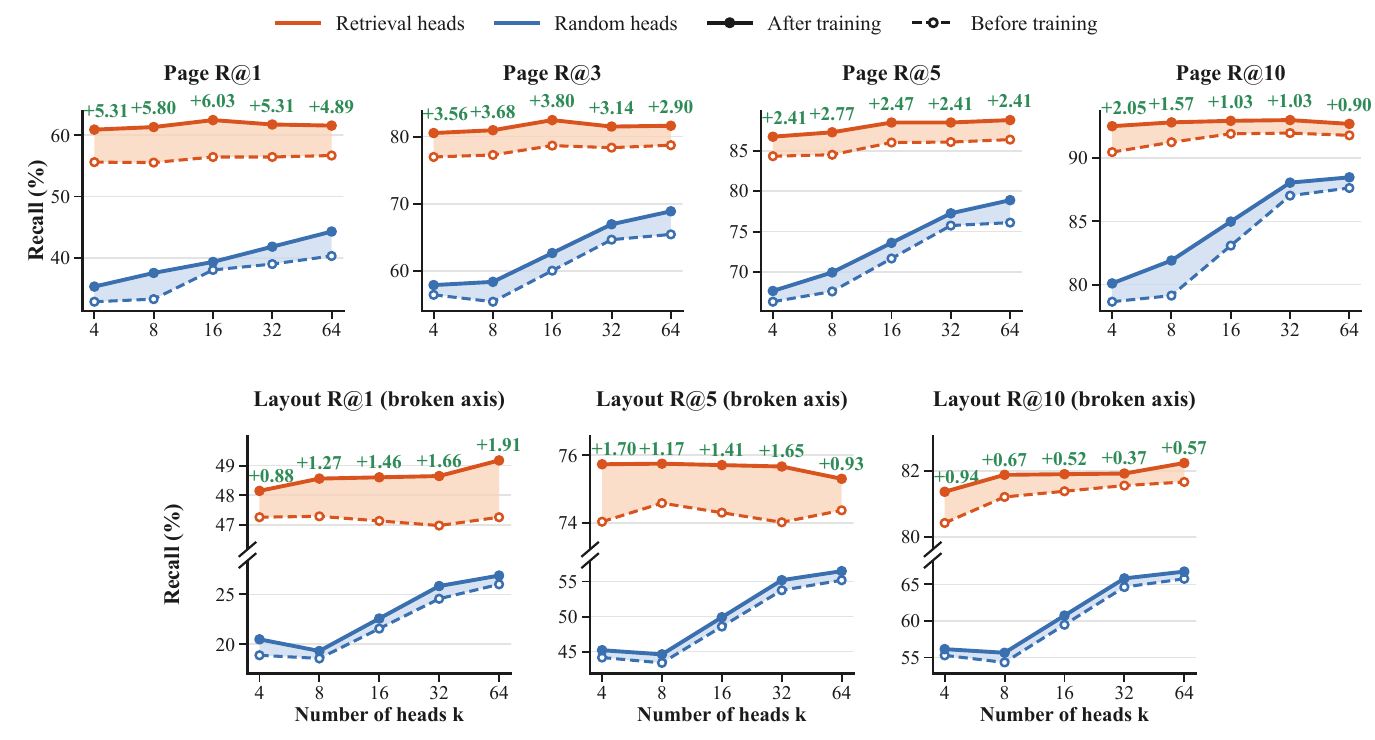
图7:Qwen3-VL-8B 上,\(k\) 个检索头(橙)或 \(k\) 个随机头(蓝)定义打分函数,虚线是训练前、实线是训练后,绿色数字是训练增益,\(k\) 从 4 扫到 64。上排 Page R@1/3/5/10,下排 Layout R@1/5/10(断轴)。检索头在每个 \(k\) 和每个 cutoff 上都碾压随机头,训练增益在 Page R@1 上最大。
| 方法 | Page Macro | Page Micro | Layout Macro | Layout Micro |
|---|---|---|---|---|
| DPR | 27.20 | 26.91 | 19.24 | 19.09 |
| ColBERT | 45.93 | 45.43 | 31.57 | 31.26 |
| DSE docmatix | 50.41 | 49.98 | 29.04 | 29.55 |
| ColPali | 55.27 | 54.58 | 33.28 | 33.06 |
| Col-Phi3 MMDocIR | 57.00 | 57.10 | 31.10 | 31.60 |
| 随机头(\(k\)=16) | 39.31 | 38.00 | 20.32 | 21.57 |
| 检索头(\(k\)=16) | 58.81 | 56.45 | 46.44 | 47.14 |
| 检索头 + 排序训练 | 63.86 | 62.48 | 47.78 | 48.60 |
表2:MMDocIR Recall@1。上半部分是已发表的检索基线(评测设置不同,仅供参照),下半部分是 Qwen3-VL-8B 在统一配置下的注意力打分。
几个点值得拆开说。
训练前,检索头打分就已经远超随机头(Page Micro R@1 56.45 vs 38.00),这反过来印证了前面的机制分析——这些头的注意力确实编码了相关性。训练之后 Page Micro R@1 再涨 6.03 个点到 62.48,而且十个文档领域里每一个都在涨。
更让我多看一眼的是 Layout 那一列:训练数据里没有任何版面级标注,只有页面级标签,但 Layout R@1 也跟着涨了 1.46 个点。页面级的训练信号迁移到了更细的粒度,这说明被优化的确实是"定位证据"这个通用能力,而不是过拟合到页面分类。
跨模型家族也验证了:Qwen2.5-VL-7B 页面 R@1 涨 5.69 个点,Gemma3-12B 涨 2.17 个点(layout 涨 2.16)。增益幅度有差异,但方向一致。
域外泛化方面,MMMU、MMMU-Pro、MathVista、MMLongBench-Doc 四个 benchmark 上训练前后变化都在 1 个点以内,有几项还略微涨了点。只动 16 个头的 LoRA,代价确实小。
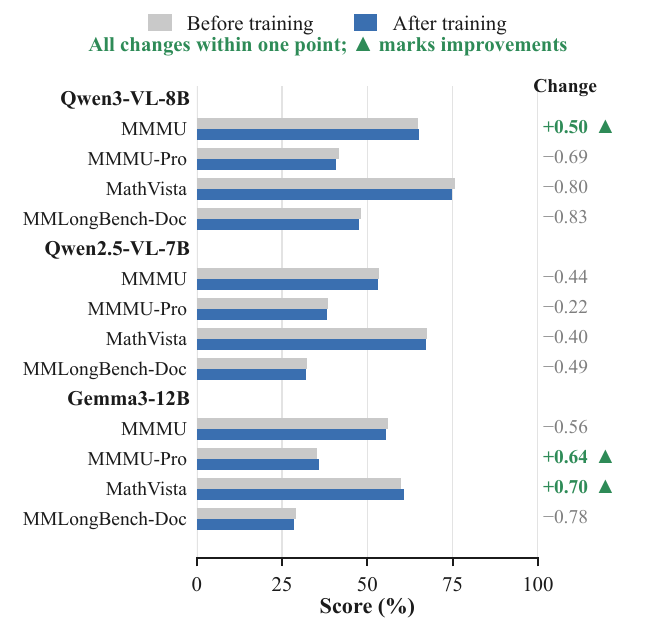
图8:三个模型在四个域外 benchmark 上训练前后的分数,所有变化都在一个点以内,绿色三角标记的是不降反升的组合。
我的判断
这篇论文最值钱的地方,是把"可解释性分析 → 因果验证 → 工程优化"这条链路走通了。多数机制可解释性工作止步于"我们发现了某某电路",这篇往前走了一步:发现的电路直接变成了可优化的目标,而且在三个模型家族上都拿到了正向结果。6.03 个点的 Page R@1 提升,在文档检索这个任务上是实打实的。
设计上我最喜欢的是 AV-NIAH 的配对构造。钉死证据内容、只动模态,这是做跨模态机制对比唯一干净的姿势,前面不少"跨模态比较"的工作其实都被内容混淆污染着。
但也有几处得泼点冷水。
MMDocIR 上超过已发表检索器这件事,作者自己都很谨慎。 表里 ColPali、Col-Phi3 那些数是不同评测设置下的公开结果,不是同配置对比。真正受控的对比只有"同模型训练前后",这个增益是可信的;但要说这套方法能替代专门训练的稠密检索器,现在还下不了结论——它免训练即用的特性更像是一个"白送的检索器",适合没有检索训练数据的场景。
AV-NIAH 的针太简单了。 一个六位数字,无论说出来还是显示出来,都是高度突出的异常信号。真实场景里的证据往往和背景内容纠缠在一起(比如一段对话里随口提到的日期),那种情况下头共享的程度还会不会是 69%-83%,我持保留态度。作者也承认了检索目标本身影响头招募——这其实是全文最重要的限定条件。
头选择依赖带标注的检测数据。 你得先有标注了证据位置的数据才能找出检索头。好在作者展示了头集合在任务间的迁移性(文档任务上选的头对别的任务也有用),但"新领域冷启动怎么选头"这个问题没有完全解决。
还有个我自己没完全想明白的点:排序训练的梯度通过 LoRA 流遍注意力投影,那被更新的其实不只是那 16 个头的参数——LoRA 的低秩更新会影响所有头的输入输出。严格来说,训练后分数提升究竟是因为"这 16 个头变强了"还是"整个注意力层被微调后这 16 个头的读数变了",论文的消融没有把这两者完全分开。图7 里随机头训练后也有提升,说明确实有一部分增益来自全局性的适配。不过检索头相对随机头的巨大差距在训练前后都保持着,功能头选择的重要性这个结论是稳的。
收尾
往回看,这条线其实挺清晰的:从 GPT 时代发现 induction heads,到长文本时代发现 retrieval heads,再到这篇确认它们跨模态存在、可继承、可优化——"功能注意力头"正在从可解释性研究的观察对象,变成模型工程的操作对象。如果你在做多模态 RAG 或者文档智能,这个"免训练检索头打分 + 轻量 LoRA 排序训练"的组合值得试试,成本极低,且不用担心把通用能力训崩。
下一个更本质的问题可能是:既然这些头是跨模态共享的"证据枢纽",那它们的存在形态能不能反过来指导架构设计——比如专门保留一类注意力头做证据搬运,把其他头解放出来做推理?这个问题,这篇论文还没回答,但它把工具递过来了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我