不动权重也能进化:TTME 用一块"外置记忆"把测试时训练踢下神坛
你有没有过这种体验:让 AI 帮你搜一个数学构造,它每试一次都花算力微调一遍权重,跑得又慢又贵,你看着 GPU 账单心里直滴血。前段时间 TTT-Discover 那篇工作挺火——在测试时边搜边用 RL 更新模型,让一个 8B 的开源模型在 Erdős 最小重叠这类数学发现任务上超过了 AlphaEvolve 这类前沿模型驱动的纯推理系统。结果很漂亮,但代价也漂亮:整个发现过程要在线更新权重,光一次任务的计算量就是几十 EFLOPs。
这篇新论文(arXiv:2610.32046)问了一个特别朴素的问题:既然经验已经摆在那里了,为什么非要把它烧进权重里?写到一块外部记忆里不行吗?
核心摘要:作者提出 TTME(Test-Time Memory Evolution,测试时记忆演化),一种即插即用的测试时自适应方法。模型权重全程冻结,只在每 2 个搜索步把评估过的经验蒸馏成两类外部记忆——操作层面的"指南记忆"和算法层面的"策略记忆"——用来条件化后续生成。在 TTT-Discover 和 ThetaEvolve 两个框架、Qwen3-8B / gpt-oss-120b / Distill-Qwen3-8B 三个模型、五个数学构造任务上,TTME 全部跑赢 TTT,同时 runtime 降低 47.7–58.4%,FLOPs 降低 82.8–84.6%。说实话看到这个结果我愣了一下:不是"接近 TTT",是全面反超,还顺手砍了八成多的算力。这篇论文最值钱的不是某个具体 trick,而是它动摇了"测试时学经验 = 更新权重"这个默认假设。
📖 论文信息
- 标题:Can Test-Time Memory Evolution Outperform Test-Time Training for Scientific Discovery?
- 作者:Yepeng Liu、Shengmai Chen、Xuandong Zhao、Chengzhi Liu、Dawn Song、Xin Eric Wang、Yuheng Bu(*共同一作)
- 机构:UC Santa Barbara、UC Berkeley
- 链接:https://arxiv.org/abs/2610.32046 | 代码:https://github.com/yepengliu/TTME
- 提交日期:2026 年 10 月 23 日
🎯 问题动机:TTT 的经验内化,是不是用错了容器?
先把背景捋清楚。科学发现类任务——比如找一个让 Erdős 最小重叠问题的上界更小的构造函数——一般被组织成一个迭代循环:LLM 生成候选程序 → 执行并验证打分 → 用反馈指导下一轮搜索。这个循环里最值钱的东西是经验:一次失败的尝试暴露了实现约束,一次成功的改动暗示了可迁移的思路。
问题是怎么"留住"这些经验。目前两条路线:
| 路线 | 代表工作 | 经验放在哪 | 代价 |
|---|---|---|---|
| 参数化(TTT) | TTT-Discover、ThetaEvolve | RL 更新进模型权重 | 每步都要反向传播,算力开销大 |
| 非参数化(记忆/prompt) | FunSearch、AlphaEvolve、Reflexion、ExpeL、GEPA | 档案、prompt 上下文 | 几乎为零,但经验组织粗糙 |
TTT 派最近的战绩确实硬:TTT-Discover(Yuksekgonul 等,Stanford/NVIDIA 等团队,arXiv:2601.16175)用 entropic RL 目标加 PUCT 复用机制,让开源模型在多个数学、kernel、算法任务上刷了新纪录。但它是把每次评估过的尝试当 RL 训练数据,在线更新 LoRA 参数。50 步搜索、每步 512 个 rollout 的预算下,光训练侧的算力就是纯推理侧的好几倍。
作者的反问很直接:现在的 LLM 本身已经有足够强的推理和代码能力去消化经验了,那"内化经验"这件事,是不是不一定非得走梯度下降这条路?
这个质疑我觉得打在了点上。权重更新是一种"编译"——把经验压进参数,优点是调用时零成本,缺点是编译过程贵,而且压进去的东西不可读、不可编辑、不可删。记忆则是一本摊开的笔记本,随时翻、随时改。对"单个任务内快速迭代"这种场景,笔记本说不定真的够用。
🧠 TTME 方法:两块记忆,分工明确
先上一张总览图,直观感受两条路线的差别。

论文 Figure 2:上方是权重自适应(TTT)——评估过的经验通过测试时 RL 更新模型参数 \(\theta_t \to \theta_{t+1}\),LLM 旁边那团火焰很形象;下方是记忆自适应(TTME)——经验蒸馏进外部记忆 \(\mathcal{M}_t \to \mathcal{M}_{t+1}\),模型权重保持冻结(雪花图标),记忆作为上下文进入 prompt。两者的底层发现框架(档案、父代选择、验证器)完全一样,只换自适应机制。
形式上,目标是在搜索预算内找到最高分的有效候选:
两条路线的区别就一行公式:
- TTT:\(\theta_{t+1}\leftarrow U_{\mathrm{RL}}(\theta_{t},\mathcal{D}_{t})\),经验进权重
- TTME:\(\mathcal{M}_{t+1}\leftarrow U_{\mathrm{mem}}(\mathcal{M}_{t},\mathcal{D}_{t}),\quad \theta_{t}=\theta_{0}\),经验进记忆,权重钉死
记忆 \(\mathcal{M}_t=(\mathcal{L}_t,\mathcal{S}_t)\) 拆成两块,各管一件事。
Guideline Memory:操作层面的"避坑指南"
一句话讲清:把最近的执行和评估反馈蒸馏成"什么时候会踩什么坑、该怎么办"的紧凑条目。
每条指南包含三个要素——适用条件(trigger)、失败或改进的机制解释、具体行动建议。每 \(K=2\) 个搜索步更新一次:
Distill 用基座模型自己从结果摘要 \(r_t\)(有效结果、分数、失败情况)里提出新指南;Maintain 负责账本管理:用词级 Jaccard 相似度 ≥ 0.5 判重,匹配上就给该条目复现计数加一并刷新"最后重申步",否则新增;超过 20 步没被重申的条目删除,总量上限 24 条(按复现计数排序保留)。
这个设计挺克制的。它没有无限累积经验,而是有明确的遗忘机制——不常被验证的教训会被自然淘汰,防止记忆库变成噪声垃圾场。每条指南进 prompt 时还有 240 字符的展示预算,成本控制做得很细。
Strategy Memory:算法层面的"招式库"
一句话讲清:只从"子代有效且分数超过父代"的成功改动 \(\mathcal{D}_t^+\) 里提取可复用的算法思想,并把同一思想的变体归成一个"策略族"。
Extract 分析父子程序、代码 diff 和评估结果,逐案例提取经验笔记;Consolidate 把共享同一底层思想的笔记归入同一 strategy family,为每个族维护一个持久条目(共享思想、应用条件、实现变体、来源引用)。
注意它和 Guideline Memory 的分工:指南记的是"操作纪律"(怎么不写崩),策略记的是"算法招式"(什么思路真的涨分)。一个管下限,一个管上限。这个二分我觉得是全文最精巧的设计。
策略引导的候选生成
有了招式库,怎么用?每个搜索步里,selector(还是基座模型自己)按父代顺序依次挑最多 \(N\) 个互不相同的策略,偏好对当前父代有改进潜力且还没被别人用过的:
然后 adaptor 读取策略完整条目和父代完整代码,生成针对该父代的修改指令;没合适策略就自由发挥提新想法:
候选预算对半开:\(\alpha B\) 走 Direct Generation(只看指南记忆),\((1-\alpha)B/N\) 走策略引导生成,实验里 \(\alpha=1/2\)。一半自由探索、一半按图索骥,这个配比避免了记忆把搜索锁死在已知套路上。
整个流程里所有角色——生成、蒸馏、提取、选择、改写——都由同一个冻结的基座模型扮演,没有任何额外训练。即插即用不是宣传词,是真的把 TTT 模块拔掉、把 TTME 模块插上,框架其他部分一行不动。
🧪 实验:五个任务,全胜
设置
- 框架:TTT-Discover(PUCT 父代选择,50 步,每步 8 父代 × 64 候选);ThetaEvolve(MAP-Elites + islands,65 步,32 父代 × 16 候选)
- 模型:Qwen3-8B、gpt-oss-120b(TTT-Discover);Distill-Qwen3-8B(ThetaEvolve)
- 任务:Erdős 最小重叠(↓)、自相关不等式 AC1(↓)、AC2(↑)、AC3(↓)、29×29 Hadamard 最大行列式(↑)
- 三组对照:w/ TTT(结果取自原论文)、w/o TTT(冻结权重裸跑)、w/ TTME(冻结权重 + 双记忆)
主结果
TTT-Discover 框架(50 步,w/ TTT 数据来自 Yuksekgonul et al.):
| 方法 | 模型 | Erdős ↓ | AC1 ↓ | AC2 ↑ |
|---|---|---|---|---|
| w/ TTT | Qwen3-8B | 0.380932 | 1.50525 | 0.9472 |
| w/o TTT | Qwen3-8B | 0.380957 | 1.505242 | 0.944771 |
| w/ TTME | Qwen3-8B | 0.380927 | 1.504329 | 0.949248 |
| w/ TTT | gpt-oss-120b | 0.380876 | 1.50287 | 0.9591 |
| w/o TTT | gpt-oss-120b | 0.380945 | 1.505966 | 0.953682 |
| w/ TTME | gpt-oss-120b | 0.380862 | 1.502745 | 0.960784 |
ThetaEvolve 框架(65 步,w/ TTT 数据来自 Wang et al.):
| 方法 | 模型 | AC2 ↑ | AC3 ↓ | Hadamard ↑ |
|---|---|---|---|---|
| w/ TTT | Distill-Qwen3-8B | 0.9469 | 1.4930 | 0.5764 |
| w/o TTT | Distill-Qwen3-8B | 0.947375 | 1.519277 | 0.571085 |
| w/ TTME | Distill-Qwen3-8B | 0.948148 | 1.464224 | 0.579938 |
坦率的讲,单看 Erdős 这种任务,小数点后四五位的差距(0.380927 vs 0.380932)确实不大,这类构造任务本来就是毫米级竞争。但 AC3 上 1.464224 对 1.4930 就不是擦边球了,Hadamard 上 0.579938 对 0.5764 也是实打实的优势。更关键的是一致性:九个"框架 × 模型 × 任务"组合,TTME 无一败绩。单次结果可以碰运气,九连胜很难解释成噪声。
下面这张分数-成本散点图是论文的题图,也是全文最有说服力的一帧:
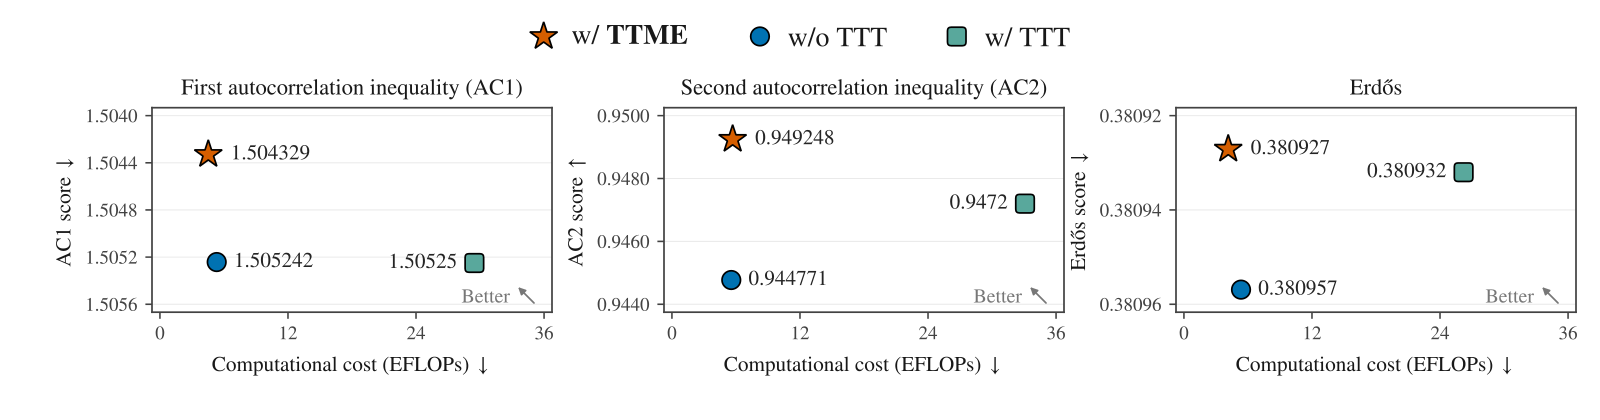
论文 Figure 1:TTT-Discover + Qwen3-8B 下三个任务的"最优分数 vs 计算成本"散点。橙色五角星是 TTME,蓝色圆点是 w/o TTT,绿色方块是 w/ TTT。三个子图里 TTME 全部占据"成本最低、分数最好"的左上角——w/ TTT 花了 5-7 倍的算力,分数还更差。
搜索过程:25 步内就锁定胜局
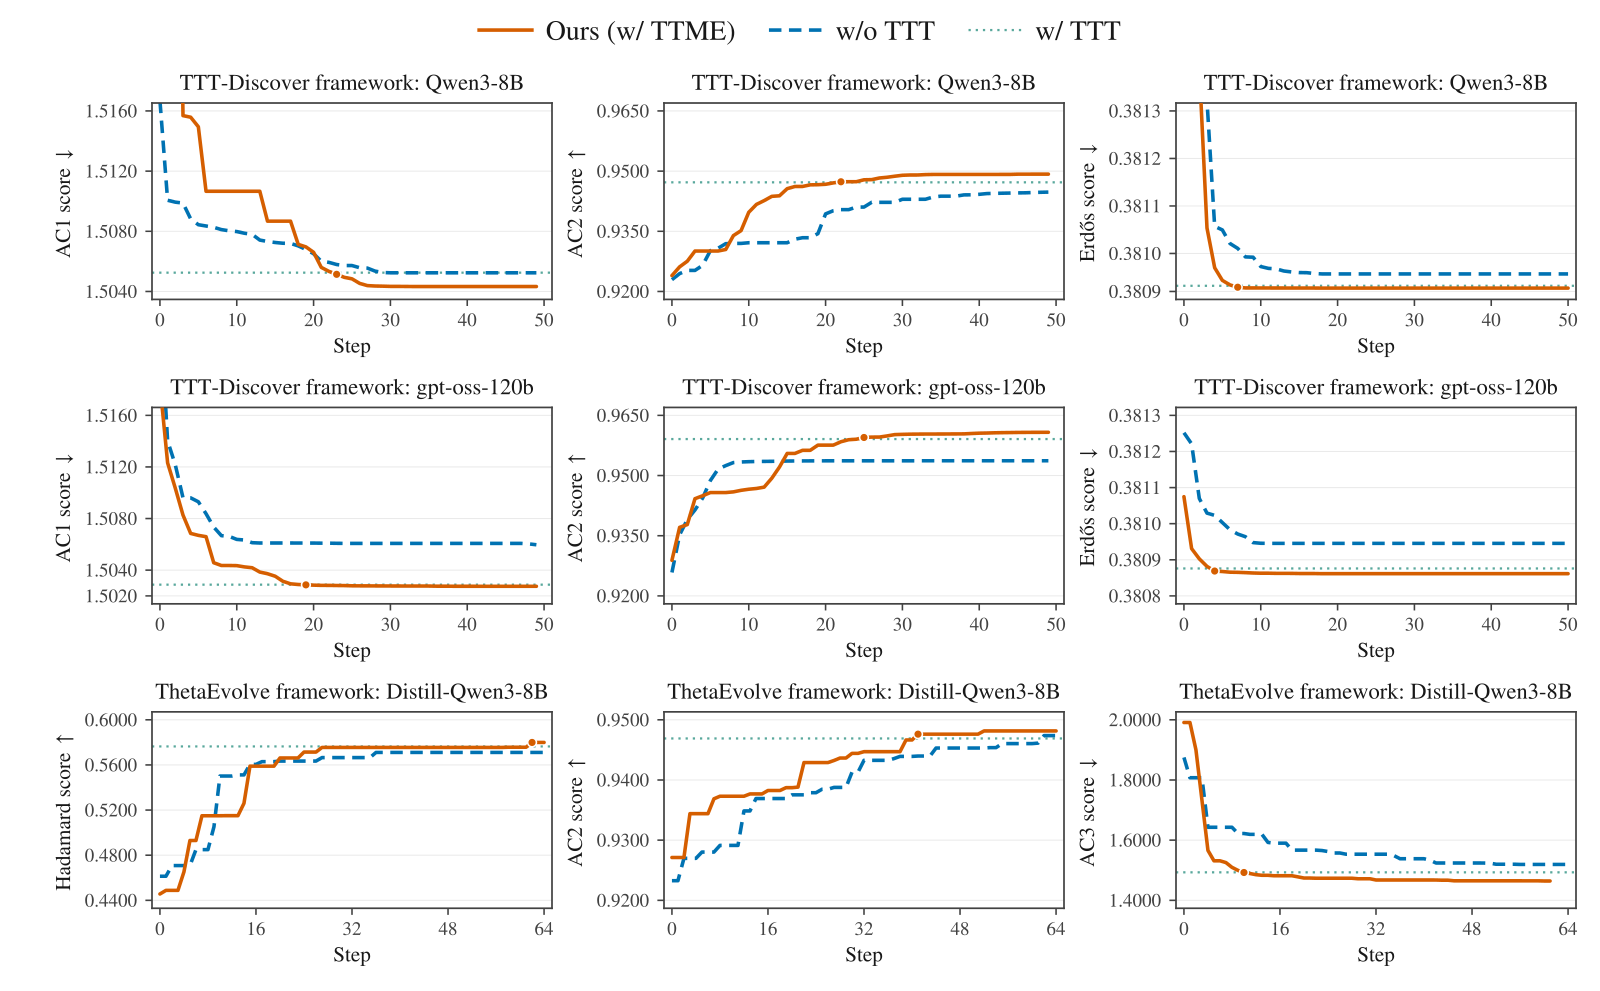
论文 Figure 3:两个框架下九个设置的搜索过程曲线。橙色实线是 TTME,蓝色虚线是 w/o TTT,灰色点线是 TTT 的最终分数,橙色圆点标记 TTME 首次超过 TTT 最终分数的搜索步。TTT-Discover 下 TTME 在 25 步以内就全部越过 TTT 的终点线——等于预算砍半还赢。
这个图信息量很大。注意看 Erdős 任务(右上、右中):TTME 的曲线在第 10 步左右就砸到了 0.3809 附近然后走平,而 w/o TTT 缓慢爬升却始终够不着。说明记忆带来的不是"慢慢积累的小优势",而是早期就找到了正确的攻击方向。
成本对比:省下的都是真金白银
| 任务 | Runtime TTT (h) | Runtime TTME (h) | 降低 | FLOPs TTT (EFLOPs) | FLOPs TTME (EFLOPs) | 降低 |
|---|---|---|---|---|---|---|
| AC1 | 11.76 | 5.36 | 54.5% | 29.47 | 4.53 | 84.6% |
| AC2 | 12.73 | 6.66 | 47.7% | 33.09 | 5.69 | 82.8% |
| Erdős | 11.67 | 4.85 | 58.4% | 26.21 | 4.15 | 84.2% |
runtime 不含评估、但包含全部记忆相关的 LLM 调用——也就是说 TTME 那些蒸馏、提取、选择的开销都已经算在账上了,还是省了一半时间、八成多 FLOPs。要知道 TTT-Discover 只更新 rank-32 的 LoRA,并不是全参数训练,成本差距还这么悬殊。对"想 scaling 到更大模型"这件事,这个差距是决定性的:120B 模型在线 RL 的工程和算力门槛,跟 120B 模型纯推理,完全是两个世界。
🔬 消融与行为分析:两个反直觉的发现
TTME + TTT 叠加,反而更差
| TTT | TTME | AC2 ↑ | Erdős ↓ |
|---|---|---|---|
| ✗ | ✗ | 0.944771 | 0.380957 |
| ✓ | ✗ | 0.9472 | 0.380932 |
| ✗ | ✓ | 0.949248 | 0.380927 |
| ✓ | ✓ | 0.944141 | 0.380944 |
我本来的预期是"记忆 + 权重双通道,怎么也该有点互补"。结果组合版在两个任务上全面垫底,AC2 甚至跌回 0.944141,比啥都不加还差。作者的解读方向是二者不互补;我个人猜测更可能是 RL 更新把模型行为往"平均奖励最大化"方向拉,和记忆引导的定向搜索产生了目标冲突。不管哪种解释,这个实验传递的信号很明确:记忆不是 TTT 的补丁,它是替代品。
双记忆缺一不可,但权重不同
| 配置 | AC1 ↓ | AC2 ↑ | Erdős ↓ |
|---|---|---|---|
| Full TTME | 1.502745 | 0.960784 | 0.380862 |
| w/o Guideline Memory | 1.505644 | 0.958506 | 0.380865 |
| w/o Strategy Memory | 1.505981 | 0.956493 | 0.380864 |
| w/o TTME | 1.505966 | 0.953682 | 0.380946 |
去掉 Strategy Memory 的伤害明显大于去掉 Guideline Memory(AC2 上 0.956493 vs 0.958506)。这印证了前面的分工判断:可复用的算法招式才是涨分主引擎,避坑指南更多是辅助。不过注意 Erdős 上 w/o TTME(0.380946)反而比两个单记忆消融都差,说明两块记忆之间还是有协同的。
行为层面:TTME 更会"缝合"思想
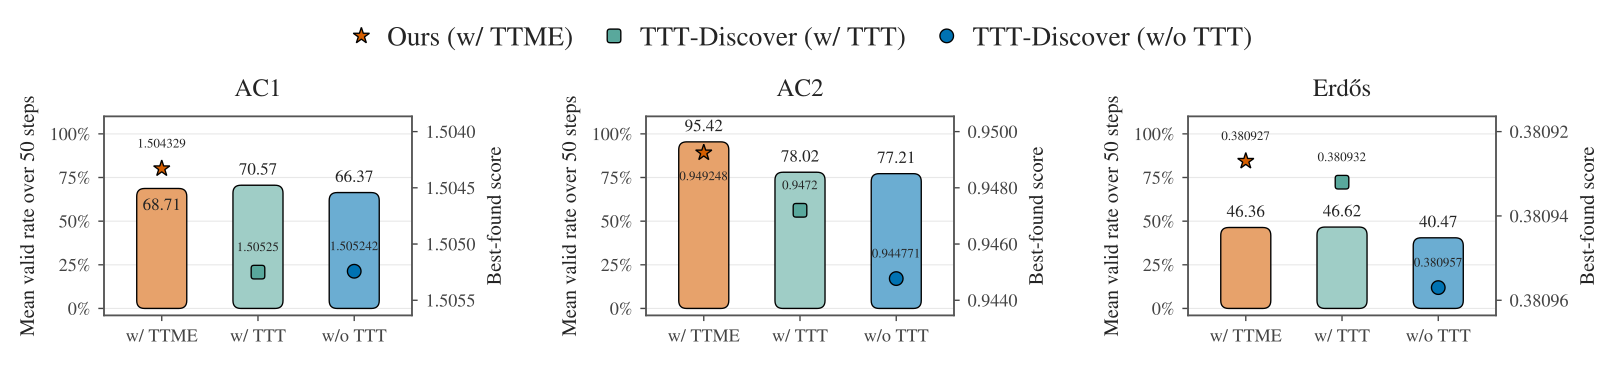
论文 Figure 4:柱状是 50 步平均程序有效率(左轴),标记是最终最优分数(右轴)。AC1 和 Erdős 上 TTME 与 TTT 的有效率几乎打平(68.71 vs 70.57、46.36 vs 46.62),但最终分数 TTME 更好——赢的不是"少写崩",而是"想法质量"。AC2 上 TTME 有效率 95.42% 倒是明显领先。
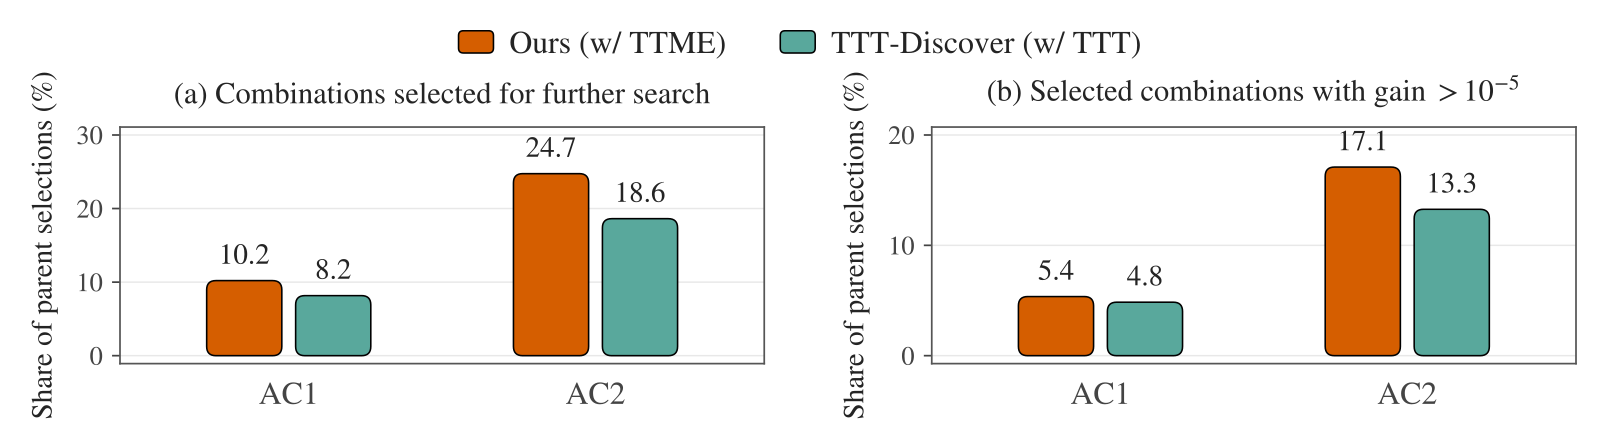
论文 Figure 5:"组合"指候选保留父代思想、同时吸收其祖先链之外已探索的思想。左图是所有被选中继续搜索的组合占比:AC1 上 10.2% vs TTT 的 8.2%,AC2 上 24.7% vs 18.6%。右图是要求改进超过 \(10^{-5}\) 的严格口径:AC1 上 5.4% vs 4.8%,AC2 上 17.1% vs 13.3%。
这组分析解释了 TTME 赢在哪。不是生成的程序更"能跑"(有效率相近),而是它更擅长把散落在搜索历史不同角落的思想杂交到一个新候选里。这正好和 Strategy Memory 的机制自洽——策略族本来就是跨案例抽象出来的可迁移招式,天然鼓励"这个思路能不能用到那个父代上"的组合式搜索。相比之下,RL 把经验压进权重后,思想之间的边界就模糊了,反而不容易做这种显式的嫁接。
发现出来的构造长什么样

论文 Figure 6(a):gpt-oss-120b + TTME 找到的 32000-bin AC1 构造,目标值 1.502745082。左图是归一化阶梯函数 \(\hat{f}(x)\)(插图为 0–0.06 区间的局部放大),右图是自卷积 \(\hat{c}(t)\)——峰值被死死压在 1 以下,正是 AC1 不等式要证的约束形态。

论文 Figure 6(b):gpt-oss-120b + TTME 找到的 65536-bin AC2 构造,目标值 0.960784。这些不是示意图,是实打实被验证器确认的新构造——数学意义上的"发现"。
🤔 我的判断
这篇论文我喜欢的地方:
实验设计干净。 同框架、同预算、同档案和验证器,只换自适应机制——这是对比实验该有的样子。很多"方法 A vs 方法 B"的论文输在比较对象根本不是一回事,这篇没有这个问题。
负结果诚实且有价值。 TTME+TTT 组合变差的消融完全可以藏起来不放,但放了,而且这恰恰强化了"记忆是替代品而非补充"的论点。
但也有几个地方要泼冷水:
w/ TTT 的分数是抄原论文的,不是自己重跑的。 这意味着随机种子、评估环境可能存在不对齐,严格说这不是完全配对的重跑对比。alphaXiv 的解读也专门点了这一条。考虑到 TTME 是九连胜且成本差距巨大,结论方向大概率稳,但严谨性上留个尾巴。
九个设置全是数学构造任务。 作者的措辞很小心,结论限定在 "in the evaluated discovery settings"。这些任务有个共同特点:验证快、反馈信号干净(连续分数 + 二值有效性)。换成 kernel 优化、生物实验设计这类评估昂贵或反馈含噪的场景,记忆的蒸馏质量和遗忘机制还hold不hold得住,是未知数。
记忆操作全是同一个基座模型在做。 8B 模型既要写代码又要当裁判、当编辑、当图书管理员。小规模模型上自蒸馏的质量会不会成为瓶颈,论文没有单独探查。
把视野放宽一点:同期还有一篇 Guidance-TTT(arXiv:2610.06269)走了条折中路——不更新大模型,只训练一个小的"指导模型"来出修改策略,执行模型冻结。加上 TTME,可以看到一个清晰的行业趋势:测试时自适应的主战场,正在从"更新生成器权重"转向"在生成器之外做轻量学习"。谁的经验容器更便宜、更可读、更好迁移,谁就能接住 scaling 到更大基座模型的红利。如果你在做 agentic 搜索或科学发现系统,这套双记忆设计——操作纪律 + 算法招式、带遗忘、带容量上限——是值得直接抄作业的部分。代码也开源了。
回到标题那个问题:Can TTME outperform TTT?在这五个任务上,答案是能,而且赢得不难看。但更准确的表述也许是:在这些验证便宜、反馈干净的任务上,把经验写进记忆,比烧进权重划算得多。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我