把信用分配对齐到「轮次」:MPO 如何用两个尺度治好长程 Agent 的 RL 训练
训练长程 Agent 的人大概都有过这种体验:一条轨迹跑完,几十个 turn、上万个 token,最后只拿到一个 0/1 的终局奖励。然后你要把这个奖励「分账」——到底是哪一步搜索查询写得好,哪一次工具调用挖错了方向?
GRPO 这类组相对方法干脆整段序列共享一个 advantage,所有 token 一视同仁;PPO 这类带 critic 的方法则把每个 token 都当作独立动作来估值。一个太粗,一个太细。这篇来自 arXiv 2610.35013 的论文给出的观察很直白:critic 的价值变化主要发生在 turn 边界上,turn 内部反而相对平稳。既然价值结构天然长在 turn 尺度上,那信用分配和策略更新为什么不对齐到 turn?
核心摘要
这篇论文提出 MPO(Multiscale Policy Optimization,多尺度策略优化),核心由两部分组成:多尺度优势估计 MAE 先在 turn 间做信用传播、再在 turn 内做均值保持的 token 级分配;策略更新则用完整 turn 的重要性比率搭配逐 token 的梯度。在 Qwen3-4B-Thinking 和 Qwen3-30B-A3B 两个模型、搜索(BrowseComp-Plus / GAIA / HLE)、Claw-Eval、Automation Bench 三类任务上,MPO 拿下了全部 9 项指标的最高分,4B 模型在 BrowseComp-Plus 上 pass@1 比最强基线高 4.33 分。我的判断:这不是颠覆性的新算法,而是把「turn 是智能体真正的决策单元」这个直觉做进了优势估计和重要性采样两个环节,理论上有界、工程上好落地,是做 Agentic RL 的人值得一读的工作。
论文信息
- 标题:Multiscale Policy Optimization for Long-Horizon LLM Agents
- 作者:Tao Ren, Hui Yang, Jia Deng, Tingyang Chen, Qiyao Wang, Shuo Tang, Ziyang Zeng, Yuhua Jiang, Guanghao Li, Huatong Song, Yining Li, Yifan Luo, Kunbao Ding, Feng Chang, Chuan Hao, Ran Tao, Bryan Dai, Jiafeng Liang, Jinyang Jiang(源码署名标识含北京大学、清华大学与 iQuest Research)
- 链接:https://arxiv.org/abs/2610.35013 (2026 年 10 月 26 日提交)
🎯 问题:信用分配的两个尺度错配
长程 LLM Agent 的轨迹长这样:\(\tau=(o_0,a_0,o_1,a_1,\ldots,o_T,a_T)\),\(a_t\) 是第 \(t\) 个 assistant turn(一次搜索、一次工具调用或最终回答),\(o_{t+1}\) 是环境返回。奖励只在轨迹末尾给一次:\(R(\tau)\)。
问题在于生成是逐 token 的,\(\pi_\theta(a_t\mid h_t)=\prod_{i=1}^{L_t}\pi_\theta(a_{t,i}\mid h_{t,i})\),而决策的语义单元是整个 turn。现有方法恰好卡在这个错配的两端:
- 无 critic 的组相对方法(GRPO、DAPO、GSPO):一条 rollout 一个共享 advantage,turn 内、turn 间的贡献差异全部被抹平;
- token 级 critic 方法(PPO、VC-PPO、VAPO、SAO):把每个 token 当动作,粒度够细,但没有显式区分「turn 内生成」和「turn 级环境交互」这两种本质不同的过程。
那到底该按哪个尺度分账?作者没有靠嘴炮,而是直接量了一遍。
📊 关键观察:价值函数自己就「长在」turn 尺度上
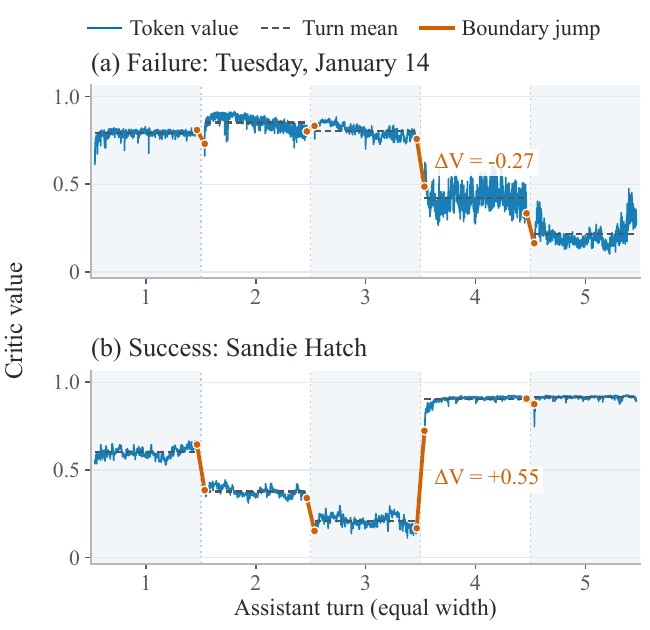
图2:一条失败轨迹(上,任务 "Tuesday, January 14")和一条成功轨迹(下,任务 "Sandie Hatch")中 critic 的逐 token 估值。蓝色是 token 级价值,黑色虚线是 turn 均值,橙色标记边界跳变。可以清楚看到:turn 内部曲线相对平稳,大幅跳变几乎都发生在 turn 边界——失败轨迹在某次交互后 \(\Delta V=-0.27\),成功轨迹则在关键 turn 后 \(\Delta V=+0.55\)。
这张图挺有说服力的。作者还给了统计证据:在一次 search-agent 训练的 8 个 checkpoint、2048 条轨迹、16323 个 turn 上,turn 均值之间的差异占 token 加权轨迹内价值方差的中位数 89.5%;93.8% 的轨迹中,turn 间方差大于 turn 内方差。
说实话看到这个数字我第一反应是去找他们怎么定义「轨迹内价值方差」的分解方式,不过结论方向上是符合直觉的:一次环境交互(搜索结果回来了、工具执行完了)才真正改变局势,turn 内部多生成几个 token 很少扭转乾坤。
这个观察直接决定了 MPO 的设计:跨 turn 传播长程信用,turn 内只保留局部差异。
🏗️ 方法:MPO 的两个组件
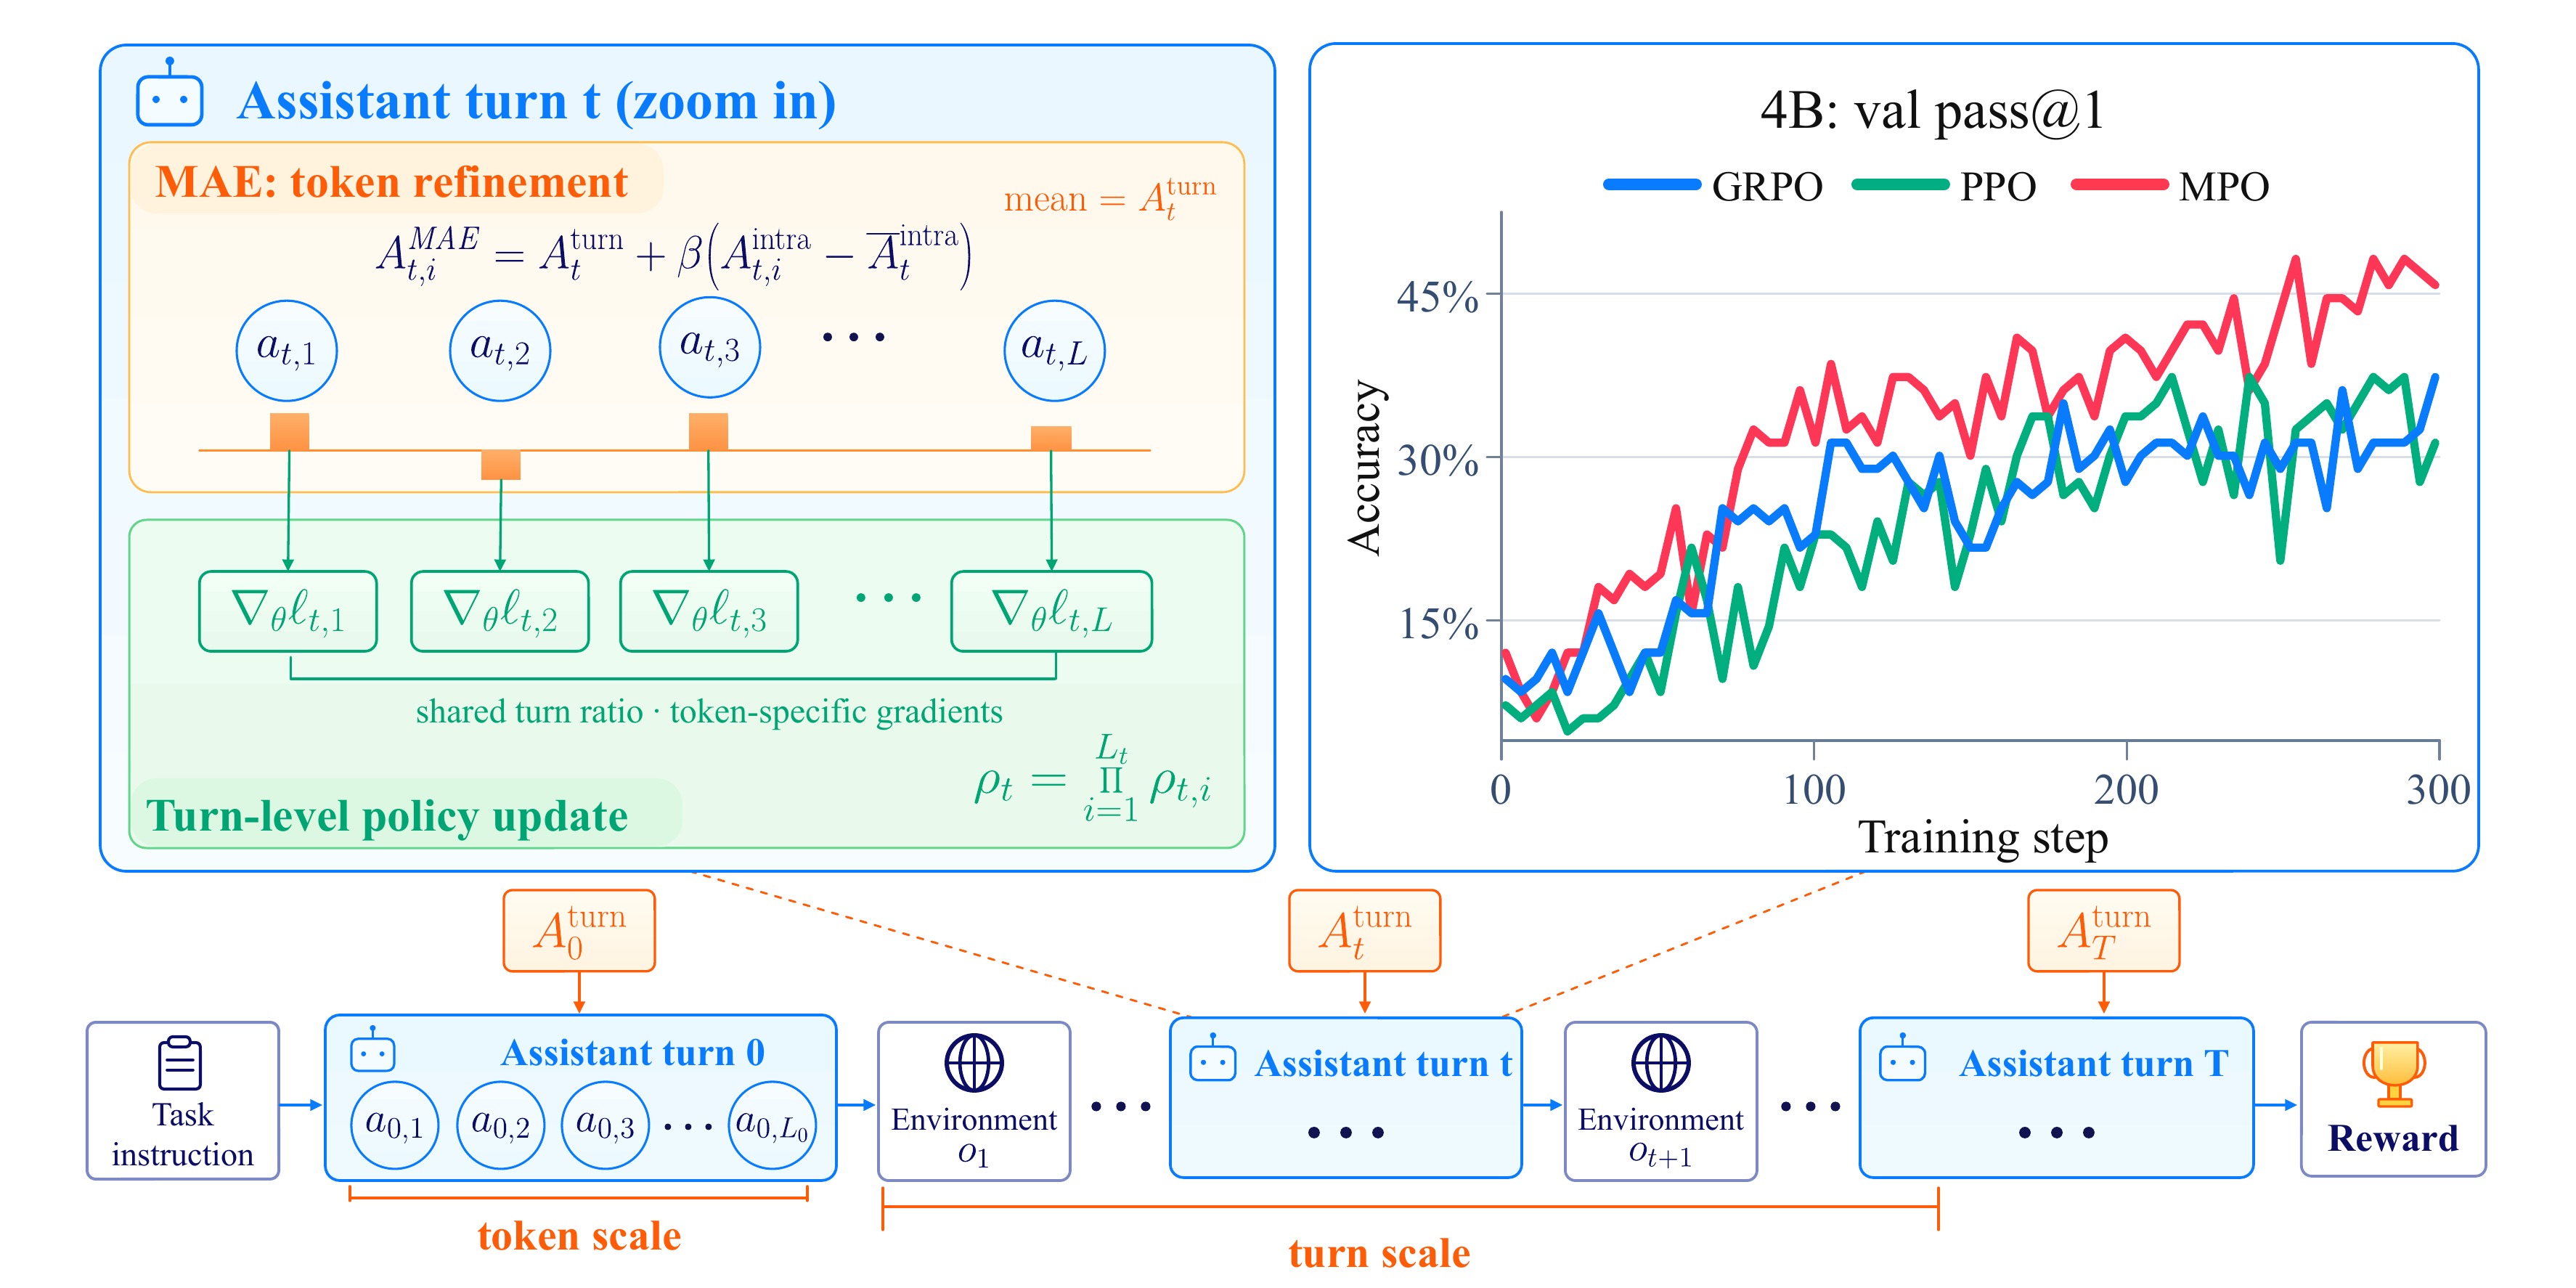
图1:MPO 总览。底部是轨迹的两个尺度——token 尺度与 turn 尺度;左上放大展示单个 assistant turn 内的 MAE 细化公式与「共享 turn 比率 × 逐 token 梯度」的更新方式;右上是 4B 模型训练 300 步内的验证 pass@1,MPO(红)全程压住 GRPO(蓝)和 PPO(绿)。
MAE:先按 turn 传,再按 token 分
多尺度优势估计(Multiscale Advantage Estimation)分两阶段,两个阶段复用同一个 critic \(V_{t,i}=V(h_{t,i})\),并在 turn 边界处衔接:\(V_{t,L_t+1}:=V_{t+1,1}\)。
阶段一:turn 级信用传播。 把一个 turn 内的 TD 残差全部加起来——注意这个求和会让 turn 内部所有价值预测两两抵消:
然后在宏观时间轴上做 GAE:\(A_t^{\mathrm{turn}}=\sum_{\ell=0}^{T-t}\lambda^{\ell}\delta_{t+\ell}^{\mathrm{turn}}\)。
这个设计有个很漂亮的性质:信用每次交互只衰减一次,而不是每个 token 衰减一次。传统的 token 级 GAE 在一条 500 token 的轨迹上,开头的动作拿到的信用被 \(\lambda^{500}\) 压得渣都不剩;MPO 里衰减次数等于 turn 数,通常只有十几次。而且结果与 turn 长度、critic 内部预测都无关——都被抵消掉了。
阶段二:turn 内信用分配。 只在当前 turn 内部构造局部轨迹:
现在手里有两样东西:turn 级优势 \(A_t^{\mathrm{turn}}\)(管均值)和 token 级局部差异 \(A_{t,i}^{\mathrm{intra}}\)(管相对高低)。怎么合?作者把它形式化为一个带约束的最小二乘投影——让 token 优势尽量贴近局部轨迹,同时约束 turn 内均值必须等于 turn 优势。解出来非常干净:
就是「turn 均值 + 去均值后的局部差异 × 强度系数 \(\beta\)」。\(\beta=0\) 时退化成整 turn 广播。这个式子简单到可以一行代码实现,但均值保持这个约束是关键——直接相加会让 turn 均值偏移 \(\beta\overline{A}_t^{\mathrm{intra}}\),跨 turn 的信用传播就白做了。
Turn 级重要性采样:一个 stop-gradient 的巧思
策略更新这边,理论分析(论文 Theorem 1/2)给出的结论是:token 级代理目标相对 turn 级精确目标会多出一项惩罚,量级是 \(2(T+1)A_{\max}^{\mathrm{tok}}L_{\max}(L_{\max}-1)\alpha_T^2\)——turn 越长、token 数越多,token 代理因为「在旧策略前缀上评估信用」引入的分布偏移越大。所以应该用完整 turn 的重要性比率 \(\rho_t(\theta)=\prod_{i=1}^{L_t}\rho_{t,i}(\theta)\)。
但直接把 \(\rho_t\) 乘到每个 token 的 advantage 上有个坑:MAE 里那部分居中的局部修正,在未裁剪的求和里会相互抵消掉——梯度一合计,正负抵消,细粒度信用又被抹平了。
作者的解法是个 stop-gradient 构造:
前向传播时每个 token 都拿到完整 turn 权重 \(\rho_t\);反向传播时梯度只流过自己的那个比率,\(\nabla_\theta\widetilde{\rho}_{t,i}=\rho_t\nabla_\theta\log\pi_\theta(a_{t,i}\mid h_{t,i})\)。这个构造我是真的觉得巧——不引入任何新模块,纯靠梯度路径设计就同时拿到了 turn 级权重和 token 级梯度。最终目标函数就是 PPO 风格的裁剪代理:
Critic 训练沿用 VAPO 的解耦 GAE,设 \(\lambda_{\mathrm{critic}}=1\) 直接回归终端回报。
🧪 实验:9 项指标全部第一
实验用 Qwen3-4B-Thinking 和 Qwen3-30B-A3B-Instruct 两个模型,三类任务:搜索(BrowseComp-Plus、GAIA、HLE)、Claw-Eval、Automation Bench。基线包括 GRPO、GSPO、PPO、VAPO、SAO,外加一个关键消融 MPO w/ token IS(保留 MAE,但把 turn 级比率换成 token 级比率)。
Qwen3-4B-Thinking(%):
| 方法 | BrowseComp-Plus p@1/p@3 | GAIA p@1/p@3 | HLE p@1/p@3 | Claw-Eval p@3/pass3 | Auto. Bench p@1 |
|---|---|---|---|---|---|
| Base | 8.84 / 18.07 | 24.92 / 33.98 | 5.53 / 9.60 | 25.22 / 8.09 | 0.00 |
| GRPO | 39.34 / 52.12 | 33.92 / 44.63 | 8.51 / 14.43 | 64.45 / 48.79 | 4.33 |
| GSPO | 38.56 / 52.11 | 34.34 / 45.26 | 9.26 / 13.71 | 63.83 / 49.35 | 5.22 |
| PPO | 40.85 / 54.30 | 31.71 / 45.03 | 7.22 / 12.82 | 63.25 / 50.78 | 11.67 |
| VAPO | 43.23 / 57.33 | 33.91 / 46.15 | 7.54 / 13.27 | 64.35 / 49.22 | 11.50 |
| SAO | 43.75 / 56.88 | 35.62 / 47.56 | 8.19 / 14.23 | 64.52 / 49.11 | 12.06 |
| MPO w/ token IS | 45.72 / 57.47 | 36.35 / 50.27 | 8.89 / 15.17 | 65.13 / 50.22 | 12.45 |
| MPO | 48.08 / 61.83 | 39.47 / 52.67 | 9.92 / 16.78 | 66.91 / 51.73 | 13.33 |
Qwen3-30B-A3B-Instruct(%):
| 方法 | BrowseComp-Plus p@1/p@3 | GAIA p@1/p@3 | HLE p@1/p@3 | Claw-Eval p@3/pass3 | Auto. Bench p@1 |
|---|---|---|---|---|---|
| Base | 21.69 / 27.71 | 25.24 / 37.86 | 7.47 / 12.60 | 32.19 / 12.64 | 0.17 |
| GRPO | 41.83 / 48.18 | 31.03 / 40.51 | 8.33 / 12.68 | 68.23 / 52.55 | 5.00 |
| GSPO | 40.22 / 47.31 | 35.25 / 46.25 | 8.61 / 13.34 | 68.62 / 51.34 | 6.23 |
| PPO | 45.20 / 51.63 | 35.70 / 45.28 | 8.31 / 13.33 | 70.14 / 55.33 | 14.17 |
| VAPO | 46.73 / 57.33 | 38.33 / 49.22 | 9.25 / 14.64 | 71.31 / 56.72 | 13.77 |
| SAO | 45.36 / 57.88 | 39.62 / 50.34 | 9.91 / 14.37 | 72.72 / 57.23 | 14.20 |
| MPO w/ token IS | 48.27 / 58.12 | 41.23 / 52.12 | 9.45 / 14.67 | 72.19 / 57.61 | 13.17 |
| MPO | 50.32 / 59.33 | 43.42 / 56.24 | 10.03 / 15.16 | 73.22 / 58.35 | 15.00 |
几个值得说的点:
MPO 在两个规模上横扫全部 9 项指标。 相对每列最强基线,4B 的 BrowseComp-Plus、GAIA、HLE pass@1 分别涨 4.33、3.85、0.66 分,30B-A3B 上涨 3.59、3.80、0.12 分。GAIA 的 pass@3 提升最大,分别涨 5.11 和 5.90 分。
token IS 消融信息量很大。 把 turn 级比率换回 token 级,所有指标都掉——4B 搜索三基准 pass@1 分别掉 2.36、3.12、1.03 分。这说明 turn 级重要性修正不是摆设。但反过来,即使只用 token IS,MAE 版本仍然全面赢过 PPO,说明多尺度信用分配本身也在起作用。两个组件各自有效、叠加更好,这个消融做得干净。
HLE 上的提升明显偏弱。 0.66 和 0.12 分,跟 BrowseComp-Plus 上的 3-4 分比差了一个量级。HLE 本身是超难的知识型基准,瓶颈可能在模型知识储备而非决策信用分配,MPO 这类优化器层面的改进自然使不上劲。挑骨头的话,论文没有展开讨论这一点。
🔬 消融:两个衰减率、一个强度系数
参考配置是 \((\lambda, \lambda_{\mathrm{intra}}, \beta)=(0.80, 0.95, 1.00)\),在 4B 搜索任务上扫参。
\(\lambda\) 与 \(\lambda_{\mathrm{intra}}\)(Table 2):
| \((\lambda, \lambda_{\mathrm{intra}})\) | BrowseComp-Plus p@1/p@3 | GAIA p@1/p@3 | HLE p@1/p@3 |
|---|---|---|---|
| (0.80, 0.95) | 48.08 / 61.83 | 39.47 / 52.67 | 9.92 / 16.78 |
| (0.60, 0.95) | 47.51 / 59.22 | 38.92 / 50.79 | 9.11 / 15.17 |
| (0.85, 0.95) | 46.36 / 58.91 | 37.26 / 51.04 | 8.87 / 14.89 |
| (0.80, 0.90) | 46.25 / 57.81 | 37.92 / 50.35 | 8.15 / 15.22 |
| (0.80, 1.00) | 47.67 / 59.18 | 38.23 / 50.95 | 8.43 / 16.16 |
为什么 turn 级用更小的衰减(0.80)而 token 级用更大的(0.95)?作者的解释挺有意思:\(\lambda\) 每次交互衰减一次,名义轨迹长度 \(1/(1-\lambda)=5\) 个 turn;\(\lambda_{\mathrm{intra}}\) 每个 token 衰减一次,0.95 对应 20 个 token。交互次数远少于 token 数,所以两个尺度需要不同的传播范围——这正是「多尺度」三个字落到实处的地方。
\(\beta\)(Table 3):
| \(\beta\) | BrowseComp-Plus p@1/p@3 | GAIA p@1/p@3 | HLE p@1/p@3 |
|---|---|---|---|
| 0.0 | 41.80 / 56.77 | 34.20 / 48.90 | 7.88 / 12.96 |
| 0.5 | 44.13 / 58.10 | 37.24 / 51.85 | 8.26 / 13.22 |
| 1.0 | 48.08 / 61.83 | 39.47 / 52.67 | 9.92 / 16.78 |
| 1.5 | 46.23 / 60.35 | 38.26 / 51.26 | 8.93 / 16.23 |
| 2.0 | 45.14 / 59.75 | 37.05 / 50.01 | 8.11 / 15.43 |
\(\beta=0\)(纯 turn 广播)就已经赢过 PPO,但比完整 MPO 差 5-6 分——turn 内的细粒度分配有独立贡献。\(\beta\) 加到 1.5、2.0 反而变差,过度放大 token 间差异有害。曲线是个倒 U,1.0 恰好是甜点。
📈 训练动态与测试时扩展
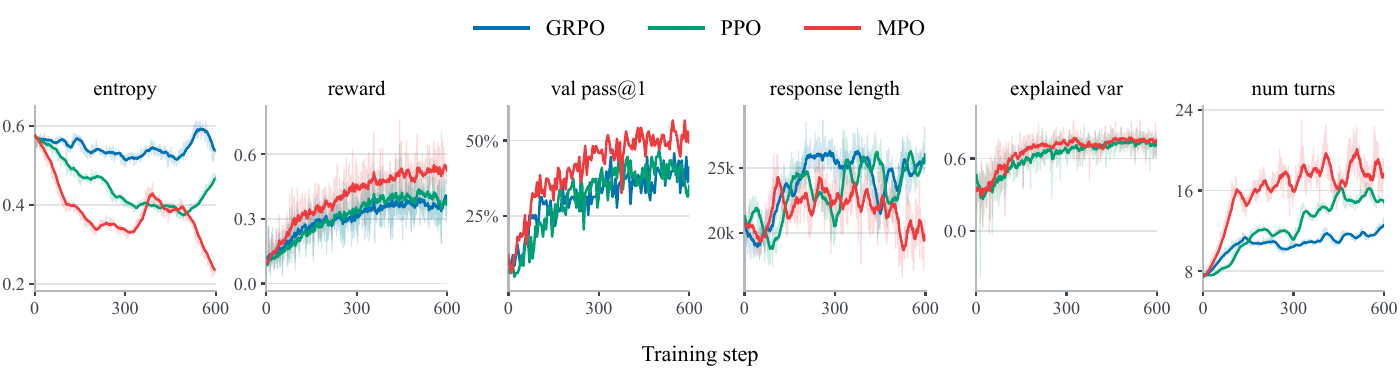
图4:GRPO、PPO、MPO 在 4B 上 600 步的训练动态,依次是熵、训练奖励、验证 pass@1、响应长度、解释方差、turn 数。MPO(红)的验证 pass@1 全程领先;注意熵曲线——MPO 的熵降得比 GRPO 快,但性能没有崩,说明熵本身不是探索崩溃的可靠信号。num turns 子图显示 MPO 学会了用更多轮交互完成任务。
一个有意思的细节:MPO 和 PPO 的 critic 都是 \(\lambda_{\mathrm{critic}}=1\) 直接回归终端回报,但 MPO 训练后期的解释方差更高。作者的猜测是 turn 对齐的更新改变了智能体访问的历史分布,回报结构变得更「好猜」。这个解释我觉得合理但证据偏间接,属于论文里少数没完全说服我的地方。
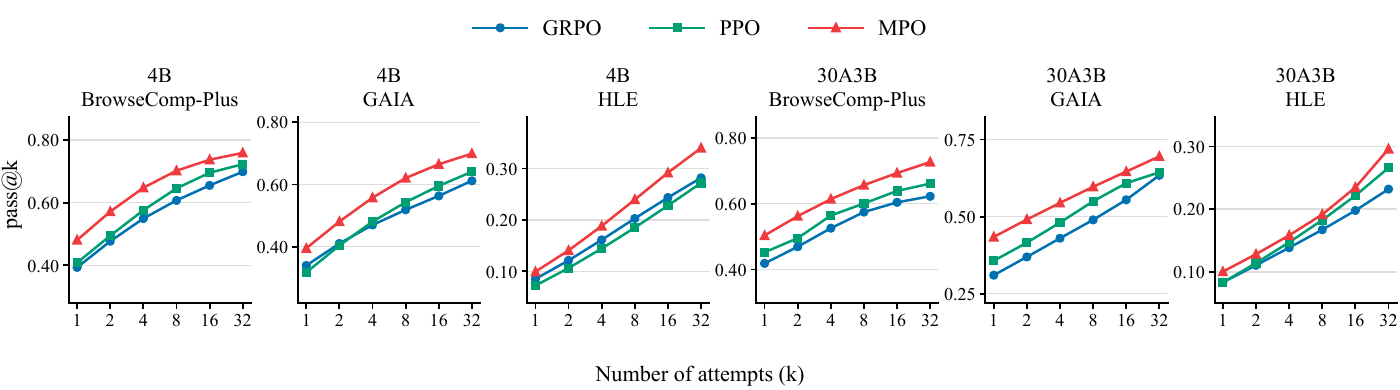
图6:6 个子图分别对应两个模型 × 三个搜索基准,展示 pass@k 随尝试次数 \(k\in\{1,2,4,8,16,32\}\) 的变化。MPO(红)在所有子图、所有 k 值上都压着 GRPO 和 PPO,且差距随 k 增大没有收窄。
测试时扩展这块,4B 上 MPO 的 pass@32 达到 75.90(BrowseComp-Plus)、69.90(GAIA)、34.00(HLE),比强基线高 3.61、5.82、5.80 分。差距在 k=32 处依然保持,说明 MPO 学到的不是单点策略的侥幸,而是整体策略分布质量的提升——多次采样时这个优势会持续兑现。
🤔 我的判断
这篇论文最值钱的地方,是把一个很多人隐约感觉到但没量化的直觉——turn 才是 Agent 的决策单元——变成了可测量的观察(89.5% 的方差占比)、有界分析(Theorem 1/2 指出 token 代理的额外惩罚项)和具体算法(MAE + turn IS)。
从工程视角看,MPO 的落地成本低得让人惊喜:MAE 是在现有 critic 之上的两趟后处理,核心分配公式一行代码;turn IS 靠一个 stop-gradient 就实现,不动采样管线。如果你已经在跑 VAPO 或带 critic 的 Agentic RL,改造成本大概是一两天的事。
批判几点:
- 理论界的实用指导有限。 Theorem 2 给出了 token 代理的额外惩罚项,但量级依赖 \(L_{\max}^2\) 这种松界,更多是「方向性辩护」而非可计算的指导。
- 强依赖 critic 质量。 整个 MAE 建立在 critic 估值上,而终端奖励、长轨迹下 critic 本身很难训准。论文用解释方差侧面回应了这个问题,但在奖励更稀疏、轨迹更长的场景(比如软件工程任务)critic 崩了 MAE 会怎样,没有答案。
- HLE 上的边际提升很小,对超难知识型任务,优化器改进可能接近天花板,论文回避了这层讨论。
- 基线选择是公平的(GRPO/GSPO/PPO/VAPO/SAO 都是当下强基线),这点没得黑。
横向看,这个工作和 GSPO(序列级重要性采样)思路有亲缘关系——都是在修正「重要性比率该在什么粒度上算」;MPO 多走的一步是把优势估计也拉到同一尺度,并用实验证明了「只对齐 IS、不对齐优势」会掉点(token IS 消融)。这个「双对齐」的论证是它对文献最实在的增量。
如果你在做 Agentic RL,我的建议是:MAE 的分配公式和 turn 级 stop-gradient 构造,值得直接抄进你的训练框架里试试,风险很低、上限不小。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我