什么时候该换题,比换什么题更重要?A-RSI 的零数据多模态自我进化
做 RL 后训练的朋友应该都有过这种体验:reward 曲线还在缓慢爬升,但你心里清楚,模型早就把这批题"背熟"了,梯度里已经没有多少真东西。继续练是浪费算力,换一批新题吧——可什么时候换?换一次烧一批新数据,换勤了浪费,换晚了空转。
这个"什么时候"的问题,在自我改进(self-improvement)这条线上一直被有意无意地跳过。大家都在卷"下一批生成什么题"——更难的、更贴近能力边界的、更多样化的——却很少有人认真对待"旧题什么时候该扔"。今天要聊的这篇 A-RSI,偏偏把这个被冷落的决策做成了主角。
核心摘要:A-RSI 解决的是零数据多模态自我改进里的两个老问题——任务池什么时候刷新、参考答案从哪来才可信。它的答案意外地朴素:训练日志里非零优势的 prompt 数掉到阈值以下就整池换题,参考答案不靠模型投票、由一套训练前冻结的程序化模板直接算出来。在 Qwen3-VL-8B 上,只用 800 个新任务就把 11 个多模态基准的平均分从 57.77 推到 61.05,比"每窗口都换题"的方案省 4 倍数据还高出 0.4 分。这不是什么颠覆性突破,但它把一个被忽略的旋钮变成了可操作的规则,而且实验做得相当克制、诚实,值得细读。
论文信息
- 标题:A-RSI: Adaptive Task Refresh for Zero-Data Multimodal Self-Improvement
- arXiv:2610.38568(2026 年 10 月 28 日提交)
- 作者:Yu Liu, Youxing Li, Yuedong Tan, Zhiwei Yang, Zihan Su, Hanqi Feng, Shaojie Zhang, Libin Liao, Zihao Wan, Chenxu Wu, Cong Cao, Fangfang Yuan, Yanbing Liu, Ziheng Chen, Pei Fu, Radu Timofte, Zongwei Wu, Nicu Sebe, Barnabas Poczos, Jian Luan
- 从论文署名页的机构 logo 看,团队横跨小米、CMU、CUHK、特伦托大学、维尔茨堡大学、西安交大、MPI-IS 等多家机构,阵容相当国际化
🎯 痛点:自我改进的两个"灯下黑"
先说说背景。去年到今年,零数据自我进化这条线跑得很快:Absolute Zero 让模型自己出代码推理题、自己解、用执行器验证;R-Zero 把出题方和解题方拆成 Challenger-Solver 双模型共演化;多模态侧也有 MM-Zero、Vision-Zero 把这套玩法搬到视觉推理上。共同点是都不再依赖人工题库。
但热闹之下有两个问题一直被压在桌底。
第一个:刷新时机。 现有方法默认"数据越多越好、换得越勤越好",很多是每一步或每个窗口都持续生成新任务。可任务生成不是免费的——出题、验证、渲染都要开销。而且一直泡在同一池题里,GRPO 的组内优势会越来越趋近于零:所有 rollout 要么全对要么全错,组内没有差异,优势为零,梯度信号直接消失。这时候继续训练就是在空转。
第二个:监督信号的自我指涉。 不少方法用自一致性或多数投票构造伪标签。模型自己投出来的"答案"再拿来训练模型自己——预测里的错误会变成下一轮更新的标签,错误自我强化。这个坑在做过自训练(self-training)的人看来应该很熟悉。
A-RSI 的处理方式是把两个问题干净地拆开:训练动态决定"何时"换新经验,新任务的答案则保持独立可检验。前者看训练日志,后者靠程序计算,谁也别污染谁。
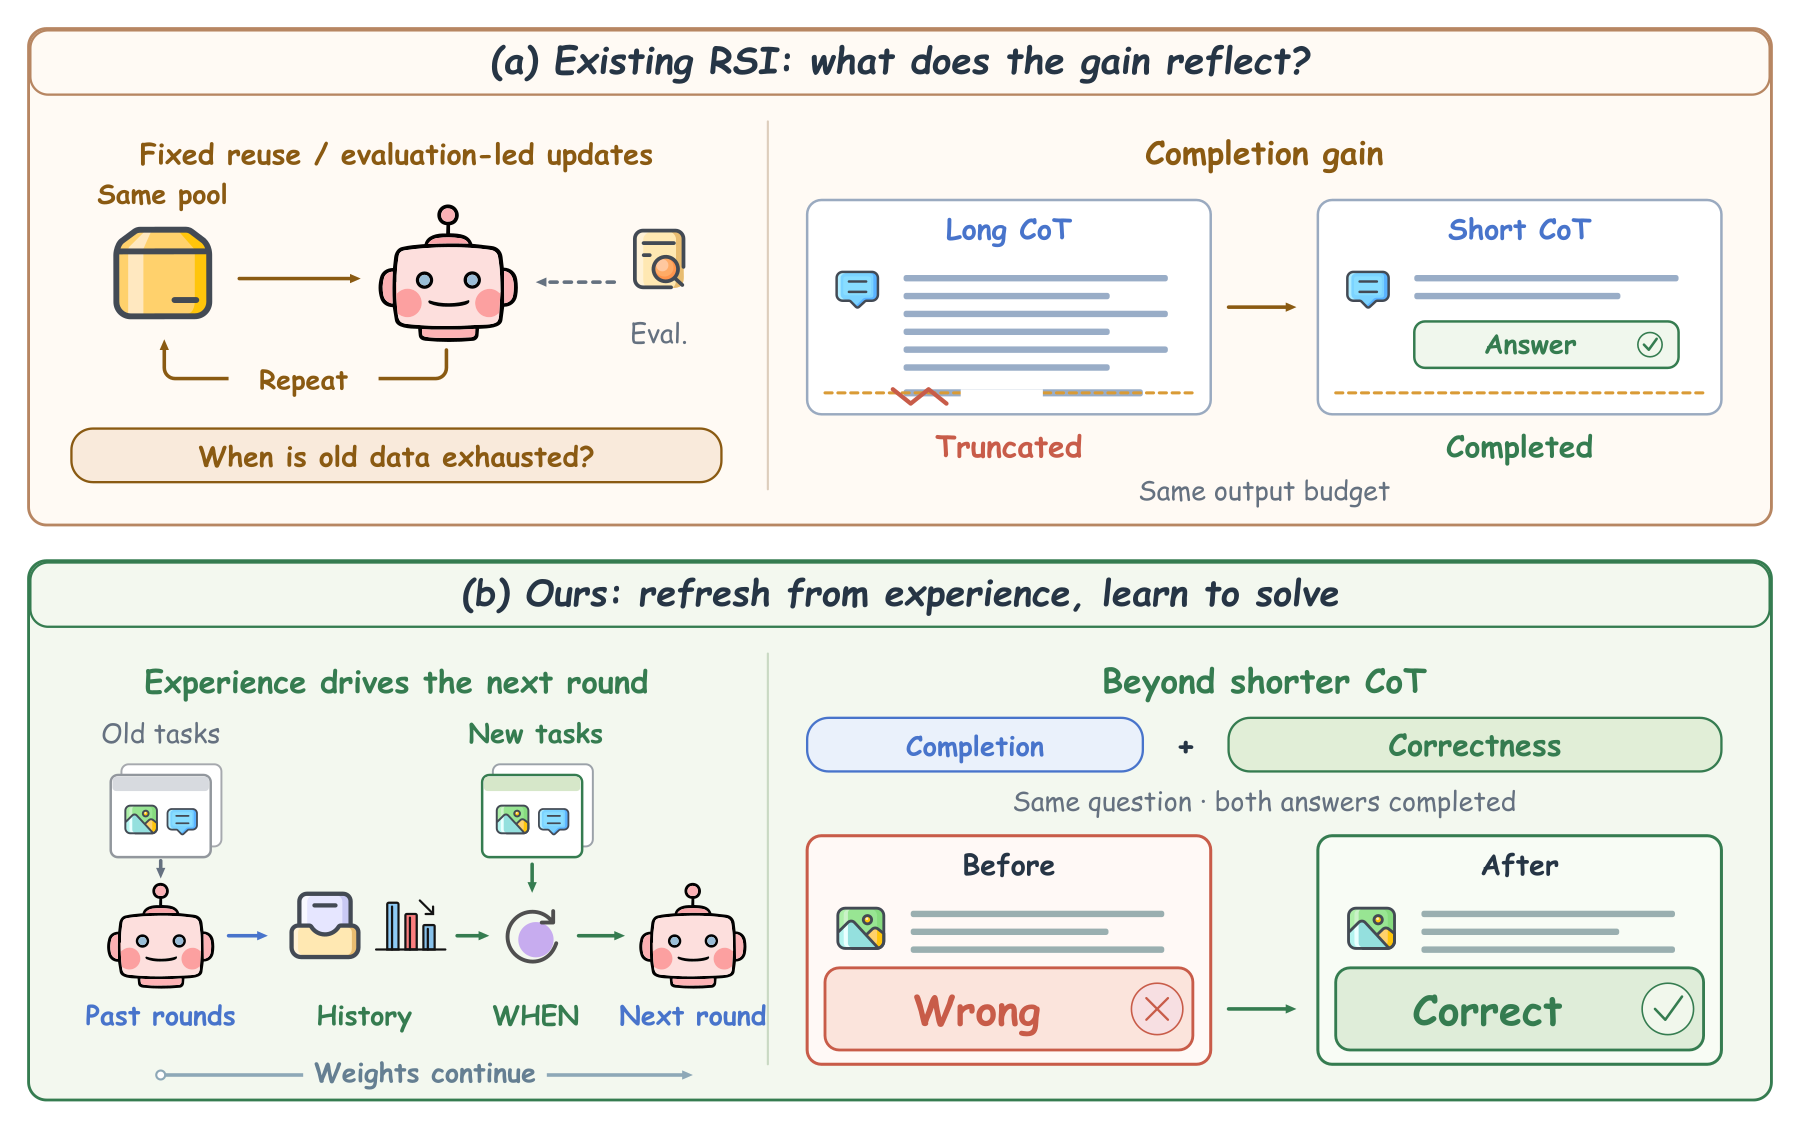
图1:动机总览。(a) 现有方法在同一任务池上反复训练("When is old data exhausted?"),而且基准涨分可能来自两种完全不同的机制——同样输出预算下,长 CoT 被截断 vs 短 CoT 正常完成,光"减少截断"就能涨分;(b) A-RSI 用历史训练日志驱动刷新决策(WHEN),权重持续累积,并通过响应级审计把增益拆成"完成率提升"和"错误纠正"两个来源。这个区分很关键,后面实验部分会看到它发挥了实质作用。
🧠 方法:三个各管一段的部件
A-RSI 的整体结构可以用一句话概括:任务怎么出,训练前一次定死;题怎么练,GRPO 正常跑;什么时候换题,训练日志说了算。
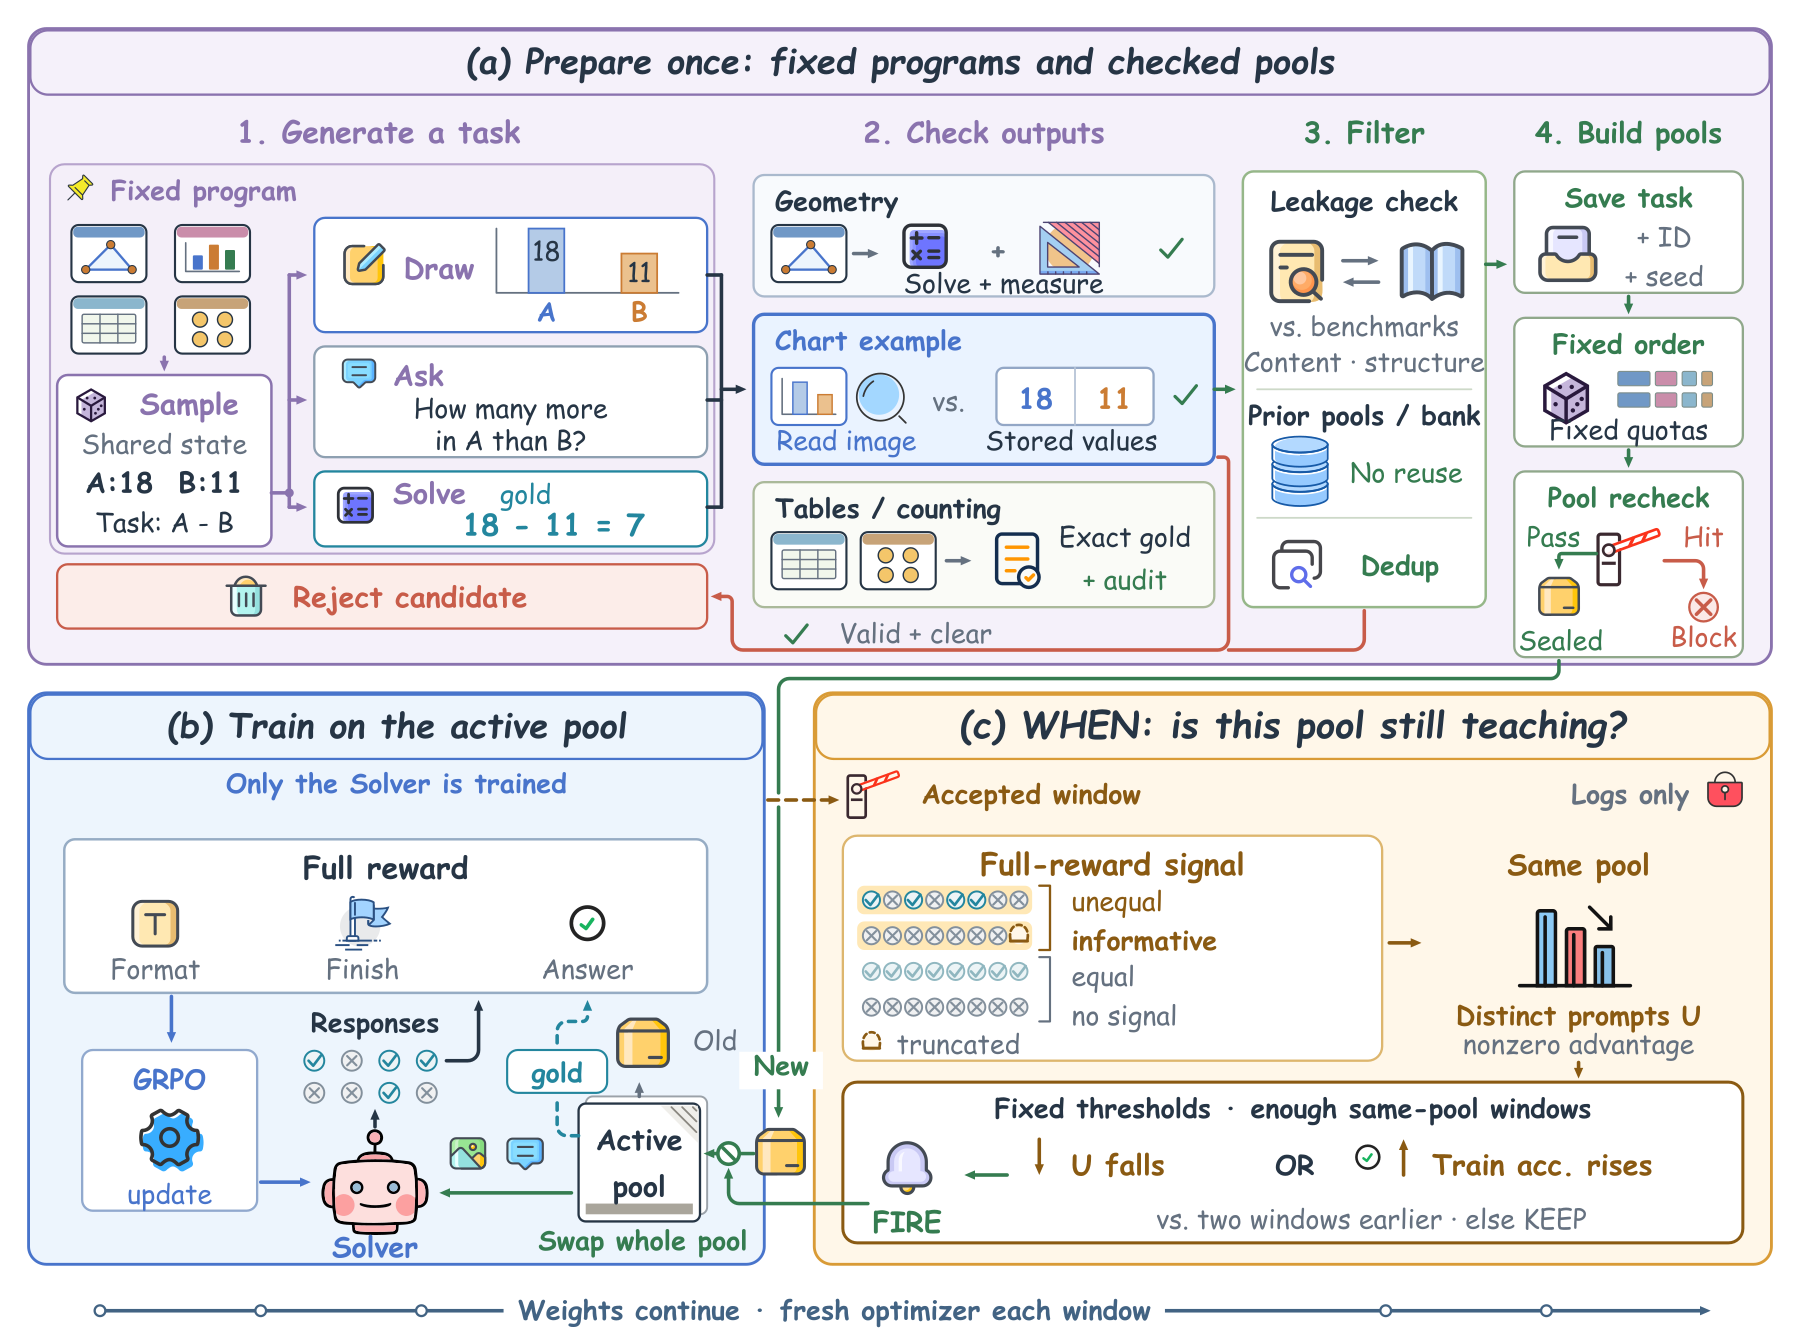
图2:方法全景。(a) 训练前一次性准备:固定程序模板采样参数(如 A:18、B:11)→ 渲染图像 + 生成问题 + 程序求解参考答案(18−11=7)→ 几何/图表/表格/计数四类任务的输出检查 → 泄漏检查、去重、池复查后封存为固定顺序、固定配额的替换池;(b) 训练中只优化 Solver,奖励 = 格式 + 完成 + 答案三项;(c) 每个窗口结束后控制器只读日志:组内奖励全相等就没有信号,非零优势的 distinct prompt 数 U 下降或训练准确率上升超过阈值则触发刷新(FIRE),否则保留旧池。注意控制器全程不碰任何验证集/测试集分数。
程序化任务构建:答案是"算"出来的,不是"猜"出来的
任务生成在训练前一次性完成。基座模型先针对几何、图表、表格、计数四类种子任务编写可复用的参数化程序模板,每个模板指定可容许的参数范围、要问的问题、以及"采样数值—渲染图像—组题—计算答案"的完整程序。模板库建好后全程冻结。
实例化一个任务就是一次程序执行:
程序先采样底层配置 \(z\)(比如柱状图里 \(v_A=18, v_B=11\)),由同一份配置同时生成图像 \(I\)、问题 \(q\)("A 比 B 大多少")和参考答案 \(a = v_A - v_B = 7\)。学习者只能看到 \((I, q)\),回答对照 \(a\) 打分。
这个设计的好处我觉得被低估了:参考答案和图像是同一个程序的同一份内部状态的两个投影,天然一致,不需要模型事后投票确认。候选任务还要过准入检查(答案计算、渲染歧义约束)、新鲜度和污染筛查,合格集 \(\mathcal{C}\) 按固定伪随机顺序预先排好替换池——控制器只决定何时激活下一个,不参与选题。
奖励与训练:三项奖励,没有花活
每个任务采样 \(m\) 个回答,奖励就三项:
答案匹配给 1 否则 0;遵循 boxed 格式给 1;输出到达长度上限(即使最后憋出了 boxed 答案)罚 −1。没有逐 token 长度惩罚,没有推理步数奖励。优化用 GRPO,只更新 Solver 策略。
说实话这个奖励设计朴素到有点"简陋",但论文第 7 节给了一个我喜欢的小论证:辅助奖励不可能逆转正确性排名——\(R(r_c) - R(r_w) \ge 1 - \lambda_{\mathrm{fmt}} - \lambda_{\mathrm{stop}} \gt 0\),格式和停止奖励加得再多也翻不了"答错"的盘。他们还做了奖励评分压力测试:7,000 个受控响应变体上,正确答案排名高于错误答案 1000/1000,格式与终止项各 1000/1000。更狠的是答案审计:从实际消耗的替换池抽 1,000 个任务,独立求解器与全部参考答案一致,注入的 4,000 个缺陷全被检出,还用 SMT 求解器机器检查了规范模型的四条性质(正确性排名保护、池内滞后索引、有界单步难度更新、跨池新鲜度)。这种"我把自己的基础设施先测一遍"的做法,在这类论文里不多见。
刷新规则:这篇论文真正的核心
直觉来自 GRPO 的一个性质:组内所有回答总奖励相同,优势就为零,这个 prompt 对策略梯度没有贡献。所以"这池题还教不教得动模型"可以直接从日志里数出来:
\(U_w\) 是当前窗口里仍有非零优势的 distinct prompt 数,\(a_w\) 是记录回答的正确率。刷新决策:
两个触发条件:有效信号 prompt 数相对 \(\ell\) 个窗口前掉到保留阈值 \(\rho\)(85%)以下,或者训练准确率涨了 \(\eta\)(10 个百分点,说明模型对池子太熟了)。满足其一且过了最小观察期就整池换掉,不放回抽新题,模型权重不重置,每个新窗口用全新优化器接着练。
有一个细节我很欣赏:作者明确说"饱和"只是操作性规则——全错的回答同样会消除组内差异,所以这条规则检测的是"没有可学的信号",不是"已经学会"。这种不夸大自己定义的克制,反而让人更信任后面的数字。
整个训练循环(Algorithm 1)还配了健康门:窗口异常就从上一接受检查点同池同种子重试一次,再失败就终止;替换池耗尽时宁可拒绝启动下一窗口,也不静默复用旧任务。工程上这些"兜底不糊弄"的选择,往往是自训练系统能不能跑久的分水岭。
🧪 实验:800 个新任务,涨 3.28 个点
设置
主实验用 Qwen3-VL-8B-Instruct(先在 500 题旧池上 100 步 GRPO 初始化得到 \(S_t\)),辅助验证用 MiMo-VL-7B-SFT。五个对比臂,从同一个 \(S_t\) 出发,每窗口 100 次更新,每次刷新换 400 个未使用任务:
| 臂 | 刷新规则 | 新池选择 |
|---|---|---|
| A-RSI | 训练日志触发 | 随机采样(固定家族配额) |
| Frontier | 同一检测器 | 前沿选择(挑模型尚不可靠的最简单难度) |
| Periodic | 每两窗口 | 前沿选择 |
| Continuous | 每窗口 | 按保留准确率自适应调难度 |
| No-Refresh | 永不刷新 | 复用旧池 |
评估是 11 个基准的完整测试集(MMSI、MathVerse、MathVision、MMMU-Pro 三种形态、VisNumBench、MMMU、ChartQA、PhyX、SCEMQA-MC),等权平均记为 Macro11,输出上限 8,192 tokens。
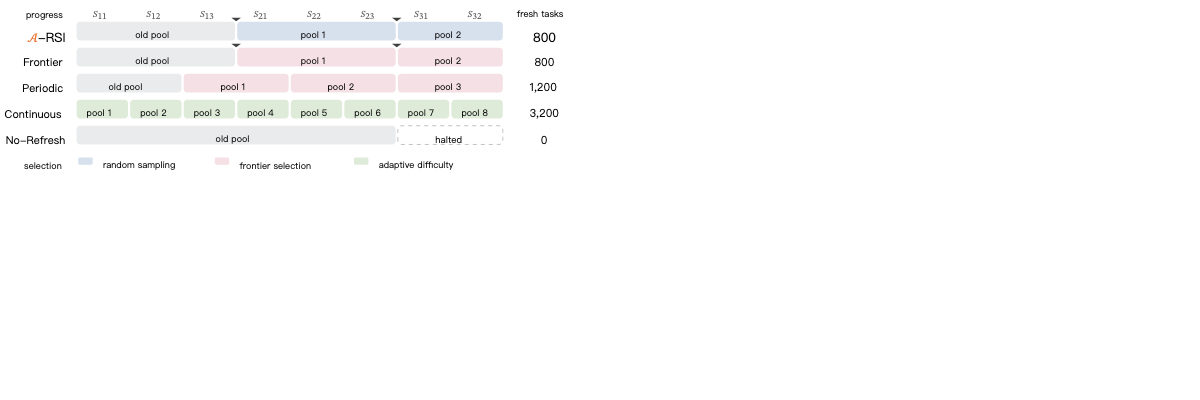
图3:五个臂的任务池消耗可视化,列按继续训练窗口对齐。A-RSI 在检测器触发的两个时刻(三角标记)换池,总共用了 800 个新任务;Frontier 同样 800 个但用前沿选择;Periodic 换三次共 1,200 个;Continuous 每窗口都换共 3,200 个;No-Refresh 一直复用旧池,中途健康门失败停机(图中虚线"halted")。
主结果
Qwen 上的核心数字:从 \(S_t\) 的 57.77 出发,窗口 4/6/8 分别达到 59.84 / 60.40 / 61.05。相对公共基座 \(S_0\) 的 56.65,端到端涨了 4.40 个点。挑几个基准看 \(S_0 \to S_{32}\) 的变化:
| 基准 | \(S_0\) | \(S_{13}\) | \(S_{23}\) | \(S_{32}\) | \(S_{33}\) |
|---|---|---|---|---|---|
| MathVision | 45.92 | 47.66 | 50.62 | 51.45 | 52.53 |
| MMMU | 60.56 | 63.24 | 64.25 | 64.36 | 65.92 |
| PhyX | 63.50 | 68.30 | 72.03 | 74.17 | 73.33 |
| ChartQA | 81.24 | 81.88 | 84.52 | 84.96 | 85.00 |
| VisNumBench | 49.03 | 54.47 | 55.62 | 55.99 | 56.19 |
| Macro11 | 56.65 | 58.75 | 60.40 | 61.05 | 61.44 |
PhyX 涨了近 11 个点,MathVision 涨 6.6 个点——提升集中在几何/物理类重推理基准上,而不是已经接近饱和的 ChartQA。MiMo 上从 59.08 到 60.71,幅度小一些但方向一致,说明机制不绑定特定基座。
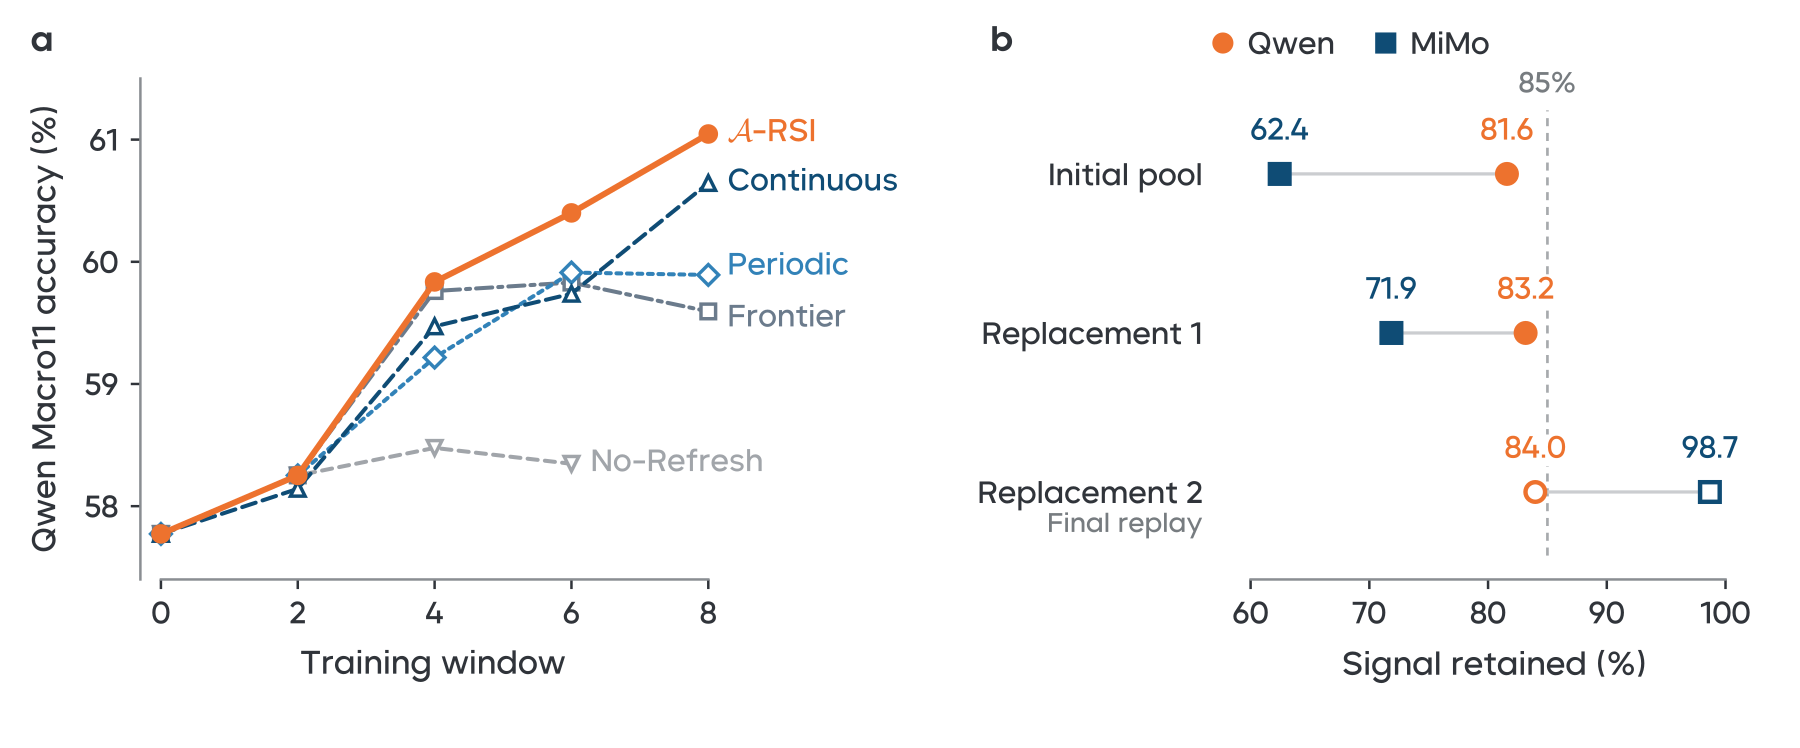
图4:(a) Qwen Macro11 随训练窗口的变化,A-RSI 全程压着其余四臂,窗口 8 时 61.05 对 Continuous 的 60.64、Periodic 的 59.89、Frontier 的 59.59;No-Refresh 在窗口 6 后停滞并停机。(b) 池内信号保留率:Qwen 初始池三窗口后非零优势任务从 239 降到 195(保留 81.6%,低于 85% 阈值,触发换池),第一替换池再降到 83.2% 又触发;有意思的是 MiMo 在第二替换池保留率 98.7%、准确率只升 6.63 点,控制器选择保留——同一条规则在同一阶段对两个模型给出不同决策,这是固定调度做不到的自适应性。
效率对比:省钱还更强
窗口 8 的横评是全文最有说服力的一张表:
| 臂 | Macro11 | 消耗新任务 | 每千任务增益 |
|---|---|---|---|
| A-RSI | 61.05 | 800 | 4.09 |
| Continuous | 60.64 | 3,200 | 0.90 |
| Periodic | 59.89 | 1,200 | — |
| Frontier | 59.59 | 800 | — |
| No-Refresh | 终止于 \(S_{31}\) | 0 | — |
同样 800 个任务,随机刷新的 A-RSI 比前沿选择的 Frontier 高 1.45 分;比"每窗口都换"的 Continuous 高 0.41 分,数据只用了四分之一。No-Refresh 最惨:\(S_{31}\) 时 100 步里只有 94 步有正常梯度,35 次零信号警告,健康门失败两次后整个训练被终止——这就是"在废池上空转"的实锤。
替换选择消融:随机打败所有"聪明"策略
这部分结果说实话有点反直觉,也因此很有意思。作者测了一堆精心设计的选择策略——失败优先采样、可学习带采样、全错采样、阶梯控制器、只增难度控制器、截断感知控制器——没有一个打赢随机替换:
| 选择策略(四窗口、每窗口刷新) | Macro11 | 与随机对照差 |
|---|---|---|
| 随机对照 | 60.29 | — |
| 只增难度控制器 | 59.81 | −0.48 |
| 截断感知控制器 | 60.24 | −0.05 |
| 阶梯控制器 | 59.47 | −0.82 |
| 全层级采样 | 59.10 | −1.19 |
| 可学习带采样 | 58.39 | −1.90 |
| 全错采样 | 57.89 | −2.40 |
| 失败优先采样 | 57.67 | −2.63 |
难度阶梯的价值在于诊断而非选择——作者发现模型自评难度与真实难度的 AUC 只有 0.50 左右,等于瞎猜,所以一切"按模型自评难度选题"的策略都建在流沙上。这个负结果对整个自我改进领域都挺有警示意义的:你以为的"课程学习",可能只是往训练里注入了噪声。
🔬 增益到底从哪来:诚实得有点罕见
这篇论文最打动我的不是主结果,而是它对自己增益来源的解剖。
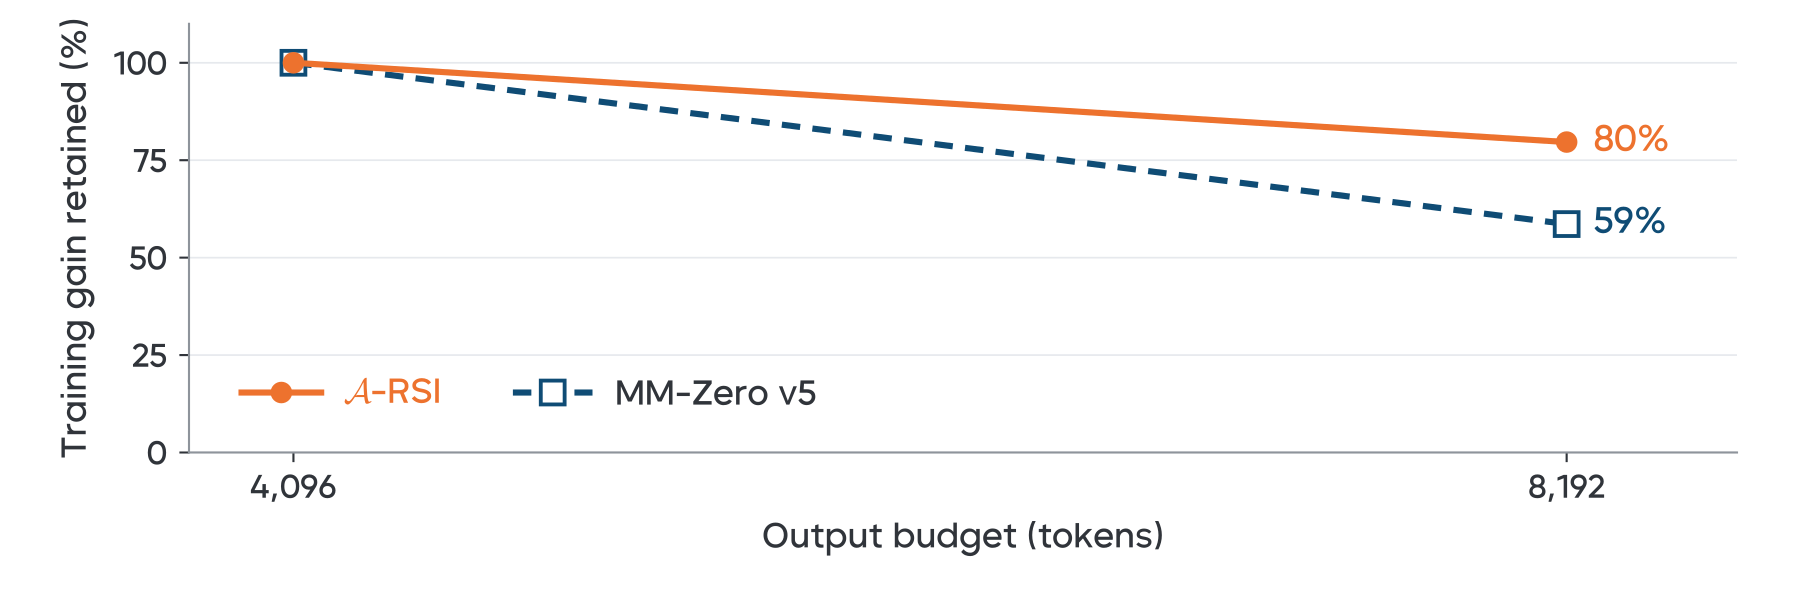
图5:输出预算从 4,096 翻倍到 8,192 tokens 时,A-RSI 保留 80% 的训练增益(仍高于基座 3.25 分),而 MM-Zero v5 只保留 59%。A-RSI 学到的行为对输出预算更不敏感。
\(S_{23}\) 处 A-RSI 比 No-Refresh 高 2.05 分,作者把这 2.05 拆开:两臂都完成的回答贡献 −0.60(A-RSI 在已完成项上其实还退步了一点),其余 +2.66 全部来自"完成率层级"的变化——也就是原来被截断、没跑出答案的回答,现在能正常收尾了。增益的大头是完成,不是纠正。

图6(案例 A1 配图):基座模型两次解码都顶到 token 上限被截断,\(S_{32}\) 两次解码分别用 1,759 和 3,437 tokens 正常完成并答对。作者也坦言:更短的完整回答能涨分,哪怕推理过程本身仍有缺陷,而且无法确定是哪个奖励分量导致了这个变化。
当然也有真纠错发生:

图7(案例配图):基座两次独立解码给出相同的错误答案(21.59 和 2),\(S_{32}\) 两次解码都给出正确答案(60.68 和 1),且这些纠正在 \(S_{21}\) 到 \(S_{33}\) 的 seed-0 评估中持续存在。作者同时提醒:个别成功案例不能证明在全部原本完成的题目上有净改进。
再看结论部分的自我拆台,堪称同行评审友好型写作:每个臂只训练了一次,没有多种子重复;MiMo 上相对旧池复用只高 0.70 分、相对每窗口刷新只高 0.02 分,不足以确立时机优势;最扎心的是这句——固定前沿选择时,检测器触发刷新(59.59)反而比固定两窗口周期刷新(59.89)低 0.30 分,而且 A-RSI 前两次随机刷新恰好都落在三窗口边界上,所以结果支持的是"这套实现整体有效",并未证明检测器时机优于固定调度。
等等,那检测器的价值到底成不成立?我的看法是:在 Qwen 主轨迹上它确实没和固定调度拉开差距,但 Figure 4b 里 MiMo 第二替换池被主动保留那个案例,展示了固定调度原理上给不出的东西——不同模型、不同阶段的饱和速度不一样,规则能逐案裁决。这个价值是真实的,只是还需要多种子实验来坐实。
🤔 我的判断
这篇论文最值钱的地方,是把"何时刷新"从工程直觉变成了一条可审计、可复现的操作规则,而且顺手用一组消融把"精心选题"的幻梦戳破了——在它的设置下,随机替换就是最强的选择策略。如果你在做自我改进或 RL 数据调度,这两个结论都值得直接抄走:监测非零优势 prompt 的保留率来触发数据更新;在怀疑随机策略之前,先把你聪明的选择规则和随机基线打一架。
但也要清醒:+3.28 个点里的大头是完成率提升,这在 8,192 输出预算的评估协议下是实打实的分数,可它更像"学会了别啰嗦",而不是"学会了更难的推理"。MathVision 和 PhyX 的持续爬升说明有真能力增益,但个案证据撑不起强结论,作者自己也没这么宣称。此外单臂单次运行、所有结论绑定这一套特定生成器家族(几何/图表/表格/计数),泛化到开放式任务时会怎样完全是开放问题。模板库的构建依赖基座模型一次性写程序,模型太弱的话这个bootstrap能不能成立,论文没有回答。
放在整个版图里看,Absolute Zero 解决了"题从哪来",R-Zero 解决了"题要多难",A-RSI 补上了"题什么时候换"——自我进化的三个正交旋钮各有人把守了。下一步大概率是三者合体:程序验证的任务生成 + 能力边界的难度调度 + 日志驱动的刷新时机,谁先把这套闭环跑顺,零数据自我改进就算真正进入了工程化阶段。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我