成功轨迹≠有效监督:Trajectory2Gym 用「组合覆盖 + 决策依据」重构工具智能体训练数据
核心摘要
做工具调用 Agent 训练的人大多默认一件事:跑通的轨迹就是好数据,收集得越多越好。这篇论文直接拆了这个台——成功的交互可能根本没教模型任何东西:要么关键的跨步依赖在数据里只出现一两次,要么被监督的动作在 agent 当时可见的信息里根本推不出来。作者提出 Trajectory2Gym,把轨迹生成从「收集成功样本」重构为「刻意构造可学习的交互经验」:围绕支持不足的组合结构合成可执行交互,只从决策时有依据的动作中提炼监督,再用结构支持选择分配训练经验、父归一化 SFT 保证语义交互是训练权重的单位。五个 Qwen3 规模(1.7B 到 30B-A3B)上,Tau1/Tau2/BFCL 三基准等权均值提升 16.9 到 29.8 个百分点,8B 模型的三基准均值 67.97 是所有受评公开 checkpoint 里最高的。我的判断:这不是又一次数据合成技巧,而是给「轨迹监督」这件事立了两条可认证的规矩——含金量在于标准,而非规模。
论文信息
- 标题:Trajectory2Gym: Decision-Grounded Compositional Interaction Synthesis for Tool-Use Agents
- 作者:Yihao Hu, Zhihao Wen, Yitong Lin, Siyuan Lu, Pan Wang, Wei Wu, Jiang-Ming Yang, Tao Lin
- arXiv:https://arxiv.org/abs/2610.33568 (2026 年 10 月 24 日提交,arXiv ID: 2610.33568)
一个让人不舒服的现象:成功轨迹可能是无效监督
你有没有遇到过这种情况:线上跑了一批 agent 轨迹,筛出任务成功的,拿去 SFT,结果模型不涨反跌?
这不是玄学。论文引用的一个观察是,直接在记录的轨迹上微调,效果甚至可能低于初始化水平。问题出在哪?作者给了两组相当扎心的统计。在他们收集的 34,772 条已认证候选轨迹池里:40.9% 的轨迹最多只包含 2 个被监督的决策点——也就是说大部分「成功轨迹」根本没几步值得学;只有 10.0% 的轨迹包含发生在真实错误之后的已认证决策——也就是「从失败中恢复」这种最有价值的行为模式,在数据里罕见得像濒危物种。
这是第一个失败模式,作者称之为组合覆盖不足(compositional coverage):轨迹没有以足够的重复去锻炼那些跨步骤的依赖关系。
第二个更隐蔽,叫决策无依据(decision grounding)。看个具体例子就明白了。

图1:Tau2 Retail 场景,用户先要换大瓶子和暗台灯,随后改口只确认台灯。下半部分展示两种过滤规则对同样两个候选动作的裁决:按「工具执行是否成功」过滤,换台灯和换瓶子两个动作都会被保留(API 对两个请求都接受);Trajectory2Gym 依据目录证据和用户最新确认,保留台灯换货、拒绝额外的瓶子换货。左上方还点出传统检查的两个盲区——单个调用脱离了上下文,错误的交换照样能执行成功。
这个例子很妙。API 层面两个调用都「成功」了,但只有一个是用户真正想要的。如果你的数据筛选标准只是「执行成功 + 任务最终成功」,那这些错误的动作就堂而皇之地进了训练集。收集者还可能用了 agent 根本看不见的标识符(比如直接从数据库里查出来的内部 ID),模仿这种动作等于让模型学会「凭空变出正确答案」——考试能抄到,实战必死。
所以作者的立场很清晰:成功应该用来「门控」监督,而不是「许可」监督。任务成功只是入场券,每个被监督的决策还得单独过审。
Trajectory2Gym:三阶段流水线

图2:方法总览。左侧「Grounded interaction construction」:针对目标能力缺口生成交互,teacher 在原生环境中执行,产生执行日志;然后过滤认证(排除 teacher 专属提示、核对证据、执行、工作流),产出学生可见的 trace——被拒绝的调用和工具错误保留为上下文,recovery 决策成为监督目标。右侧「Structural-support learning」:认证轨迹池按 Discover / Recover / Complete 三类能力组织,经结构选择后做父归一化 SFT。
先把问题形式化一下。环境为 \(\mathcal{E}\),\(V\) 是把完整交互历史投影到 agent 可见部分的算子。策略基于决策上下文行动:
监督集是带 mask 的轨迹集合 \(\mathcal{D}_s = \{(\tau_i, m_i)\}\),\(m_{it}=1\) 表示第 \(t\) 个决策是监督目标。注意一个关键设计:完整的可见交互保留为上下文,mask 只负责挑选「学哪几步」。整条流水线分三段。
组合交互合成:哪里薄弱补哪里
第一个阶段解决覆盖问题。作者定义了一个共享能力词表 \(\mathcal{K}\),覆盖语义动作与参数、观测结果、恢复、分支、移交、终止、时域等角色,把原生工具映射到这些角色上。有序路径 \(p = (\kappa_1, \dots, \kappa_\ell)\) 组合这些能力需求,生成器构造请求和兼容的初始状态,teacher 在原生环境里执行:
然后是支持度统计:\(n_\mathcal{S}(p) = \sum_{\tau \in \mathcal{S}} \mathbb{1}[p(\tau)=p]\)。核心动作是针对支持度不足的路径做定向条件生成。为什么要定向而不是随机多采?论文里有个简单但有力的概率论证:从 \(N\) 个候选里均匀选 \(B\) 个,某条只出现一次的路径被漏掉的概率是 \(1 - B/N\)——预算再大都是杯水车薪。稀有结构只能刻意去造。
合成不是「编对话」。每条路径所需的实体、前置条件和信息来源都被显式建立,且只有当其动作-观测依赖真实出现在执行日志中才被认证,计入支持库存。
Grounded 监督:每个决策单独过审
第二个阶段是这篇文章最硬核的部分。监督资格被拆成两个独立条件:
\(e_t\) 是原生执行有效性(认证的非错误执行),\(v_t\) 是决策时依据——工具必须对 agent 可用,标识符类参数必须有先前可见信息支撑(可发现的工具得先出现在可见检索结果里)。只有收集者知道的标识符,不配支撑监督目标。
被拒绝的调用和真实错误怎么处理?这个设计我很喜欢:保留为可见上下文,但不承担模仿损失。也就是说,模型看得到「这一步调错了、工具报了什么错」,但不会被要求模仿这个错误;而错误之后的 grounded recovery(恢复动作)反而成为最有价值的监督目标。真实错误是上下文,不是目标——这句话值得抄在墙上。
最终的监督 mask 还要过工作流完成度这一关:
\(R_\tau\) 是原生终止成功,\(q_\tau \preceq A_\tau\) 检查任务的有序需求是否被合格动作序列完整覆盖。三关全过的轨迹才进入合格池。
结构支持学习 + 父归一化 SFT
第三个阶段决定「学哪些、怎么加权」。规模 \(s\) 下给每条可行的 canonical 路径设定目标不同轨迹数 \(d_s\)(1.7B 到 30B-A3B 分别是 1、2、3、4、8——小模型浅覆盖,大模型深覆盖),剩余缺口为:
选择算法从固定认证核心出发,优先补缺口。论文证明在纯基数预算下,缺口阶段恰好最大化受限支持 \(\sum_p \min(n_\mathcal{S}(p), d_s)\)——这是个分配问题,不是「越多越好」的扩展问题。
最后是父归一化 SFT,一个容易被忽略但实测收益最大的设计。一条语义轨迹可以渲染出多个训练样本(按不同监督目标分组),如果按行平均,长多轮交互会凭子样本数量优势主导损失。父归一化把权重定义在父轨迹级别:
举个例子:两条交互分别渲染出 3 个和 1 个样本,行平均给的权重是 3/4 和 1/4,父归一化各给 1/2。你想想看,凭什么一条 20 轮的对话就该比一条 3 轮的多学 6 倍?没道理。
实验:五个规模全面上涨,多轮场景提升最猛
实验设置很干净:Qwen3 五个规模(1.7B/4B/8B/14B/30B-A3B),全部从公开初始化出发,只做 1 个 epoch 全参数 parent-normalized SFT,训练集按规模条件化(11.6k 到 19.9k 条轨迹)。基准是 Tau1、Tau2、BFCL 三个。评测证据标准是配对比较:同任务集、同接口、同解码、同用户模拟器、同评分器,每任务跑一次。
Tau1 / Tau2 主表
| 模型 | Tau1 Avg | Tau2 Avg | Mean | Δ |
|---|---|---|---|---|
| GPT-5.2 (high)(参考) | 69.22 | 84.76 | 76.99 | – |
| Claude-4.5-Opus (high)(参考) | 73.45 | 85.31 | 79.38 | – |
| Qwen3-1.7B | 8.52 | 23.33 | 15.93 | – |
| + Trajectory2Gym | 34.43 | 37.50 | 35.97 | +20.04 |
| Qwen3-4B | 24.22 | 19.17 | 21.70 | – |
| + Trajectory2Gym | 44.22 | 69.17 | 56.70 | +35.00 |
| Qwen3-8B | 27.87 | 25.00 | 26.44 | – |
| + Trajectory2Gym | 51.13 | 74.17 | 62.65 | +36.21 |
| Qwen3-14B | 32.04 | 25.00 | 28.52 | – |
| + Trajectory2Gym | 58.04 | 80.83 | 69.44 | +40.92 |
| Qwen3-30B-A3B | 44.39 | 28.33 | 36.36 | – |
| + Trajectory2Gym | 66.78 | 84.17 | 75.47 | +39.11 |
几个值得停一秒的数字:
- 4B 训后 Tau2 达到 69.17,超过了公开的 30B-A3B 初始化(28.33)——数据质量碾压了 7 倍多的参数差距;
- 30B-A3B 训后 Tau2 达 84.17,距闭源参考(84.76、85.31)在 1.2 分以内;
- 25 组配对比较里 24 组提升,唯一例外是 1.7B 在 Tau2 Airline 持平;
- 最夸张的单格:Tau2 Telecom 在 30B-A3B 上从 12.50 涨到 95.00。说实话看到这个数我愣了一下——这不是改进,是起死回生。
作为参照,重评估的公开 checkpoint 里 MUA-RL-32B 的 Mean 是 49.52,Simia Tau-SFT 39.55,LoopTool-8B 只有 23.87。
BFCL 主表
| 模型 | Live Simple | MT Base | Overall | Δ |
|---|---|---|---|---|
| GPT-5.5(参考) | 73.64 | 60.00 | 75.63 | – |
| Gemini-3.0-Pro(参考) | 87.60 | 69.00 | 79.97 | – |
| Qwen3-8B | 73.64 | 36.00 | 67.30 | – |
| + Trajectory2Gym | 74.42 | 68.00 | 78.62 | +11.32 |
| Qwen3-30B-A3B | 82.95 | 65.00 | 77.58 | – |
| + Trajectory2Gym | 69.77 | 72.00 | 80.93 | +3.35 |
提升几乎全部集中在 Multi-turn Base(+7 到 +41),4B 及以上的训后模型全部超过 GPT-5.5 的 MT Base(60.00)。30B-A3B 的 Overall 80.93 压过了 Gemini-3.0-Pro 的 79.97。
但有个诚实的负面信号值得点名:Live Simple 在 5 个规模中的 4 个下降了 6 到 13 分。简单单轮任务反而退步了——这很合理,训练分布整体偏向复杂多轮交互,单轮简单调用被「挤占」了。作者没藏着这个数据,好评。
三基准等权均值的总提升是 16.9 到 29.8 个百分点(8B 的 67.97 是所有受评 checkpoint 的最高值,其余公开 checkpoint 至多 57.17)。
消融:父归一化是隐藏 MVP
Qwen3-8B 上的匹配对照消融(Table 3),每组只动一个组件:
| 对照组 | 干预 | Mean 变化 |
|---|---|---|
| 现有候选池 | + 定向扩展 | +3.55 |
| 宽松成功派生目标 | + 决策依据化 | +2.75 |
| 随机选择 | + 结构选择 | +2.32 |
| 渲染行平均 | + 父归一化 | +8.04 |
四个组件全部正向,但幅度差距很大。父归一化单组件 +8.04,比另外三个加起来还多——尤其是 Tau2 从 52.50 直接跳到 74.17。一个训练权重的修正,收益超过数据合成策略本身,这个结果挺反直觉的,也提醒做 SFT 的人:样本渲染策略不是工程细节,是一等公民。
还有个敏感性实验(Table 4)更值得玩味:结构支持深度从 2 加到 4,均值反而从 72.28 降到 69.44(下降集中在 Tau2,82.50 → 75.00)。结构支持不是越深越好——它是分配问题,不是数据扩展规则。这个结论对「数据越多越好」的朴素信仰又是一击。
定性对比:同一个任务,三种死法和一种活法
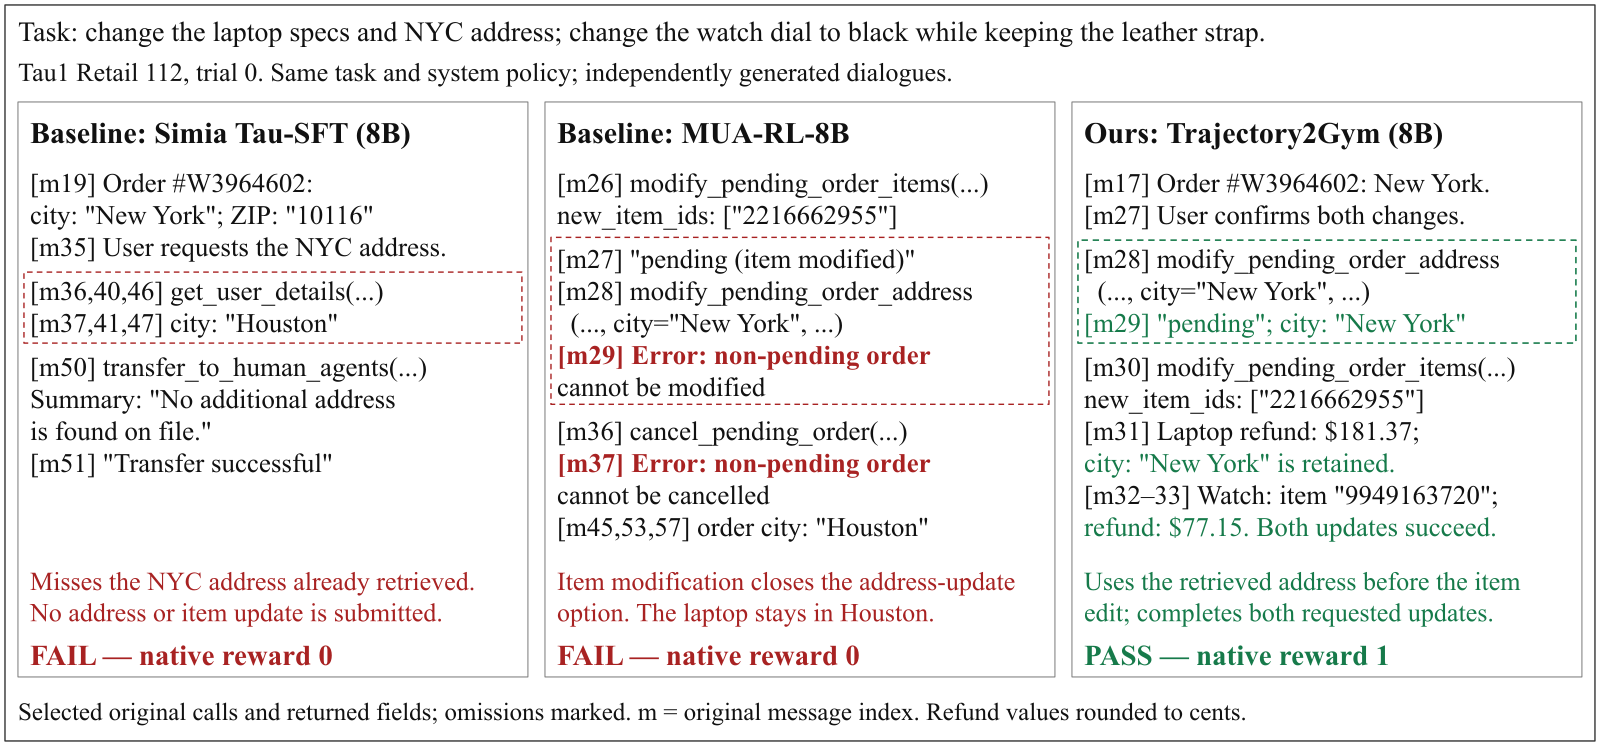
图4:Tau1 Retail 同一任务(改笔记本规格+纽约地址,表盘换黑但保留皮表带),三个 8B 模型的独立 rollout。Simia 拿到了纽约地址却没用上,最后转人工;MUA-RL 违反状态依赖顺序,先改商品导致订单变成非 pending,后续地址修改直接报错;Trajectory2Gym 复用已检索的地址、保持正确依赖顺序,两项更新都完成,原生奖励 1。
这个对比把「决策依据」讲活了:Simia 的问题是忽视可见证据(地址明明检索过了),MUA-RL 的问题是违反状态依赖(操作顺序错了,后面全崩)。这两类病,恰好就是组合覆盖和决策依据两条标准分别治的。
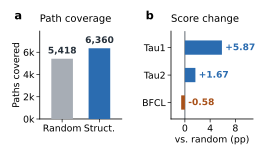
图3:(a) 结构选择覆盖 6,360 条 canonical 路径,随机选择只有 5,418 条(多覆盖 942 条);(b) 相对随机选择的分数变化:Tau1 +5.87,Tau2 +1.67,BFCL 基本持平(-0.58)。

图5:email 查询返回「user not found」后,agent 改用姓名+ZIP 码的替代查询恢复工作流——失败的调用和真实错误响应保留在可见上下文里,后续的 grounded 恢复决策成为监督目标。
我的判断:亮点与保留意见
亮点在哪。
一是问题定义打得准。「成功轨迹≠有效监督」不是新直觉,但把它拆成组合覆盖和决策依据两个可认证、可操作的条件,并且给出量化证据(40.9%、10.0% 那两个数字),这是真功夫。二是 grounding 的决策级审计思路普适性很强——\(g_t = e_t \cdot v_t\) 这个分解,基本上可以直接搬进任何轨迹数据 pipeline 当过滤器用。三是父归一化的消融结果对所有做轨迹 SFT 的人都有直接参考价值,不管你用不用这套数据合成框架。
保留意见也要说。
一是整条 pipeline 依赖 teacher 模型和「认证」基础设施,论文对认证本身的成本和失败率着墨不多——认证器如果系统性偏向某类结构,支持库存的统计就会被污染。二是作者自己很诚实地声明:与公开 checkpoint 的对比不是等算力比较,不能跨方法做组件级归因。所以「超过 MUA-RL-32B」这类说法,当作参考而不是判决。三是全部实验基于 Qwen3 一个模型家族,跨家族泛化还是未知数;消融是单次运行,作者也承认一个 Tau2 Airline 任务就能让三基准均值波动 0.56 分,小幅增益(+2.32 这个量级)应视为方向性证据。
还有个小疑问:Live Simple 的退化虽然在预期内,但如果这套方法要落地,简单交互的保持可能需要显式的混合策略,论文没有给方案。
对工程的启发。
如果你在做工具调用 agent 的 SFT 数据,这三条结论可以直接拿走:成功只当门控、不当许可;真实错误留作上下文、不作目标;监督权重按语义轨迹归一、不按渲染行数。哪怕不造新数据,光是把现有轨迹池按「每条轨迹的监督决策数」「错误后恢复决策占比」重新体检一遍,大概率都会有惊人发现。
作者在结尾留的方向是把决策级认证扩展到 on-policy rollout 和 web、软件、终端 agent——如果 grounding 认证能在策略循环里实时跑,这套框架就从「数据工厂」升级成了「在线课程设计」,那是更有想象力的故事。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我