被 GRPO 挤下牌桌的 critic,这次真的回来了:S3AC 让 Actor-Critic 在长 CoT 推理上跑通 397B
你有没有发现一个挺反常的现象:这两年做推理模型的 RL 后训练,大家几乎人手一份 GRPO 系的 critic-free 配方,PPO 里那个经典的 critic(价值网络)反而没人敢用了。问起来理由都很一致——长思维链、稀疏奖励、策略一直在变,critic 根本学不准,训了也是白训,不如用组内相对优势省事。
但省事是有代价的。critic-free 方法的优势信号是整条响应共享一个标量,一道难题上失败和一道简单题上失败,受到的惩罚可能一模一样;响应内部哪个 token 立了功、哪个 token 带歪了方向,更是完全分不出来。上海 AI Lab 这篇 S3AC(arXiv:2610.35518)干的事情,就是把 critic 这条路从"理论上更好但工程上跑不通"的状态,拽回到"真的能打"的状态。
核心摘要:S3AC 先诊断出长 CoT critic 训练的两个真实死因——初始策略的轨迹里又长又对的样本太少(超过 24K token 的响应只有 5.0% 是对的),价值头预训练早期 99% 以上的梯度范数都来自那个新初始化的小头、把 backbone 的更新全给 clip 没了。对症下药的配方其实不复杂:混合多个强度策略的轨迹做覆盖式价值预训练、把价值头初始化压到 \(1/(H+1)\)、把 critic 的梯度裁剪阈值从 1 放宽到 10。训出来的 critic 一鱼两吃,既给 token 级 GAE 优势,又在生成前给提示级难度估计,驱动 DAPS 难度感知采样。效果上,1.5B 到 397B 四个模型全面超过强化版 GRPO-X,35B 单 rollout 场景 80.9 对 70.4 吊打 REINFORCE++ 十条街。我的判断:这不是底层理论突破,但它把 critic 路线最大的几个工程地雷挨个排掉了,对做 RLVR 基础设施的团队参考价值很高。
论文信息
- 标题:S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
- 作者:Shuo Shen、Guangran Cheng、Chengqi Lyu、Xiangsen Wang、Yanan Sun、Wenwei Zhang
- 机构:上海人工智能实验室(Xiangsen Wang 为独立研究者)
- 链接:https://arxiv.org/abs/2610.35518 (2026 年 10 月 26 日提交,17 页 14 图)
🎯 为什么 critic 在长 CoT 上一直立不起来
先把问题讲清楚。RLVR 的场景里,奖励只有最后那个 token 有(答案对 +1,错 -1),中间几千甚至几万个 token 全是白茫茫一片。这种情况下学价值函数 \(V_\phi(s_t)\),难处不在公式,在数据。
作者点出的第一个死因是轨迹长度覆盖不足。初始策略的采样分布是严重偏科的:短的、错的多,长的、对的少。论文里给了一个很扎眼的数字——在 Intern-S2-Preview-35B 上,长度超过 24K token 的响应里,初始策略采样只有 5.0% 是正确的,而训练到 1,600 步之后的策略,这个比例是 61.8%。你拿初始策略的轨迹去预训练 critic,它对"长且正确"这条流形几乎没见过,后面在线学习就要还这笔债。
第二个死因更隐蔽,是优化层面的:价值头是全新初始化的,critic 预训练早期的梯度几乎全被它霸占。论文实测,前 10 个 critic 更新步里,这个只有 2,048 个参数的线性头占了平方梯度范数的 99% 以上。道理不难懂——线性头 \(v_t = w^\top h_t\) 的梯度 \(\nabla_w \ell_t = e_t h_t\) 直接正比于 hidden state 的模长,而传回 backbone 的梯度 \(\nabla_{h_t} \ell_t = e_t w\) 要乘上那个很小的初始权重。如果你用 actor 训练常用的裁剪阈值 1 去做全局 clip,结果就是把 backbone 本来就小的梯度再往死里缩。作者的消融里,阈值 1 时 99.7% 的步数都在触发裁剪,基本等于 backbone 没在学。
说实话,这两个死因单拎出来都不算惊人发现,但把它们量化清楚、再配一套能抄作业的解法,就是这篇文章的价值所在。
🏗️ S3AC 的三块拼图
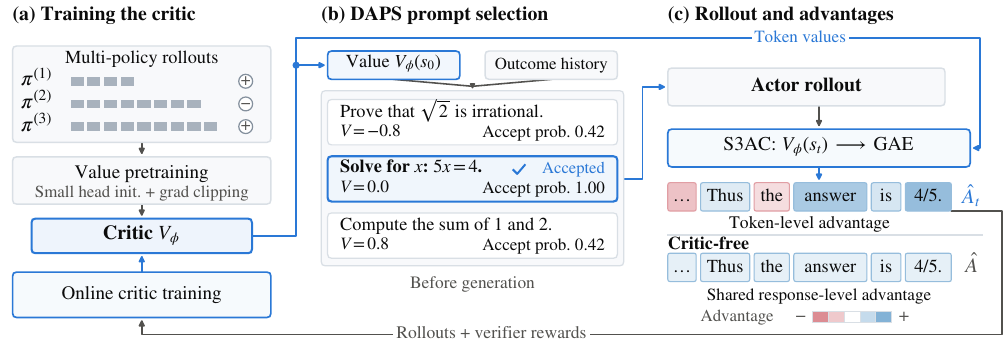
图1:S3AC 总览。(a) critic 先在多个强度策略的轨迹上做价值预训练(小初始化 + 放宽梯度裁剪),然后在线更新;(b) DAPS 用 critic 的初始状态价值 \(V_\phi(s_0)\) 结合历史对错记录在生成前选提示,比如"证明根号2是无理数"预测价值 -0.8(太难,接受概率 0.42),"解方程 5x=4"价值 0.0(中等难度,接受概率 1.00 被选中);(c) rollout 阶段 S3AC 用 token 级 GAE 优势,不同位置的 token 拿到不同的红蓝信号,而 critic-free 方法整条响应共享一个优势值。
整个框架分成三步:先把 critic 训好(Stabilized),再用 critic 挑题(Selective),最后 token 级优势驱动策略更新(Scalable 的部分体现在 1.5B 到 397B 都能跑)。
模型设定是标准的 token 级 MDP:状态 \(s_t\) 是提示加已生成的前 \(t\) 个 token,奖励只在终止 token 给 \(R \in \{-1, +1\}\),\(\gamma = 1\)。优势用 GAE 算:
Actor 端没有自己造轮子,用的是 MiniMax 的 CISPO——把 clipped importance ratio 和优势的乘积 stop-gradient 后当作 log-prob 的权重,再叠上 token 级重要性采样修正和序列级 mask 来处理训练-推理不一致。Critic 端则是向 Monte Carlo return 回归的 clipped 平方误差损失。这些都是成熟件,新意不在这里。
新意之一:覆盖式价值预训练
针对第一个死因,做法很直接:别只用初始策略的轨迹,把不同强度策略(比如训练早、中、晚期的 checkpoint)的 rollout 混在一起做预训练,让 critic 在开工前就见识过各种长度、各种对错结局的轨迹。预训练跑两个 epoch、token 平均 MSE,冻结 attention 层(沿用 SAO 的做法)并额外冻结 MoE router。
针对第二个死因,两招:价值头初始化标准差压到 \(1/(H+1)\)(\(H\) 是 hidden size),控制初始预测别乱跳;critic 的梯度裁剪阈值从 1 提到 10,让 backbone 的梯度能正常流过。
在线阶段则是 two-timescale 的思路:critic 学习率是 actor 的 5 倍,每个 rollout batch critic 更新两个 epoch、actor 只更新一个。GAE 参数 actor 和 critic 解耦(学 VC-PPO)——critic 用 \(\lambda_{\text{critic}} = 1\) 直接回归 MC return,actor 用 VAPO 的长度自适应 GAE:
响应越长,\(\lambda\) 越接近 1,越依赖真实回报而非 bootstrap——长轨迹上价值估计不准,少信它一点,这个设计挺合理的。
新意之二:DAPS,让 critic 顺便把选题的活也干了
这块是我个人觉得最划算的设计。critic 在 \(s_0\) 处的价值 \(V_\phi(s_0)\) 本身就是对"当前策略做这道题的预期回报"的估计,生成之前就能算出来。既然反正都训了,为什么不拿它来决定哪些题值得生成?
DAPS 的做法:把 \(V_\phi(s_0)\) 换算成成功率估计 \(p_c = \text{clip}((V_\phi(s_0)+1)/2, 0, 1)\),再和这题历史对错记录做贝叶斯式融合:
\(S\)、\(N\) 是这题历史上成功和总尝试次数,\(n_c\) 控制 critic 先验的权重。新题没有历史记录时,估计直接退化为 critic 的预测——这就是它相对 SPO、PCL 这些需要离线初始化难度统计的方法省事的地方,零额外模型、零离线 rollout。历史计数还随训练衰减,防止过期数据拖着估计不放手。
接受概率偏向中等难度的题:
\(\hat{p} = 0.5\) 时接受率最高,两头太难太简单的题也有 \(a_{\min}\) 保底,类似 \(\epsilon\)-greedy 留出探索余地。和 DAPO 的 dynamic sampling 比,关键差别是时机:dynamic sampling 是生成完才发现这组全对或全错、整组扔掉,算力已经花了;DAPS 在生成之前就把题筛了一遍,被扔的轨迹从源头就少了。
🔬 critic 给出的信号到底长什么样
方法讲完,先看两张"证据图",这是我觉得论文里最能说服人的部分。
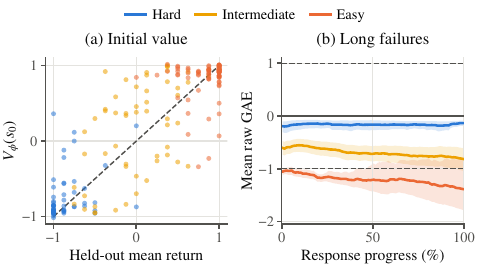
图2:35B 单 rollout 下 critic 学到的信号。(a) 每个提示一个点,\(V_\phi(s_0)\) 对 held-out 独立 rollout 的平均 MC 回报,散点基本沿对角线分布——critic 在生成前就能区分难题和简单题;(b) 同样是超过 20K token 的失败长轨迹(终止奖励全是 -1),难提示上的平均原始优势接近 0,简单提示上则明显低于 -1。同样是失败,"虽败犹荣"和"不该错的错了"被区分开来了。
图 2b 这个区分是 batch 统计类方法(REINFORCE++、FlashREINFORCE)给不出来的——它们的 baseline 是跨提示共享的,一道全班都会的题做错了,和一道全班都不会的题做错了,在这类方法眼里差别被严重稀释。

图3:一个具体案例里 critic 价值的逐 token 变化。响应前期价值一直在 -1 附近徘徊(模型在绕圈子),当推理在 A 处识别出候选值循环"1/5 → 2/5 → 4/5 → 3/5 → 1/5"、锁定候选集合时,价值跳升;在 B 处算出 2014 mod 4 = 2、确定答案为 4/5 时,价值进一步走高。token 背景色就是该前缀下的 \(V_\phi(s_t)\),GAE 把这些变化折成逐 token 的优势信号。
图 3 展示的是 token 级信用分配的直观形态:关键顿悟发生的那几步,价值曲线陡升,对应 token 拿到正优势;前面绕圈的部分则不被奖励。一条响应一个标量的 critic-free 信号,结构上就没法表达这种东西。
📊 实验:1.5B 到 397B,group 和 single 两条线都赢了
实验覆盖四个模型:稠密的 Qwen2.5-Math-1.5B 和 R1-Distill-1.5B,MoE 多模态的 Intern-S2-Preview-35B 和 Intern-S2-397B。Group rollout 下稠密模型每题采 16 条、MoE 采 8 条;single rollout 每题 1 条。基线是 GRPO-X(叠了 R3、GEPO 熵控制等现代补丁的 GRPO 强化版)、REINFORCE++ 和 FlashREINFORCE,同模型内共享 base checkpoint、训练数据和评测协议——这个对比设置算是干净的。
35B 主表(每个 run 取七基准平均最高的 checkpoint):
| 方法 | Rollout | AIME24 | AIME25 | GPQA-D | IMO-AnswerBench | MMMU-Pro | MathVision | MathVista | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| GRPO-X | group | 91.5 | 89.8 | 67.8 | 60.3 | 69.5 | 70.1 | 85.6 | 76.4 |
| S3AC | group | 93.1 | 91.3 | 74.9 | 67.5 | 74.6 | 75.4 | 86.7 | 80.5 |
| REINFORCE++ | single | 87.7 | 87.3 | 62.5 | 51.6 | 60.8 | 62.2 | 80.8 | 70.4 |
| FlashREINFORCE | single | 85.4 | 81.9 | 51.1 | 53.9 | 54.9 | 63.0 | 81.3 | 67.4 |
| S3AC | single | 91.9 | 90.0 | 76.1 | 66.8 | 78.1 | 76.0 | 87.8 | 80.9 |
几个值得多看两眼的点。一是 S3AC group 在七个基准上全部赢 GRPO-X,平均涨 4.1 个点,不是偏科。二是 S3AC single(80.9)居然比自家 group(80.5)还高一点,同时对 REINFORCE++ 的领先拉大到 10.5 个点——这和理论预期一致:group 场景里组均值已经提供了提示级 baseline,critic 的增量主要是 token 级优势;single 场景里 critic 连 baseline 都得一肩挑,价值更大。单 rollout 能做到这个水平,对推理算力紧张、开不起组采样的团队是实打实的利好。
397B 主表(梯度步 1,200 处):
| 方法 | GPQA-D | IMO-AnswerBench | MMMU-Pro | MathVision | HMMT26 | 平均 |
|---|---|---|---|---|---|---|
| GRPO-X | 88.9 | 81.4 | 80.8 | 87.5 | 86.9 | 85.1 |
| S3AC | 90.5 | 84.2 | 82.9 | 89.7 | 88.8 | 87.3 |
五个基准全胜,平均涨 2.2 个点。397B 这种规模上跑 actor-critic 还能稳住,说明那套预训练配方的可扩展性不是吹的。
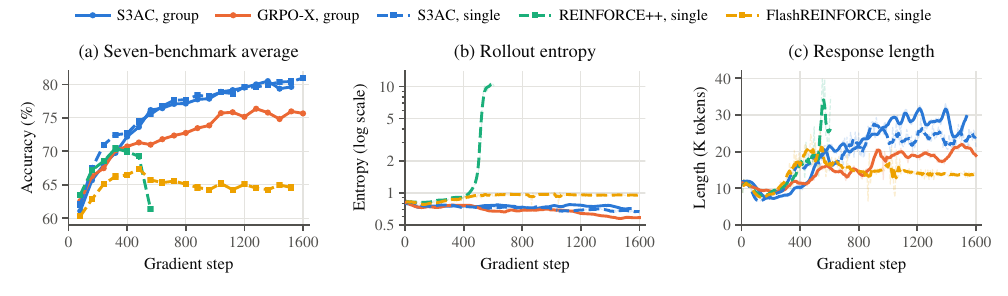
图4:Intern-S2-Preview-35B 的训练动态。(a) 七基准平均:S3AC(group 实线、single 虚线)一路涨到 80+,GRPO-X group 停在 75 附近,REINFORCE++ single(绿色)在 400 步左右冲高后崩溃,FlashREINFORCE single(黄色)在 65 上下横盘;(b) rollout 熵:REINFORCE++ 的熵爆炸到 10(log 尺度),是训练失控的直接证据;(c) 响应长度:REINFORCE++ 长度同步暴涨,FlashREINFORCE 则萎缩变短——两种典型的 critic-free 失效模式。
图 4 是全文最有戏剧性的一张。两个 single-rollout 的 critic-free 基线都是先甜后苦:REINFORCE++ 熵和长度一起爆炸然后崩掉,FlashREINFORCE 靠序列级信任域压着不炸,但代价是响应越来越短、分数阴跌。S3AC 的熵和长度曲线则一直很平静,1,600 步内分数守住不回吐。作者还在附录里给了末段统计:S3AC single 的 actor-target explained variance 有 0.67,说明 critic 对优势目标的解释力确实在线,不是摆设。
1.5B 小模型上结论一致:Qwen2.5-Math-1.5B 上 S3AC group 43.3 对 GRPO-X 的 42.7,single 43.0 对 REINFORCE++ 的 40.4、FlashREINFORCE 的 36.0;R1-Distill-1.5B 上 S3AC group 31.4 对 29.5。唯一的例外是 R1D single 上 S3AC(29.8)略输给 FlashREINFORCE(30.4),差了 0.6——作者没回避这个数,我注意到也没多解释,算是全胜战绩里的一个小缺口。
🔧 消融:两个死因,各自的对症药灵不灵
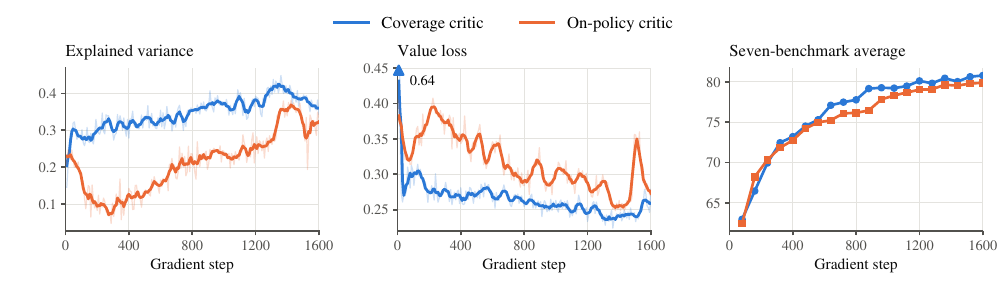
图5:coverage critic(混合多强度策略轨迹预训练)对 on-policy critic(只用初始策略轨迹)。左:在线训练早期 coverage critic 的 explained variance 明显更高(0.3+ 对 0.1 左右);中:价值损失全程更低(起点 0.45 对 0.64);右:同样的 actor 更新预算下,coverage critic 驱动的策略最终七基准平均更高。差距随在线适应收窄,但先发优势转化成了最终性能优势。
覆盖式预训练的价值在图 5 里很清楚:起点高、收敛快、终点也高。初始价值损失 0.45 对 0.64 这个差距,基本就是"见长正确轨迹"和"没见过"的差距。
初始化和裁剪的消融同样干脆。价值头初始化标准差从 0.01(已经小于 Xavier 默认)再压到 \(1/(H+1)\),前 20 步平均价值损失从 0.72 降到 0.45。裁剪阈值从 1 提到 10,触发裁剪的步数占比从 99.7% 降到 12.5%,而最终价值损失基本不变——既放开了 backbone 的学习,又留着对极端梯度的保险丝。
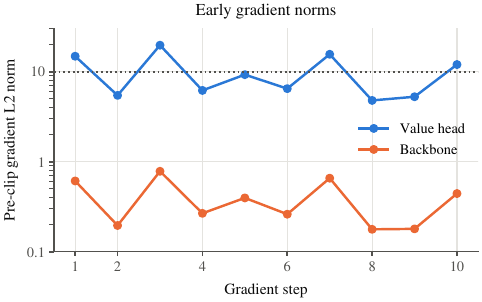
图6:35B 价值预训练前 10 步的梯度范数(log 尺度,裁剪后为分布式归约后、裁剪前测量)。蓝色价值头的 pre-clip 梯度 L2 范数在 5-15 之间,反复顶到虚线标记的裁剪阈值 10;橙色 backbone 梯度只有 0.2-0.9,差了将近两个数量级。如果阈值设成 1,backbone 的更新会被这个头的梯度拖累着一起缩没。
图 6 把"价值头主导早期梯度"这个诊断画得明明白白,是我觉得全文最有工程教学价值的一张图——下次你训任何带新初始化小头的模型(reward model、value model、各种 probe),遇到 backbone 学不动的情况,先查一下梯度范数分布,大概率是同款病。
DAPS 的消融(Table 5):
| 设置 | 提示×K | 步数预算 | Uniform | +DAPS |
|---|---|---|---|---|
| 35B group | 512×8 | 1,520 | 79.04 | 80.49 |
| 35B single | 4096×1 | 1,520 | 74.40 | 76.94 |
| R1D group | 256×16 | 1,024 | 30.87 | 31.08 |
| R1D single | 4096×1 | 1,024 | 30.16 | 30.36 |
35B 上提升明显(single 设置涨 2.5 个点),R1D 上只有 0.2 个点,聊胜于无。说实话 R1D 这个数字让我对 DAPS 的普适性打了个问号——1.5B 小模型的 critic 估计本身就糙,拿它选题的增益自然也糙,这个解释说得通但论文没展开验证。
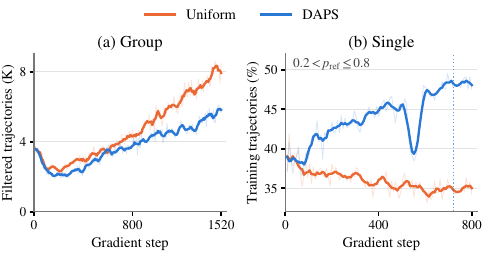
图7:(a) group rollout 下每个 batch 被 dynamic sampling 丢弃的轨迹数,训练后期 DAPS(蓝)比 uniform(橙)少扔约 3K 条——生成前筛选省下的都是真金白银的推理算力;(b) single rollout 下,DAPS 把训练份额持续倾斜到参考成功率 0.2-0.8 的中等难度题上(约 48% 对 uniform 的 35%),和接受规则的设计意图吻合。
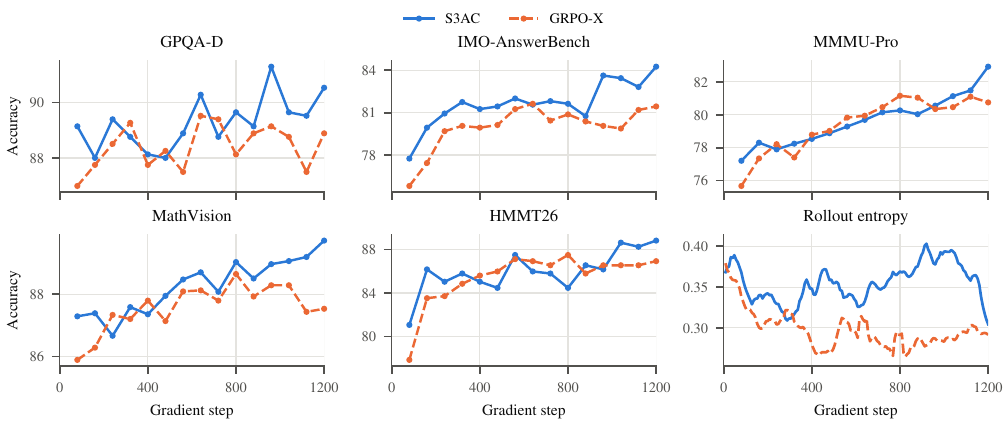
图8:Intern-S2-397B group rollout 的逐基准曲线。S3AC(蓝)在 GPQA-D、IMO-AnswerBench、MathVision、HMMT26 上后段都压住 GRPO-X(橙),MMMU-Pro 上交替领先;右下角的 rollout 熵曲线里 S3AC 维持在 0.3-0.4,高于 GRPO-X 的 0.3 以下,多样性保持得更好。
🤔 我的判断:值在哪,坑在哪
值钱的地方,按重要性排:
第一,它把"critic 在长 CoT 上训不动"从一句玄学抱怨变成了两个可测量、可修复的具体问题。99% 梯度被价值头霸占、99.7% 步数触发裁剪、>24K token 轨迹只有 5% 正确——这些数字每个做 RL infra 的人都该抄进自己的 debug 清单里。哪怕你不打算用 S3AC,下次 critic 训不动也知道往哪查。
第二,single-rollout 场景的稳定性是真稀缺。10.5 个点对 REINFORCE++ 的碾压,加上熵和长度曲线全程不失控,对算力受限、开不起 K=8/16 组采样的团队来说,这条路第一次显得能走了。
第三,DAPS 复用已有 critic 做选题,零额外模型零离线初始化,设计得很经济。dynamic sampling 生成完再扔和 DAPS 生成前就筛,后者在 35B 上省下的丢弃轨迹是肉眼可见的。
要打问号的地方:
一是开销。作者自己承认 S3AC 每个 actor 梯度步的摊销 wall time 比 GRPO-X 贵 27-40%——critic 要训练还要陪跑推理。benchmark 上多涨的两三个点能不能盖住三成的算力溢价,得看你的预算结构。论文按梯度步对齐比较是公平的,但按 wall time 对齐的话差距会缩水。
二是 DAPS 在 R1D 上几乎没增益,说明这套"靠 critic 估难度"的选题机制对 critic 质量本身很敏感。小模型上 critic 糙,选题就糙,这个传导链条论文没有量化分析。
三是评测全部集中在可验证奖励的推理任务(数学、科学、多模态),agentic 多轮、需要跨工具调用做信用分配的场景完全没碰,作者也坦承这是 open 的。另外 RL 训练的种子间方差没有系统报告——single-run 的曲线再漂亮,RL 的老读者都知道要留个心眼。
四是和同期工作的关系要客观看。VC-PPO 的价值预训练、VAPO 的长度自适应 GAE、SAO 的冻结 attention,S3AC 都直接拿来用了,它的增量在"诊断 + 组合 + 两处关键超参(初始化尺度和裁剪阈值)+ DAPS"。这不妨碍它是一篇好工程论文,但"复活 critic"的功劳簿上,前面这些工作得记一笔。
📝 收尾
如果你在做 RLVR infra,这篇论文的 actionable 程度很高:混合强度策略做价值预训练、价值头初始化压到 \(1/(H+1)\)、critic 裁剪阈值放宽一个数量级、critic lr 五倍于 actor——每一条都是可以这周就试的改动。如果你在纠结 single-rollout 的稳定性问题,S3AC 基本是目前公开方案里最能打的一个。
但更有意思的悬念是作者自己留下的那个:当 critic 足够好、好到能可靠估计每道题的难度时,"训什么题"和"怎么训"就开始合流了。DAPS 只是这个方向的第一步,课程学习式的 RL 数据调度后面估计还有得挖。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我