成功轨迹里 41.6% 的动作是废的,GRPO 还在给它们发奖金——ProAS 怎么把这笔糊涂账算清楚
训过多轮 Agent 的朋友大概率遇到过这种憋屈事:ALFWorld 任务跑完了,轨迹成功了,reward 到手了,GRPO 高高兴兴地把正优势广播给轨迹里每一步。但你把轨迹拉出来一看,中间明明夹着一堆原地打转、反复查看同一个物体的废动作——它们也吃到了同样的正反馈。下一次 rollout,这些废动作被强化得更理直气壮。
这不是猜测。这篇论文给出的数字相当扎心:Qwen2.5-1.5B 用 GRPO 训出来的成功轨迹里,不合理动作占比在 ALFWorld 上高达 41.6%,WebShop 上也有 39.6%。接近一半的动作是混子,却和真正推进任务的动作拿一样的奖励。
核心摘要:ProAS(Progress-Aware Advantage Shaping)做的事情一句话能讲完——给 GRPO 这类 critic-free 方法的"均匀信用分配"做一次按步算账。它维护一张随训练动态演化的 Agentic Reference Graph(ARG),把成功轨迹抽象成子目标 DAG,用图来判定每个动作是"合理且推进"、"合理但原地踏步"还是"纯错误",然后非对称地重塑优势:成功轨迹里把不合理动作的奖励直接置零(MUI),失败轨迹里按"下游拖累程度"给早期肇事动作加重惩罚(APR)。结果:ALFWorld 成功率峰值 94.3%(7B)、WebShop 70.8%,收敛速度最高加快 2.44 倍,而且不用训 critic、不用训奖励模型。我的判断:这是近期 agentic RL 信用分配方向里少见的"诊断做得比疗法还扎实"的工作,即插即用属性对工程落地很友好,但对 ARG 初始化的依赖是真实存在的门槛。
📖 论文信息
- 标题:ProAS: A Progress-Aware Advantage Shaping Framework for Multi-Turn Agentic Reinforcement Learning
- 作者:Bowen Ding, Mingda Wan, Yuhan Chen, Jiyao Yuan, Qi Zhu, Futing Wang, Heyuan Deng, Fei Mi, Lifeng Shang, Tao Lin
- 机构:浙江大学、西湖大学、西湖大学先进研究院、华为诺亚方舟实验室
- arXiv:https://arxiv.org/abs/2610.18683 (v1 2026-10-13,v2 2026-10-25)
- 代码:https://github.com/LINs-lab/ProAS
🎯 问题动机:均匀信用分配这笔糊涂账
先把 GRPO 的账本摊开看。GRPO 对同一 prompt 采样 \(G\) 条轨迹,用组内归一化算轨迹级优势:
然后在优化目标里,这个标量 \(A_i\) 被乘到轨迹 \(\tau_i\) 的每一个 token 上。on-policy 设定下,重要性比率 \(\rho_{i,t} \equiv 1\),clip 指示函数也是 1——于是同一条轨迹里所有步骤的梯度被同一个标量无差别驱动。第一步的精妙探索和第四十七步的原地打转,待遇完全一样。
这就是所谓的均匀信用分配困境(uniform credit assignment dilemma)。论文没有停留在吐槽层面,而是做了两组干预实验把病灶钉死,这也是我觉得全文最漂亮的部分。
病灶一:成功轨迹里的不合理动作被真金白银地强化。 作者的探针实验是这么设计的:固定一个环境状态(agent 在 desk 1、手里持有 keychain 2、还剩 47 步预算),然后往可见历史里注入 4 步不合理动作——注意,这些动作没有真的执行,只是污染上下文。接着从这个状态各采样 50 条后续轨迹。干净对照组的成功率(ESR)是 82%,注入噪声后掉到 58%。你想想看,仅仅是"历史里出现过几步废动作",就把成功率打掉 24 个点。而 GRPO 恰恰在不断强化这些废动作——等于训练过程在系统性地给自己的上下文下毒。
病灶二:失败轨迹里的均匀惩罚不公平。 失败轨迹里,不推进动作(NA,non-advancing)高度集中:ALFWorld 上占 93.1%。但由于自回归特性,后期的废动作往往是早期某步错动作污染上下文的必然结果——真正的罪魁在前面,均匀惩罚却把所有步骤各打五十大板。作者定义了一个 Future-Drift(FD) 指标:从第 \(t\) 步开始(含本步)的下游不推进动作总数
然后做反向验证:在同一条失败轨迹里,分别强制抑制 FD 等于 47、23、11、4 的动作,重采样 50 条后续,恢复后的成功率分别是 24%、16%、10%、0%——严格单调。被抑制动作的 FD 越大,agent 越容易起死回生。因果链很清楚了:早期高 FD 动作才是失败的根因,均匀惩罚完全搞反了轻重。
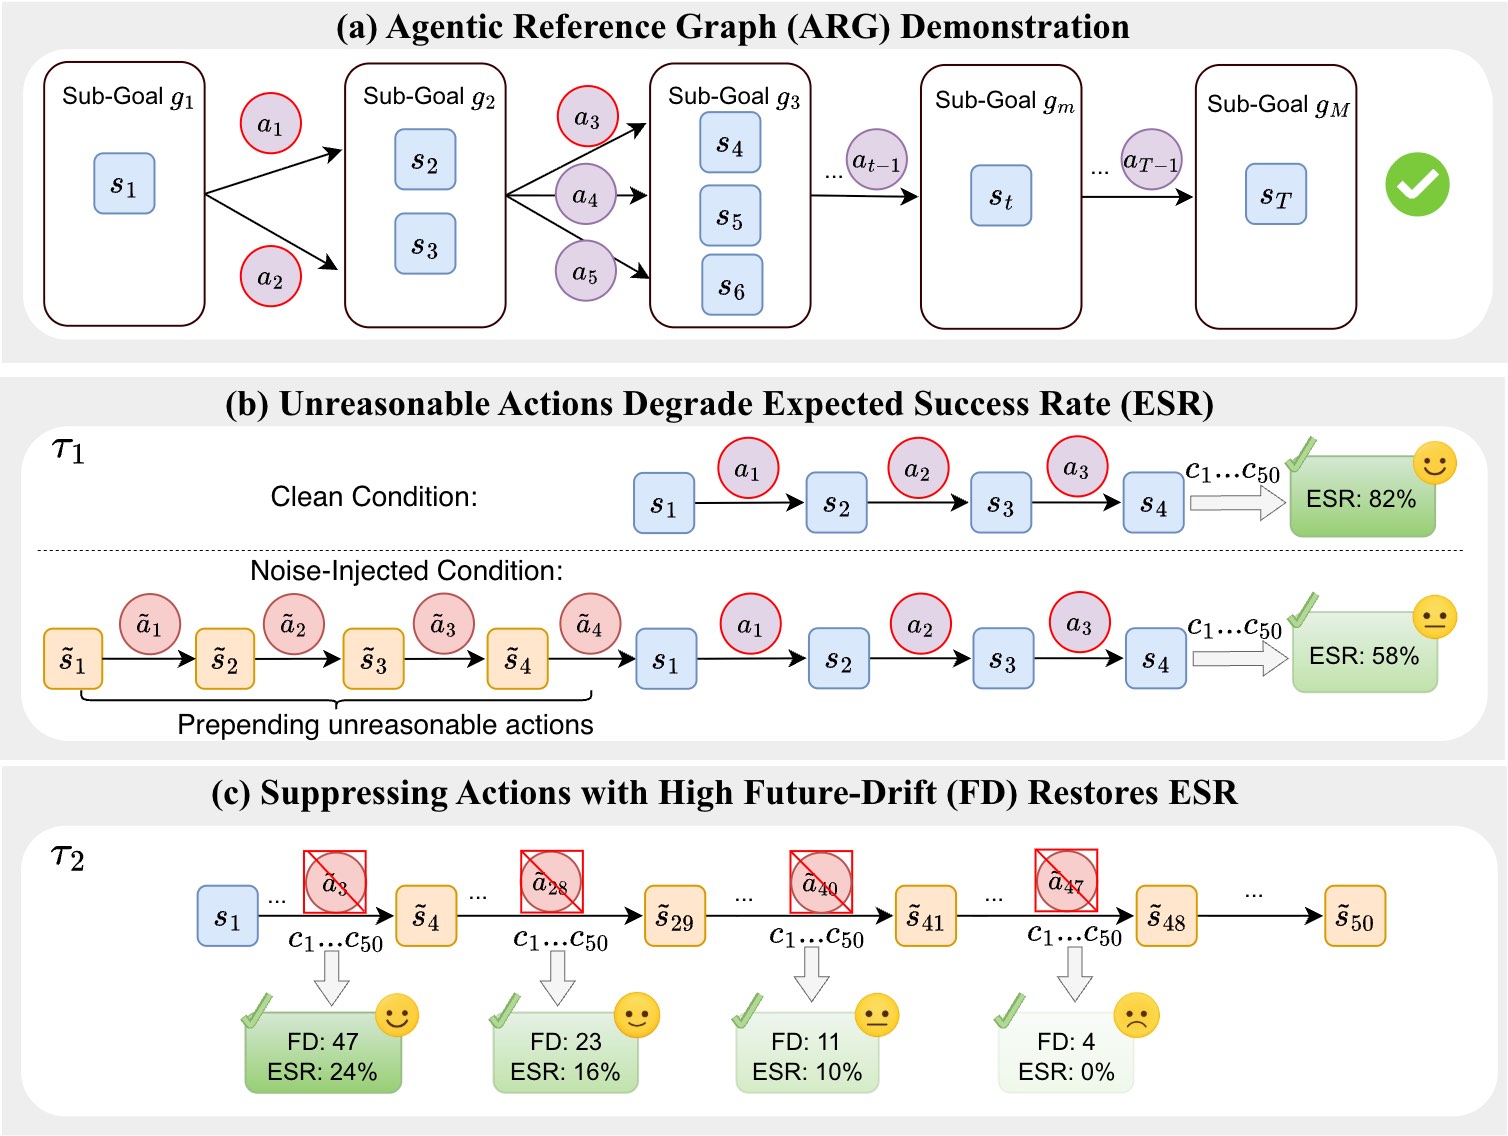
图1:论文的"题眼"。(a)Agentic Reference Graph 把多条成功轨迹统一成子目标 DAG,作为进度参照系;(b)污染探测实验——干净历史 ESR 82%,注入 4 步不合理动作后跌到 58%;(c)按 Future-Drift 抑制动作——抑制 FD=47/23/11/4 的动作后,恢复 ESR 分别为 24%/16%/10%/0%,单调关系坐实了"早期肇事、后期背锅"的因果结构。
🧠 方法核心:一张会生长的图 + 两把非对称手术刀
一句话直觉:ProAS 给每条轨迹配了一张"进度参照图",每个动作拿多少优势,先看它在图上是推进、踏步还是犯错,再分正负两种情况分别处理。
ARG:把成功轨迹压成一张子目标 DAG
Agentic Reference Graph 是一个有向无环图 \(\mathcal{G} = (\mathcal{V}, \mathcal{E})\),把任务求解抽象成 \(M\) 个有序子目标:
- 顶点是子目标:\(\mathcal{V} = \bigcup_{m=1}^{M} \mathbf{g}_m\),每个子目标 \(\mathbf{g}_m\) 是一组排列不变的有效状态的无序集合。这个设计很务实——比如 WebShop 里选 size 和选 color 的先后顺序根本不重要,把它们建在同一子目标里,就不会对合法的排列差异乱开罚单。
- 边是动作:\(\mathcal{E}\) 刻画相邻子目标间在合法动作下的确定性转移 \((s, a, s')\)。
- 图保持纯净:无效转移和自环一律剪掉。
初始 ARG 来自预先收集的成功轨迹:ALFWorld 用官方众包标注(任务有严格顺序性,每步一个子目标),WebShop 用官方标注的子目标。
关键在动态演化。训练第 \(k\) 轮,只要 rollout 产生了经过环境验证的新成功轨迹,就先纯化、再把新状态新边并进图里:
为什么必须演化?论文附录给了个例子:ALFWorld 里"Look at a pencil"任务,pencil 1 和 pencil 2 都是有效解,静态 ARG 只覆盖其中一条的话,另一条合法路径会被误判成"不合理"。图随训练生长,覆盖面才跟得上 policy 的探索。消融实验也证实这点:禁用演化后 ALFWorld 成功率从 87.0% 掉到 82.8%。
有了图,每个动作就能打两个标签。合理性:\(\text{Rea}_t = \mathbb{I}[(s_t, a_t, s_{t+1}) \in \mathcal{E}^{(k)}]\),转移在图里才算合理。推进性:\(\text{PA}_t = \text{Rea}_t \cdot \mathbb{I}[s_{t+1} \in \mathcal{V}^{(k)} \setminus \mathcal{S}_{\le t}]\),得到达一个此前没访问过的有效状态才算推进。于是动作分三类:\((1,1)\) 合理且推进、\((1,0)\) 合理但原地打转、\((0,0)\) 图不支持的显式错误。这个细粒度区分是后面一切操作的基础。
MUI + APR:一张一弛的非对称重塑
核心的优势重塑公式(式 7)长这样:
拆开看就是两把手术刀,对应前面两个病灶:
MUI(Masking Unreasonable Incentives):成功轨迹(\(A_i \gt 0\))里,不合理动作的优势直接置零——不奖励,但也不惩罚(它毕竟是成功轨迹的一部分)。这直接掐断"废动作吃正反馈"的通道。
APR(Asymmetric Penalty Redistribution):失败轨迹(\(A_i \lt 0\))里,惩罚按归一化 Future-Drift 重新分配,\(\bar{\mathcal{D}}_i\) 是共享优势步集合 \(\mathcal{T}\) 上的平均 FD。FD 大的早期肇事动作吃更重的罚单,后期被动背锅的动作惩罚减轻。注意重分配是保持总惩罚量不变的——只是把钱从冤大头身上挪到肇事者头上,设计相当克制。
这个"正侧掩码、负侧重分配"的非对称结构,说实话我觉得是全文最精巧的一笔。它背后的判断很清醒:成功轨迹的问题是"别让混子分奖金",失败轨迹的问题是"别让无辜者顶罪",两个问题的药方本来就不该一样。
📊 实验:三个 baseline 全面抬升,收敛快最多 2.44 倍
实验在 ALFWorld(6 类 embodied 任务)和 WebShop(网页购物)两个 benchmark 上跑,模型用 Qwen2.5-1.5B-Instruct 和 Qwen2.5-7B-Instruct,ProAS 以插件形式叠加在 GRPO、DAPO、GiGPO 三个 group-based baseline 上。所有数字是 3 个种子的均值 ± 样本标准差。
主结果
| 方法 | ALFWorld SR(1.5B) | ALFWorld SR(7B) | WebShop SR(1.5B) | WebShop SR(7B) |
|---|---|---|---|---|
| GPT-5.6-Sol (ReAct) | 78.9 | 78.9 | 21.9 | 21.9 |
| SFT | 79.7±0.8 | 79.9±0.5 | 64.3±3.0 | 70.1±0.9 |
| PPO | 73.2±4.3 | 83.6±4.1 | 55.2±6.6 | 66.7±4.3 |
| MiGPO | 91.1±1.6 | 91.9±1.2 | 53.6±1.8 | 67.2±3.1 |
| GRPO | 70.3±2.8 | 80.7±3.9 | 57.0±3.1 | 67.7±5.5 |
| GRPO+ProAS | 87.0±2.3 | 89.1±2.3 | 64.6±1.2 | 70.8±0.9 |
| DAPO | 82.3±5.0 | 88.8±5.2 | 57.3±4.6 | 68.8±4.7 |
| DAPO+ProAS | 86.5±1.2 | 89.6±2.0 | 66.7±1.2 | 70.6±0.9 |
| GiGPO | 90.1±0.5 | 93.8±2.1 | 64.3±3.9 | 70.3±1.6 |
| GiGPO+ProAS | 91.9±0.5 | 94.3±2.4 | 66.7±3.2 | 70.1±2.3 |
表1:主实验结果(成功率 %,三个种子)。ProAS 对三个 baseline 几乎全部正提升,峰值 ALFWorld 94.3%(GiGPO+ProAS,7B)、WebShop 70.8%(GRPO+ProAS,7B)。
几个值得说的数。提升最猛的是 GRPO+ProAS:1.5B 的 ALFWorld 从 70.3% 拉到 87.0%,涨了 16.7 个点——GRPO 恰是均匀分配病最重的方法,药效也最明显,逻辑自洽。ALFWorld 7B 上 GiGPO+ProAS 的 94.3% 比 GPT-5.6-Sol 高 15.4 个点。WebShop 1.5B 上 GiGPO+ProAS 比专门做里程碑分配的 MiGPO 高 13.1 个点。
但也要客观说:不是每个格子都在涨。7B WebShop 上 GiGPO+ProAS(70.1±2.3)相比裸 GiGPO(70.3±1.6)基本持平甚至略降,DAPO+ProAS 的 70.6 对比 68.8 也只是小幅提升且方差有重叠。WebShop 的天花板似乎就在 70 附近,ProAS 在这个任务上的边际收益明显小于 ALFWorld——毕竟 ALFWorld 步数上限 50、WebShop 只有 15,轨迹越长,信用分配的空间越大。这个规律本身倒是印证了论文的问题设定。
消融:两把刀缺一不可,图必须干净且在生长
优势重塑侧的消融(1.5B + GRPO,ALFWorld ALL):
| 变体 | ALFWorld SR | 相对完整 ProAS |
|---|---|---|
| 完整 ProAS | 87.0±2.3 | – |
| 禁用 MUI(ProAS−) | 71.6±10.4 | 降 15.4 个点 |
| 禁用 APR(ProAS+) | 83.3±1.8 | 降 3.7 个点 |
| 朴素掩码替代 APR | 72.9±2.4 | 降 14.1 个点 |
| 后缀长度替代 FD | 81.5±2.0 | 降 5.5 个点 |
| 改成奖励塑形(PR) | 72.9±2.3 | 降 14.1 个点 |
表2:优势重塑消融。MUI 的贡献比 APR 更大;用"距轨迹末尾的朴素后缀长度"替代 FD 会掉 5.5 个点,说明 FD 度量的是结构性的下游拖累而非简单的位置先验。
说实话有个细节让我多看了两眼:禁用 MUI 后方差飙到 ±10.4,训练明显不稳——混子动作不被掐掉,policy 会被随机强化的废动作带得忽左忽右。另外"改成奖励塑形"掉 14.1 个点这个结果挺重要:同样的信息,注入奖励侧远不如注入优势侧。奖励塑形会污染组内归一化的 baseline 估计,优势重塑则保持了 critic-free 的纯净性——这对工程选型是个直接的启示。
ARG 侧的消融同样有说服力:随机标注直接崩到 47.7%(比裸 GRPO 还惨,错误的图比没有图更糟);砍掉 40% 的图还有 77.3%,仍比裸 GRPO 高 7 个点;甚至用 7B 模型蒸馏出来的 ARG(覆盖 2,566 个任务)也能拿到 83.6%。结论:图的质量重要,但框架对不完美图的容忍度不错——这点对落地很关键,因为你很难一上来就有完美标注。
收敛加速与开销
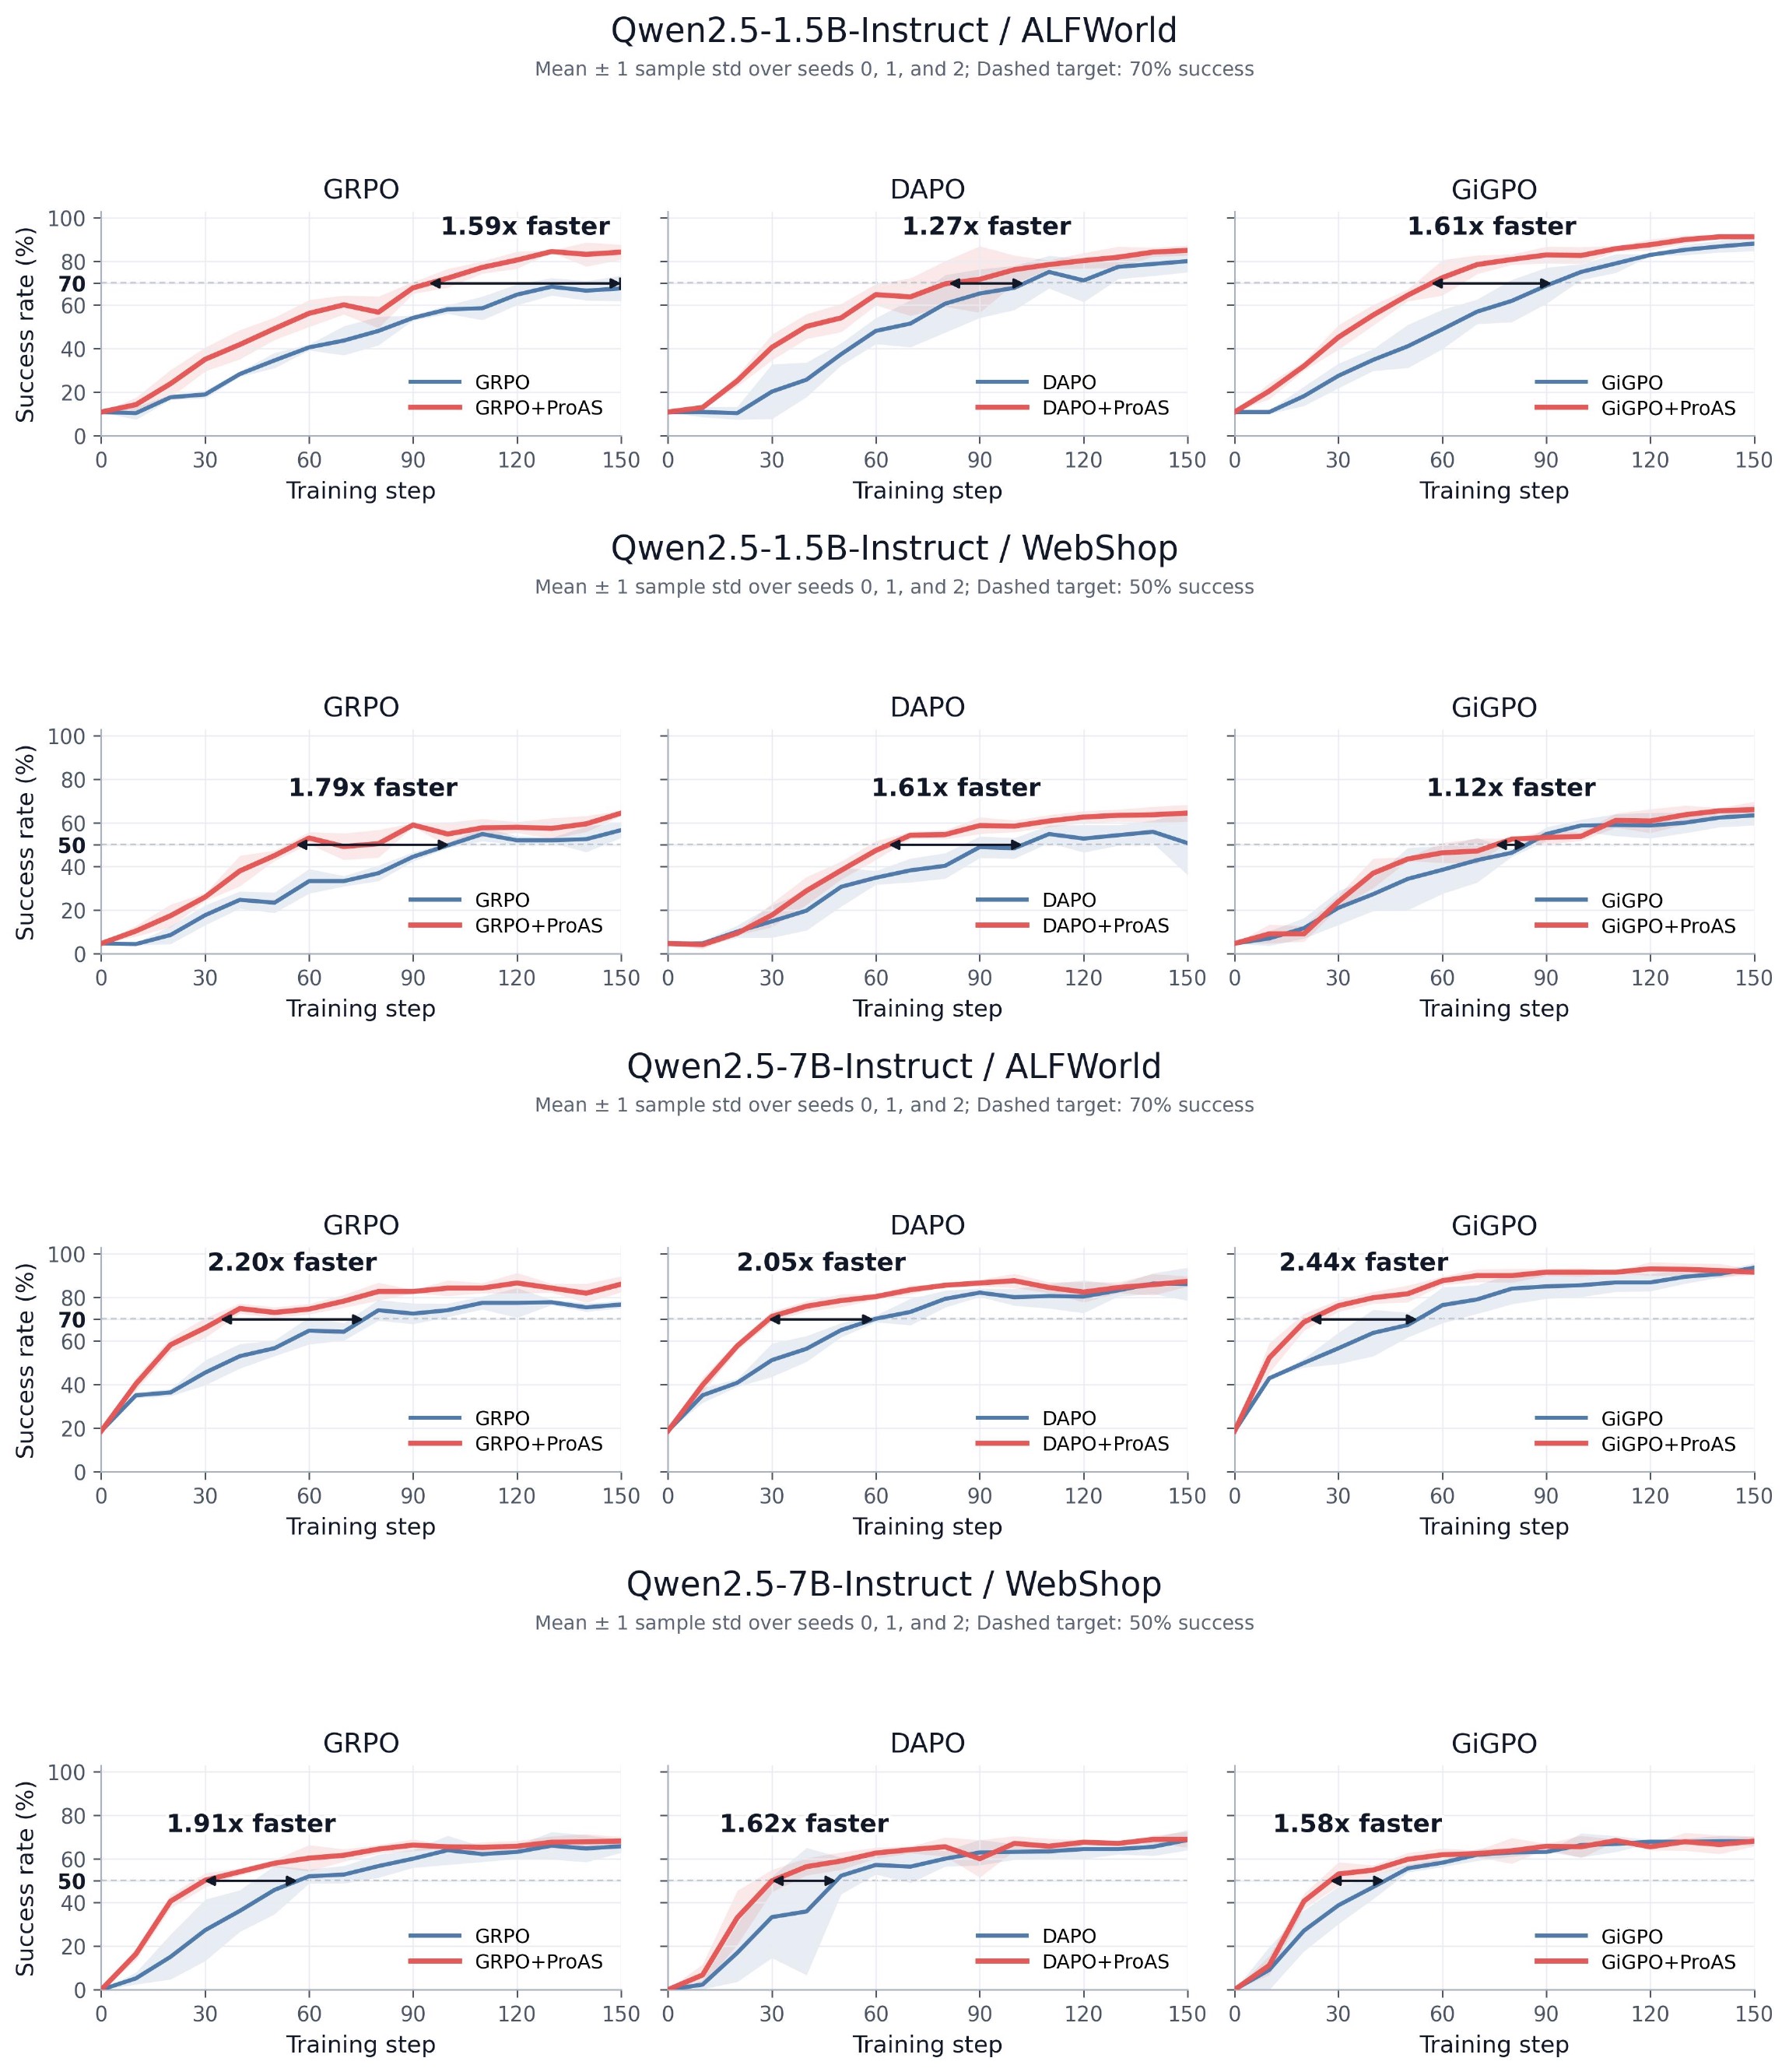
图3:四行两列(两种模型 × 两个任务)各三个算法的训练曲线。红色(+ProAS)几乎在所有子图里都压在蓝色上方,黑色双箭头标注达到目标成功率(ALFWorld 70%、WebShop 50%)的加速比,7B ALFWorld 的 GiGPO+ProAS 达到全场最高的 2.44×。
加速比的定义是 baseline 与 ProAS 首次达到目标成功率所需 RL 步数之比。整体规律:模型越大,加速越明显——7B 上 ALFWorld 平均约 2.2 倍(GRPO+ProAS 2.20×、GiGPO+ProAS 2.44×),1.5B 上约 1.5 倍。直觉上说得通:大模型探索空间更大,废动作的分布更广,细粒度信用分配省下的试错就更多。
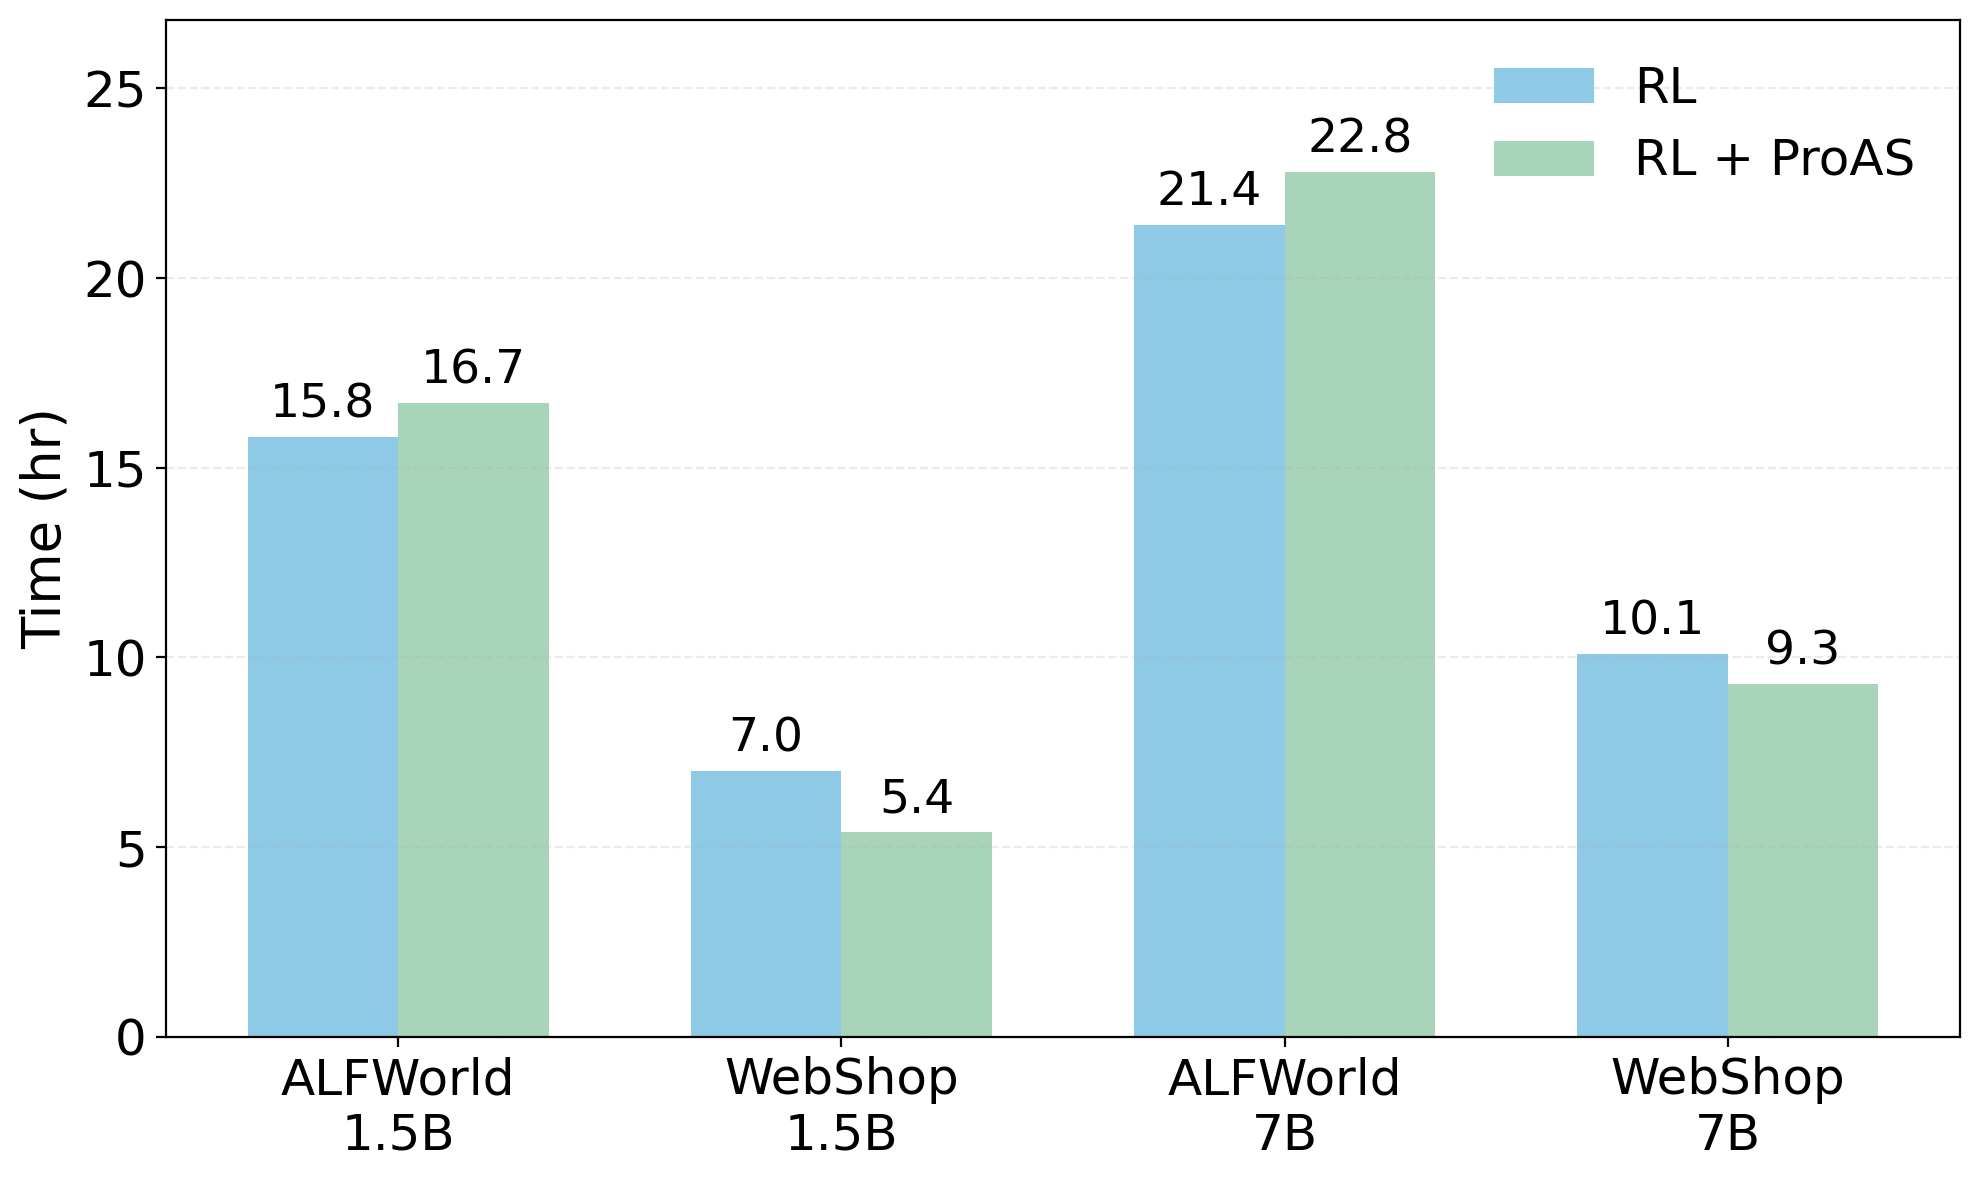
图2:挂钟时间(小时)。ALFWorld 上 ProAS 略增开销(1.5B 15.8→16.7 小时,7B 21.4→22.8 小时),WebShop 上反而更快(1.5B 7.0→5.4 小时,7B 10.1→9.3 小时)。
开销这块值得给个好评。ProAS 不训 critic、不训奖励模型,额外成本只有 ARG 的查询更新和逐步标注。WebShop 上加 ProAS 后训练时间反而下降——收敛快、无效 rollout 少,省下的环境交互时间超过了图操作的开销。ALFWorld 因为轨迹长、标注成本高,有 5-7% 的时间增加,可以接受。
🔬 我的判断:诊断一流,疗法务实,但别忽视 ARG 这道门槛
这篇论文最值钱的地方,我的看法不是那个 94.3%,而是两组干预实验。把"均匀信用分配有害"从直觉变成因果——注入废动作历史 ESR 掉 24 个点、按 FD 抑制动作恢复率严格单调——这种"先做实证诊断再开药方"的写法,比一堆上来就堆方法的 agentic RL 论文扎实得多。41.6% 这个数字应该会被后续工作反复引用。
方法本身属于"结构先验 + 优势整形"路线,跟同期 GiGPO(步级折扣优势)、MiGPO(里程碑匹配)是同一战壕的。ProAS 的差异化在于参照物不是手工折扣因子或启发式里程碑,而是一张从成功轨迹里长出来的、经过环境验证的图——先验更硬,误判更少。MUI/APR 的非对称设计也比 GiGPO 的对称整形更贴合两类错误的成因差异。
但门槛得说清楚:ARG 从哪来? 论文答案是官方标注(ALFWorld 众包、WebShop 子目标标注)或 7B 模型蒸馏。也就是说,这套方案默认你已有相当规模的成功轨迹或标注体系——对没有标注的新环境,冷启动问题真实存在。蒸馏消融(83.6% vs 完整图 87.0%)说明可行但有损。另外实验只在 ALFWorld 和 WebShop 两个状态结构清晰、转移确定性的环境里验证,碰到状态难以离散化、转移带随机性的场景(比如真实网页操作、代码执行),ARG 的"状态等价类"建法是否还成立,论文没有回答。这是我读完全文最大的疑问。
工程上的启发倒是立竿见影:
- 如果你在用 GRPO 类方法训多轮 Agent,先去统计一下成功轨迹里废动作的占比——这个诊断零成本,数字大概率会让你不适。
- "优势侧整形优于奖励侧整形"的消融结论有普适性,改 reward 之前三思。
- 没有图也有降级方案:APR 的核心只需要一个"下游拖累度"的估计,哪怕用启发式近似(论文里的 suffix 变体都有 81.5%,比裸 GRPO 高 11 个点)。
信用分配是 RL 里最古老的问题之一,从 TD 到 hindsight 到 PRM,每代方法都在回答同一个问题:这笔账到底记谁头上。ProAS 给出的答案谈不上终极——它把问题转化成了"如何维护一张好图"——但在 critic-free、即插即用这两个约束下,这是目前我看到的最干净的解法之一。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我