DynaFlow:让主 Agent 自己写"编排程序",多智能体协作不用再画死流程图
做过多智能体系统的人大概率踩过这个坑:你精心设计了一套固定工作流——先检索、再求解、再验证——上线后发现简单问题被这套流程拖慢,复杂问题又嫌这套流程不够用。流程画死了,任务却是活的。
上周刷到的这篇 DynaFlow(arXiv:2610.34467)给了一个挺干脆的思路:别预设协作结构了,让主 Agent 把"写工作流"当成一个动作,需要协作时现场合成一段可执行的 JavaScript 程序去调度子智能体。说实话我第一反应是"这不就是把 orchestration 塞进 action space 吗",但看到实验数据的时候我愣了一下——Forced 模式下六个基准平均 88.08%,比同 backbone 最强基线高出 10.90 个百分点,90 道 AIME 题目全对。这个数很能打。
更让我觉得有意思的是它的训练策略:只用 SFT 蒸馏轨迹训练主 Agent,所有子智能体全程冻结。也就是说,它把"编排能力的学习"和"执行能力的提升"干净地切开了——涨的点全部来自编排,不掺水分。
核心摘要:DynaFlow 解决的是多智能体系统依赖预定义协作结构、无法适配多样任务的老问题。它把自由形式的可执行工作流合成(顺序/并行执行、结构化信息交换、验证)集成进主 Agent 的动作空间,主 Agent 自己决定何时协作、生成任务专属程序,执行结果和轨迹回流指导后续决策。训练上只做两阶段 SFT:先蒸馏教师轨迹,再用 LLM judge 过滤掉有前提注入、验证缺陷、信息流缺陷的样本(2254 条里只留 712 条)。在数学推理、科学问答、多跳检索共六个基准上,Forced 模式拿到 88.08% 的 overall 准确率。我的判断:这不是底层算法突破,而是把"编排即可学习动作"这件事做扎实了的工程范式,但它揭示的"跨阶段信息流是多智能体编排的关键维度"这个洞察,值得每个做 Agent 系统的人看看。
📖 论文信息
- 标题:DynaFlow: Learning Free-Form Multi-Agent Orchestration
- 作者:Ruhao Liu、Qi Li(共同一作)、Shizun Wang(项目负责人)、Xinchao Wang(通讯作者)
- 机构:National University of Singapore
- 发表:2026 年 10 月 25 日提交,arXiv:2610.34467v1 [cs.MA]
- 链接:https://arxiv.org/abs/2610.34467
- 代码:github.com/amiya-special/Dynaflow
🎯 问题动机:固定工作流的天然缺陷
多智能体系统的效果,说到底取决于协作的组织方式。而不同任务对协调的需求差异极大:一个简单查询可能一个智能体就够了;几个独立子任务适合并行;有依赖关系的阶段则必须可靠地拿到上游结果。
现有方法在这个问题上都有点"瘸":
| 方法 | 做法 | 局限 |
|---|---|---|
| DyFlow | 利用执行反馈修订计划 | 只能从有限的算子模板集合里搭计划 |
| MAS-Orchestra | 通过函数调用做编排 | 单次决策生成完整协调结构,看不到中间执行结果 |
| 传统固定工作流 | 预设角色和通信模式 | 结构僵化,带来不必要的通信、延迟和计算 |
作者想要的能力叫 Free Orchestration(自由编排):主 Agent 自己判断什么时候需要协作,并且在求解过程中动态构建任务专属的工作流。这里的关键词是"过程中"——不是开局拍脑袋定一个结构跑到底,而是执行一段、看结果、再决定下一步怎么编排。
这个动机我觉得是成立的,不是伪命题。之前做 Agent 项目的时候我们也碰到过类似情况:写死的 pipeline 在分布内的任务上跑得不错,一旦任务形态偏一点,整个链路就开始互相拖累。
🏗️ 方法核心:工作流合成就是一个动作
一句话讲清核心 idea:主 Agent 的动作空间里除了工具调用和最终答案,还多了一类动作——生成并执行一段 JavaScript 工作流程序。
形式化地说,主 Agent 的策略 \(\pi_\theta\) 定义在三种动作形式上:
其中 \(\mathcal{A}_{tool}\) 是普通工具调用,\(A_{ans}\) 是最终答案输出,\((P, W(P))\) 就是工作流动作——主 Agent 合成程序 \(P\),再通过工作流工具 \(W\) 调用执行。
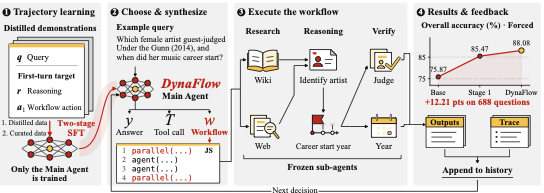
图2:DynaFlow 的四步循环。(1) 轨迹学习——两阶段 SFT 只训练主 Agent 的首轮推理 r 和工作流动作 a₁,蒸馏演示加精选子集,子智能体不训练;(2) 选择与合成——面对示例查询"Under the Gunn (2014) 哪位女艺术家客串过、她的音乐生涯何时开始",主 Agent 在直接作答、工具调用、生成工作流三者中选择,图中给出一段并行调度 Wiki/Web 检索的 JS 程序;(3) 执行工作流——冻结的子智能体按程序分工(Research/Reasoning/Verify)协作;(4) 结果回流——输出和执行轨迹追加到历史,指导下一轮决策。右上角小图显示 Forced 模式从 Base 的 75.87 一路涨到 Stage 2 的 88.08,提升了 12.21 个点。
程序 \(P\) 通过一组原语定义子智能体的角色、阶段和依赖:
agent(prompt, options):启动一个子智能体,可以用 JSON schema 要求结构化输出parallel(thunks):并发执行多个独立调用pipeline(items, stages...):对多个项目跑依赖阶段phase(title):阶段标签,方便追踪
有几个设计细节值得留意。独立的调用并行跑,有依赖的调用显式接收上游输出;每个子智能体只拿到程序指定的指令和输入,不会自动继承主 Agent 的历史——这一点其实很关键,它强迫主 Agent 在写程序时就把信息传递设计清楚,上下文给少了下游就直接抓瞎。工作流执行完返回输出加每个子智能体调用的状态轨迹,而主 Agent 在调用工作流后被限制为只做协调和总结,实质性求解委托给子智能体。这个"委托协议"防止了主 Agent 既当裁判又当运动员。
训练:只训主 Agent,而且只用首轮轨迹
训练分两个阶段,全部基于 Qwen3.5-27B 的 4-bit NF4 QLoRA:
Stage 1 是轨迹蒸馏。教师模型(GLM-5.3 Max)用同样的工作流接口、工具和冻结子智能体生成轨迹,只保留最终答案正确且遵守委托协议的样本。监督目标是首轮推理 \(r\) 和工作流动作 \(a_1\),损失函数很标准:
指令、问题、工具定义部分被 mask 掉。
Stage 2 是高质量筛选,这是我觉得全文最值钱的部分。作者用 LLM judge(deepseek-flash)检查三类缺陷:
- 前提注入(Premise injection):主 Agent 把任务给定条件之外的、直接决定答案的论断当作既定前提塞进程序——相当于偷偷给子智能体剧透答案
- 验证缺陷(Verification defects):审查指令或输出约束把验证者往预期答案上引,或者限制了独立检查和修正的空间——验证流于形式
- 信息流缺陷(Information-flow defects):缺失上下文、错误引用、有损传递、硬编码替代上游输出——信息到不了下游智能体手里
每条报告的缺陷都必须有程序或启动参数中的匹配摘录支持,不是 judge 随口说了算。最终从 2254 条含工作流的演示里只保留了 712 条(HotpotQA 449 条 + BrowseComp 263 条),从 Stage 1 的 checkpoint 继续以小学习率训练。
| 训练配置 | Stage 1 | Stage 2 |
|---|---|---|
| 训练样本 | 2,257 | 712 |
| 学习率 | 5×10⁻⁵ | 1×10⁻⁵ |
| Epochs | 2 | 2 |
| LoRA rank / α / dropout | 16 / 32 / 0 | 同左 |
| 有效 batch size | 4 | 4 |
| 最大序列长度 | 67,584 | 同左 |
算力开销不算夸张:2 张 H100 80GB,Stage 1 约 52 GPU 小时,Stage 2 约 17,总共 69 GPU 小时。
等等,这里有个地方要提一句:正文 §4 写 Stage 1 数据量是 2,031 条,附录 C 写 2,257 条,两处数字对不上。不是什么大问题,但说明论文校对还有提升空间。
推理时的三种模式
- Direct:不用工具和工作流,直接回答
- Dynamic:第一个决策在直接回答和调用工作流之间自由选择
- Forced:第一个实质性动作必须调用工作流——专门用来剥离路由决策、纯看工作流构建能力
Dynamic 和 Forced 都允许后续继续调工具和工作流。
🧪 实验:90 道 AIME 全对是什么概念
评测设置:六个基准共 688 题——AIME 2024/2025/2026(各 30 题)、PolyMATH(200 题,多语言数学)、GPQA-Diamond(198 题,研究生级理化生)、HotpotQA(200 题,多跳问答,带 web 搜索)。主 Agent 和子智能体都是 Qwen3.5-27B(thinking 开启),子智能体用未做编排训练的 Base checkpoint 且全程冻结。基线包括 CoT、CoT-SC(5 采样自一致性)、Self-Refine、AFlow、Base + Web search,以及未训练主 Agent 的三种模式。
主实验结果(Table 1,准确率 %):
| 方法 | AIME24 | AIME25 | AIME26 | PolyMATH | GPQA-D | HotpotQA | Overall |
|---|---|---|---|---|---|---|---|
| CoT | 96.67 | 93.33 | 86.67 | 83.00 | 85.35 | 46.50 | 74.27 |
| CoT-SC | 90.00 | 93.33 | 96.67 | 84.50 | 85.86 | 50.50 | 76.16 |
| Self-Refine | 96.67 | 93.33 | 93.33 | 87.50 | 88.38 | 48.00 | 77.18 |
| AFlow | 93.33 | 96.67 | 100.00 | 86.00 | 87.37 | 47.00 | 76.45 |
| Base, Direct | 93.33 | 93.33 | 93.33 | 74.00 | 83.33 | 47.50 | 71.51 |
| Base + Web search | 83.33 | 73.33 | 73.33 | 66.00 | 79.80 | 77.50 | 74.71 |
| Base, Forced | 76.67 | 70.00 | 70.00 | 70.00 | 77.78 | 81.50 | 75.87 |
| DynaFlow (Direct) | 93.33 | 90.00 | 90.00 | 87.00 | 86.87 | 51.50 | 77.18 |
| DynaFlow (Dynamic) | 93.33 | 100.00 | 96.67 | 91.50 | 83.84 | 84.50 | 87.94 |
| DynaFlow(Forced) | 100.00 | 100.00 | 100.00 | 90.50 | 84.85 | 83.50 | 88.08 |
几个点值得停下来看。
AIME 三年 90 道题,Forced 模式全对。AIME 题目总共就 30 道一年,样本小,全对有运气成分,但三年连续全对还是说明工作流编排对数学竞赛题确实有实质帮助——附录的案例研究里有个例子挺说明问题:AIME 2026 一道回文计数题,Base 用单个 solver 算出 59(错的),DynaFlow 让三个子智能体用互补方法分别求解再加验证者交叉核对,都得到了正确答案 62。
HotpotQA 上 Dynamic 拿到 84.50%,比 Base + Web search 高 6 到 7 个点。注意 Base, Forced 在 HotpotQA 上就有 81.50%——检索类任务天然适合编排,这解释了为什么训练数据选了 HotpotQA 和 BrowseComp。
但 GPQA-D 是个反例:Forced 的 84.85% 虽然比 Base, Forced 高了 7.07 个点,Self-Refine(88.38%)和 AFlow(87.37%)仍然领先。作者也诚实分析了失败模式——子智能体的错误中间结论会误导后续验证,主 Agent 综合最终答案时可能没有优先采用正确证据。研究生级科学题上,"多几个脑子"未必比"一个脑子反复自我修正"强。
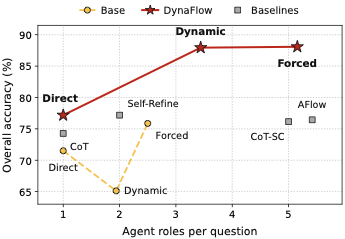
图1:Overall 准确率 vs 每题平均 agent 角色数(688 题,Qwen3.5-27B)。黄色虚线是 Base:Direct 用 1 个角色拿 71.5%,Dynamic 反而跌到 65.1%,Forced 回到 75.9%——不训练的编排是在帮倒忙。红色实线是 DynaFlow:Dynamic 以平均约 3.44 个角色拿到 87.9%,Forced 88.1%。灰色方块是各基线,全部落在 DynaFlow 曲线下方。
这张图其实是全文最有说服力的一张。它把"准确率-协作成本"的帕累托前沿画出来了:DynaFlow 的 Dynamic 模式用比 Forced 更少的子智能体拿到几乎相同的分数——Dynamic 模式下 47.1% 的问题主 Agent 判断后直接作答,平均每题只用 2.44 个子智能体,比 Forced 的 4.16 个少了约 41%。学会"什么时候不用协作",和学会"怎么协作"一样重要。
消融:工作流只有在训练后才有用
Table 2(训练阶段 × 执行模式,Overall %):
| Main Agent | Direct | Dynamic | Forced |
|---|---|---|---|
| Base | 71.51 | 65.12 | 75.87 |
| Stage 1 | 76.74 | 84.45 | 85.47 |
| DynaFlow (Stage 2) | 77.18 | 87.94 | 88.08 |
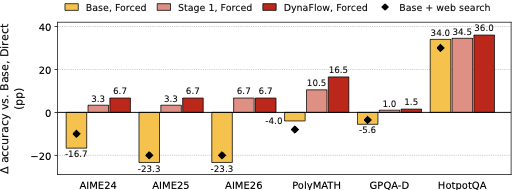
图3:"工作流只有在训练后才有用"。黄色柱(Base, Forced)在 AIME 三年和 PolyMATH 上全部大幅为负(最低 -23.3 个点),只有 HotpotQA 例外(+34.0);Stage 1 后各基准全部转正,Stage 2 进一步推高(PolyMATH +16.5,HotpotQA +36.0)。黑色菱形是 Base + web search,在多数基准上也是负的。
看到 Figure 3 我才意识到这个消融的分量:未训练的主 Agent 强行编排,六个基准里五个都在掉点,AIME25/26 和 PolyMATH 直接掉 23 个点。工作流不是免费的午餐,编排能力本身是学出来的。
另一个细节:Dynamic 和 Forced 的差距从 Base 的 10.75 个点,收窄到 Stage 1 的 1.02,再到 DynaFlow 的 0.14。训练到位之后,主 Agent 的路由决策几乎不会犯错——它自己选择是否协作,效果和强制协作一样好。
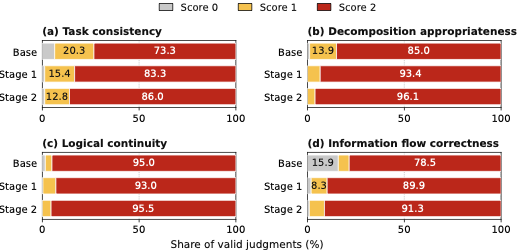
图4:Forced 模式每题首个工作流的 judge 评分分布(0=重大缺陷,1=轻微弱点,2=无缺陷),四个维度。任务一致性(a)的满分比例从 Base 的 73.3% 升到 Stage 2 的 86.0%;分解恰当性(b)从 85.0% 升到 96.1%;逻辑连续性(c)三个阶段都在 93% 以上;信息流正确性(d)从 78.5% 升到 91.3%——这是提升最大的维度之一。
📊 工作流分析:训练到底改变了什么
这部分是论文里我最喜欢的,因为它回答了"SFT 到底教会了主 Agent 什么"。
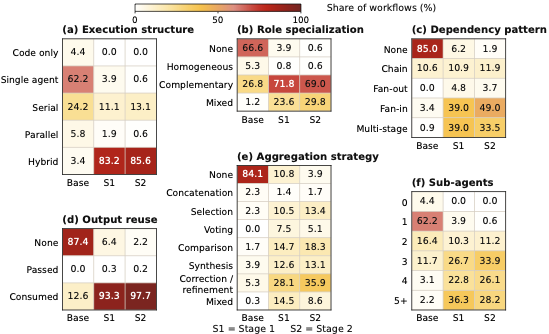
图5:六个维度上 Base / Stage 1 / Stage 2 的工作流分布(%)。(a) 执行结构:Hybrid(混合结构)从 Base 的 3.4% 飙升到 Stage 1 的 83.2%、Stage 2 的 85.6%,单一 agent 从 62.2% 降到 0.6%;(b) 角色专门化:Complementary(互补角色)从 26.8% 升到 71.8% 后回落到 69.0%,Mixed 占 29.8%;(c) 依赖模式:Fan-in 从 3.4% 升到 49.0%,多阶段协作占 33.5%;(d) 输出复用:Consumed(传递上游输出并显式要求下游使用)从 12.6% 升到 93.3% 再到 97.7%;(e) 聚合策略:Correction/refinement(修正细化)从 5.3% 升到 35.9%;(f) 子智能体数量集中在 3-5 个。
几个数字单独拎出来:输出显式消费从 12.6% 涨到 97.7%。训练前的主 Agent 写的工作流,绝大多数根本没把上游输出有效传给下游——信息在链路里断掉了,协作形同虚设。这正好呼应了 Stage 2 筛选里的"信息流缺陷",前后逻辑闭环了。重大信息流缺陷的比例也从 Stage 1 的 1.9% 降到 Stage 2 的 0.9%。
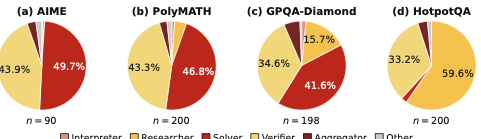
图6:Forced 模式下四个基准族的角色占比(n 为题目数)。AIME 上 Solver 占 49.7%、Verifier 占 43.9%,两者合计超九成;PolyMATH 类似(Solver 46.8% + Verifier 43.3%);GPQA-Diamond 的 Solver 占 41.6%,但 Researcher 和 Interpreter 占比明显上升(34.6% 的 Verifier);HotpotQA 完全不同——Researcher 占 59.6%,Verifier 占 33.2%。
主 Agent 学会了按任务类型分配角色:数学题就是"求解+验证"二人转,检索题则是"研究员为主、验证为辅"。这种任务特定的角色分配不是人写的规则,是 SFT 从蒸馏轨迹里学出来的。
🤔 我的判断:亮点、疑点与工程启发
亮点很清楚。 把自由形式工作流合成做成主 Agent 的可学习动作,并且用"只训主 Agent、子智能体全冻结"的设定干净地分离了编排能力和执行能力——这个实验设计我很喜欢,涨点归因没有水分。Stage 2 的三类缺陷筛选(前提注入、验证缺陷、信息流缺陷)也不是拍脑袋,每一条都要求 judge 给出程序中的匹配摘录,工程上可直接抄。六基准 88.08%、超最强基线 10.90 个百分点,在相同 backbone 下这个幅度不是靠堆采样能拿到的。
疑点也得说。
第一,评估的公平性有个小瑕疵。AFlow 基线是把 MATH 上搜索的工作流迁移到 AIME/PolyMATH、把 HotpotQA 工作流迁移到 GPQA-D,没有在评测任务上重新搜索——而 DynaFlow 是在相关分布上训过的。AFlow 作为一个需要 per-task 搜索优化的方法,这个对比对它不太公平。当然反过来说,"不用重新搜索就能泛化"恰恰是 DynaFlow 的卖点,这个对比方式本身就是在强化论文的论点,baseline 选得有点巧妙。
第二,数字不一致。除了前面说的 2,031 vs 2,257,Dynamic 模式平均每题子智能体数,Figure 1 图注写 3.44 个 agent roles,正文 §5.4 写 2.44 个子智能体——可能一个是"角色数"一个是"智能体数"口径不同,但论文没有解释。另外论文提到设了"等量随机子集继续训练"的对照组来区分筛选效果和单纯多训的效果,但正文没给这个对照的数值,少了一块关键拼图。
第三,GPQA-D 上 Self-Refine 和 AFlow 仍然领先,作者自己的失败分析也指出错误中间结论会污染验证环节。当前的监督只覆盖首轮轨迹,遇到多轮分歧和错误结果时主 Agent 缺乏恢复能力——作者也承认这是未来方向。还有一点坦率说我不是特别确定:整个筛选 pipeline 依赖 LLM judge(deepseek-flash),judge 的误判会直接进训练数据,论文没有报告 judge 的准确率或人工抽检结果。
对工程的启发,我觉得有三条可以直接拿走:
- 如果你在做多智能体系统,先检查信息流。97.7% 对 12.6% 这个数字对比说明,大多数"多智能体不 work"的根因不是模型不行,是上游输出根本没有效传到下游。给链路加"显式消费上游输出"的约束,成本低收益大。
- 编排能力可以单独训。不需要动子智能体,只用几百条高质量首轮轨迹做 SFT 就能让编排能力质变——712 条、17 GPU 小时,这个投入产出比很诱人。
- 训练路由决策和训练编排决策同样重要。Dynamic 模式 47% 的题直接作答、少用 41% 的子智能体,说明训练后的主 Agent 学会了"不该协作时别协作"——在在乎成本和延迟的生产环境里,这比绝对准确率更值钱。
这篇论文的定位我的判断是:不是底层突破,但它把"编排即动作"这个范式做扎实了,而且用干净的对照实验证明了价值。如果你正在搭多智能体系统,Stage 2 的缺陷筛选清单和工作流分析维度,值得打印出来贴在工位上。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我