Δτ-Bench:工具天天在变,Agent 背下来的"武功秘籍"还管用吗?
你有没有想过一个场景:公司花大力气给 AI 智能体接入了全公司几百个内部工具,又用各种技能学习方法让它"攒经验",上线头一个月表现亮眼。半年后,IT 部门重构了一批接口,财务系统换了新 API,旧的订票工具下线了——智能体还在用老套路干活,有些流程悄悄断掉了,有些明明有更省事的新路径,它却浑然不觉。
更扎心的是:它可能依然"任务成功"这件事本身。成功掩盖了落后。
浙大和 UCL 的这篇 Δτ-Bench(arXiv: 2610.34238)就是冲着这个问题来的。他们造了一个会"持续演变"的工具生态基准:42 个领域、1,588 个多轮任务、6 个连续的生态系统状态,工具会被改名、拆分、合并、下线。结果相当难看——最强的模型和 harness 也只拿到 42.3% 的任务成功率,而现有技能学习方法的初期收益,在生态演变几轮之后就无法持续。论文顺手给了一个解法:Steward,一个同时管理工具库和技能库的"生态管家",用增量技能维护加动态供应把成功率稳住了。说实话,我觉得这篇最值钱的不是 Steward 本身,而是它把"静态基准测不出来的一种失败模式"给量化出来了。
论文信息
- 标题:Δτ-Bench: Pushing Agents Toward a Moving Capability
- 作者:Shuofei Qiao、Xuanguang Pan(共同一作)、Yijun Chen、Wendi Feng、Bin Wu、Runnan Fang、Yuqi Zhu、Shumin Deng、Emine Yilmaz(通讯)
- 机构:浙江大学、University College London
- 链接:https://arxiv.org/abs/2610.34238(2026 年 10 月 25 日提交,ICLR 2027 投稿)
🎯 问题动机:静态基准测不出的失败模式
先看看现有的工具智能体基准都在测什么。ToolRet、MetaTool 这类测大规模工具检索;AppWorld、τ-bench 测有状态的多轮执行;CostBench、TravelPlanner 测变化执行条件下的重规划;MCPEvol-Bench、ToolQA-D 测工具演化的鲁棒性。
看着覆盖挺全?但论文点出一个共同的盲区:这些能力基本是被拆开单独测的。服务结构要么固定不变,要么变化的时候限制了工具发现的空间。没有一个基准同时要求智能体:在几百个工具的大生态里主动找到更高效的工具路径,并且在生态演变后及时更新自己积累的程序性知识。
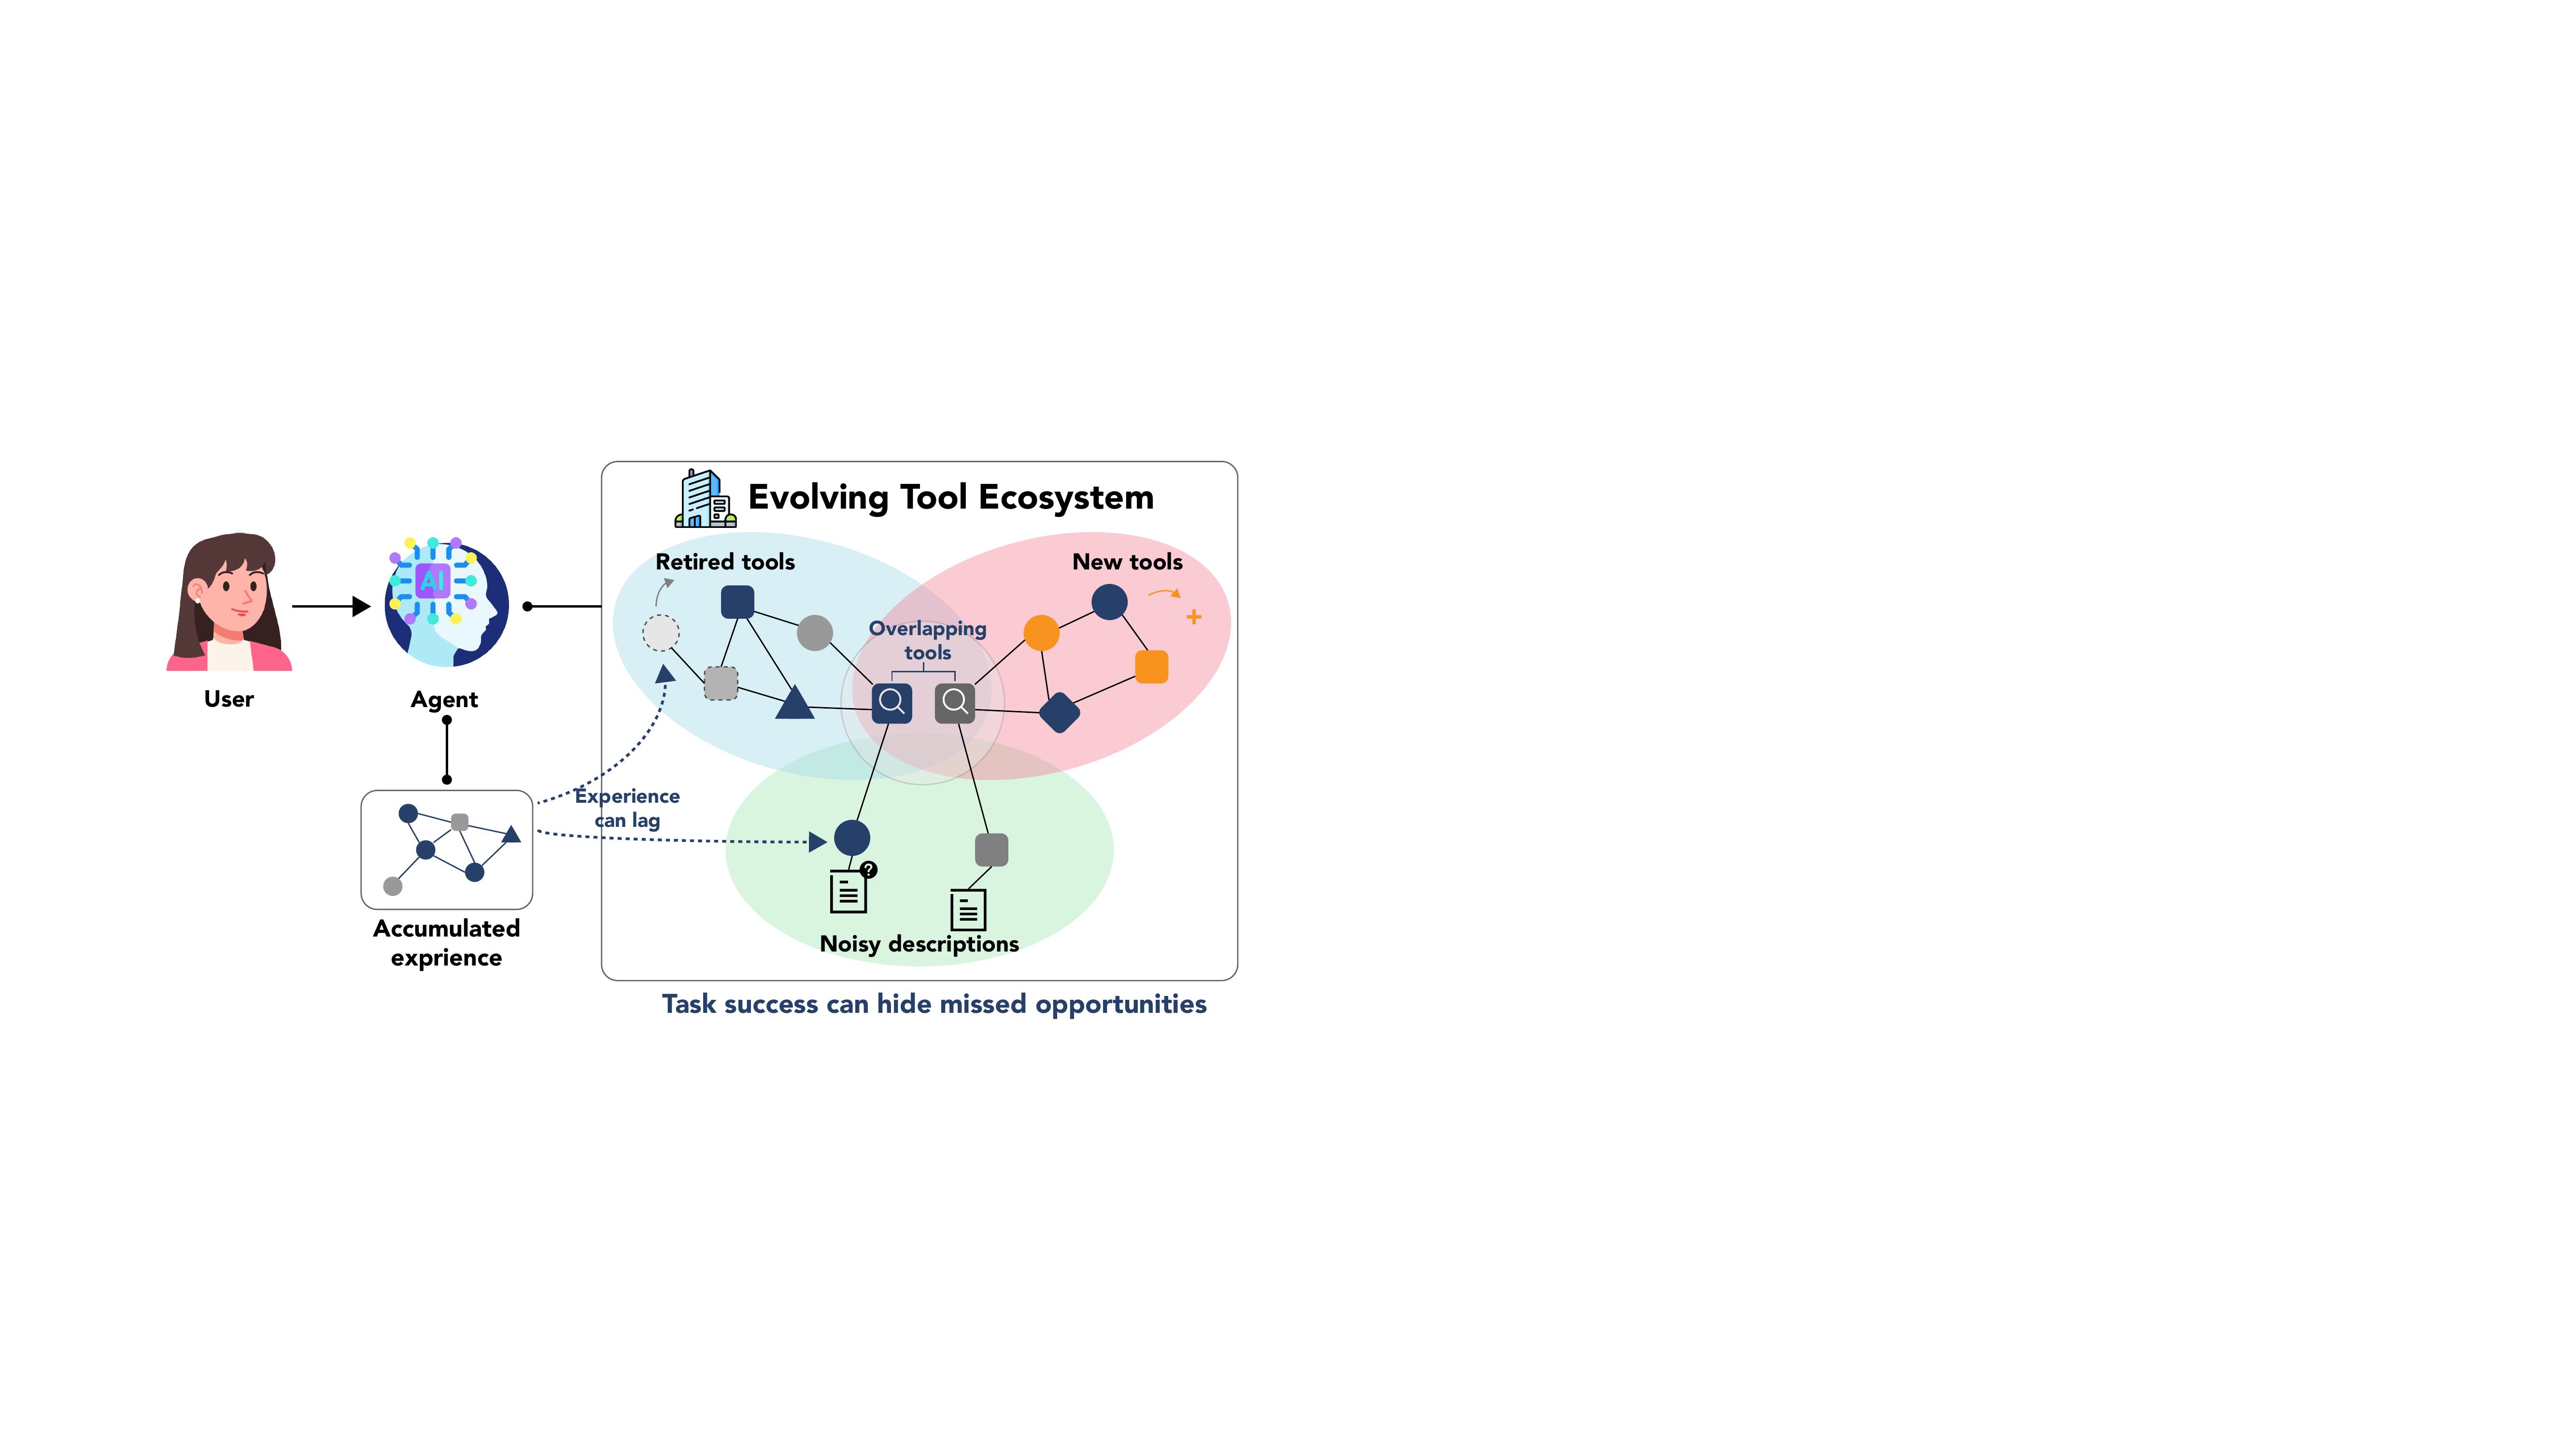
图1:论文开篇的场景图。用户把需求交给智能体,智能体背后是一个持续演化的工具生态——旧工具退役(Retired tools)、新工具出现(New tools)、功能重叠的工具(Overlapping tools)和噪声文档(Noisy descriptions)交织在一起。左下角"Accumulated experience"与生态之间标着 "Experience can lag":积累的经验会滞后;底部的 "Task success can hide missed opportunities" 点出核心矛盾——任务成功可能掩盖错失的机会。
这个痛点是真的。我之前做内部工具平台的时候就碰到过:接口改版后,靠 prompt 里写死的调用流程直接哑火,而没人知道还有多少"能跑但不是最优"的流程在悄悄浪费调用次数。论文管这个叫 moving capability frontier(移动的能力前沿)——生态能做什么是在变的,智能体学到的东西如果不跟着动,差距只会越拉越大。
🏗️ Δτ-Bench 怎么造出来的
这个基准的工程量大得有点夸张,我拆成四层来讲。
第一层:可执行的有状态环境。 从种子领域扩展出 42 个领域,每个领域围绕一个主要用户角色构建实体 schema 和实体关系图,再把验证过的函数确定性地转成带自然语言描述和 JSON Schema 的工具接口,背后用 MCP 服务实现,状态存在 mock 数据库里。也就是说,每个工具调用都真实改变环境状态,不是模拟输出。
第二层:任务合成与执行验证。 从工具依赖图上采样路径,生成自然语言任务模板,每个任务要求多轮用户交互(用户模拟器拿着一本私有"手册",按需渐进披露信息)。关键一步是回放验证:实例化的动作序列必须在 MCP 环境里从头跑通,所有状态转移符合预期才保留。最后留下 1,588 个任务(训练集 1,191,测试集 397),乘上 6 个生态版本,共 9,528 个任务-生态实例。
第三层:能力保持的演化变换。 这是 Δτ-Bench 名字里 Δτ 的由来。每个领域从基础工具集出发,用三类变换生成"同一能力的不同实现":一对一(改名、加参数、换格式)、一对多(一个函数拆成多个协调接口)、多对一(连续工作流合并成统一接口)。每次版本更新会应用有限数量的变换,新旧工具可能共存(考验选择能力)或直接替换(考验适应能力)。每次变更都通过谱系递归验证,保证所有基础能力仍然可达。生态规模有多大?v1 有 892 个工具,之后每个版本大约新增一百多个、退役一百多个、修改一百五十个左右——这个变动密度相当接近真实企业的迭代节奏。
第四层:任务级最优路径搜索。 这是整个基准的灵魂。同一任务在不同版本下,最优实现路径可能完全不同。论文把任务的黄金轨迹拆成有序基础函数序列 \((f_1, \ldots, f_n)\),在每个版本里搜索它的所有可行实现,用动态规划分别找出步数最少和成本最低的参考路径:
说人话:把任务切成若干连续函数块,每块选一个当前版本可用的实现,让总代价最小。成本是 LLM 按工具定义和实现打的 1-10 分。有了这条"当前最优路径"作为参照,才能衡量智能体是"勉强跑通"还是"跑得漂亮"。
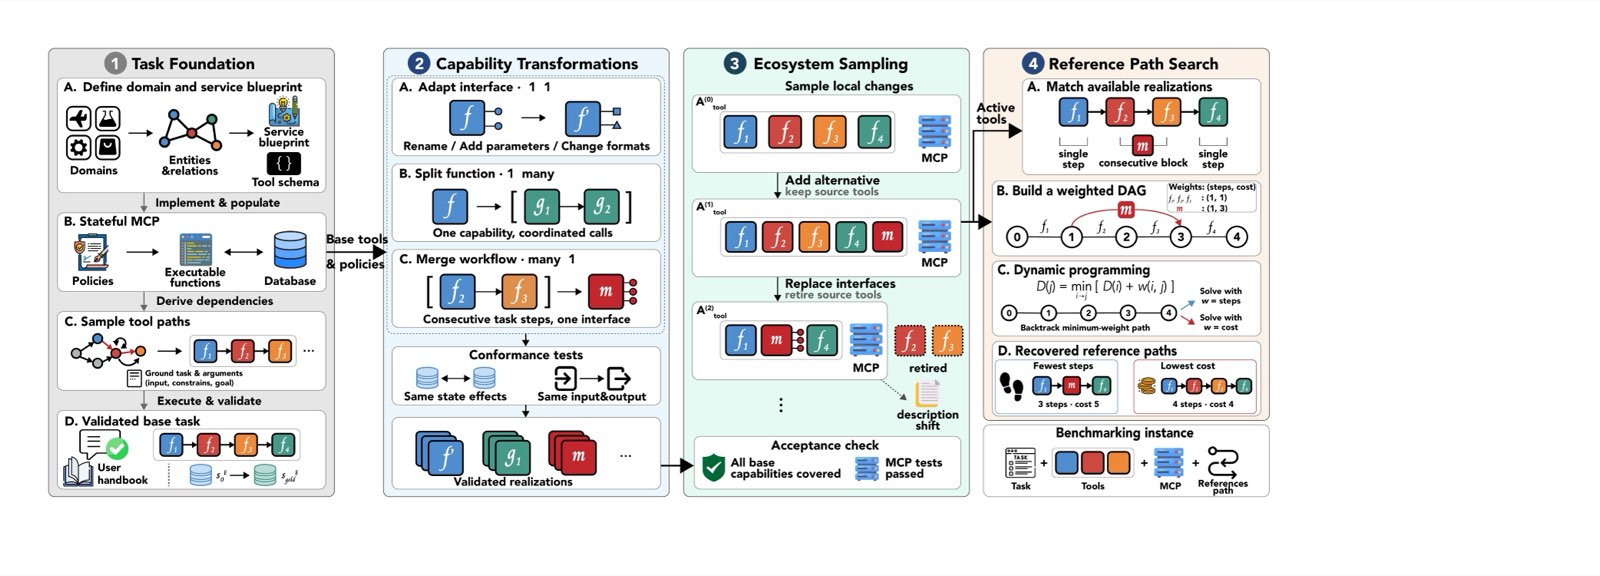
图2:基准构建四阶段总览。① Task Foundation:定义领域与服务蓝图,实现有状态 MCP 服务,采样并执行验证基础任务;② Capability Transformations:一对一适配接口、一对多拆分函数、多对一合并工作流,每个候选实现都要过一致性测试(相同状态效果、相同输入输出);③ Ecosystem Sampling:从变换空间采样每个版本的活跃工具集,可选保留或退役源工具,并做接受检查(所有基础能力被覆盖、MCP 测试通过);④ Reference Path Search:匹配可用实现、构建加权 DAG、动态规划求解,还原出步数最少与成本最低两条参考路径。
这套指标设计也值得说。 除了常规的 SR(任务成功率,判定标准是智能体产生的数据库变更覆盖黄金变更)和工具检索 P/R/F1,最核心的是 SPE(Success-weighted Path Efficiency,成功加权的路径效率):
只有任务成功才计入效率分,效率是参考路径权重与智能体实际路径权重的比值。针对前沿跟踪,又拆出 IDR(Improvement Discovery Rate,发现更优路径的能力)和 DAR(Degradation Adaptation Rate,最优路径变差时的适应能力)。后两个指标是这这篇论文独有的拷问:生态变好时你跟上了吗?生态变差时你恢复了吗?
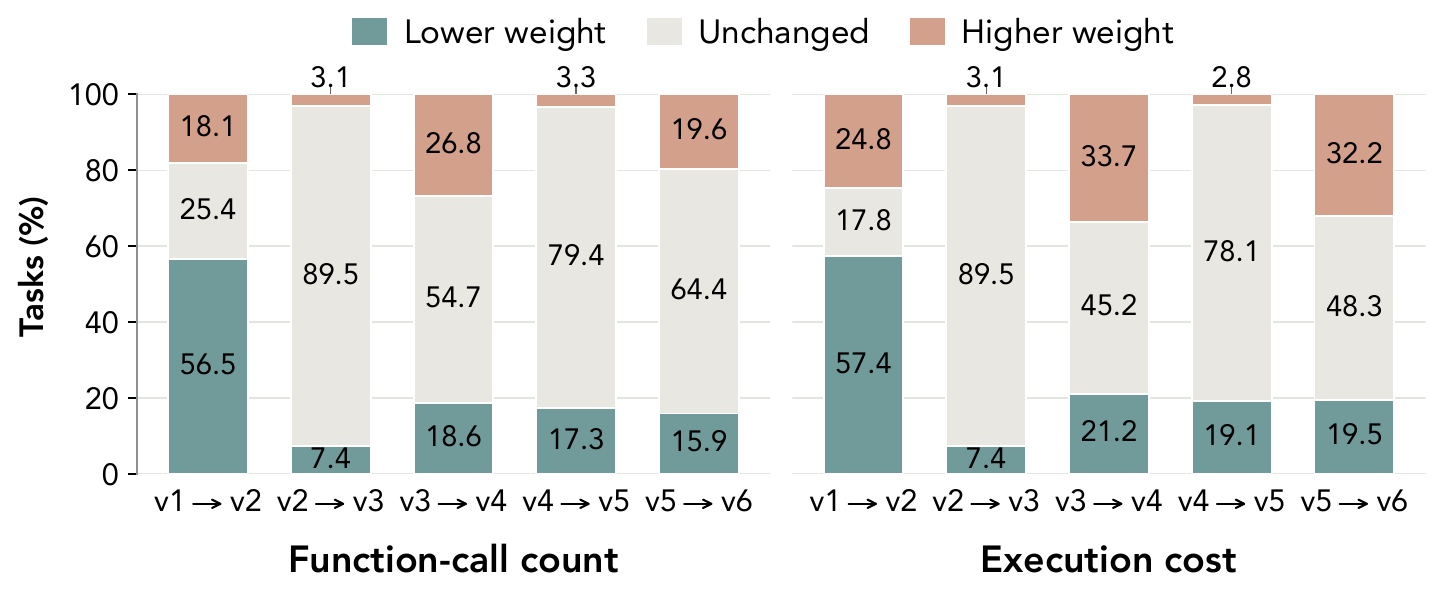
图3:每次版本迁移时,任务按参考路径权重变化分三类——变优(绿)、不变(灰)、变差(橙)。v1→v2 时按调用步数统计有 56.5% 的任务出现了更短路径,v3→v4 又有 26.8% 的任务最优路径变长。也就是说,每次生态演化都同时带来大量"红利"和"坑",前沿是真的在动。
📊 实验一:现在的模型连当前前沿都够不着
论文先测了一批顶配模型在六个版本上的表现,用户模拟器固定为 DeepSeek-V3.2。
| 模型 | SR | 检索 P | 检索 R | 检索 F1 | Step-SPE | Cost-SPE |
|---|---|---|---|---|---|---|
| Codex-GPT-5.5(harness) | 42.27 | 19.90 | 90.36 | 32.04 | 26.93 | 27.90 |
| Gemini-3.6-Flash | 41.65 | 19.30 | 87.51 | 31.13 | 25.49 | 25.88 |
| GPT-5.5 | 31.74 | 20.21 | 81.08 | 31.86 | 23.11 | 23.42 |
| DeepSeek-V4-Pro | 33.29 | 18.65 | 79.00 | 29.65 | 13.49 | 14.31 |
| GLM-5.2 | 32.28 | 19.32 | 78.25 | 30.47 | 19.39 | 19.84 |
| Claude-Sonnet-5 | 29.97 | 19.36 | 76.93 | 30.41 | 20.48 | 20.60 |
| Qwen-3.8-Max | 30.10 | 18.46 | 80.02 | 29.49 | 15.84 | 16.84 |
| Kimi-K3 | 28.30 | 19.20 | 77.01 | 30.20 | 17.78 | 17.83 |
表1:模型评测主表(整理自论文 Table 1)。SR 与 SPE 单位均为 %。
几个数字很扎眼。
最强的 Codex-GPT-5.5 也只有 42.27% 成功率,Step/Cost-SPE 连 30% 都不到——就算它跑通了任务,走的路也远比最优路径绕。再看检索那一栏:召回 90.36%,精确率却只有 19.90%。这个模式在所有模型上一致存在——模型会把相关工具捞进来,但不会扔,候选集里塞满了无关和重叠的工具。你想想看,八九百个工具里给你捞出一堆"可能有用"的,最后还是靠模型在嘈杂的上下文里硬选。
还有个细节:DeepSeek-V4-Pro 的 SR 略高于 GLM-5.2,SPE 却全面落后。成功和高效在这个基准里是两回事,这正是 SR 单一指标掩盖的问题。
为了定位瓶颈,论文做了一个逐步"开卷"的诊断实验:
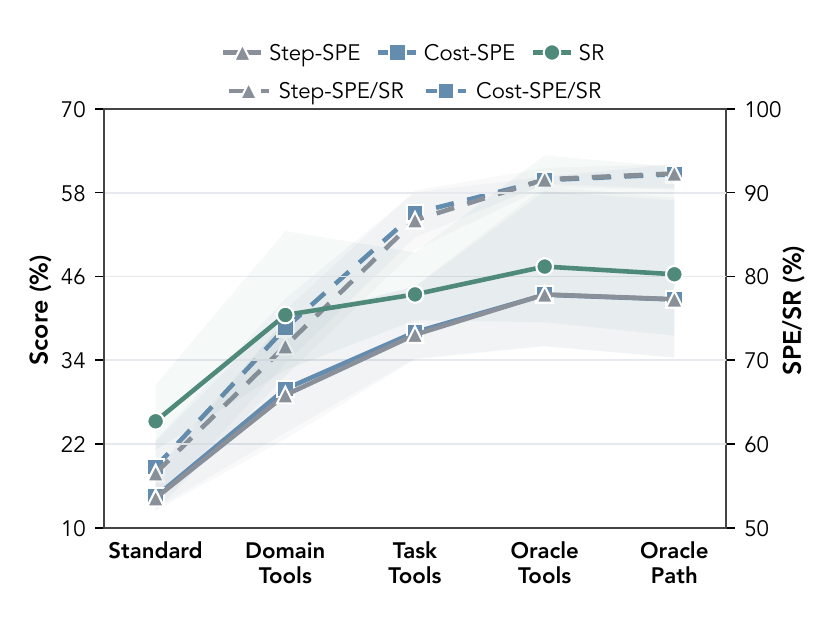
图4:从左到右信息越来越充分——Standard(全生态检索)、Domain Tools(限定领域内)、Task Tools(给全该任务跨版本用过的所有工具)、Oracle Tools(只给当前版本相关工具)、Oracle Path(再给参考路径)。SR 和 SPE 一路爬升到 Oracle Tools,但 Oracle Path 几乎不再带来提升。
这个图的读法很讲究。Standard 到 Domain/Task Tools 的爬升说明:去掉无关候选能缓解工具识别问题。Task Tools 到 Oracle Tools 那一跳更关键——即便把候选集缩到"这个任务相关的工具",模型仍然分不清哪些是当前版本可用且高效的、哪些是已退役或重叠的。而 Oracle Path 没有进一步提升,说明剩下的差距不在高层规划能力,而在能不能正确高效地把可用工具用起来。瓶颈在执行层,不在规划层。
📉 实验二:技能学习方法的红利撑不过几个版本
既然模型自己搞不定,那给它攒技能行不行?论文测了四个自动技能方法——EvoSkill、AutoSkill、Trace2Skill、SkillOpt,对比 No Skill 基线,跑满六个版本。
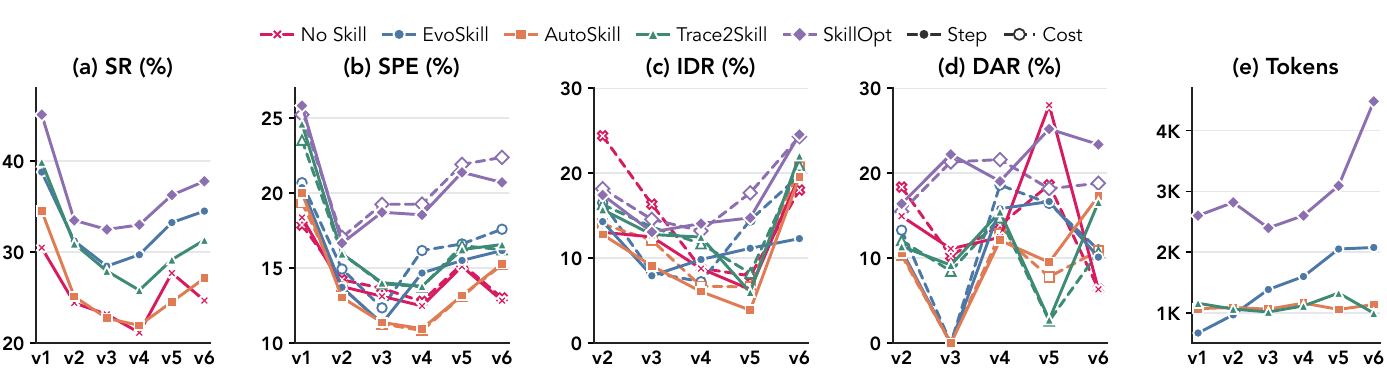
图5:五个子图分别是 SR、SPE、IDR、DAR 和维护 token 开销(实线 Step、虚线 Cost)。v1 时四个方法全面领先 No Skill;但 AutoSkill 在 v3、v5 的 SR 跌破 No Skill 线;DAR 子图里 v3 处 EvoSkill 和 AutoSkill 直接归零;最右侧 SkillOpt 的维护成本一路飙升到接近 3,000 K/task,是其他方法的两到三倍。
v1 的普涨不出意料,积累的经验确实有指导价值。但往后看就露馅了。
最触目惊心的是 DAR:v3 时 EvoSkill 和 AutoSkill 的 Step-/Cost-DAR 掉到 0,而不攒任何技能的 No Skill 还保持着 11.11%/10.25%。你品品——当生态变化打断了旧工作流,攒了技能的智能体反而比裸奔的更不会恢复。我的理解是:过期技能不只是没用,它还会误导,让智能体固执地走已经不存在的路径。
SkillOpt 在 SR 和 SPE 上一直领先,但它的优势没有稳定延伸到 IDR 和 DAR,而且代价是平均约 3,000 K token/任务的技能生成与优化开销。当前版本跑得好,不代表能跟上移动的前沿——这个区分是之前所有技能学习论文都没测过的。
🔧 Steward:把工具和技能当成耦合资源来管
基于上面的诊断,论文提出 Steward。一句话概括:技能和工具不是两张皮,而是一个耦合的资源系统,要一起维护、一起供应。
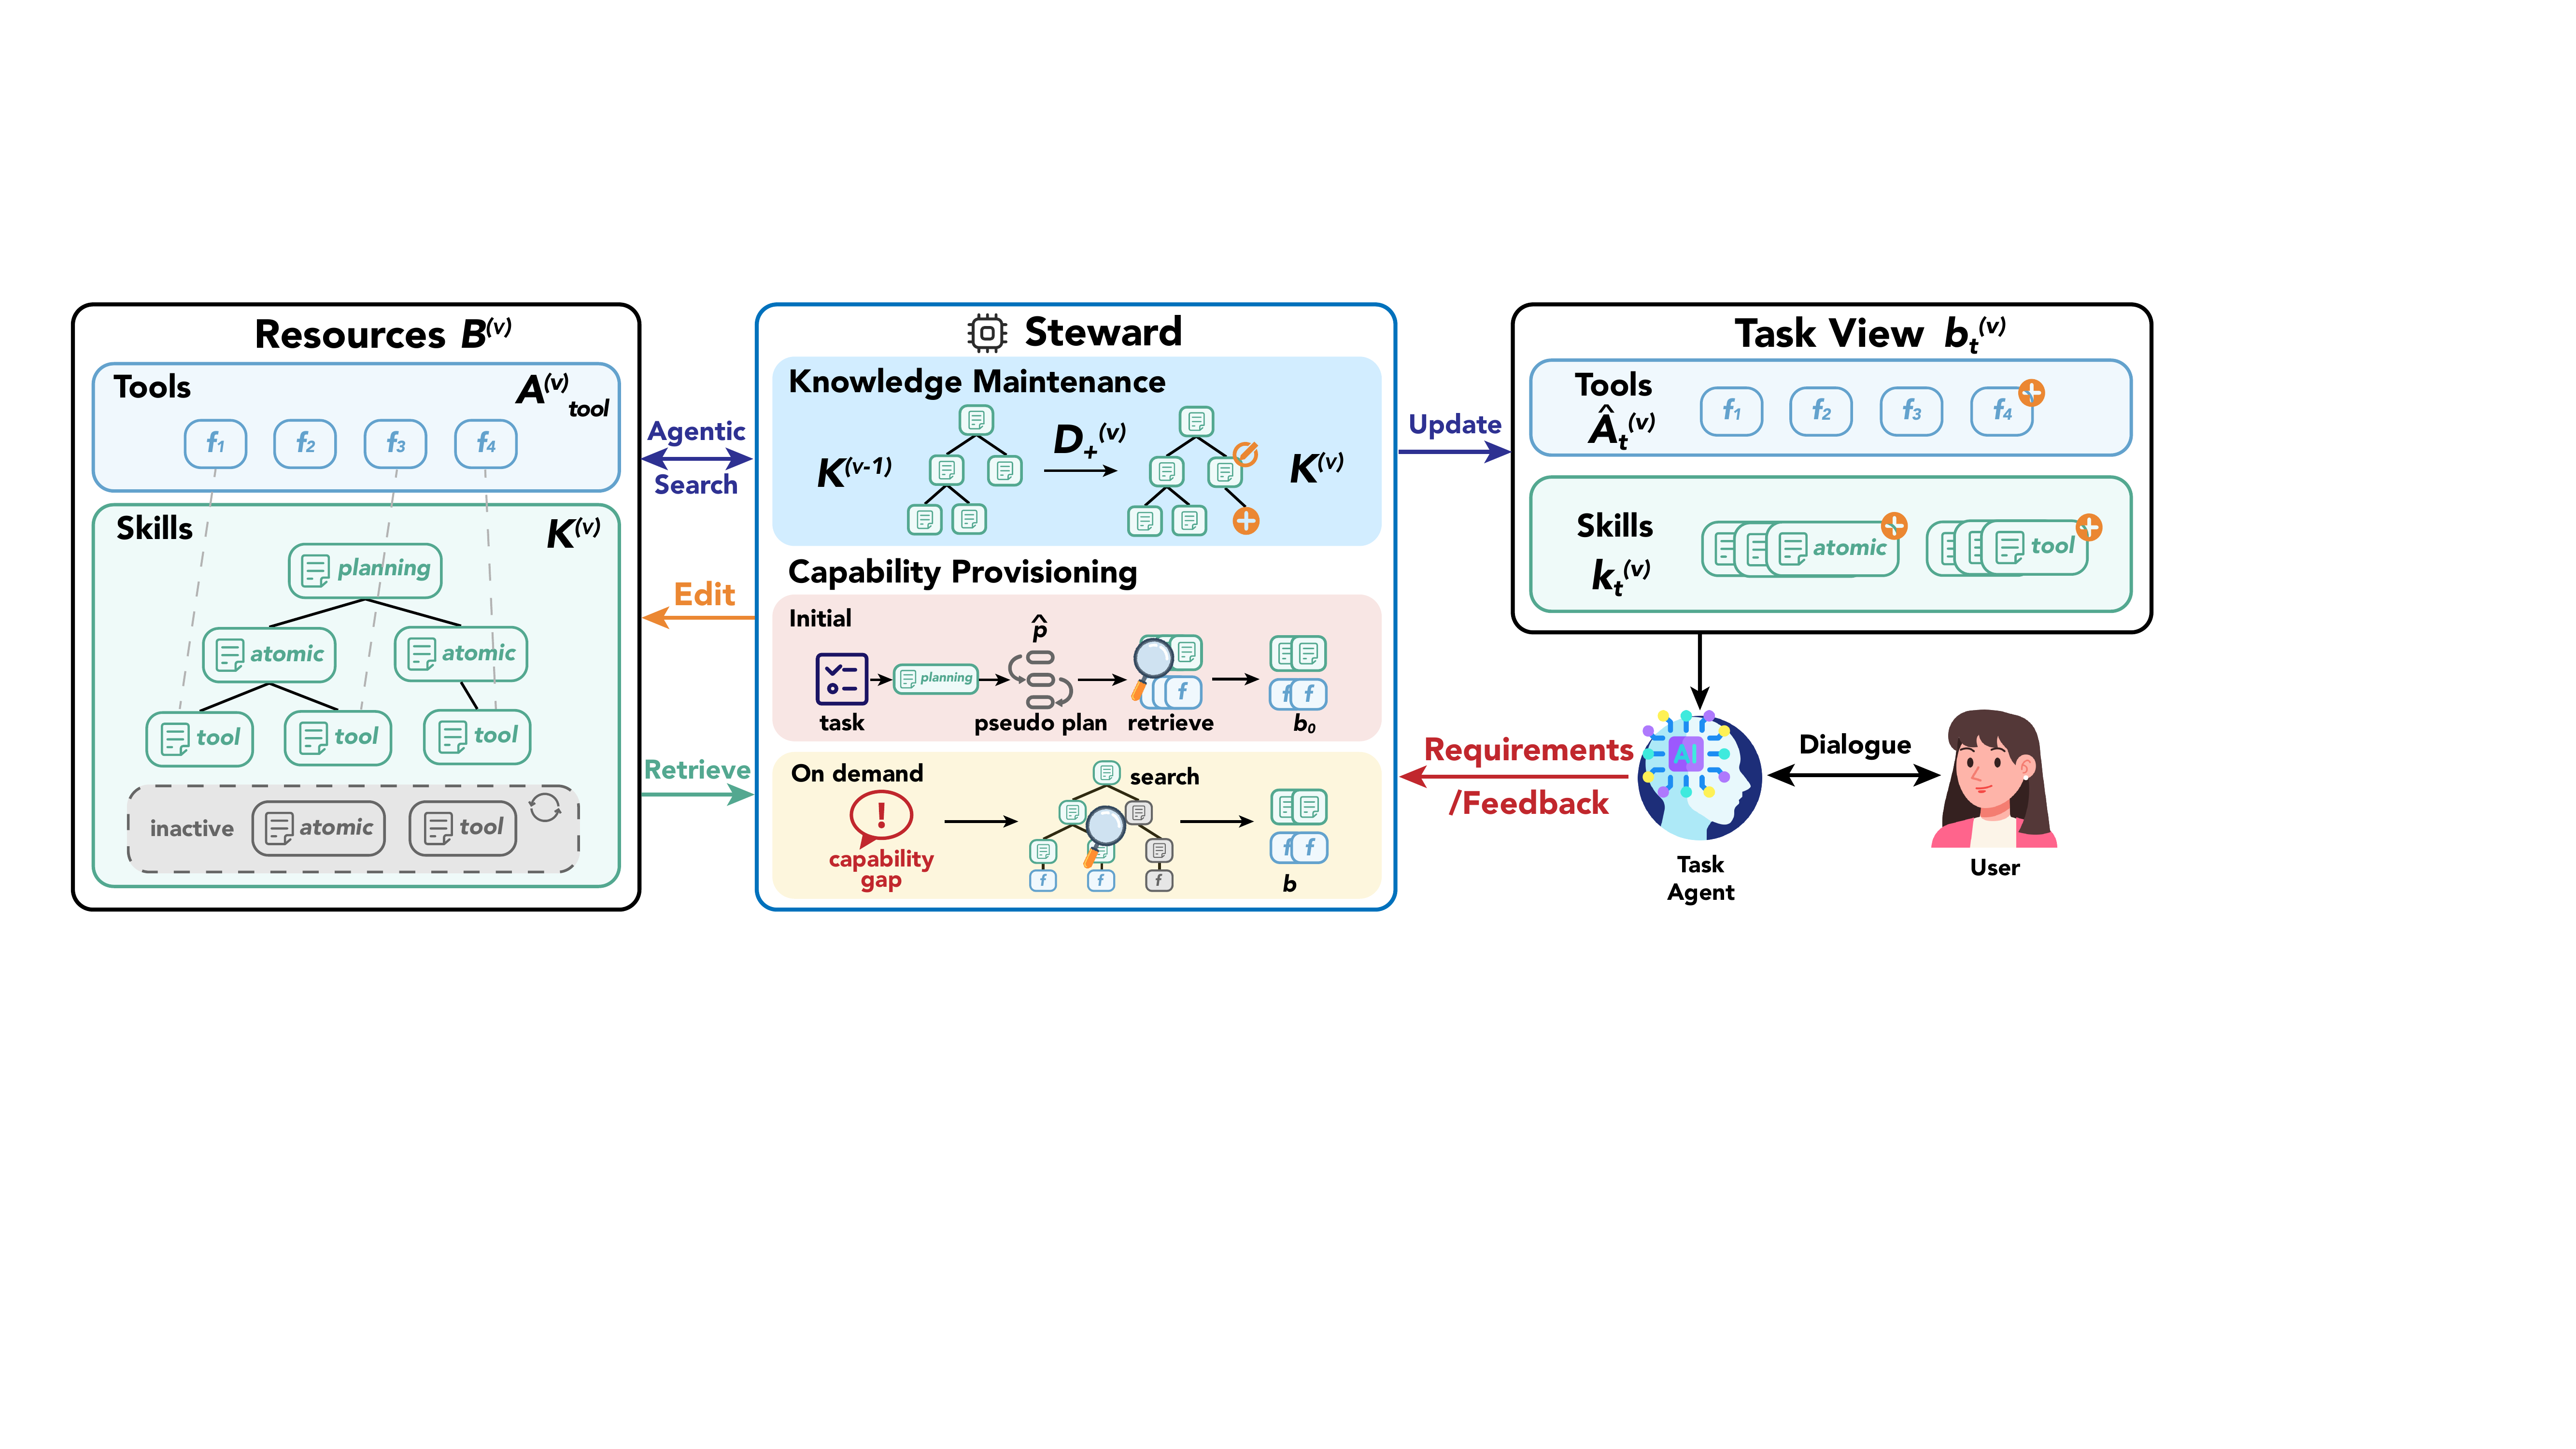
图6:左侧是共享资源状态 \(\mathcal{B}^{(v)}\),包含工具目录和三级技能库(planning skills 管任务级工作流、atomic skills 管可复用操作、tool skills 管单个工具的调用要求,失效技能保留在 inactive 区而非删除)。中间 Steward 做两件事:Knowledge Maintenance 用新版本工具目录和验证过的成功轨迹 \(\mathcal{D}_+^{(v)}\) 对旧技能库做局部编辑;Capability Provisioning 在任务开始时检索规划技能生成临时计划 \(\hat{p}\)、按步检索原子技能和工具构建初始任务视图 \(b_0\),执行中一旦出现能力缺口就按需补充。右侧任务智能体拿着动态更新的任务视图与用户对话。
两个机制值得单独拎出来。
增量知识维护。 每个版本,Steward 把新验证的成功轨迹蒸馏成对现有技能层次的局部编辑,而不是重建整个库。然后根据技能的工具依赖在当前版本是否可用,把技能标记为 active 或 inactive——失效技能不删,留着,等依赖的工具哪天回来了还能复活。这个"软删除"设计挺精巧的,直接对应生态演化的波动性。
动态能力供应。 任务开始时给的是一个临时的初始视图,执行过程中根据用户新披露的信息和工具报错反馈,实时补充工具和操作指引。这等于承认了一个现实:在嘈杂的大生态里,开局一次性把所有东西备齐是不可能的。
📈 Steward 的实验结果
用 DeepSeek-V3.2 做任务模型,跟四个技能方法跑六个版本:
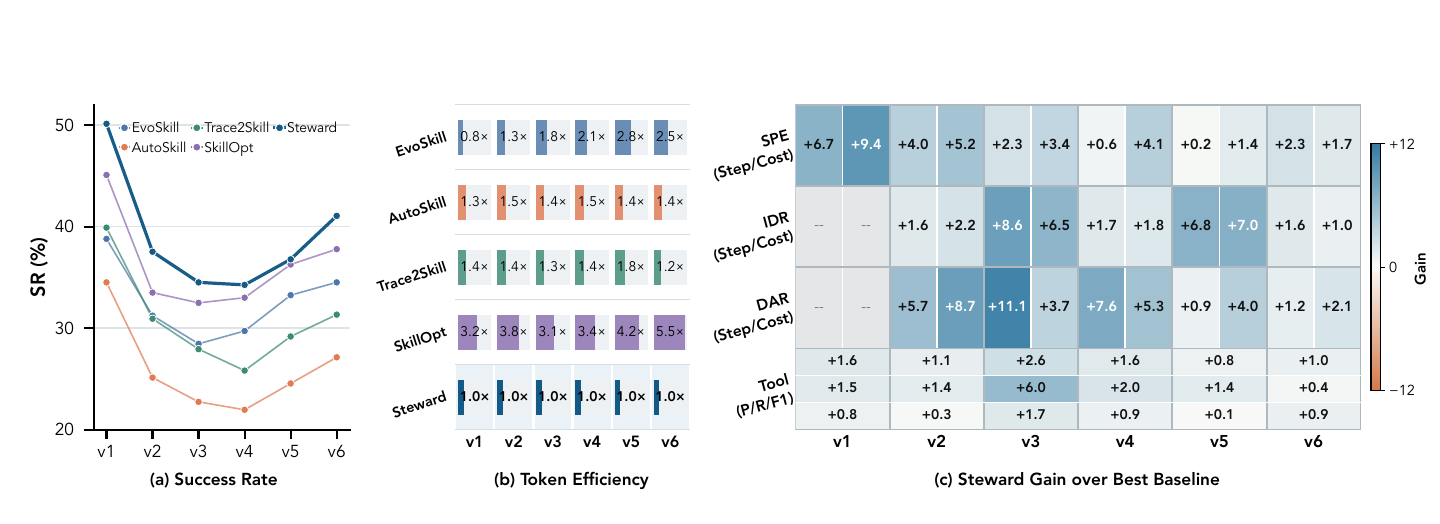
图7:(a) Steward 在每个版本的 SR 都是最高;(b) 从 v2 起 Steward 的维护 token 恒为 1.0× 基准线,其他方法要 1.2-5.5 倍,SkillOpt 到 v6 已达 5.5×;(c) Steward 相对每版本最强基线的百分点增益热力图,DAR 在 v3 一处高达 11.1 个点。
数字层面:Steward 平均 SR 39.04%,SkillOpt 是 36.36%;维护成本 v2 起全场最低;Step-/Cost-IDR 平均提升 4.04/3.69 个点,Step-/Cost-DAR 提升 5.28/4.76 个点,Step-/Cost-SPE 提升 2.68/4.21 个点。优势不只在"保持成功率",还在"发现更优路径"和"从退化中恢复"这两件别人做不了的事上。
消融实验更有说服力。跨版本维护策略对比(同一初始技能库,v2 起分岔):
| 模型 | 策略 | SR | Tool F1 | 维护 token (K/task) |
|---|---|---|---|---|
| DeepSeek-V3.2 | 冻结库 | 33.90 | 35.96 | 0 |
| DeepSeek-V3.2 | 全量重建 | 34.61 | 33.56 | 1,271.10 |
| DeepSeek-V3.2 | 增量维护 | 36.83 | 39.37 | 769.55 |
| GPT-5.5 | 冻结库 | 39.60 | 27.20 | 0 |
| GPT-5.5 | 全量重建 | 38.99 | 26.50 | 1,449.60 |
| GPT-5.5 | 增量维护 | 40.81 | 29.54 | 约 1,009 |
表2:跨版本知识维护消融(整理自论文 Table 2)。
注意 GPT-5.5 那一行:全量重建(38.99%)居然跑不过冻结库(39.60%)——花了 1,449 K token 重建技能,效果反而比不更新还差。这说明重建过程本身在破坏已经验证过的知识。增量维护在 SR 上比全量重建高 2.22/1.82 个点,token 还省 39.5%/30.4%。
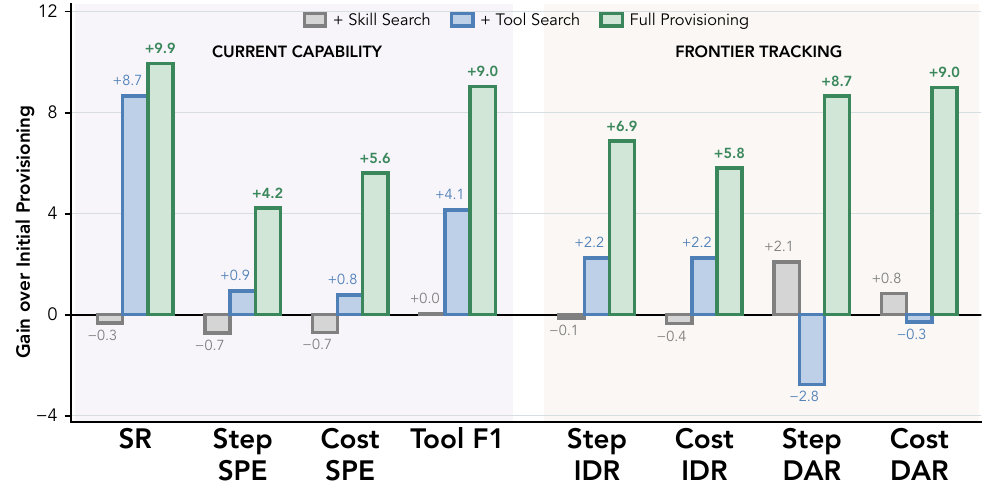
图8:以初始供应为基线的增益对比。灰色(只加技能搜索)几乎全线无增益甚至为负;蓝色(只加工具搜索)SR 涨了 8.7 个点但 Step-DAR 掉了 2.8;绿色(完整供应)在所有指标上最优,相对只加工具搜索,Step-/Cost-DAR 再涨 11.41/9.30 个点。
这个消融把"耦合"两个字坐实了:只搜技能不搜工具,知识落不了地;只搜工具不搜技能,找到了工具也不会高效地用,DAR 反而倒退。两个模块单独看都不完整,合在一起才 work。
🤔 我的判断
这篇论文最值钱的地方,是它把一个工程上人人都隐约知道、但学术上从没被量化过的问题,变成了一个可测的基准对象。"技能会过期"这件事,之前所有 agent 技能学习的工作(Voyager 一系、各种 skill library 方法)都默认环境是静止的,Δτ-Bench 直接把这块遮羞布扯了——v3 处 DAR 归零那个数据,我觉得会吓醒不少做 agent memory 的人。
批判性地说几句。其一,生态演化是合成的,三类变换(一对一/一对多/多对一)虽然设计得合理,但真实世界的 API 演化还包括语义漂移、隐式行为变更这类更难捕捉的变化,这个基准测不到。其二,工具成本分(1-10 分)是 LLM 打的,Cost 相关指标的可靠性系于这个打分的质量,论文没有给出人工校准的佐证。其三,Steward 说到底是一个精心设计的工程系统,它的增益有多少来自"方法创新"、多少来自"多了一个管理模块的算力投入",从论文数据里看不算完全清晰——尽管维护 token 的对比多少回应了这一点。
但即便如此,这个方向我认为是对的。智能体评测正在从"单次任务能不能完成"走向"长期部署能不能持续称职",Δτ-Bench 是这个转向里目前做得最扎实的一个。如果你在做企业内部 agent 平台、工具中台或者 agent 记忆系统,DAR 和 IDR 这两个指标值得直接抄走,拿去拷问你自己的系统:上次接口改版之后,你的 agent 恢复得怎么样?
顺便一提,这还是个 work in progress,作者标注了后续会更新,可以持续关注。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我