最强 Agent 也只通过 47.7% 的关卡:CLE 用一场"五级职业大考"拷问大模型的持续学习能力
你有没有发现一个很拧巴的现象——现在的 Agent 评测榜单一个比一个刷得高,GAIA、SWE-bench 上各家模型你追我赶,可真把一个 Agent 扔到公司里连续干一个月活,它大概率第二周还在犯第一周犯过的错。
问题出在哪?我们根本没有一场考试,去考"经验积累"这件事。
上周挂在 arXiv 上的这篇 Continual Learning Exam(以下简称 CLE,arXiv: 2610.33956)让我眼前一亮。它不再问"这个任务你能不能做",而是问"做完前面四关之后,第五关你是不是比第一次做更强了"。结果是相当打脸的:17 个前沿 harness+模型配置里,最强的 Claude Code + Opus 5 也只通过了 47.67% 的关卡,能一口气打穿全部五级的任务只有 23.33%。
核心摘要
CLE 是一个由 50 多位领域专家手工编写的大规模持续学习基准:120 个真实职业任务,每个任务是一条五级阶梯,共 600 关,覆盖 89 个职业角色、12 个职业领域。关键设计是"门控解锁"——过不了当前关卡,后面全判失败,而且后续关卡的题目本身就建立在前几关产出的文件、数据库状态和经验之上。评测发现,即便给出诊断反馈并允许一次修订,最强系统的关卡通过率也不到一半;反馈+修订只带来中位 5.33 个百分点的提升。我的判断:这不是一篇刷榜论文,而是一份相当扎实的"打脸报告"——它把"Agent 会不会从经验中学习"这个被长期回避的问题,量化成了所有人都没法再装看不见的数字。
论文信息
- 标题:Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
- 作者:Haoyu Zhao、Sitian Tu、Yuxuan Huang、Huichi Zhou、Zhangyue Yin、Jiahao Huang 等 19 人(通讯 Haoyu Zhao,另有 Meng Fang、Jun Wang 等)
- 链接:https://arxiv.org/abs/2610.33956
- 提交日期:2026 年 10 月 25 日
- 项目主页:https://haoyu-zhao.github.io/CLE/index.html
🎯 为什么需要这场考试
先说说现有评测的盲区在哪。
通用能力榜(GAIA 那类)把任务一道一道独立摆出来,做完一道清零,下一道从零开始。这考的是"裸能力",考不出"越用越强"。记忆类基准(LoCoMo 那类)只考你能不能把之前的对话翻出来,翻出来和"用上经验把活干得更好"是两码事。还有一些带持久状态的自动化助手评测,状态是持久了,但持久状态本身证明不了 Agent 变强了——你只是记住了,没学会。
真正的持续学习应该长这样:\((\theta_{n+1}, s_{n+1}) = U_n(\theta_n, s_n, e_n)\)。模型参数 \(\theta_n\)、harness 的持久状态 \(s_n\)(记忆、技能库),随着每一段经验 \(e_n\) 被不断更新。在权重冻结的主流设定下,这个式子退化成只有 \(s\) 在变——也就是说,今天我们能考的持续学习,几乎全部发生在 harness 层的记忆和技能沉淀上。
CLE 就是冲着这个空白来的:构造一串必须按顺序做的真实工作任务,后面用到前面的产出,看 Agent 到底能不能把经验攒起来、用起来。

图4(Overview of CLE):每个人工编写的任务由五个顺序关卡组成,关卡之间靠可迁移知识连接;Agent 通过 API 与有状态应用交互,评估 Agent 对照人工评分标准核验提交。K=1 时每关只允许一次提交、无反馈;K=2 时首次失败后给出诊断反馈并允许一次重交。
🏗️ 基准设计:一场不许跳级的职业大考
CLE 的规模先摆在这:120 个任务 × 5 级 = 600 关,89 个职业角色横跨 12 个领域(金融、工程、医疗、IT/网络安全、生命科学、运营/HR、软硬件、商业、数据/AI、法律/公共服务、研究/教育、媒体/设计),每个领域 7 到 13 个任务。配套 23,981 个真实输入文件(77 种格式,还特意保留了重复记录、冲突信息这些真实的脏数据)、19 个有状态模拟应用、1,024 个 API。注意"有状态"这三个字——你在第二关往数据库里写的东西,第五关还在。语言上 508 关英文、92 关中文。
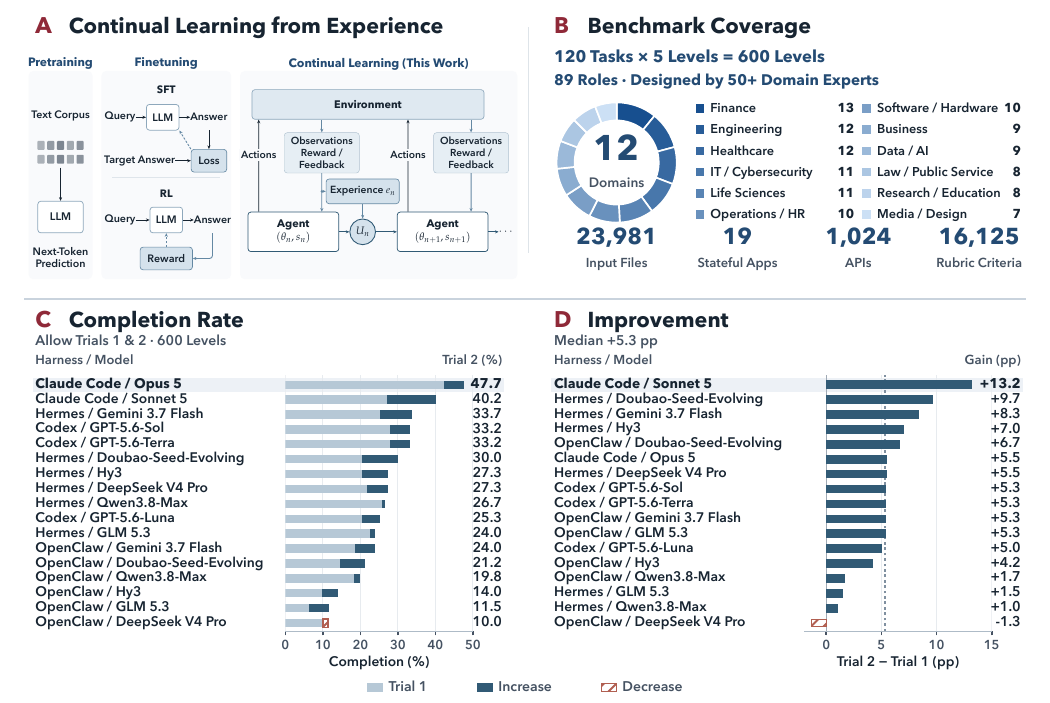
图1(CLE at a Glance):(A) 从预训练、微调到持续学习的学习范式对比——CLE 关注的是 Agent 与环境交互中不断积累经验 \(e_n\)、经更新算子 \(U_n\) 演化出 \((\theta_{n+1}, s_{n+1})\) 的过程;(B) 基准覆盖:120 任务 × 5 关 = 600 关,12 个领域、23,981 个输入文件、19 个有状态应用、1,024 个 API、16,125 条评分标准;(C) 17 个配置的完成率排行;(D) Trial 2 相对 Trial 1 的增益分布。
设计上我觉得有三个点最值得讲。
一是门控解锁,不攒经验就走不远。 Agent 必须通过当前关卡才能解锁下一关;在提交预算 \(K\) 内没过,这条阶梯直接终止,后面没摸到的关全部计失败。这个设计很狠——它把"持续学习"从可选项变成了硬约束。你第一关糊弄过去的那些坑,第三关会以更复杂的形式回来找你。
二是关卡之间的五种可迁移知识。 后一关不是新题,而是"同一个职业情境下的下一个任务",复用关系被作者拆成五类:工具与技能(之前学会的工具用法直接复用)、数据依赖(前面的产出是后面的输入)、策略(有效的方法复用、踩过的坑避开)、用户情境(交互中学到的用户偏好)、领域知识(专业规则在新要求下的应用)。坦白讲,这个分类法本身对做 Agent 产品的人就有参考价值——你设计记忆系统的时候,可以对照这五类检查自己的 memory 到底存了哪几种。
三是评分极其严苛。 全部 16,125 条人工编写的 checklist 条目,平均每关 26.9 条,每条都写明目标、预期结果和验证证据,全部满足才算过。评分文件和参考答案对 Agent 隐藏。评分由一个多轮评估 Agent 完成,在隔离的 Docker 容器里对照人工验证过的参考材料核验提交物(它是"对答案",不是"重做一遍")。评估器用 DeepSeek V4 Flash 实例化,与人类标注的条目级一致率达到 96.86%——这个数字让自动评分的可信度站得住。
看一个具体例子会更直观。

图5:一个五级任务示例——Ibex RISC-V 核的维护与验证。五个关卡共享同一个职业情境(硬件工程师维护开源 RISC-V 核),但每一关的目标和约束都在变,要求 Agent 把前几关积累的代码理解、验证流程和工具用法适配到新问题上。
数据质量这块,作者搭了一条"专家起草 → 评审 Agent 审计 → 两名随机分配的人类评审交叉评审"的双闸门流水线,任何一道闸门被拒就打回作者重写。50 多位专家(博士研究员、软硬件工程师、会计师、金融与运营分析师等)从自己的真实工作流里出题,这也是任务"职业味"很正的原因。
顺带提一下论文里一个我比较欣赏的概念辨析。标题里的 RSI(递归自我改进)被作者认真地和在线学习、test-time training、case-based reasoning 划清了界限:这三者都可以在固定的学习流程下运行,光用它们不构成 RSI;RSI 关注的是"改进后续改进本身如何被生成、评估或实现"的那种变化。作者还给了一个 T1 到 T5 的能力阶梯(从预定义规则学习一路到自主设定研究目标),指出 Claude Cowork、Codex 这类带记忆/技能工作流的系统提供了 T1 基础,而 Agent 自主选择保留什么经验已经透出一点 T2 的意思。这个分层有没有成为共识还不好说,但至少给"长程 RSI"这种大词安了一把可以量化的尺子。
🧪 实验:17 个配置,全军覆没式的成绩单
实验设置是 4 个 Agent harness × 11 个骨干模型,共 17 个配置:Claude Code(Opus 5、Sonnet 5)、Codex(GPT-5.6-Sol/Terra/Luna)、Hermes-Agent 和 OpenClaw(各接 Gemini 3.7 Flash、Doubao-Seed-Evolving、Qwen3.8-Max、Hy3、DeepSeek V4 Pro、GLM 5.3 六个模型)。120 条阶梯按固定顺序串行执行,跑两种 Trial:Trial 1 每关一次提交、无反馈;Trial 2 首次失败后给诊断反馈、允许修订后再交一次。
主结果表(Table 1)信息量很大,我把核心列整理如下:
| Harness | 模型 | T1 完成率 | T2 完成率 | T2 各级通过率(L1→L5) | T2 成本 |
|---|---|---|---|---|---|
| Claude Code | Opus 5 | 42.17% | 47.67% | 85.83 / 56.67 / 39.17 / 33.33 / 23.33% | $720.56 |
| Claude Code | Sonnet 5 | 27.00% | 40.17% | 74.17 / 48.33 / 34.17 / 25.00 / 19.17% | $506.30 |
| Codex | GPT-5.6-Sol | 27.83% | 33.17% | 65.00 / 38.33 / 26.67 / 18.33 / 17.50% | $210.83 |
| Codex | GPT-5.6-Terra | 27.83% | 33.17% | 68.33 / 40.83 / 25.83 / 18.33 / 12.50% | $83.16 |
| Codex | GPT-5.6-Luna | 20.33% | 25.33% | 56.67 / 30.83 / 19.17 / 11.67 / 8.33% | $33.53 |
| Hermes-Agent | Gemini 3.7 Flash | 25.33% | 33.67% | 62.50 / 40.83 / 30.00 / 19.17 / 15.83% | $394.84 |
| Hermes-Agent | Doubao-Seed-Evolving | 20.33% | 30.00% | 62.50 / 38.33 / 22.50 / 14.17 / 12.50% | $102.61 |
| Hermes-Agent | Qwen3.8-Max | 25.67% | 26.67% | 74.17 / 34.17 / 16.67 / 5.83 / 2.50% | $134.54 |
| Hermes-Agent | Hy3 | 20.33% | 27.33% | 60.83 / 35.00 / 19.17 / 11.67 / 10.00% | $16.18 |
| Hermes-Agent | DeepSeek V4 Pro | 21.83% | 27.33% | 55.83 / 33.33 / 20.00 / 14.17 / 13.33% | $96.51 |
| Hermes-Agent | GLM 5.3 | 22.50% | 24.00% | 62.50 / 30.00 / 15.00 / 7.50 / 5.00% | $102.58 |
| OpenClaw | Gemini 3.7 Flash | 18.67% | 24.00% | 59.17 / 32.50 / 15.83 / 6.67 / 5.83% | $212.33 |
| OpenClaw | Doubao-Seed-Evolving | 14.50% | 21.17% | 48.33 / 26.67 / 15.83 / 8.33 / 6.67% | $40.50 |
| OpenClaw | Qwen3.8-Max | 18.17% | 19.83% | 65.00 / 20.00 / 10.83 / 1.67 / 1.67% | $101.54 |
| OpenClaw | Hy3 | 9.83% | 14.00% | 37.50 / 12.50 / 7.50 / 6.67 / 5.83% | $11.95 |
| OpenClaw | DeepSeek V4 Pro | 11.33% | 10.00% | 30.00 / 6.67 / 5.83 / 4.17 / 3.33% | $48.10 |
| OpenClaw | GLM 5.3 | 6.17% | 11.50% | 27.50 / 14.17 / 9.17 / 4.17 / 2.50% | $80.50 |
说实话,看到这张表的时候我停了几秒。最强的 Opus 5,Trial 2 也只过了 47.67% 的关,打穿全部五级的任务 120 个里只有 28 个(23.33%)。而 17 个配置的 Trial 2 累积通过率中位数,L1 还有 62.50%,到 L5 只剩 8.33%——阶梯越深,掉队越狠,这正是"不会从经验中学习"的直接证据。
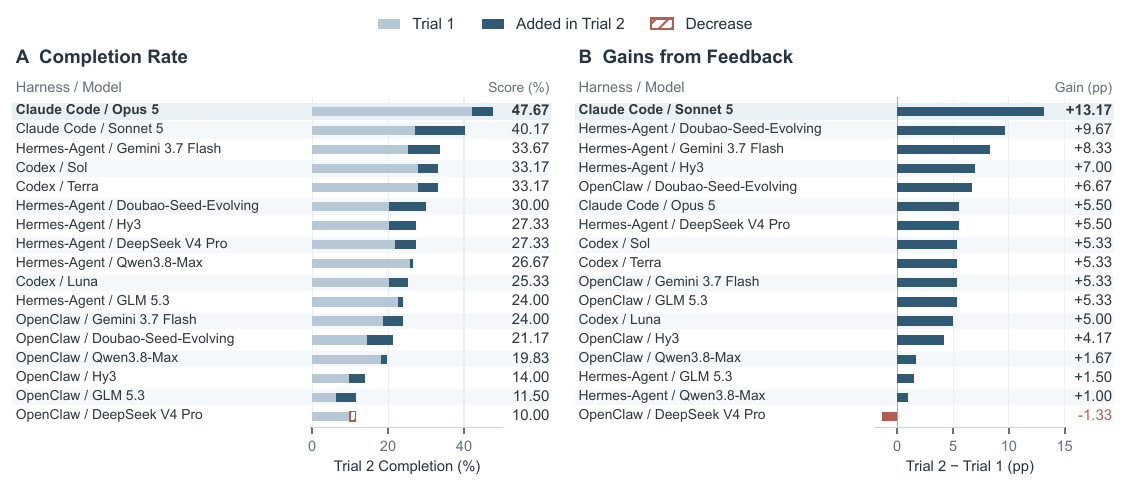
图9:左图是 17 个配置的 Trial 2 完成率排行(浅色为 Trial 1,深色为 Trial 2 新增部分);右图是按反馈增益排序——Claude Code + Sonnet 5 增益最大,达 +13.17 pp,而 OpenClaw + DeepSeek V4 Pro 是唯一倒退的配置(-1.33 pp)。17 个配置里 16 个有提升,中位增益 5.33 pp。
反馈增益这块有几个细节值得琢磨。增益最大的不是最强的 Opus 5(+5.50 pp),而是 Sonnet 5——从 27.00% 一口气涨到 40.17%,完整任务数从 8 个翻到 23 个。我的读法是:反馈修订对"中等生"的边际价值最大,强模型第一次提交就把容易拿的分拿了,留给反馈的空间反而小。另外两个 Qwen3.8-Max 配置在 L1–L3 有提升但 L4–L5 纹丝不动——反馈能帮它修当前关的错,却帮不了需要跨关经验沉淀的深水区。这个分化现象其实比平均增益本身更有信息量。
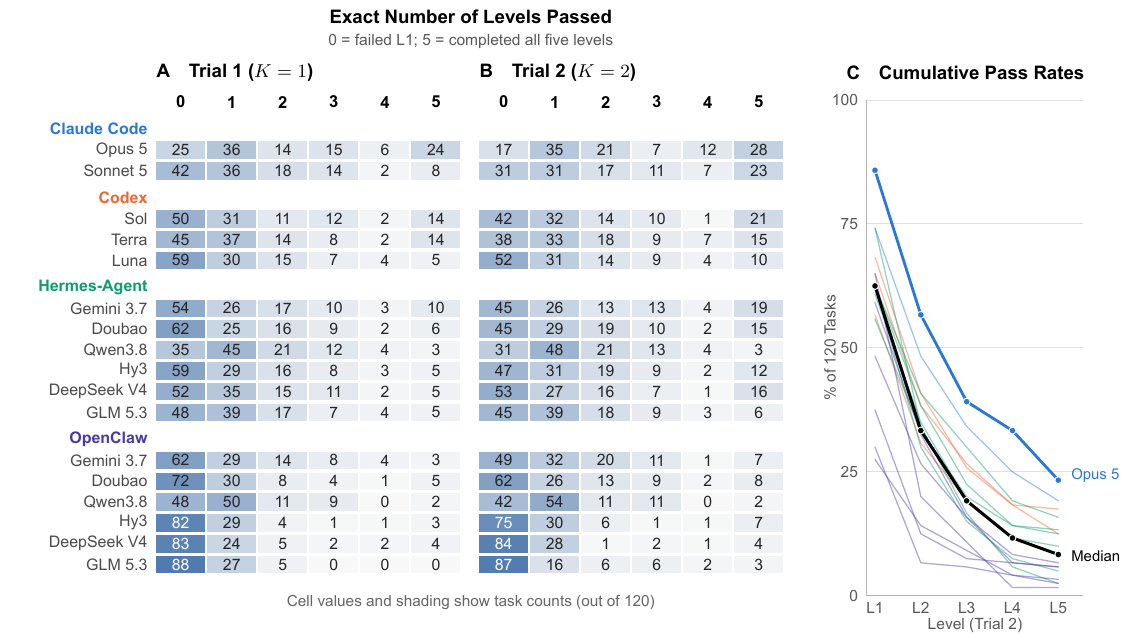
图13:(A-B) Trial 1 和 Trial 2 中各配置"恰好通过 n 关"的任务数分布(0 表示第一关就挂了);可以看到 OpenClaw + GLM 5.3 在 Trial 1 有 88 个任务卡在 0 关。(C) Trial 2 的累积通过率曲线:蓝色高亮的是 Opus 5,黑色粗线是中位数——中位数曲线从 L1 的约 62% 一路俯冲到 L5 的约 8%。
还有一张相邻关卡的条件推进率(Figure 14,过了 Lk 的任务里有多少能过 Lk+1),以及分级反馈增益热力图(Figure 15),都指向同一个结论:关卡越靠后,经验复用的权重越大,而现有系统恰好在这里最弱。

图14:每个单元格表示"通过 Lk 的任务中通过 Lk+1 的百分比"。可以直观看到阶梯越深,条件通过率越低。

图15:各级 Trial 2 相对 Trial 1 的通过率差值热力图(蓝为提升,红为下降)。反馈增益集中在前几关,深层关卡多数配置几乎无增益。
🔬 Harness 对比与成本账
同一个模型放进不同 harness,差距能有多大?CLE 给了干净的对照:6 个共享骨干上,Hermes-Agent 全面优于 OpenClaw,平均优势从 Trial 1 的 9.56 pp 扩大到 Trial 2 的 11.42 pp(平均完成率 28.17% vs 16.75%)。最典型的反例是 DeepSeek V4 Pro:在 Hermes-Agent 里反馈带来 +5.50 pp,在 OpenClaw 里反而 -1.33 pp——同一个脑子,换套脚手架,反馈从助力变成了干扰。
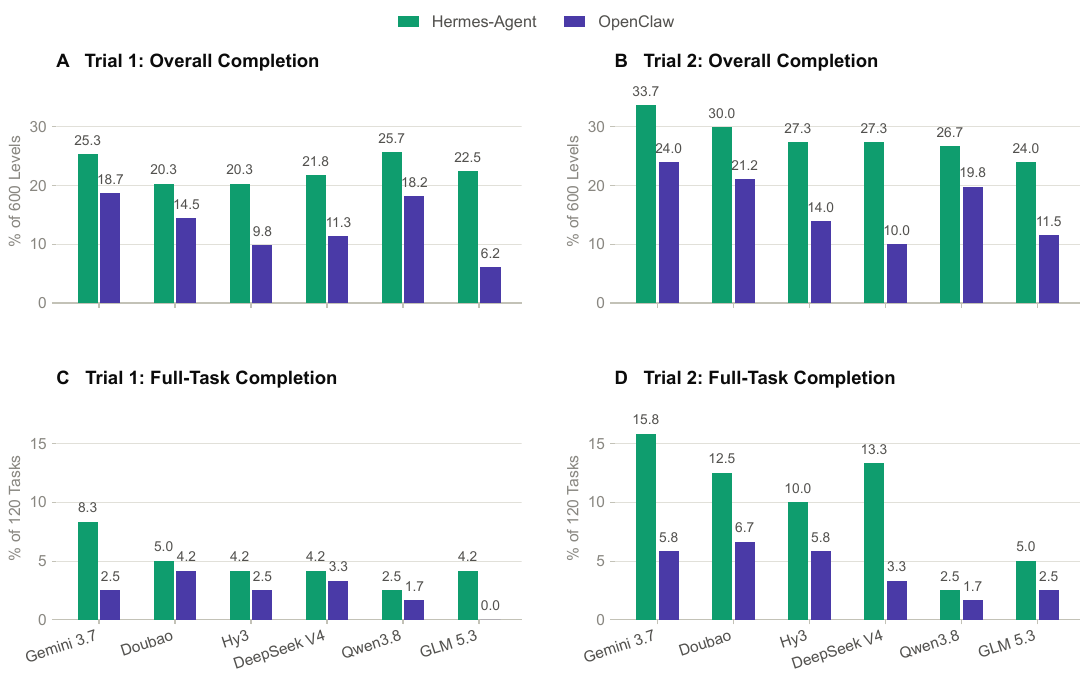
图16:Hermes-Agent(绿)与 OpenClaw(紫)在六个共享模型上的对比。(A-B) 600 关总完成率,(C-D) 120 任务完整通过率。无论 Trial 1 还是 Trial 2,绿色柱子全面压过紫色。
我的第一反应是:harness 的工程差距,可能比模型代差更被低估。你想想看,大家平时吵模型谁强谁弱,但在持续学习这个维度上,记忆怎么存、反馈怎么消化、技能怎么沉淀——这些 harness 层的决策直接决定了 10 个点上下的差距。
成本账也算得很清楚。
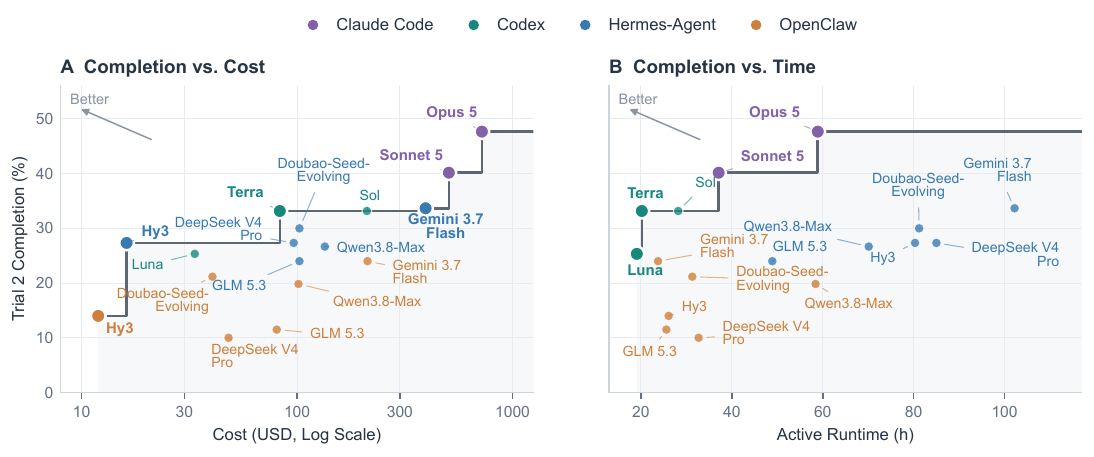
图10:(A) 完成率对成本(对数轴),(B) 完成率对运行时长;颜色区分 harness,阶梯状粗线标出 Pareto 前沿。Opus 5 在最右上,Terra、Luna、Hy3 等占据着各自的性价比位置。
几个有意思的点:Codex 家的 Terra 和 Sol 完成率打平(都是 33.17%),但 Terra 只要 $83.16 / 20.2 小时,Sol 要 $210.83 / 28.2 小时——不过 Sol 完整打通的任务数更多(21 vs 15),便宜是有代价的。Hermes-Agent + Hy3 用 $16.18 拿到 27.33%,站在成本-完成率的 Pareto 前沿上,代价是要跑 80.3 个小时。Claude Code + Opus 5 的 $720.56 和 520.62M token 则是另一个极端——全榜最贵,但确实最强。
💡 我的判断
这篇论文最值钱的地方,不在于它提出了什么新方法——它一个方法都没提——而在于它把"Agent 的持续学习"从一句口号变成了一套没法糊弄的数字。47.67% 和 23.33% 这两个数,估计会被接下来一两年的 Agent 记忆/技能系统论文反复引用当靶子。
几个批判性的观察,坦白说:
第一,"反馈+修订"的增益其实相当有限。 中位 5.33 pp,而且主要集中在浅层关卡。论文把 Trial 1 vs Trial 2 设计成联合评估"诊断反馈 + 额外一次机会",没有拆开——多出来的提升到底是反馈的功劳还是单纯"多试一次"的功劳,分不清楚。作者自己也承认了这点,建议未来做"每任务前重置 harness 知识状态"的对照实验来分离跨任务知识保留的贡献。这个坑留给后续工作了。
第二,门控解锁是一把双刃剑。 它让"经验"变成必需品,但也意味着早期关卡的偶发失败会级联放大——一个本来能做 L5 的系统可能因为 L2 翻车被整体判死刑。0 关任务数那么多的配置(OpenClaw + GLM 5.3 有 88 个任务第一关就挂),到底是"不会学"还是"起手就菜",这个基准分不开。不过作者支持 block-based 评估(可以从中间关卡起跑、人工准备前置工件),算是留了补救口子。
第三,评估器依赖另一个 LLM。 96.86% 的条目级一致率不错,但那剩下的 3% 多落在 16,125 条 rubric 上就是几百条的判分噪声,而且"全对才算过"的规则会把误判放大。这不是这篇论文独有的问题,整个 Agent 评测圈都在往 LLM-as-judge 走,只是值得留个心眼。
还有一点我得承认没完全看懂:论文说这套数据可以用于后训练来增强持续学习能力,但 600 关、16,125 条 rubric 的训练信号怎么设计、会不会和评测集污染打架,正文里着墨不多。这块要看后续工作。
对工程实践的启发,我倒觉得比论文结论更直接:如果你在做 Agent 的记忆系统,CLE 的五类可迁移知识(工具技能、数据依赖、策略、用户情境、领域知识)是一份现成的检查清单;如果你在为选 harness 纠结,Hermes-Agent vs OpenClaw 这 11 个点的差距说明脚手架的记忆与反馈机制值得认真对待;而"反馈对中等生帮助最大"这个发现,提示我们在产品里做失败诊断反馈时,别只盯着旗舰模型调优。
收尾
CLE 给出的画面很清晰:今天的前沿 Agent 是"一次性高手"——单次任务能打,长线学习不行。600 关的职业大考,最强的也只拿到不到一半的分数。从"会做"到"会学",中间隔着的不是更大的模型,而是一套我们还没真正造出来的经验沉淀机制。这个榜单大概率会成为下一代 Agent 记忆系统的试金石,值得关注。
如果你也在做 Agent 相关的系统,建议把论文里 Table 1 和 Figure 13 翻出来仔细看看——哪些关卡在批量倒下,往往就是你的产品下一步要补的课。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我