OPST:不给题目也不给答案,只扔几个主题词,模型居然自己把自己练强了
做后训练的人都绕不开一个现实问题:数据从哪来?SFT 要人工写的参考答案,RLVR 要 gold answer,哪怕是最新的 on-policy self-distillation(OPSD),不用外部强 teacher 了,也得给它一份人工整理好的题目集和标准答案当"特权信息"。标注一个数学语料库就要约 80 万条人工步骤标签(Lightman et al., 2024),OpenAssistant 那种指令集背后是 1.3 万志愿者的人力堆出来的。
这篇论文把这个依赖推到了极限:连题目都不给。只给模型几个粗粒度的主题词,比如"抽象代数"、"常识因果推理",剩下的事——出题、写答案、判卷、训练——全由模型自己完成。结果 Gemma 4 E2B 在 MMLU 上直接涨了 10.2 个点,多模态版本只用无标注图片就在 VQAv2 上提升 6.9 个点。说实话,看到这个设定我的第一反应是"这不可能 work",自产自销的数据训练自己,不就是在噪声里打转吗?但消融实验做得相当扎实,有几个发现确实值得细聊。
核心摘要:这篇论文提出 On-Policy Self-Training(OPST,arXiv: 2610.32770),把 on-policy self-distillation 改造成一个完全无数据的自训练框架——模型只靠主题描述词自己出题、自己生成特权推理信息,经过伪验证和难度门控过滤后,用一个 EMA teacher 做 token 级自蒸馏。在 Gemma 4 E2B/E4B 上,OPST 在同样的合成数据上比 SFT 高 5.6 个点、比 GRPO 高 6.3 个点(2B 无 thinking 设定平均分),甚至追平了用人工标注答案的 Supervised OPSD。我的判断:这不是一个刷榜工作,而是对"自监督后训练的监督下限在哪"的一次认真试探,方法本身比数字更有价值。
论文信息
- 标题:On-Policy Self-Training: Data-Free Self-Improvement in Large Language Models
- 作者:Leon Sick, Lukas Hoyer, Yannick Strümpler, Christian Reisswig, Timo Ropinski, Federico Tombari
- 提交日期:2026 年 10 月 23 日
- 链接:https://arxiv.org/abs/2610.32770
📖 问题的来龙去脉:监督信号一直在"搬家",从没被消灭
先盘一下这条技术线,因为 OPST 的定位只有放在这条线上才看得清楚。
| 方法 | 需要什么人工监督 |
|---|---|
| SFT | 题目 + 参考答案 |
| RLVR | 题目 + gold answer(用于验证) |
| OPD(on-policy distillation) | 题目 + 更强的 teacher 模型 |
| OPSD | 题目 + 特权上下文(通常是标准答案) |
| 自训练(STaR、ReST 类) | 人工整理的问题集 |
| OPST | 只要几个主题词 |
看出来了吗?每一代方法都在把监督往后挪一步,但问题集本身一直是人工准备的。哪怕是 STaR 这类自训练方法,模型只是解答别人出的题,"出哪些题"这个决定权还在人手里——而选题本身就决定了模型能学什么。
OPST 的回答很干脆:语言模型既然能解题,为什么不能出题?顺着这个思路,外部供给的东西就只剩主题描述了。
🏗️ OPST 的三板斧:出题、过滤、自蒸馏
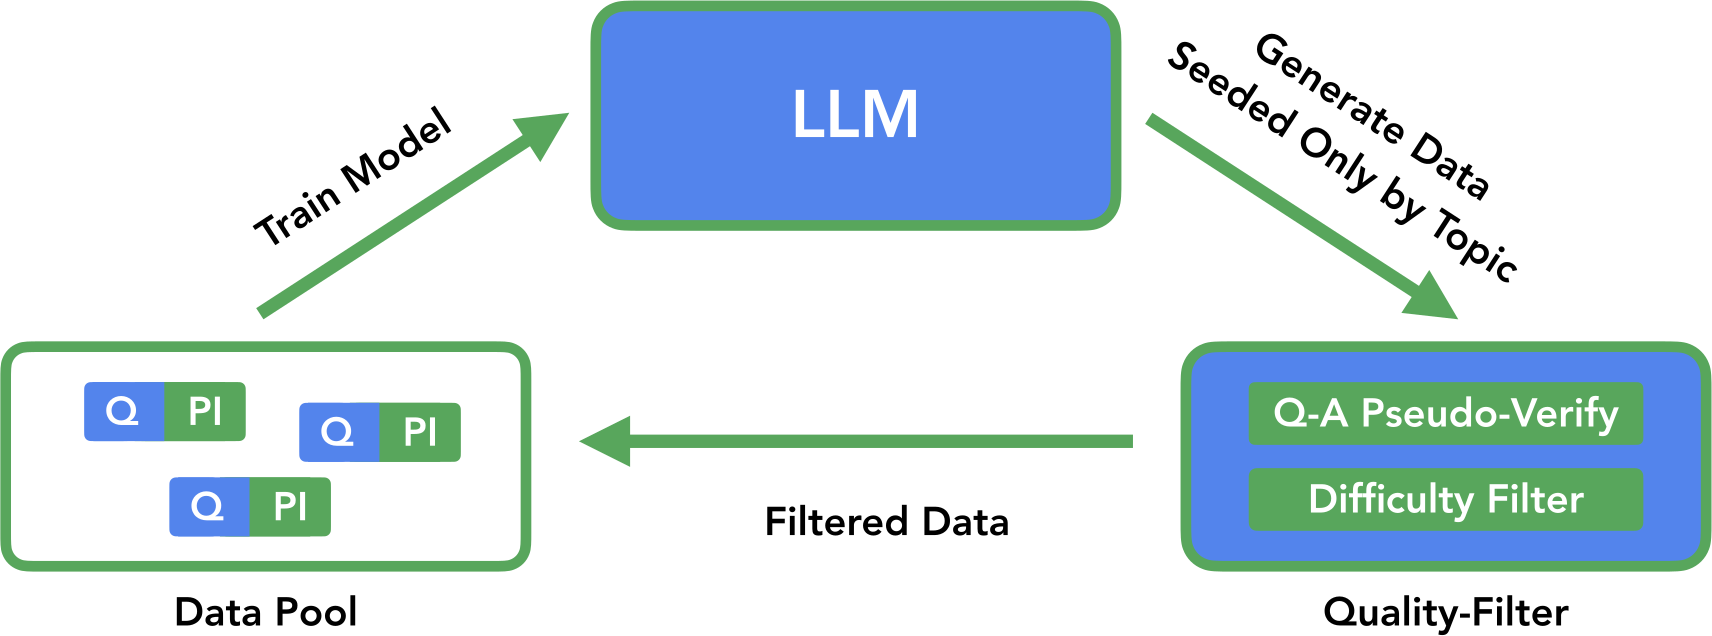
图1:OPST 的完整循环。模型只被主题词播种,生成并过滤自己的问答对,然后通过特权 EMA teacher 的 on-policy 自蒸馏来训练,不断迭代实现无数据自我提升。
整个流程就是一个三角循环:LLM 生成数据 → 质量过滤器(Q-A Pseudo-Verify + Difficulty Filter)→ 过滤后的数据进数据池 → 训练模型 → 更强的模型生成更好的数据。每一步都有讲究,拆开说。
出题:主题词播种的课程生成
给模型一个主题 \(\tau\)(比如"Abstract Algebra"),生成器 \(\pi_{gen}\) 一次性产出一个问题 \(x\) 和特权信息 \(z=(r,a)\),\(r\) 是推理过程,\(a\) 是候选答案:
注意一个关键设计:学生和 teacher 看到的东西不一样。学生只看问题 \(x\),teacher 多看一份特权信息 \(z\)。这个信息不对称是整个方法的发动机,后面细讲。
生成器可以是初始模型的冻结副本,也可以是 EMA teacher——后者让数据质量随训练一起提升,形成正循环。
过滤:两道方向相反的闸门
自己出的题质量肯定参差不齐,这是这个方法最大的软肋。OPST 的对策是两道方向相反的过滤器:
伪验证(Pseudo-Verification)——保证题目是"良构"的。 让生成器在一个全新上下文里、不带有出题时的意图、低温度下重新解这道题,要求解出的答案和候选答案一致:\(\hat{a}(x) = a\)。这一步把"出题"和"解题"分开——一道表述有歧义的题,出题时照样能自信地给个答案,但换个上下文重新解就露馅了。还不够,再把题目改写成 \(x'\),要求改写后答案不变:\(\hat{a}(x') = a\)。一道良构的题,换个说法答案不该变。两条都过才保留:
共识门控(Consensus Gate)——保证题目是"有信息量"的。 学生自己对每个通过验证的样本采样 \(G\) 条推理路径,如果所有 rollout 的答案都和候选答案一致(\(c(x,z)=1\)),说明这题学生已经稳会了,teacher 看了特权信息也给不出什么新东西,直接扔掉。
这两道闸门的设计挺巧妙的:伪验证留住的样本要"足够稳",门控丢弃的样本要"已经足够会",留下来的恰好是学生能力前沿上的题。而且门控是相对当前学生评估的,所以课程难度会随模型变强自动升级——这相当于一个免费的自适应课程学习。
训练:特权 EMA teacher 的自蒸馏
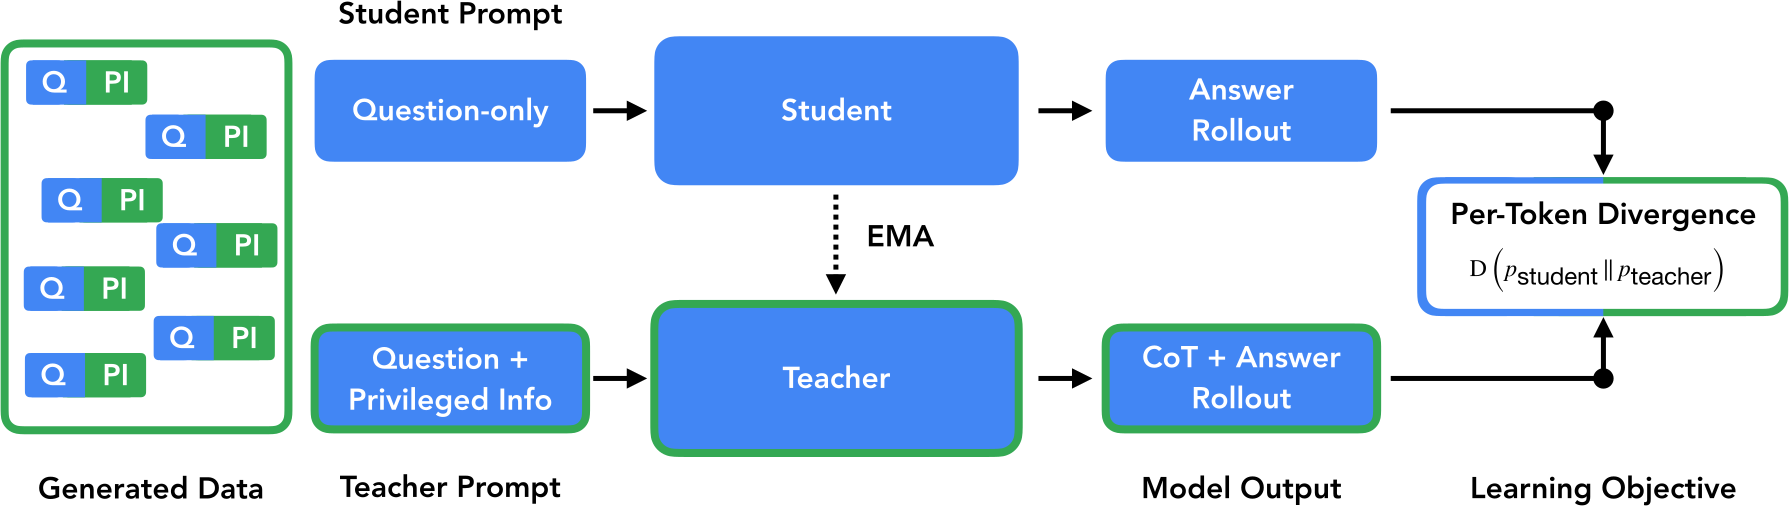
图2:训练细节。学生只看到问题(Question-only)并做 Answer Rollout;teacher 看到问题加特权信息(Question + Privileged Info)做 CoT + Answer Rollout;学习目标是在学生自己的轨迹上做逐 token 的分布匹配 \(D(p_{student} \| p_{teacher})\)。teacher 是学生的 EMA。
训练目标沿用 OPSD 的框架:学生在自己的 rollout 轨迹上,逐 token 匹配 teacher 的分布。散度用的是带偏斜的 Jensen–Shannon 散度,\(\alpha=0.8\) 偏向 mode-seeking 一侧:
为什么不用裸 KL?论文给了个很实在的理由:JS 散度有上界(被二元熵 \(H(\alpha)\) 封住),所以合成提示里那些局部瑕疵——某个 token 上 teacher 分布给了近零概率——不会主导梯度。处理噪声数据时这个性质很要紧。
这里的核心论点值得单独拎出来:把生成的答案当训练目标(SFT)或奖励信号(RL),监督质量就被生成质量封顶了;但把它当 teacher 的上下文,teacher 会从自己的参数知识里补全省略的推理步骤,产出比答案本身更丰富的 token 级监督。一句话——答案当"提示"用,比当"标准"用值钱。
teacher 用 EMA 更新:\(\phi_k = (1-\beta)\phi_{k-1} + \beta\theta_k\)。\(\beta=1\) 时一个噪声 batch 立刻污染后续所有目标,错误自我强化;EMA 把波动平均掉,只有跨 batch 稳定存在的改进才能进入这个循环。这跟视觉自监督里的 momentum teacher(DINO 那一系)是一个思想。
多轮迭代与多模态扩展
单轮受限于初始模型的出题质量,所以迭代 \(N\) 轮:每轮重新生成数据、去掉和以往轮次重复的题、继续训练。teacher 变强后,下一轮出题更准、验证更可靠、监督更密——三个环节同时受益。
多模态版本(Visual OPST)用无标注图片替代部分播种:给图 \(I\) 加视觉主题词("空间关系"、"物体计数"之类)出题,特权信息用场景 caption 或检测出的空间关系,验证换成在 \(K\) 个增广视图(颜色抖动、缩放、随机裁剪;水平翻转特意排除,因为会改变左右类问题的答案)上求解并统计答案一致性。这个排除水平翻转的细节说明作者真的想过这个问题,不是拍脑袋搬过来的。
🧪 实验:数字说话
同样的合成数据,OPST 碾压 SFT 和 GRPO
Table 1 是最干净的一组对比——所有方法用完全相同的自生成数据,差别只在怎么用候选答案:
| Gemma 4 E2B 无 thinking | 信号类型 | MMLU | GPQA | HellaSwag | 平均 |
|---|---|---|---|---|---|
| Base | — | 37.5 | 28.8 | 48.7 | 38.3 |
| + SFT(答案当目标) | Dense Target | 38.3 | 30.8 | 50.8 | 40.0 |
| + GRPO(答案当奖励) | Sparse Reward | 37.3 | 30.3 | 50.3 | 39.3 |
| + OPST(答案当 teacher 上下文) | Dense Context | 47.7 | 32.8 | 56.2 | 45.6 |
平均分:SFT 涨 1.7,GRPO 涨 1.0,OPST 涨 7.3。同样的数据,SFT 和 GRPO 几乎榨不出东西,OPST 翻了四倍多。这个对比基本锁死了"答案当上下文 vs 当目标"这一个变量,说服力很强。
带 thinking 的设定下差距收窄但仍在:E4B 上 OPST 平均涨 4.7 个点(GSM8K 涨 8.6),SFT 只涨 0.9,GRPO 原地不动。
跨监督级别对比:追平全监督
Table 2 更有意思——把 OPST 放到监督强度的光谱上比:
| Gemma 4 E2B 无 thinking | 人工题目 | 人工答案 | 平均分(提升) |
|---|---|---|---|
| + Supervised SFT | ✓ | ✓ | 43.8(+5.5) |
| + Supervised OPSD | ✓ | ✓ | 46.6(+8.3) |
| + u-OPSD | ✓ | ✗ | 44.6(+6.3) |
| + R-Zero | ✗ | ✗ | 41.8(+3.5) |
| + OPST | ✗ | ✗ | 45.6(+7.3) |
几个值得琢磨的点:
- OPST 不要题目也不要答案,却超过了要人工题目的 u-OPSD(1.0 到 2.8 个点)和同监督级别的 R-Zero(1.4 到 5.2 个点)。这说明"人工整理的问题集"不是必要条件,提升来自训练方式而非数据。
- 2B 无 thinking 时,OPST 追回了 Supervised OPSD 增益的 88%(7.3/8.3);带 thinking 时,两个模型规模上都直接追平甚至反超(+0.2 和 +0.7 个点)。
一个完全自产自销的方法追平吃人工答案的方法——这是全文最硬的一个结论。
多领域混合与域外保持
Table 3 测试混合多个领域的主题词一起训练(E2B)。三个领域全混,域内平均涨 7.6 个点,只比单域单独训练低 1.0,说明领域间干扰很小。有个反直觉的发现:MMLU + GSM8K 混合训练,MMLU 涨 11.3 个点,比只用 MMLU 主题词(+10.2)还多——数学推理对通用知识有正迁移。甚至主题词完全不含 MMLU 时,MMLU 也涨了 5.1 个点,说明部分增益不特定于播种领域。
但域外保持不是全是好消息:三域混合时 MATH-500 掉了 4.9 个点。作者对此比较坦诚,没有藏着。我的看法:这说明"自训练不遗忘"这个卖点是有条件的,混合领域多了之后,数学这种结构差异大的能力还是会受损。
Visual OPST:只用无标注图片
| Gemma 4 E2B | VQAv2 Acc. | POPE F1 | POPE Acc. | POPE Rec. |
|---|---|---|---|---|
| Base | 49.1 | 82.2 | 83.2 | 72.9 |
| + Visual OPST(空间关系) | 55.7(+6.6) | 84.7(+2.5) | 85.1(+1.9) | 77.4(+4.5) |
| + Visual OPST(caption) | 54.0(+4.9) | 83.0(+0.8) | 83.9(+0.7) | 74.0(+1.1) |
| + Visual OPST(两者结合) | 56.0(+6.9) | 84.6(+2.4) | 85.0(+1.8) | 77.4(+4.5) |
2B 上两种特权信息结合效果最好;但 4B 上空间关系单独用反而最好(VQAv2 +3.7),两者不是稳定互补的——作者如实写了,这种不粉饰的态度我挺欣赏。POPE 的提升主要来自召回率(2B 涨 4.5,4B 涨 6.2),即模型更少漏报物体。
消融:每个部件都在干活
Table 5(E2B,MMLU):
| 样本选择 | MMLU |
|---|---|
| Base | 37.5 |
| 无过滤的 OPST | 42.7 |
| + 伪验证 | 45.4 |
| + 共识门控 | 47.7 |
伪验证贡献 2.7 个点,门控再贡献 2.3 个点,层层叠加有效。
| 特权信息 | MMLU |
|---|---|
| 无 | 40.6 |
| 安慰剂(同主题别题的答案) | 40.2 |
| 只有答案 | 44.6 |
| 只有推理过程 | 45.8 |
| 完整(推理+答案) | 47.7 |
这个 placebo 实验是全文我最喜欢的设计。给 teacher 换一个同主题但驴唇不对马嘴的答案,增益从 10.2 缩到 2.7——证明提升确实来自"这道题专属的"特权信息,而不是"随便给点上下文"的安慰剂效应。推理过程比答案本身更值钱(8.3 vs 7.1 个点的恢复量),呼应了前面的核心论点。
抗错答案能力(Table 5c):故意把 \(p\) 比例的候选答案换成错的。\(p=75\%\) 时,SFT 掉 5.7 个点、比 base 还差 4.4;OPST 只掉 1.9 个点,仍然高出 base 3.3。四分之三的答案是错的都不崩——这就是"答案当上下文"相比"答案当目标"的鲁棒性红利。
EMA 与迭代轮次(Table 6):\(\beta=1\)(无 EMA)时几乎不涨(38.1 vs 37.5 的 base),\(\beta=0.05\) 最好(47.7),EMA 是存亡级别的部件,不是锦上添花。轮次上 7 轮达到峰值 47.7,继续到 12、20 轮回落到 46.2 但不崩——错误会累积,但有 EMA 兜着不会失控。另外 EMA teacher 本身比学生准 1.8 个点,所以论文评估的都是 teacher。
🤔 我的判断:亮点和疑点都说说
最值钱的地方,我觉得不是 MMLU 涨 10 个点这个数字,而是 placebo 实验和抗错误答案实验这两组消融。它们把"为什么 work"讲清楚了:特权信息的价值在于样本特异性,以及上下文用法对噪声的天然免疫。这对所有做合成数据训练的人都有直接启发——如果你现在还在把模型生成的答案直接 SFT 回去,这篇论文给出了一个明显更好的用法。
疑点也有几个。其一,主题词虽然粗,但还是人工挑的,而且直接对标评测基准的领域(MMLU 主题词训完测 MMLU),这个"无数据"的成色要打个折——真正的 data-free 应该是连主题都不知道要测什么。其二,作者自己也承认,伪验证测的是自一致性而不是正确性,模型一致地错,错误照样进训练集——自训练的经典陷阱并没有被根治,只是被 EMA 和过滤缓解了。其三,实验只做到 4B 规模,这套自我增强循环在更大模型上会不会更快碰到能力天花板(毕竟它只能放大已有知识,不能凭空创造知识),是个开放问题。
和同期工作比,R-Zero、Self-Questioning 这类 self-play 方法走的是"出题当 RL 奖励"的路线,OPST 的差异点在于把出题时顺手产出的推理信息做成了密集监督而不是压成一个标量奖励——从信息利用效率上讲,这个选择是聪明的。
工程启发:如果你手头的场景是"有大量无标注输入、标注成本高"(比如垂直领域的 VQA、内部知识问答),OPST 的配方——主题词播种 + 改写验证 + 共识门控 + EMA teacher 自蒸馏——基本是开箱即用的 checklist。特别是 placebo 对照和错答案压力测试这两个实验设计,值得抄到自己的合成数据管线里当质检工具。
但还有一个更本质的问题没解决:当模型的自一致性错误恰好落在人类知识盲区时,这套机制就是在给幻觉打蜡。工具验证或检索接地(作者也提了)恐怕是下一步绕不开的方向。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我