层级多智能体怎么端到端训练?这篇论文给 Searcher 配了个"蒸馏教练"
你有没有想过一个问题:一个 Agent 团队一起做任务,最后只拿到一个"对/错"的结果,那中间干活的子 Agent 到底该怎么奖励?
Leader 派活、Searcher 查资料、Answerer 写答案——最后答案对了,是 Leader 任务分解得好,还是 Searcher 查的资料好,还是 Answerer 蒙对了?答案错了又该怪谁?这就是多智能体强化学习里最经典的信用分配难题。最近阿里和浙大的一篇论文(arXiv:2610.23234)给出了一个我觉得挺漂亮的解法:先用一个简单工作流训出一个"教练",再让教练用逐 token 蒸馏的方式指导团队里的 Searcher,而 Leader 和 Answerer 继续吃最终结果的奖励。
核心摘要
层级多智能体系统(Leader 分派任务、子 Agent 执行)联合训练的核心障碍是:最终答案只给子 Agent 提供间接反馈,而 LLM 评委打的分又依赖评委自身的判断力,噪声大、粒度粗。MultiAgent-OPD 的思路是把 on-policy 蒸馏(OPD)嵌进端到端 RL:先在简单的 Searcher–Answerer 级联工作流里用答案正确性训出一个 Teacher,再在团队训练中冻结它,让它对学生 Searcher 生成的搜索和摘要 token 打分,提供逐 token 的局部过程监督;Leader 学自团队成败,Answerer 学自候选答案正确性。在 7 个问答数据集上拿到 38.68% 的 macro avg@4,比 Prompted Critic 高 4.06 个百分点,比训练过的级联系统 C-MAS + RL 高 2.61 个百分点。我的判断:这不是底层算法突破,而是"给不同角色匹配不同性质的学习信号"这个设计哲学的干净落地——但真正值钱的是它的消融实验,把"子 Agent 用结果奖励训练会崩"这件事用数据拍在了桌上。
📖 论文信息
- 标题:MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
- 作者:Yuhan Sun、Jiaxin Zhao、Yongdong Luo、Yibo Hu、Meiguang Jin、Junfeng Ma、Weixun Wang、Weihang Pan、Zhongan Bi
- 机构:Alibaba Group、Zhejiang University
- 链接:https://arxiv.org/abs/2610.23234
- 发布时间:2026 年 10 月 16 日(v2 于 10 月 20 日修订)
🎯 问题动机:团队奖励为什么这么难用
先把这个痛点说透。
现在主流的 Agent 系统——Claude Code、Codex、Kimi Code 这些——都是 Leader–Subagent 结构:主 Agent 拆任务、派活,子 Agent 干活交报告。系统搭起来不难,难的是怎么训练它们一起变强。
已有的路子大概三条:
- 只训 Leader,子 Agent 冻结。Kimi K2.5 的 PARL 就是这么干的。问题是子 Agent 的能力天花板被锁死,谈不上"联合进化"。
- 用最终答案奖励训所有人。听起来最直接,但论文的消融实验告诉你这条路会崩,而且崩得很难看——具体数据后面放。
- 引入 LLM 评委给子任务打分(M-GRPO 的路线)。思路对,但评委本身是个有偏、会推理出错的 LLM,而且一个标量分数对"一连串搜索决策"提供的指导太粗了。
MultiAgent-OPD 的观察是:三种角色跟最终结果的关系本来就不一样,凭什么用同一种信号训练?
- Leader 做的是协调决策,团队成功就是它该优化的目标——结果奖励天然对口。
- Answerer 的输出直接就是答案,正确性直接可评——结果奖励也够用。
- Searcher 不一样。它采集的是中间证据,证据的下游价值取决于别人用不用。一份好报告可能因为 Leader 没选中它而拿不到任何正反馈。
所以 Searcher 需要一个"懂行的人"在现场盯着它干活,而不是等终局开奖。这就是 Teacher 的由来。
🏗️ 方法核心:两阶段,三种信号
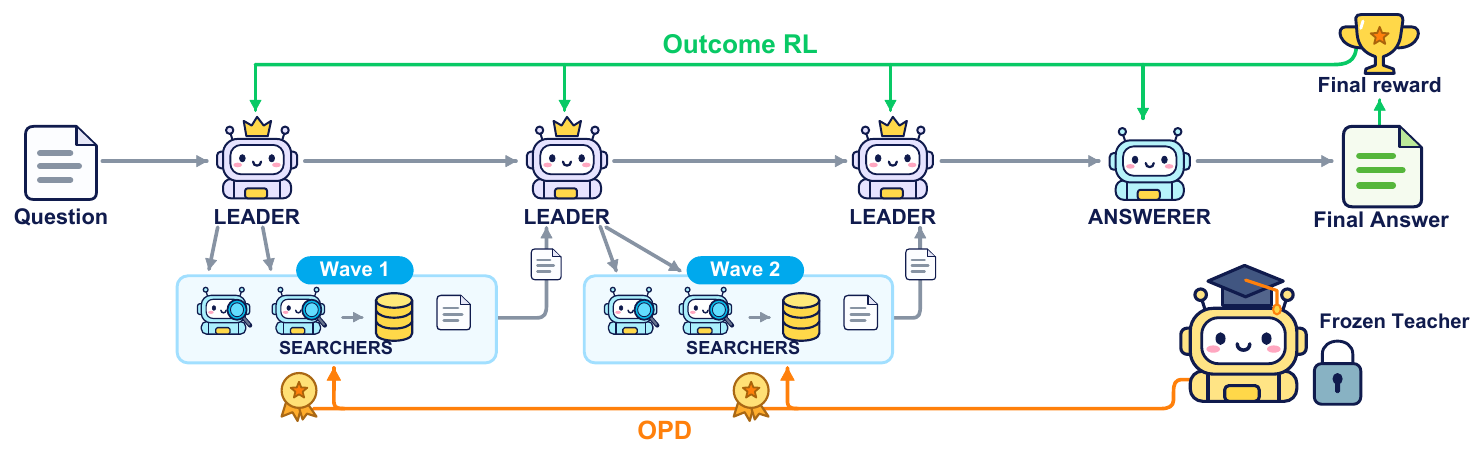
图1:整体框架。灰色箭头是工作流:Leader 分波次(wave)派出 Searcher、收集报告、挑选证据交给 Answerer。橙色线是从冻结 Teacher 出发的 OPD 反馈,训练 Searcher;绿色线是最终答案奖励,训练 Leader 和 Answerer。三个角色共享同一份模型参数。
整套训练分两个阶段。
Stage I:先训一个会搜索会总结的 Teacher
在一个更简单的 Searcher–Answerer 级联工作流里做 RL:Searcher 拿到原始问题、检索证据、写报告,Answerer 基于报告答题。奖励设计很轻:
其中 \(R_{\mathrm{EM}}\) 是团队级精确匹配(五个候选答案里有一个对就是 1),\(c_{i,j}\) 是每个候选答案自己的 EM 分数,\(b_{S,i}\) 是个行为小奖励——一步搜索后出摘要给 0.5,两步及以上给 1,否则 0,格式无效直接扣 1 分。直接说就是:大头压在答案对不对上,顺手用零头鼓励多搜几步。
训完冻结,这就是 Teacher \(\pi_T\)。同时这个 Stage-I 策略本身也被当作一个 baseline 来评测,就是后面的 C-MAS + RL。
Stage II:团队训练,角色各有信号
团队侧从指令微调基座 \(\pi_0\) 初始化(注意不是从 Teacher 热启动),用 GRPO 做组内相对优化。关键设计是每个 token 拿哪个 advantage,取决于它是哪个角色生成的:
Leader 的奖励是 \(R_{L,i} = 0.9\,R_{\mathrm{EM},i} + 0.1\,R_{\mathrm{assign},i}\),其中 \(R_{\mathrm{assign}} = \min(C_{\mathrm{tool}}, 6)/6\),给搜索活动一个有上限的奖金。Answerer 沿用候选正确性。两者还有系数 \(10^{-3}\) 的 KL 惩罚指向 Teacher。
重头戏是 Searcher 的 OPD advantage:
\(\beta = 0.01\),\(M_t\) 只在 Searcher 自己生成的 token 上为 1(检索回来的段落是环境写的,要 mask 掉)。直觉很简单:冻结 Teacher 在同一个历史 \(h_t\) 下给这个 token 的概率比学生高,log 比值为正,就往这个 token 的方向推一把。这是 sampled reverse-KL 蒸馏(GKD/MiniLLM 那一路)的梯度形式直接当 advantage 用。
这个设计有几个我很欣赏的细节:
- 每个 token 都有信号。哪怕这条轨迹最终答案错了、哪怕同一道题 G 条轨迹结果全一样(GRPO 在这里直接 advantage 清零),Searcher 照样收到反馈。信用分配的"颗粒度"问题被绕开了。
- 监督是 on-policy 的。Teacher 评的是学生当前策略生成的 prefix,Leader 改了任务分解方式,新 subtask 的轨迹照样能被打分。这比离线蒸馏一个固定数据集要跟得住。
- 接口不变性是 implicit 的复用基础。Searcher 在两个工作流里的接口完全一样——输入一个问题或子任务,输出一份报告——所以在原始问题上训出来的 Teacher,天然能给团队里跑 subtask 的 Searcher 打分。这个迁移来得几乎免费。
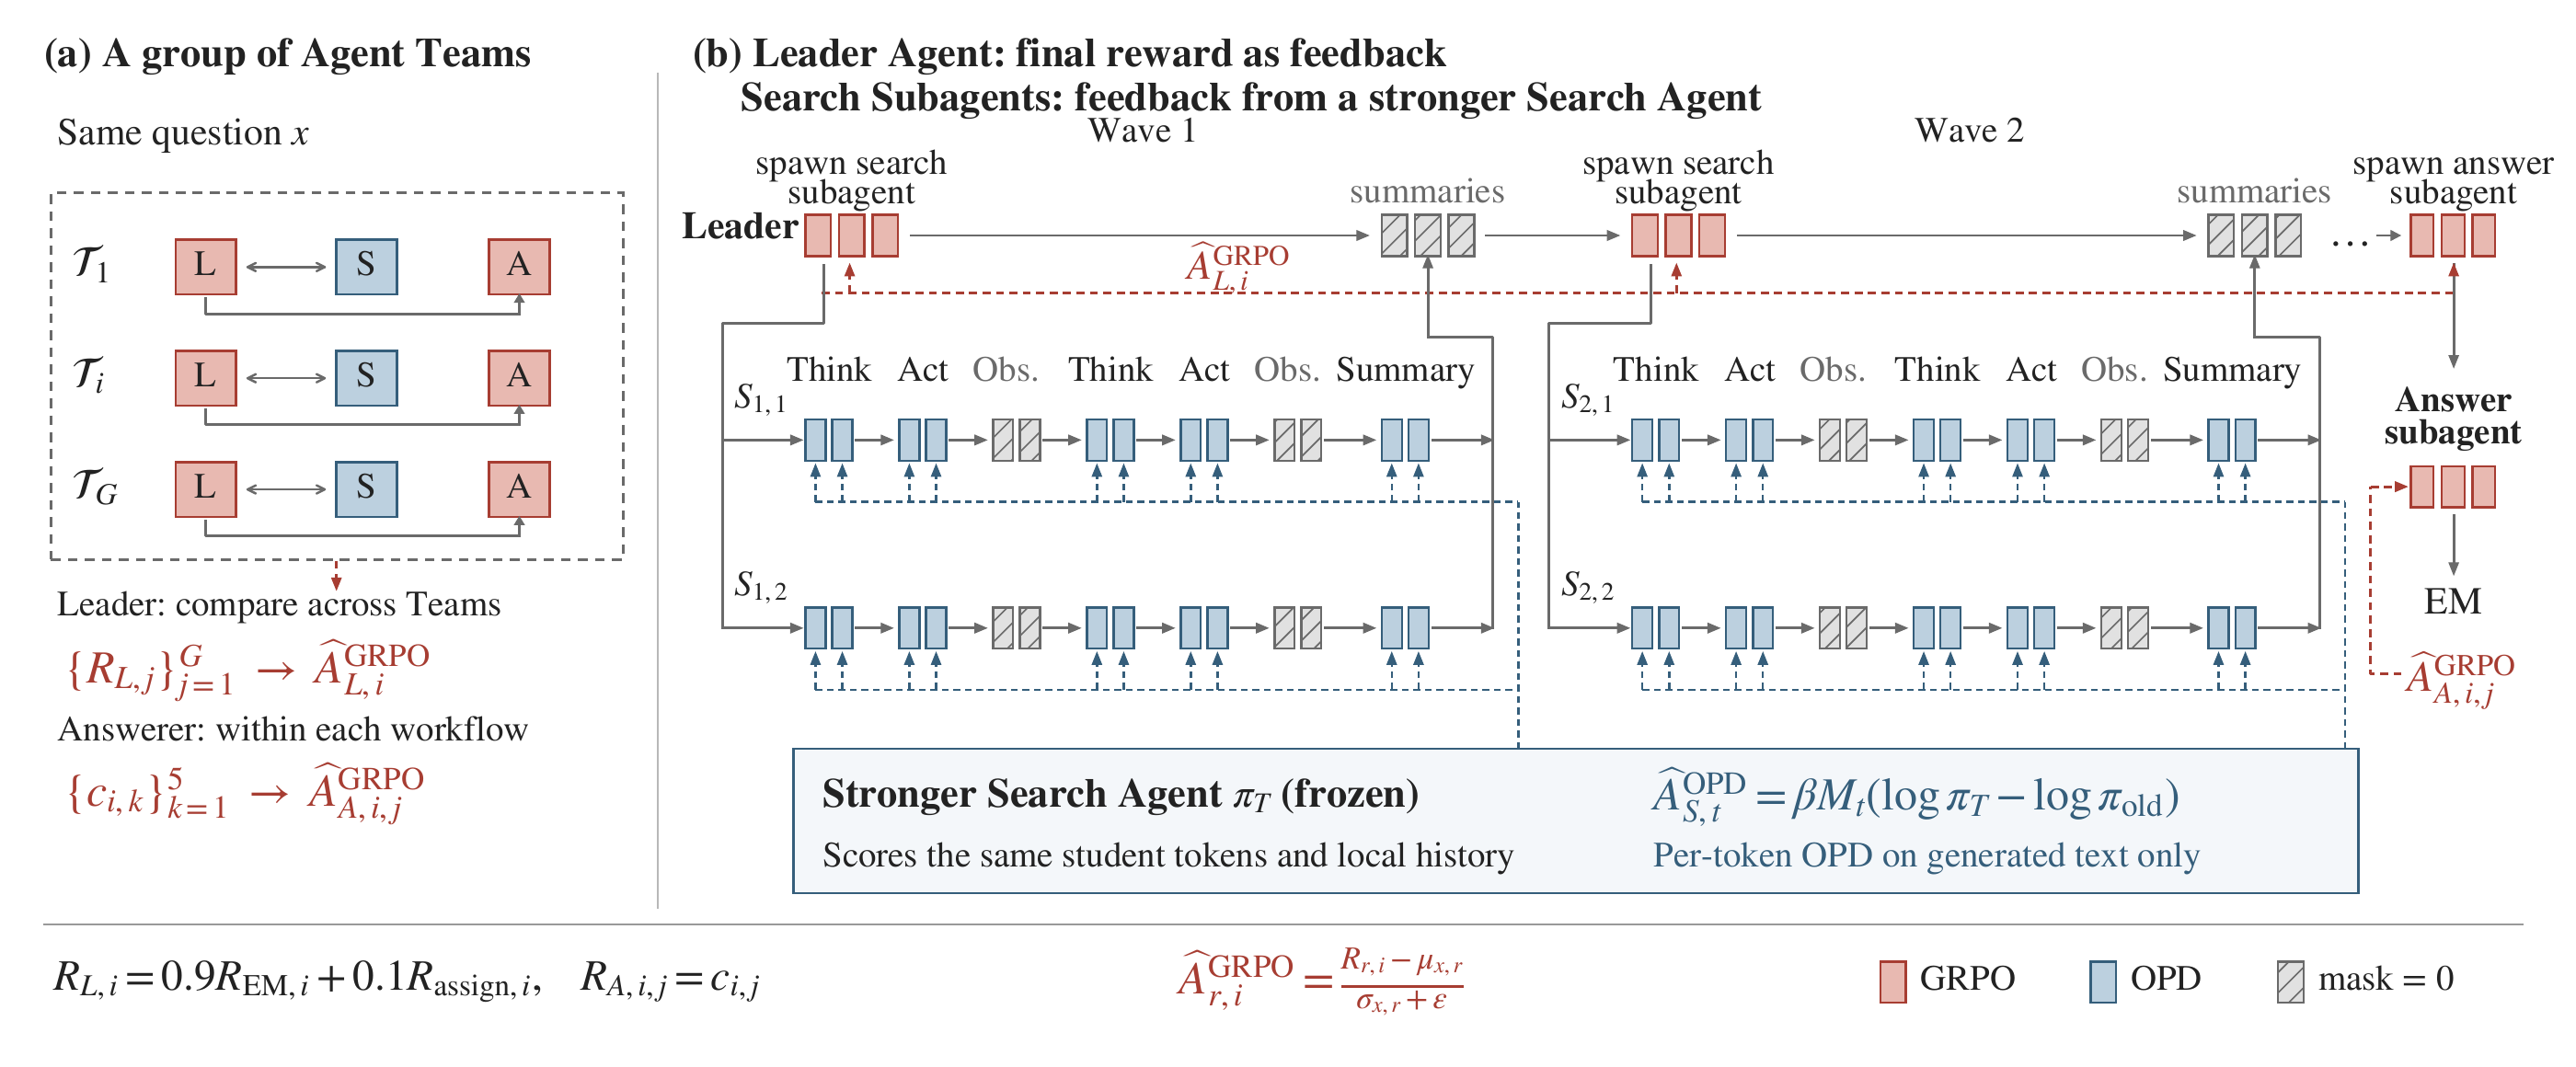
图2:(a)同一道题采样一组 Agent Team 轨迹,团队结果给 Leader 算 GRPO advantage,候选答案给 Answerer 在工作流内部算 advantage。(b)Leader 分波次派出并行 Searcher,每个 Searcher 走 ReAct 式轨迹(Think/Act/Obs./Summary),冻结 Teacher 在相同局部历史下用 teacher–student log 概率差给每个生成 token 打 OPD 权重;检索内容和回传的摘要在对应角色的 loss 里被 mask。
🧪 实验结果
设置
所有系统都建在 Qwen3-4B-Instruct-2507 上,接同一个检索器(每 query 返回 3 段)。训练用 NQ 和 HotpotQA,测试在 7 个基准的 5000 道固定题上:单跳的 NQ、TriviaQA、PopQA,多跳的 HotpotQA、2Wiki、MuSiQue、Bamboogle。每题跑 4 次,主指标是 macro avg@4(7 个数据集等权的四次平均正确率),辅以 pass@4(四次至少对一次)。
主实验
| 方法 | NQ | TriviaQA | PopQA | HotpotQA | 2Wiki | MuSiQue | Bamboogle | Macro avg@4 |
|---|---|---|---|---|---|---|---|---|
| C-MAS base | 30.0 | 50.9 | 25.6 | 23.6 | 12.9 | 6.3 | 26.4 | 25.09 |
| C-MAS + RL | 43.7 | 60.2 | 33.9 | 33.3 | 30.5 | 11.5 | 39.4 | 36.07 |
| H-MAS base | 30.7 | 49.8 | 23.2 | 27.1 | 22.6 | 9.7 | 37.2 | 28.60 |
| Prompted Critic | 37.4 | 56.9 | 28.5 | 33.1 | 33.9 | 11.5 | 41.0 | 34.62 |
| MultiAgent-OPD | 42.3 | 62.5 | 33.6 | 37.5 | 34.0 | 14.0 | 46.8 | 38.68 |
| Search-R1 | 41.1 | 58.4 | 32.8 | 34.0 | 32.1 | 8.1 | 27.2 | 33.39 |
| DeSA | 35.9 | 61.4 | 35.9 | 36.6 | 33.0 | 13.5 | 42.4 | 36.96 |
| Tree-GRPO | 38.6 | 60.5 | 36.3 | 36.8 | 32.8 | 12.2 | 44.4 | 37.37 |
| MemSearcher | 37.8 | 59.0 | 36.8 | 36.5 | 38.3 | 13.3 | 36.0 | 36.81 |
| Dr. MAS | 34.2 | 60.5 | 35.4 | 36.5 | 30.6 | 13.2 | 38.4 | 35.54 |
表1:avg@4 主实验结果(%)。上块是级联/层级系统,下块是五个 RL 搜索 Agent baseline。
几个值得咂摸的点:
- 38.68 vs 36.07 vs 34.62。MultiAgent-OPD 对 Prompted Critic(M-GRPO 式的"团队奖励 + 评委打分")的领先是 4.06 个点,bootstrap 95% 置信区间 [+2.98, +5.12],不碰零,这个领先是实的。对 C-MAS + RL 的区间 [+1.49, +3.73] 同样显著。
- 对 RL 搜索 Agent 的领先不大:最强的 Tree-GRPO 是 37.37,只差 1.31 个点。这里没有置信区间对比,我倾向认为这个差距在噪声边缘。不过层级系统在 Bamboogle 上 46.8 vs 44.4、pass@4 上 48.73 vs 47.53,一致性好一些。
- 有个有趣的负面对照:C-MAS + RL(36.07)其实比 Prompted Critic(34.62)高。一个简单级联工作流认真训,比层级系统配个 prompted 评委要强。这反过来说明评委质量是那条路线的真瓶颈,也铺垫了 OPD 用"任务训出来的 Teacher"替代"提示词评委"的动机。
消融:这部分是全文的精华
| 变体 | Macro avg@4 | Macro pass@4 |
|---|---|---|
| MultiAgent-OPD(完整) | 38.68 | 48.73 |
| w/ outcome-based Searcher RL | 17.78 | 22.79 |
| w/ base-model teacher | 29.50 | 40.86 |
| w/o direct Searcher supervision | 29.82 | 39.86 |
表2:诊断对比。所有变体都保留 Leader 和 Answerer 的目标,只动 Searcher 侧。
说实话,看到第一行变体的时候我愣了一下。
w/ outcome-based Searcher RL:把 Searcher 的 OPD 换成最终答案的 GRPO advantage,macro avg@4 从 38.68 直接掉到 17.78——比不训练的 H-MAS base(28.60)还低 10 个多点。更惊悚的是行为层面的崩溃:20000 条测试工作流里,一条搜索动作都没发生,尽管 99.51% 的轨迹还在生成子任务和报告、99.03% 还在输出最终答案。模型学到了一个退化策略:搜索这个动作对奖励没有可区分的贡献,干脆不搜了,反正报告和答案照写。
这就是"最终奖励训子 Agent"这条路线的实证死刑判决。不是效果差,是检索行为直接被训没了。
w/ base-model teacher:OPD 框架不变,只是把 Teacher 换成没经任务训练的基座指令模型。38.68 → 29.50,七个数据集全面下降。这说明蒸馏的来源必须是"真的会干这个活的策略",而不是随便一个语言建模能力强的模型。蒸馏蒸馏,总得先有东西可蒸。
w/o direct Searcher supervision:不给 Searcher 任何直接 loss,只靠 Leader/Answerer 的更新通过共享参数间接带动。38.68 → 29.82。共享参数耦合确实能传点东西,但远不如显式的过程监督。
三个消融合起来讲了一个完整的故事:Searcher 需要直接监督(不然掉到 29.82),这个监督不能来自最终奖励(不然行为崩溃到 17.78),也不能来自不懂任务的 Teacher(不然只有 29.50)——必须来自任务训出来的 Teacher 的逐 token 蒸馏。逻辑链是闭环的。
训练动态与成本
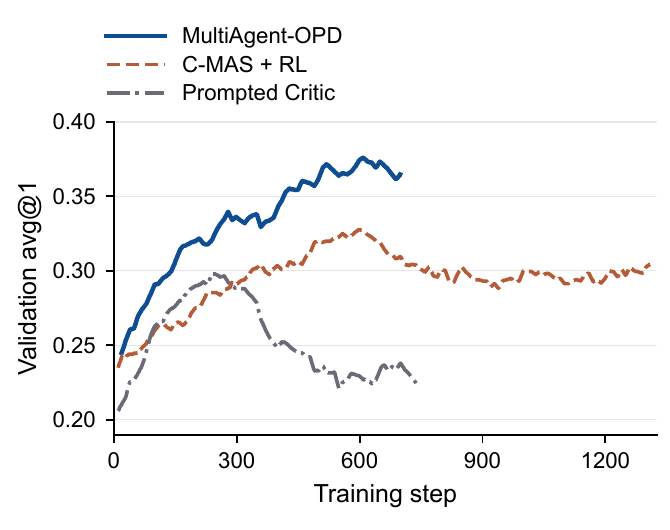
图3:训练期验证 avg@1 曲线。MultiAgent-OPD(蓝实线)一路爬升到 0.37 附近;C-MAS + RL(橙虚线)在 0.33 左右见顶回落;Prompted Critic(灰点划线)早期上升后持续下滑到 0.22 附近,典型的评委信号不稳导致的退化。注意横轴是训练步数不是算力,且只有单 run,不代表种子间方差。
成本侧也交代得比较诚实(图4 的三个子图分别对 search actions、输入 token、输出 token 画准确率–成本关系):MultiAgent-OPD 每条工作流用 5.39 次搜索动作和 9172 个输入 token,比 Prompted Critic(4.45 次、6786 token)分别高 21.4% 和 35.2%,但输出 token 反而从 885 降到 697。精度的提升是拿更多搜索和输入处理换来的,作者没有藏着这一点。另外 C-MAS + RL 用最少的搜索(2.86 次)拿到 36.07,说明"多干活"本身并不解释排名——这点作者自己也点破了,算是少见的老实。
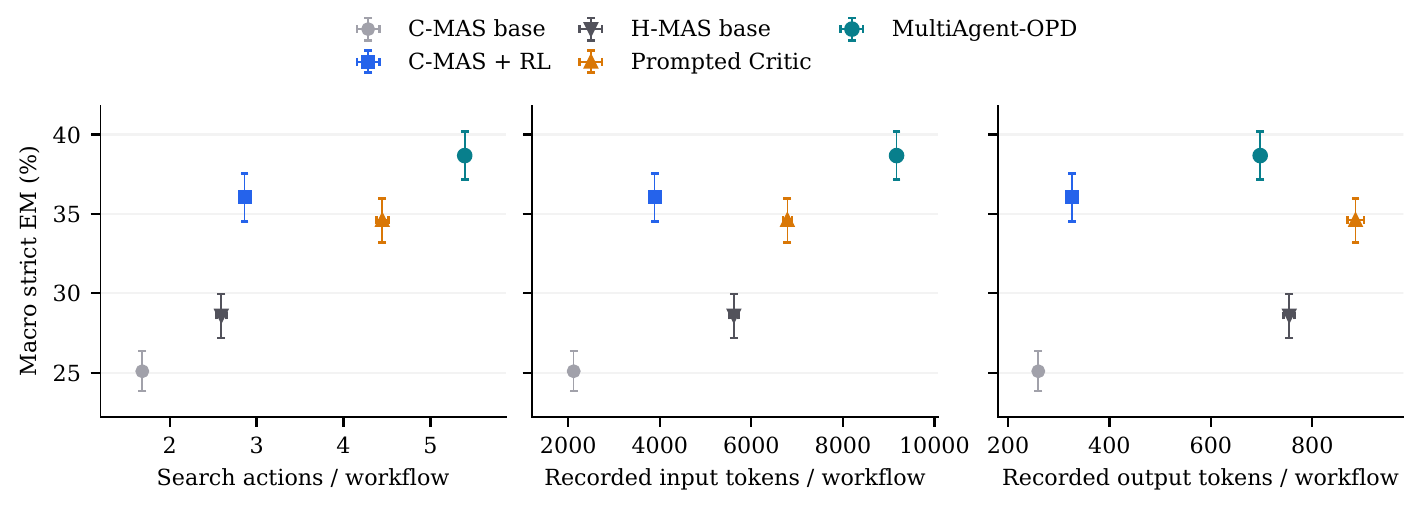
图4:macro strict EM 对三种推理开销(每条工作流的搜索动作数、记录输入 token 数、记录输出 token 数)的散点。MultiAgent-OPD 在准确率最高,但搜索和输入成本也最高;输出 token 上它反而比 Prompted Critic 省。
四次尝试的覆盖和一致性上,MultiAgent-OPD 的 macro pass@4 是 48.73%(C-MAS + RL 45.97、Prompted Critic 45.96),四次全对的比例 29.27%(对 27.05 和 23.24)。领先既体现在"至少对一次"的覆盖上,也体现在"次次都对"的稳定性上。
💡 我的判断
这篇论文值得花时间读,但要读对地方。
亮点有三个。 一是问题切得准——层级多智能体联合训练的信用分配,是 Agent 系统从"提示词拼装"走向"端到端训练"绕不开的坎,论文把它定位得很清楚。二是 OPD 当过程监督的嫁接很自然:reverse-KL 蒸馏的梯度形式就是 log 比值,天然可以塞进 PPO 的 advantage 槽位,工程上实现成本低。三是消融实验的设计和数据呈现都非常扎实,尤其是 outcome-based Searcher RL 的行为崩溃,这个负面结果对做 Agent RL 的人是真金白银的警示。
槽点也不能不说。 跟 RL 搜索 Agent 的对比只有 Tree-GRPO 差 1.31 个点且无置信区间,这个"超过所有 baseline"的说法在这个维度上是偏软的。所有实验都锁在 Qwen3-4B 这一个尺寸上,7B、32B 上 Teacher 和学生同词表、同架构的要求会不会成为瓶颈,不知道。还有一个作者自己也承认的点:OPD 提供的是"Teacher 的偏好",不是"token 对最终答案的因果贡献"——Teacher 会犯错,而且 Teacher 是在完整问题上训的、用在被委派的 subtask 上,这中间的分布偏移没有量化分析。
跟同期工作比,OPDSearch+ 也是冻结 Teacher 蒸馏搜索轨迹,SD-Search 用 hindsight 自蒸馏在 query 位置加监督——但那些都是单 Agent 场景。把"任务训出的 Teacher"嵌进联合训练的层级结构里给被委派的子任务打分,这确实是这篇论文独有的位置。它更像是一次干净的工程整合加一组高价值的诊断实验,而不是算法层面的新东西——但对正在搭多智能体训练 pipeline 的人来说,后者的实用价值可能更大。
如果你在工程上要借鉴,我的建议是:先把"角色奖励匹配"这个设计原则拿走——协调者吃团队结果、终端执行者吃直接正确性、中间环节的采集者需要局部过程监督;然后小心那个 17.78 的陷阱,给子 Agent 配结果奖励之前,先想想你的搜索动作会不会被训没。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我