不偷思维链,自己写一条:TraceForge 让学生用"自家的思考方式"蒸馏最强教师
你有没有注意到一个变化:找最强模型要数据,越来越难了。
以前做蒸馏很简单——把问题丢给强模型,连它的完整思维链一起收回来,喂给学生。DeepSeek-R1 那波开源浪潮之后,"用强模型的推理轨迹训小模型"几乎成了标准动作。但现在,头部厂商把这条路封了:API 只返回最终答案,或者一段压缩过的推理摘要,真正的 reasoning trace 藏在加密块里,你看不见。
更微妙的是,偷也有偷的办法。今年 8 月那篇 Stealing Reasoning Traces from Proprietary LLM APIs(Panfilov et al., arXiv 2608.09867)发现,各家返回的加密推理块居然可以跨会话、跨用户、甚至跨同厂商的不同模型重放——把强模型的加密块喂给同家族的小模型,小模型会老老实实把它解密并复述出来。这个洞后来被厂商修补了,但哪怕没修,用它做产品也是把刀悬在头上:直接违反服务条款。
所以现在的问题变成了:不偷、不违反条款,还能不能拿到能用的思维链?
arXiv 2610.29680 这篇 TraceForge 给的答案有点反直觉:拿不到教师的思维链,那就自己写一条——而且写出来的,比教师本人的思维链还好用。
🎯 核心摘要
前沿模型封死了推理轨迹,"偷"加密块又违反 ToS。TraceForge 换了个思路:只用教师返回的(问题、答案),让一个专门训练的生成器按学生自家模型家族的文风补写思维链,再用一个判别器通过对抗训练保证写出来的轨迹"像真的"。在 Qwen3.5-9B-Base 学生、5000 条固定问答对上,用这种"家族原生轨迹"替换教师 Fable 5 自己的思维链,HumanEval+ 涨 3.7 个点、MBPP+ 涨 7.1 个点;对比直接蒸馏 Qwen3.8-Max 的原生数据,领先 21 和 35 个点。单作者、单次运行、数据来源标注"confidential",这些都要打折扣,但"训练数据的形式比来源更重要"这个发现,值得每个做蒸馏的人认真看。
📖 论文信息
- 标题:TraceForge: Distilling with Your Own Thinking
- 作者:Yan Wang(Independent Researcher,单作者)
- arXiv:2610.29680,2026 年 10 月 21 日提交(v1),10 月 22 日更新(v2)
- 链接:https://arxiv.org/abs/2610.29680
- 协议:CC BY 4.0
顺带一提,这篇论文的行文风格相当少见的坦率——作者会直接在正文里记录自己踩过的坑(后面细讲),通篇带着一种"我就是要打破这个垄断"的明确立场,毫不掩饰。
🤔 问题动机:护城河、灰色地带,和一个被忽视的变量
先把背景补齐。这件事有三条线。
第一条线:反蒸馏护城河。 厂商隐藏思维链的理由是安全与知识产权,实际效果是垄断——正如论文原话,"the moat is the point"。开源模型随便蒸馏没人管,限制只针对自家输出,多少有点讽刺:这些模型自己就是蒸馏人类知识长起来的。
第二条线:加密块重放。 就是开头说的 Panfilov et al. 那篇。技术上很漂亮,法律上死路一条。顺带说一句,那篇论文的研究者从公开仓库里解码了 315,320 个加密推理块,从中翻出 367 条个人隐私信息和 182 条凭证——这个攻击面的严重性远超蒸馏本身,但那是另一个故事。
第三条线:合成思维链。 Cornell Tech 的 Trace Inversion(Zhang et al., arXiv 2603.07267)已经证明:只凭黑盒模型暴露的问题和最终答案,就能训练一个"反演模型"合成推理轨迹,效果在数学任务上相当能打(他们让学生在 MATH500 上从 56.8% 涨到 77.6%)。但 Trace Inversion 的报告里恰好有个软肋:编程任务上效果差,作者归因于风格与格式不匹配。
TraceForge 抓住的就是这个软肋。之前做类似蒸馏工作时我们也踩过同样的坑:合成出来的思维链读起来"很对但很假"——通用叙述腔、编号步骤、把答案复述一遍而不是推导一遍。学生模型学这种文风,等于既要学内容又要学一种"外语"。
于是核心假设来了:思维链的文风(形式)和内容(来源)是可以解耦的,而形式对学生学习效率的影响被严重低估了。
🏗️ 方法核心:一个生成器、一个判别器、五轮对抗
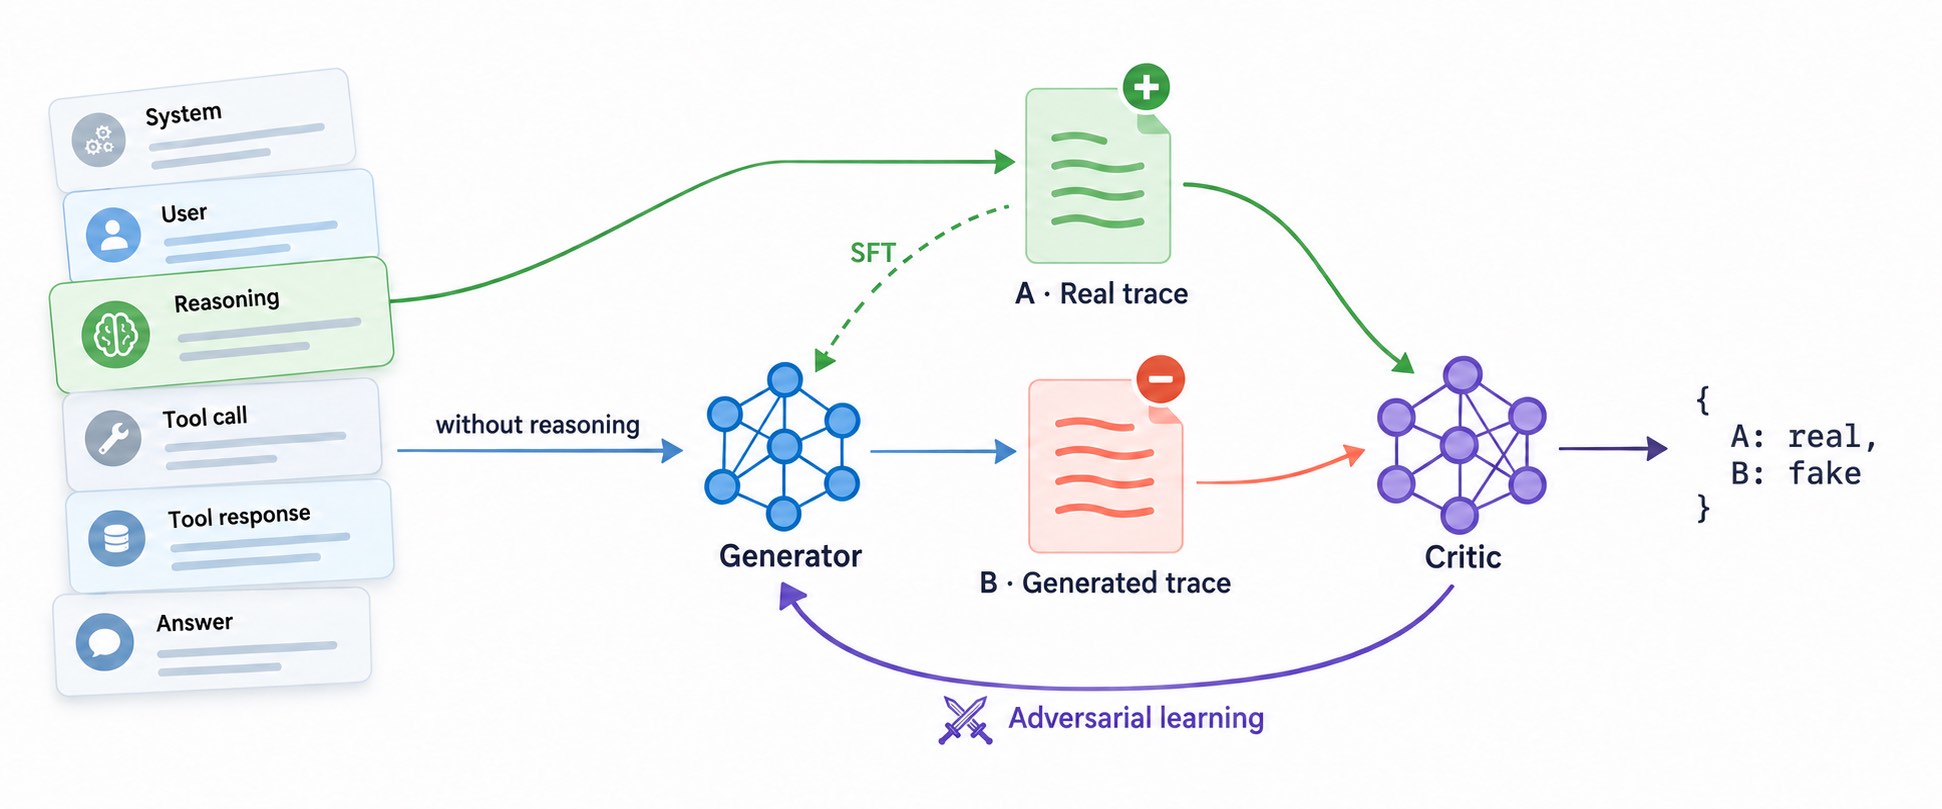
图:TraceForge 流程。左侧是把对话拆成系统提示、用户轮次、推理轨迹、工具调用、答案等元素;生成器(蓝色)接收去掉推理轨迹的完整上下文,负责补写轨迹;判别器(紫色)看真轨迹和生成轨迹各一份,判断哪个是真的;判别结果再通过底部的对抗回路反馈给生成器,形成 GAN 式的闭环训练。
第一步:把问题定义干净
论文的操作对象是一条完整对话:系统提示 \(S\)、用户轮次 \(U\)、答案 \(A\)、工具调用及响应 \(T\),加上推理轨迹 \(R\)。生成器学的就是这个条件分布:
给定除轨迹之外的一切,补写那条轨迹。
注意两个设计细节,都挺关键:
- 训练数据只来自学生自己的家族。 大约一万条 Qwen3.8-Max 的真实对话,五要素齐全,轨迹直接监督,全程不碰任何闭源模型。教师只在推理阶段登场,而且只贡献 \(S, U, A, T\) 四个输入——也就是说,教师的思维链从头到尾不存在于这个系统里。
- 答案在输入端,永远不在输出端。 生成器学的是一条"终止于 \(A\) 的推导过程",而不是对 \(A\) 的复述。这一条直接决定了合成轨迹的质量下限——很多合成方法翻车就翻在把推导写成了答案复读。
这里有个容易误读的地方,论文特意强调了:生成器训练时见到的轨迹都是为 Qwen 家族自己的答案写的,推理时换成教师的答案,它不可能在"背诵"什么,它是在做训练目标定义的事——写一条指向该答案的推导,用家族的口吻。作者给这种产物起了个名字:family-native trace(家族原生轨迹)。
第二步:监督训练生成器
生成器是 Qwen 家族的一个模型,在这一万条对话上做 SFT:轨迹从输入里挖掉,loss 只落在轨迹上。简单直接。
训完之后用外部裁判(GPT-6.1-SOL)打"真实度"分:真实家族轨迹平均 0.66,生成器只有 0.54。这个差距就是下一步要解决的。
第三步:监督训练判别器
判别器的任务是区分真轨迹和生成轨迹,每条真实样本配一条生成器产的"配对负样本"。有个训练细节:不把分类 margin 推到底,而是判别器给正样本的概率高出负样本 0.2 就停。
这里有个论文坦白记录的坑,值得单独讲。 作者最初假设小模型能当判别器判大模型的输出——失败了。几百步之内,小判别器学到的是捷径特征,在验证集上分数漂亮,但对生成器毫无训练价值。结论:判别器至少要和生成器一样大。 这个教训在判别式任务里其实相当普适:让弱者判断强者,弱者学到的大概率是表面纹理而不是本质差异。
第四步:五轮对抗协同训练
GAN 式的闭环,但用的是偏好学习而不是梯度穿透:
- 每轮生成器产出 5,000 条轨迹,和对应真实轨迹一起摆给判别器;
- 骗过判别器的轨迹 → 变成判别器的训练数据(判别器继续进化);
- 没骗过的轨迹 → 变成生成器的偏好对(用标准 DPO 目标拉近差距);
- 每轮结束用 GPT-6.1-SOL 在留出集上重新打分。
五轮之后分数不再涨,就停。最终成绩:生成器单独 0.68(超过真实轨迹的 0.66),判别器四选一(best-of-4)达到 0.82。
注意这是真实度分数,不是正确率——它衡量的是"像不像这个家族写的",至于轨迹本身推理对不对,是另一回事,要靠下游基准说话。
🧪 实验设计:控制变量做得很干净
这是我觉得这篇论文最值得学的部分:五个语料库,只动"轨迹和答案从哪来"这一个变量,其他一切冻结。
学生统一是 Qwen/Qwen3.5-9B-Base 预训练底座;训练配置全参数 SFT、BF16、8 张 H20、TP4/PP2、学习率 \(2\times 10^{-5}\) 余弦退火、约 1,600 个 packed-batch step、seed 固定 42;对抗阶段用标准 DPO。数据池固定:5,000 条带 Fable 5 真实推理轨迹和答案的 Claude Code 轨迹(256K 上下文),每个语料库用同一批 prompt 和同一批答案。
| 语料 | 推理轨迹来源 | 答案来源 |
|---|---|---|
| S1 | Fable 5 原生轨迹 | Fable 5 |
| S2 | 家族原生轨迹(TraceForge) | Fable 5 |
| S3 | Qwen3.8-Max 原生轨迹 | Qwen3.8-Max |
| S4 | Trace Inversion 合成 | GPT-6.1-SOL |
| S5 | 家族原生轨迹(TraceForge) | GPT-6.1-SOL |
看清楚了:S1 对 S2,答案完全相同,只有轨迹作者不同;S4 对 S5,答案完全相同,只有合成器不同。这就是能下因果结论的比较设计。
主结果:三个"没想到"
Table 1:五个语料在最终 checkpoint 的成绩(ARC 为 acc-norm,BoolQ 为准确率,代码为 pass@1):
| 语料 | ARC-E | ARC-C | BoolQ | HumanEval+ | MBPP+ |
|---|---|---|---|---|---|
| S1: Fable 5 轨迹+答案 | 81.02 | 58.36 | 89.63 | 64.63 | 52.38 |
| S2: 家族原生+Fable 5 答案 | 81.19 | 59.73 | 89.33 | 68.29 | 59.52 |
| S3: Qwen-Max 轨迹+答案 | 81.52 | 58.28 | 88.35 | 46.95 | 24.60 |
| S4: TraceInversion+Sol 答案 | 81.48 | 58.53 | 88.99 | 3.66 | 6.61 |
| S5: 家族原生+Sol 答案 | 80.98 | 58.19 | 88.65 | 59.15 | 60.05 |
第一个没想到:S2 打赢了 S1。 教科书配方是"用能拿到的最强轨迹当训练信号",这里把 Fable 5 的真轨迹换成 TraceForge 写的家族轨迹,HumanEval+ 涨 3.7 个点,MBPP+ 涨 7.1 个点。作者的解释:学生吸收自家文风的轨迹不需要"忘掉自己的习惯",适应成本更低,灾难性遗忘更小。说到底就是那句老话的机器学习版——最好的学生不是最好的老师教出来的,是"用学生最能吸收的方式"教出来的老师教出来的。
第二个没想到:S3 惨败。 Qwen3.8-Max 是家族里最强的合法教师,预期表现接近 Fable 5,实际在代码两项上落后 S1 十几到二十几分、落后 S2 整整 21 和 35 个点。教师能力是必要条件,不是充分条件——一个强教师用"自己的手"教,不如一个更强的教师把内容翻译成"学生的手"再教。
第三个没想到:S4 崩了。 Trace Inversion 在数学任务上是验证过的方法,这里最终只有 3.66 和 6.61。作者读了它的输出:明显的合成腔——通用叙述口吻、编号步骤、复述答案。这和 Trace Inversion 原文自报的"编程任务上偏弱、风格不匹配"完全对上,也算是一次独立复现式的佐证。
而 S5 用同样的 GPT-6.1-SOL 答案、只换合成器,就到了 59.15 和 60.05——同样的答案,换个轨迹合成器,差出 55 和 53 个点。
训练过程:曲线比终点更有信息量
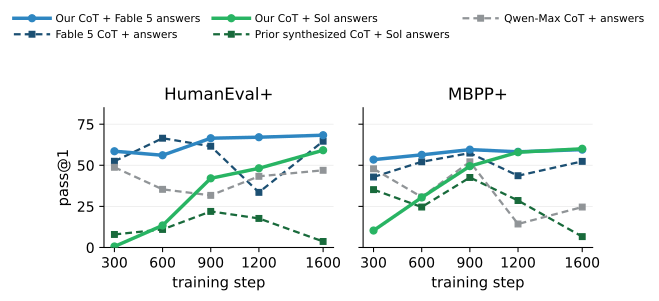
图:HumanEval+(左)与 MBPP+(右)随训练步数的变化。实线是 TraceForge 的两条线(家族轨迹 + Fable 5 答案 / + Sol 答案),全程稳定爬升并最终领先;虚线是三个基线——Fable 5 原生轨迹波动剧烈,Qwen-Max 轨迹中途崩落,Trace Inversion 一路在底部挣扎。
Table 2:代码基准每个 checkpoint 的 pass@1:
| Step | 300 | 600 | 900 | 1,200 | 1,600 |
|---|---|---|---|---|---|
| HumanEval+ | |||||
| S1 | 52.44 | 66.46 | 61.59 | 33.54 | 64.63 |
| S2 | 58.54 | 56.10 | 66.46 | 67.07 | 68.29 |
| S3 | 48.78 | 35.37 | 31.71 | 43.29 | 46.95 |
| S4 | 7.93 | 10.98 | 21.95 | 17.68 | 3.66 |
| S5 | 0.61 | 13.41 | 42.07 | 48.17 | 59.15 |
| MBPP+ | |||||
| S1 | 42.86 | 52.12 | 57.41 | 43.65 | 52.38 |
| S2 | 53.44 | 56.35 | 59.52 | 58.20 | 59.52 |
| S3 | 47.88 | 30.69 | 52.12 | 14.29 | 24.60 |
| S4 | 35.19 | 24.60 | 42.59 | 28.57 | 6.61 |
| S5 | 10.32 | 30.42 | 49.47 | 57.94 | 60.05 |
三个看点:
S1 不稳定。 600 步到 66.46,1,200 步暴跌到 33.54,最后又回到 64.63。作者复评了两次排除打分错误——33 个点的自愈式下跌不是噪声。解释:教师文风离家族太远,拟合它要把参数推很远,推远了就会过冲。
S5 是"慢热但从不回头"的典型。 前 300 步只有 0.61,之后一路单调爬升。作者给了一个挺有意思的归因:Qwen3.5 的中训练据说用了大量 Claude 系数据、很少 GPT 系数据,所以 GPT-6.1-SOL 的答案文风对底座是"新东西",需要先适应答案风格,轨迹才能发挥作用——而轨迹本身的文风不新,所以爬升一旦开始就不再逆转。两个基准的均值上,S5 甚至超过了 S1。
S3 和 S4 的输出里出现了"死循环"。 复读、原地绕圈、反复推导已有结论,训得越久越多。这对应基础模型圈的一句行话——"吸二手烟"(breathing second-hand smoke):蒸馏一个本身被蒸馏过的模型,学生思考时容易陷入死循环;直接用 Claude 或 GPT 原生数据训练就很少出现。Qwen3.8-Max 和 Trace Inversion 的产物都中招了,而家族原生轨迹完全没有这个症状。说实话,这个观察我个人觉得是全文最值钱的实验发现之一,它把"数据风格"从口感问题升级成了训练稳定性问题。
一个彻底规避法律暴露的变体
论文还给了个更保守的玩法:对完全不想碰 Claude/OpenAI 输出的团队,先生成家族原生轨迹,再让 Qwen3.8-Max 基于这条轨迹写答案,用这组(轨迹+答案)训练。全程没有 Claude/OpenAI 的 token 参与反向传播。作者说跑过这个变体,效果和 S2 基本持平。
🔬 我的判断:想法漂亮,证据链有短板
亮点先说清楚:
- 问题定义干净。 "轨迹的文风与来源解耦"这个问题提得很准,S1/S2、S4/S5 的控制变量设计是我最近看到的蒸馏类论文里最清爽的。
- 形式与内容解耦,这个结论本身有独立价值。对所有做合成训练数据的人,"用学生家族的文风写数据"这条原则的适用面远不止蒸馏场景。
- 坦诚。 论文自己承认 S1/S2 的比较"不能把家族文风和流水线之间的其他所有差异完全隔离开"——TraceForge 的生成器和 Trace Inversion 的差别不止文风一个维度。这种自我限定在论文里很少见。
但短板也必须摆出来:
单次运行。 Table 1 原文标注"One run per cell"。S1 那种 33 个点的深 V 自愈,在单次运行的设定下,你没法完全排除它就是运行间方差——作者虽然复评了打分,但没换 seed 重训。3.7 和 7.1 个点的主结论,量级上没到可以无视方差的程度。
数据来源写着"confidential"。 5,000 条带 Fable 5 完整真实推理轨迹的 Claude Code 数据,来源保密。对一篇把"合法性"当核心卖点的论文,教师数据本身的合规性是论述链条上最关键的一环,这里缺了交代。而且注意:S1 能成立,本身就说明作者手里有一批带真实思维链的闭源模型数据——这批数据的获取方式是否合规,论文没有回答。生成过程合法,不等于训练语料合法。
一个家族,一个学生规模。 只在 Qwen3.5-9B 上、只用 Qwen 家族轨迹验证。"家族文风匹配"是不是普适规律,换个家族(比如 Llama 或别的底座)是否复现,未知。作者在页脚也承认 API 目前只支持 Qwen 家族的轨迹。
一个小小的数字打架。 HTML v2 版摘要里写"the same 3,500 questions",实验部分明确写 5,000 条轨迹,摘要页元数据又是 5,000。应该是改版残留,以实验部分为准,但这种不一致出现在一篇强调严谨的单作者论文里,还是让人皱了下眉。
ARC/BoolQ 那三列别太当真。 三个多选知识任务对所有语料几乎无区分度(论文自己也把它们放一边了),全文有效证据就是两个代码基准。代码恰好是"格式敏感"的任务类型,对文风变量的反应天然放大——换到数学推理上家族轨迹还能不能赢教师原生轨迹,这篇论文没有给出证据。
综合看:这是一个聪明的工程方案 + 一个有真实启发的经验发现,但距离"定论"还差一轮多 seed、多家族的复现。 它更适合被当成"训练数据形式论"这个方向的强先验,而不是可以直接抄的配方。
💡 工程启发
如果你在做蒸馏或合成训练数据,这篇论文直接可带走的几条:
- 合成轨迹时先问"写给谁看"。 同样的内容,用学生家族的文风重写,学习效率可以差出几十个点。花在"文风对齐"上的算力,回报可能比多爬一万条数据更高。
- 答案进输入端、不进输出端。 生成"终止于答案的推导"而不是"答案的复述",这一条几乎零成本,但直接决定合成轨迹是不是废话。
- 判别器不能比生成器小。 弱判别器学到的是捷径,会给对抗训练提供假信号。
- 盯训练曲线,别只看终点。 深 V 自愈和大幅崩落都是数据风格不匹配的征兆,单看最终 checkpoint 会漏掉这些信息。
- 死循环复读是数据病,不是模型病。 学生出现 thinking 死循环时,先查训练语料里有没有"二手烟"。
最后留一个开放问题。TraceForge 的前提是"教师答案可靠、且家族里有强模型可提供一万条真实轨迹"。如果教师本身就经常给出错误答案(比如长程 agent 任务),一条"终止于错误答案的漂亮推导"会不会反而把错误学得更扎实?这个问题论文没有碰,而它恰恰是这套方法走向真实生产环境前必须回答的。护城河的战事还长,但"形式与内容解耦"这一枪,确实打在了要害上。
参考
- TraceForge: Distilling with Your Own Thinking, Yan Wang, arXiv 2610.29680
- Stealing Reasoning Traces from Proprietary LLM APIs, Panfilov et al., arXiv 2608.09867
- How to Steal Reasoning Without Reasoning Traces(Trace Inversion), Zhang et al., arXiv 2603.07267
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, DeepSeek-AI, arXiv 2501.12948
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我