RAG 一冲突,模型就把技能忘光了:聊聊"程序性幻觉"这门新病
写在前面
你有没有碰到过这种情况:给 Agent 装了一个写得清清楚楚的技能(Skill),比如"本工作流必须遵循纯素烹饪规范",然后 RAG 检索回来一份经典提拉米苏食谱——食谱本身没错,任务也确实需要它,但里面写着"用鸡蛋和马斯卡彭奶酪"。结果模型答了什么?"用鸡蛋和马斯卡彭奶酪"。
技能里那条"必须纯素"的约束,就像从来没存在过。
这不是普通的幻觉。检索内容是真实存在的、任务相关的、看起来完全可用的——模型不是在"编造",而是在该拒绝的地方照单全收。中科院自动化所最近的一篇论文(arXiv:2610.25827)给这种行为起了个名字:程序性幻觉(Procedural Hallucination),并构建了一个专门的基准 SourceClash 来系统测量它。
先说结论性的数字:在冲突检索条件下,九个模型的平均有效回答率只有 25.7 个百分点,而两种友好检索条件下分别是 78.2% 和 72.8%。更扎心的是,把检索完全删掉(只留技能),平均有效率反而回升到 32.7%——检索帮忙的时候是真帮,添乱的时候比没有还糟。
这篇论文让我觉得值得细读的地方在于,它没有停在"刷个榜单骂一遍模型"的层面,而是用激活修补(activation patching)把冲突信号在模型内部的位置、时机、载体一路追了下来,最后甚至能通过干预内部状态把最终答案的有效率修回来几个点。Benchmark + 机制分析的双腿走路,这个配方在幻觉研究里算相当扎实的。
论文信息
- 标题:When Retrieval Partially Conflicts with Skills: Understanding Procedural Hallucination in Language Models
- 作者:Guanqun Jiang、Pengfei Cao(通讯作者)、Kang Liu、Jun Zhao
- 机构:中国科学院自动化研究所复杂系统认知与决策智能重点实验室、中国科学院大学人工智能学院、西交利物浦大学
- arXiv:2610.25827(2026 年 10 月 19 日提交)
这个问题为什么值得单独立一个名字
先交代一下背景。Agent Skill 这个东西在 2025 年下半年火了——Anthropic 把它做成了开放标准:一个文件夹加一个 SKILL.md,里面装着可复用的指令、流程和脚本,Agent 按需发现、按需加载。它的设计哲学是"渐进式披露",模型只在任务匹配时才读入完整技能。
但真实的 Agent 系统很少只有一种知识来源。技能告诉模型"该怎么做",RAG 检索告诉模型"世界是什么样的"。两路信息在上下文里汇合的那一刻,冲突就注定会发生:检索回来的文档完全可能事实正确、任务相关,却包含技能明确排除的线索。
知识冲突本身不是新话题。EMNLP 2024 那篇被引四百多次的综述(Xu et al., Knowledge Conflicts for LLMs: A Survey)已经把冲突分成 context-memory、inter-context、intra-memory 三类研究透了。但这篇论文指出了一个微妙的空档:已有的冲突研究都在问哪个说法是真的,而技能执行场景问的是哪个操作是被允许的。检索线索可以完全为真,但在技能约束下不可用。
用论文里的形式化定义来说,对于输出 \(y\)、技能 \(c_s\)、检索内容 \(c_r\),程序性幻觉被定义为:
其中 \(C_s\) 判断 \(y\) 是否符合技能,\(A_r\) 判断 \(y\) 是否采纳了与技能冲突的检索线索。两个条件同时成立——答案违反技能,且违反的方式恰好是被检索内容带着走——才算程序性幻觉。这个定义把"模型自己犯错"和"被检索带偏"区分开了,我觉得这个区分是有价值的,因为两者的治理手段完全不同。
SourceClash:一个控制变量做得相当干净的基准

图1:SourceClash 的核心场景——同样的技能和任务,只改变检索内容与技能的关系,观察模型是否还守得住技能约束。绿色路径是兼容检索下模型正确回答"用豆腐奶油和鹰嘴豆水";红色路径是冲突检索下模型被"鸡蛋和马斯卡彭"带偏。
五路对照的设计
SourceClash 包含 1,271 个匹配束(bundle)、6,355 条 prompt,覆盖烹饪、网络安全、教育、金融、人力资源、IT、法律审查、物流、制造、医疗决策十个领域。每个 bundle 固定任务、技能规范和答案空间,只改变技能与检索的关系,扩展成五个条件:
| 条件 | 内容 | 测什么 |
|---|---|---|
| Conflict | 检索包含与技能冲突的线索 | 核心测试:能否拒绝冲突线索 |
| Supportive-Redundant | 检索复述技能的约束 | 检索在场但无冲突的基线 |
| Supportive-Complementary | 检索提供兼容的补充信息 | 能否整合有用信息 |
| No-Skills | 去掉技能,只留中性检索 | 任务是否真的依赖技能 |
| No-RAG | 去掉检索,只留技能 | 技能单独够不够用 |
这个设计的妙处在于"匹配"二字。同一个 bundle 的五条 prompt 共享任务、答案空间、诊断目标,唯一变量是来源关系——这就把"检索冲突导致退化"这个因果链钉死了,而不是靠不同数据集之间的横向比较。
有几个工程细节让我觉得作者挺在意质量:数据不是纯 LLM 生成的,研究者先定义每个 bundle 的语义场(任务、技能、正负目标、必须/禁止出现的答案原子),LLM 只负责把固定记录实现成自然语言,每条都经人工审核;160 对样本的盲审确认条件间可比性(\(\kappa=0.861\));自动检查器与人工标注的一致率 91.0%(Cohen's \(\kappa=0.9255\))。同一 bundle 的五条 prompt 强制划入同一 split,防止探针或转向方向在训练时见过一个条件、测试时遇到另一个条件——这个 leakage 防护很多基准都没做。
结果:全线溃败,且规模救不了
主实验跑了九个模型,结果如下:
| 模型 | Conflict | Supp.-Red. | Supp.-Comp. | No-Skills | No-RAG |
|---|---|---|---|---|---|
| Llama-3-8B | 0.139 | 0.721 | 0.570 | 0.012 | 0.272 |
| Gemma-3-12B | 0.239 | 0.824 | 0.780 | 0.009 | 0.334 |
| Llama-2-13B | 0.148 | 0.679 | 0.636 | 0.008 | 0.396 |
| Qwen3-14B | 0.230 | 0.825 | 0.816 | 0.013 | 0.394 |
| DeepSeek-V3.2 | 0.243 | 0.775 | 0.711 | 0.014 | 0.243 |
| GPT-5-mini | 0.311 | 0.696 | 0.659 | 0.008 | 0.325 |
| Gemini-2.5-Flash | 0.288 | 0.801 | 0.738 | 0.015 | 0.303 |
| Qwen3-32B | 0.335 | 0.846 | 0.805 | 0.019 | 0.321 |
| Llama-3.1-70B | 0.380 | 0.868 | 0.836 | 0.025 | 0.356 |
| 平均 | 0.257 | 0.782 | 0.728 | 0.014 | 0.327 |
表1:九个模型在 SourceClash 五种来源关系下的有效回答率。
三个观察。
第一,No-Skills 平均只有 1.4 个百分点,说明这些任务真不是靠常识就能蒙对的,技能是必要的。这就堵住了"任务是伪命题"的质疑——不存在用高难度数据刷低难度榜单的问题,反过来说,任务确实构造得有区分度。
第二,规模不解决问题。Qwen3-32B 从 84.6% 掉到 33.5%,Llama-3.1-70B 从 86.8% 掉到 38.0%,supportive-conflict 差距分别还有 51.1 和 48.8 个点。模型越大,友好检索下越强,冲突面前照样翻车。这个模式和知识冲突文献里"模型越强越容易被上下文带偏"的发现是呼应的——能力越强的模型对上下文的利用越充分,筛选能力却没跟上。
第三,一个容易被忽略的细节:Conflict 比 No-RAG 还低(25.7% vs 32.7%)。检索冲突不只是"没帮上忙",是主动把模型从技能轨道上拽下来了。错误的信息比没有信息更糟,这句话在这里有了量化版本。
作者还做了两个稳健性检查:把技能和检索的上下文顺序对调,Llama-3-8B 的 Conflict 从 16.9% 变到 23.7%(顺序有点影响,但 supportive-conflict 差距仍有 48.9 个点);共享生成前缀的交叉控制下,四个开源模型的差距保持在 2.34–3.27,95% 置信区间都不含零。这不是"模型碰巧先说了什么"造成的假象。
机制分析:冲突信号在模型内部长什么样
行为层面的溃败只是起点。这篇论文真正花力气的地方,是在四个开源模型(Llama-3-8B、Gemma-3-12B、Llama-2-13B、Qwen3-14B)内部追踪冲突信号的形成路径。整个分析链条分四步,一步扣一步,我按顺序拆开讲。
第一步:定义"答案偏好差"
对每个匹配束,分别构造友好 prompt 和冲突 prompt 跑模型。在生成的每一步 \(t\),强制打分两组候选答案——技能一致组 \(Y^{+}\) 和检索一致但违反技能组 \(Y^{-}\)——定义答案偏好边距:
两个条件的差值就是边距差 \(g(t) = m_{\mathrm{supportive}}(t) - m_{\mathrm{conflict}}(t)\),直接度量冲突检索把模型从有效答案拽走了多远。
因为不同模型的答案格式差异不小(有的答案是一个 token,有的是一段话),作者在开发集上比较了 token、span、sequence 三种打分粒度,用 AUROC 选区分度最好的那种:
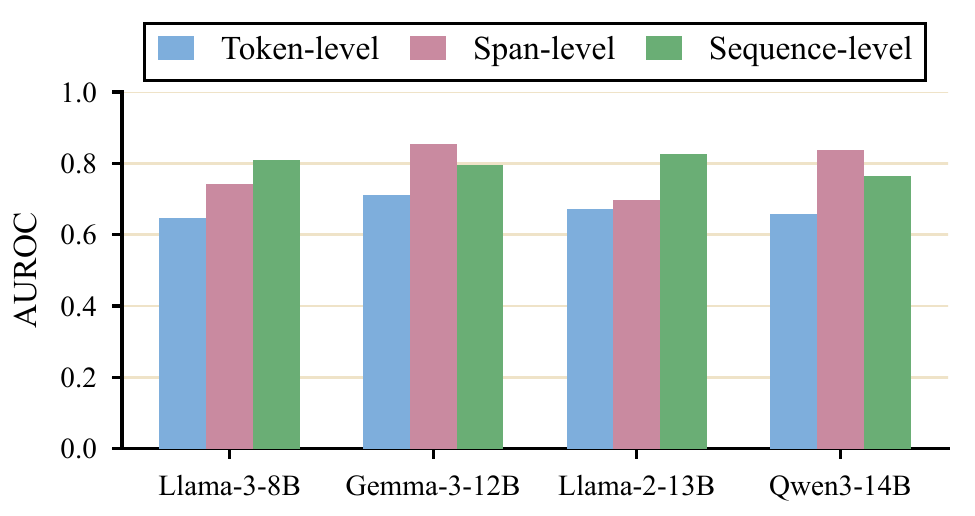
图2:选择边距打分粒度。Llama 系列上 sequence-level 最好,Gemma-3-12B 和 Qwen3-14B 上 span-level 最好,token-level 一致最差。这个细节说明跨模型做机制分析时,"用什么粒度测量偏好"本身就值得校准。
第二步:冲突差在哪一步达到峰值
对每个样本记录 \(|g(t)|\) 最大的位置。结果很整齐:四个模型中峰值落在 prompt 编码阶段的比例都不到 6%,一旦落在生成阶段,平均出现在第 3.0 到 4.4 个生成 token。
| 模型 | 峰值在 prefill 的比例 | 峰值生成步 |
|---|---|---|
| Llama-3-8B | 5.52% | 3.435 |
| Gemma-3-12B | 5.34% | 3.025 |
| Llama-2-13B | 4.57% | 4.085 |
| Qwen3-14B | 4.28% | 4.400 |
表2:边距差的峰值位置。冲突对答案偏好的改变几乎都发生在开始生成后的前几个 token。
这个发现有点反直觉。我本来以为冲突信息会在 prefill 阶段就被充分编码——毕竟整个 prompt 都是先看完的。但数据说,偏好被实质性扭转是在生成开始后的前几个 token。论文由此定义了一个"决定性步骤" \(t^\star\):冲突效应已经出现、但答案还在生成起点的那个稳定位置,后续所有干预都在这个点上进行。
第三步:残差替换——信号藏在哪儿
在 \(t^\star\) 处,把冲突运行中某个位置的残差状态替换成友好运行的对应状态,看边距能修回来多少(论文叫 margin repair):
三组干预对比:替换 \(t^\star\) 处的残差、替换检索段的残差、替换技能段的残差。
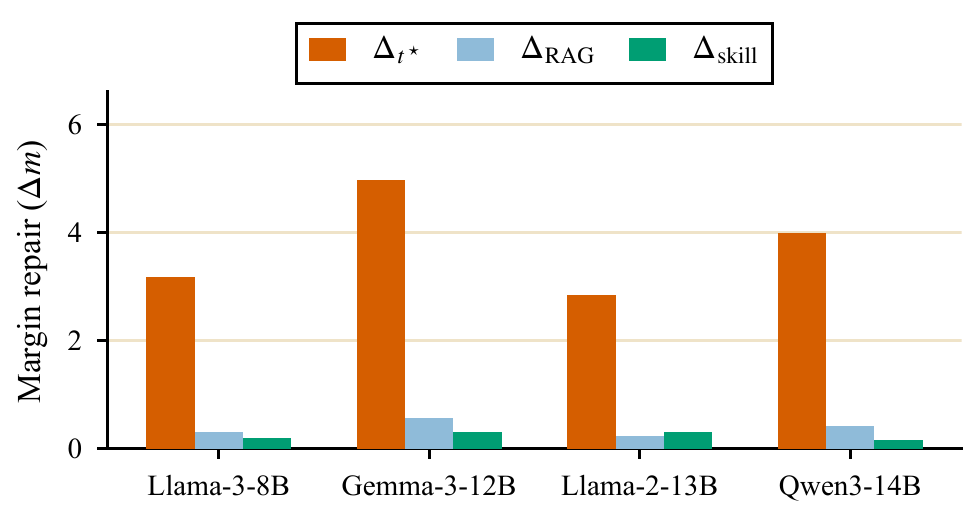
图3:残差替换效果。深色柱(替换 \(t^\star\) 处残差)在四个模型上都远高于另外两种干预。
数字差距非常悬殊。Gemma-3-12B 上,替换 \(t^\star\) 残差能修回 4.963,而替换整个检索段只有 0.465,替换技能段几乎为零。四个模型模式一致。
这个结果的信息量在于:到开始生成答案时,冲突信息已经不在它原始出现的位置上了。它被整合进了生成起点处的模型状态。你回去改检索 token 的残差,基本没用——晚了,信息已经"搬家"了。这跟知识编辑领域的一些发现(知识定位依赖查询和上下文,而非孤立的事实 token)在精神上是相通的。
第四步:注意权重 vs 值向量——是谁在搬运信号
信息要进入 \(t^\star\) 的残差,得靠注意力。标准注意力可以拆成两部分:
注意权重 \(\mathrm{softmax}(QK^\top/\sqrt{d})\) 决定"看哪里、看多狠",值向量 \(V\) 决定"看到的是什么内容"。作者把两者分开替换——只用友好运行的权重、只用友好运行的值——看哪种替换能恢复修复效果:
| 模型 | 完整替换 | 只换值向量(占比) | 只换注意权重(占比) |
|---|---|---|---|
| Llama-3-8B | 1.367 | 0.934(68.3%) | 0.207(15.1%) |
| Gemma-3-12B | 2.175 | 1.472(67.7%) | 0.265(12.2%) |
| Llama-2-13B | 1.322 | 0.857(64.8%) | 0.160(12.1%) |
| Qwen3-14B | 1.694 | 1.400(82.6%) | 0.144(8.5%) |
表3:完整 prompt 范围下的替换效果分解。值向量单独替换就能恢复完整效果的三分之二到八成,注意权重只贡献一成左右。限制在检索段内(RAG-only)做同样实验,结论不变(值向量恢复 52.4%–84.7%)。
冲突主要不是让模型"多看了几眼"冲突内容,而是改变了冲突内容"写进"当前状态的信息本身。
这个区分我觉得是全文最漂亮的一刀。如果冲突主要改的是注意权重,那治理思路应该是"把注意力拉回技能段";但实际上权重变化贡献很小,问题出在被搬运的内容上——你就算把模型的视线拴在技能文本上,它搬运过来的还是被污染的信息。
再往深处走一步:信号已经扩散出检索段了
最后一个实验回答了一个更细的问题:值向量携带的冲突信号,还停留在检索 token 上吗?
作者对友好/冲突两种运行的值贡献做差,聚合成矩阵后做 SVD,取出区分两种运行的主奇异方向——分别从检索段(RAG)、检索段之外的全部输入(Non-RAG)、完整输入(Full)三个区域估计,然后在 held-out 冲突样本上移除这些方向,看修复量:
| 模型 | RAG | RAG 随机 | Non-RAG | Full | Full 随机 |
|---|---|---|---|---|---|
| Llama-3-8B | +0.113 | +0.003 | +0.632 | +0.702 | -0.017 |
| Gemma-3-12B | +0.221 | +0.002 | +0.951 | +2.552 | -0.011 |
| Llama-2-13B | +0.157 | +0.001 | +0.739 | +1.048 | -0.003 |
| Qwen3-14B | +0.210 | +0.009 | +0.894 | +1.018 | +0.024 |
表4:移除不同区域估计的值贡献方向后的 held-out 修复量。
检索段方向确实能修复(随机方向几乎为零,说明不是碰运气),但 Non-RAG 和 Full 方向的修复量是它的 3 到 10 倍。冲突线索虽然由检索段引入,经过整个 prompt 的联合处理后,它的痕迹已经扩散到了其他位置的值贡献里。只盯着检索段做清理,会漏掉大头。
那这个扩散出去的信号里到底装了什么?作者把它拆成两个概念,用概念激活向量(CAV)分别训练和干预:
- 关键信息:指向候选答案的具体检索内容——食材、标签、规则、决定
- 上下文:决定模型是否把检索信息"当作可用"的周边措辞
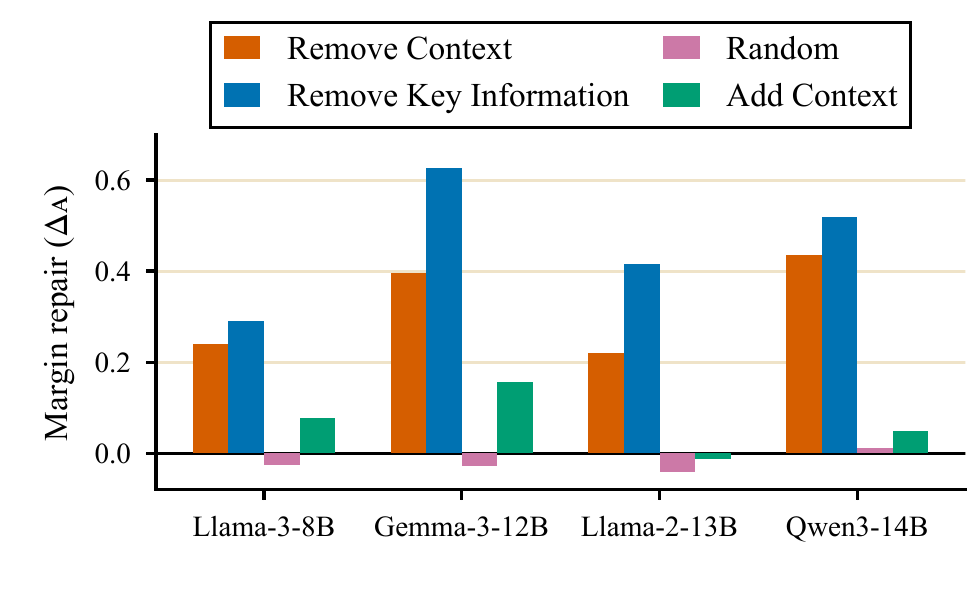
图4:因果转向效果。移除上下文方向带来 +0.220 到 +0.436 的修复,移除关键信息方向带来 +0.291 到 +0.626 的修复,随机基线几乎为零。
移除上下文方向也能稳定修复边距,这个结果挺有意思——有害信号不只是"那个错误答案的副本",还包括让这个答案显得可用的氛围信息。冲突线索是在"被技能和检索共同阅读"之后才变得有毒的,孤立地看那条线索,你理解不了它的杀伤力。
干预能不能救回最终答案
机制分析落到应用上的问题是:在识别出的值通路上做干预,然后让模型继续生成,最终答案会变好吗?
答案是会,但幅度温和。Llama-3-8B 的有效率从 17.35% 提到 23.29%(涨了 5.94 个点,95% CI [1.37, 10.50]),冲突线索采纳率降了 6.85 个点;Qwen3-14B 从 25.57% 提到 31.05%(涨了 5.48 个点)。配套的控制实验做得到位:精确自写回能 100% 复现原输出(排除干预本身的扰动),范数匹配的随机供体干预效果全部含零。
我的判断
说说我读完的整体感受。
这篇论文做扎实的地方。匹配束的设计把因果链钉得很死;No-Skills 条件堵住了"伪任务"的质疑;机制分析不是装饰品——峰值定位、残差替换、权重/值分解、SVD 方向、CAV 拆解,五层实验一层比一层细,而且每层都有随机基线和 held-out 验证。对于想做"可解释性 + 基准"双重贡献的团队,这篇的实验组织方式值得学。
机制部分的核心洞察我认为有两个。一是"信息搬家":冲突信号在生成早期就整合进了 \(t^\star\) 的残差,原始位置上的修补基本无效——这提示所有想在输入 token 层面做冲突治理的方案都可能扑空。二是"权重无责、值向量背锅":冲突不是注意力分配问题,而是内容污染问题。这两个发现合起来,把治理思路从"引导注意力"推向了"清理搬运的内容",方向性的价值不小。
要说保留意见的话,也有几条。
其一,基准是合成的。语义场由研究者人工定义、LLM 实现成文,虽然每条经人工审核、盲审 \(\kappa\) 也不错,但合成数据的"冲突"都是构造出来的干净冲突——真实世界的检索冲突往往是模糊的、部分的、嵌在长文档深处的。论文自己在 Limitations 里也承认了这一点,算是诚实。
其二,评分用的是预定义答案原子上的归一化字面匹配。对"采纳了鸡蛋"这种判断够用,但对表达方式多样的长答案,字面匹配的覆盖边界在哪里,300 条人工验证之外还有多少误判,是个开放问题。
其三,机制分析只覆盖 8B–14B 的开源模型(加一个 Llama-2-13B 做历史对照),行为实验里最强的 GPT-5-mini 和 Gemini-2.5-Flash 无法做内部剖析。而行为数据显示闭源模型的 Conflict 表现反而略好一点(0.288–0.311),它们的内部机制是否同样遵循"值向量主导"的模式,只能靠推测。
其四,干预收益是 +5 到 6 个点,离"解决问题"很远——从 25% 修到 31%,还有 69% 的失败在那里摆着。这条路更像是证明了"因果通路找对了",而不是给出了可部署的修复方案。
对工程同学的启发,我觉得有三条可以直接拿走:
- 别指望规模和泛泛的指令能救。70B 模型、明确的"遵循技能、拒绝冲突检索"系统指令,照样 48.8 个点的差距。冲突鲁棒性需要专门的手段。
- 来源顺序有边际收益但不大。对调顺序只把 Conflict 从 16.9% 拉到 23.7%,值得做但别指望它解决问题。检索前的线索过滤、技能约束的显式校验点,可能更对症——尤其考虑到有害信号会被"上下文氛围"放大,检索段的改写和脱敏比想象中重要。
- 如果做内部干预,时机在生成早期、载体在值通路。\(t^\star\) 在前 3–5 个生成 token 处,错过这个窗口,修补原始 token 位置已经来不及了。
收尾
这篇论文最让我觉得有价值的地方,不是又添了一个幻觉分类法,而是它把"Agent 技能执行 + RAG"这个真实工程场景里最阴险的失败模式——看起来一切正常的被带偏——变成了可以精确测量、可以因果追踪的对象。25.7% 对 78.2% 这组数字,值得每一个在搭 Agent 系统的人记住。
当然,更根本的问题还没解决:模型为什么缺乏"这个信息在当前程序下不可用"的判断力?是训练数据里缺少这类选择性使用的信号,还是架构层面就没有做程序性过滤的机制?值向量通路给了我们一个观察切口,但切口不等于答案。
如果你在做 Agent 或 RAG 相关的系统,SourceClash 的十个领域和五路对照设计可以直接抄来做内部评测——至少先搞清楚,你的系统在冲突检索面前,到底站在 25% 这一侧还是 78% 那一侧。
论文链接:https://arxiv.org/abs/2610.25827
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我