同样的 token 预算,花在生成还是花在裁决?BOSS 把这个决策搬到了线上
你有没有算过一笔账:给推理模型 4000 token 的硬预算,是让它多采样几条解题路径,还是少采两条、把省下的 token 拿去"当裁判"比较已有答案?
这个问题听起来不起眼,但在真实部署里天天碰到。API 按 token 计费、服务有延迟上限,每一道题的预算就是死的。Self-Consistency 的做法是把预算全砸在采样上,最后多数投票;另一派 pairwise selection 的做法是先按固定计划生成,再拿 judge 模型做两两对比。两派各自都发展得很成熟——但"这一题剩下的 token 到底该继续生成还是开始裁决"这个在线决策,一直没人认真形式化过。
吉林大学联合中国电信星辰 AGI Lab、Bilibili、渥太华大学最近放出的论文 BOSS(arXiv: 2610.26383)就把这个问题摆到了台面上。方法本身不训练任何东西,纯粹是一个推理时的调度策略:在每个决策点,从 Return / Generate / Adjudicate 三个动作里选一个,所有 token 走同一个台账,每次调用前做最坏情况的预算检查。就这么个朴素的方案,在 Llama-3.1 两个规模、四个推理基准、24 个 model-task-budget 组合里拿下 22 个最优。
我的判断先放这:这篇论文单点技术不新(停止规则、pairwise judging 都是现成的),但它把"生成-裁决分配"论证成了一个独立的设计维度,实验控制做得相当干净——尤其是同一候选池只换选择器的那组对照,是我最近看到比较漂亮的消融设计。
📖 论文信息
- 标题:BOSS: Token-Budgeted Online Sampling and Selection for LLM Reasoning
- 作者:Yupeng Chang, Yahan Li, Chenlu Guo, Diana Inkpen, Yuan Wu, Yi Chang
- 机构:吉林大学人工智能学院、中国电信人工智能技术(北京)星辰 AGI Lab、Bilibili、渥太华大学
- arXiv:2610.26383,2026 年 10 月 19 日提交
- 代码:https://anonymous.4open.science/r/boss-BF00/
🎯 核心摘要
测试时扩展(test-time scaling)的既有工作要么自适应控制生成长度,要么在固定生成计划之后做答案选择,没人把"剩余 token 花在生成还是裁决"当成一个在线分配问题。BOSS 给出了一个 training-free 的三路决策策略:共识够了就返回,新答案假设还在涌现就继续采样,新颖度枯竭且预算付得起裁决开销就切换到成对比较。两代 Llama、四个基准、三种硬预算下,24 个格子里 BOSS 拿了 22 个最高分;Llama-3.1-8B 在 4k 预算下 macro 平均 60.5,比 Adaptive-Consistency(58.6)、TALE-EP(59.1)、固定调度的 League(58.9)都高。最有说服力的是同池实验:完全不动候选答案池,只把多数投票换成随机 A/B 重复裁决,分数就从 58.4 涨到 60.3。这不是底层突破,是一个被论证得很扎实的工程洞察——答案选择应该是预算下的一等公民动作,而不是免费的后续处理。
🤔 问题动机:被"顺手"处理掉的分配决策
先说清楚为什么这是个真问题,而不是造出来的伪命题。
部署侧的约束是每实例硬预算 \(B\):一道题的所有 prompt 加 completion token 加起来不能超。注意是"每实例"——不是全数据集平均,是每一道题都有天花板。这个设定非常贴近真实 API 场景。
在这个约束下,token 的花法有质的区别。多采一条推理轨迹,是花钱扩大"假设空间";调用一次 judge 比较"答案是 72 还是 48",是花钱在已有假设里做筛选。这两件事抢同一笔预算。而且裁决一点都不便宜——judge 的 prompt 里要装下原题加两个候选的完整推理过程,一次比较的 prompt 开销可能比一次生成的 completion 还贵。
现有工作怎么处理这个矛盾的?Adaptive-Consistency、ESC 这类方法决定"还要不要继续采样",但采完就直接投票了,不会把剩余预算导去裁决。TALE-EP、s1 的 budget forcing 控制的是单条轨迹的长度。另一边,pairwise selection 一派(Knockout、League 这些)会花算力做比较,但生成计划是事先定死的——先生成多少条、再留多少预算做选择,这个比例是在开发集上调好就固定下来的。
你看出问题了吧:两派方法都隐含地替你做了分配决策,但都没把决策放到线上。固定调度的 League 在预算充裕时可能生成不足、假设池太浅;在预算紧张时又可能生成过头、裁决没钱做了。而同一道题,简单题生成三条就收敛了,难题可能八条还在打架——固定比例怎么可能两头都占。
所以论文把这个缺口形式化成一个三路在线决策:
看到新候选之后,要么直接返回当前答案,要么再生成一条,要么冻结候选池、把剩余预算全部花在两两比较上。这个形式化的价值在于把"分配"从各个具体方法里剥离出来了——你可以往里塞任何停止规则和任何 judge。
🏗️ 方法核心:一个台账,两道闸门
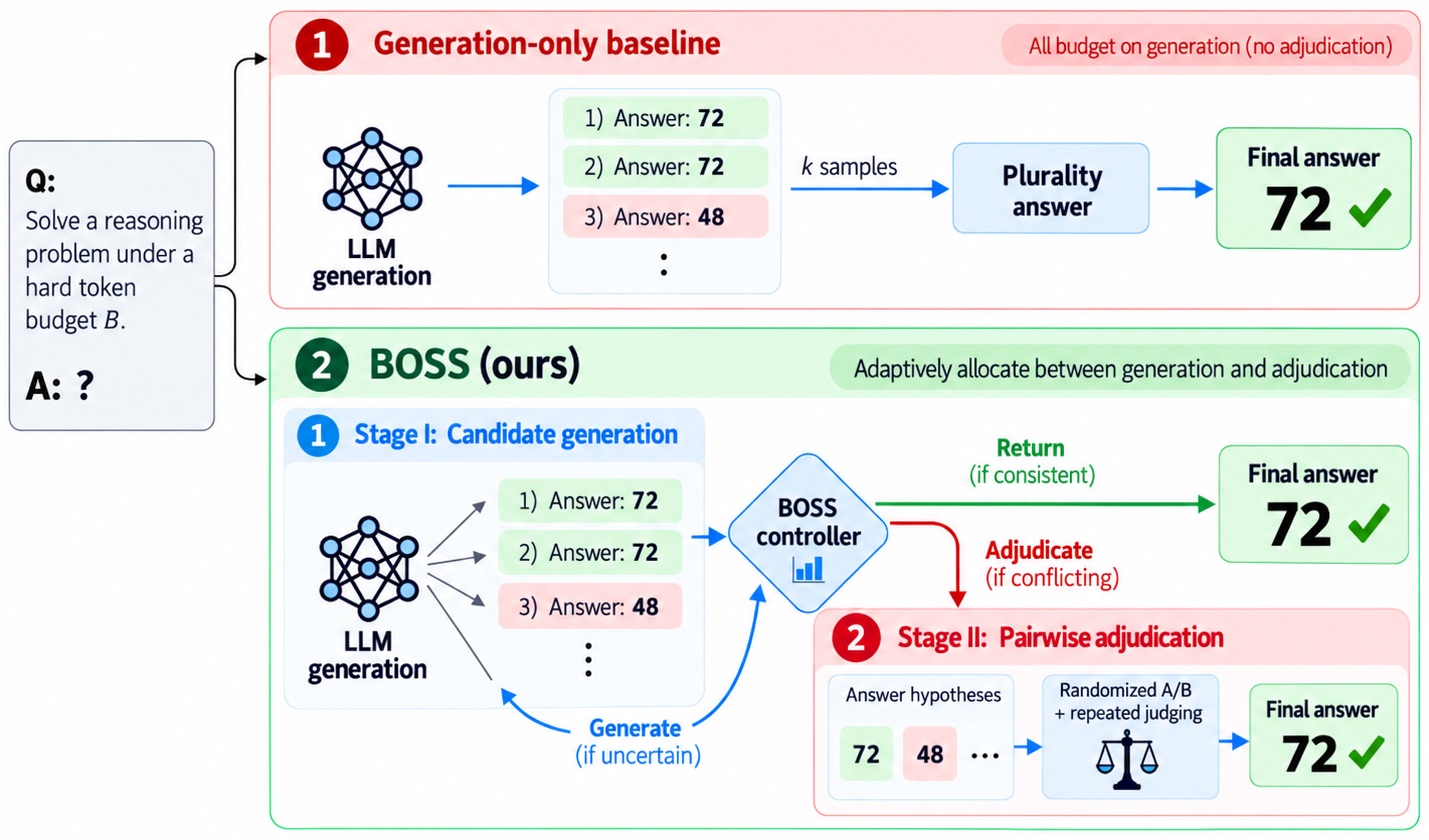
图 1:BOSS 总览。上方面板是 generation-only 基线:全部预算用于生成 k 个样本再多数投票;下方面板是 BOSS:候选一致就直接返回,冲突时由 controller 决定继续生成还是进入 Stage II 的成对裁决。题目"答案 72 还是 48"的例子里,两条路径最终都答对,但 BOSS 用更少的采样拿到了更稳的判断。
预算安全:最坏情况检查
整个方法的地基是一条硬约束。第 \(t\) 次调用消耗 \(c_t = \mathrm{tok}(p_t) + \mathrm{tok}(y_t)\),要求:
关键在于怎么保证不超支。BOSS 的做法简单粗暴但严谨:每次发起调用前,按最坏情况算成本——prompt 长度加上 completion 上限 \(L\):
只有这个不等式成立才发调用。因为实际输出永远不会超过上限,所以预算永远不会爆。生成调用的上限是 \(L^{\mathrm{gen}} = 1024\),judge 调用的上限只有 4 个 token——judge 被约束解码只输出 A 或 B,无效输出当弃权处理。这个细节我喜欢:judge 的回答本来就是单 token 的,把它的成本上限压到最低,等于把裁决的单价降到极限。
顺便说一句,并行的基线(FFS、short-\(m@k\))也被同样记账:所有活跃流的 token 都算到终止为止,包括那些没贡献答案的半成品流。这一点对公平性很重要,后面实验部分还会提到。
Stage I:共识停止 + 新颖度切换
Stage I 就是不断采样,但每采一条之后做两个检查。
共识检查决定要不要提前返回。设解析出的答案频率,多数答案占比超过 \(\tau_{\mathrm{cons}} = 0.70\) 且与第二名差 \(m_{\mathrm{gap}} = 2\) 票以上,就直接返回,后面的预算全省了。这是对 Adaptive-Consistency 一脉思路的继承。
新颖度检查决定要不要切换到裁决。定义一个滑动窗口的新颖度:
\(\mathcal{U}_{\leq t}\) 是到 \(t\) 为止见过的不同答案集合,\(W = 4\) 是窗口。意思是:最近 4 条采样里,还有几条带来了从未见过的新答案。当新颖度掉到 \(\rho_{\mathrm{novel}} = 0.25\) 以下、且手里至少有两个不同答案时——继续采样大概率只是在已有假设里打转,边际价值开始低于"把这几个假设拉出来比一比"。
这两道闸门的设计里有个我觉得值得单独拎出来的洞察:共识和新颖度是两个独立信号,不能互相替代。高共识支持返回(答案已经稳了),低共识 + 低新颖度支持裁决(采样在原地踏步但没有答案占优)。如果你只用一个信号,就会在这种中间状态里犯错——要么浪费 token 继续采,要么过早把还没收敛的池子拿去裁决。
还有个务实的设计:切换闸门跟预算台账耦合。只有当剩余预算付得起至少一次完整的比较调用(含 prompt)时才允许切换,否则 Stage II 根本不可行。反过来,新颖度还高的时候就算有两个答案也不切,因为假设空间还在扩张。这让 BOSS 在不同预算下会自发表现出不同行为,不用改超参——后面机制分析会验证这一点。
Stage II:不是锦标赛,是在线安排的擂台赛
进入 Stage II 后,先按答案频率保留最多 \(K_{\max} = 5\) 个假设,每个假设挑一个最短的代表性推理(超过 256 token 会截断,但保留答案行——控制比较 prompt 的开销)。
然后是成对比较。直接做循环赛会浪费,BOSS 借用了 dueling bandits 的思路(就是引用了 Yue et al. 2012 那套 K-armed dueling bandits),给每个假设维护一个平滑胜率:
\(w_a\) 是胜场,\(g_a\) 是场次,\(\alpha = 1.0\) 是平滑常数。每轮挑 UCB 最高的两个假设打,打完用类似 LCB 的半径剪掉明显被支配的假设。每场比赛用随机 A/B 顺序并最多重复 \(R = 3\) 次投票取多数——这两个手段是对 LLM-as-a-judge 位置偏差的标准缓解,论文里 Figure 2(b) 的数据会告诉你这一步有多关键。
预算耗尽或只剩一个活跃假设时结束,返回 \(\hat{p}_a\) 最高的假设,平局按 Stage I 频率、代表长度、字典序确定性打破。如果一场比较都没做成,回退到多数投票。
整套流程没有任何训练,全靠推理时的规则调度。说实话我看到这里的第一反应是:这不就是个规则系统吗,能有多少肉?但看到实验部分我收回了一半的轻视——肉不在单个组件,在组件之间的耦合方式和验证耦合价值的实验设计。
🧪 实验:24 个格子拿 22 个,但这不是重点
主实验:硬预算对比
主表在 Llama-3.1-8B-Instruct 和 70B-Instruct 两个规模上跑 GSM8K、MATH、GPQA-Diamond、MMLU-Pro,预算 \(B \in \{2\mathrm{k}, 4\mathrm{k}, 8\mathrm{k}\}\),5 个随机种子取平均。所有方法走同一套 token 台账、解码上限和解析接口。
8B 在 \(B=4\mathrm{k}\) 的关键数字(各基准准确率,%):
| 方法 | GSM8K | MATH | GPQA-D | MMLU-Pro |
|---|---|---|---|---|
| CoT@1(贪心) | 84.5 | 51.9 | 30.4 | 48.3 |
| SC(预算化) | 87.3 | 56.6 | 35.7 | 51.2 |
| ESC | 87.6 | 56.8 | 36.1 | 51.6 |
| short-\(m@k\) | 87.9 | 57.1 | 35.9 | 51.8 |
| League(固定调度) | 87.5 | 57.2 | 37.8 | 52.9 |
| BOSS | 88.8 | 59.4 | 39.5 | 54.4 |
24 个 model-task-budget 格子里 BOSS 拿了 22 个最优。\(4\mathrm{k}\) 和 \(8\mathrm{k}\) 下全列领先;\(2\mathrm{k}\) 时丢了两个格子,都是 GSM8K,被 FFS 拿走——预算太紧时裁决付不起钱,而 GSM8K 这种饱和基准上多采一条的边际价值更高,这个失败模式跟方法的设计逻辑自洽。最大的差距出现在 MATH 和 GPQA-Diamond 上,竞争级数学和研究生级科学的题目里竞争性假设更多,裁决的空间更大。
配对逐题检验(8B、\(4\mathrm{k}\),对每个基准最强的非 BOSS 基线):GSM8K 提升 0.9 个点(p=0.021),MATH 提升 2.2 个点(p<0.001),GPQA-D 提升 1.7 个点(p=0.026),MMLU-Pro 提升 1.5 个点(p<0.001)。四个都过了 0.05 的显著性线。
70B 上的模式类似,比如 MATH 在 \(8\mathrm{k}\) 下 BOSS 77.6 对 League 76.1。模型变强,分配问题的价值没有消失。
同池实验:这篇论文最漂亮的地方
主表赢了不算数——可能是你候选生成得更好,可能是你偷偷用了没记账的开销。论文设计了一组"同一候选池"的对照:完全复用 BOSS Stage I 采出来的候选,只换最后一步的选择器。
| 选择器(同一候选池,8B,\(B=4\mathrm{k}\)) | Macro(%) |
|---|---|
| 多数投票 | 58.4 |
| 单次固定顺序 judge | 59.1 |
| 随机 A/B judge | 59.7 |
| 随机 A/B + 重复投票 | 60.3 |
| 完整 BOSS 选择器 | 60.5 |
这组数字能拆出两层信息。第一层:从多数投票到随机 A/B + 重复投票的 1.9 个点,全部来自裁决本身——候选一个字没变。第二层:随机化和重复投票各自贡献了大约 0.6 和 0.6 个点,说明 LLM judge 的位置偏差不是玄学,是被量化了的实打实的税。
错误恢复的分析更细:在多数投票错了但正确假设已经在池子里的案例中,重复裁决能救回 22.8%,代价是把原本对的 2.0% 改错;完整 BOSS 选择器救回 25.1%,误伤 2.2%。十比一的恢复伤害比,这个交换是划算的。
分配机制的消融
组件消融(8B,\(B=4\mathrm{k}\),macro 平均):
| 变体 | MATH | GPQA-D | Avg |
|---|---|---|---|
| BOSS(完整) | 59.4 | 39.5 | 60.5 |
| 去掉提前停止 | 58.0 | 38.7 | 59.6 |
| 去掉新颖度切换 | 58.1 | 37.6 | 59.0 |
| 固定生成-选择比例 | 58.5 | 38.1 | 59.3 |
| 固定顺序单票 judge | 56.8 | 35.0 | 57.7 |
| 循环赛调度 | 57.4 | 37.1 | 58.8 |
| 完整代表(不截断) | 55.9 | 38.3 | 58.3 |
几个值得停一下的数字。把 judge 换成固定顺序单票,掉到 57.7——一个选择器的实现细节能值 2.8 个点,这在选择类方法里应该是通用教训。代表不截断掉到 58.3:长 prompt 挤占了能做的比较次数,同样 2.2 个点没了。裁决的质量和数量都是被预算买出来的,这反过来又印证了"分配是个独立设计轴"的核心论点。
在线分配 vs 固定分配的对比也有:开发集调好的固定生成-选择比例拿到 59.3,去掉新颖度切换拿到 59.0,完整 BOSS 是 60.5。在线决策的溢价在 1.2 到 1.5 个点之间。说实话这个差距不算碾压——如果你的场景预算永远固定、题目难度分布均匀,一个调好的静态比例可能够用。BOSS 的优势在异质场景:题目难度混杂、预算档位多变时,一套超参不用改就能自适应。
成本匹配:把"占便宜"的质疑堵上
硬预算对比有个天然质疑:自适应方法会提前停,BOSS 把预算用到 98.7%(4k 预算下平均实际用 3947 token),别的早停方法平均只用 2500 多。同样上限不等于同样花费,这是所有 cap-matched 评估的软肋。
论文的回应是近似成本匹配的运行点:
| 方法 | 平均 token | Macro(%) |
|---|---|---|
| BOSS | ≈2,500 | 58.4 |
| Adaptive-Consistency | 2,508 | 58.6 |
| BOSS | ≈3,100 | 59.4 |
| TALE-EP | 3,074 | 59.1 |
| BOSS | ≈3,850 | 60.3 |
| League | 3,853 | 58.9 |
在 2.5k 附近,Adaptive-Consistency 反超 0.2 个点;到了 3.1k,BOSS 领先 0.3;到 3.85k,领先扩大到 1.4。结论清晰:裁决的价值随可用预算增长——钱不够时先保证假设池的覆盖是对的,钱多了之后比较才开始值钱。这个 trade-off 曲线本身就是对"什么时候该用裁决"这个问题的定量回答,比一味宣称全面领先要诚实得多。
机制分析:它真的在做自己声称的事
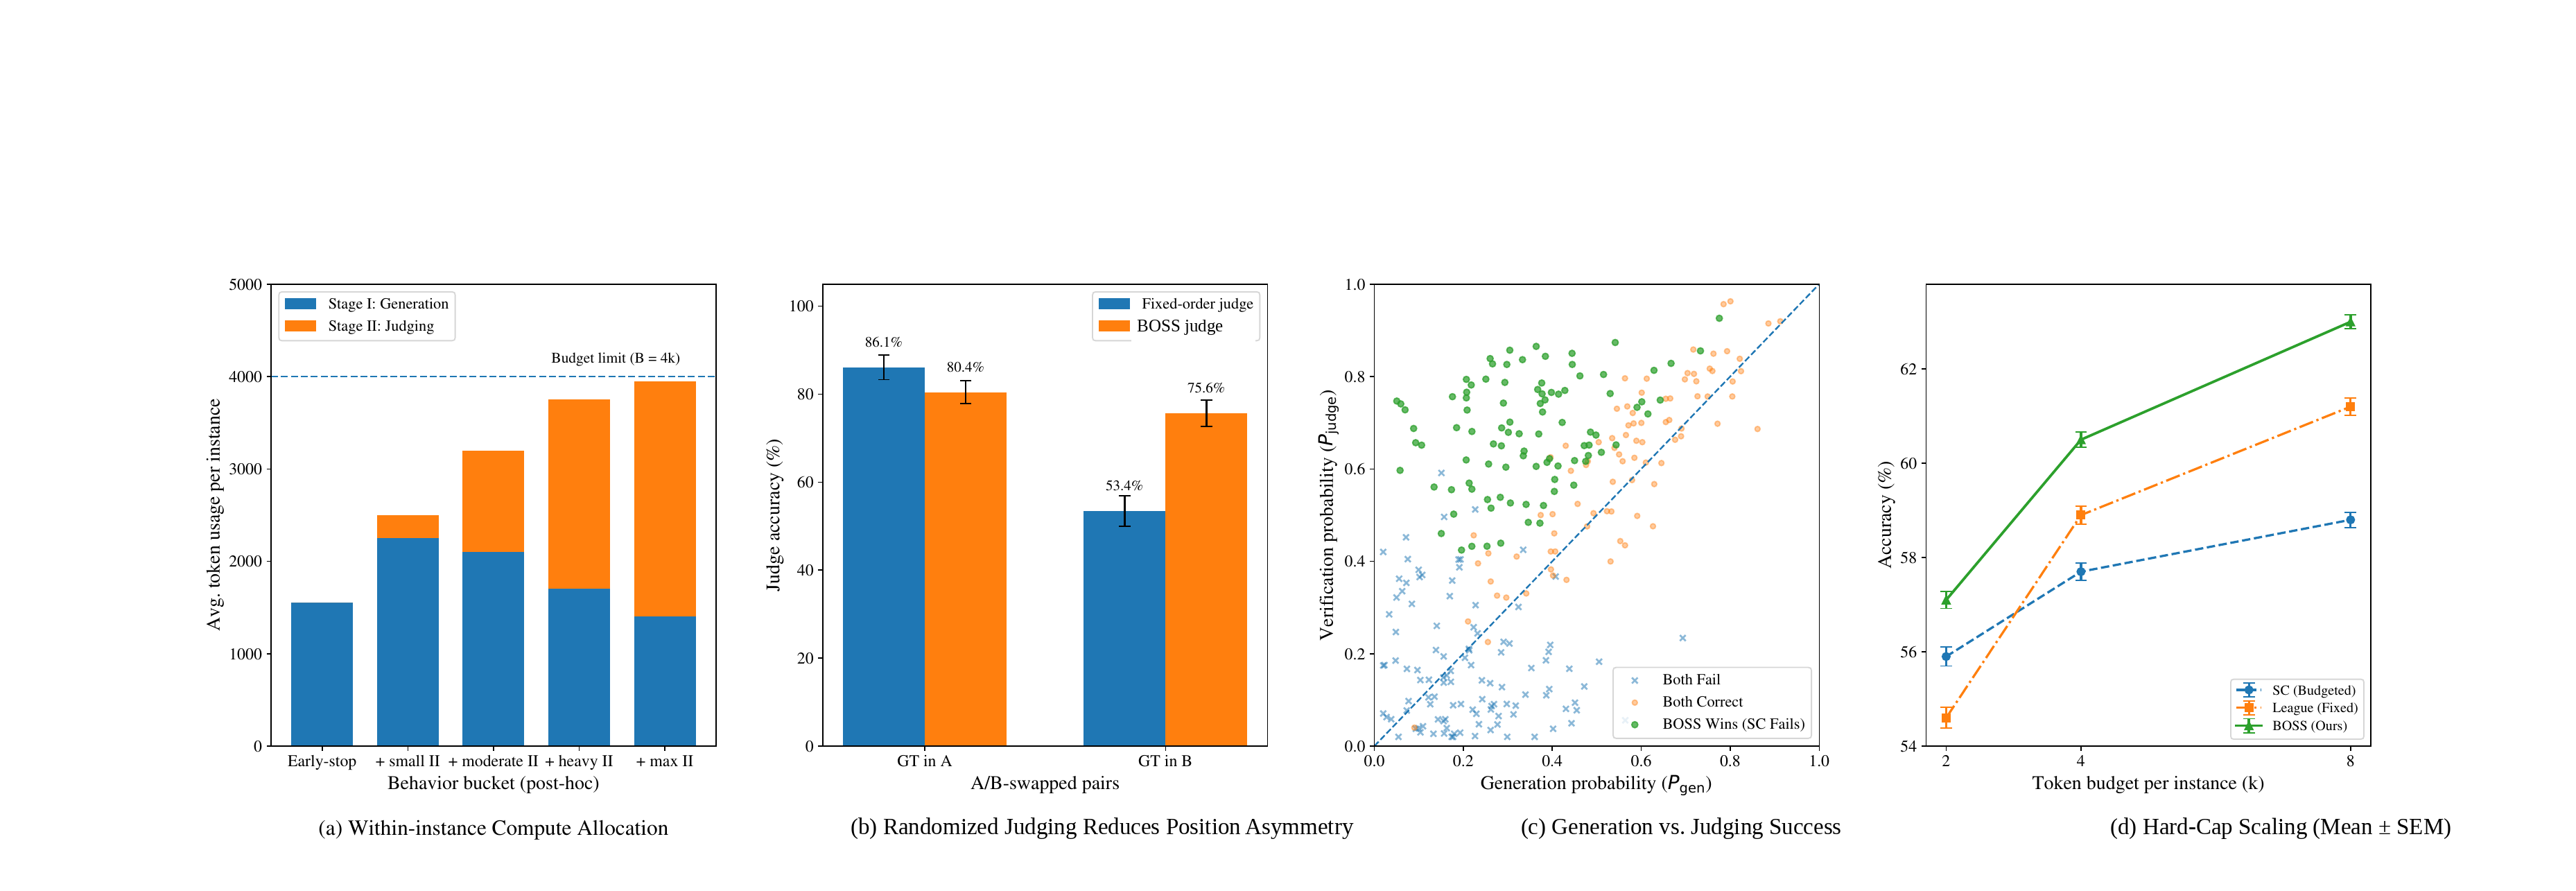
图 2:四个机制诊断。(a) 把实例按行为分桶后,Stage II 占比随预算上升,8k 时裁决 token 超过生成 token;(b) 固定顺序 judge 在正确答案位于 A 位和 B 位的准确率是 86.1% 对 51.6%,BOSS 的随机化裁决把它压到 80.0% 对 75.6%;(c) 散点显示 BOSS 赢而 Self-Consistency 输的案例集中在裁决成功率高于生成概率的区域;(d) 预算从 2k 到 8k,BOSS 始终高于 BoN-Softmax 和预算化 SC,且差距随预算扩大。
这张图基本回答了"BOSS 是不是真在动态分配"的疑问。Stage II 的进入率随预算从 2k 的 31.8% 涨到 4k 的 84.1%、8k 的 94.1%,同时"预算耗尽被迫多数投票"的安全回退从 65.6% 掉到 1.2%。生成 token 只从 1445 涨到 1987,多出来的预算几乎全灌进了裁决——8k 时 judge 的 token(5924)是生成(1987)的三倍。预算越多,BOSS 越像个裁判而不是生成器,这正是方法设计的预期行为。
(b) 那个子图值得所有用 LLM judge 的人存一下:固定顺序下,正确答案放 A 位 judge 准确率 86.1%,放 B 位只有 51.6%——34 个点的位置偏差。随机 A/B 加重复投票把不对称压到 80.0% 对 75.6%。位置偏差不是小到可以忽略的噪声。
超参敏感性也稳:新颖度阈值 \(\rho_{\mathrm{novel}}\) 从 0 扫到 0.5,macro 在 59.4 到 60.5 之间晃;窗口 \(W\) 和共识阈值 \(\tau_{\mathrm{cons}}\) 在测试范围内也都落在 59.9 到 60.5。没有悬崖式的敏感点,对一个规则系统来说这算交代得过去。
🔬 我的判断
聊完了干货,说说我自己的几点看法。
这篇论文的真实贡献是"问题定义 + 干净验证",不是新算法。共识停止是 Adaptive-Consistency 的,随机 A/B 重复投票是 judge bias 文献里的标准操作,UCB 调度是 dueling bandits 的现成货。BOSS 的价值在于把这些零件放进一个预算感知的在线框架里,然后用同池对照、成本匹配、组件消融这三级证据把"分配本身值钱"这个因果链钉死了。我特别欣赏同池实验的设计——很多 selection 类论文赢完主表就收工,你永远不知道增益是来自更好的候选还是更好的选择,这篇论文用"冻结候选池只换选择器"一剑封喉地回答了。
几个让我皱眉的地方。第一,收益规模。1 到 2 个点的 macro 提升,放在 2026 年的测试时扩展文献里不算大——尤其考虑到 BOSS 平均把预算花到 98.7%,等于用满了钱才换来这些点,而成本匹配曲线也承认 2.5k 附近会输给 Adaptive-Consistency。它买的是"预算利用效率",不是绝对性能。第二,只测了 Llama-3.1 系列。推理特化的模型(o 系、R1 蒸馏系)答案分布可能完全不同——长思维链模型一道题几千 token,2k 预算可能一条完整推理都装不下,整个三路决策的存在前提就变了。论文自己在 Limitations 里也承认了这一点,算是诚实。第三,judge 和 generator 是同一个模型,自评的系统性偏差(比如偏好自己风格的答案)没有被讨论,这块说实话我也不是特别确定影响有多大,但至少值得一个消融。
工程上能不能抄?能,而且门槛很低。整个方法是 training-free 的,核心就是公式 (6) 的最坏情况预算检查加两条切换规则,一个下午就能接到现有 inference pipeline 上。最值得直接搬的是三件事:judge 的 4 token 约束解码(把裁决单价压到地板)、随机 A/B 加重复投票(如果你还在用固定顺序单票 judge,Figure 2(b) 那 34 个点的偏差就是你在交的税)、代表截断到 256 token(省出来的钱能多做几轮比较)。如果你的产品场景是按题限流的推理服务,BOSS 的分配思路值得认真试。
还有一个更远的问题没解决:这篇论文做的是实例内的分配,另一条线(难度自适应的跨实例分配)是正交的。真实的推理服务里两层分配会嵌套——全局预算怎么分给题目、每道题内部怎么分给生成和裁决——两层联合优化目前还是空白。
📚 收个尾
测试时扩展做到今天,"花更多算力"的红利吃得差不多了,接下来的肉在"怎么花算力"上。BOSS 把答案选择从免费的后续处理提升成了预算下的一等公民动作,这个提法我认为会留下来。它可能不会以原始形态成为什么标配——规则系统的天花板摆在那里——但"生成-裁决分配"作为设计维度,会被后续的 learned policy、过程奖励模型这些更强的基础设施继承下去。
如果你在做按 token 计费的推理产品,这篇论文和它的同池实验设计,值得花四十分钟读一遍原文。
论文:https://arxiv.org/abs/2610.26383
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我