PPO 的裁剪方向一直是错的?EPIC 用前缀重要性比率重构信任域,off-policy 训练 MoE 不再需要路由重放
上周读了一篇让我眼前一亮的论文(arXiv:2610.29999)。它回答了一个在 LLM RL 工程圈里吵了很久、但一直没有理论定论的问题:裁剪(clipping)到底应该在什么粒度上做?
核心摘要
做 LLM 强化学习的人都知道,现在的训练管线根本做不到严格 on-policy——异步 rollout、推理引擎和训练引擎的 kernel 差异,让行为策略(采样用的那个模型)和目标策略之间始终存在分布失配。PPO 的 token 级裁剪只盯着当前 token 的条件概率,但问题是:条件上下文(前缀)本身就是策略生成的,你只看局部概率等于漏掉了策略漂移的大头。
这篇论文(EPIC)做的事情很"回到原点":把自回归生成重新写成有限时域 MDP,严格推导性能差恒等式,发现前缀似然比才是每步改进项的精确重要性权重;然后从 TRPO 的单调改进原则出发,用精确 reverse-KL 坐标 \(r-1-\log r\)(而不是 PPO 的二次近似)构造前缀级信任域,得到一个 PPO 风格的序列裁剪目标。
效果:在 Qwen3-30B-A3B 稀疏 MoE 的强 off-policy 训练中,四个数学推理基准平均 39.34%,比 GRPO 高 10.69 个点,比 GSPO 高 6.50 个点;并且不需要任何 expert routing replay,driver 进程内存比 R2 方案低 77.5%。
我的评价:这是一篇理论驱动、工程落地也扎实的论文。它不是又一篇"调参刷榜"的工作,而是真正把"自回归 LLM 的信任域应该长什么样"这个问题从头推导了一遍。值得细读。
📖 论文信息
- 标题:EPIC: Rethinking Trust Regions for Autoregressive LLM Policies via Exact-KL Prefix Importance-Ratio Clipping
- 作者:Chengxi Li, Hanlin Wu, Zhicheng Cai, Huan-ang Gao, Wei-Ying Ma, Jingjing Liu, Hao Zhou(清华 AIR、ByteDance Seed 等)
- 链接:https://arxiv.org/abs/2610.29999
- 代码:https://github.com/LiChengxi666/EPIC
- 发表时间:2026 年 10 月 21 日
🎯 问题:token 级裁剪到底漏掉了什么?
先讲一个工程上的真实处境。现在主流的 RLVR(可验证奖励强化学习)训练管线——verl、slime 这类框架——都是全异步的:rollout 集群在一边采样,训练集群在另一边更新,中间隔着不知道多少个 step。再加上推理引擎(vLLM/SGLang)和训练引擎(Megatron/FSDP)在 kernel 实现上的数值差异,你拿到的 log-prob 跟采样时的真实分布根本不是一回事。
严格意义上的 on-policy 训练,在工业界已经不存在了。
那怎么办?PPO 给的答案是裁剪:重要性比率 \(r_t = \pi_\theta(a_t|s_t)/\mu(a_t|s_t)\) 偏离 1 太多就 clip 掉,限制策略每步的变化幅度。这个设计在经典 RL 里 work 得很好,但搬到自回归 LLM 上有个微妙的错位——
token 级裁剪只衡量"在当前前缀下选这个 token 的概率变了多少",但前缀本身也是策略生成的。回复越长,策略在前缀上的累积漂移越大,而这个漂移在 token 级比率里完全不可见。你可能每个 token 的比率都在裁剪范围内,但整条回复的似然比早就飞到天上去了。
等等,业界不是已经意识到这个问题了吗?对,GSPO(Qwen 团队)就是把重要性比率从 token 级抬到序列级,现在 Ling-2.6、Qwen-AgentWorld 这些都在用 GSPO 风格的序列裁剪;而 DeepSeek-V4、GLM-5 还在用 GRPO 风格的 token 级裁剪。两条路线并存,谁对?没人从理论上说过清楚。
MoE 模型还有额外的坑:采样和训练两次前向之间,专家路由会翻转,token 级比率噪声大到直接把训练打崩。所以工程上搞出了 Routing Replay(R2/R3)——把采样时的专家路由索引存下来,训练时强制重放。这能压住失配,但代价是要存海量路由索引(论文附录里算过,单个 dense routing tensor 在 9000 token 回复下要 1.65 GiB),还限制了学习自由度。
这篇论文的作者大概是受不了了:与其在工程上打补丁,不如回到 PPO-clip 的设计原点——TRPO 的 KL 信任域——把自回归场景下的信任域从头推导一遍,看看到底应该裁剪什么。
🧠 方法:从性能差恒等式到前缀信任域
第一步:把自回归生成写成 MDP
给定 prompt \(x\),位置 \(t\) 的状态是 \(s_t=(x, y_{<t})\),动作 \(a_t=y_t\),转移是确定性的:\(s_{t+1}=(x,y_{\le t})\)。固定时域 \(H\),提前结束的回复用 eos 补齐、零奖励。
因为转移确定,Bellman 恒等式里的期望消失了,优势退化成:
沿轨迹对这个式子求和,中间的价值项全部抵消,得到性能差恒等式:
到这一步还是标准操作。关键在下一步。
第二步:测度变换,找出精确重要性权重
现在想把这个期望从 \(\pi\) 下采样换成 \(\mu\)(行为策略)下采样。在共同支撑假设下,定义前缀重要性权重:
注意这里是从第 1 个 token 到第 \(t\) 个 token 的累积似然比,不是单步的。代入测度变换,得到精确的自回归性能差恒等式:
这个式子值得停下来看一眼。它说:第 \(t\) 步的策略改进项,正确的加权系数是前缀比率 \(r_t^{\mathrm{pre}}\)——它同时修正了"到达状态 \(s_t\)"和"选择动作 \(a_t\)"这两件事的概率。而且不需要后缀比率,因为精确优势 \(A^\mu\) 已经对 \(\mu\) 下的未来回报取过平均了。
这就是 token 级裁剪错在哪里的理论答案:\(r_t^{\mathrm{pre}}\) 才是精确权重,单步比率只是它的最后一个因子。
第三步:构造信任域,但不是 PPO 那种
有了精确权重,接下来是信任域。定义前缀级 KL:
以及最大逐 token 累积 KL:\(\mathcal{D}_x^{\mathrm{pre}}(\mu,\pi)=\max_t K_{x,t}(\mu,\pi)/t\)。作者证明了一个 TRPO 风格的单调改进命题(命题 1):下界目标 \(B_{\mu,x}^{\mathrm{pre}}(\pi)=S_{\mu,x}^{\mathrm{pre}}(\pi)-\lambda\mathcal{D}_x^{\mathrm{pre}}(\mu,\pi)\) 满足
任何提升这个下界的更新都保证真实性能单调不降。等价的约束形式是 \(K_{x,t}(\mu,\pi)\le t\delta,\ \forall t\)——预算随时域线性增长。
第四步:从 KL 约束到可计算的裁剪边界
到这里还是理论。怎么变成一个能跑的目标函数?关键技巧是利用 \(\mathbb{E}_\mu[r_t^{\mathrm{pre}}]=1\),把前缀 KL 写成比率的精确函数:
\(\phi\) 就是精确的 reverse-KL 坐标:严格凸、非负、在 \(r=1\) 处取 0。PPO 的裁剪本质上是 \(\phi\) 在 \(r=1\) 附近的二次近似的代理,而这里直接用精确坐标。
然后给每个样本每个位置解一个逐点预算。预算用行为策略前缀概率的几何均值做校准:
再求解 \(\phi(\ell_{i,t})=\kappa^-_{i,t}\)、\(\phi(u_{i,t})=\kappa^+_{i,t}\) 得到每个位置的裁剪下界和上界。这个除法的设计意图是:前缀概率越小的样本(越长的回复),裁剪边界越宽——概率校准。
实际计算上有个很漂亮的性质:前缀对数比率就是个累积和,
\(O(T_i)\) 一次扫完,不需要额外的模型前向。
最后还差一步:裁剪作用在几何平均权重 \(g_{i,t}=(r^{\mathrm{pre}}_{i,t})^{1/t}\) 上,但梯度怎么传?作者用了 straight-through 构造:
前向值是前缀几何均值,但梯度只流过当前 token 的 log-prob(\(\nabla_\theta\widetilde{g}_{i,t}=g_{i,t}\nabla_\theta\log\pi_\theta\))。再配上符号感知的双重裁剪算子(正优势只 clip 上界,负优势上下都 clip),得到最终目标:
说实话这个 straight-through 设计我第一反应是"这梯度估计会不会有偏"——但仔细想想,这正是 GSPO 那类序列级方法的标准做法:用序列级比率做裁剪决策,梯度仍走 token 级。不同的是 EPIC 的裁剪边界是从精确 KL 坐标解出来的,每个位置、每个样本都不一样,而不是一个全局常数。
🧪 实验:off-policy MoE 训练上见真章
实验设置:Qwen3-30B-A3B-Base(稀疏 MoE),训练数据是处理后的 DAPO-Math-17K,规则验证器给二值正确性奖励。评测四个数学基准:AIME 2024/2025、AMC 2023、HMMT 2025。baseline 包括 GRPO、DAPO、GSPO、CTPO、RIPO,全部用各自公开的默认裁剪参数。EPIC 的预算取 \(\delta^-=5\times10^{-4}\)、\(\delta^+=2\times10^{-3}\),更新深度 8。主结果是 3 个独立种子的平均。
主结果表(Table 1,Accuracy %):
| Method | AIME 24 | AIME 25 | AMC 23 | HMMT 25 | Average |
|---|---|---|---|---|---|
| GRPO | 23.61 | 16.81 | 69.48 | 4.72 | 28.65 |
| DAPO | 31.67 | 24.03 | 76.25 | 9.86 | 35.45 |
| GSPO | 30.00 | 20.56 | 73.44 | 7.36 | 32.84 |
| CTPO | 30.14 | 20.97 | 76.04 | 8.75 | 33.98 |
| RIPO | 26.94 | 21.81 | 74.69 | 8.47 | 32.98 |
| EPIC | 38.06 | 25.28 | 77.92 | 16.11 | 39.34 |
几个数值得单拎出来说。
HMMT 2025 上 EPIC 拿 16.11%,第二名 DAPO 是 9.86%——相对提升 63%。HMMT 是这四个基准里最难的(GRPO 只有 4.72%),越难的任务回复越长、off-policy 程度越严重,正好是前缀漂移最致命的场景。EPIC 在最难基准上拉开最大差距,这跟理论预测完全一致。
平均 39.34%,比 GSPO 高 6.50 个点。GSPO 已经是序列级裁剪的代表了,EPIC 还能再涨,说明"序列级"和"前缀级 + 精确 KL 坐标 + 概率校准边界"之间确实有真实的差距,不是换汤不换药。
另外一个让我比较信服的细节:训练全程的验证曲线和后期训练奖励 EPIC 都是最高的,不是那种"最后一刻 checkpoint 运气好"的赢法。
与 Routing Replay 的正面对比
这是我觉得最有工程价值的部分。MoE 训练的"正统"稳定性方案是 R2/R3 路由重放,EPIC 声称自己不需要它。直接对比:
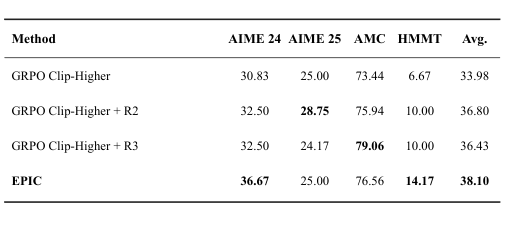
EPIC(38.10% 平均)不存任何路由索引,却比 GRPO Clip-Higher + R2(36.80%)和 + R3(36.43%)都略好,HMMT 上 14.17% 对 10.00% 优势明显。
再看内存账:
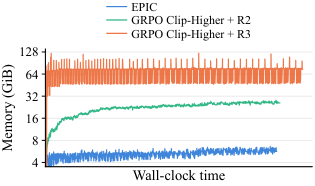
这张图信息量很大(注意 y 轴是对数刻度,4 到 128 GiB):R3 方案 driver 进程常驻 64~100+ GiB,R2 在 16~32 GiB 之间爬坡,而 EPIC 全程压在 4~8 GiB。论文给的中位数对比:EPIC 比 R2 低 77.5%,比 R3 低 93.0%。三者回复长度相近(R2 8557、R3 9476、EPIC 9001 tokens),排除了"EPIC 内存低是因为生成短"的可能。
一句话:不用存路由索引,性能还更好。 这对要在有限资源上跑 MoE RL 的团队是很实在的吸引力。
消融:裁剪位置的均匀性
作者还做了一组我很少在同类论文里看到的分析——裁剪活动到底发生在回复的哪些位置?
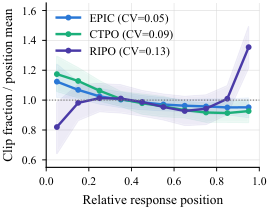
这张图横轴是相对回复位置(0 是开头,1 是结尾),纵轴是该位置裁剪比例除以全局均值。RIPO(紫色)在回复结尾处飙到 1.4 左右——裁剪严重集中在尾部;而 EPIC(蓝色)全程贴着 1.0 的虚线走,变异系数 CV 只有 0.05,CTPO 是 0.09,RIPO 是 0.13。
训练动态上更直观:
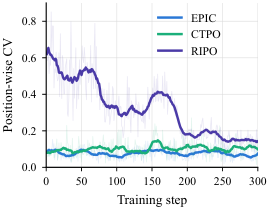
RIPO 的 CV 起步在 0.6 以上,训练 300 步后才降到 0.1 左右;EPIC 全程压在 0.1 以下。裁剪在回复各位置均匀分布,说明 EPIC 的信任域确实在所有前缀位置都在起作用,而不是只在某些位置装装样子。
概率校准的作用也被单独验证了:
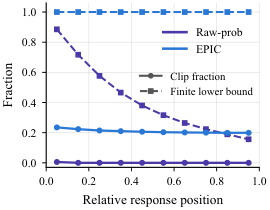
虚线是"有限下界"的比例,实线是裁剪比例。Raw-prob(紫色)方案下,随着回复位置靠后,有限下界迅速坍缩到 0——后半段的前缀实际上不被裁剪了,信任域形同虚设;几何均值校准(EPIC,蓝色)把裁剪比例稳定维持在 0.20~0.23,全位置都有保护。这个消融直接回答了"为什么预算里要除以 \(\mu(o_{i,1:t}|x)^{1/t}\)"——没有它,长回复尾部就是信任域的盲区。
附录里还有一张图也挺有意思:
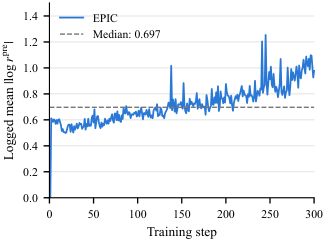
这是训练中实际观测到的前缀 log-ratio 幅度,中位数 0.697,后期涨到 1.0~1.2。这个量级提醒我们:在真实 off-policy 训练里,前缀漂移不是理论上的小扰动,而是 \(e^{1.0}\approx 2.7\) 倍级别的似然偏移。token 级裁剪对这种幅度的漂移基本无感。
💡 我的判断
亮点:
- 理论链条完整且自洽。从 MDP 重写 → 性能差恒等式 → 精确重要性权重 → TRPO 单调改进 → 精确 KL 坐标 → 可计算的裁剪边界,每一步都有出处,没有"凭直觉设计 loss"的环节。在 LLM RL 这个越来越像经验炼金的领域里,这种第一性原理的工作越来越少了。
- 对"裁剪粒度之争"给了理论裁决。GSPO vs GRPO 的 token/sequence 之争,本质是"正确的重要性权重是什么"。EPIC 的推导说:是前缀比率,而且每一时刻都不同——这比"整条序列一个比率"(GSPO)更细,比"每 token 一个比率"(GRPO)更准。
- 工程账算得漂亮。免路由重放、内存降 77.5%~93%、\(O(T)\) 的累积和计算、无额外前向——这是能直接搬进 verl/slime 的东西,代码也开源了。
要泼的冷水:
- 裁剪不是硬 KL 约束。作者自己在附录 7.2 给了一个反例:即使所有比率都被裁到平台值,真实 KL 依然可以发散到无穷。所以 EPIC 提供的是悲观代理目标,不是信任域投影——理论上标题党程度比正文低,这点作者还算诚实。
- 命题 1 依赖精确优势,实际用的是组相对估计 \(\widehat A_i\),理论上界和实际目标之间有缝。
- 评估面偏窄:单一模型(Qwen3-30B-A3B)、单一任务域(数学推理)。稠密模型上前缀比率会不会行为不同?非数学任务(代码、agentic)上裁剪预算怎么调?都没答案。内存指标也只是 driver 进程 CPU 内存,不是 GPU 或集群总账。
- 对比 ScaleRL 那种" CISPO vs GSPO 后期互有胜负"的结果,EPIC 在更长训练 horizon 下的表现还有待观察——300 步不算长。
跟同期工作的位置:2025-2026 这一年,LLM RL 的优化器演化主线几乎全是稳定性——GRPO 干掉 critic、DAPO 修 clip-higher、GSPO 抬到序列级、CISPO 裁剪 IS 权重。EPIC 属于这条线的理论收束端:它没有发明新的 trick,而是告诉你这些 trick 各自在逼近哪个"正确答案"。如果你只关心能不能抄,答案是可以,代码在 GitHub 上;如果你关心为什么,这篇论文是目前讲得最清楚的。
🤔 收尾
如果你在维护一套 LLM RL 训练管线,我的建议是:先在 verl 里把 EPIC 的 loss 换上跑一个数学任务对照实验,预算超参直接抄论文的 \(\delta^-=5\times10^{-4}\)、\(\delta^+=2\times10^{-3}\),重点看两件事——训练曲线有没有更稳(尤其 MoE 模型),以及裁剪比例的 position profile 是否真的均匀。这两个信号比最终 benchmark 分数更能告诉你这个方法在你的设置里是否 work。
还有一个更本质的问题这篇论文没解决:逐点裁剪预算(式 18)比期望级 KL 预算(式 16)更强,是工程近似。理论上更忠实的做法——直接在期望 KL 约束下做投影——在百万 token 规模的训练中怎么高效实现?这可能是下一篇论文的故事了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我