Heartbeat Thinking:让语音智能体边听边干活,工具调用不等说完话再开始
你有没有用过那种语音助手:你一口气说完需求,然后……沉默。三秒、五秒,屏幕上的小圆点转啊转,你才听到回复。问题不在于模型慢,而在于它一直在"听",等你闭了嘴才开始"想"。可实际上,你刚说出"帮我查一下订单 BOB12"这几个字的时候,需要调用的工具、要传的参数,就已经齐了。剩下的等待,纯属浪费。
蚂蚁国际这篇 Heartbeat Thinking 瞄准的就是这个痛点。核心思路一句话:在用户说话的过程中,以固定心跳间隔周期性地拉起推理调用,新调用不打断旧调用,已完成的工具结果沉淀进共享状态,等用户说完话直接把积累好的成果交接给应答模型。在 FDBench v3 上,推测式工具覆盖率从 34.67% 拉到 50.67%(涨 16 个点),最终响应延迟从 6.90 秒压到 4.39 秒(降 36.4%),比最快的级联 baseline Pipecat 还低 45.7%。
但别急着叫好——任务准确率在两个 benchmark 上反而轻微下滑了。这篇论文最诚实的地方,恰恰在于它自己把这个问题摆上了台面。
📖 论文信息
- 标题:Heartbeat Thinking: Speculative Reasoning and Tool Execution While Listening in Realtime Voice Agents
- 作者:Zhenyu Zhang, Kewei Fu, Yongqi Tong, Chenzhi Zheng, Wei Wu, Jiang-Ming Yang, Jianshe Li
- 机构:Ant International(蚂蚁国际)
- arXiv:https://arxiv.org/abs/2610.26233 (2026 年 10 月 19 日)
🎯 问题:语音对话里的"等待悖论"
传统语音 Agent 是级联流水线:ASR 转写 → LLM 推理 → 调工具 → TTS 播报。所有思考和工具调用都堆在"用户说完话"之后。可用户说话时信息是陆续到达的——说"track order BOB12"的时候,订单号在第 8 秒就齐了,整个请求 16 秒才说完。中间这 8 秒,系统干瞪眼。
之前的工作已经开始利用这段"听的时间":
- SHANKS(Chiang et al., 2026,微软的工作)在收到每个语音 chunk 后就推理一段,但每个推理 episode 被 chunk 边界框死——如果一次生成没把工具调用的参数写完,chunk 更新一来,这次生成就废了。长参数的工具调用很容易被拦腰截断。
- SIA(Hooper et al., 2026)用"打断"处理新输入:新的语音或工具结果一到,正在进行的生成直接中断重来。更新越频繁,能 uninterrupted 写完一个完整工具调用的时间窗口就越短。
你发现没有,这两种方案都把"计算时间"和"语音更新节奏"耦合在了一起。说话碎一点、更新勤一点,推测式执行就废了。
Heartbeat 的解耦思路:新输入来了,不打扰正在跑的推理,直接新开一个调用去处理新输入;旧的调用和已派发的工具继续跑到完。
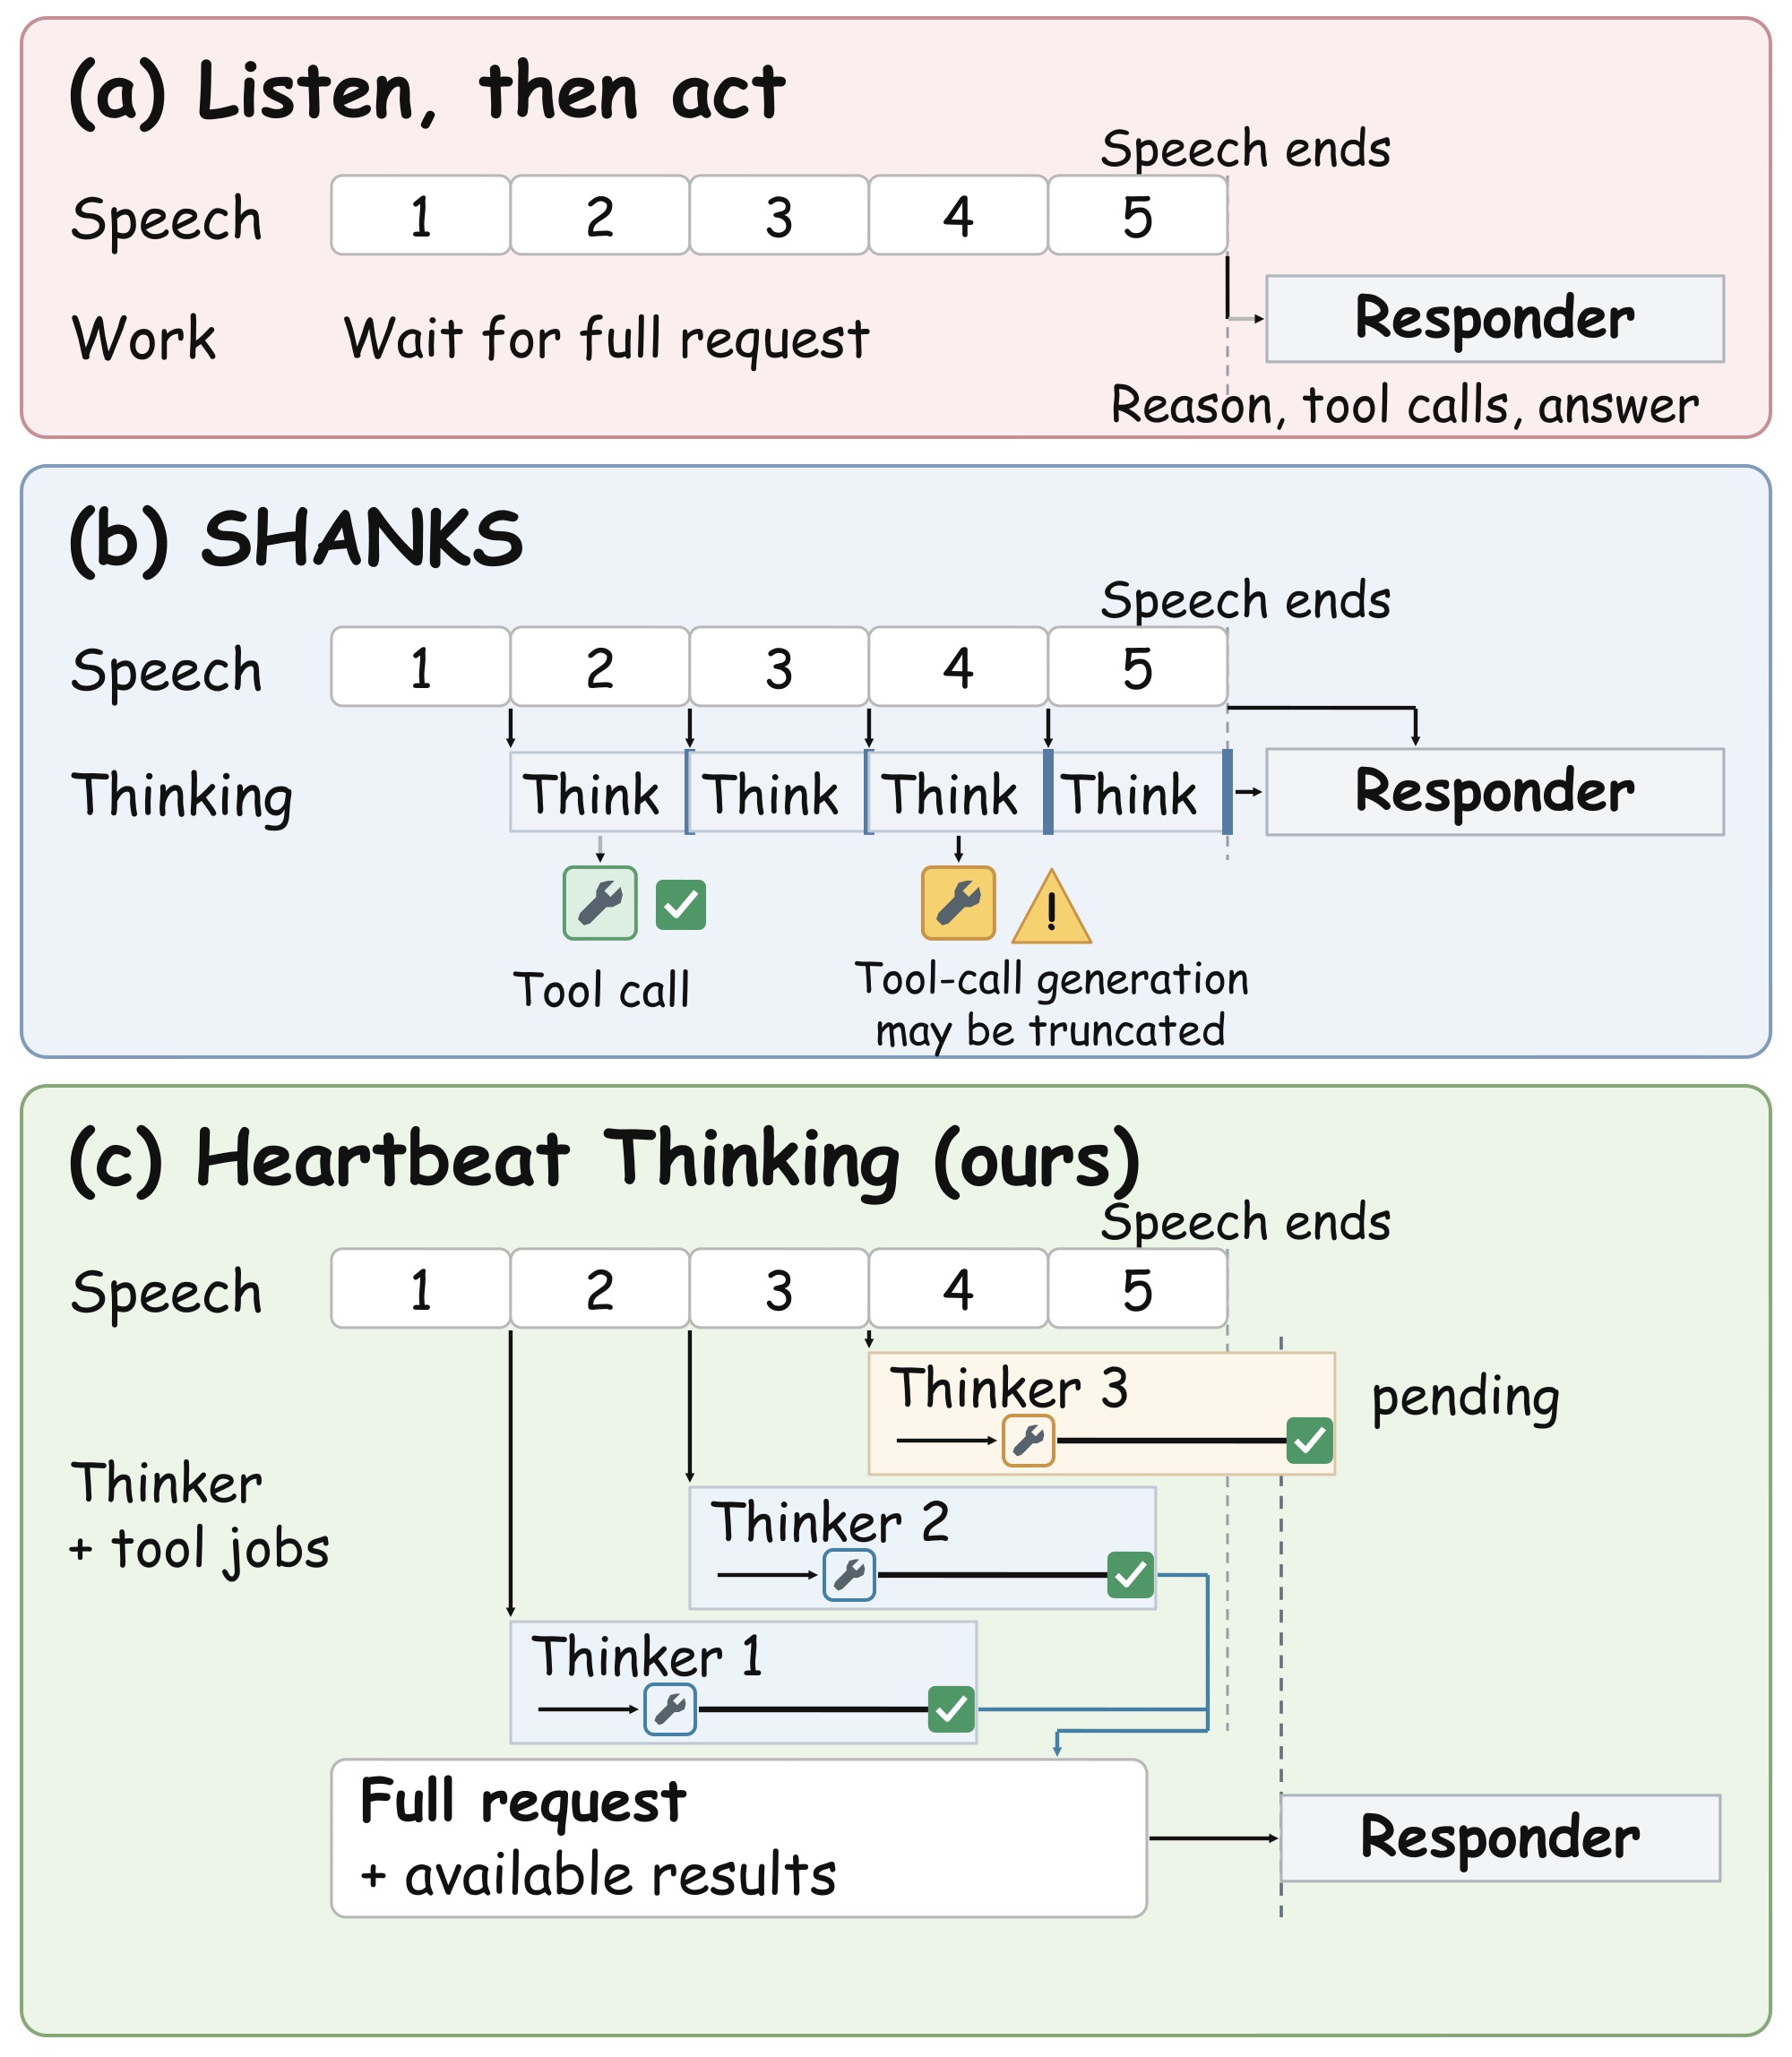
图 1:(a) 级联流水线听完才干活;(b) SHANKS 的工具调用可能在 chunk 边界被截断(黄色警告);(c) Heartbeat 的 Thinker 调用和工具执行跨语音更新交叠推进,Responder 复用已完成的准备、不等 pending 的任务。
🏗️ 方法:心跳式调度 + 共享状态 + 终点交接
整个架构拆成三个角色:
| 角色 | 触发方式 | 职责 |
|---|---|---|
| Thinker | 每 Δ 秒周期性触发(实验中 Δ=500ms) | 读最新部分转写 + 共享状态,产出增量推理或工具调用请求 |
| 共享状态 | — | 记录已完成的推理记录、已派发的工具调用、已返回的工具结果 |
| Responder | VAD 检测到语音结束时触发 | 拿完整转写 + 准备快照,核对、复用、补齐,生成最终回答 |
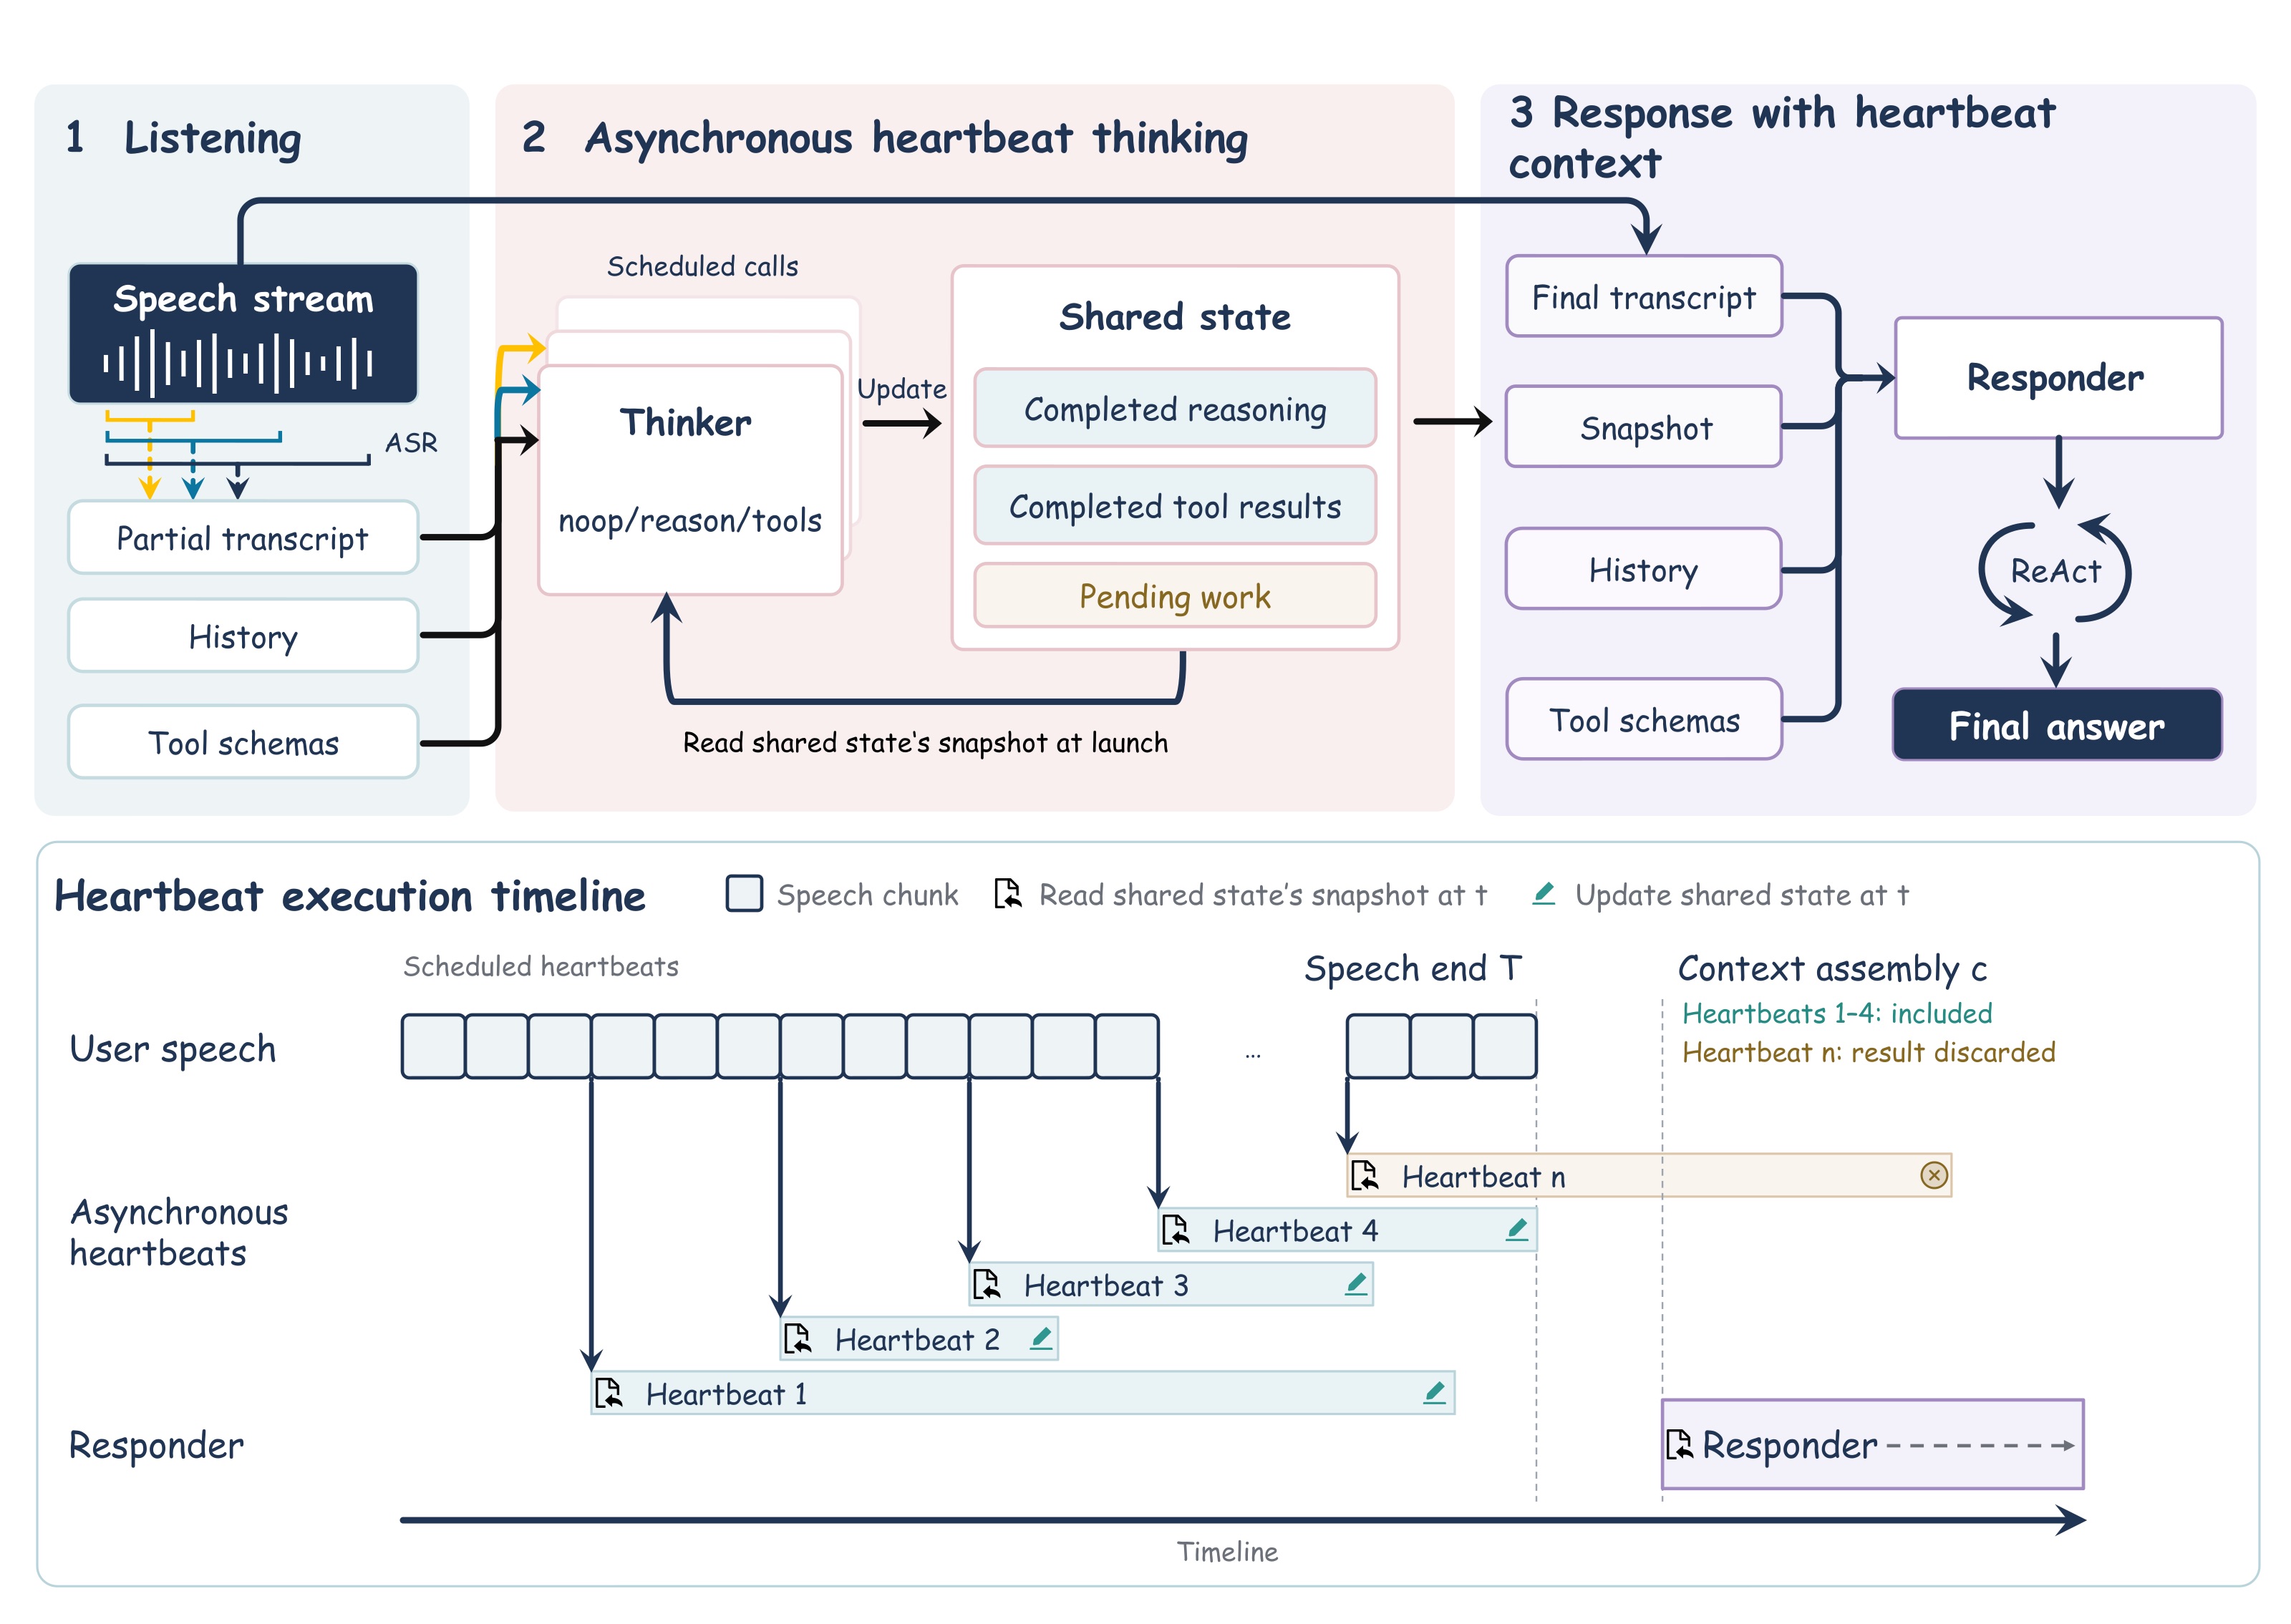
图 2:上图为架构——语音流经 ASR 产出部分转写,Thinker 周期性读取并写入共享状态;下图为时间线——多个 Heartbeat 调用异步交叠,在 context assembly 时刻 c 做快照,晚于 c 返回的结果直接丢弃。
几个关键设计值得展开说:
重叠调用,而不是打断。最多允许 K 个 Thinker 调用并发(实验中 K=2),心跳触发时如果 K 个槽位都占着,这次触发直接跳过、不排队。新语音、新工具结果都通过"下一次调用"进入系统,而不是注入正在进行的生成。这就从根上消灭了"截断"这个概念——每次调用都能跑到自然结束。
工具执行和模型调度解耦。Thinker 的并发上限是 K,但工具派发不设上限,由执行后端自己排队。工具结果返回后按 tool-call ID 关联回请求记录。所以即使转写没有新内容,后续的 Thinker 调用也能拿着刚返回的工具结果去补全缺失参数、发起依赖调用——推测式准备可以在"没有新输入"的情况下继续推进。这个细节我觉得挺漂亮的,它把"心跳"从单纯的输入驱动变成了状态驱动。
prompt 层面防重复。每个 Thinker 被明确指示:不要重复发起与 pending 或已完成调用同名同参数的请求。输出格式是严格 JSON:{"action":"noop"} 或 {"action":"think","thinking":"…","tools":[…]}。
交接时刻的快照语义。设 VAD 触发的上下文组装时刻为 c,准备输出 \(r_j\) 的可用时间为 \(a_j\),Responder 拿到的快照是:
交接时,调度器停止新触发、取消未完成的 Thinker 和推测工具任务(包括排队中的),c 之后才返回的结果一律丢弃。Responder 走 ReAct 流程:拿完整请求核对准备内容,拒绝被后续语音推翻的解释,复用参数完全匹配的已完成结果,缺什么自己补调。由于 Thinker 和 Responder 之间只通过"已完成的推理记录和工具结果"这个外部接口交换信息,两个角色可以用完全不同的模型——实验中 Thinker 用 Qwen3.6-35B-A3B,Responder 用 DeepSeek-V4-Flash。
对比一下三者的信息流哲学:SHANKS 把计算塞进 chunk 窗口里,SIA 让新输入打断旧计算,Heartbeat 让计算自由完成、用共享状态串起来。说实话,这个思路在工程上并不稀奇——搞异步任务系统的人都会本能地这么设计——但把它系统地落到语音 Agent 的推测式工具调用上,并用实验量化收益,这是这篇论文的贡献。
🧪 实验:覆盖率大涨,延迟大降,但准确率掉了
三个 benchmark,分工不同:
- SpeechFCEval:1914 条样本,考察语音 function calling(函数名 + 参数准确率)
- FDBench v3:100 条录音、79 个场景,考察口吃、犹豫等真实口语不流畅下的意图跟随
- AudioCRAG:1312 条样本,考察知识型语音问答(检索复用)
核心指标是 STC(Speculative Tool Coverage):参考调用中有多大比例被"已完成且 Responder 没有重复发起"的推测调用覆盖。这个指标设计得挺讲究——推测调用不仅要对、要完成,还得被 Responder 真正用上(Responder 重复调了就不算)。
主结果
| 系统 | SpeechFCEval Acc. | STC | FDBench Quality | Pass@1 | STC | AudioCRAG Correct | STC |
|---|---|---|---|---|---|---|---|
| Speech-to-Speech | 58.66 | 0.00 | 84.0 | 75.0 | 0.00 | 56.48 | 0.00 |
| Pipecat | 56.83 | 0.00 | 78.0 | 63.0 | 0.00 | 56.94 | 0.00 |
| LiveKit | 52.85 | 0.00 | 77.6 | 67.0 | 0.00 | 59.45 | 0.00 |
| Window Thinking (SHANKS) | 67.95 | 33.13 | 72.0 | 57.0 | 34.67 | 57.24 | 20.05 |
| Heartbeat | 66.85 | 43.69 | 77.0 | 65.0 | 50.67 | 55.49 | 62.42 |
表 1:主结果(%,越高越好)。推测系统用 Qwen3.6-35B-A3B 做 Thinker,全部系统用 DeepSeek-V4-Flash 做 Responder。
三个 benchmark 上 STC 分别涨 10.56、16.00、42.37 个点。AudioCRAG 那个 42.37 个点的涨幅很夸张——从 20.05% 到 62.42%,检索复用率翻了三倍。
但看任务质量这列,事情就有意思了:FDBench 上 Quality 72.0→77.0、Pass@1 57.0→65.0,确实双涨;可 SpeechFCEval 准确率 67.95→66.85 微跌,AudioCRAG 正确率 57.24→55.49 也在跌,甚至跌到了级联 baseline 之下。推测准备留得更多,并不自动等于最终答案更好。 论文自己很坦诚地承认了这一点,这个态度我欣赏。
延迟:这才是真正能打的数据
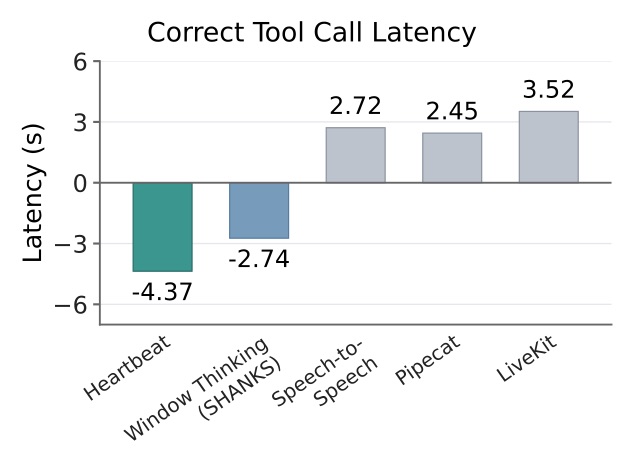
图 3:FDBench v3 上"首个匹配最终请求的工具调用"的发起时刻,相对语音结束点。负值表示在用户说完话之前就已经发起。
Heartbeat 的平均正确工具调用发起时间是语音结束前 4.37 秒,SHANKS 是 -2.74 秒,而三个级联 baseline 全在语音结束后 2.45~3.52 秒才开始调工具。也就是说,用户还没说完,Heartbeat 的工具结果可能都已经在回来的路上了。
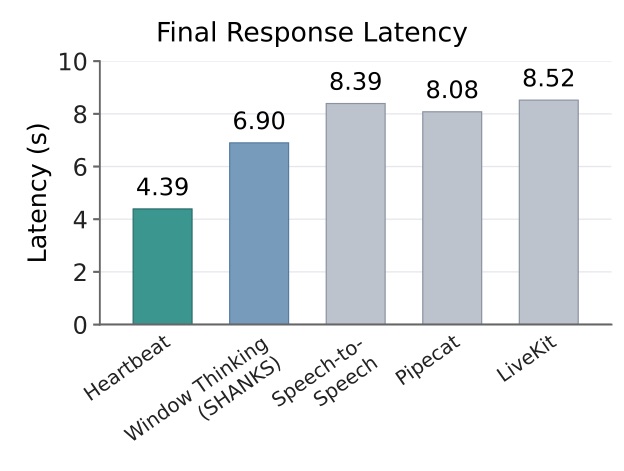
图 4:最终语音回答的起始时刻,相对语音结束点。
最终响应延迟:Heartbeat 4.39 秒,SHANKS 6.90 秒(降 36.4%),最快的级联 baseline Pipecat 8.08 秒(Heartbeat 比它低 45.7%)。用户感知到的"说完话到听到回答"的等待时间,直接砍掉一半以上。
分场景细看:信息来得越早,推测越准
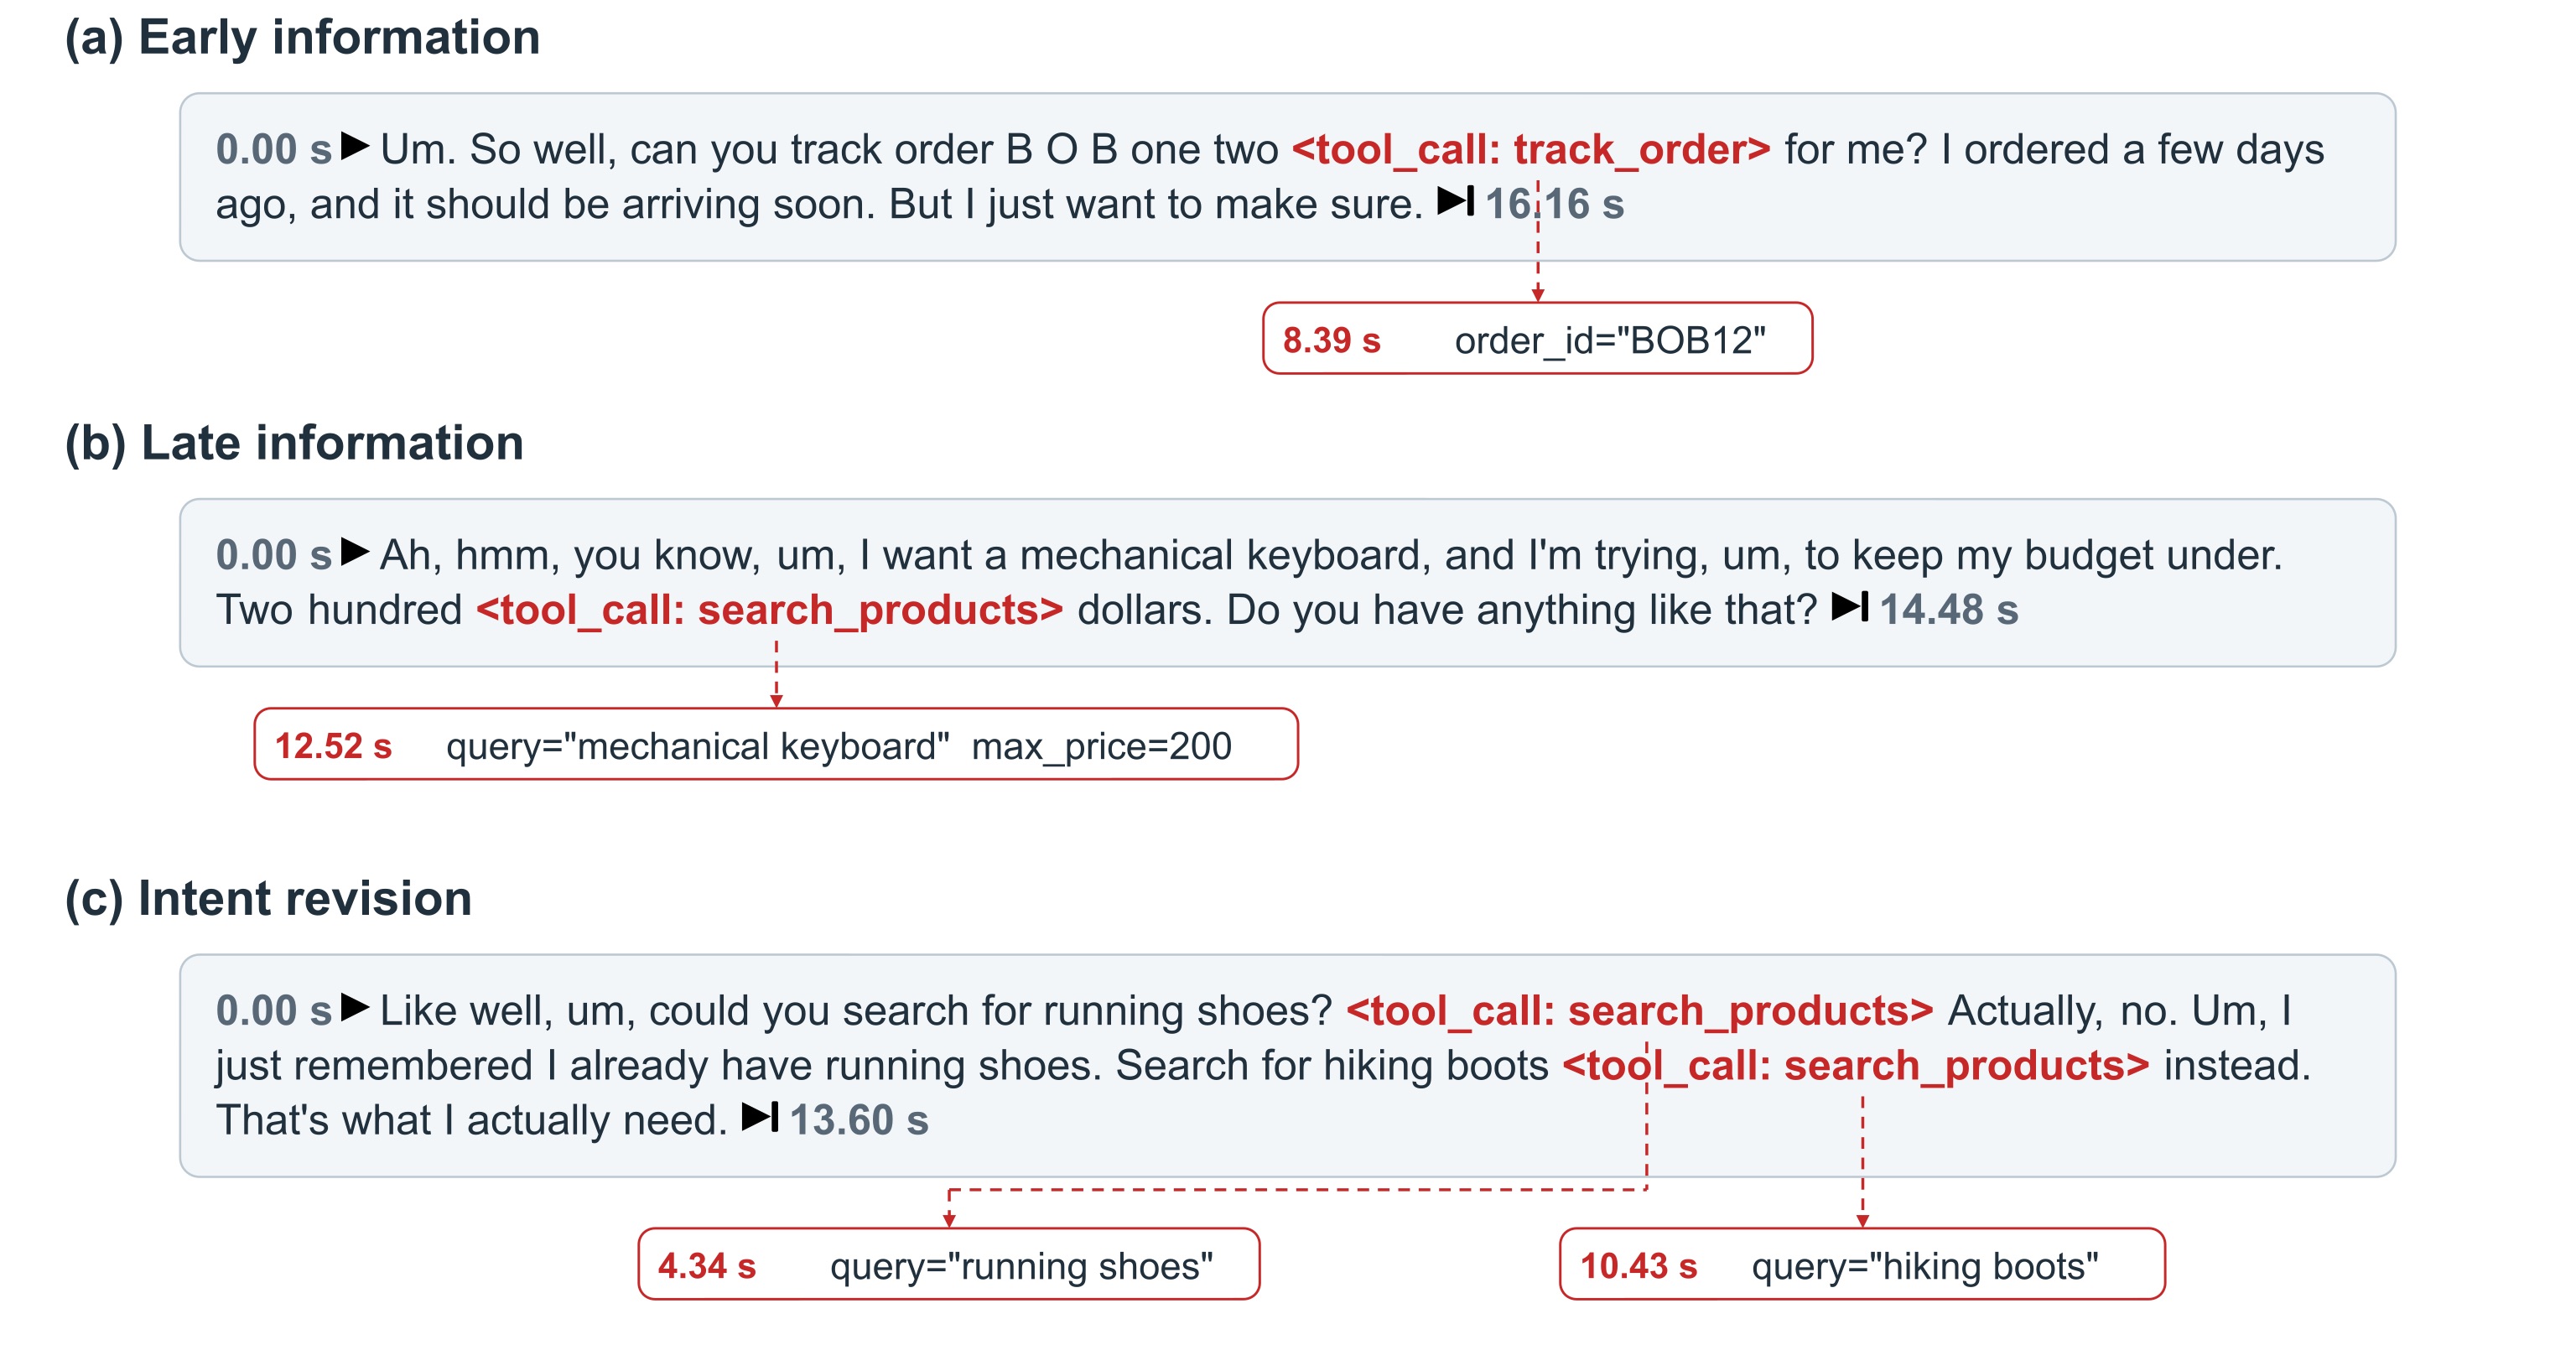
图 5:FDBench v3 上的三类典型场景——(a) 早期信息:订单号在第 8.39 秒就触发 track_order;(b) 晚期信息:预算约束快说完才齐,12.52 秒发起 search_products;(c) 意图修正:先说 running shoes 后改 hiking boots,系统在 4.34 秒发起旧调用、10.43 秒发起修正调用。
按信息到达时间分组统计"语音结束前发起正确调用"的成功率:
| 输入分组 | 成功率 |
|---|---|
| 早期信息(前 70% 说齐) | 73.3% |
| 晚期信息(最后 30% 才齐) | 49.2% |
| 显式意图修正 | 70.6% |
意图修正那组让我有点意外——70.6% 的改口场景里,系统能在说完前发出修正后的调用。这侧面印证了"新调用处理新输入"的架构确实比"打断重来"更抗更新。
跨模型稳健性
换了三个 Responder(DeepSeek-V4-Flash、Qwen3.5-397B-A17B、Qwen3.8-Flash-Next),Heartbeat 的 STC 在全部组合里都高于 Window Thinking。换了四个 Thinker(再加 Qwen3.5-9B、GLM-4.7-Flash、Gemma-4-26B-A4B-it),STC 全部非零。覆盖率优势是架构带来的,不是某个模型的巧合。但也有反例:SpeechFCEval 上 Gemma 做 Thinker 时 STC 略低(42.71% vs 43.69%)但准确率反而更高(68.58% vs 66.85%)——又一次说明覆盖率和最终质量之间的相关性并不牢靠。
⚠️ 泼点冷水:这篇论文真正暴露的问题
我觉得这篇论文最有价值的不是那个 36.4% 的延迟降幅,而是它无意中证明了一件事:"推测式执行"和"推测结果的正确使用"是两个独立的问题,后者远比前者难。
论文 Appendix D 里有个很扎心的失败案例:用户说"把咖啡机加购物车……等等我预算只有 50 刀"。系统在听到预算约束前已经把一台 99.99 刀的咖啡机加进了购物车,之后修正搜索找到了 40 刀的商品——但最终回答宣称"已添加 40 刀商品",报的却是 99.99 刀的购物车总额。修正后的搜索无法撤销已经执行的状态变更操作。4.0% 的 FDBench 录音出现了这类"参数正确但结果用错"的回答。
你想想这个工程含义:对有副作用的工具(下单、加购、发消息),推测式执行天然携带风险。Heartbeat 的论文没碰这个问题——它的工具大多是只读查询。真要在生产环境上这套架构,工具得先分个读写等级,写操作的推测派发要么禁止、要么进二次确认队列。
另外几个我会皱眉的点:
- 固定心跳调度有点糙。Δ=500ms 一刀切,不管有没有新信息都在烧推理。论文 Limitations 里自己也承认没探索自适应调度。用户长时间停顿或慢速说话时,冗余推理的开销可能相当可观——论文完全没报告推理成本这个维度。
- 延迟只在 FDBench 上测了。100 条录音的样本量,撑 latency 结论略显单薄。
- Responder 只拿 c 时刻的快照。慢速工具(比如跨库查询)在交接后才返回的结果直接丢弃,Responder 只能自己重调。增量递送晚期结果是个明显的改进方向。
- STC 指标本身有偏向性。它奖励"Responder 不重复调用",但这依赖 Responder 能正确识别和信任推测结果——而这恰恰是掉准确率的地方。指标涨、质量跌的组合,说明这个指标和用户体验之间的链条还有缺口。
还有一点值得一提:这本质上是工程架构创新,不是模型创新。不改权重、不动训练,纯靠调度策略和状态管理把听的时间变成准备时间。这类工作往往不如"新模型刷新 SOTA"性感,但对真正做语音产品的人来说,可能比这季度大部分论文都实用。
💡 收尾
Heartbeat Thinking 把一个很朴素的异步系统思想——新任务不打断旧任务、结果沉淀到共享存储、按需交接——第一次系统地装进了实时语音 Agent 的推测式工具执行里。数字上最硬的是延迟:最终响应 4.39 秒,把"说完话干等"的时间砍了一半以上;最有意思的发现是反面的:推测覆盖率涨 42 个点,正确率反而跌了——准备的归准备,判断的归判断,中间的鸿沟比预想的大。
如果你在做语音 Agent 或全双工交互系统,这篇论文的架构设计(心跳调度、共享状态、快照交接)值得直接参考;但上线前先把有副作用的工具隔离好,再给 Responder 配一套"怀疑推测结果"的校验机制——论文里那 4% 的脏数据回答,就是没做这层的样子。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我