把记忆塞进隐层:DFM 用 1/2048 的检索量,训出免检索的参数化记忆
让大模型"补课"一直是个让人纠结的事。继续预训练吧,学着学着就把老本行忘了;挂个 RAG 吧,每次推理都要跑一遍检索,延迟肉眼可见地涨。后来有人想出"参数化记忆"这条路——把检索好的知识离线蒸进一个外挂模块,推理时完全不碰检索器。听着很美,但我之前看 MLP Memory 那类方案时一直有个疙瘩:构造训练数据要做 token 级别的检索,一个 4B token 的语料就要跑 40 亿次检索查询,每次还要拉回上千个邻居。这个离线成本,基本把"省事"两个字抵消掉了一半。
这篇 Deep Fusion Memory(DFM,arXiv:2610.25100)就是冲着这个疙瘩来的。
📌 核心摘要
DFM 把参数化记忆的监督粒度从 token 级放宽到 chunk 级:每 32 个 token 共享一份记忆目标,检索查询量直接砍掉 96.88%,检索条目数砍掉 99.95%(从 4.096T 降到 2B)。更关键的是融合方式——以往方案只在输出概率上做插值,属于"浅融合";DFM 训练一个因果记忆预测器,从上下文直接"生成"记忆,再通过门控交叉注意力把它融进 decoder 中间层的隐状态里。推理时零检索。结果:六个知识密集 QA 任务上,比最强 baseline 相对提升 12.71%(Mistral-7B-v0.3)和 11.19%(Qwen3-8B-Base);代码、数学、法律三个领域的域适应上,平均涨 6.51(4B)和 4.38(8B)个点。我的判断:这不是颠覆性创新,但"chunk 级监督 + 深层融合"这个组合打得非常准,是参数化记忆路线里少有的把成本账和效果账一起算明白的工作。
论文信息 - 标题:Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models - 作者:Rubin Wei, Siyuan Sun, Hao Sun, Yuliang Liu, Xiang Shi, Jiarui Wang, Junming Zhang, Zhouhan Lin - 链接:https://arxiv.org/abs/2610.25100(2026 年 10 月 18 日提交) - 致谢中可见为上海交通大学与上海人工智能实验室的合作项目
🎯 问题动机:三条知识注入路线,各有各的坑
模型预训练完,知识就封盘了。要让它掌握新 facts,绕不开三条路:
| 路线 | 代表方法 | 推理开销 | 核心问题 |
|---|---|---|---|
| 继续训练 | CPT、LoRA | 无 | 灾难性遗忘,老能力被冲掉 |
| 推理时检索 | RAG、RETRO、xRAG | 高(在线检索+证据处理) | 延迟大,依赖外部 datastore |
| 参数化记忆 | MLP Memory、Memory Decoder | 无 | 离线构造训练数据的检索量爆炸;输出层插值融合太浅 |
第三条路的方向感是对的——推理时自给自足,不动 backbone。但坑在两头。一头是构造成本:token 级记忆意味着每个 token 都要拿它的上下文去语料库里检索一遍,4B token 语料就是 4B 次查询,每次取 Top-1024 邻居,总共 4.096T 条检索结果要存要用。另一头是融合深度:MLP Memory 这类方法学的是预测 token 级的 kNN 分布,最后在输出概率上做插值——记忆只在 logits 层面和主干"见面",中间层的表征完全没被影响。说实话,这种浅融合能 work 已经挺让人意外了,但天花板也明显。
DFM 的思路就是同时拆这两个坑:监督目标按 chunk 共享,把检索量降下来;记忆不往输出层走,而是进中间层的隐状态,把融合做深。
🏗️ 方法核心:预测记忆,而不是检索记忆
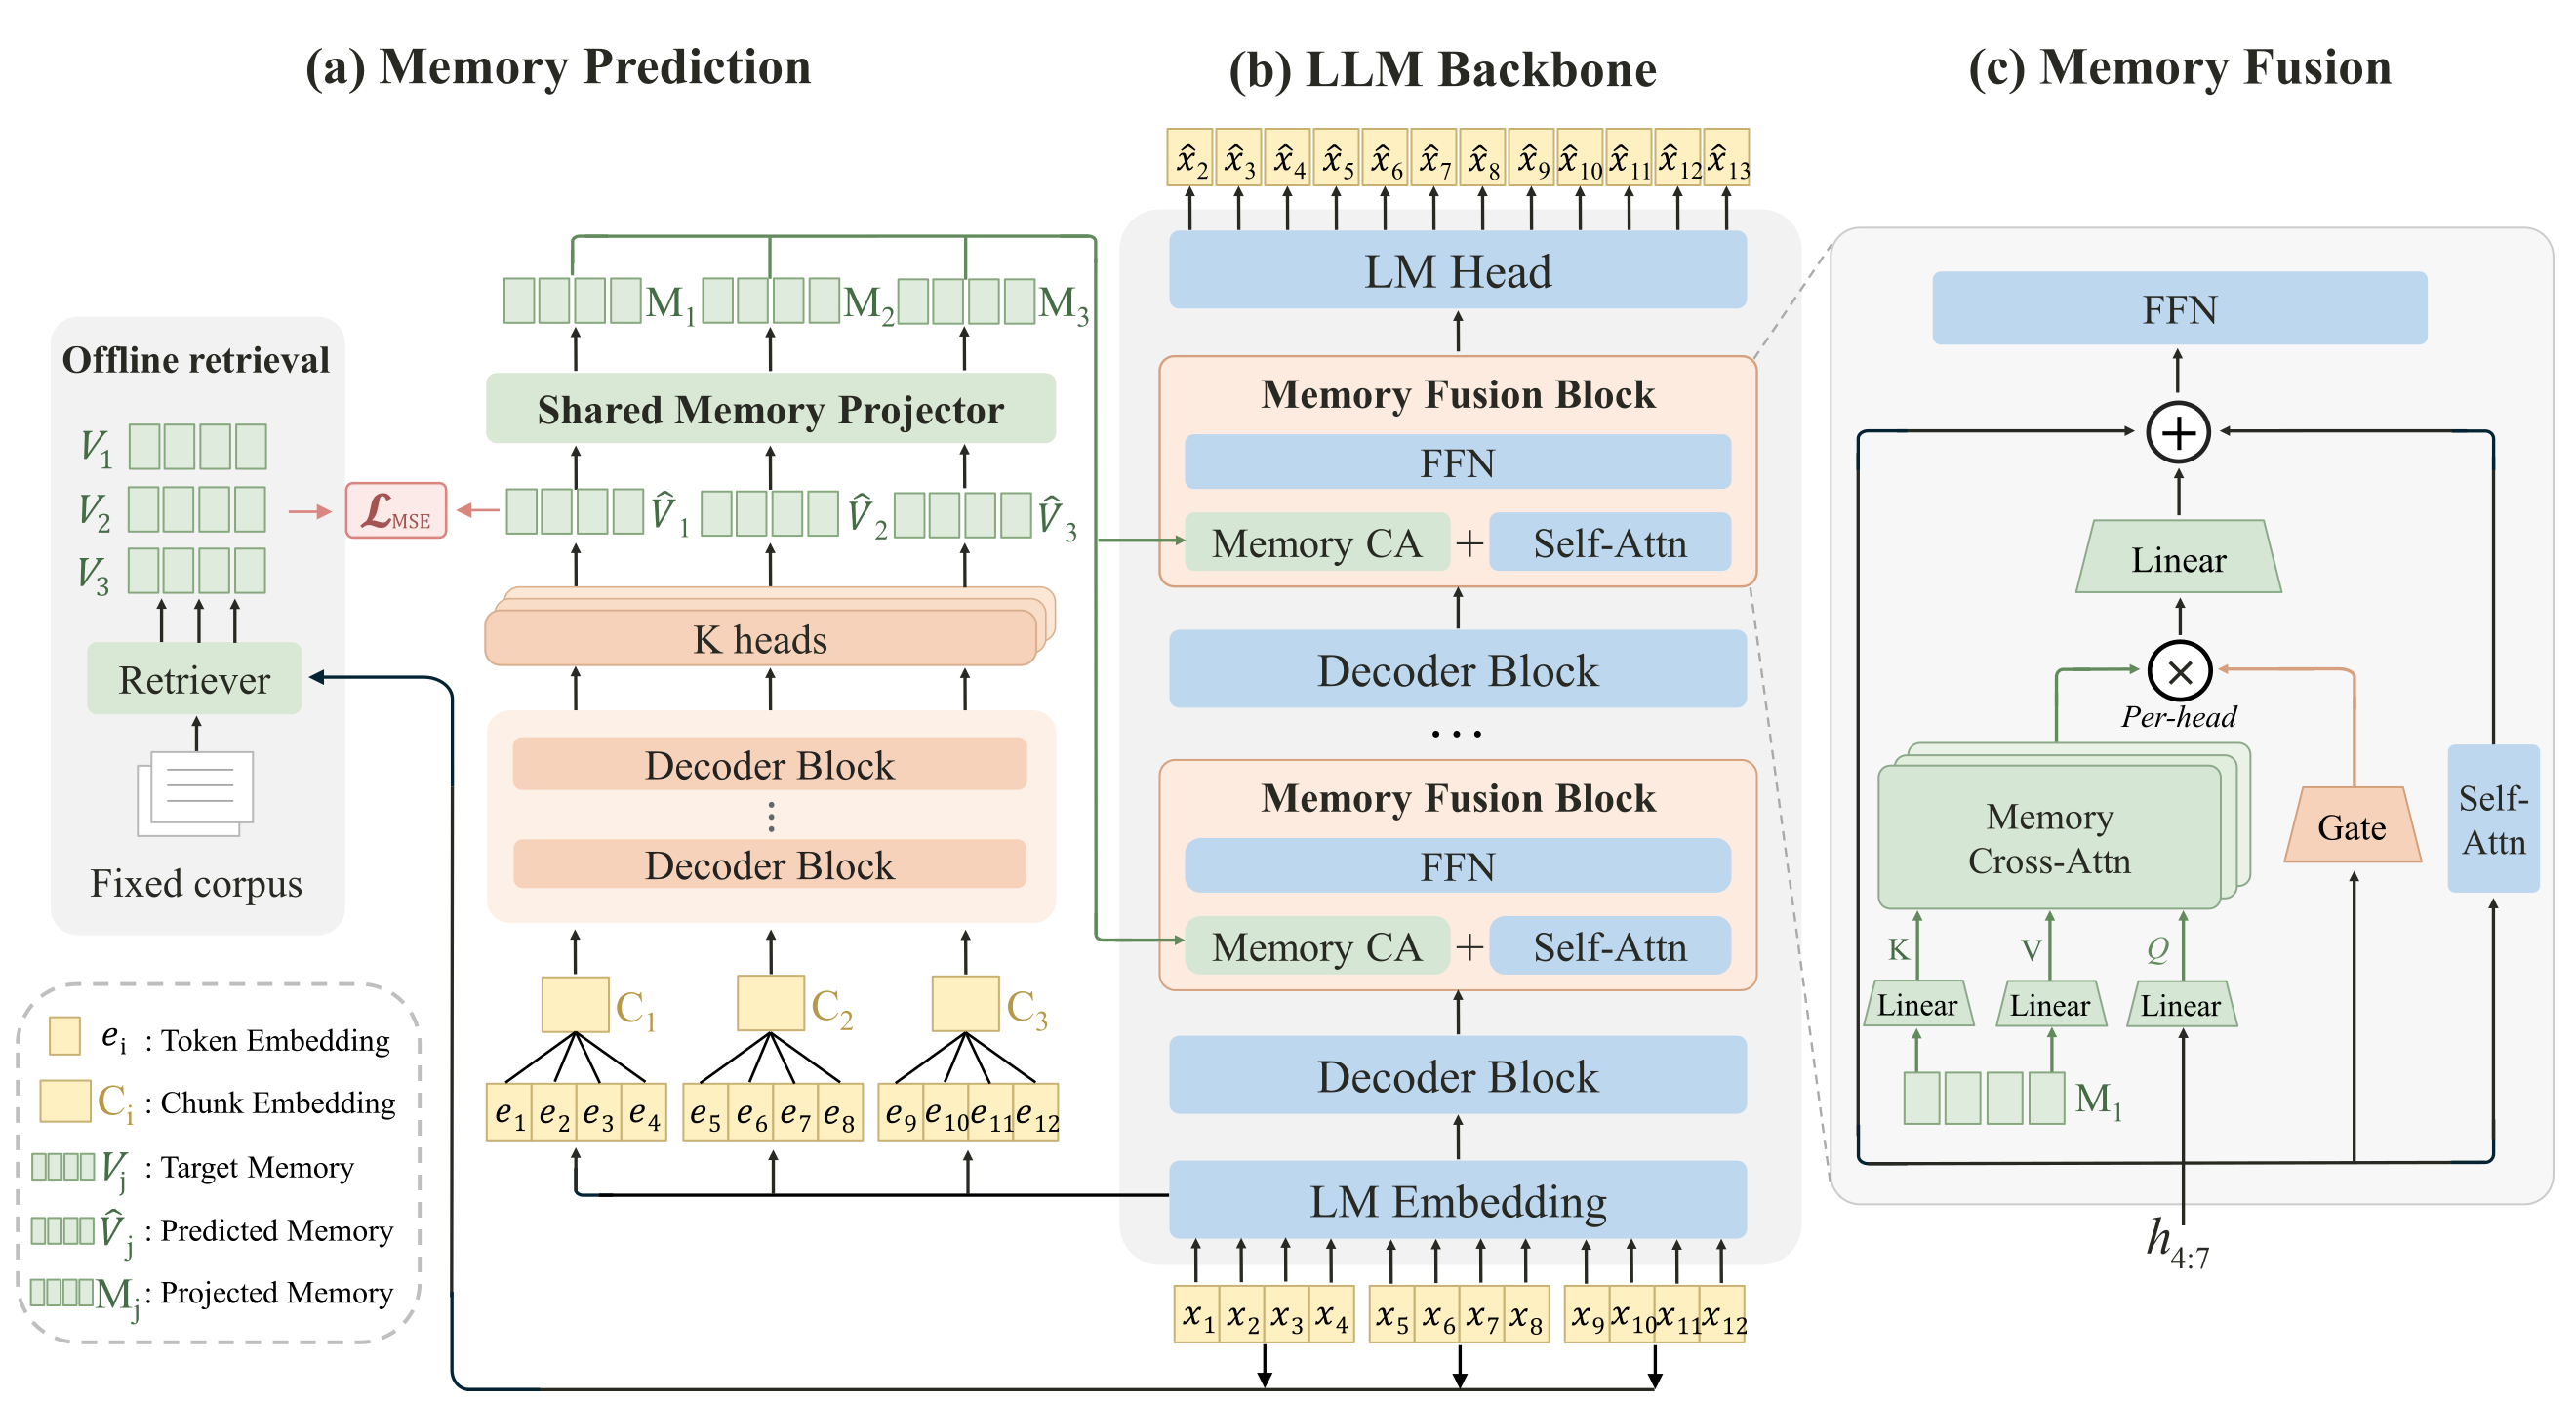
图1:DFM 架构总览。(a) 记忆预测——离线检索器先从固定语料里取出目标记忆 \(V_j\),记忆预测器(若干 decoder block + K 个输出头)把池化后的 chunk 嵌入 \(C_j\) 映射为预测记忆 \(\hat{V}_j\),用 MSE 损失监督;共享投影器把预测记忆投到 decoder 隐空间。(b) LLM 主干——选定的若干 decoder 层插入记忆融合模块。(c) 记忆融合——前一 chunk 预测出的记忆通过门控交叉注意力支持下一 chunk 的 token 预测,每个注意力头有独立门控,推理全程无需检索。
一句话讲清核心 idea:既然推理时不想检索,那就训一个模型去"猜"检索器会返回什么。猜的依据是前面的上下文,猜的监督信号来自离线检索好的 chunk 嵌入。
训练数据构造:chunk 级共享监督
把训练序列切成不重叠的 chunk,每个 chunk \(c_k\) 含 32 个 token。离线阶段,检索器(Qwen3-Embedding-0.6B)拿前一个 chunk \(c_{k-1}\) 做查询,从语料库取 Top-16 邻居,每个邻居用一个冻结文本编码器产出稠密嵌入,按检索排名堆叠成目标记忆 \(V_k \in \mathbb{R}^{16 \times d}\)。
关键点:这 16 条记忆向量是 chunk 内所有 token 共享的监督目标。token 级方案每个 token 都要一次查询,这里 32 个 token 摊一次——32 倍的查询量缩减就是这么来的。第一个 chunk 没有前驱,不用记忆也不参与记忆监督,边界处理得很干净。
记忆预测器:因果地"生成"记忆
预测器的输入是 chunk 嵌入序列:对主干冻结的词嵌入按 chunk 做 mean-pooling,得到 \(C_j\),必要时过一个线性层对齐宽度。预测器本身是个因果 Transformer,带 16 个独立的线性输出头(一个记忆槽一个头),对 chunk \(k\) 产出:
因果注意力保证预测 \(\hat{V}_k\) 时只能看到 \(c_{k-1}\) 及更早的 chunk 摘要——这点和 next-token prediction 的信息可见性严格对齐,不会偷看未来。监督就是预测记忆和目标记忆之间的 MSE:
\(\mathcal{L}_{\text{MSE}}\) 直接对 L2 归一化的目标嵌入算,预测侧不再归一化。整个训练里 LM 消费的一直是预测记忆,目标记忆只用来算 loss——也就是说模型从训练起就习惯"自己造的记忆",不存在训推不一致。
记忆融合:门控交叉注意力进隐层
这是和浅融合拉开差距的地方。预测记忆先过一个共享投影器(LayerNorm + 两层 Linear + GELU)映射到 decoder 隐空间,得到 \(M_j\),然后在选定的 decoder 层(默认第 9、15、21、27 层)里,与因果自注意力并联一条记忆交叉注意力支路。每个头的输出被一个 sigmoid 门控缩放:
门控是 per-token、per-head 的一个标量,权重零初始化、bias 设为 \(-2\)——初始时记忆支路被压得很小,对预训练主干的扰动有限,训练中再学着放开。两条支路的输出相加进同一个残差更新,然后走原本的 FFN。主干全程冻结,只有预测器、投影器、交叉注意力和门控参数在动,Mistral/Qwen3-8B 上新增约 0.75B 参数。
推理时没有任何检索:chunk 查询由主干输入嵌入池化而来,预测器直接供记忆。QA 场景下记忆从 prompt 算出来后固定,答案生成阶段不再更新。
🧪 实验:QA 和域适应两头都涨了
实验设置:QA 用 Mistral-7B-v0.3 和 Qwen3-8B-Base,训练语料是 2018 年 12 月英文维基(约 4B token),16 张 A800 训一个 epoch。评测 2 个单跳 QA(NQ、WebQA)+ 4 个多跳 QA(HotpotQA、2Wiki、MuSiQue、Bamboogle)。Baseline 覆盖非参数路线(RAG、xRAG、RETRO)和参数路线(CPT、LoRA、MLP Memory)。
表1:六个 QA 基准上的主结果(Avg 为六任务简单平均)
| 方法 | NQ | WebQA | HotpotQA | 2Wiki | MuSiQue | Bamboogle | Avg |
|---|---|---|---|---|---|---|---|
| Mistral-7B-v0.3 | |||||||
| Base | 20.30 | 29.28 | 20.96 | 5.87 | 1.43 | 3.91 | 13.63 |
| RAG | 24.03 | 27.90 | 29.09 | 31.02 | 9.87 | 18.56 | 23.41 |
| xRAG | 27.39 | 40.06 | 27.55 | 27.78 | 9.57 | 12.51 | 24.14 |
| RETRO | 20.26 | 29.48 | 21.06 | 5.90 | 1.48 | 4.19 | 13.73 |
| CPT | 11.44 | 32.92 | 12.13 | 14.22 | 4.51 | 5.65 | 13.48 |
| LoRA | 14.24 | 40.21 | 13.43 | 14.98 | 4.90 | 5.08 | 15.47 |
| MLP Memory | 26.32 | 39.57 | 24.83 | 22.36 | 7.36 | 12.08 | 22.09 |
| DFM | 33.57 | 42.47 | 29.53 | 25.00 | 10.05 | 22.65 | 27.21 |
| Qwen3-8B-Base | |||||||
| Base | 17.60 | 41.78 | 24.65 | 24.83 | 9.72 | 17.66 | 22.71 |
| xRAG | 24.34 | 41.54 | 27.74 | 22.46 | 9.67 | 15.30 | 23.51 |
| MLP Memory | 18.30 | 43.26 | 25.27 | 27.47 | 10.81 | 17.66 | 23.80 |
| DFM | 27.46 | 39.47 | 26.46 | 32.38 | 12.89 | 20.09 | 26.46 |
几个值得说的点。Mistral 上 DFM 把六任务均值从 xRAG 的 24.14 推到 27.21,相对提升 12.71%,而且六个任务全面超 Base——Bamboogle 从 3.91 直接干到 22.65,这个幅度有点夸张。Qwen3 上从 MLP Memory 的 23.80 提到 26.46,相对 11.19%。
但别急着吹。有两个数据我挺在意:Qwen3 上 WebQA 反而从 41.78 掉到 39.47,MLP Memory 在同一项上拿了 43.26;Mistral 的 2Wiki 上 RAG 仍以 31.02 压着 DFM 的 25.00。作者自己也承认——记忆适应不是对所有 backbone 都一致有益,显式检索在部分基准上仍有优势。这种把负面结果摆上桌面的写法,我反而觉得可信度高了不少。
另一个对照组的信息量很大:CPT 和 LoRA 在 Mistral 上六任务均值只有 13.48 和 15.47,CPT 甚至比 Base 还低——灾难性遗忘不是理论风险,是真金白银地发生在对照实验里。
表2:域适应结果(Qwen3-4B/8B-Base,Code/Math/Law)
| 方法 | HumanEval | HumanEval+ | GSM8K | LawBench | Avg |
|---|---|---|---|---|---|
| Qwen3-4B-Base | |||||
| Base | 62.04 | 57.32 | 83.40 | 29.96 | 58.18 |
| CPT | 66.62 | 58.54 | 84.84 | 41.66 | 62.92 |
| LoRA | 59.45 | 58.54 | 85.37 | 39.43 | 60.70 |
| DFM | 69.51 | 62.80 | 86.05 | 40.41 | 64.69 |
| Qwen3-8B-Base | |||||
| Base | 69.36 | 59.15 | 85.60 | 38.45 | 63.14 |
| CPT | 68.29 | 59.76 | 87.11 | 45.09 | 65.06 |
| LoRA | 69.05 | 65.85 | 87.19 | 45.73 | 66.96 |
| DFM | 73.02 | 64.02 | 86.43 | 46.61 | 67.52 |
QA 之外的泛化是这篇论文打动我的另一部分。法律域上 RAG 直接崩了(4B 上 LawBench 从 29.96 掉到 24.35),而 DFM 涨到 40.41——拉开 RAG 16 个点以上。两个尺度上 DFM 都拿下最高均值,分别涨 6.51 和 4.38 个点。不过 8B 的 GSM8K 和 HumanEval+ 上 LoRA 仍然更强,域适应这块 DFM 不是碾压局,是"平均最强"。
📊 效率分析:这篇论文最硬的一张图
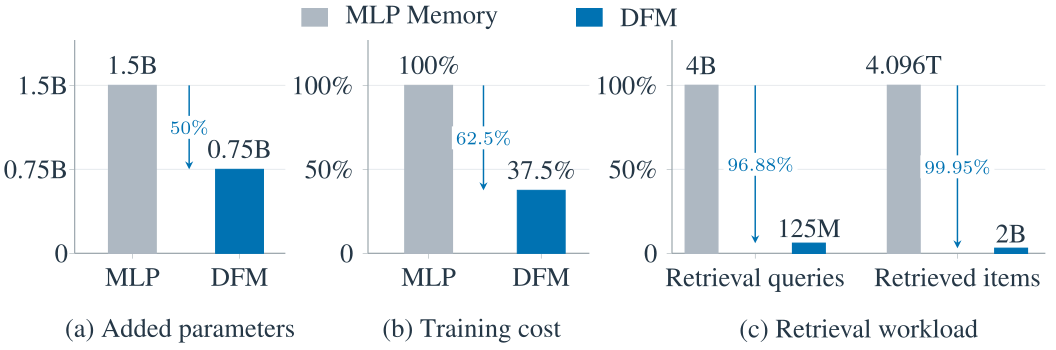
图2:DFM 与 token 级 MLP Memory 的资源对比。(a) 新增参数:1.5B 对 0.75B,减半。(b) 训练耗时:同样 16 张 A800、同样语料和 epoch 数,64 小时对 24 小时,省 62.5%。(c) 检索工作量:4B token 语料下,检索查询从 4B 降到 125M(省 96.88%),检索条目从 4.096T 降到 2B(省 99.95%)。
说实话看到 (c) 的时候我愣了一下。参数减半、训练省六成,这些都还在预期内;但检索条目 2048 倍的缩减,意味着离线构造这条 pipeline 从"需要一套正经的检索基础设施"变成"随便跑跑就能出"。对于想在自家语料上试参数化记忆的团队,这个数字比 QA 涨几个点更有实际意义——它直接决定了这件事的准入门槛。
🔬 消融:哪些设计真的在起作用
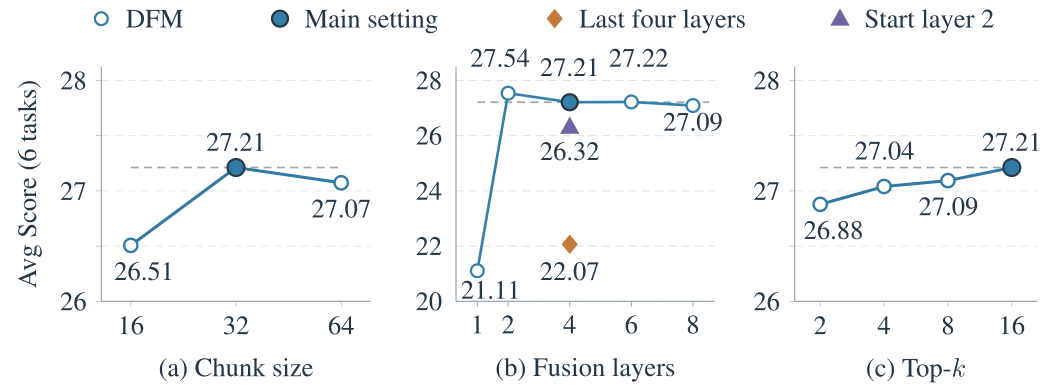
图3:Mistral-7B-v0.3 上的结构消融,纵轴为六任务 QA 均值。(a) chunk 大小:16/32/64 分别得 26.51/27.21/27.07,32 最优。(b) 融合层数:仅最后一层融合只有 21.11,最后四层 22.07,而从第 9 层开始的 2 到 8 层融合在 27.09 到 27.54 之间。(c) Top-k:2/4/8/16 分别得 26.88/27.04/27.09/27.21。
最有信息量的是融合位置。只在最后一层融合,均值直接掉到 21.11——比 Base 好不了太多;最后四层也只有 22.07。而从中间层(第 9 层起)开始铺开,2 层就到 27.54。记忆必须进中间层,让后面的层有机会加工融合后的表征——这几乎是对"输出层插值太浅"这个论断最直接的实验证据。作者的解释是中后期层的语义表征更成熟,适合接入记忆,留给后续层处理的时间也更长,和 RETRO 的层选择经验一致。
chunk 大小和 Top-k 的结论则是"钝感"的:chunk 从 32 翻倍到 64 只掉 0.14 分,Top-2 和 Top-16 只差 0.33 分。这在工程上是好消息——可以用更粗的 chunk、更少的记忆槽进一步压成本,性能损失很小。
表3:门控初始化消融(Mistral-7B-v0.3)
| 门控设置 | NQ | WebQA | HotpotQA | 2Wiki | MuSiQue | Bamboogle | Avg |
|---|---|---|---|---|---|---|---|
| 无门控 | 34.08 | 42.72 | 29.80 | 24.94 | 10.08 | 19.35 | 26.83 |
| \(b_g=0\) | 32.34 | 42.18 | 28.54 | 23.55 | 9.03 | 14.94 | 25.10 |
| \(b_g=-1\) | 32.70 | 42.22 | 29.39 | 25.98 | 10.42 | 19.70 | 26.73 |
| \(b_g=-2\)(默认) | 33.57 | 42.47 | 29.53 | 25.00 | 10.05 | 22.65 | 27.21 |
| \(b_g=-4\) | 34.59 | 42.13 | 30.38 | 29.68 | 10.94 | 19.69 | 27.90 |
门控本身值 0.38 个点(27.21 对 26.83),主要救的是 Bamboogle。有意思的是 \(b_g=-4\) 其实比默认的 \(-2\) 还高 0.69 分,五个任务都更好——作者选了 \(-2\) 作为"保守默认",坦白说这个选择我没完全看懂,可能是担心更强的初始抑制在别的 backbone 上泛化不稳,也可能只是没来得及全量扫。这里留了个小尾巴。
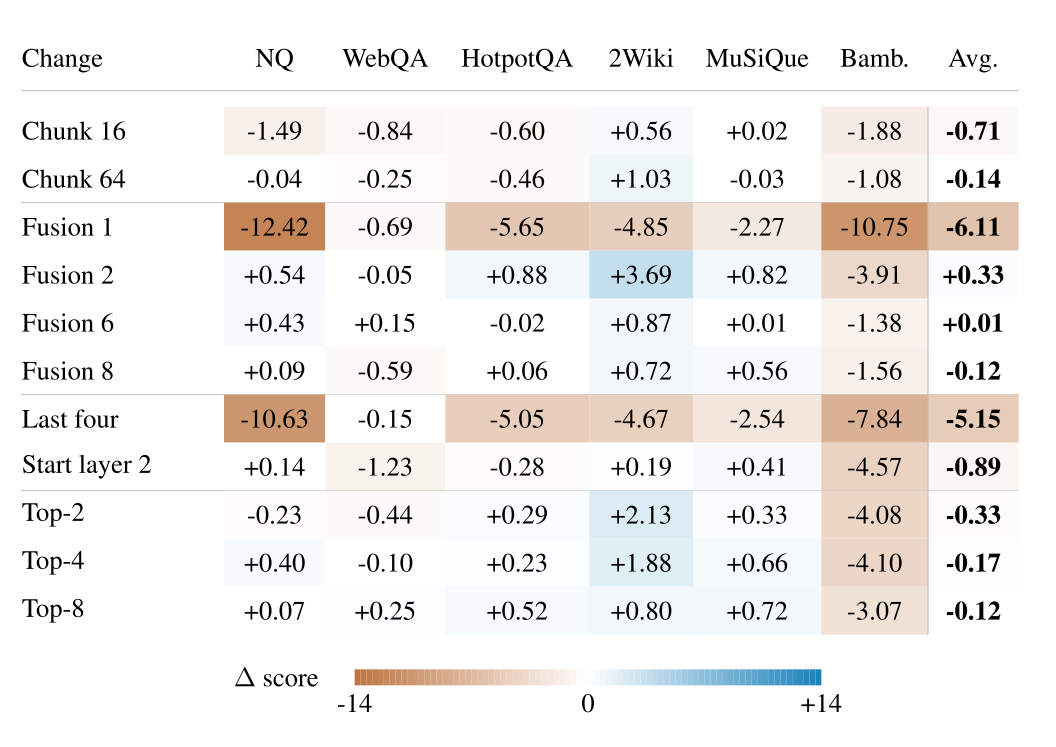
图4:相对主配置的任务级分数变化热力图。蓝色为提升、棕色为下降。Fusion 1(仅最后一层融合)在 NQ 上掉 12.42 分、Bamboogle 掉 10.75 分,是所有改动里杀伤最大的;而 Top-k 和 chunk 大小的改动基本是温和的零星波动。
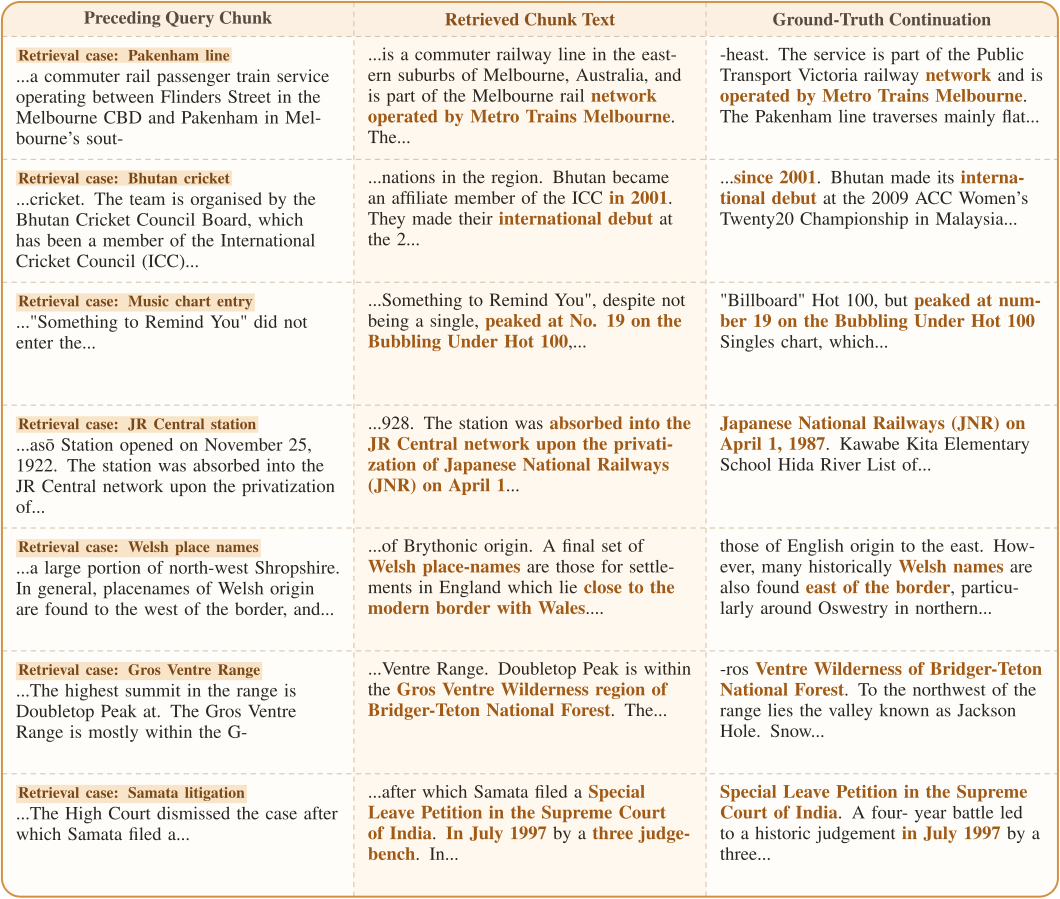
图5:七个离线检索样例。每行展示前驱查询 chunk、检索到的 chunk 文本及其嵌入。可以直观看到目标记忆的语义质量——检索器返回的内容与查询主题高度相关,这正是预测器要学习逼近的监督信号。
💡 我的判断
这篇论文最值钱的地方,是把参数化记忆的两个老大难——构造贵、融合浅——用一对互相咬合的设计一起解了。chunk 级共享监督不只是省检索,它还顺带定义了"记忆预测器"这个可以端到端学的模块形态;而门控交叉注意力进中间层,消融数据(21.11 vs 27.54)证明这不是花架子,是主要增益来源。
但也要泼几盆冷水。其一,所有 QA 实验的训练语料是 2018 年 12 月的维基,评测集(NQ、HotpotQA 等)的答案大头也来自同时期维基——分布高度对齐的设定下,"预测记忆"能多大程度替代"真实检索",在开放域、跨时效语料上还需要验证。其二,WebQA 和 2Wiki 上的回退说明这套方法对 backbone 和任务有选择性,不是无脑替换 RAG 的银弹。其三,多轮对话、长文档生成这类记忆需要动态更新的场景,论文里"prompt 阶段算一次记忆就固定"的推理模式能不能接住,没测。
工程启发倒是实打实的:如果你在做知识注入,先算一笔检索构造的账——chunk 级监督这条降本路径几乎零副作用;如果你已经在用外挂记忆模块,检查一下融合点是不是太靠后了,往中间层挪一挪,可能白捡几个点。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我