压缩一倍还能反超不压缩?Cola2 给层级语言模型算清了一笔"信息账"
核心摘要
把文本先压成连续潜变量、再用离散解码器还原成文字——这条"分层生成"路线听起来很美,但一直没人回答两个灵魂问题:潜空间到底该压进去什么信息?解码器该在多大程度上相信潜变量?Cola2 的做法是让两边"协同进化":token 预测损失的梯度直接回传编码器,潜空间存什么由解码器的实际需求说了算;同时用 stop-gradient 把潜变量先验(DiT)的拟合目标和表征学习隔开,防止 DiT 为了"好拟合"而劫持潜空间。结果相当能打:动态语义分割在压缩率 1/2 下拿到 29.4% 的 LAMBADA 准确率,反超不压缩的模型(28.7%);最终用 346B token 训出一个未收敛的 checkpoint,八任务平均 60.10,在 HellaSwag 和 StoryCloze 上反超训练数据多 43 倍的 Llama-3-8B。这是一篇"系统工程味"很浓的论文,47 页里大部分是扎实的组件级消融,值得做潜空间生成的人细读。
论文信息
- 标题:Cola2: Co-Adaptive Hierarchical Language Modeling with Continuous Semantic Compression and Balanced Discrete Generation
- 作者:Hongcan Guo、Yian Zhao、Feng Wang、Shen Nie、Guoqiang Wei、Yan Zeng(Project Lead)、Hengshuang Zhao(通讯作者)
- 机构:The University of Hong Kong、ByteDance Seed、Peking University、Renmin University of China
- 链接:https://arxiv.org/abs/2610.31305 (2026 年 10 月 22 日提交,47 页,14 图 5 表)
- 项目主页:https://hongcanguo.github.io/Cola2
这篇是 Cola DLM 的续作,同一批核心作者。Cola DLM 提出把文本生成拆成"连续潜空间里组织语义 + 离散空间里落成文字"两步,Cola2 则是把这个框架里所有没说清的设计问题一次性摊开做透。
🎯 问题:分层生成不是"一拆就灵"
先说背景。自回归模型逐 token 串行生成,推理时被这个顺序锁死。扩散语言模型(比如 LLaDA)用迭代去噪打破串行依赖,是这两年很热的一条线。Cola DLM 更进一步,把生成拆成层级结构:先在压缩过的连续潜空间里做"高层规划",再让离散解码器把潜变量翻译成 token。
但说实话,我看到这类"连续-离散分层"方案时的第一反应是怀疑的。把序列压短了不等于拿到了好的语义表征——VAE 只优化重建损失时,潜变量完全可以只记住"局部好重建"的肤浅信息,对预测未来文本毫无帮助。反过来,如果解码器只会照着潜变量逐字还原,一旦潜变量有误差(推理时潜变量是 DiT 生成的,必然有误差),整个生成就会崩。
作者的概括很精准:潜空间该保留什么信息,取决于解码器能补全什么信息;反过来解码器的训练又依赖潜空间的质量。这俩没法分开设计。这就是论文标题里 "Co-Adaptive"(协同适应)的来历。
还有一个更隐蔽的问题:训练潜变量先验(一个 DiT,用 Flow Matching 拟合潜空间分布)时,梯度要不要回传编码器?直觉上说端到端一起训不是更好吗?作者的答案是否定的,而且给了一个挺有意思的解释——DiT 的拟合目标只关心"当前潜变量好不好拟合",它的梯度会把潜空间往"分布简单"的方向推,而不是往"对文本建模有用"的方向推。这其实是一种 latent hacking。
🏗️ 方法:三个模块 + 一套梯度路由
Cola2 的整体框架是三个模块的组合:压缩 VAE 编码器 \(E_\phi\) 学连续潜变量,块因果 MDM 解码器 \(D_\psi\) 把潜变量落成 token,块因果 DiT \(G_\theta\) 在潜空间里学生成先验。形式化地说,文本概率被分解为:
其中 \(Z\) 是连续潜变量序列,压缩率 \(\rho = K/T\),\(K\) 是潜变量个数、\(T\) 是 token 数。默认设置下每个潜变量平均覆盖 2 个 token。
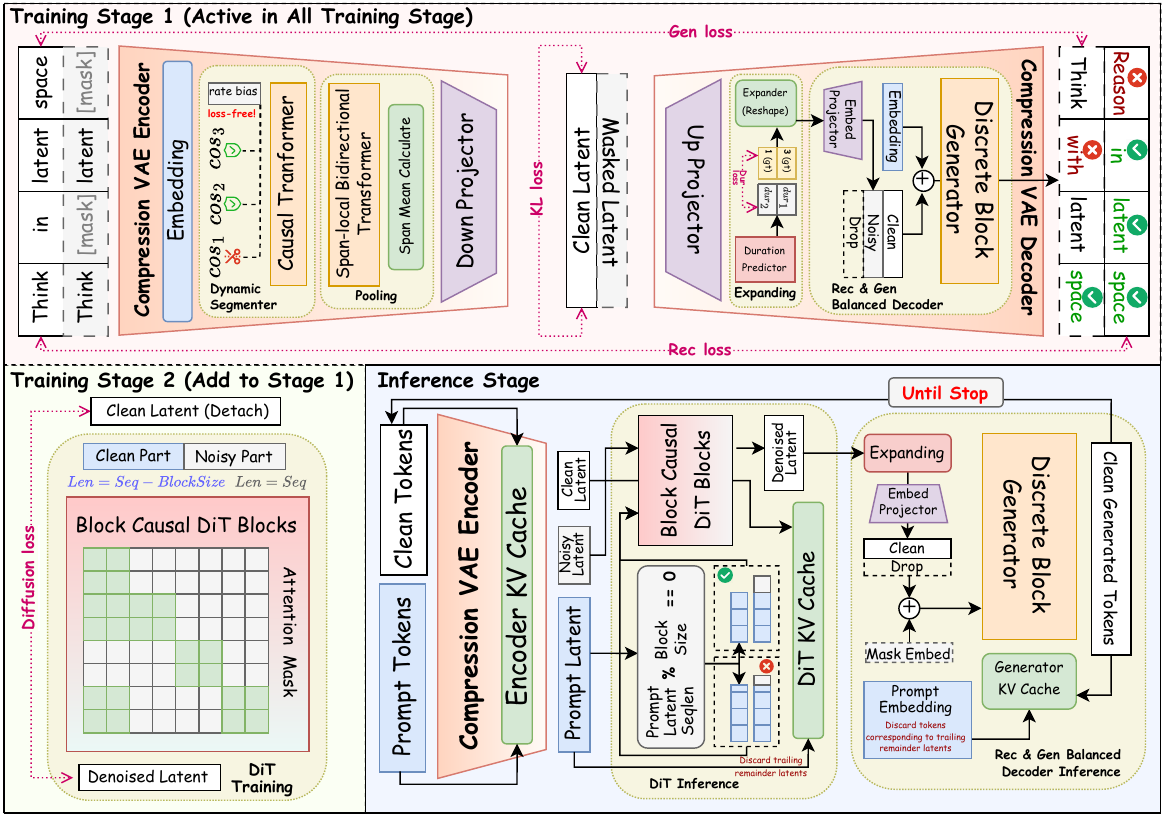
图 1:Cola2 的整体工作流程。上半部分是 Stage 1(压缩 VAE 编码器 + 重建-生成平衡解码器联合训练,含 KL 损失、生成损失、重建损失);左下是 Stage 2(在 detach 后的干净潜变量上训练块因果 DiT);右下是推理阶段(DiT 逐块生成潜变量 → 解码器解码成 token → 生成的文本被重新编码回潜空间,保证历史一致)。注意右下角那个"重新编码"的回路,这是推理一致性的关键设计。
信息论视角:一笔算得清的信息账
论文把设计目标写得很清楚。给定上下文 \(C\),目标文本的不确定性可以拆成:
\(S\) 是高层语义变量。这个分解的读法是:潜变量应该尽量吃掉第一项(语义信息),把第三项(潜变量解释不了的不确定性)留给解码器去生成。作者还定义了一个"语义密度" \(\mathcal{D}_{\mathrm{sem}} = I(S;Z\mid C)/(\rho T)\),衡量每个潜变量位置承载多少高层语义——这个量不直接进损失,是个设计标尺。
动态语义分割:按内容切,不按长度切
编码器的第一个模块是动态分段器。具体做法很朴素:计算相邻 token 表示的余弦距离 \(\delta_t = 1 - \cos(\mathrm{LN}(h_t), \mathrm{LN}(h_{t+1}))\),映射成边界概率 \(p_t = \sigma(\alpha(\delta_t - \tau_0) + b)\),超过 0.5 就切一刀。
压缩率怎么稳住?这里有个漂亮的小设计:不用任何可微的"压缩率损失",而是搞了一个无辅助损失的负反馈控制器——偏置 \(b\) 不参与反向传播,按 \(b \leftarrow \mathrm{clip}(b - \eta_b(\hat\rho - \rho^\star), -c_b, c_b)\) 规则直接更新。压缩率偏高就调低边界密度,偏低就调高,跟控制论里的负反馈一模一样。
这个选择有实际收益。对比 DLCM(一种用辅助速率损失做动态压缩的方法),负反馈控制在同样压缩率下拿到 25.0%,DLCM 只有 18.4%——差了 6.6 个点。作者的解释是:可微的速率损失会和表征学习目标互相拉扯,硬约束的负反馈直接绕开了这个竞争。
分段之后,span 内部用双向注意力做池化,潜变量序列方向用因果 Transformer 建模,输出对角高斯后验。编码器最优结构是 0+2+2(0 层 token 级 + 2 层池化 + 2 层潜变量级因果),总共只有 4 层——比 6 层的所有变体(20.9%–26.3%)都好,拿到 29.6%。编码器不是越深越好,层数分配比深度重要。砍掉池化层(2+0+2)直接掉到 15.7%,说明 span 内聚合才是核心。
重建-生成平衡:三种潜变量状态混合训练
解码器是块因果 MDM——块间因果、块内双向去噪。训练时每个潜变量块随机处在三种互斥状态之一:
- cond(干净潜变量,概率 0.2):解码器照着潜变量还原文本,学"忠实重建"
- noise(加噪潜变量,概率 0.4):潜变量部分损坏,学"半信半疑地生成"
- drop(直接丢掉潜变量,概率 0.4):只给文本上下文,学"完全自主生成"
为什么这样配?因为推理时 DiT 生成的潜变量必然带误差,解码器如果只在干净条件下训练,遇到有噪声的潜变量就会无所适从。数据也支持这个配比:重建准确率在所有配置下都保持在 99.5% 以上(重建这件事太容易了),所以大部分训练数据可以放心地分给"损坏条件"下的生成。把 noisy/clean 比例从 0.0/0.8 推到 0.6/0.2,LAMBADA 从 39.5% 涨到 43.2%;再把 drop 比例从 0.2 提到 0.4,又涨 2.2–2.4 个点。
另外还有一个生成监督损失 \(\mathcal{L}_{\mathrm{gen}}\):在编码器输入端随机 mask 掉一些 span(固定分割布局),强迫潜变量去预测"自己看不见"的 token。这个 BERT 式目标逼潜变量携带预测性信息,而不只是可重建性信息——论文里还专门给了个引理证明这个目标无法靠"复制当前输入"来作弊。
梯度路由:整个框架最精妙的地方
Stage 1 里,token 预测损失的梯度直接穿过潜变量回传编码器——\(\nabla_\phi \mathcal{L}_{\mathrm{tok}} \neq 0\)。这就是"协同适应"的物理实现:潜空间的信息分配由解码器的真实需求动态决定,而不是事先固化。
Stage 2 加入 DiT 训练潜变量先验,用的是标准 Flow Matching:采样 logit-normal 噪声时间 \(u\),构造插值 \(z_u = (1-u)\bar z + u\epsilon\),回归速度场 \(v^\star = \epsilon - \bar z\)。但关键来了——DiT 看到的潜变量是 \(\bar Z = \mathrm{sg}(Z)\),stop-gradient 切断了 Flow Matching 损失到编码器的通路。
这个"断"字值多少钱?实验显示:让 DiT 梯度每 10 步注入一次编码器,20k 步时确实领先 2.2 个点(23.6 vs 21.4),但 80k 步后被反超,140k 步时落后 1.0 个点(32.1 vs 33.1)。DiT 梯度的早期收益是"潜变量变得好拟合了",长期代价是"潜变量偏离了对文本建模最优的方向"。这个结论对做端到端潜空间训练的人很有参考价值——端到端不总是对的。
推理:提议-解码-重编码-提交
推理流程有个容易忽略但很重要的设计。DiT 逐块生成潜变量(提议),解码器把它落成 token,然后生成的文本会在固定的 span 布局下被重新编码,用校正后的潜变量替换提议值,才提交进历史缓存。
为什么多此一举?训练时干净历史来自真实文本的编码;如果推理时直接把 DiT 的"提议"潜变量存进历史,后续块看到的潜空间历史和实际生成的 token 历史就来自两个不同的语义状态,误差会累积。重编码把两个空间重新对齐到同一份已提交历史上。这个设计让我想到 Kalman 滤波里的"预测-校正"结构——提议是预测,重编码是用观测校正。
CFG 方面有两级:DiT 在速度空间做标准 CFG(\(\gamma_{\mathrm{gen}}\));解码器在 logit 空间做"前缀 × 潜变量"双轴 CFG,四个分支组合。实验发现最优解码器 CFG 权重稳定在 \(w_{\mathrm{dec}} = -0.9\) 附近。
🧪 实验:每个组件都被拆开验过
实验分三层:组件分析(主要在 LAMBADA 上)、受控 scaling(5 个任务、约 210B token)、以及一次 346B token 的大规模预训练对比。基础配置:OLMo 2 语料、\(\rho = 1/2\)、\(d_z = 64\)、\(L_{\max} = 8\)。
语义压缩:动态分割反超不压缩
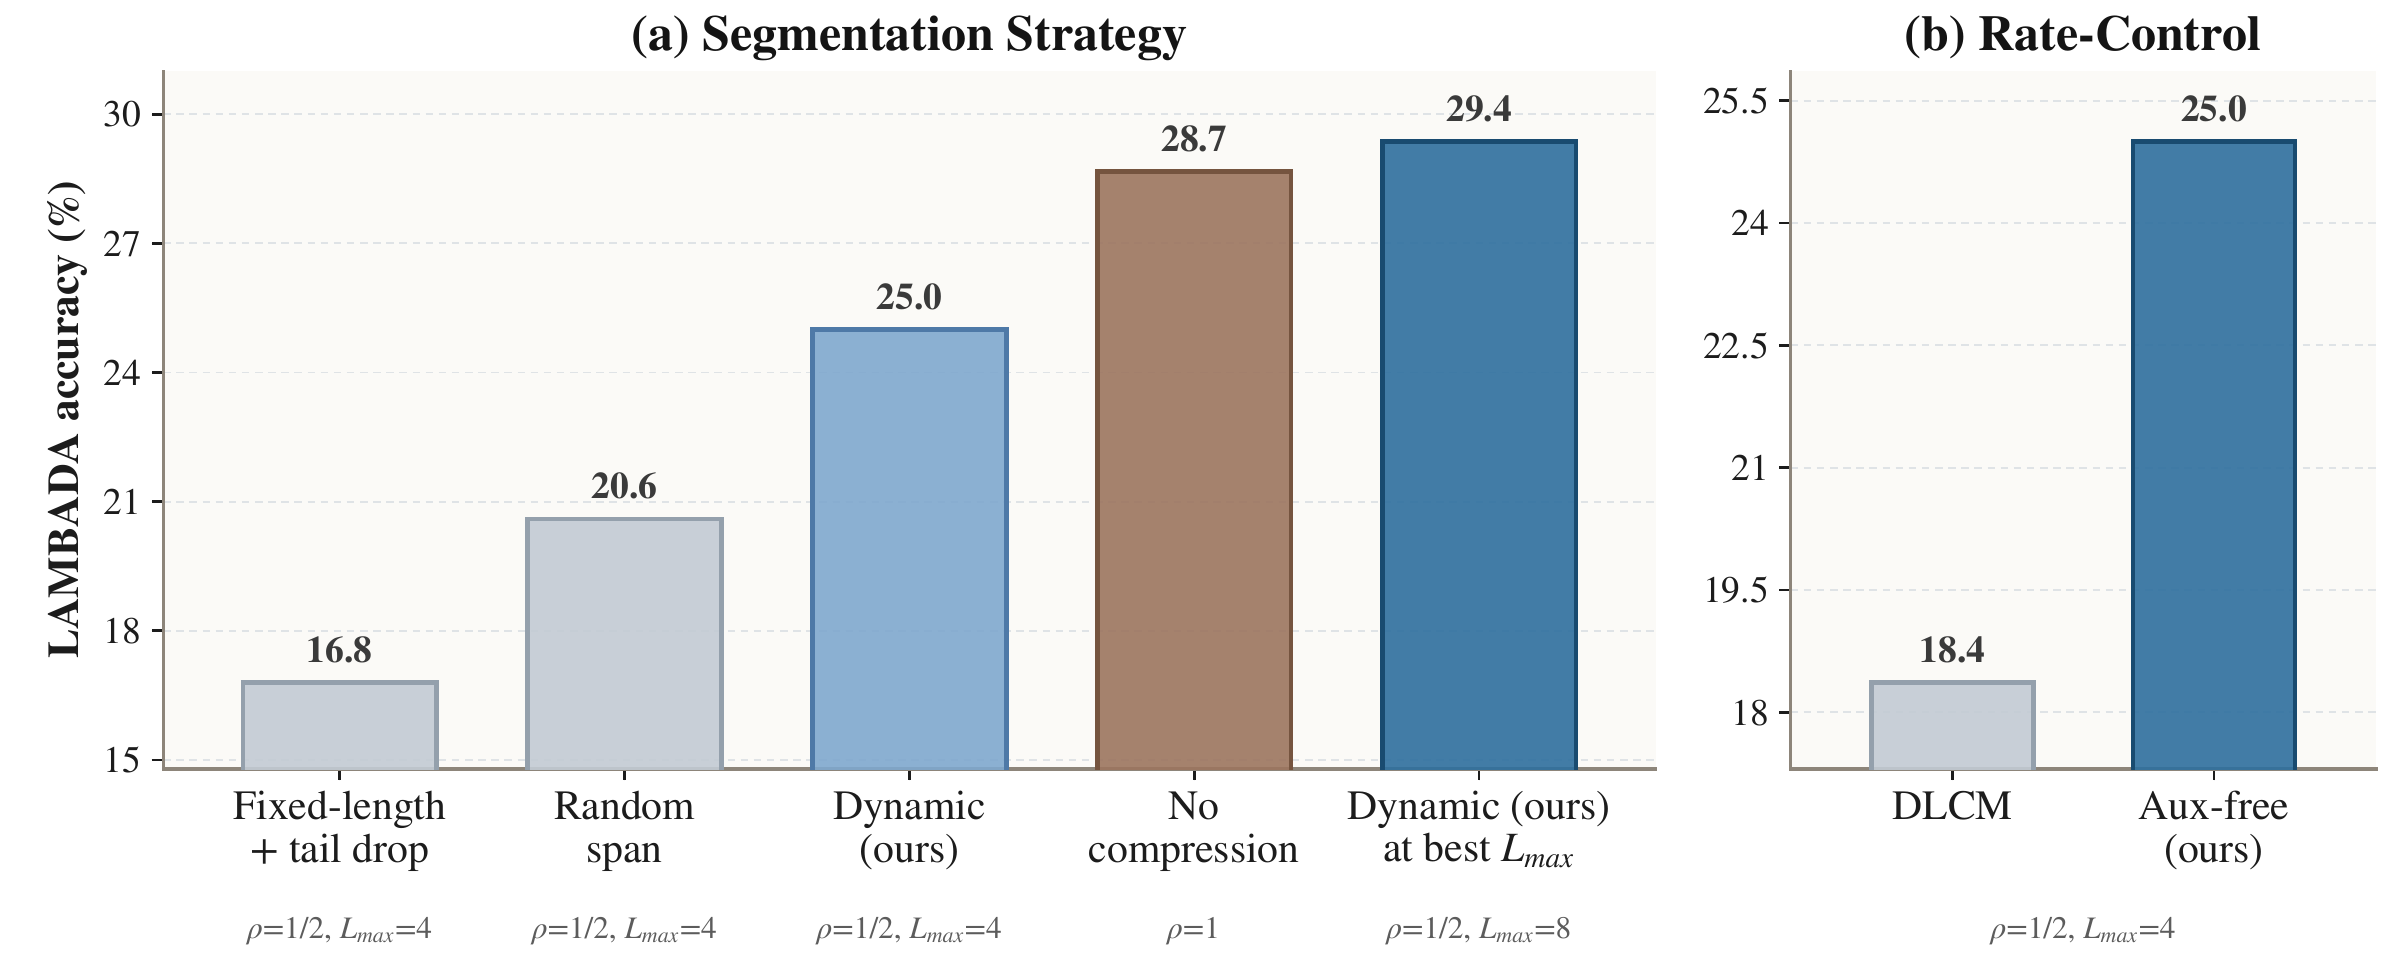
图 2:左图对比分割策略——固定长度 16.8%、随机 span 20.6%、动态分割 25.0%,而放宽 \(L_{\max}\) 到 8 后动态分割达 29.4%,反超不压缩模型(28.7%);右图对比速率控制——无辅助损失的负反馈控制(25.0%)大幅优于 DLCM 的辅助损失方案(18.4%)。
这个结果我觉得是全文最有分量的发现之一:基于内容的压缩不仅无损,反而有益。29.4% 对 28.7%,压缩一倍的模型赢了不压缩的。作者的解释是动态分割强迫潜变量对齐语义边界,等于给表征加了个有用的归纳偏置。
不过也要冷静看:这个"反超"是在 LAMBADA 单任务、小模型组件实验的规模下成立的。后面 scaling 实验里,压缩版(Cola2-MDM)在逐字复现类任务上仍然稳定落后于不压缩版。压缩的代价没有消失,只是换了地方体现。
压缩率、潜变量维度 \(d_z\)、\(L_{\max}\) 三者必须联合调。\(d_z = 64\) 时 LAMBADA 32.3%,拉到 512 反而崩到 14.5%——潜变量越宽,DiT 要拟合的分布越复杂。每个压缩等级的最优配置是:span 2 / \(d_z\) 64 / \(L_{\max}\) 8 → 32.3%;span 3 / 128 / 8 → 26.9%;span 4 / 256 / 18 → 25.2%。压缩越强掉点越多,这是诚实的结论。
生成监督与协同进化:encoder 必须跟着 decoder 一起长
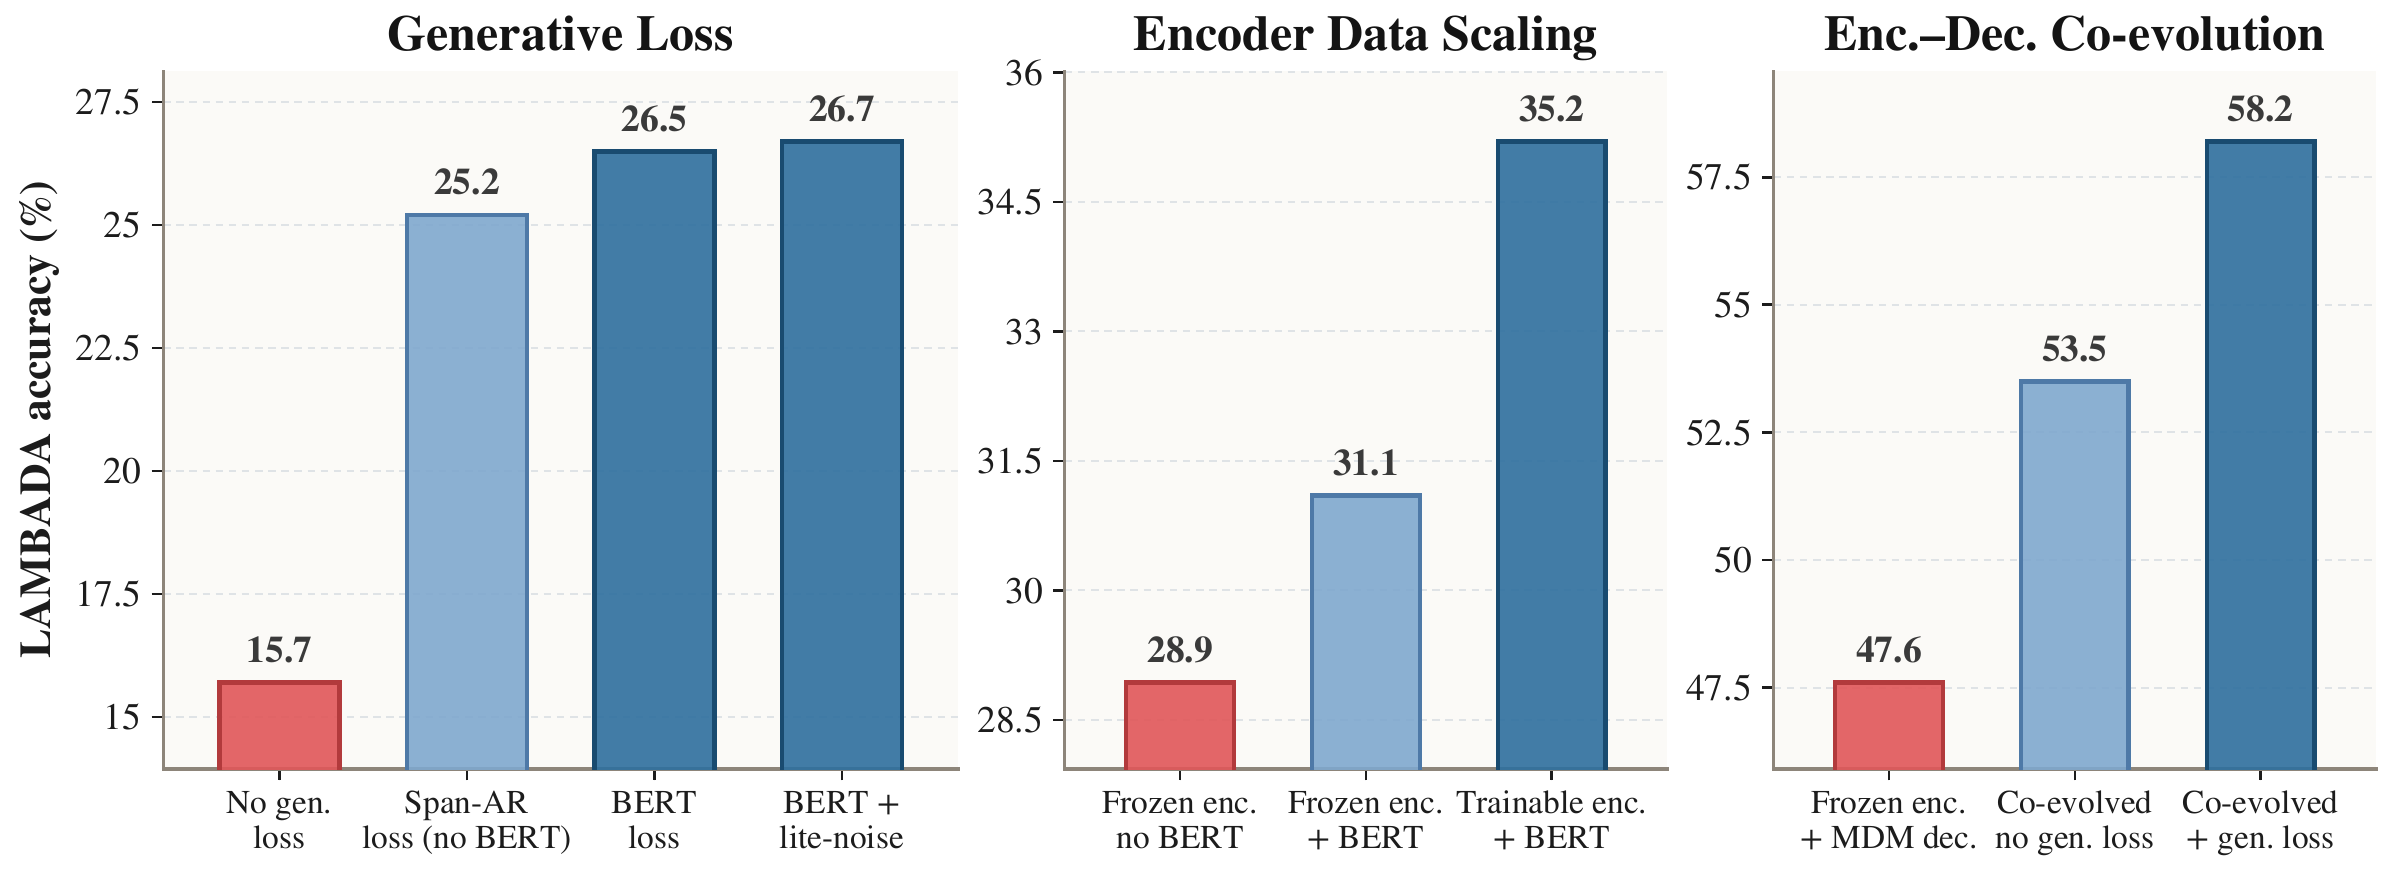
图 3:左图——纯重建只有 15.7%,加 Span-AR 目标到 25.2%,BERT 式目标 26.5%,BERT + 轻噪声 26.7%;中图——冻结编码器时 BERT 目标收益有限(28.9%→31.1%),解冻后到 35.2%;右图——MDM 解码器下,冻结编码器 47.6%、端到端协同进化 53.5%、再加生成损失 58.2%。
三个递进的数字值得记住:15.7 → 26.7(生成监督,涨 11 个点)、47.6 → 53.5(编码器解冻协同进化,涨 5.9 个点)、53.5 → 58.2(再加生成损失)。这直接支撑了论文的核心论点——潜空间存什么,必须由解码器的实际需求来决定。冻结编码器等于在解码器还没学会用潜变量之前就把信息分配方案钉死了。
DiT 侧:detach、噪声调度和块大小
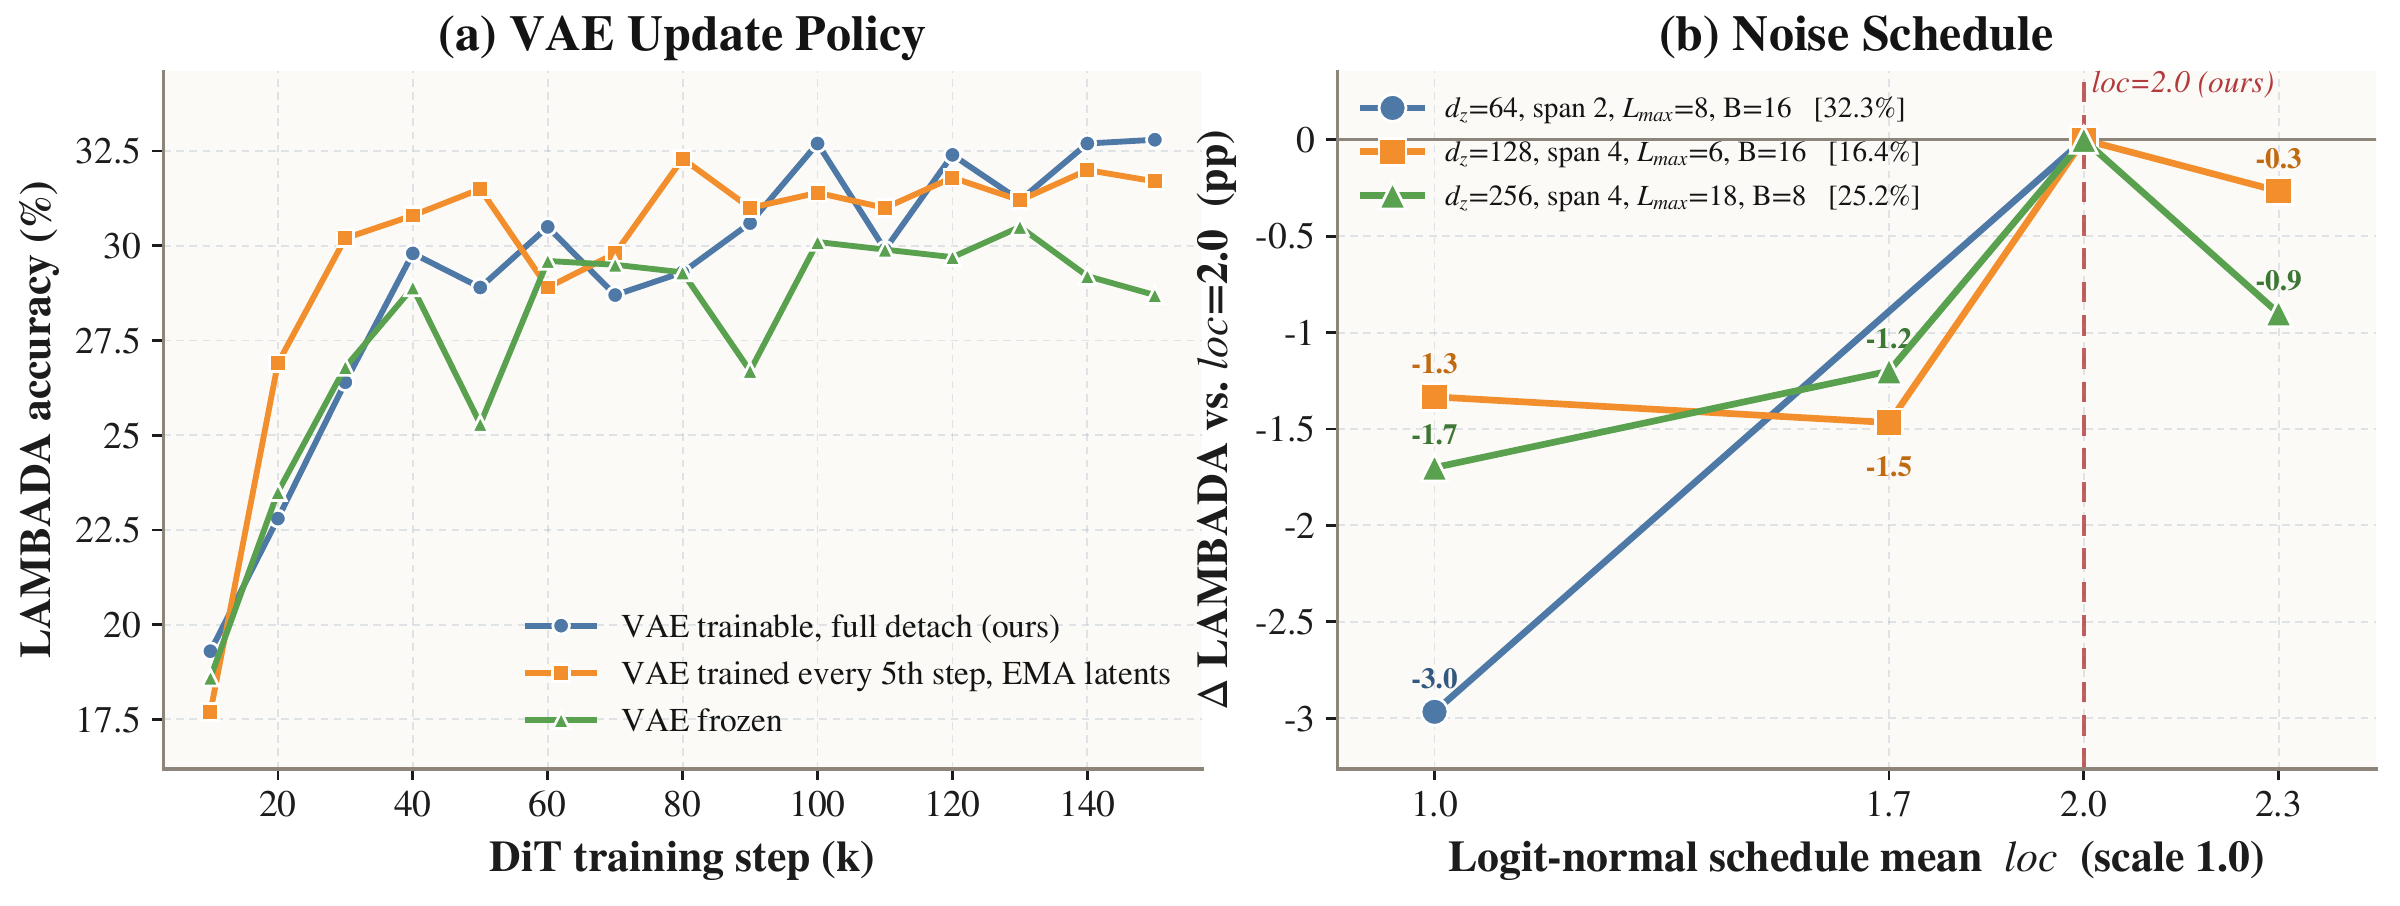
图 4:左图——Stage 2 中"VAE 可训练 + DiT 梯度完全 detach"(蓝线)全程领先于"VAE 冻结"(绿线);右图——logit-normal 噪声调度的 loc 在 2.0 处对三种配置都是最优,偏离会掉 0.3–3.0 个点,且损失幅度随 \(d_z\) 和压缩率变化。
几个实用结论:Stage 2 里 VAE 要继续训(32.8% vs 冻结的 28.7%)但 DiT 梯度必须 detach;噪声调度和潜变量分布要联合校准(loc=2.0 对当前配置最优,换了 \(d_z\) 或压缩率就得重新调);2B DiT 的最优块大小是 \(B = 4\)(36.4%),\(B = 1\) 退化成 31.8%,\(B = 24\) 掉到 27.3%,但 DiT 越大对大块越宽容——\(B\) 从 8 到 16 的损失,2B 模型掉 4.5 个点,7B 掉 3.4,32B 只掉 2.7。推理侧 DiT 8 步去噪就饱和了(8 步和 128 步差距不超过 0.3 个点),但 CFG 要开得很猛:8 步时 \(\gamma_{\mathrm{gen}} = 14\) 才能把准确率从 12.2% 拉到 37.1%。
解码器侧:混合比例与潜变量依赖
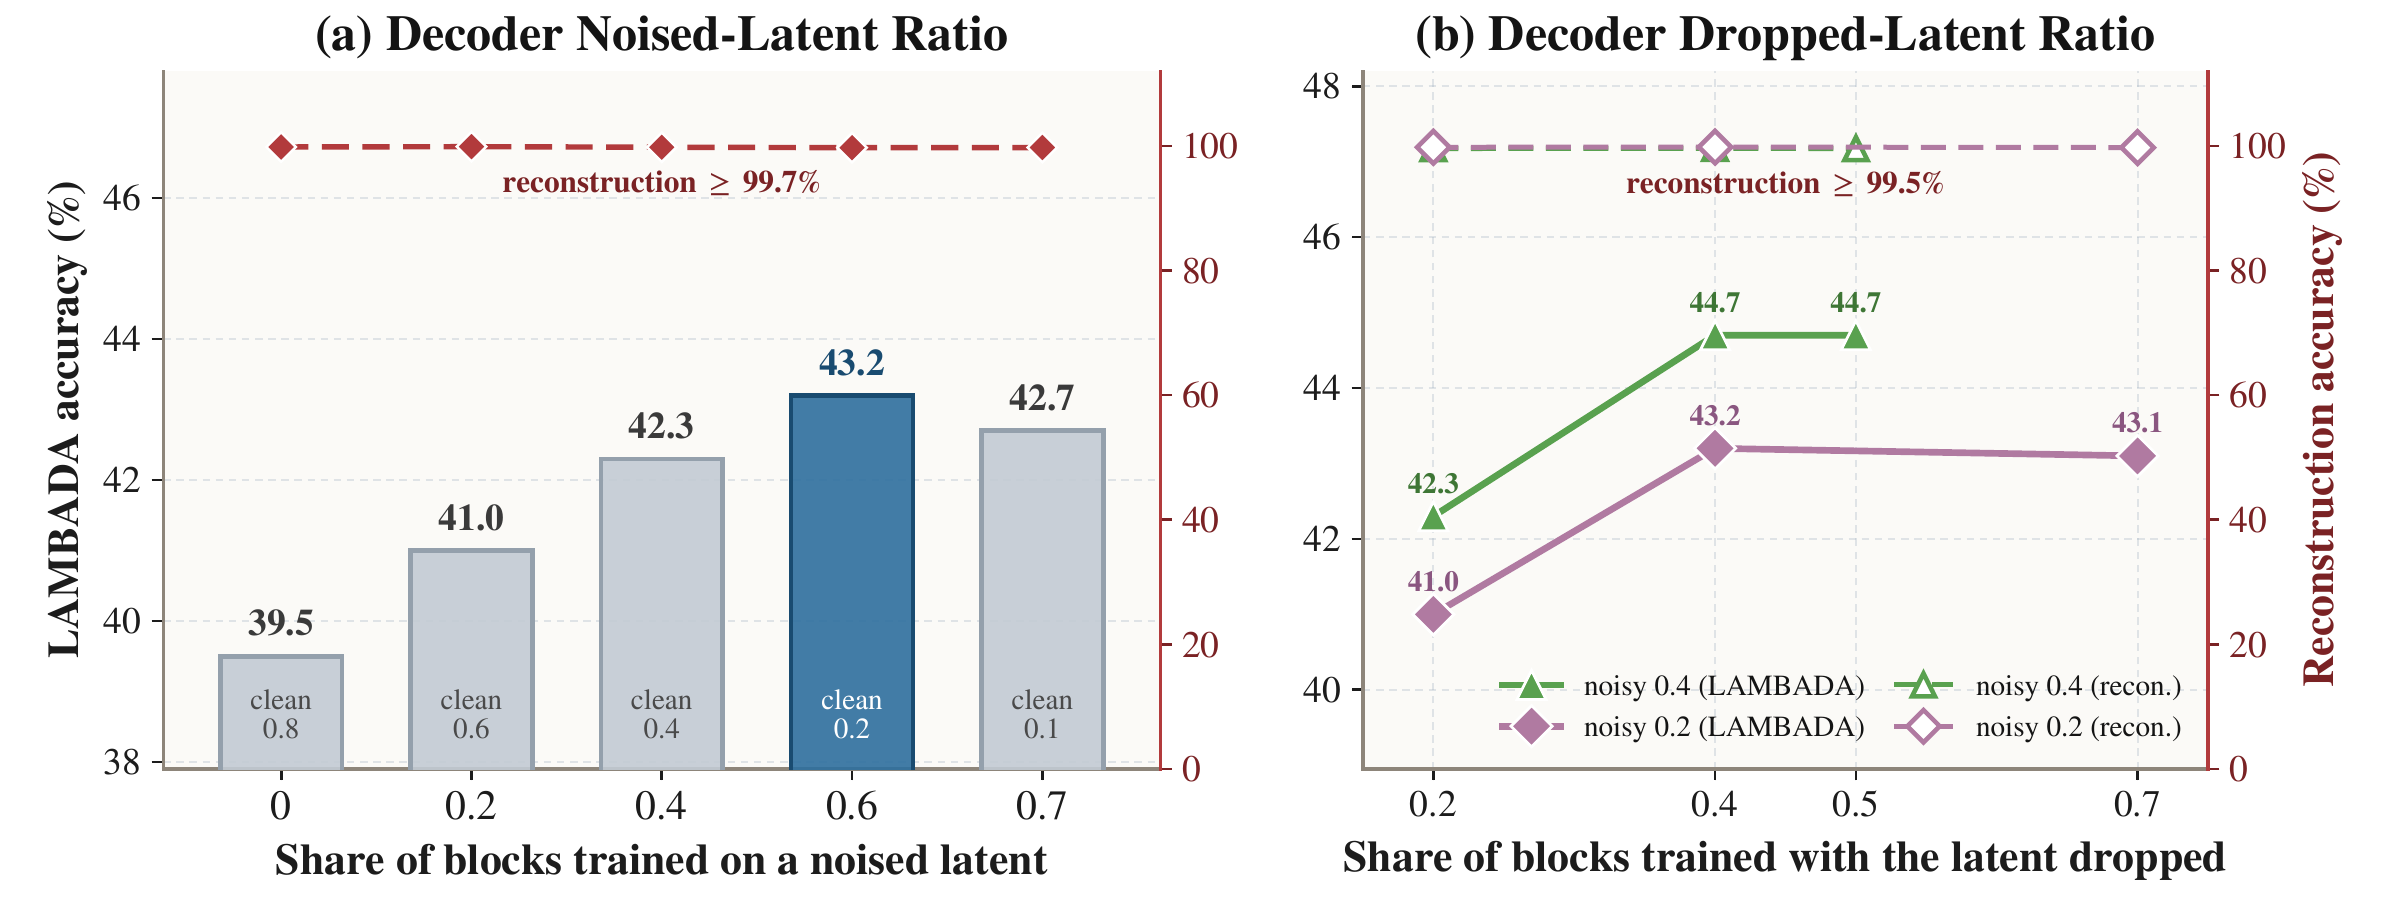
图 5:解码器训练数据的条件配比消融。左图——noisy 比例从 0 提到 0.6(clean 从 0.8 降到 0.2),LAMBADA 从 39.5% 涨到 43.2%;右图——drop 比例从 0.2 提到 0.4 再涨 2 个多点,最终 drop/noisy/clean = 0.4/0.4/0.2 拿到最好的 44.7%。注意右轴:重建准确率全程保持在 99.5% 以上。
这张图的信息量在于它推翻了一个朴素直觉:"多给解码器干净条件,重建会学得好,整体应该更好"。事实是重建早就饱和了(99.5%+),瓶颈全在"潜变量不可靠时怎么办"。训练时多见损坏条件,推理时才能扛住 DiT 生成的不完美潜变量。
还有个有意思的发现:解码器用 AR-MTP 还是 MDM,差距始终在 1.4 个点以内、而且训练过程中交替领先——解码器的具体分解方式不是决定性因素,层级框架对两种 token 空间生成范式都兼容。真正值钱的是共享的"潜变量-token 接口"。
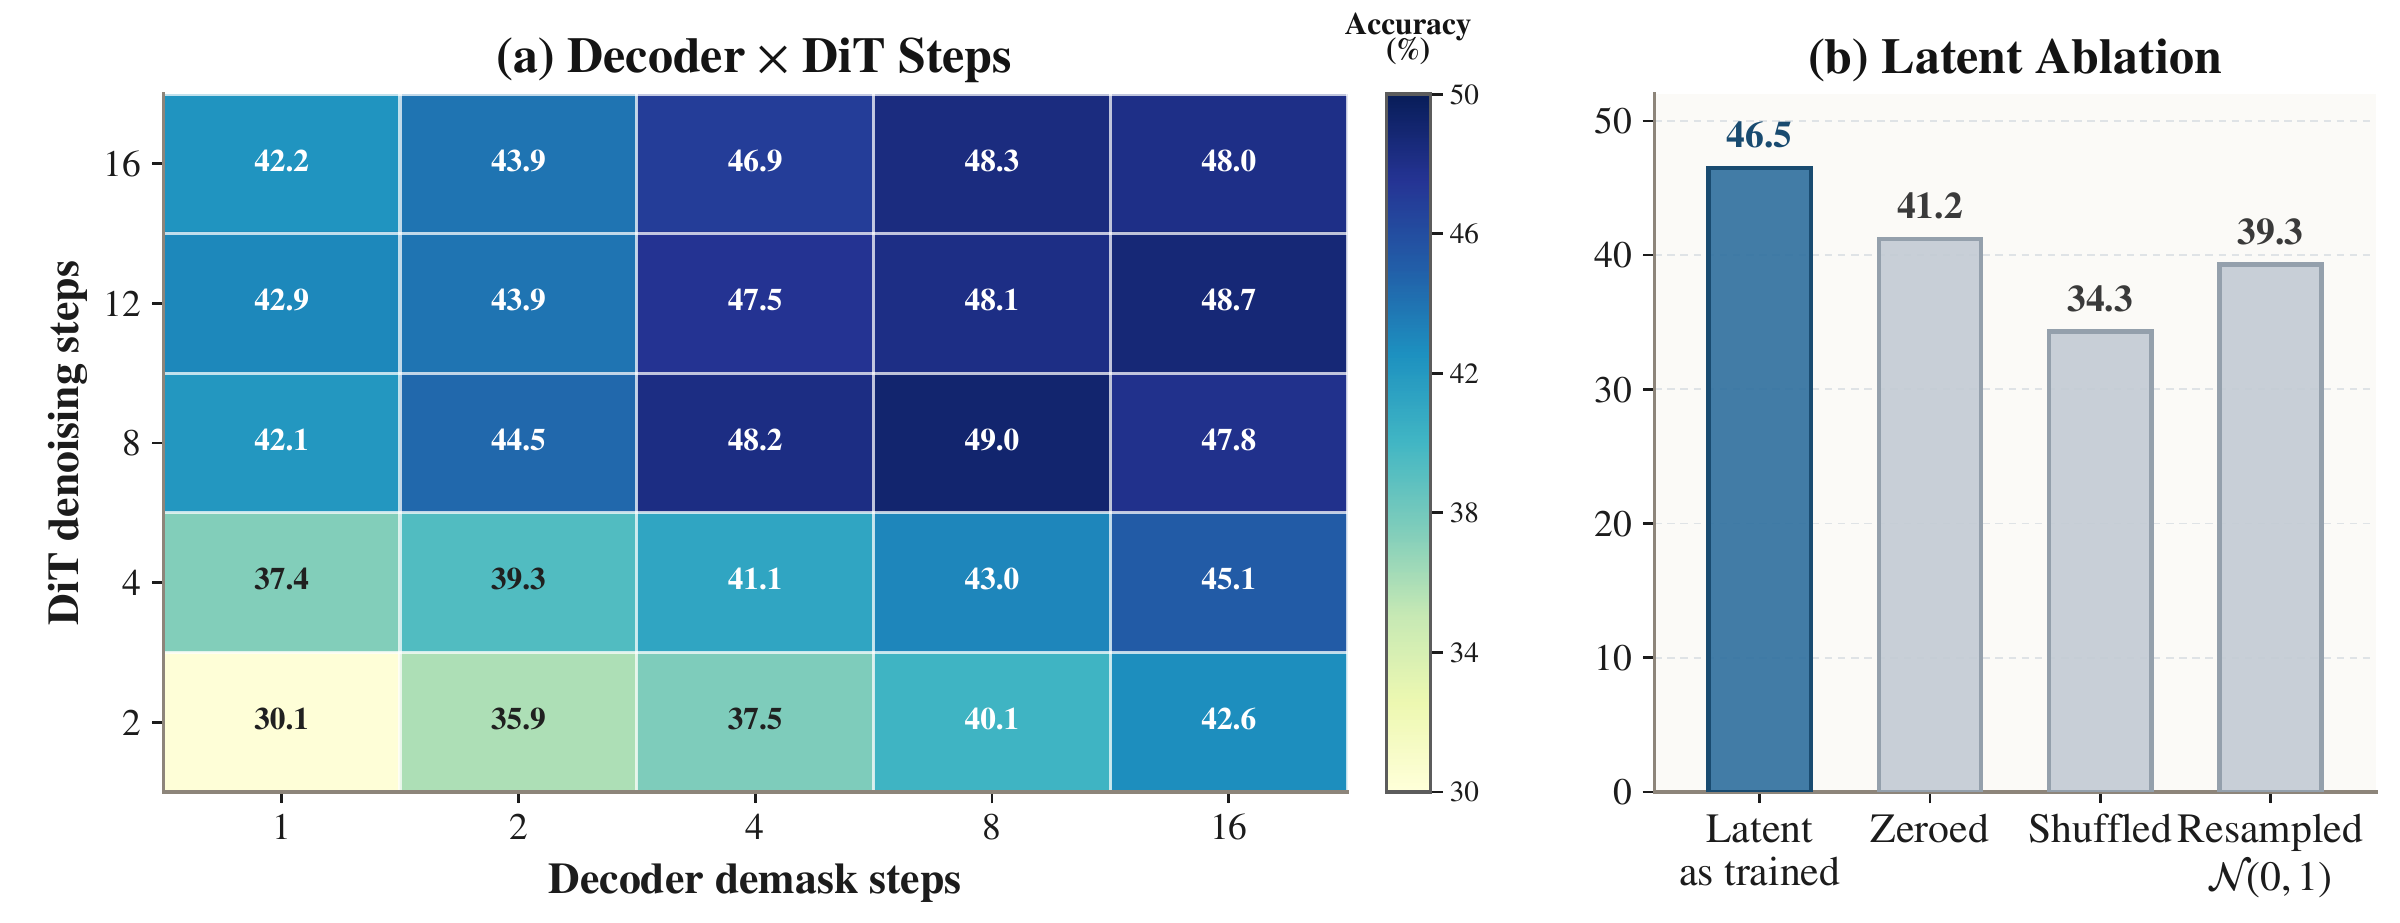
图 6:左图——DiT 去噪步数 × 解码器去掩码步数的热力图,8/8 拿到最好的 49.0%,8/4(48.2%)是低成本的默认配置;右图——潜变量消融:正常 46.5%,置零 41.2%、重采样 39.3%、打乱 34.3%。打乱最伤,因为潜变量统计上真实但语义上错位。
打乱潜变量掉 12.2 个点、比置零还惨——这说明解码器是真的在"读"潜变量的内容,而不是把它当可有可无的辅助信号。置零对应训练时见过的 drop 状态,所以掉得最温和。这个消融设计得很干净,直接把"解码器是否依赖潜变量"这个问题钉死了。
参数分配上,固定 3B 总预算,2B DiT + 1B 解码器(44.4%)比其它分法好 3.3–4.4 个点——DiT 比解码器更吃参数。这也符合直觉:高层语义规划是难的部分,逐字落实相对简单。
Scaling:压缩版追得慢,但没饱和
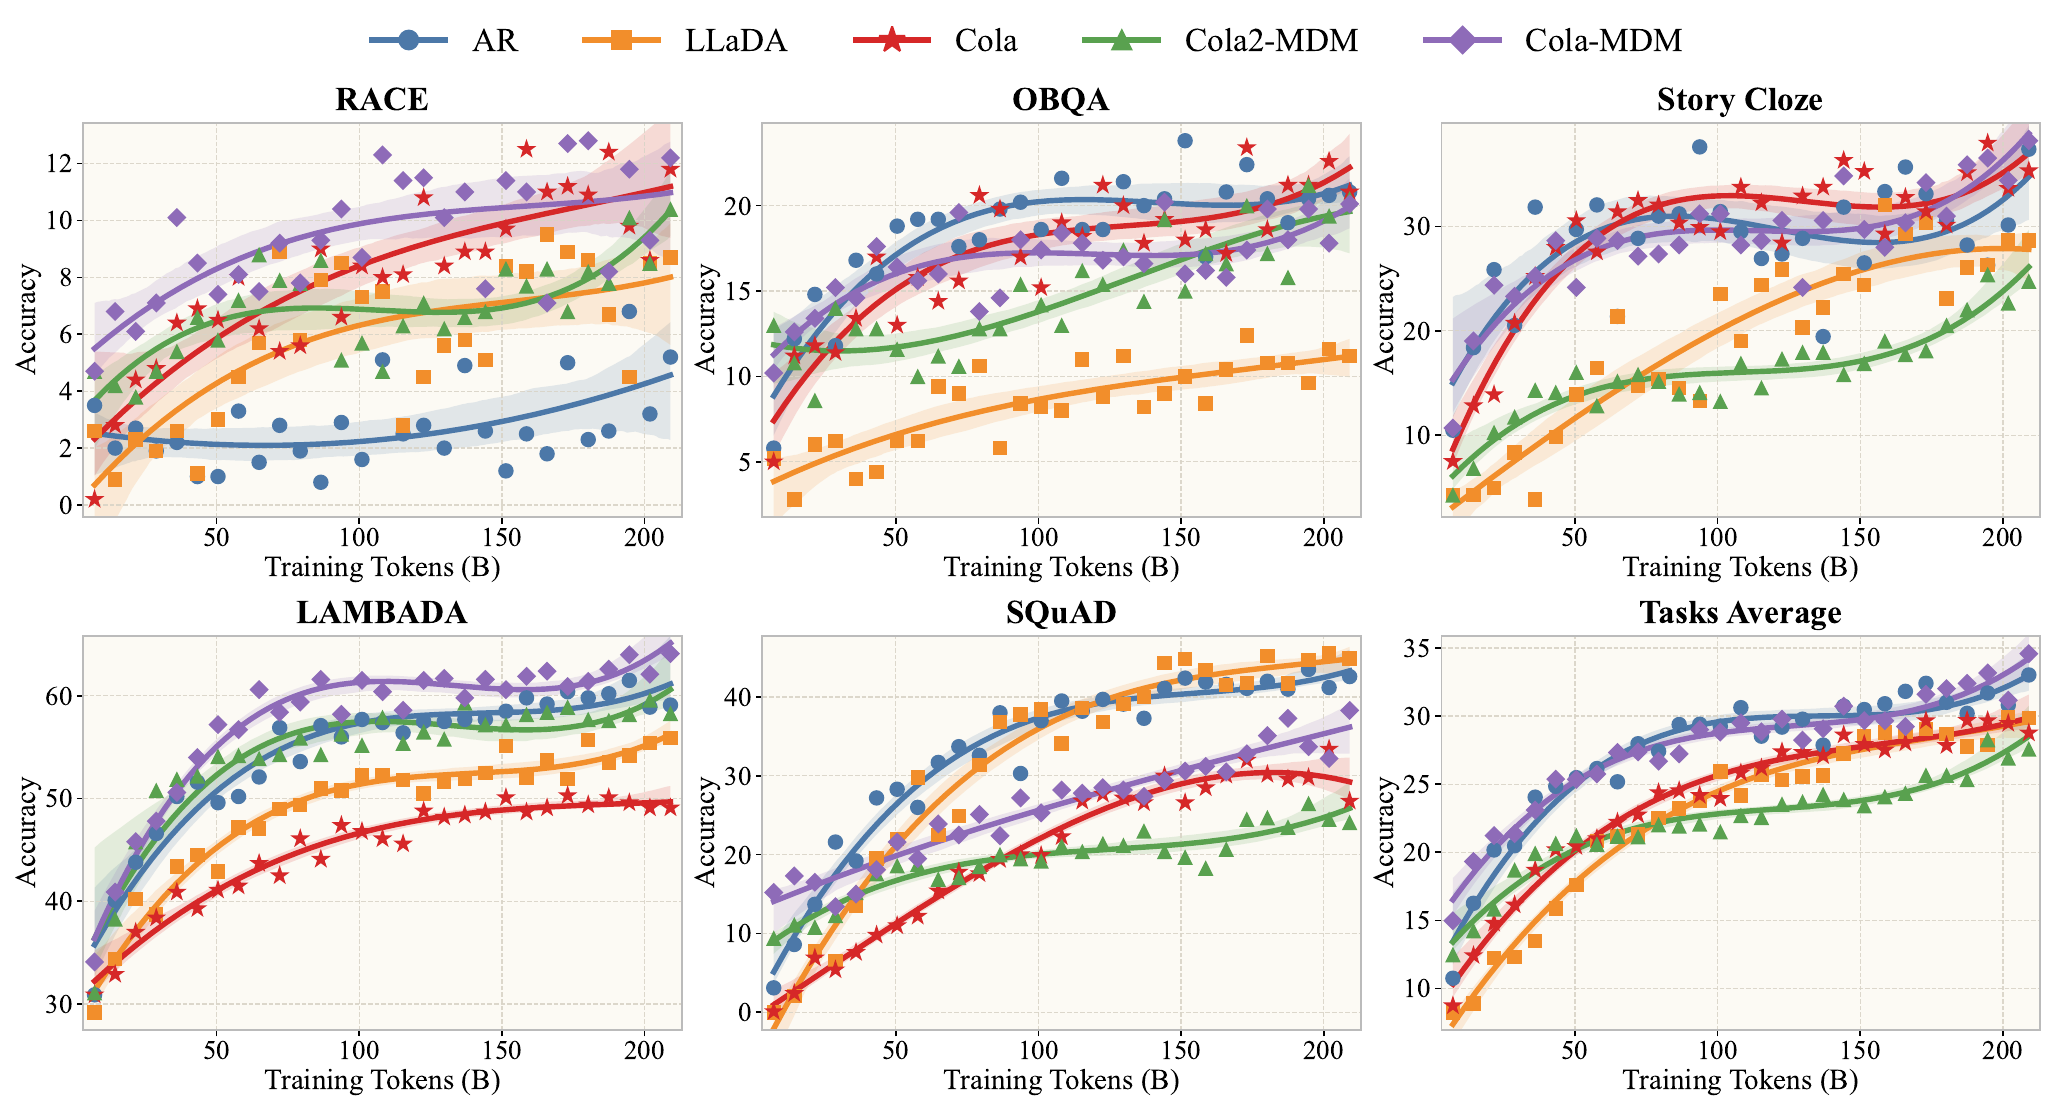
图 7:约 210B token 内五种范式在 5 个任务上的 scaling 曲线。Cola-MDM(不压缩,紫色)整体最强;Cola2-MDM(压缩版,绿色)起步慢但持续收窄差距,在 RACE 上大幅领先所有对手,在 LAMBADA 上与 AR 打平;Cola DLM(红色)受限于自家解码器,在生成类任务上明显偏弱。
几个关键读数:Cola-MDM 最终任务平均约 34.5%,超过 AR 的约 33%;LAMBADA 上约 64%,比 Cola DLM 高 15 个点左右——说明 Cola DLM 的短板在解码器,不在层级框架本身。Cola2-MDM 在 RACE 上 10.5% 对 AR 的 4.5%,优势夸张;但在 SQuAD 和 StoryCloze 这类需要逐字复现的任务上落后——压缩的代价集中在这里,跟前面组件实验的判断完全自洽。150B token 之后,压缩版和 LLaDA 的平均差距从约 4 个点缩到 1.5 个点,曲线还没走平。
大规模预训练:346B token 对打 15T 的 Llama-3-8B
最后一组实验换了独立的大规模配方:Qwen3-4B tokenizer、序列长 4096、解码器和 VAE 词嵌入从 Qwen3-4B-Base 初始化。三阶段训练:Stage I 用 52.43B token 训压缩 VAE;Stage II 加入约 4B 参数的潜变量 DiT(34 层、hidden 2560、20 头、块大小 8),再训 125.83B;Stage III 冻结 EMA VAE、只训 DiT,再训 167.77B。总计 346.03B 源 token。
| 任务 | Llama-3-8B | Qwen2.5-7B | Qwen3-8B-Base | LLaDA-8B-Base | Cola2 |
|---|---|---|---|---|---|
| 预训练 token 量 | 15T+ | 18T | ~36T | 2.3T | 346B |
| RACE | 75.77 | 89.95 | 90.65 | 87.40 | 69.91 |
| NarrativeQA | 42.70 | 32.90 | 37.30 | 36.00 | 32.70 |
| HellaSwag | 39.21 | 75.67 | 68.13 | 69.65 | 41.75 |
| StoryCloze | 79.49 | 95.09 | 97.44 | 95.94 | 80.42 |
| LAMBADA | 75.70 | 71.82 | 71.20 | 67.90 | 63.00 |
| ARC-Easy | 90.86 | 96.00 | 97.35 | 93.85 | 87.62 |
| TruthfulQA | 63.04 | 69.03 | 72.58 | 64.87 | 54.10 |
| MMLU | 63.19 | 70.16 | 72.31 | 61.27 | 51.32 |
| 八任务平均 | 66.25 | 75.08 | 75.87 | 72.11 | 60.10 |
表 1:预训练后八任务对比。Cola2 用 346B token(未收敛 checkpoint)拿到 60.10 的平均分,在 HellaSwag 和 StoryCloze 上反超训练 token 多 43 倍以上的 Llama-3-8B。
怎么看这张表?公平地说,60.10 对 66.25 还是输的,离 Qwen3-8B 的 75.87 差得更远。但要注意两点:一是 token 效率——346B 对 15T,数据量差了 43 倍,平均分差只有 6.15 个点,而且这个 checkpoint 明确说没收敛;二是 MMLU 和 TruthfulQA 这种知识密集型任务恰恰是数据量最敏感的地方,Cola2 在这些任务上落后最多(MMLU 51.32 vs 63.19),这更像是"数据没喂够"而不是"范式不行"。反过来在 HellaSwag、StoryCloze 这类依赖语言建模能力本身的任务上能反超 Llama-3-8B,说明 Qwen 初始化的解码器能力确实通过这套框架迁移了过来。
论文自己也很克制,明说这组对比"模型不是算力对齐的",目的是给 post-pretraining 性能一个坐标,而不是宣称胜利。这个态度加分。
💡 我的判断
这篇论文最值钱的地方不是某个单点创新,而是把"连续潜空间 + 离散生成"这条路线上的关键设计问题全部拆开做了一遍受控实验。 动态分割要不要做?要,而且能反超不压缩。压缩率怎么控?负反馈硬控制,别用辅助损失。编码器冻不冻?不能冻,要让解码器的梯度去塑造它。DiT 梯度回不回传?不回传,stop-gradient 防 latent hacking。解码器条件怎么配?0.4/0.4/0.2 的 drop/noisy/clean。每个问题都有直接的实验答案,对后来者是实打实的工程地图。
几个我觉得需要留意的点:
- 压缩的真实代价在逐字复现任务上。SQuAD、StoryCloze 的差距在整个 scaling 曲线上没有消失的迹象。如果应用场景需要精确引用原文,1/2 压缩率的潜空间可能不是好选择。
- 反超 Llama-3-8B 这件事要冷静读。只在 2/8 个任务上反超,平均分仍落后 6 个多点。token 效率的叙事成立,但"43 倍数据差"这种表述很容易被断章取义成"效率提升 43 倍"——论文没这么说,读者也别这么读。
- 推理成本没被打包票。论文对推理开销的分析很诚实:压缩把潜变量轴长度降到 \(\rho\) 倍、注意力对数降到 \(\rho^2\) 倍,但编码器-解码器通路、CFG 分支、重编码反馈都各自有成本,论文明确说这些复杂度结论"不构成端到端加速的充分条件"。这点很实在,比直接宣称"推理更快 N 倍"的论文可信得多。
- 组件实验大多在 LAMBADA 单任务、较小规模下做的,29.4% 反超不压缩这类结论能否在大规模下复现,scaling 章节只给了部分回答。
跟同期工作比,Cola2 的位置很清晰:它不是第一个做连续潜空间语言模型的(COSMOS、TextLDM 等都在做),也不是第一个做扩散解码的,但它是把"压缩-生成平衡-协同适应"这三件事放进统一框架里系统研究的第一批工作。从 Cola DLM 到 Cola2 的演进路线也说明了问题所在——上一代的瓶颈不在框架,在解码器。
如果你在做潜空间生成、扩散语言模型,或者单纯想找一条 AR 之外有 scaling 潜力的路线,这篇值得花一个下午精读。附录里 30 多页的实现细节(推理缓存协议、FLOP 记账方式、几个引理的证明)都是诚意。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我