不用闭源大模型,也能给电脑智能体"造世界":WildAWM 的全开源环境合成流水线
训练一个会操作电脑的智能体(Computer-Use Agent,CUA),最缺的是什么?不是模型,不是算法,是环境。让 agent 直接在真实电脑上跑强化学习,状态没法重置、网站天天在变,探索性动作还可能闯祸——OpenAI 自己都发过真实世界 RL 的事故报告。手工搭环境(WebArena、OSWorld 那一类)可控是可控,但贵且慢,规模化不了。
所以最近一年"合成环境"成了热门方向。但说实话,我看了不少这类工作,大多有两个让我皱眉的地方:一是只覆盖单一交互接口——要么只做网页 GUI,要么只做工具调用或终端,可真实的电脑使用任务根本不挑接口;二是合成过程严重依赖闭源前沿模型,GPT、Claude 烧一通 token,成本和可复现性都不友好。
这篇 WildAWM(arXiv:2610.26828)把这两个问题一起打了:用纯开源模型造出同时支持 GUI、MCP 服务、CLI 三种接口的个人电脑环境,再配上五道执行级质量关卡筛任务。最终合成的 341 个长程任务,连 GPT-6-Astra 也只能解出约 60%。拿这些合成世界去训 Qwen3.6-35B-A3B,8 个未见过的 OOD benchmark 平均涨 10.58 个点。
核心摘要
痛点:CUA 的 RL 训练卡在环境供给上——真实世界太贵太危险,手工环境不可扩展,已有合成流水线又只覆盖单接口且依赖闭源模型。方案:WildAWM 从"用户人设 + 多日生活轨迹"出发,用开源编码 agent(GLM-5.2 + OpenCode)逐日物化出一台包含网站、MCP 服务、本地文件的虚拟个人电脑,再合成必须跨 GUI/MCP/CLI 三种接口才能完成的 XAI 任务,用异构 agent 试错 + 五道质量门保证任务可解、够难、验证器可靠。效果:341 个任务平均 4.2 个子任务、3.1 次接口切换,74.5% 需要回访已用过的接口;Qwen3.5-4B 和 Qwen3.6-35B-A3B 只在合成世界里训练,8 个 OOD benchmark 全线上涨。我的判断:这不是某个单点算法突破,而是一条完整的"环境工业化"流水线,最值钱的是那套执行级质量门设计——它把"合成数据可信吗"这个老问题变成了可量化、可回归的工程问题。
论文信息:Zhaoyang Wang, Qianhui Wu, Haorui Wang, Simon Yu, Baolin Peng, Canwen Xu, Hao Cheng, Wenlin Yao, Boyi Liu, Yite Wang, Jianfeng Gao, Huaxiu Yao(UNC-Chapel Hill / Microsoft Research / Georgia Tech / Northeastern University 等),2026 年 10 月 19 日提交。代码开源在 GitHub(MSR-Orchard/WildAWM)。
🎯 问题动机:为什么单接口合成不够用
真实的电脑任务是由"要完成什么"定义的,不是由"用什么接口"定义的。订个机票可能要查邮件(MCP)、跑个脚本整理行程(CLI)、最后在网页上点确认(GUI)。而已有的合成流水线——AWM 只做工具调用、WebArena-Infinity 和 CUA-Gym 只做网页 GUI、TMax 只做终端——造出来的都是"单机房",agent 学不到跨接口协调这个关键能力。
WildAWM 换了个视角:直接合成一整台"有人用过的个人电脑"。这台电脑里有网站镜像、有 MCP 服务、有多天积累下来的本地文件和应用数据,任务天然长在这样的世界状态上,而不是空降的孤立指令。
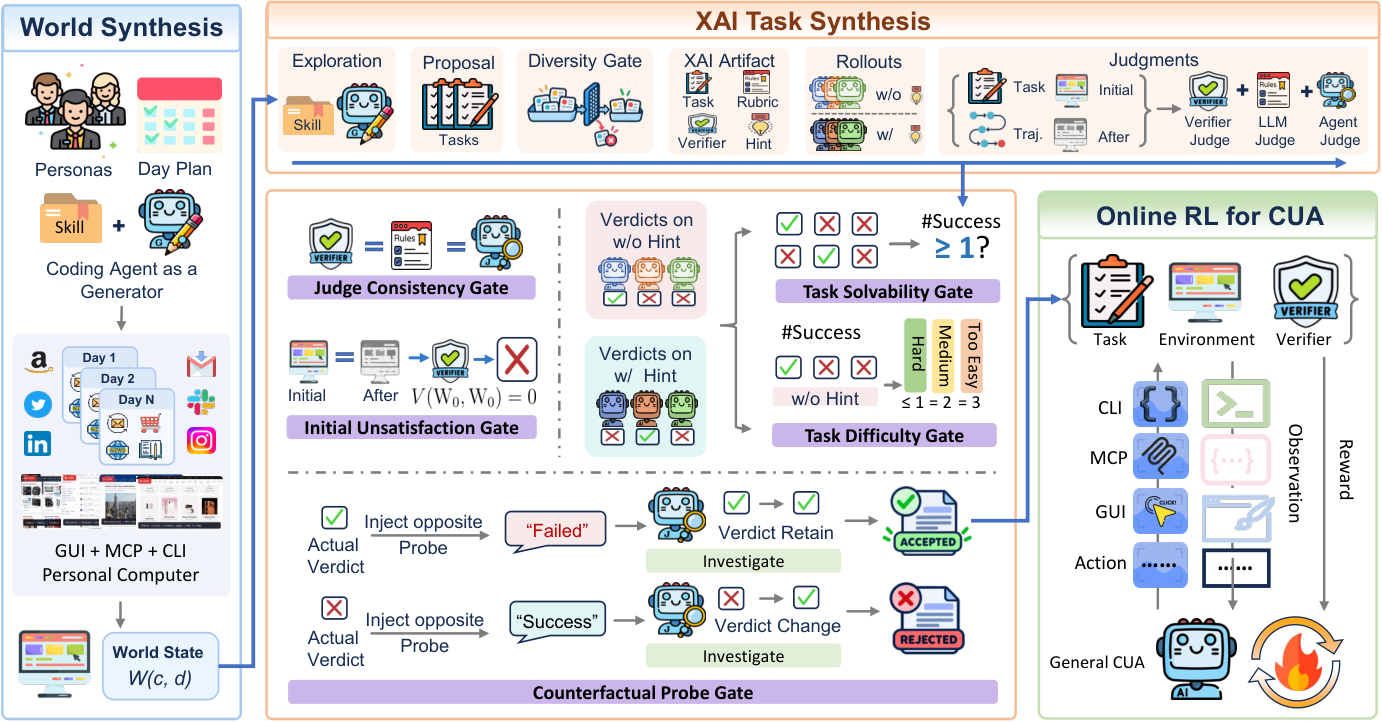
图1:WildAWM 流水线总览。左侧 World Synthesis:人设 + 多日计划由编码 agent 逐日物化成世界状态 W(c,d),暴露 GUI+MCP+CLI 三种接口;中间 XAI Task Synthesis:探索→提案→多样性门→rollout→三级裁判,再过五道质量门(裁判一致性、初始不满足、可解性、难度、反事实探针);右侧用 {task, environment, verifier} 三元组做在线 RL 训通用 CUA。
🏗️ 方法一:世界合成——先造人,再造他的生活
世界合成的思路挺有意思:不直接造环境,而是先造"人"。
生成器(GLM-5.2 跑在 OpenCode 里)先凭空合成一个 persona——职业、联系人、常用网站、跨多天的活动线。然后把这个 persona 的活动展开成逐日的 day plan,每天明确涉及哪些人、哪些数字资产、需要哪些应用和服务。接着编码 agent 逐日物化:第 d 天的状态 \(W(c,d)\) 是在第 d-1 天基础上增量构建的,已有应用实现直接复用,缺的再补。
这里有个我很喜欢的设计:可复用技能库。每个事件技能(event skill)固化了一类活动涉及的接口、状态变更和跨记录的一致性约束——比如"学生在 Coursera 选课并完成作业"这个技能,就编码了对应的数据库和文件更新流程。新活动来了就合成新技能,加进共享库给后续的人设和日子复用。最后产出的规模:36 个 persona、15 个网站镜像(来自 WebHarbor)+ 8 个 MCP 服务、640 个世界状态、83 个技能、17 万条数据库记录。
世界状态不是一次性的背景板,它是有"历史"的——任务可以依赖几天前埋下的聊天记录、库存文件,这就让长程依赖自然地长出来了。
🔧 方法二:XAI 任务合成与五道质量门
环境有了,任务合成才是真正的硬骨头。作者点出三个反复出现的问题:可解性(任务真的能被完成吗)、难度(别一眼就被秒了)、验证器可靠性(判分器别瞎判)。解法是一条执行级多智能体验证回路。
rollout 阵容相当豪华:3 个开源模型(GLM-5.2、DeepSeek-V4-Flash、MiniMax-M3)× 6 个 harness(OpenCode、Codex、Claude Code 三个 coding agent,加 Nanobot、OpenClaw、Hermes Agent 三个 claw agent),组成 18 个模型-harness 组合,每个任务跑 6 条 rollout(一半带提示)。三级裁判:合成器刚写出来的程序化验证器 \(V\)、语义级 LLM judge、以及会主动多轮检查环境前后状态的 agent judge。
验证器本身是个 N 项二元清单,任务成功要求全部通过:
然后五道门逐个把守:
| 质量门 | 检查什么 | 不通过怎么办 |
|---|---|---|
| 裁判一致性 | 6 条 rollout 上 \(V = V_{\text{LLM}} = V_{\text{agent}}\) 全部相等 | 带着分歧证据回去改 rubric 和验证器 |
| 初始不满足 | \(V(W_0, W_0, \emptyset) = 0\),初始状态不能算完成 | 拒绝"已经做完了"的水任务 |
| 任务可解性 | 至少 1 条 rollout 成功,且成功轨迹用满声明的三种接口 | 全部失败就打回 |
| 任务难度 | 3 条无提示 rollout 成功数 \(k\):\(k \le 1\) 为 hard,\(k=2\) medium,\(k=3\) 太简单退回加难度 | 太简单就回炉 |
| 反事实探针 | 故意告诉 agent judge 相反的结果结论,看它是否坚持原判 | 被带偏就拒绝 |
最后这道反事实探针是真的巧。LLM 有谄媚(sycophancy)倾向——你说"我觉得它其实成功了",judge 很可能顺着你改口。作者反过来利用这个弱点做压力测试:注入与真实结论相反的主张 \(1 - V\),judge 重新调查后 verdict 不变才算过。用模型的缺点来检验模型,这个思路我觉得可以推广到很多 judge-based 流水线里。
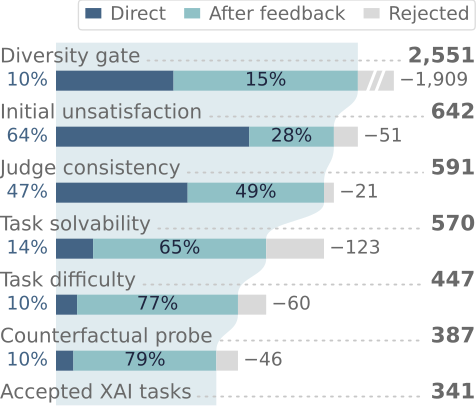
图2:任务候选通过各阶段的漏斗——相当比例的候选是靠反馈修订后才过关的,说明质量门确实在"干活"而不是摆设。
最终的 341 个任务里 273 个 hard、68 个 medium。合成期无提示成功率只有 21.3%,带提示也才 45.6%。平均 4.2 个子任务、3.1 次接口切换,74.5% 的任务需要回访之前用过的接口——也就是说 agent 必须在接口切换间保持状态,不能在一个接口里闷头做完。每个任务平均要修 2.5 轮,生成器平均吃掉约 7000 万输入 token。成本不低,但换来的是执行级的可信度。
📊 实验:只在合成世界里训练,OOD 全线上涨
训练配置:Qwen3.6-35B-A3B 和 Qwen3.5-4B 两个底座,先用 100 条 GLM-5.2 轨迹 SFT 热启动 3 个 epoch,再跑 GRPO 最多 64 步。奖励设计值得一看——成功任务拿满 1 分,未完成的按清单项给部分分:
格式错误直接 -1 并终止该 rollout。针对小模型常见的"全组零方差、GRPO 没信号"问题,作者借鉴 DAPO 给每个任务维护一个 rollout 倍率的指数滑动估计,还给"全员格式错误"的组一个 \(-K^{-1/2}\) 的保底劣势信号。都是工程细节,但都是真踩过坑才会写的细节。
主实验表(Table 5)是全文最硬的证据:
| 模型 | O2W | WA | QCB | CLE | CUG | OSV | OS-2 | ALE | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| GLM-5.2 | 86.67 | 67.26 | 64.44 | 59.67 | 78.78 | 62.46 | 45.00 | 41.39 | 63.21 |
| GPT-6-Astra | 92.78 | 74.34 | 65.21 | 80.33 | 83.56 | 71.28 | 60.77 | 56.58 | 73.11 |
| Qwen3.5-4B 基座 | 26.39 | 30.09 | 44.06 | 26.67 | 21.39 | 18.18 | 0.87 | 7.00 | 21.83 |
| WildAWM-4B | 45.65 | 39.82 | 48.37 | 36.67 | 37.35 | 22.48 | 1.03 | 8.96 | 30.04(+8.21) |
| Qwen3.6-35B-A3B 基座 | 69.60 | 53.54 | 57.86 | 38.00 | 53.73 | 33.16 | 13.22 | 23.57 | 42.84 |
| WildAWM-35B | 80.77 | 67.26 | 61.44 | 54.67 | 65.95 | 49.22 | 21.73 | 26.31 | 53.42(+10.58) |
三个值得说的点。第一,8 个 benchmark 全线上涨,而且这 8 个全是 OOD——训练只用合成世界,评测全是没见过的 web / claw / computer-use 任务,这个泛化幅度说明合成世界确实抓到了某些可迁移的能力,不是过拟合到自己的分布上。第二,大模型获益更多(+10.58 vs +8.21),CLE 上直接 +16.67、OSV +16.06。第三,35B 训完在 WebArena 上追平了 GLM-5.2(67.26),在 O2W 上反超 GPT-5.5(80.77 vs 72.22)。
当然也要泼点冷水:离 GPT-6-Astra 的 73.11 还有明显差距,OS-2 和 ALE 这种超长程榜单上绝对值仍然很低(21.73 和 26.31)。合成世界能填的差距是有边界的。
🔬 消融与行为分析:钱花在了哪
质量门消融(Table 7,4B 模型 + SFT)很有说服力:拆掉任何一道门,平均掉 2.60–9.30 个点。裁判一致性和初始不满足这两道最关键——拆掉后域内验证集从 21.59 崩到 3.79 和 3.05。换句话说,没有质量门的合成数据近乎有毒。
RL 配方消融(Table 8,35B):去格式奖励 -1.24,去清单部分分 -2.25,去 SFT 热启动直接 -5.31。热启动的重要性再次印证——小模型直接上 RL 大概率学不动。
行为分析(图5)是我觉得全文最有洞察的部分:
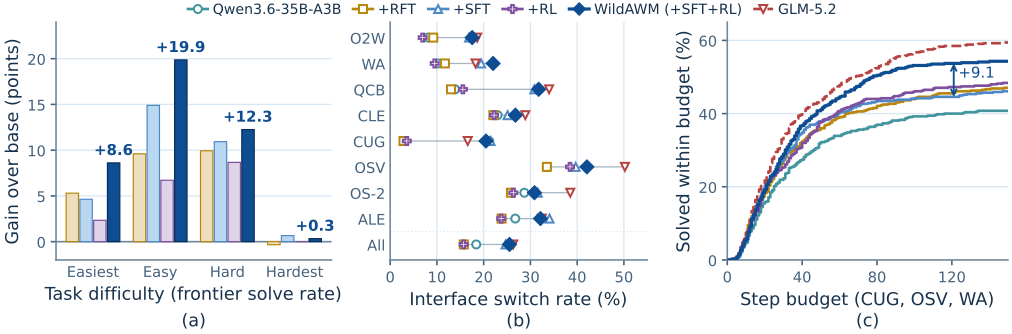
图5:(a) 按前沿模型解题率分难度四分位,WildAWM 的增益集中在第二、三档(+19.9 / +12.2),最难档几乎没涨——老师够不着的,学生也学不到;(b) 接口切换率:SFT 后从 18.4% 升到 24.7%,RL 微升到 25.5%,逼近老师 GLM-5.2,而用自身轨迹 RFT 或直接 RL 反而降到 15.8%/15.7%——跨接口行为是从老师轨迹里学来的,不是自己悟出来的;(c) 步数预算曲线:40 步内 SFT 和 WildAWM 接近,40–120 步区间 WildAWM 多涨 17.0 个点而 SFT 只有 9.7——RL 真正的贡献在长程解题。
这三张图合起来讲了一个很干净的故事:SFT 从老师那里继承跨接口行为模式,RL 在此基础上长出长程能力,二者分工明确,谁也替代不了谁。
合成质量方面(图3):WildAWM 的环境状态中位数 52.4K token,是 CUA-Gym(1.1K)的近 50 倍,Vendi 多样性分数还更高,最近邻余弦距离 0.25 vs 0.20——又大又多样。验证器与三个 agent judge 的多数投票一致率 95%,Cohen's \(\kappa\) 0.90,可靠性在自然波动范围内。可扩展性上,341 个任务覆盖 134 个领域、91 种任务类型,53% 接受率,且随池子增长任务间平均余弦距离保持稳定——没有靠"换皮"凑数。
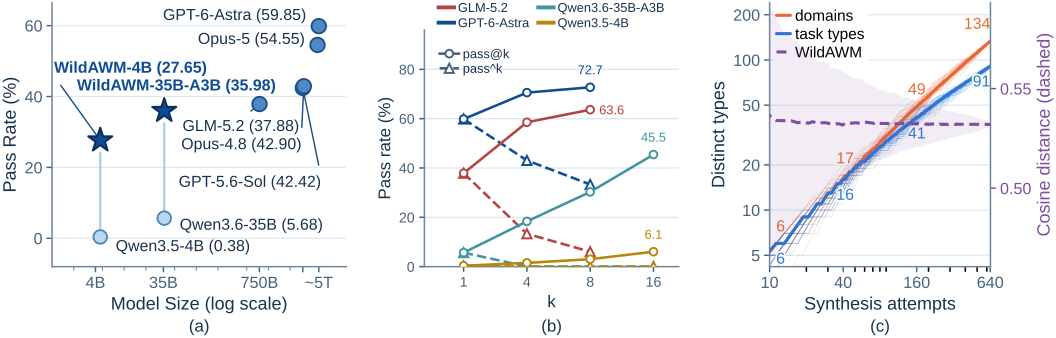
图4:(a) 不同规模模型在 WildAWM 验证集上的表现,训练后的 35B 模型(35.98)逼近 GLM-5.2(37.88);(b) pass@k 与 pass^k 曲线——即使 8 次尝试,GPT-6-Astra 仍有 27.3% 的任务解不出,说明难度在 test-time scaling 下依然成立;(c) 领域与任务类型随合成尝试数持续扩张,未见饱和。
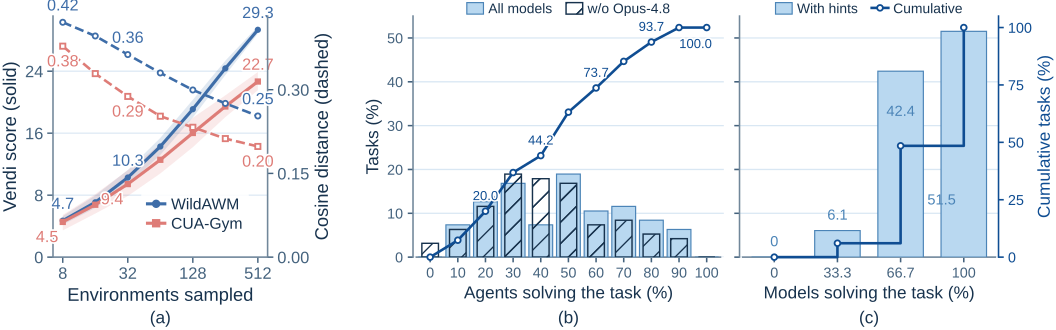
图3:(a) Vendi 分数对比,WildAWM(蓝)在各采样规模下均高于 CUA-Gym(红);(b) 24 个模型-harness 配置下,每个任务都至少被一个 agent 解出;(c) 仅用三个开源模型,带提示时 100% 的任务至少被一个模型解出、51.5% 被全部三个解出。
💡 我的判断
这篇论文的定位要放准:它不是提出新 RL 算法,而是把"环境合成"从手工作坊推向流水线工业。我认为最值钱的三样东西:
- 三接口统一的世界观。GUI+MCP+CLI 共存于一台有历史的虚拟电脑里,这比单接口合成更贴近真实电脑使用的形态,大概率会成为后续 CUA 环境工作的标配设定。
- 五道执行级质量门。尤其是反事实探针——用 sycophancy 反向压力测试 judge,这个 trick 成本低、通用性强,任何用 LLM-as-judge 的数据流水线都可以抄。
- 全开源模型的可行性证明。合成、验证、裁判全部用开源模型完成,且造出的任务连前沿闭源模型都只能解 60%——这件事本身就打破了"高质量合成必须靠 GPT/Claude"的迷思。
不足也得说:一是成本不低,每个任务平均 7000 万输入 token 的合成开销,离"便宜规模化"还有距离;二是增益集中在老师够得着的难度区间,最难的四分位基本没涨——本质是模仿学习的老瓶颈,合成环境并没有绕过去;三是绝对水平离前沿模型还有 20 个点左右的差距,合成世界能补的课是有限的。
如果你在做 agent 后训练,我的建议是:质量门那套设计(尤其 judge 一致性 + 反事实探针)可以直接搬进你的数据流水线,不管你的环境是不是合成的。这可能比论文的 RL 配方更有迁移价值。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我