120 组实验烧出来的结论:游戏智能体的 Scaling Law,和语言模型完全不是一回事
机器人圈这两年有个让人羡慕的叙事:数据越多、场景越杂,模型就越通用。物理世界的 scaling 确实是 work 的——重力、碰撞、物体恒存这些规律在所有场景里都成立,一个厨房里学到的抓取经验,搬到仓库里大概率还能用。
但游戏世界不吃这一套。Minecraft 里撸树、Doom 里开枪、2D 平台跳跃、棋类对弈——每个世界的物理、画面、操作、目标全都不同。经验还能不能跨世界复用?多游戏混合训练到底是互补还是互相干扰?说实话,这个问题之前所有的工作都答不上来,因为大家都是把数据量、多样性、模型大小捆在一起改,谁也说不清是哪个因素在起作用。
这篇 GameScaling 论文把这件事掰开揉碎了:4 种模型尺寸 × 6 档数据预算 × 5 种数据配比,120 组受控实验,一口气烧掉 3.5×10¹¹ token、2.2×10²² FLOPs。得出的结论相当反直觉——虚拟世界的 CPT 扩展规律和物理世界、和语言模型都不一样,而且有些发现直接打脸了"数据越多越好"的朴素信仰。
核心摘要
这是米哈游 Honkai AI 团队和清华、国科大、港大等机构合作的一项大规模受控研究,系统回答了"继续预训练在异构虚拟世界中是否可扩展"这个问题。核心发现有三条:其一,数据量提升语料内表现,多样性主要改善近邻世界的迁移,对遥远世界帮助有限;其二,训练存在"界面阶段"和"世界阶段"两阶段动态,作者据此拟合了一个把数据量、多样性、模型规模统一进来的三因子 scaling law,在 Minecraft 和语料内验证损失上 R² 分别达到 0.982 和 0.995;其三,训出的模型在 3D 世界能和前沿大模型掰手腕,实时设定下甚至数倍反超——但在视觉机制迥异的遥远世界,所有模型集体翻车。我的判断:这不是一篇刷榜论文,是一份难得的"否定性结果地图",它告诉你 CPT 这条路能走到哪、在哪堵墙前会停下来。
论文信息
- 标题:Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
- 作者:Kuan Zhang、Yukun Chen、Zhihao Yang、Yue Su、Xiangnan Wu、Zirong Chen、Run Luo、Jinkun Hou、Tao Tan、Yinhe Zheng(通讯)、Yiming Li(通讯)
- 机构:miHoYo Honkai AI R&D Team、清华大学、中国科学院大学、香港大学 MMLab、新加坡国立大学、北京大学
- 链接:https://arxiv.org/abs/2610.28698
- 项目主页:https://gamescaling.github.io | 模型:https://huggingface.co/THUSI-Lab/GameScaling | 代码:https://github.com/THUSI-Lab/GameScaling
为什么这个问题值得专门研究
先看这张图,它把论文的出发点讲得很清楚。
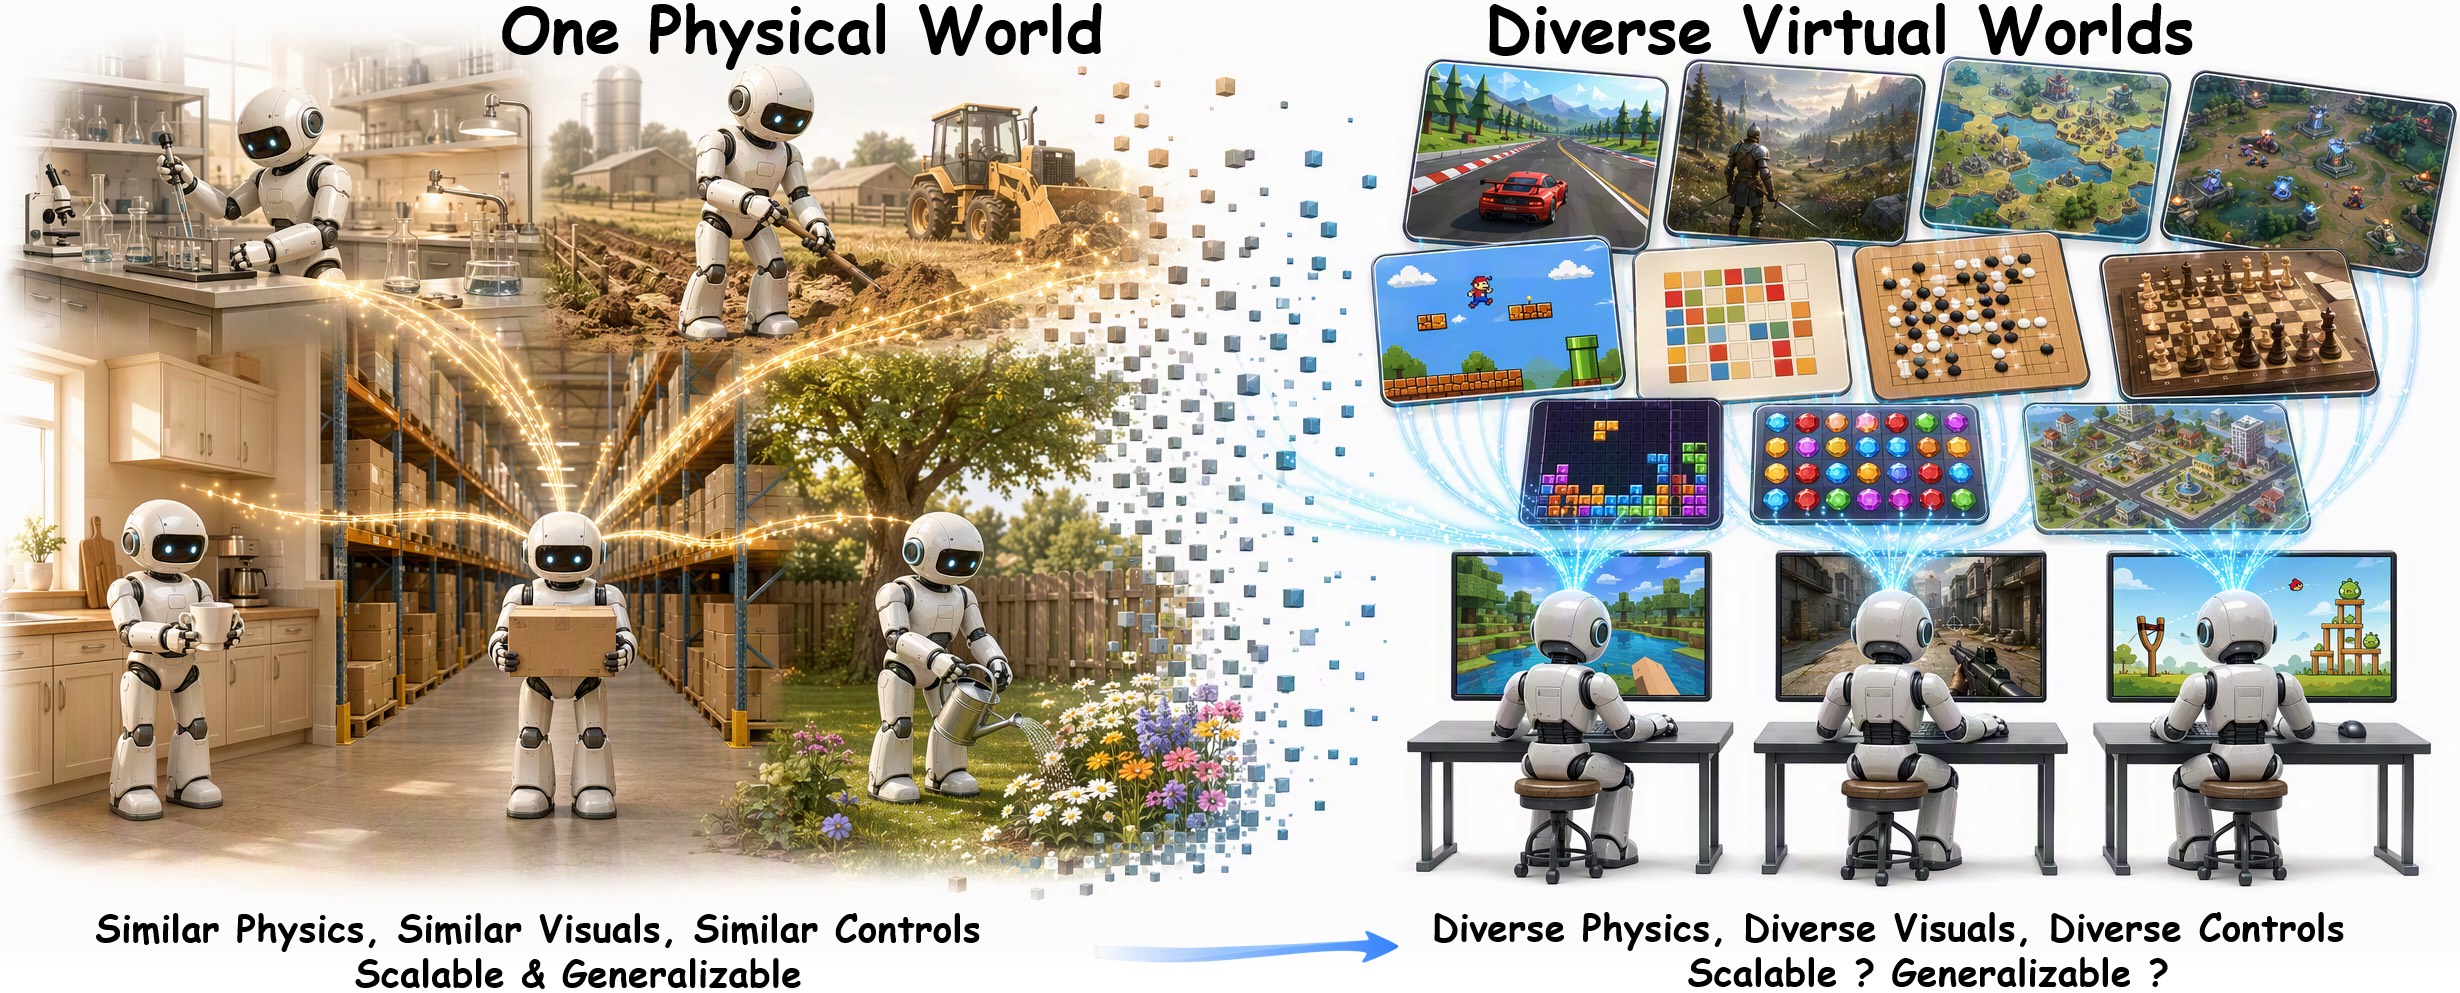
图1:左边是机器人学的设定——不同场景共享同一套物理规律,视觉、动力学、控制方式都相似,所以扩展经验能带来泛化;右边是游戏世界的设定——赛车、开放世界、即时战略、平台跳跃、棋类,每个世界的物理、画面、操控完全不同,scaling 是否还成立、能否泛化,都是问号。
机器人领域的 scaling 研究(比如 RT 系列、跨本体模仿学习)已经反复验证:经验越杂,模型越通用。前提是所有数据活在同一个物理现实里。游戏世界把这个前提抽掉了——两个游戏之间可能连"上下左右"的语义都不一样。
而游戏恰好又是通用具身智能体最严格的考场:感知是像素级的,动作是原生键鼠,规则和目标还千奇百怪。人类玩家换个游戏几分钟就能上手,这种跨世界适应力正是通用游戏模型想要的能力。已有的工作——VPT、NitroGen、OpenP2P、SIMA、GameTARS——都把 CPT 当成标准配方,但全是"一锅端"的改法。这篇论文想做的就是控制变量:一次只动一个轴,看看到底谁在起作用。
实验框架:120 组配置的网格
先交代游戏被怎么建模。每个时刻,模型输入提示上下文、当前观测画面和交互历史,输出一段可空的推理文本 \(r_t\),再输出一个动作块 \(a_t\):
动作块是结构化文本,覆盖 200ms 的操作:
其中 \((\Delta x_t, \Delta y_t)\) 是离散化的鼠标相对位移,\(\Delta z_t\) 是滚轮,每个 \(K_t^{(j)}\) 是 33ms 内按下的 0-4 个键。模型以 5Hz 接收画面、以 30Hz 输出控制,每条轨迹 20 个回合。这套接口和 SIMA、GameTARS 一脉相承,好处是所有游戏共享同一个动作空间,混合训练才有意义。
三条扩展轴这样安排:
- 模型:Qwen3.5 的 0.8B、2B、9B、27B 四档,全参数更新(含 ViT),AdamW + Warmup-Stable-Decay 调度
- 数据预算:50、100、200、400、800、1600 小时游戏录像
- 数据配比:S1(100% Minecraft)→ S2(51.4% MC)→ S3(27.1% MC)→ S4(2.8% MC)→ S5(0% MC),其余部分从 80 个游戏的池子里采样
训练数据 85% 是游戏轨迹(来自 VPT、D2E、OpenP2P 三个公开数据集),15% 是通用视觉语言和具身数据,用来保住 backbone 的通用能力。另外有个细节挺讲究:他们用 GPT-5.6-Luna 给一小部分游戏回合事后补标了推理文本——只加 <think> 内容、不改动作目标,这样既保留了模型的推理习惯,又不污染行为克隆的监督信号。
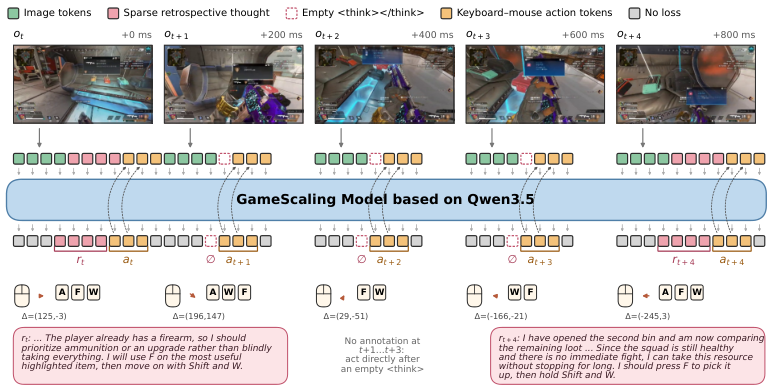
图5:Apex Legends 录像里连续的 5 个 200ms 回合。只有第 t 和第 t+4 回合带事后生成的推理文本,其余三个回合输出空的 think 段直接出动作。稀疏标注避免了逐帧推理带来的训练负担。
评估设计是这篇论文的骨架——三级验证损失加四级 benchmark:
| 层级 | 数据集 | 与训练分布的距离 |
|---|---|---|
| 语料内世界 | MCU(Minecraft)、ViZDoom(Doom) | 训练覆盖 |
| 未见近邻世界 | OmniGameArena(7 个未见 3D 世界) | 动作原语有对应物 |
| 未见遥远世界 | GameWorld(2D/2.5D 为主) | 视觉、物理、操控全面不同 |
验证损失也分三级:Minecraft 单独、语料内游戏混合、语料外 OOD。这套设计让"泛化距离"变成一个可以量化的变量,而不是泛泛的"能迁移/不能迁移"。
核心发现一:两阶段学习动态
这是整篇论文我觉得最值钱的观察。
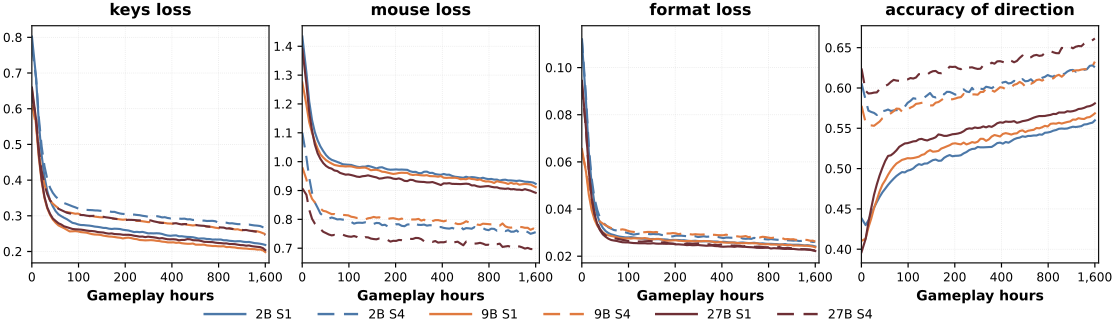
图2:按键、鼠标、格式 token 的训练损失,以及八方向鼠标预测准确率。三类损失在前几十小时骤降后进入平缓期,而鼠标方向准确率持续爬升——模型是先学会"怎么操作",再慢慢学会"玩哪个游戏"。
看训练曲线会发现一个清晰的分水岭:前 50 小时左右,所有验证集的损失齐刷刷地跌破基座模型水平,连训练数据里根本没出现的游戏也一样降。作者把这叫"界面阶段"(interface phase)——模型在学和具体游戏无关的东西:动作块的格式、键鼠的操控原语、画面的通用表示。这部分能力天然是跨世界共享的。
50 小时之后进入"世界阶段"(world phase),画风突变:继续加数据,只有和训练分布相关的世界还在受益。S1–S3 这些含 Minecraft 的配比下,1600 小时时 Minecraft 验证损失平均再降 10.4%,MCU 分数跟着涨;但如果配比里没有 Minecraft,堆再多别的游戏也推不动这条曲线。语料内验证损失则是多游戏训练持续下降、纯 Minecraft 训练反而平台化甚至回升。至于 OOD 损失,所有 20 条曲线全都停滞或缓慢上升——虽然还低于基座,但再训也不会有新收获。
一句话总结:CPT 的跨世界红利在前 50 小时就发完了,后面 1550 小时都是在为"见过哪些世界"还债。
核心发现二:三条轴各自的脾气
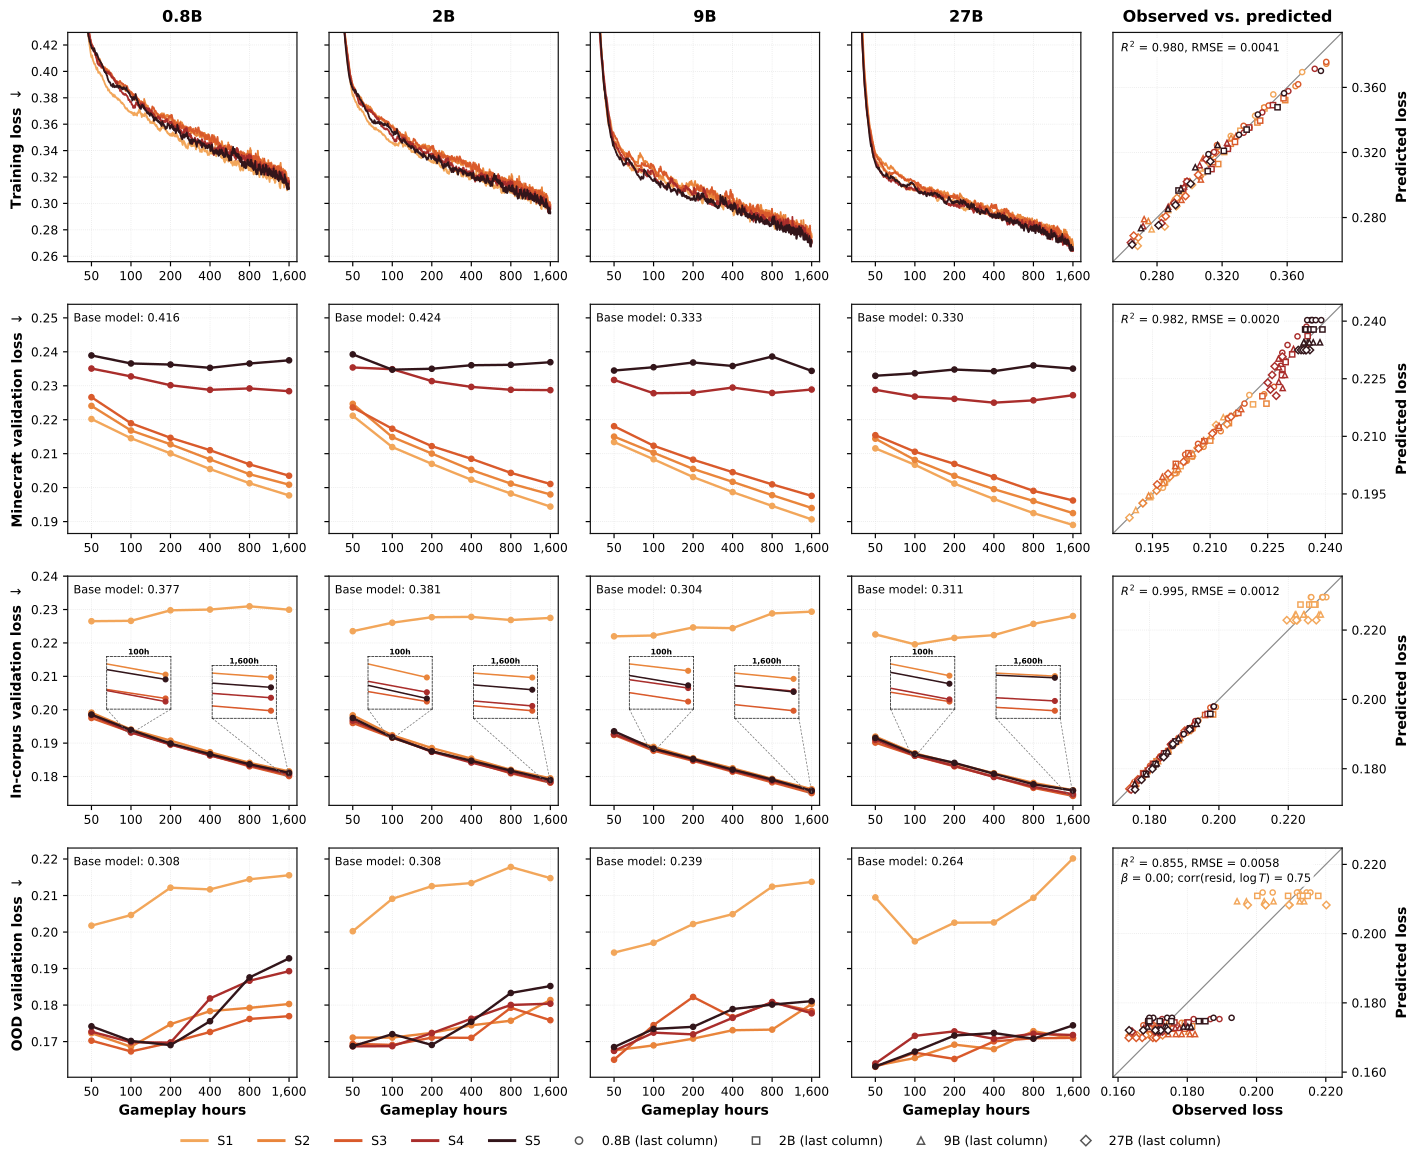
图3:四行分别是训练损失、Minecraft 验证损失、语料内验证损失、OOD 验证损失;前四列是 0.8B 到 27B,颜色是 S1–S5 配比。注意第四行——OOD 损失几乎不随数据量下降,和前三行形成鲜明对比;第五列是 scaling law 的预测值 vs 观测值,拟合得相当紧。
数据量轴:多多益善只在语料内成立。Minecraft 验证损失最优的永远是 S1,语料内损失最优的是 S3/S4——配比要跟着评估目标走。最扎心的是 S1:虽然 Minecraft 内部也有战斗、探索、导航这些多样机制,但这种"游戏内多样性"对其他世界几乎零迁移,S1 的 OOD 损失和 ViZDoom、OGA、GameWorld 分数全是所有配比里最差的。
多样性轴:1600 小时时,S2–S5 的平均 OGA 分数约是 S1 的 2.8 倍,16 个混合配置在同模型规模下全部超过 S1——基础的导航、瞄准能力确实能在 3D 游戏间迁移。甚至一个小模型配多样数据,能打过只玩 Minecraft 的大模型。但到了 GameWorld 这种遥远世界,多游戏训练也只是"减缓退化",没法稳定超过基座。
模型规模轴:大模型数据效率惊人——达到同等性能所需数据量最多可省 32 倍,50 小时的大模型能打过 1600 小时的小模型。但有个陷阱:单游戏训练下,越大的模型跨世界退化越狠。1600 小时时,27B-S1 在三个非 Minecraft benchmark 上全部跑输自己的基座,GameWorld 上掉了约 17 个点。数据效率高是把双刃剑——它同样高效地过拟合到了单一世界上。
核心发现三:三因子 Scaling Law
在 Chinchilla 形式 \(L = E + A/N^\alpha + B/T^\beta\) 的基础上,作者给数据项引入配比 \(\rho\) 来刻画多样性,再加一个在零占比处仍有界的项来捕捉跨配比的迁移:
预测 Minecraft 损失时 \(\rho = r\)(Minecraft 占比),预测语料内损失时 \(\rho = 1 - r\)。这个设计的动机很直接:S5 完全不含 Minecraft,但 Minecraft 验证损失依然远低于基座——零占比处不能让损失爆炸,所以加了 \(\epsilon\) 项兜底。
拟合质量:训练损失 R² 为 0.980,Minecraft 0.982,语料内 0.995,RMSE 分别是 0.0041、0.0020、0.0012。更难得的是外推能力——去掉 27B 模型、去掉 1600 小时档、或去掉 50 小时档重新拟合,对留出块的预测 RMSE 仍在 0.0016 到 0.0027 之间。和各类阉割版定律对比(Table 11),三因子形式全面占优;比如 Minecraft 损失上用两相数据项的 two-phase 变体 R² 能到 0.989,但那是只用 S1–S3 的 72 个条件拟合的,放到全部 120 条件上三因子律仍是赢家。
然后是最值得玩味的结果:OOD 损失不服从任何 scaling law。硬拟合出来 \(\beta \approx 0\),R² 只剩 0.855,而且这 0.855 全是配比间的静态差异贡献的(within-mixture 的 R² 只有 0.079)。也就是说,对遥远世界,CPT 的边际收益在 50 小时就封顶了,之后加数据只是在原地踏步甚至倒退。定律拟合得再好,也只对语料内有效——这一点作者没有回避,我觉得是全文最诚实的地方。
和前沿模型比一比
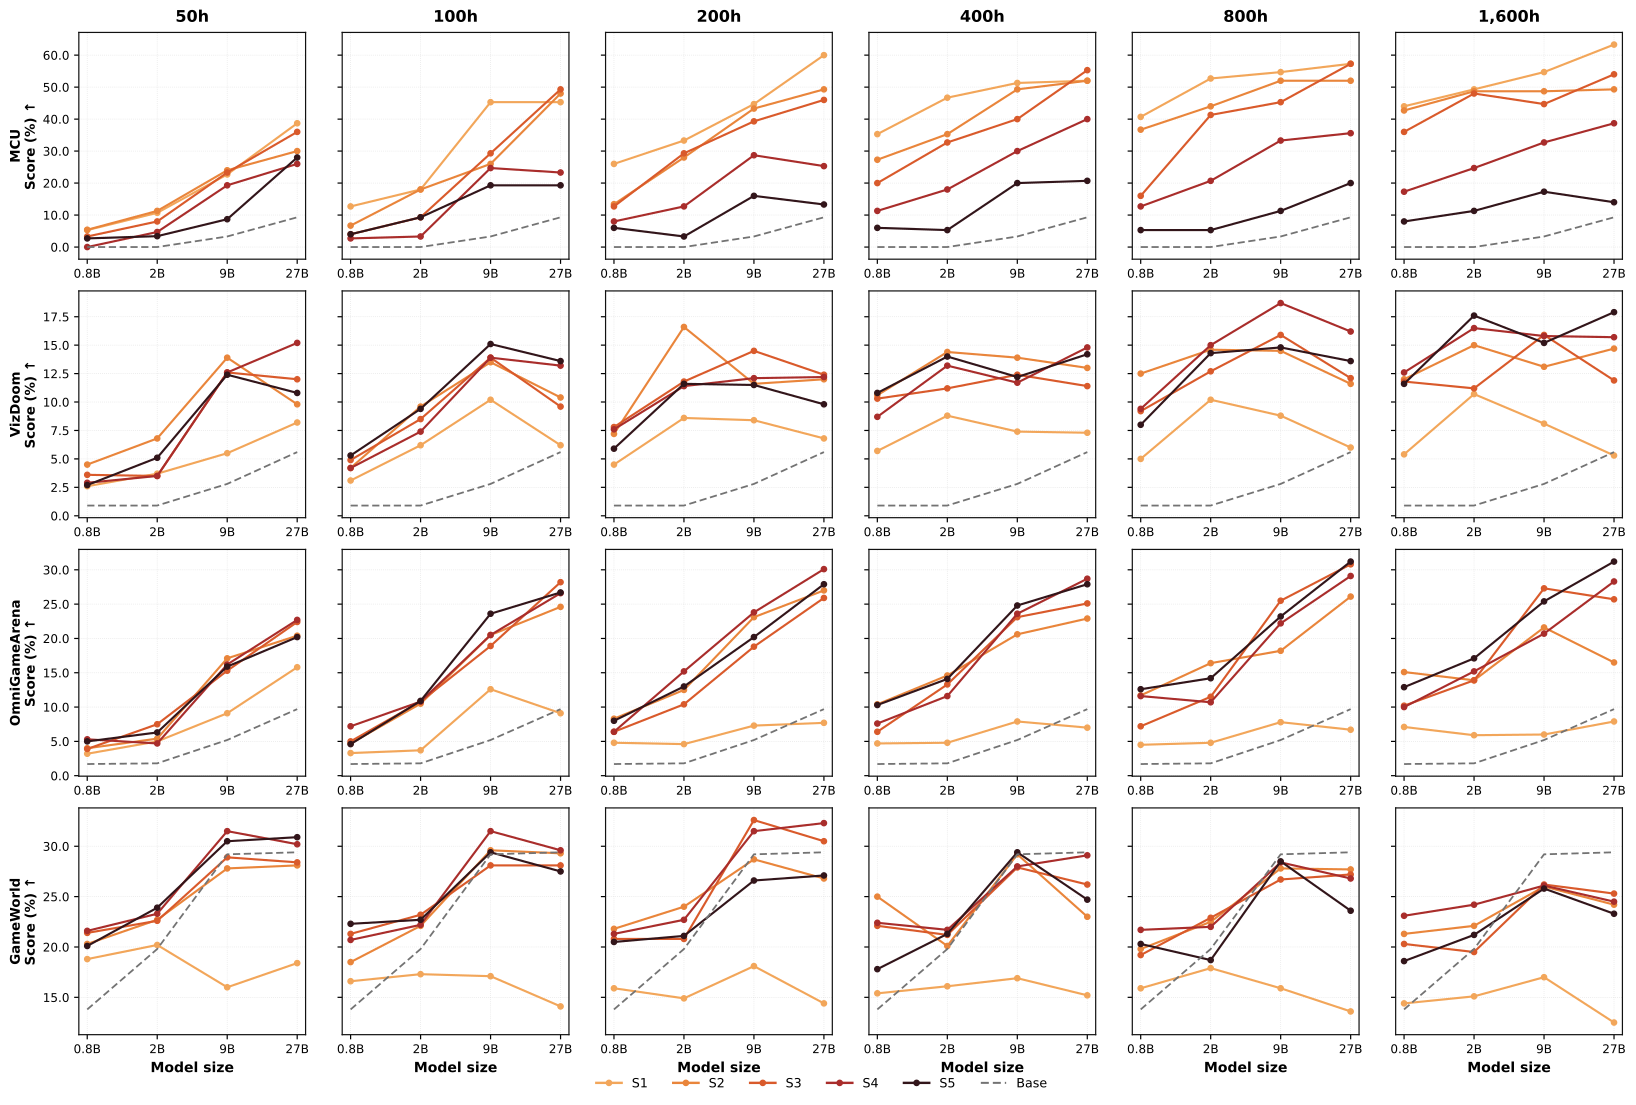
图4:四行是 MCU、ViZDoom、OmniGameArena、GameWorld,六列是 50 到 1600 小时。S1(黄色)在 MCU 上领先但在其他三个 benchmark 上垫底;GameWorld 一行里,几乎所有配比随模型变大反而下滑——虚线的基座参照多次反超训练后的模型。
先看 Minecraft 主场 MCU(30 个综合任务,报告平均步数和成功率 ASR):
| 模型 | 规模 | 平均步数 ↓ | ASR ↑ |
|---|---|---|---|
| VPT | 248M | 390 | 4.8 |
| ROCKET-1 | 72B | 356 | 24.5 |
| MAIN-VLA(最优专用模型) | 7B | 267 | 41.5 |
| GameWAM | 6B | 165 | 50.7 |
| GameScaling-0.8B-S1 | 0.8B | 406 | 44.0 |
| GameScaling-27B-S1 | 27B | 338 | 63.3 |
| NitroGen | 500M | 562 | 1.0 |
| GameTARS-MoE | 20B-active | 249 | 64.5 |
| GameScaling-27B-S3 | 27B | 375 | 54.0 |
三个值得注意的点。第一,生成式 backbone 的能力压过了 Minecraft 专用设计:27B-S1 比最好的专用模型高 13 个点,连 0.8B-S1(44.0)都超过了一票 7B 专用模型。第二,语言基座比数据规模更关键——NitroGen、OpenP2P 这些几万小时纯行为克隆的模型,在指令条件任务上接近零分,而 0.8B-S3 都能完成 36%。第三,任务类型暴露了两阶段动态的痕迹:具身类任务在各尺寸间稳定且领先所有 baseline(界面阶段就学会了粗粒度移动),而 GUI 任务成功率从 0.8B 到 27B 翻了六倍(8.0 → 50.0)——精细光标控制是吃模型容量的。
再看跨 benchmark 的正面交锋(Table 2,数字太多,挑关键的):
- 暂停设定下,CPT 把 27B 基座的 MCU 从 9.3 拉到 54.0(约 6 倍),OGA 从 9.7 拉到 25.7(2.6 倍);9B 和 27B 的 GameScaling 能打平约 300B 的开源模型(GLM-5.3-Flash MCU 47.3)
- GameWorld 上形势逆转:前沿闭源模型得分是 GameScaling 的两倍(Gemini-3.8-Flash 60.7 vs 27B-S3 的 25.3),CPT 只在 0.8B 和 2B 上有正收益
- 实时设定下再逆转一次:前沿模型在 ViZDoom 和 MCU 上分数暴跌约 90%——等你 3 秒想完,游戏世界早就变了;GameScaling 的 0.8B–9B 保住 88% 的暂停成绩,9B-S3 实时均分 25.3,反超最好的前沿模型(19.2)
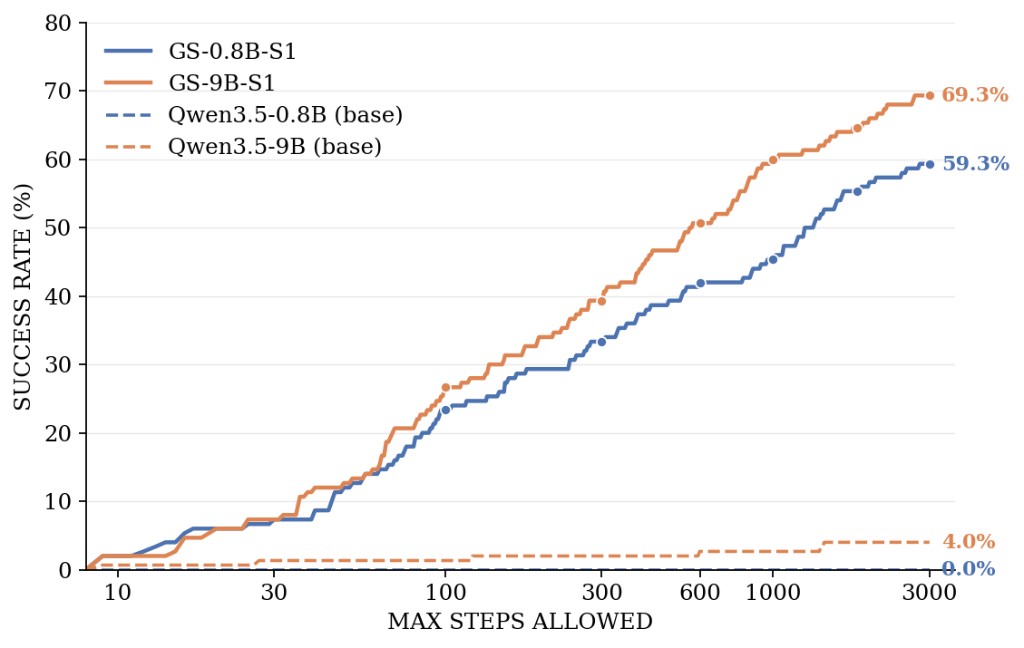
图9:MCU 上允许的最大步数 vs 累积成功率。实线是 GameScaling,虚线是未训练的 Qwen3.5 基座。CPT 模型在任何步数预算下都大幅领先,且 9B 在标准 600 步协议前就已收敛——它不是靠"磨步数"赢的。
实时这个结果要冷静看待。GameScaling 跑在自家 H200 集群的 vLLM 端点上,前沿模型走公网 API——延迟差距里有多少是模型能力、多少是部署基建,其实分不干净。作者自己也承认了这点,呼吁以后的游戏评测要同时报告分数、响应时间和部署环境。这个倡议本身比数字更有价值。
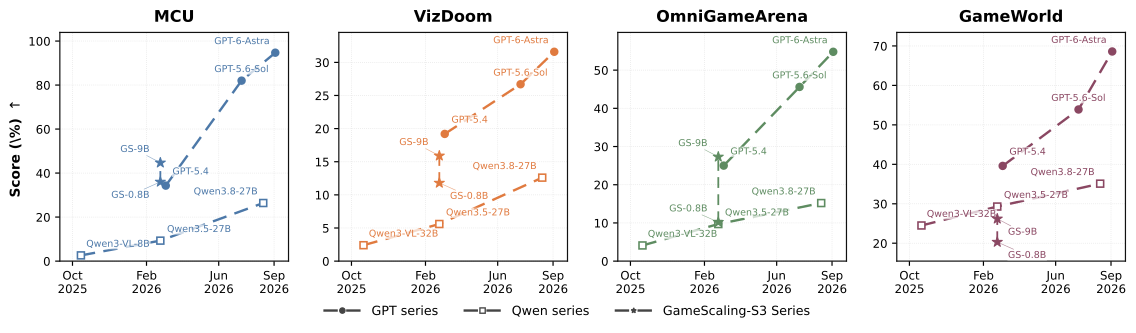
图6:圆圈是 GPT 系列,方块是 Qwen 系列,五角星是 GameScaling-S3。前沿模型沿时间轴快速爬升,GameScaling 在 MCU 和 OGA 上卡进了同期前沿的位置,但在 GameWorld 上被明显甩开——泛化距离依然是分水岭。
我的判断
这篇论文的真正贡献不是某个模型分数,而是它画出的那张"能力边界地图"。
亮点很实在。120 组受控配置、三级泛化评估、外加一个能外推的三因子定律——这在游戏智能体领域是第一次有人把 CPT 从"配方"变成"科学"。两阶段动态(界面阶段/世界阶段)也是个漂亮的概念框架,它解释了一个长期困惑:为什么游戏模型训练前期普涨、后期分化。Table 16 里作者把自己的训练预算和 GUI、机器人领域的 scaling 研究并列,这份诚实在当下挺少见。
但有几个地方要泼冷水。其一,所谓"实时反超前沿模型 5 倍",部署不对称的干扰太大,我更愿意把它读成"小模型低延迟在游戏场景有结构性优势",而不是"我们的模型比 GPT 强"。其二,OOD 泛化的失败被归因为"模仿学习缺乏环境反馈",这个推测合理但没有实验支撑——缺一个对照组(比如加一小段在线 RL)来证明反馈确实是缺失的那块拼图。其三,所有发现都建立在 Qwen3.5 一个家族上,两阶段动态和三因子律换个个 backbone 是否还成立,文章没回答。
对工程的启发倒是很直接。如果你在训练游戏或 GUI 类智能体:预算有限就别贪多样性,让训练配比对齐目标世界;前几十小时的"界面学习"是免费的午餐,但别指望它在遥远世界上继续生利息;大模型配单游戏数据是个明确的大坑,过拟合速度和小模型完全不是一个量级。
至于"通用游戏模型"这个终极目标,这篇论文给出的答案其实挺悲观的:CPT 能把你送到语料内的天花板,但通往遥远世界的路,光靠行为克隆铺不出来。下一步要么扩大世界覆盖的多样性,要么在真实对局中引入在线反馈——墙在哪里已经很清楚了,就看谁先翻过去。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我