不动一个字,直接把 KV cache 删掉——清华这篇论文给 Agent 降本开了条新路
先问一个做 Agent 的朋友都肉疼的问题:你的 Agent 跑一个深度搜索任务,几百轮交互下来,账单大头花在哪?
不是生成。是反复读历史。清华这篇 Cache Engineering(arXiv:2610.28577)给了一组数字:KV cache 的读取占 Agent API 总成本的 82.4%。也就是说,你付的钱里五分之四都花在让模型一遍遍"回头看"那些越来越长的历史上。
更难受的是现有的解法。上下文超长了怎么办?主流做法是 context engineering——把早期历史剪裁掉或者总结成一段摘要。但这会改动轨迹前缀,后面所有已缓存的 KV 状态全部作废,得重新 prefill。而且改得越早,要重算的尾巴越长。所以工程上大家都是拖到快撞上下文墙了才狠心砍一刀,砍完还得祈祷别丢关键信息。重算成本和准确率,两头只能顾一头。
这篇论文的思路让我眼前一亮:既然心疼的是 cache,为什么要在文本层面动刀?直接在 KV cache 层面操作不就行了——文本历史一个字不改,只把选中的 KV 条目从后续注意力里"除名"。
核心摘要:论文提出 cache engineering 新范式,Agent 通过 drop(剔除选中缓存)和 repos(重编码位置)两个原语直接操控自己的 KV cache,不改轨迹、不重算。配套设计的 AKV 服务引擎解决了"相同 token 前缀产生不同缓存状态"的复用难题。结果相当能打:相比传统的阈值触发摘要,平均 benchmark 分数反涨 1.7 个点,成本反降 27.7%;P95 延迟提速 1.51 倍;让 Agent 自己进化缓存策略还能再省 7.1%。这不是又一个近似压缩 trick,而是一套从算法到系统打通的完整方案,代码已开源(thu-nics/AKV)。
论文信息:Cache Engineering for Agents,清华大学 + 香港中文大学,Tianyu Fu、Ruoxi Wang(共同一作)等,通讯作者 Yu Wang,2026 年 10 月 20 日提交,arXiv:2610.28577。
🎯 为什么文本层面的瘦身是个伪命题
把三种方案放在一起对比,差异一目了然:
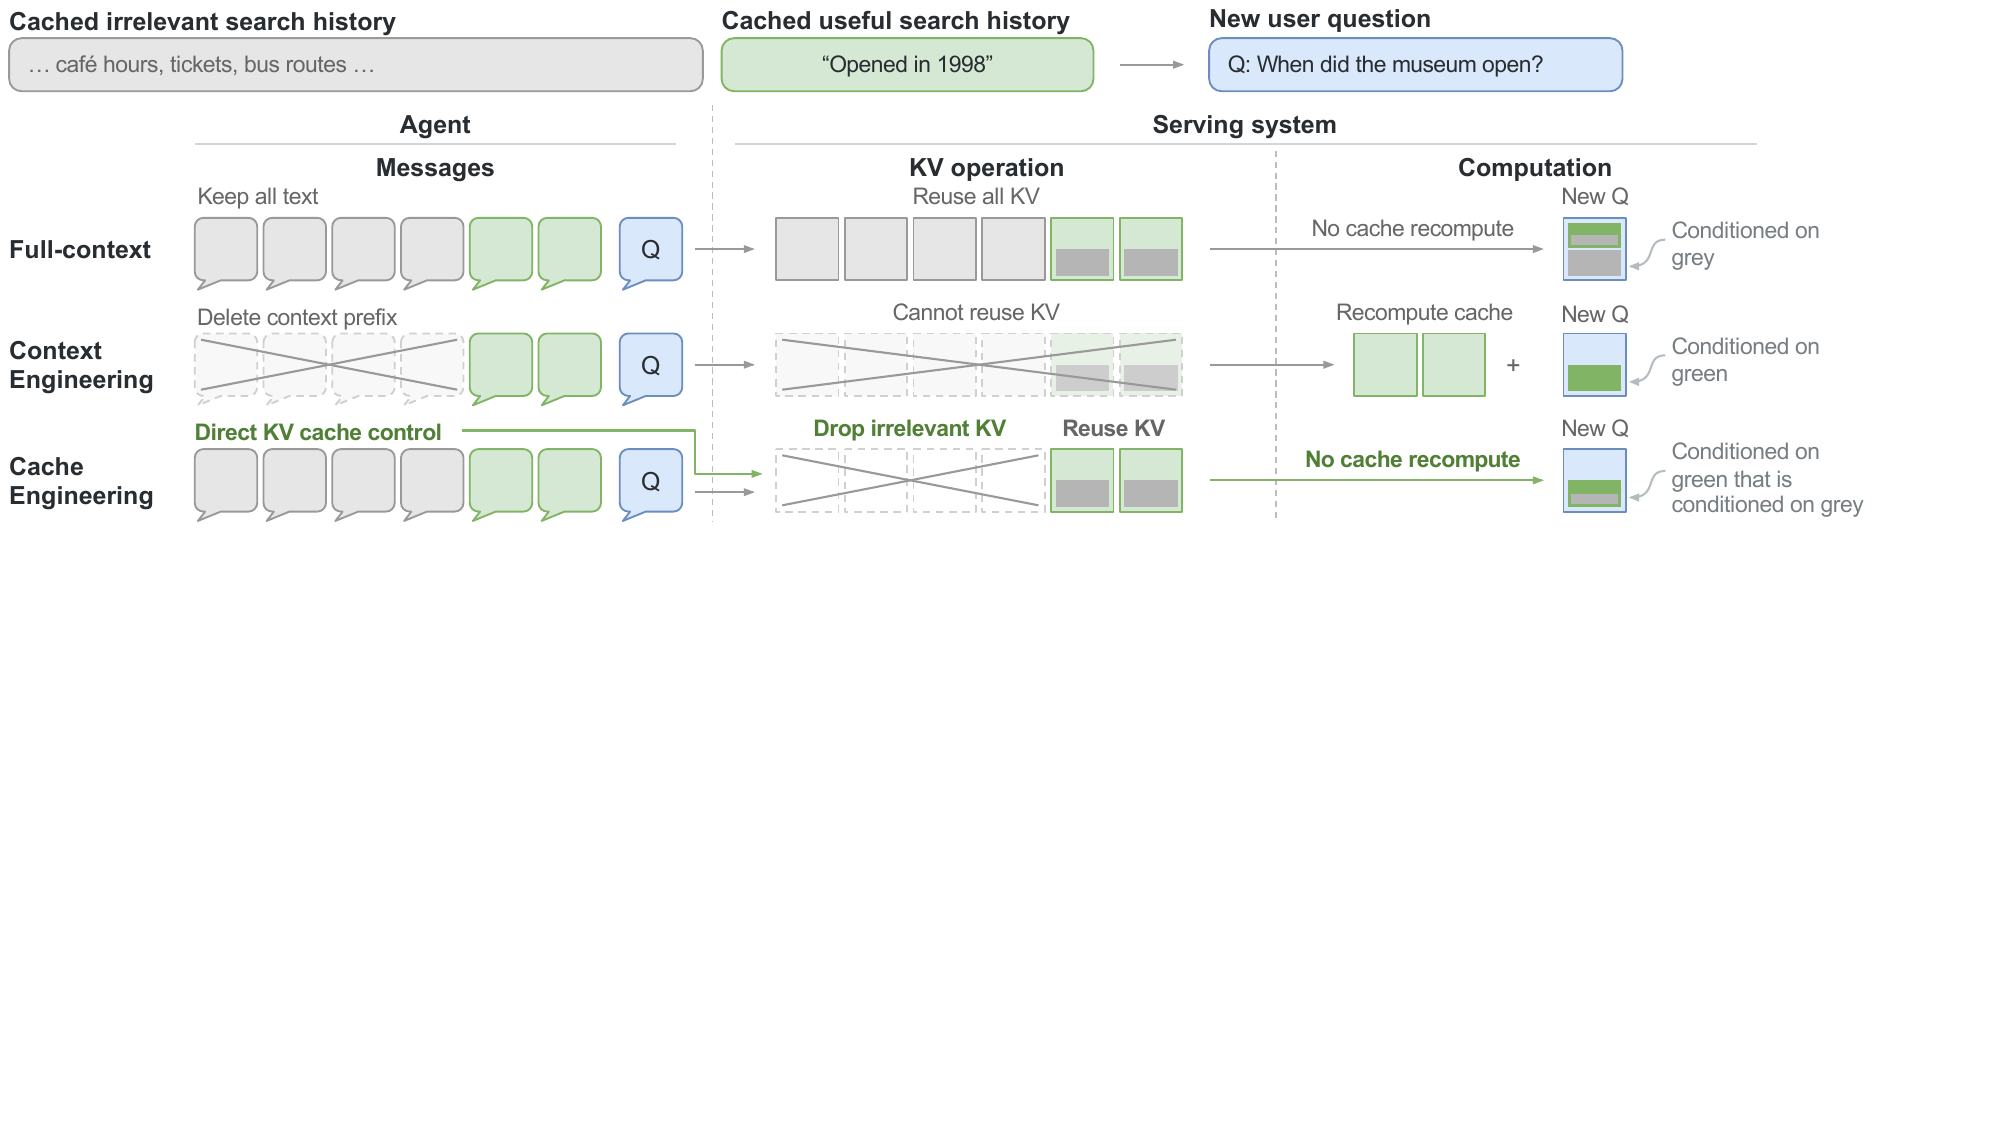
图1:三种范式对比。Full-context 保留全部文本和 KV,不做任何重算但成本爆炸;Context Engineering 删掉无关文本前缀,导致后续 KV 全部失效要重算(注意灰色的"Cannot reuse KV");Cache Engineering 文本原封不动,只 drop 掉无关的 KV 条目,保留的缓存直接复用。嵌套色块表达了一个关键事实:保留的 KV 里其实还"携带着"被 drop 历史的信息,因为当初计算它们时 attend 过那些内容。
这张图里最值得琢磨的是右下角那句 "Conditioned on green that is conditioned on grey"。你 drop 掉的是灰色的无关 KV,但保留下来的绿色 KV 在计算时已经"吸收"过灰色内容的信息。这跟文本剪裁有本质区别——文本删掉就真没了,KV drop 掉之后它的影响还留在后续状态里。这让人想起 StreamingLLM 里 attention sink 的现象,也和一些 KV 驱逐工作的观察一致:缓存条目承载的信息不等于它对应 token 的字面信息。
还有一个实证支撑。作者统计了 BCP 任务上的注意力分布:
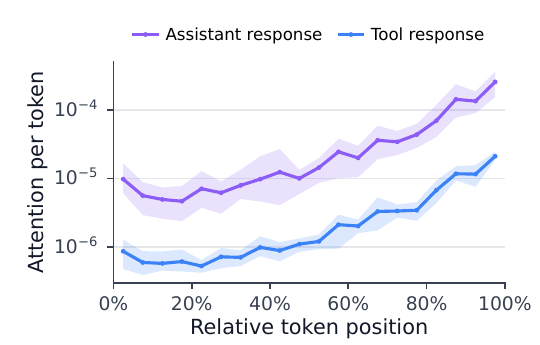
图2:对 10 个 BCP 请求统计的逐 token 注意力。两条曲线都在靠后位置抬升(近因效应),而且在相同相对位置上,tool response 拿到的注意力比 assistant 消息低了近一个数量级(10⁻⁶ vs 10⁻⁵ 量级)。
看到没?工具返回的搜索结果、网页内容这些往往又长又没人看,而模型的推理过程(assistant 消息)才是注意力的焦点。这直接给出了策略方向:滚动 drop 掉老的 tool response cache,保留全部推理过程和最近几轮工具结果。这就是论文的主打策略 tool-response rolling drop(保留最近 12 轮工具响应)。
🧠 三个原语:append、drop、repos
Cache engineering 把 Agent 对缓存的操控形式化为三个操作:
- append:标准推理流程,新 token 进来,KV 追加进缓存,\(\mathcal{C} \leftarrow [\mathcal{C}; C_{t+1}]\)。
- drop(P):把逻辑索引集合 P 对应的 KV 条目从后续注意力中移除,\(\mathcal{C} \leftarrow \mathcal{C} \setminus \{C_i : i \in P\}\)。注意文本轨迹不动、保留条目的位置编码不动、后续 append 的位置计数也不重置。
- repos:把保留的 key 重新紧凑编码到 0 到 r-1 的位置(r 是保留条目数)。对 RoPE 来说这是纯几何操作,不需要重算:
其中 \(R(p)\) 是位置 p 的旋转矩阵。key 转一下角度,value 原封不动,一次矩阵乘法搞定。
repos 解决的问题挺微妙:光 drop 不重排位置的话,位置编码索引还是跟着逻辑轨迹涨,缓存再小也会撞到模型的位置上限导致执行中断。后面消融实验会看到,这个操作贡献了相当大一块准确率。
⚠️ 一个让现有推理引擎崩溃的问题:历史依赖
想法漂亮,但落地有个硬障碍。现在的推理引擎(vLLM、SGLang 这些)做前缀缓存复用,依赖一个铁律:相同的 token 前缀必然产生相同的 KV 状态。
Cache engineering 把这个铁律打破了。
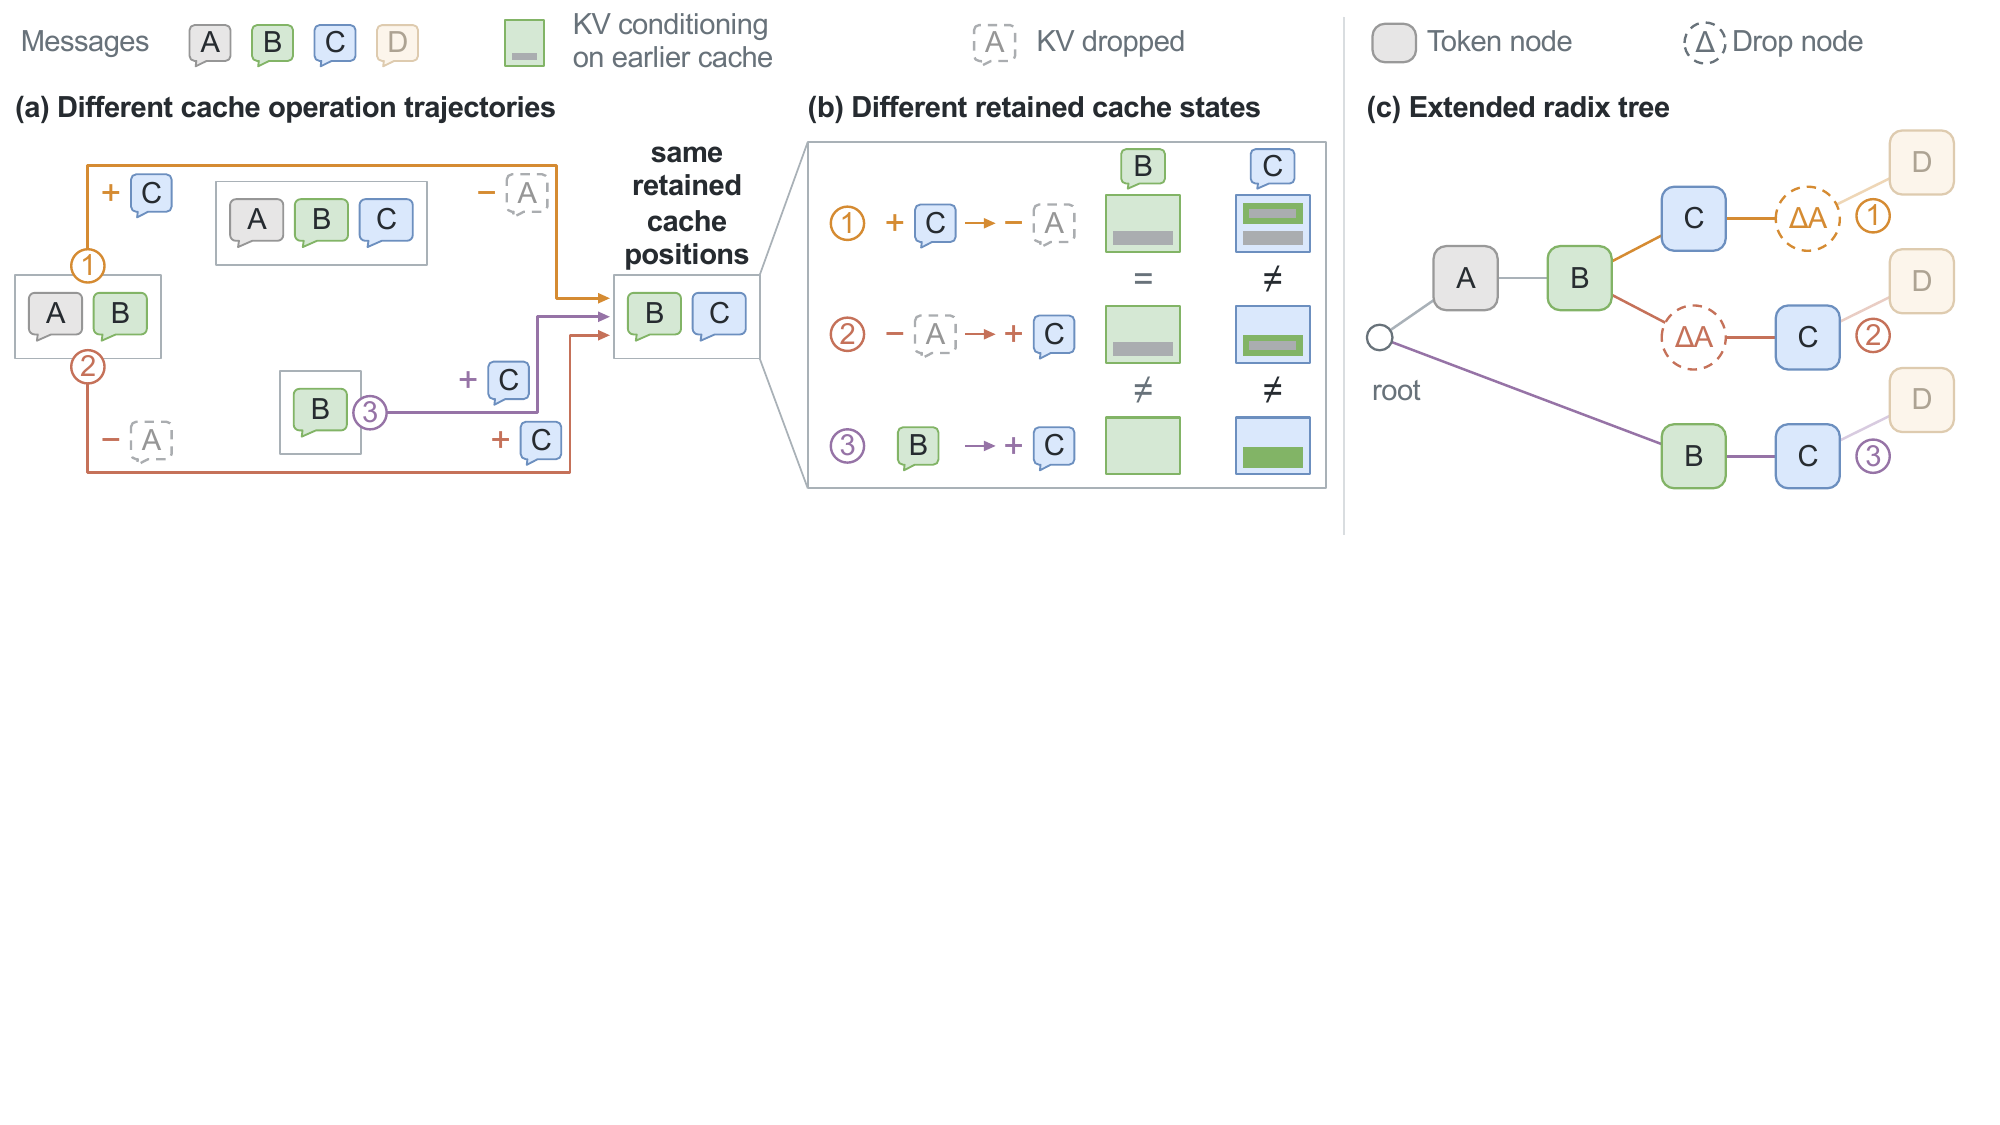
图5:(a) 三条不同的操作轨迹:① 先 append C 再 drop A;② 先 drop A 再 append C;③ 从 B 开始 append C。三条轨迹最终都保留 B 和 C,缓存位置也一样。(b) 但状态完全不同——B 的 KV 在 ①② 中相同(都算过 A),在 ③ 中不同;C 的 KV 三条都不一样。(c) 扩展 radix tree 通过 drop 节点(ΔA)区分这些分支,①② 共享 A-B 前缀但在 drop 时点之后分叉。
你想想看,同样的 token 序列,不同的操作顺序,产出不同的缓存。前缀匹配不够用,你得连"操作历史"一起匹配。这就是为什么论文必须配套做一个新的服务引擎。
🏗️ AKV:无状态接口,有状态服务
AKV 的设计原则一句话概括:stateless interface, stateful serving。
对 Agent 来说,API 跟现在的 OpenAI 风格接口完全兼容——照样提交 messages 数组,只是多了一个可选的 cache 字段,用 "operate-after" 语法声明在第几条消息之后 drop 哪些消息、在哪做 reposition。Agent 不需要知道服务器上哪些 KV 还驻留着,每个请求自己完整描述所需的缓存状态。
麻烦事全在服务器内部,对应三个挑战的解法:
| 挑战 | AKV 的解法 | 干什么用 |
|---|---|---|
| 前缀匹配会错误复用 | 扩展 radix tree,插入 drop 节点 | 同时按 token 历史和操作历史匹配 |
| 一个请求 drop 的缓存别人可能还要 | drop-aware 驱逐 | 优先驱逐已被 drop 的缓存,而非已完成请求的缓存 |
| 普通 prefill 无法复现 drop/repos 后的状态 | segment-batch attention | 单次 prefill 内分段重建,FFN 不重复读权重 |
segment-batch attention 这个设计挺精巧。被驱逐的缓存要恢复时,朴素做法是重放整个操作历史,要跑多轮前向。AKV 的做法是在每层把 query 在 drop 触发点切分,每段因果地 attend 自己的 token 和之前段的活跃缓存——被 drop 的缓存对晚段不可见,但对早段仍然可见(因为它们当初就是用过的)。关键在于只有 attention 分段,FFN 整条序列一次 batch 过,避免重复读 FFN 权重这个大内存开销。
repos 的管理也类似:KV 池里同一逻辑条目可以存在多个位置版本,radix tree 上挂 reposition 节点区分,位置匹配的直接复用,不匹配的就地旋转 key 生成新版本。
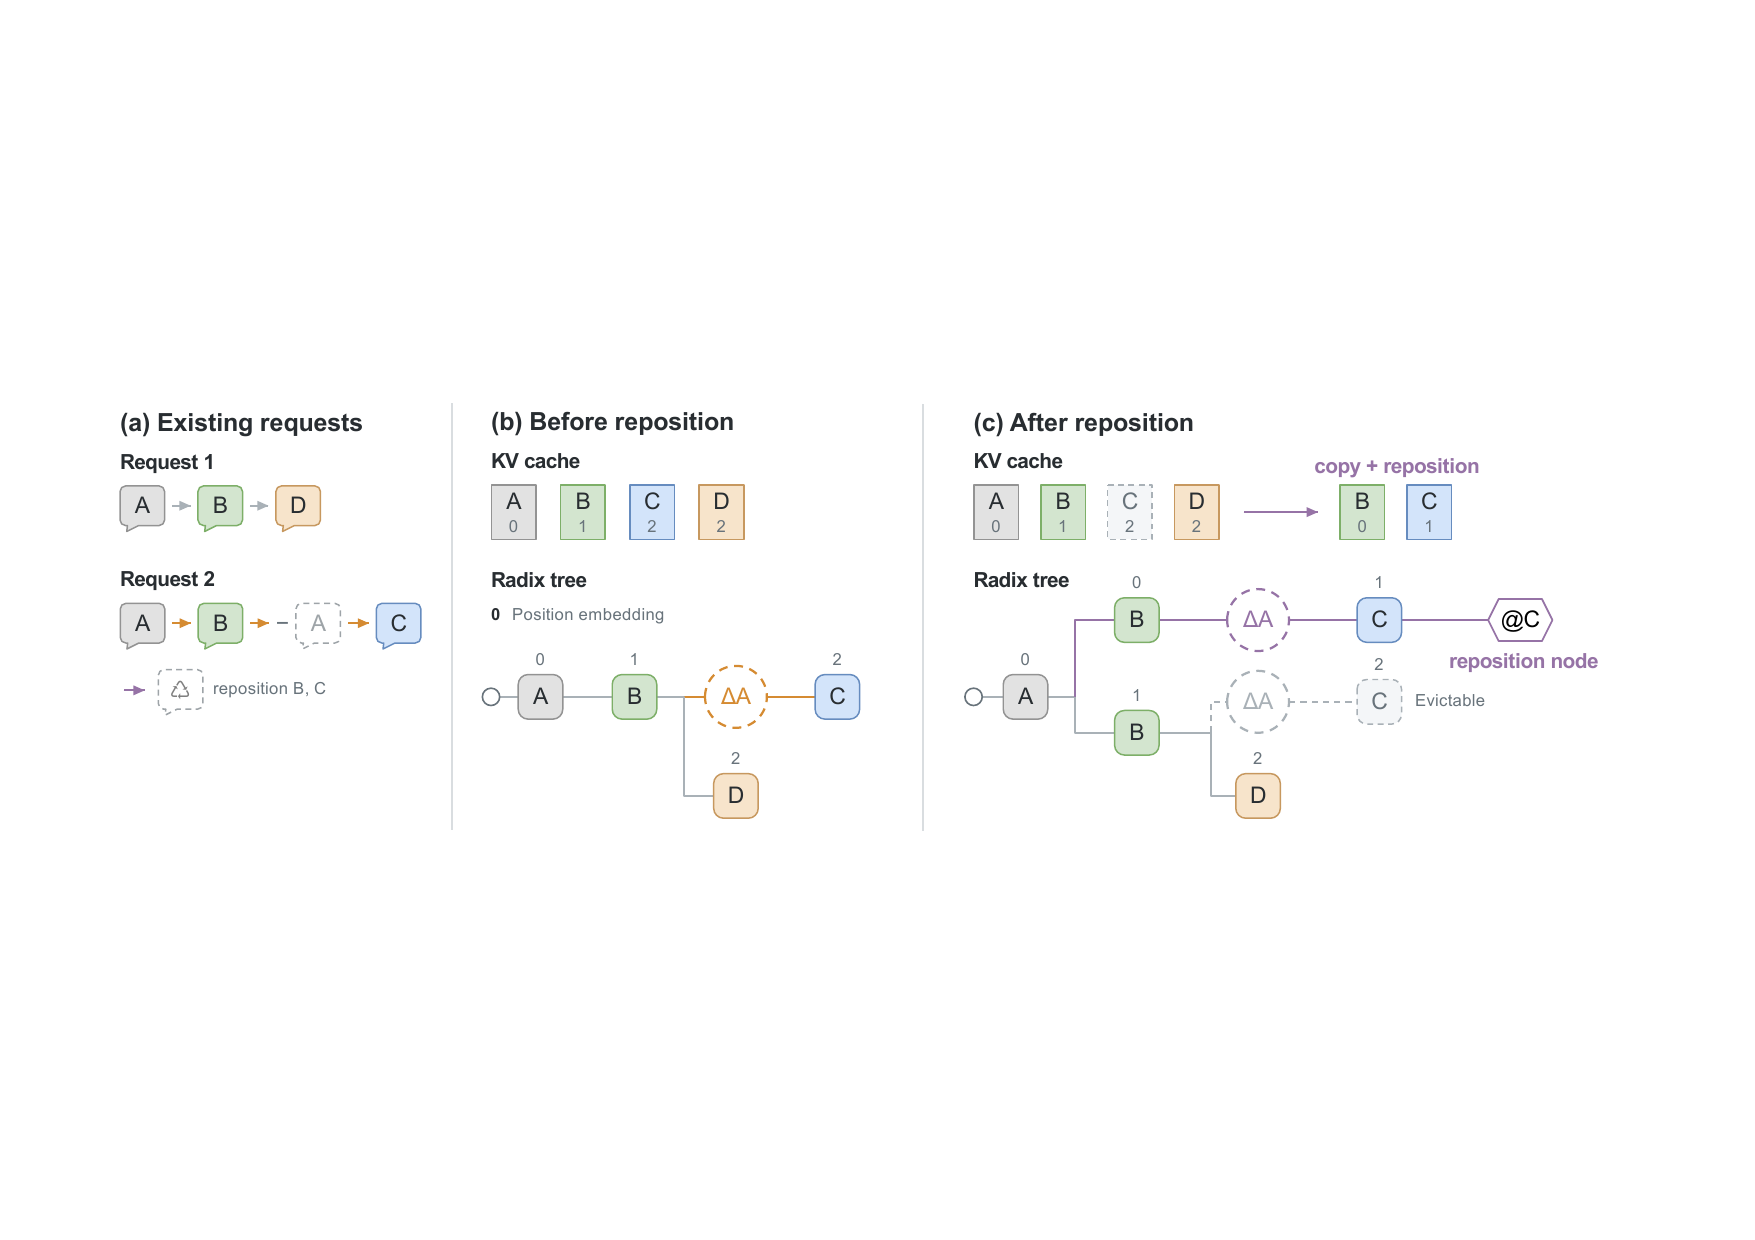
图8:两个请求共享 A、B,Request 2 drop A 后 append C。repos 执行后,B 和 C 的 key 从位置 1、2 复制重编码到位置 0、1;原 B 继续服务 Request 1,原 C 变成可驱逐状态。radix tree 在 B 处分叉区分位置版本,C 后挂 reposition 节点。
📊 实验:分数涨、成本降,两头都占了
主实验覆盖三个模型(MiniMax-M2.7、GPT-OSS-120B、MiroThinker-1.7-Mini)× 四个 benchmark(BCP、GAIA-Text、SWE-Verified、xbench-DS),对比 Standard(高阈值摘要,96K/192K)和 Text Engineering(低阈值 48K 摘要)。摘几个关键数字:
| 模型 | 方法 | BCP 分数 | 平均成本(美分) |
|---|---|---|---|
| GPT-OSS-120B | Standard | 57.5 | 11.2 |
| GPT-OSS-120B | Text Engineering | 52.7 | 10.2 |
| GPT-OSS-120B | AKV | 61.9 | 7.3 |
| MiroThinker-1.7-Mini | Standard | 60.0 | 20.4 |
| MiroThinker-1.7-Mini | Text Engineering | 45.7 | 18.1 |
| MiroThinker-1.7-Mini | AKV | 63.5 | 14.8 |
GPT-OSS-120B 上 AKV 平均成本 7.3 美分,Standard 是 11.2——降了 35%,分数还从 51.0 涨到 53.1。三模型四任务平均下来:分数涨 1.7 个点,成本降 27.7%(对比 Standard)。
为什么分数还能涨?作者按长度切了 BCP 的准确率:48K 以内三家差不多;48K–96K 区间 Text Engineering 垫底(它砍得早);96K 以上 Standard 垫底(轮到它砍了)。每次触发摘要都是一次"信息休克",而 rolling drop 是渐进式的,没有这种断崖。
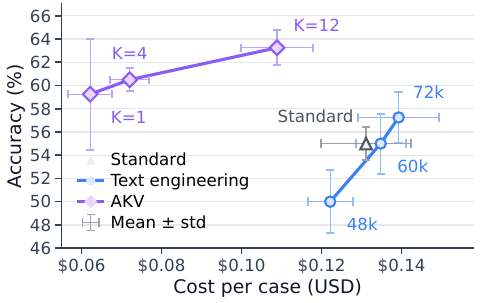
图3:Pareto 前沿图,AKV(紫色,K 表示保留的工具响应轮数)整体压在两个文本工程 baseline(蓝色系,48k/60k/72k 为摘要阈值)的左上方——更便宜且更准。K=12 达到 63% 准确率、约 0.11 美元/任务;Text Engineering 的 48k 阈值掉到 50% 准确率还要 0.12 美元。
服务效率上,SWE-Verified Top-80 的压测(8×A800,prefill/decode 各 4 卡):AKV 在并发 14 时达到峰值,相比 Standard 峰值(并发 12)——平均请求延迟提速 1.36 倍,P95 提速 1.51 倍,输入吞吐量 1.53 倍,输出吞吐量 1.18 倍。高并发下差距拉大,因为 KV 压力一大,Standard 的重 prefill 就把 decode 挤垮了。
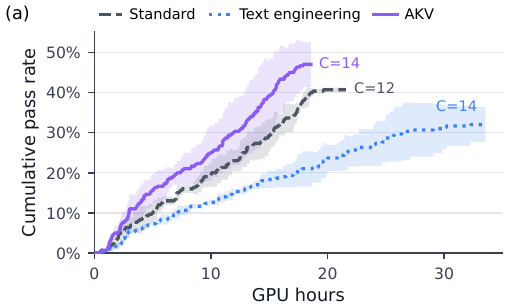
图9(a):真实在线评估。同样烧 GPU 时长,AKV(紫)约 20 小时冲到 47% pass rate,Standard(灰)同时间只有 40%,Text Engineering(蓝)30 多小时才爬到 32%。任务性能和服务效率的收益叠加在一起了。
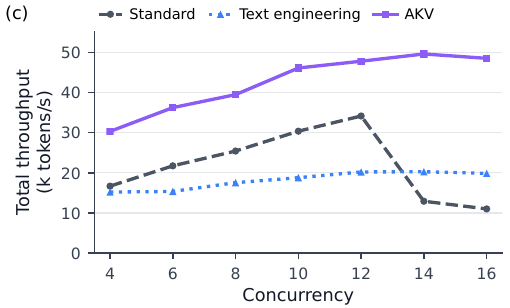
图9(c):吞吐量-并发曲线。Standard 在并发 12 后崩溃式下滑(34k 掉到 11k tokens/s),AKV 一路爬到 49k tokens/s 才见顶。这就是为什么 AKV 能在更高并发下稳定服务。
消融实验里有个值得记住的发现:repos 不是配角。BCP 上只做 tool drop 是 55 分,加上 repos 直接跳到 62 分——没有位置重排,缓存再小也会被位置索引上限卡死,长任务直接执行不下去。另外 drop 推理缓存(不管单独还是和 tool 一起)都比只 drop tool response 差,印证了注意力分布图的观察:推理过程真的不能丢。
🔬 最有想象力的部分:让 Agent 自己进化缓存策略
既然缓存操作是可编程的,那策略本身也可以被搜索。作者用 MiniMax-M2.7 在 20 个 BCP 任务上做递归自我改进(RSI),在 100 个 held-out 任务上评估:
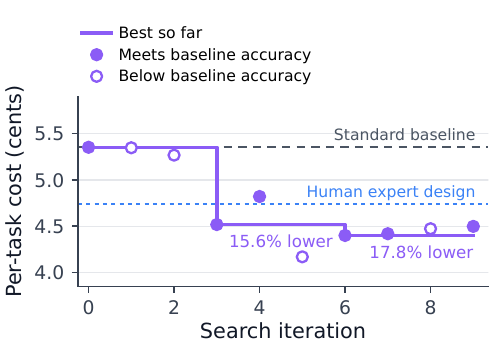
图4:RSI 搜索过程。横轴搜索迭代,纵轴单任务成本。第 3 轮迭代找到的策略比 Standard 低 15.6%,第 6 轮的低 17.8%——比人工专家设计的 rolling-drop(虚线)还便宜,且准确率守住 baseline。整体比专家设计再省 7.1%。
人工设计的策略被 Agent 自己搜出来的策略超过了,而且这是在 held-out 任务上。这个方向我觉得比论文主结果更有深意——缓存管理正在从"系统层的黑盒"变成"Agent 可以学习和优化的技能"。论文还把 cache management 做成工具暴露给 Agent(Cache-As-Tool),让模型自己决定何时砍、留什么,BCP 子集上两个模型都拿到最高分(61.0% / 64.0%)。
🤔 我的判断
这篇论文的价值在于把一个工程直觉变成了完整的形式化 + 系统实现。"Agent 的上下文管理不该在文本层做"这个洞察本身不复杂,但作者把它推到底了:操作语义定义清楚、历史依赖问题点破、服务系统配套落地、策略还能自我进化。每个环节都闭环了。
当然也有要泼冷水的地方。rolling-drop 策略的收益高度依赖"工具响应不重要"这个观察,对工具结果需要反复引用的任务(比如代码仓库级理解)未必适用——论文自己也承认策略探索是 future work。repos 依赖 RoPE 的旋转性质,对 linear attention 或 NoPE 类模型怎么迁移还没答案。还有 history dependence 带来的树分支膨胀,论文没给 radix tree 开销随分支数增长的量化分析,极端发散的操作历史下树管理本身会不会成为瓶颈,这块我没完全看懂,得去翻代码。
但瑕不掩瑜。如果你在做 Agent 产品,被长轨迹的推理成本折磨过,这套思路值得认真试——尤其是 tool-response rolling drop 这个策略,简单到不需要 AKV 也能先在业务里模拟验证效果。往大了说,当 Agent 的"记忆管理"变成一个显式、可编程、可学习的接口,这可能是继 prompt engineering 之后又一个会沉淀下来的工程范式。context engineering 这个词火了一年,cache engineering 可能是下一个。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我