FocusGUI:GUI 智能体的病根不在"看得太多",而在"不会挑着看"
你有没有遇到过这种情况——让一个全模态 GUI 智能体帮你操作手机,第一步还挺像回事,走到第四步第五步就开始"发疯":点错按钮、输错文字、在错误的界面上反复横跳,最后整个任务彻底跑偏,拉都拉不回来。
这不是个别现象。南洋理工大学和阿里巴巴的研究者在这篇论文里把这个毛病起了个名字:Sequential Distraction(序列性分心)。更关键的是,他们发现业界主流的解法——把截图裁剪、缩放、只给模型看"关键区域"——方向上就错了。问题不是给得太多,而是模型不知道这一刻该信谁。
核心摘要:这篇论文(arXiv:2610.26203)提出 FocusGUI,一个挂在冻结全模态大模型上的轻量适配器(仅 1.15M–1.45M 参数)。它的思路很反直觉:不动输入、不裁截图、不微调 backbone,而是在每一步动态地给各个感知通道(屏幕、音频、视频、历史、设备状态)打分排序,把"这一步最该看的证据"压缩成一个 64 维的 latent,以零初始化残差的方式注入到 decoder 生成动作的边界位置。结果相当能打——四个全模态 backbone 上 Type Match 平均提升 33.2 个点,Exact Match 平均翻 3.0 倍,比最强的现有增强方法还高 30.1 个点。更漂亮的是,backbone 走到第四步时 TM 腰斩,FocusGUI 保住了 86.8%。这不是底层模型能力的突破,而是一个"感知组织方式"层面的精巧工程,但它的诊断分析和机制设计都值得细读。
论文信息
- 标题:Focused Omni-Modal GUI Agents
- 作者:Fuyao Zhang, Wenwen He, Jiaming Zhang, Yurong Hao, Xuan Wang, Guowei Guan, Che Wang, Longtao Huang, Wei Yang Bryan Lim
- 机构:Nanyang Technological University、Alibaba Group
- 链接:https://arxiv.org/abs/2610.26203 (2026 年 10 月 19 日提交)
🎯 问题:相关性是"步骤"的属性,不是"画面"的属性
先说说这篇论文最打动我的地方——它没有急着提方法,而是先扎扎实实做了一个诊断实验。
研究者拿 Qwen2.5-Omni 在多步交互任务上跑,每走一步就做一次"模态消融":单独拿掉某一个模态(比如音频),看 ground-truth 动作的 log-likelihood 掉不掉。掉了,说明这个模态有用;涨了,说明这个模态在干扰。
结果挺触目惊心的:
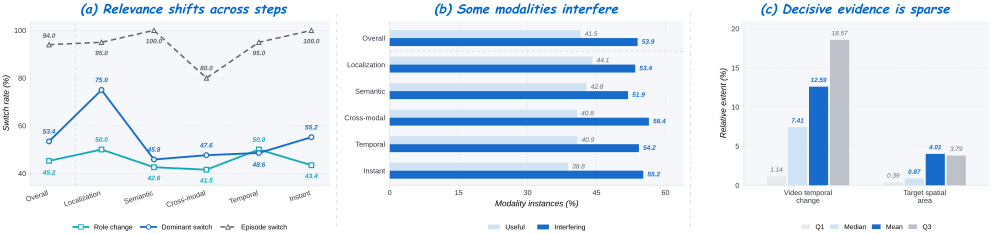
Figure 1:对 Qwen2.5-Omni 做多步交互中的单模态消融。(a) 主导模态在 45.3% 的相邻步骤之间发生切换,94.0% 的 episode 至少经历一次主导模态切换;(b) 90.1% 的步骤里至少存在一个干扰模态(拿掉它反而让预测更准);(c) 决定性证据极其稀疏——目标元素中位数只占屏幕面积的 0.87%,视频内容每步中位数只变化 7.41%。
你品品这三个数字。近一半的步骤之间,"该看哪个模态"这件事就变了;九成步骤里混着干扰信号;真正决定动作的证据,在屏幕上占的面积不到百分之一。
现在的默认范式是什么?每一步把完整的多模态观测——截图、视频流、音频、交互历史、设备状态——一股脑塞给 decoder,让它自己隐式地判断什么重要。等于每一步都逼模型重新"发现"一遍相关性,而且不给任何"这一步和上一步不一样"的提示。
单次看错也就罢了。但 GUI 智能体是闭环的:它执行的动作会改变环境,新的观测和历史又喂回给下一步。这一步的误读会滚进下一步的上下文,误差像雪球一样越滚越大。这就是 Sequential Distraction 的本质——漂移是一步一步产生的,每一步的污染不清掉,就会累积成不可逆的轨迹崩塌。
🚫 为什么"裁截图"这条路走不通
面对"信息太多"的问题,最直觉的反应是做减法。现有的 DRS-GUI、OmniParser、RegionFocus 这些方法都是这个思路:裁剪候选区域、把屏幕解析成结构化元素、放大模型关注的区域。
作者直接点破:这跟流式交互的本质是错配的,错在两处。
第一,决定性信号随时可能来自音频、视频、设备状态——这些通道根本不在空间裁剪的作用范围内。你在屏幕上裁得再精细,引擎声该来还是来不了。
第二,就算信号在屏幕上,被裁掉的"背景"里往往藏着定位坐标和文本参数所必需的上下文。你把画面裁小了,动作类型(TM)可能更容易猜对,但坐标和参数(EM)就瞎了。
实验数据把这个诊断坐实了:三个视觉细化 baseline 在 TM 上平均只动 0.9 个点(近乎中性),却把 EM 相对拉低 28%、GP 相对拉低 35%——12 个 backbone-指标组合里无一幸免。收窄截图让动作原语更显眼(TM 奖励的东西),却扔掉了固定坐标和文本所需的周边上下文(EM 需要的东西)。
这个洞察我觉得是全文最值钱的一句话:问题不在于 decoder 被给了太多,而在于它没有得到"如何排优先级"的指引。正确的聚焦机制应该改变 decoder 读取观测的方式,而不是改变它读到的东西。
🏗️ FocusGUI:不动输入,只给 decoder 递一张"小抄"
基于这个判断,FocusGUI 的形态就被定死了:既然 backbone 本来就能读完整观测、缺的只是"此刻什么重要"的信号,那就把 backbone 和输入都原封不动,把这份信号额外递进去。

Figure 2:FocusGUI 总览。冻结 backbone 的原始通路完整保留(上半部分);同一份观测被拆成可分离的感知通道,对照每步重算的 decision reference 打分排序(左下,Step-Adaptive Prioritization),压缩成紧凑的 focus latent \(z_t\),展开为 \(K=4\) 个零初始化残差 \(R_t\),加在动作边界之前的 embedding 位置上(Residual Alignment),引导自回归 decoder 生成动作,监督信号只来自动作本身。
拆开看是四步:
通道分解(Channel Decomposition)。优先级没法定义在一个融合后的表示里,所以先把观测 \(O_t = \{g, I_t, V_t, A_t, H_t, S_t\}\)(目标、界面、视频、音频、历史、设备状态)暴露成可分离的感知通道 \(X_t = \{x_t^{(m)}\}\),包括各单独模态、backbone 的集成 hidden state、以及一个空间屏幕通道。每个通道经各自的 projector 映射到共享的 128 维空间:\(e_t^{(m)} = P_m(x_t^{(m)})\)。
步自适应排序(Step-Adaptive Prioritization)。通道有没有用,不只取决于它装了什么,还取决于当前的任务状态。所以从完整观测的集成表示里算出一个 decision reference \(q_t = P_q(e_t^{(\mathrm{all})})\),然后给每个通道打分:
其中 \(r_m\) 是可学习的通道身份 embedding,\(\tau = 1.0\) 是 softmax 温度。直觉上讲,\(q_t\) 相当于"当前这一步的决策语境",每个通道跟它算一次兼容性,兼容性高的通道这一步就多说话。注意这个式子里没有任何跨步骤的状态——排序每步从零重算,这正对着 Sequential Distraction 的药方:漂移是一步一步累积的,那就在每一步把污染清掉。
紧凑压缩(Compact Focus)。加权组合 \(c_t = \sum_m \alpha_t^{(m)} e_t^{(m)}\) 再压到 64 维:\(z_t = P_s(c_t)\)。为什么敢压这么狠?因为 \(z_t\) 不需要重建观测——每个像素、坐标、文本都还在原始通路里躺着,decoder 随时能读。它的职责只是"调节读法",不是"携带证据"。这个分工我觉得想得很清楚。
残差对齐(Residual Alignment)。设动作生成开始于位置 \(b_t\),取它前面的 \(K=4\) 个 prompt embedding 位置 \(J_t = \{b_t - K, \dots, b_t-1\}\),把 \(z_t\) 展开成残差加上去:
两个细节很关键。一是 \(W_p\) 和 \(b_p\) 零初始化——训练起点上 \(R_t = 0\),模型就是原始的冻结模型,之后逐渐学出观测条件化的偏移。这跟 LLaMA-Adapter 那套零初始化注意力的思路一脉相承,好处是训练初期不破坏预训练模型的行为。二是加性形式:不替换任何 embedding、不加文本提示、不删任何多模态输入,只是在既有位置上加一个条件信号。
训练方式是全文我最喜欢的部分之一:只用下一步动作的 NLL,没有任何"哪个模态重要"的标注。梯度穿过冻结的 decoder 流到适配器参数 \(\phi\)(通道投影、排序、压缩、残差对齐),一个动作目标同时学会三件事——该强调什么证据、怎么总结它、怎么用 decoder 的原生表示空间表达出来。参数量 1.15M–1.45M(视 backbone 而定),AdamW、lr \(2\times10^{-4}\)、weight decay \(10^{-3}\)、3 个 epoch,greedy 解码。
📊 实验:四个 backbone 全线拉升,越深越能扛
评测在 OmniGUI benchmark 上进行——29 个手机应用、708 个 episode、2572 个动作步,每步配截图 + 同步音频、视频、动作历史。三个指标:Type Match(动作原语对不对)、Exact Match(坐标落在目标框内且文本匹配)、Goal Progress(每个 episode 正确执行步数的比例)。
四个 backbone:Qwen2.5-Omni、VITA-1.5、MiniCPM-o 4.5、Baichuan-Omni-1.5。四个 baseline:DRS-GUI、OmniParser、RegionFocus(都是推理时的视觉细化),以及 GUI-Actor——这个 baseline 值得多说一句,它在冻结 backbone 上学了一个可训练的 action head,跟 FocusGUI 用同样的标注和划分。这是个很关键的控制:如果 FocusGUI 的提升只是"多了可训练参数",GUI-Actor 应该也能吃到;结果吃不到。
主表(Table 1)的 Overall 数字,我把四个 backbone 的 TM/EM/GP 整理如下:
| Backbone | 冻结推理 TM / EM / GP | +GUI-Actor(最强 baseline) | +FocusGUI |
|---|---|---|---|
| Qwen2.5-Omni | 49.61 / 12.60 / 5.50 | 50.20 / 13.78 / 5.54 | 71.65 / 40.16 / 17.49 |
| VITA-1.5 | 13.98 / 9.65 / 6.09 | 14.57 / 11.02 / 5.39 | 58.66 / 26.38 / 6.84 |
| MiniCPM-o 4.5 | 36.02 / 13.58 / 7.55 | 36.61 / 14.17 / 7.64 | 67.72 / 41.54 / 16.76 |
| Baichuan-Omni-1.5 | 24.41 / 8.86 / 4.32 | 31.10 / 11.02 / 5.35 | 58.86 / 25.98 / 8.73 |
平均下来,FocusGUI 比冻结推理高 33.2 TM / 22.3 EM / 6.6 GP,比各 backbone 上最强的 baseline 高 30.1 / 23.6 / 8.0,而且在全部 24 个 backbone×类别格子里同时拿下最好的 TM 和 EM。VITA-1.5 那行尤其夸张——TM 从 13.98 拉到 58.66,四倍多。
分任务类型看,Temporal 类(信号跨帧持续、单张截图最不够用的场景)TM 提升最大,达 37.3 个点;Instant 类(反应当即、证据就在当前屏幕上)提升最小,27.8 个点。这个排序本身就是对方法定位的印证。另一个有意思的现象:四个 backbone 的 overall TM 差距从 35.6 个点收窄到 13.0——观测组织好了之后,"选对动作类型"这件事对 backbone 的依赖明显降低了。
越深越能扛。Figure 3 是对 Sequential Distraction 假说的直接检验:如果这方法真的是在对付"误差累积",那它跟 backbone 的差距应该随轨迹变长而拉大,而不是恒定地强一截。
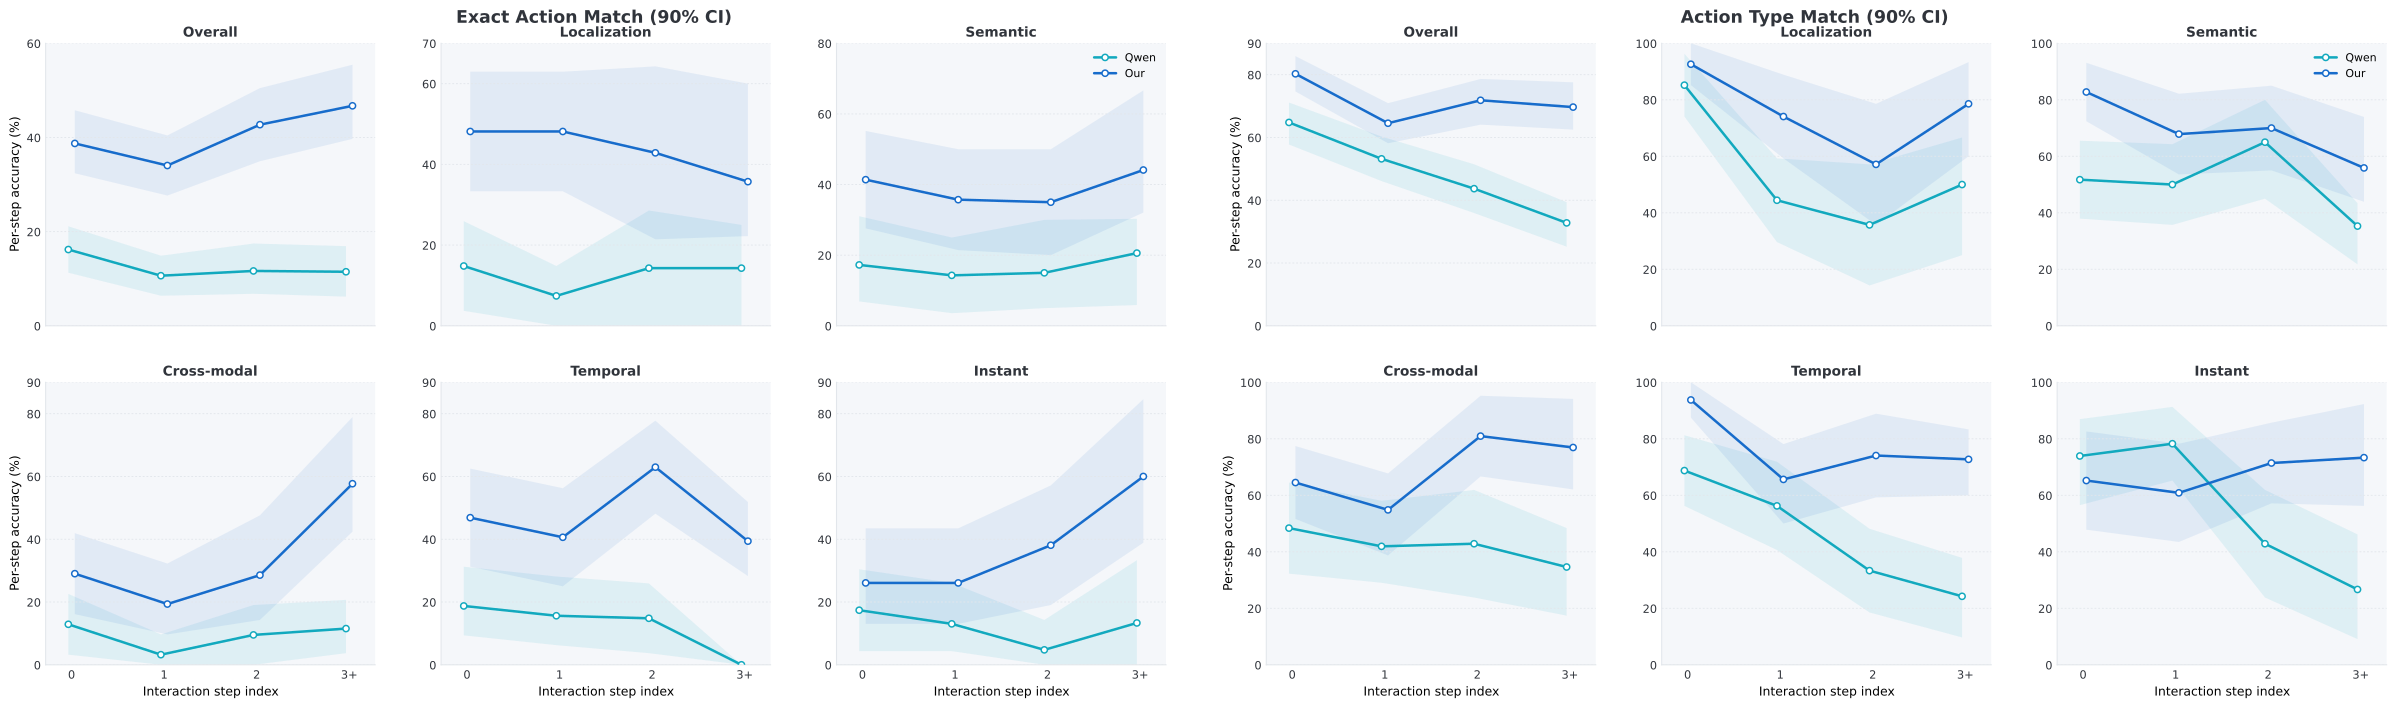
Figure 3:Qwen2.5-Omni 上按步骤在 episode 内的位置分桶的每步 Exact Match(左)与 Type Match(右),3+ 表示第四步及以后,阴影是 90% episode 聚类 bootstrap 区间。青绿色是冻结 backbone,深蓝色是 FocusGUI。
数据很硬:Qwen2.5-Omni 从第一步的 64.79 TM 掉到第三步以后的 32.79,腰斩;FocusGUI 同区间保住 86.8%,而且它的 EM 不降反升(38.73 → 46.72)。EM 增益从第一步的 22.54 个点单调涨到 35.25 个点,所有区间都不含零。Temporal 任务上最极端——backbone 在第三步以后的 EM 是 0.00,FocusGUI 还能拿到 39.39。
作者还做了个漂亮的负对照:Instant 类任务在前两步(还没什么历史可累积的时候),FocusGUI 跟 backbone 统计上分不出差别;等到第 2、3+ 步历史开始累积,增益立刻跳到 28.57 和 46.67 个点。这种"随深度分离"的行为,正是一个针对累积机制的方法该有的样子,而不是一个全方位更强的预测器。
学到的优先级长什么样? Figure 4 给出了一个让我有点意外的答案。

Figure 4:(a) Qwen2.5-Omni 上各通道在各阶段的平均优先级 \(\bar{\alpha}^{(m)}\),均匀分配应为 14.3%;(b) 每格相对该通道全程均值的偏移。
交互状态(Interaction state)在开局拿走 30.9% 的优先级质量——两倍于均匀份额——到收尾阶段掉到 7.7%,从最高优先级变成最低;音频和视频反着走,从 13.4% 和 11.3% 升到 18.8% 和 18.3%。想想看这其实很合理:开局时"我刚做了什么、现在处于什么状态"最重要,收尾时流媒体通道里的信号更关键。
真正耐人寻味的是屏幕通道:全程在 10.9%–12.8% 之间,每个阶段都低于均匀值;空间屏幕通道更是从没超过 9.1%。也就是说,先验工作拼命 refinement 的那两个通道,恰恰从来不是主导通道;而后程发力的流式通道,是那些方法根本够不着的。没有任何固定权重能同时拟合这条曲线的两端——只有随决策变化而重加权输入的表示才行。而且这一切没有任何模态相关性监督,是从动作标注里自己长出来的。
🔬 消融与控制实验:每个组件都主要在给 GP 续命
Table 2 在 Qwen2.5-Omni 上逐个拿掉组件(CD 通道分解、SP 步自适应排序、AP 动作充分投影、RA 残差对齐):
| 移除的组件 | Overall TM 降幅 | Overall GP 降幅 |
|---|---|---|
| 动作充分投影(AP) | 0.51 | 1.38 |
| 残差对齐(RA) | 1.20 | 5.38 |
| 步自适应排序(SP) | 4.27 | 5.93 |
| 通道分解(CD) | 5.39 | 5.29 |
注意这个不对称性:每个组件对 GP 的价值是对 TM 的四到五倍(TM 最多掉 7.5%,GP 最多掉 33.9%)。这说明这些组件的首要作用不是"让单步猜对动作类型",而是"让轨迹不散架"——又是 Sequential Distraction 预言的行为。其中 RA 的消融最说明问题:把加性残差换成直接替换 prompt embedding,TM 只动 1.20 个点,EM 掉 5.30、GP 掉 5.38——保留原始 embedding 这件事,最影响的是把选中的动作落到正确参数上。
还有两个控制实验值得一提。容量敏感性(Table 3):\(K\) 从 1 扫到 16,Overall TM 只在 2.6 个点内波动且无趋势——因为 \(R_t\) 是 \(z_t\) 的确定性函数,窗口加宽只是把同一份压缩表示摊到更多位置,并不放进更多观测。真正的瓶颈在 \(d_z\):\(d_z = 32\) 时 latent 小到装不下动作信息,EM 掉 6.9、GP 掉 6.5;从 64 起就稳了。参数匹配控制(Table 5)更狠:把 decision reference 换成固定拼接布局、参数量对齐到只差 79 个(1,444,913 vs 1,444,992),动态排序仍然 EM 涨 3.54 个点、GP 涨 3.44 个点——增益来自"每步打分"这个机制本身,不是来自参数预算。
附录的配对纠错分析(Figure 10)显示,FocusGUI 纠正了 153 个 backbone 的错判,只引入 13 个回退,净改善最大的是 Temporal 类。

Figure 10:左图是各任务类别中"两个模型都对 / FocusGUI 纠正 / FocusGUI 回退 / 两个都错"的比例;右图是 FocusGUI 相对原始 backbone 的 TM 与 EM 提升(百分点)。纠正在五个类别里 consistently 远多于回退。
🧪 一个屏幕永远给不出答案的案例
Figure 5 的 case study 把这整套逻辑演了一遍。指令是:"听到引擎轰鸣(赛车)就点屏幕暂停视频;听到海浪声(冲浪)就退出视频。"

Figure 5:每一步的屏幕画面看起来几乎一样,决定性证据全在音频里。雷达图显示每步的通道优先级 \(\alpha_t^{(m)}\)。FocusGUI(+Our)一路 Wait,第 4 步引擎声出现时才 TAP 暂停成功;冻结 backbone 被视觉显著性诱导提前行动,之后自己的动作重新进入后续每一步的上下文,再也无法恢复。
屏幕内容每步都差不多,该听什么全写在指令里。FocusGUI 的雷达图显示音频通道在关键步骤被顶到最高优先级,于是耐心等到第 4 步引擎声出现才点击。冻结 backbone 在视觉显著性的诱惑下提前 TAP,之后一路 Wait 错到底——它自己的错误动作回流进上下文,后面每一步都在这个被污染的语境里做决策。这个案例把 Sequential Distraction 的闭环机理演示得明明白白。
💡 我的判断
说实话,看到 TM 涨 33 个点、EM 翻 3 倍的时候,我第一反应是去找实验里有没有坑——比如 FocusGUI 是不是偷偷用了更多训练数据。但看下来控制做得比较干净:GUI-Actor 用同样的标注和划分训练、参数匹配控制只差 79 个参数、零初始化保证起点就是冻结模型。增益的来源被层层剥离,最后落在"步自适应的证据组织"上,这个归因是可信的。
这篇论文真正的贡献,我觉得不是 FocusGUI 这个具体模块,而是那个 framing:区分了 agent 被给的证据和 decoder 读证据的方式这件事。一旦接受这个区分,视觉细化类方法的失败就是注定的——你在"给什么"上做减法,永远解决不了"怎么读"的问题。Figure 4 里屏幕通道全程低于均匀优先级这个发现,对整个 GUI grounding 领域都是一记警钟:大家拼命优化的空间裁剪和屏幕解析,可能从一开始就不是信息瓶颈所在。
当然,问题也有。其一,decision reference \(q_t\) 是从当前观测的集成表示算出来的,也就是说排序只基于"现在能看到什么",没有"接下来可能什么重要"的预判能力——作者自己在 limitations 里也承认了这点。其二,所有实验都在 OmniGUI 这一个 benchmark 上,708 个 episode 的规模不算大,能不能迁移到桌面端 computer-use 这类更野的场景还是问号。其三,这个方法要求 backbone 本身就是全模态的(能吃音频视频流),对纯视觉的 GUI 模型不适用——不过这本来也不是它的目标场景。
工程上的启发很直接:如果你在冻模上挂适配器做 agent 类任务,"零初始化残差 + 动作边界注入"是个值得抄的设计——不动 backbone、不动输入词表、起点即原始模型,训练稳、风险低。更宏观一点说,随着全模态模型把"能接收什么"的边界越推越远,"该怎么组织这些证据"会变成一个独立的、值得认真对待的研究层。这篇论文算是给这一层开了个相当漂亮的头。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我