LiveMACE:收益排名会撒谎,把 5 个顶级大模型扔进真实市场做了一次"过程体检"
你有没有想过一个问题:两个 AI 交易员月底都赚了 5 个点,它们的能力是一样的吗?
直觉上你可能觉得"赚到就是赚到"。但做过实盘或者量化的人都知道,收益这东西水分太大了——行情来了猪都能飞,一个胡乱加杠杆的 agent 和一个严格风控的 agent,在牛市里收益曲线可能几乎重合。问题是,等行情转熊,前者爆仓后者活下来。只看结果的评估,根本分不清这两种 agent。
这篇论文干的事,就是把这件事做成了可测量的科学。作者把 GPT-5.4、DeepSeek-V3.2、Gemini-3.1-Pro、Grok-4.20、Qwen3-Max 这五个顶级模型扔进真实的加密货币和美股市场,实盘(paper trading)跑了整整 30 天,不给它们重置机会,每一步决策的完整轨迹都记录下来。最后的结论让我挺震撼的:收益排名和能力排名之间,存在一条巨大的鸿沟——收益榜第一名可能是工具用得最烂的,规则遵守最好的模型收益反而排第三。
核心摘要
LiveMACEBench 是一个"过程感知"的 agent 评测基准,用持续演化的真实金融市场当测试床。五个前沿 LLM 在统一的 ReAct 脚手架上,分别挂载工具使用、持久记忆、规则遵循、多智能体协作四种机制,跑 30 天不间断的交易轨迹。评测不只看最终收益,而是从完整决策轨迹里提取每种机制的诊断指标。30 天跑下来发现:收益排名随时间剧烈翻转,最多出现 29 次两两反转,而能力排名几乎不动,最少只有 0 次反转;Grok-4.20 在工具配置下收益最高但工具调用分垫底,DeepSeek-V3.2 规则执行很好但完全说不清自己为什么遵守了规则。我的判断:这不是一个刷榜用的 benchmark,而是一台"agent 核磁共振仪"——它的价值在于把"有机制"、"用好机制"、"机制带来收益"这三件之前被混在一起的事情拆开了。做 agent 产品的人值得认真读。
论文信息
- 标题:LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets
- 作者:Jun Zhao、Leiming Fu(共同一作),Yanbo Wen、Yiding Wang、Xuantong Liu、Yang Shu、Yuyang Lu(核心贡献者),Xuanran Xing、Jingqi Tong、Hao Xu、Qi Zhang、Xuanjing Huang
- 机构:新加坡国立大学、复旦大学、悉尼大学
- 发表:2026 年 10 月 7 日提交,arXiv: 2610.09872
- 代码:https://github.com/RaymondVoldemortFu/LiveMACE
🎯 为什么结果导向的评测不够用
现在的 agent benchmark,不管是 SWE-bench 还是 WebArena,基本都是看最终任务成功率。task 做完了就是好 agent,做不完就是不行。这个逻辑在静态任务里勉强说得过去,但放到动态环境里就崩了。
论文里把这个归因问题讲得很透:在演化的环境里,观察到的表现是 agent 行为、环境变化、历史状态三者纠缠在一起的产物。你上个月赚的钱,可能是你这个月持仓的锅;你今天踩的坑,可能是三周前某个决策埋的雷。环境因素自己在动,根本不归 agent 管。
我之前看一些交易 agent 的榜单就有这个疑惑——Alpha Arena 这类实时交易评测,排名每隔几天就大洗牌,到底谁强?说实话看完这篇我才意识到,这个"排名不稳定"本身就是结果导向评测的病灶:收益曲线里混着太多运气成分,它无法归因到任何具体能力上。
作者的思路是:与其纠结收益,不如把真实市场当成一个"持续出题的考官"。市场永远在变,它会不断逼 agent 去搜集信息、复用经验、遵守约束、协调分工——这些行为在轨迹里全部可见。那就别只看月底成绩单了,把每次决策的"草稿纸"都收上来批改。
🏗️ LiveMACEBench 的设计:一个共享考场,四种能力变体
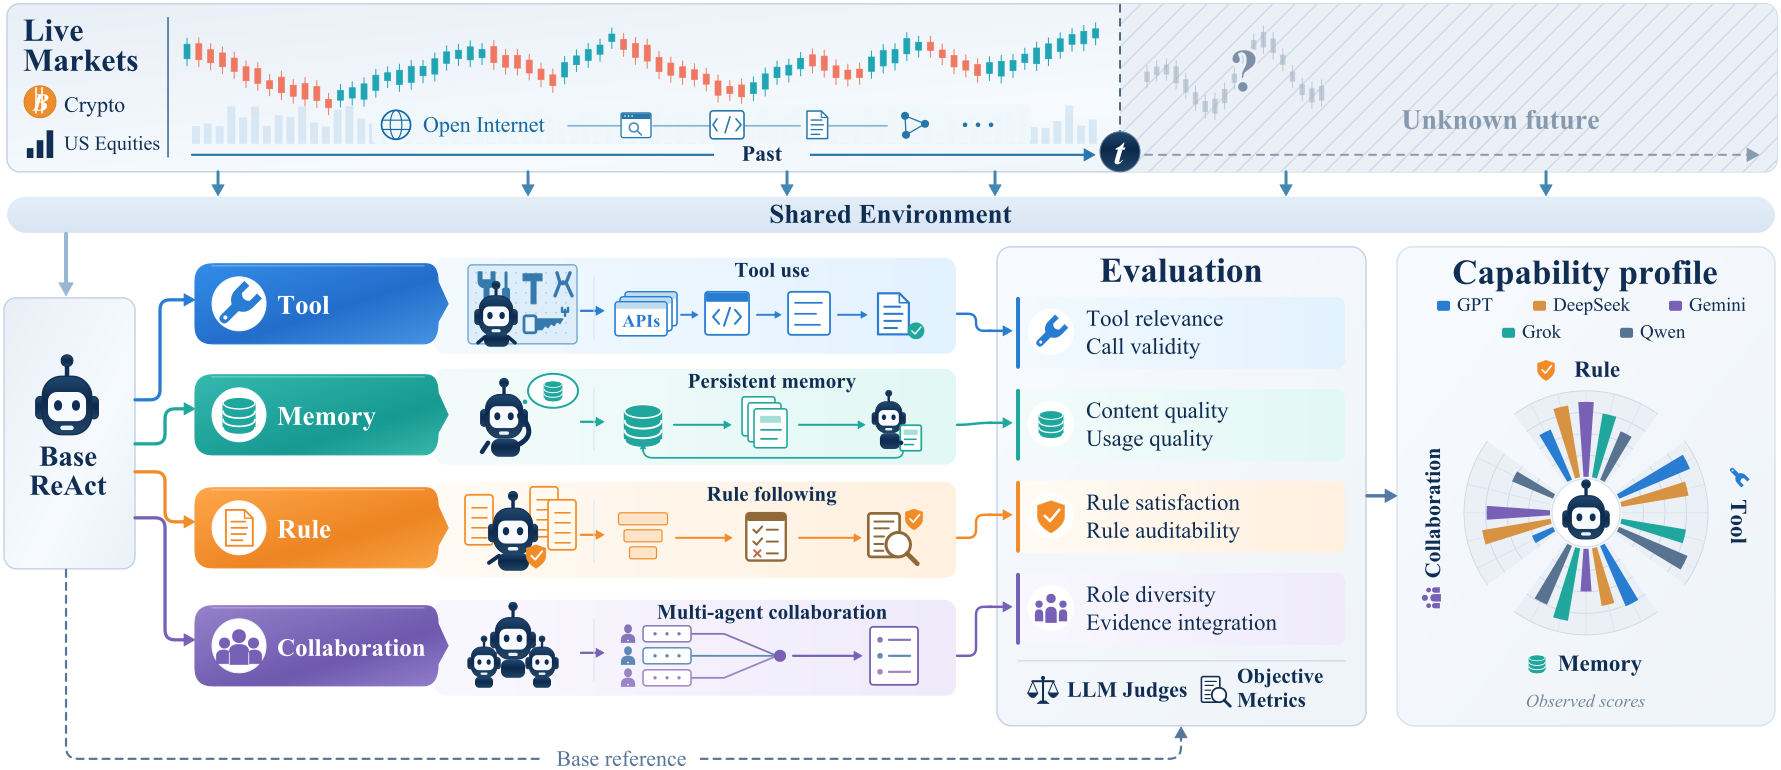
图1:框架总览。上方是持续演化的真实市场(加密货币 + 美股),未来对所有 agent 未知;中间是 Base ReAct 脚手架和四种受控机制变体(工具、记忆、规则、协作);右侧是评测体系——LLM 裁判打分 + 客观指标,最终产出每个模型的能力雷达图。
测试床的设定有几个细节我觉得挺讲究的:
- 真实市场,不是回放。6 个加密货币(Hyperliquid 数据源)+ 17 只美股(Alpaca SIP 数据源),2026 年 4 月 13 日到 5 月 13 日实盘跑。市场演化不受 agent 控制,也没有"任务终点"——账户状态不可重置,仓位会一直滚动下去。
- 每 4 小时一个决策轮。所有 agent 在同一个决策时间网格上跑,保证大家面对的市场条件完全一致。每轮内 agent 可以多次推理、调工具,最后下零到多个交易指令。一轮的完整模型响应、工具调用、工具返回、交易动作,全部记成一条决策轨迹。
- 初始资金 1 万美元,收益用账户净值在更细的时间粒度上结算。
在这个共享考场上,作者搭了五个配置:一个 Base(标准 ReAct + 固定工具集)作参照,然后四个能力变体——
| 配置 | 引入的机制 | 考察什么 |
|---|---|---|
| Tool Use | 动态路由的大型异构工具空间 | 工具发现、调用、证据利用 |
| Persistent Memory | 跨决策轮的持久记忆读写 | 经验构建、检索、应用 |
| Rule Following | R0>R1>R2 的分层交易规则 | 硬约束遵守 + 规则理解可审计性 |
| Multi-Agent | Manager 带专科 agent 的层级协作 | 角色多样性 + 证据整合 |
关键设计在于受控对比:同一模型横向比配置(加机制前后差多少),同一配置纵向比模型(谁把这机制用得好)。配合三类信号——任务结果、机制引入的对照效应、轨迹过程诊断——把"能访问机制"、"有效使用机制"、"机制带来收益"这三个量彻底分开。
这个想法我觉得是真的漂亮。之前太多工作把"给了工具"当成"会用工具",把"接了记忆模块"当成"有长期记忆",这篇论文直接告诉你:这三个是不同的东西,而且可以分别测量。
📊 核心发现:收益排名在翻烧饼,能力排名纹丝不动

图2:(a) 工具配置下,同一批账户的日度累计收益排名(上)与 TCS 能力排名(下)。收益排名 30 天里发生 21 次两两反转,能力排名 0 次反转。(b) 五个模型在四个能力维度上的得分全景——没有任何一个模型全面碾压。
看图 2(a) 的对比太直观了。上半部分的收益排名曲线像一锅粥,模型之间不断交叉换位——四种配置下的两两排名反转次数分别是 21、19、19、29 次。下半部分的能力指标排名呢?几乎四条平线,反转次数只有 0、5、8、2 次。
这就是论文标题里那个 outcome-capability gap 的实锤:收益是闭环交互的最终产物,时间在拉长,运气在累积,排名自然乱窜;而能力指标从决策过程里提取,时间上稳定得多。
更扎心的是图 2(b) 的能力全景表:
| 模型 | 工具 TCS | 记忆 MUQ | 规则 RSS | 协作 OCS |
|---|---|---|---|---|
| GPT-5.4 | 0.894 | 0.762 | 0.634 | 0.265 |
| DeepSeek-V3.2 | 0.789 | 0.680 | 0.847 | 0.806 |
| Gemini-3.1-Pro | — | 0.497 | 0.872 | 0.738 |
| Grok-4.20 | 0.760 | 0.855 | 0.751 | — |
| Qwen3-Max | 0.864 | 0.742 | 0.612 | 0.516 |
四个维度的第一名分属四个不同模型。GPT-5.4 工具最强,Grok-4.20 记忆利用最好,Gemini-3.1-Pro 规则遵守最佳,DeepSeek-V3.2 协作最均衡。没有全能冠军。
而且能力第一和收益第一经常不是同一个人。最极端的例子:Grok-4.20 在工具配置下收益全场最高,但 TCS 垫底(0.760)。赚钱最多,工具用得最糙。你想想看,如果只看收益榜,你会得出完全错误的选型结论。
🔧 分能力解剖:四种机制各有各的死法
工具使用:覆盖率人人及格,效率全员拉胯

图3:左图为 LLM 裁判(Qwen3.5-397B-A17B,每个骨干模型评 170 条轨迹)在四个维度上的打分——工具相关性 TR、调用效率 IE、信息覆盖 IC、证据忠实 EF;右图为客观指标 RQ(路由质量)与 VCR(有效调用率)。HFR 全员满分 1.0 故略去。
有个反直觉的发现:所有模型的信息覆盖率都超过 0.8(0.809–0.911),但调用效率 IE 一致地成为最弱维度(0.581–0.731)。
这说明什么?凑够信息不难,难的是经济地凑够。agent 发现前面工具调用浪费了,大不了再多调几轮补上——冗余交互被最终的信息充分性掩盖了。只看"最后证据够不够",根本看不出过程里浪费了多少轮。
更细的拆解在客观指标上。工具使用其实有两个独立的失败阶段:
- Qwen3-Max:路由质量最低(RQ=0.736,找不到对的工具),但一旦工具到手,调用几乎不出错(VCR=0.978)
- Grok-4.20:反过来,路由不错(RQ=0.805),但执行拉胯(VCR=0.666,三分之一的调用是废的)
- GPT-5.4:唯一两头都强的(RQ=0.920,VCR=0.998)
选对工具和调对工具是两码事。说实话这个发现对做 tool-use 产品的人挺有实操价值的——你的 agent 工具链出问题,先别急着换模型,先分清是检索路由的锅还是参数构造的锅。
持久记忆:搜了 332 次,只存了 1 条
记忆这块的数据是我觉得全文最魔幻的。看这张生命周期表:
| 模型 | 检索次数 | 新增条目 | 库存 | 内容质量 MCQ | 使用质量 MUQ | ΔMDD | ΔTL |
|---|---|---|---|---|---|---|---|
| GPT-5.4 | 332 | 1 | 1 | 0.978 | 0.762 | −0.10 | +0.13 |
| DeepSeek-V3.2 | 712 | 55 | 41 | 0.938 | 0.680 | +2.57 | +0.40 |
| Gemini-3.1-Pro | 319 | 97 | 93 | 0.938 | 0.497 | +0.06 | +0.05 |
| Grok-4.20 | 291 | 12 | 12 | 0.760 | 0.855 | 改善 3.30 | 改善 0.83 |
| Qwen3-Max | 415 | 15 | 11 | 0.878 | 0.742 | +1.51 | +0.38 |
GPT-5.4 干了件什么事呢?332 次检索,30 天只往记忆里写了 1 条。轨迹分析显示它反复在复用同一条宽泛的规则,从来觉得"没啥新经验值得存"。等等,这算什么记忆?这是一个缓存了一次的字典啊。
Gemini-3.1-Pro 则是另一种病:勤勤恳恳存了 93 条,内容质量也高(MCQ=0.938),但使用质量垫底(MUQ=0.497)——建了全市场最大的仓库,然后基本不怎么看。
真正会用的是 Grok-4.20:只存 12 条,内容质量一般,但 MUQ 最高(0.855),下游效果也最猛——最大回撤改善 3.30 个百分点,尾部损失改善 0.83 个点。
存得多、存得好、用得上,是三件独立的事。好消息是,记忆机制在风控上的收益相当一致:五个模型加了记忆后尾部损失全部下降,其中四个最大回撤也改善了。坏消息是,收益效应就参差不齐了——Qwen 加了记忆反而亏得更多(全程 −6.50 vs 后期 −4.85 个百分点的差距)。
规则遵循:做得对,但说不清自己为什么对
规则配置的设定是一个 R0>R1>R2 的分层交易政策:R0、R1 是硬约束(比如单资产集中度上限),R2 是软偏好。agent 不仅要遵守,还得显式声明"我检查了哪些规则、怎么判断的、冲突怎么解决的"。
于是评测拆成两半:程序化的检查器看执行(硬规则通过率 HPR、规则满意度 RSS),LLM 审计员看推理(规则覆盖 RC、冲突处理 CH,合成可审计性 RAS)。

图4:(a) RSS-RAS 散点图,气泡大小为 1−HPR,颜色深浅为最终收益。右上角 Gemini-3.1-Pro 两全其美;DeepSeek-V3.2 偏科明显——RSS 0.847 很高,RAS 0.623 却很低。(b) LLM 审计员的细分诊断,Gemini 的规则覆盖和冲突处理都是 8.8 分,Qwen3-Max 双双垫底。
结果表里藏着一个特别能说明问题的对照:
| 模型 | 最终收益 | MDD | HPR | RSS | RAS |
|---|---|---|---|---|---|
| GPT-5.4 | +5.738% | 5.169% | 0.682 | 0.634 | 0.677 |
| DeepSeek-V3.2 | 涨 5.765 个点 | 4.270 个百分点 | 0.877 | 0.847 | 0.623 |
| Gemini-3.1-Pro | +3.503% | 4.927% | 0.888 | 0.872 | 0.882 |
| Grok-4.20 | +3.085% | 5.165% | 0.834 | 0.751 | 0.775 |
| Qwen3-Max | +4.418% | 5.674% | 0.613 | 0.612 | 0.511 |
DeepSeek-V3.2 和 GPT-5.4 的收益几乎一模一样(+5.765% 对 +5.738%,差 0.027 个点),但硬规则通过率差了快 20 个点(0.877 对 0.682)。光看收益,你会以为这俩一样稳;实际上一个守规矩一个不守。
反方向的对照是 Gemini-3.1-Pro:收益排第三(+3.503%),但 HPR、RSS、RAS 三项全是第一。它是唯一"既做对了又说得清"的。
DeepSeek 的病最隐蔽:很多决策机械地合规了,但轨迹里几乎没有显式的规则检查、数值证据和冲突推理,甚至有些决策基于错误的持仓状态。说得直白点——它是蒙对的。执行层面的高频翻车点是 R1-02 单资产集中度限制,尤其 GPT-5.4 和 Qwen3-Max:不是故意无视规则,而是算不清"现有敞口 + 增量订单 + 价格变动"叠加后的交易后敞口。这个失败模式太工程了,做合规 agent 的同行应该直接抄进自己的 checklist。
多智能体协作:收益涨了,回撤也涨了
多智能体配置是一个 manager 带着一群专科 agent 的层级结构。配对比较(同模型 ReAct vs Multi-Agent)的结果:
| 模型 | Δ收益 | Δ暴涨次数 | Δ最大回撤 | Δ尾部损失 |
|---|---|---|---|---|
| GPT-5.4 | +2.45 | +3 | +0.93 | +0.38 |
| DeepSeek-V3.2 | +3.72 | +2 | +0.25 | +0.26 |
| Gemini-3.1-Pro | +2.57 | +2 | +0.49 | +0.26 |
| Qwen3-Max | −4.39 | +6 | +2.85 | +0.26 |
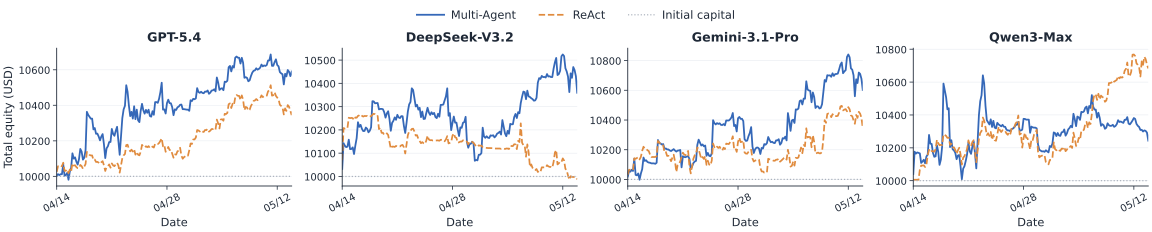
图5:四个模型的净值轨迹,蓝实线为多智能体,橙虚线为单智能体 ReAct,灰点线为初始资金 1 万美元。前三个模型多智能体全程领先,Qwen3-Max 则被反超。
前三个模型收益涨了 2.45 到 3.72 个百分点,但注意右边两列:所有模型的最大回撤和尾部损失都在恶化。多智能体不是免费的午餐,它换来的是更猛的收益-波动 profile。Qwen3-Max 是最惨的案例:多抓了 6 次暴涨,但回撤恶化 2.85 个点,最终收益反而掉了 4.39 个点。
那协作过程本身呢?看角色多样性和证据整合:
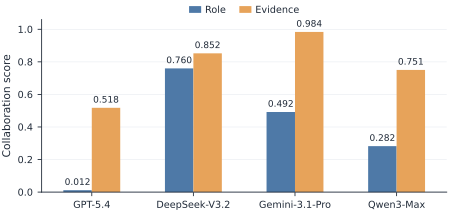
图6:四个模型的 Role(角色多样性 RD)与 Evidence(证据整合 EI)得分。DeepSeek-V3.2 最均衡(0.760/0.852);Gemini 偏证据(EI 0.984 全场最高);GPT-5.4 的 RD 只有 0.012,几乎塌缩成单角色工作流。
GPT-5.4 这个数据让我愣了一下:RD=0.012,挂着多智能体的架构,实际跑成了单角色流程。但它的收益还涨了 2.45 个点。所以收益提升和可观测协作之间根本没有单调关系——GPT 证明了"几乎不协作也能多赚钱",Qwen 证明了"有证据整合也能亏钱"。同一个 harness,四种模型跑出四种完全不同的协作模式。系统里有多个 agent,绝不等于发生了实质协作,这句话值得刻在每个 multi-agent 架构师的显示器上。
🤔 我的判断
这篇论文最值钱的地方,是把 agent 评测的认识论问题变成了工程问题。"能力 ≠ 结果"这个道理大家都懂,但 LiveMACEBench 给出了一套可操作的拆解方案:受控配置做归因,完整轨迹做诊断,真实市场做压力源。
几个我认为真正站得住的贡献:
第一,收益排名的不稳定性被量化了。21–29 次反转 vs 0–8 次反转,这组对比数字以后大概率会被反复引用。它直接挑战了所有用收益率给交易 agent 排座次的榜单。
第二,每个能力维度都挖出了具体的、可复现的失败模式。工具的效率-覆盖脱钩、记忆的构建-使用脱节、规则的执行-审计背离、协作的形式-实质分离——这四个"脱"字是论文的骨架,而且每个都有轨迹级的证据支撑。
但我也有几个保留意见。说实话,30 天的窗口还是短了点,而且只有一个时间段(2026 年 4–5 月)的市场行情——如果这 30 天恰好是单边市,很多结论的泛化性要打折。论文自己也承认这点,把"更长周期、更多市场 regime"列为 future work。另一个担忧是,LLM-as-a-judge 的维度(MCQ、MUQ、RC、CH)说到底是用一个模型评另一个模型,虽然附录里做了跨裁判一致性验证,但 judge 自己的偏见并没有被完全排除。4 小时一轮的决策频率对"高频"场景的代表性有限,这套诊断框架搬到分钟级交易上结论是否还成立,我持保留态度。
还有一个我心里没完全放下的问题:过程指标和长期真实表现之间的因果链,论文展示的是相关性证据。Grok 的 MUQ 高、回撤改善也大,但样本是 5 个模型 × 30 天,统计功效有限。这个方向需要更多模型和更长窗口来夯实。
收尾
如果你在做 agent 产品,这篇论文的实操启发很直接:别再只盯最终指标做选型和迭代了。给你的 agent 加上轨迹级的过程埋点——工具调用有效率吗?记忆存了有人用吗?规则是蒙对的还是真懂的?多智能体是真协作还是独角戏?这四个问题,每个都可能藏着你不知道的坑。
对评测圈来说,LiveMACEBench 代表了一个我觉得会扩散的趋势:从"排行榜环境"转向"诊断环境"。排行榜告诉你谁赢了,诊断环境告诉你为什么赢、能不能一直赢。在 agent 越来越深度介入真实世界决策的时代,后者的价值只会越来越大。
毕竟,靠运气赚来的钱,迟早靠实力亏回去。评测也一样。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我