Hy-Memory-30B-A3B:把"记笔记"这件事,从 prompt 工程变成可训练的决策问题
你有没有发现一件挺别扭的事:这两年 Agent 长期记忆系统卷得厉害,Mem0、MemOS、A-MEM、MemoryOS 一个比一个花哨,检索、分层、生命周期管理全都安排上了——但真到"写"这一步,绝大多数框架的做法还是在后面挂一个通用大模型,塞一段巨长的框架专属 prompt,让它看着办。
写得好不好,全看运气。框架救不回 writer 漏掉的信息,再强的 reader 也没法推理出一条从来没被存进去的事实。反过来,什么都往里存,成本和检索干扰又压不住。
这篇来自 Tencent Hunyuan 的论文(arXiv:2610.22196)就是冲着这个环节来的:把记忆写入(memory writing)当成一个可训练的、长周期的决策问题,用强化学习去训一个专门干这件事的小模型。
核心摘要
一句话版本:作者训了一个 30B-A3B 的 MoE 记忆写入器(激活参数约 3B),先在 Mem0、MemOS、Hy-Memory 三套真实框架里做 On-Policy 蒸馏学会"按协议办事",再用一套归因式 RL(dense per-chunk probes + 跨 chunk 归因奖励 + 防过存储惩罚 + chunk 级 GRPO)优化"写出来的记忆库能不能支撑下游问答"。结果:四个 harness(含完全没见过训练的 EverMemOS)全部第一,macro average 55.49 分对 Claude Opus 5 的 54.62 分。
我的定位判断:这不是底层算法突破,而是一套非常扎实的"奖励工程 + 信用分配"系统设计。它最值钱的地方不是某个公式,而是把"记忆写入的 RL 为什么难"拆得清清楚楚,然后每一刀都砍在对应的痛点上。做 Agent 记忆或长周期 RL 的人值得细读;只想要个现成记忆组件的,直接去 Hugging Face 拉权重就行。
论文信息
- 标题:Hy-Memory-30B-A3B: Attributed Reinforcement Learning for Long-Term Memory Writing
- 作者:Tianxiang Fei, Jiazheng Kang, Mao Zheng, Xingyan He, Xiang Yu
- 机构:Tencent Hunyuan
- 提交日期:2026-10-15(cs.CL)
- 链接:https://arxiv.org/abs/2610.22196
- 代码与模型:https://github.com/Tencent-Hunyuan/Hy-Memory ,https://huggingface.co/tencent/Hy-Memory-30B-A3B
为什么记忆写入值得单独训
先把长期记忆系统的pipeline摊开看,它其实有三段:writer 把交互转成持久化记忆操作,retriever 按需检索,reader 拿着检索结果回答问题。过去大家的注意力都在后两段,第一段基本靠 prompt 硬撑。
但 writer 要干的活远比"摘要"复杂:它要分清什么是该长期保存的用户信息、什么是寒暄和临时文本;要保住精确的名字、数字、版本、日期、路径;要表达状态转移而不丢掉被替换的旧状态;要把新证据和库里已有的记忆对齐;最后还得按框架的 schema 吐出合法操作。
之前已经有人用 RL 训记忆行为了——Memory-R1 用最终答案奖励训 memory manager 和 answer agent,MemAgent 学递归压缩,Mem-α 把 QA 正确性和格式、压缩奖励混在一起,MemCoE 用 guideline 对齐的过程反馈。这些工作证明了记忆行为是可学的,但也留下一个共同问题:一个最终答案分数,监督的是一长串异质的写操作,而真正提供证据(或者闯祸)的只有其中几步。
说实话,这个问题在 LLM RL 里是通用的。标准 GRPO 对整条轨迹给一个标量分,组内归一化后把同一个 advantage 拍在每个 token 上。做数学题这样没问题,因为 completion 就是"一个解"。但记忆轨迹违反两个前提:早期的写入可能要等到很靠后的问题才显出价值,大部分写入拿不到任何直接证据;二值 exact match 还经常让一个小 group 里所有 rollout 同分,advantage 全归零,梯度直接消失。论文引用了 He et al. 2026 的观察,memory-grounded QA 里确实存在这种零方差组。
还有一个更隐蔽的坑:如果 writer 和 answer model 一起优化,QA 分数涨了,你分不清是记忆写得更好了,还是 reader 更会脑补了。所以这篇论文做了个很克制的选择——只训 writer,answer model 和 judge 全程冻结,让记忆库成为奖励路径里唯一在变的组件。
两阶段训练:先学会按协议办事,再学会写好
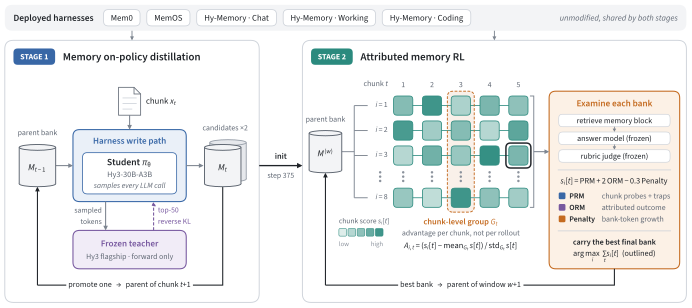
图1:Hy-Memory-30B-A3B 的两阶段训练。左侧 Stage 1 是 Memory On-Policy Distillation:父记忆库 \(M_{t-1}\) 和新 chunk 走真实 harness 的写入路径,所有 LLM 调用都路由到学生模型 Hy3-30B-A3B,冻结的 Hy3 旗舰教师只前向返回 top-50 分布做 reverse KL 蒸馏,产出一个候选库晋级为下一个 chunk 的父库。右侧 Stage 2 是 Attributed Memory RL:8 个 rollout 从同一个父库的独立副本出发写满整个窗口,逐 chunk 打分(颜色深浅代表 chunk 得分 \(s_i[t]\)),优势按列(同一 chunk 位置)归一化而不是按行——所以每个 chunk 的最优 rollout 可以不同。窗口结束后总分最高的最终库(描边格)晋级为下一窗口的父库。
这张图最打动我的细节是:两个阶段都在未修改的部署 harness 里跑。五个配置——Mem0、MemOS,加上 Hy-Memory 的 Chat / Working / Coding 三个场景——框架原生的控制流一刀不动,只是把里面的 LLM 调用换成学生模型。
为什么要两阶段?直接从指令模型上 RL,大量样本会浪费在协议级失败上:JSON 格式错、操作名错、字段缺失、多阶段控制流走岔。而纯蒸馏又只会模仿教师,没法在"都合法"的多种写法里按下游用处排序。OPD 解决"怎么在框架里行动",RL 解决"哪些合法动作能产出有用的库"。
Stage 1 的蒸馏有个讲究:教师不自己生成理想轨迹,而是在学生生成的轨迹上打分。冻结的 Hy3 旗舰模型对学生的 token 流做前向,返回 top-50 的 log-prob,目标函数是 top-k 近似的 reverse KL:
这个思路和 MiniLLM 一脉相承,但在记忆场景下好处多了一层:未来的 prompt 里包含的记忆状态本身就是学生写出来的,on-policy 不只是 token 前缀对齐,连状态分布都对齐了。一次 harness 写入如果触发多次 LLM 调用,各段保留为独立 segment,position id 在调用边界重置,不会拼成一段假对话。
配置上,学生是 Hy3-30B-A3B 指令版(激活约 3B),每行 2 个 rollout,学习率 1e-6 恒定,entropy 系数 0.005,RL 从 OPD 第 375 步初始化。
奖励数据:从失败表面反推考题
这是我个人认为全文最硬核的一节。作者的立场很明确:拿现成 benchmark 的最终问题当奖励,是个低密度学习问题——几百个有用事实可能只配几道题,没被问到的写入拿不到证据,答错了也分不清是漏写、写糊、旧状态混淆、检索失败还是 reader 翻车。
所以他们从"记忆写入的失败表面"反推奖励数据。
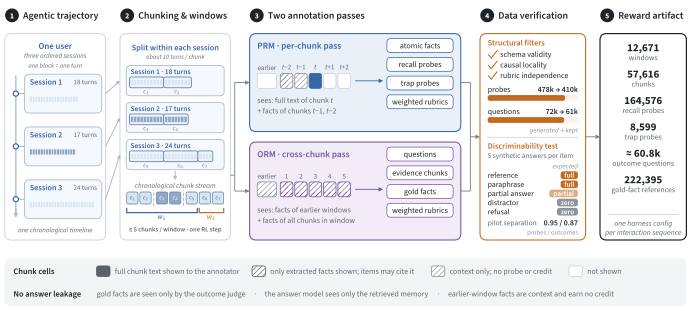
图2:Memory RL 奖励工件的五步构造。(1)按用户组织的多 session 交互轨迹;(2)每个 session 独立切成约 10 轮的 chunk(chunk 不跨 session),再按时间序把最多 5 个 chunk 组成一个 RL 窗口;(3)两遍标注——PRM per-chunk pass 只看当前 chunk 全文加前两个 chunk 的已提取事实(用于消解指代和判断新颖性),产出原子事实、召回探针、陷阱探针和加权 rubric;ORM cross-chunk pass 用更早历史加当前窗口全部事实,产出跨 chunk 问题、证据 chunk、gold facts 和 rubric;(4)四层数据验证,包括用 5 个合成答案做判别性测试;(5)最终工件规模:12,671 个窗口、57,616 个 chunk、164,576 条召回探针、8,599 条陷阱探针、约 60.8k 条跨 chunk 问题、222,395 条 gold-fact 引用。
几个设计值得展开讲。
为什么 PRM 标注只看前两个 chunk? 孤立看 chunk \(t\) 会出两种错:"那个项目"这类指代解不开,也没法判断一个事实是 chunk \(t\) 新引入的还是重复旧内容。但给全历史更糟——对照实验里,全历史标注用了 33 倍的输入 token,而两 chunk 上下文产出的每条事实多 25% 的专有名词和 59% 的数字。视野太大,标注员的注意力就从当前 chunk 漂走了,产出的事实变笼统,这恰好是探针要抓的"过度泛化"失败。这个权衡论证得很实在。
探针按失败模式分类,不是笼统的 QA:特异性(名字、数字、版本、路径是否保真)、语义精确(否定、范围没被反转)、次级维度(主干话题别把小细节挤掉)、状态转移(新旧状态都要在)、不该存(寒暄、客套、助手通用话术不能进库)、存内容而非元描述,等等。
陷阱探针(trap probes)是我觉得最巧的一招。只看召回,"全都存"就是最优策略。trap 问的是不该进长期记忆的内容,比如助手的一句泛泛鼓励,参考答案就是"库里没有这条记录"。writer 一旦存了,检索就会把它捞出来,答案就错了。它和库增长惩罚互补:惩罚管体积,trap 管语义选择性——把废话压缩得再短也躲不过 trap。
数据验证也做得像测试仪器而不是收货:schema 校验、因果局部性、rubric 独立性、判别性四层。判别性测试要求 judge 对每道题的 5 个合成答案按预期排序给分——参考和改写满分、部分答案部分分、干扰项和拒答零分。pilot 里忠实改写平均保住 0.90 的分数。478k 生成探针最终留下约 410k,72k 跨 chunk 问题留下约 61k,每 chunk 最多保留 3 条正向探针加 1 条 trap 以控制 judge 成本。
信用分配:把每个 chunk 的功劳算清楚
奖励计算是"三跳考试":窗口内所有 chunk 写完之后,对每个问题,harness 从写好的库里检索记忆块,冻结的 answer model 只用这个块作答,冻结的 judge 拿答案对照参考答案和加权 rubric 打分。注意它不直接问 judge"检索文本里有没有答案"——因为矛盾或过期记忆导致答错,恰恰是它想测的。
每个 chunk 的分数由三项组成:
其中权重 \(w_{\mathrm{prm}}=1\)、\(w_{\mathrm{orm}}=2\)、\(w_{\mathrm{pen}}=0.3\)。\(\mathrm{prm}[t]\) 是该 chunk 正向探针和 trap 的平均得分;\(\mathrm{orm}[t]\) 是引用了该 chunk 的跨 chunk 问题里、答案恢复出该 chunk gold 证据的平均程度——靠 gold facts 把跨 chunk 的功劳归到源头 chunk,而不是把一个总分广播给所有写入;\(\mathrm{pen}[t]\) 是库 token 增长相对输入 chunk token 的比例,过了一个免罚阈值后按指数曲线爬满惩罚。打折因子 \(\gamma=0\),作者的理由是 gold-fact 归因已经处理了延迟证据,没必要把带噪声的未来召回分往前广播。
然后是chunk 级 GRPO。标准 GRPO 把同一 prompt 的一组采样归一化出 advantage,这里改成按 chunk 位置分组:同一窗口、同一 harness 配置、同一序列、同一 chunk 位置的 8 个 rollout 归一化:
你想想看,为什么非这样不可——8 个 rollout 只在 chunk 0 共享同一个库,之后每个 rollout 看到的是自己前面写出来的库,轨迹级打分又会把一个评价广播给所有写入。按列归一化后,rollout 1 可以在 chunk 2 最强、rollout 3 在 chunk 4 最强,各论各的功过。还有一个防刷分细节:一个 chunk 如果触发了 3 次 LLM 调用,3 段共享同一个 advantage 但只算一票,否则策略可以通过增减调用次数操纵 baseline。少于两个有效 rollout 的组直接给零 advantage。
窗口结束时,8 个最终库按总分排名,赢家成为下一窗口的初始状态,其余丢弃。这意味着训练的第二阶段 on-policy 有两层含义:token 是当前 writer 采的,未来 prompt 里的记忆库也是这个 writer 写出来的。继承下来的错误拿不到回溯梯度,但作者认为带着自己的错继续写,比 teacher forcing 一个理想库更贴近部署——部署时 writer 本来就得在自己之前的烂摊子上干活。说实话我觉得这个论证是对的,虽然"继承错误在组内 baseline 里倾向于抵消"这个说法多少有点乐观。
实验:四个 harness 全部第一,但差距要拆开看
评测纪律先值得夸一句:只换 writer,harness 版本、prompt、检索配置、answer model、judge 全冻结,每个 writer 从空库建库。六个指标等权平均成 harness 分:LoCoMo Judge、LongMemEval、PersonaMem-v2、Travel SPS、Shopping PS、Code Memory Bench。为省算力,所有 benchmark 在固定的 20% 子样本上跑。
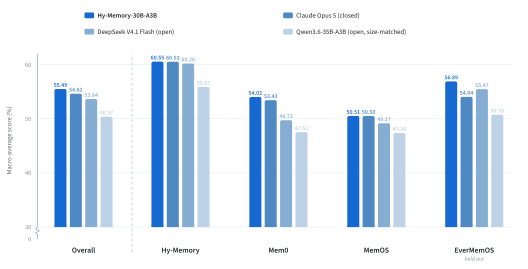
图3:固定 20% benchmark 矩阵上的跨 harness macro average。Overall 上 Hy-Memory-30B-A3B 以 55.49 领先 Claude Opus 5(闭源)的 54.62 和 DeepSeek V4.1 Flash(开源)的 53.64;分项看,Mem0 上 54.02 对 53.43,MemOS 上 50.51 对 50.50,Hy-Memory 上 60.55 对 60.53,而 held-out 的 EverMemOS 上差距拉大到 56.89 对 54.04。尺寸对齐的开源对照 Qwen3.6-35B-A3B 各项均明显落后。
完整数字如下:
| 记忆写入器 | Mem0 | Hy-Memory | MemOS | EverMemOS(未见) | 平均 |
|---|---|---|---|---|---|
| Hy-Memory-30B-A3B | 54.02 | 60.55 | 50.51 | 56.89 | 55.49 |
| Claude Opus 5 | 53.43 | 60.53 | 50.50 | 54.04 | 54.62 |
| DeepSeek V4.1 Flash | 49.73 | 60.20 | 49.17 | 55.47 | 53.64 |
| Hy3 | 45.99 | 58.06 | 50.19 | 52.30 | 51.63 |
| Qwen3.6-35B-A3B | 47.51 | 55.87 | 47.36 | 50.75 | 50.37 |
| Hy3-A3B Base | 40.20 | 50.39 | 49.05 | 50.98 | 47.66 |
| Qwen3-30B-A3B | 39.81 | 45.67 | 45.44 | 46.57 | 44.37 |
现在说点批判性的。先看好的:EverMemOS 是完全没参与训练的 held-out 框架(一个自组织记忆操作系统,把对话流组织成 MemCell 和主题 MemScene,算是开源社区里很强的一类 baseline),在这里赢了 Opus 5 2.86 个点,比宏平均的 0.87 个点有说服力得多——它把"学到了记忆写作能力"和"背熟了训练框架协议"分开了。对 Hy3-A3B 底座提升 7.84 个点,训练本身确实在起作用。
但有几处必须泼冷水。MemOS 和 Hy-Memory 上对 Opus 5 只赢 0.01 和 0.02 个点——论文自己承认这在确定性 20% 子样本评测下只是"打平",不是统计显著的差异。单点提升的来源也不均匀:EverMemOS 上的增益主要由 Travel SPS(涨 10.65 个点)和 CMB(涨 13.66 个点)驱动,而 Shopping PS 这类指标上各家都在 20 分上下挣扎,谁也没真正解决。
还有一件让我皱眉的事:全文没有任何消融实验。chunk 级 vs 窗口级 GRPO、gold-fact 归因 vs 广播 ORM、有无 trap、有无增长惩罚、OPD 初始化 vs 普通 SFT——全部留作 future work。一篇以奖励设计为核心贡献的论文,不消融奖励组件,等于核心声明没有被直接验证。再加一句,Hy-Memory 是作者自家的框架,自家 harness 上训练又评测,虽然 EverMemOS 的 OOD 结果缓解了一部分疑虑,但"四个 harness 全部第一"这个 headline 里有两个 harness 的差距只有小数点后两位。
工程教训:silent failures 清单
第 9 节是意料之外的宝藏,列了一串"看起来健康、其实坏了"的失败模式:库没有跨窗口持久化但磁盘上留了文件、奖励还非零;教师没返回 top-k 但请求状态成功,OPD 梯度全是零;chunk 到 segment 的映射缺失时 fallback 把一个分广播给所有段;硬编码调度漏了某个配置但磁盘工件完好;"read all"静默分页导致库条目数卡在默认上限;失败的写 checkpoint 成空库却被标记完成;沙盒共享 trajectory 身份导致请求挂错 rollout;格式错误被当成环境错误处理,坏动作直接从训练里消失。
贯穿的原则就一条:坏策略动作必须拿低分,平台故障绝不能伪装成策略行为。做过 RL 系统的人看到这条会心有戚戚——这类 bug 不产生 crash,只产生"看起来还行但怎么都不收敛"的训练。
我的判断
这篇论文的真实贡献,是把"记忆写入 RL 为什么难"拆成五个具体问题——奖励稀疏、信用广播、过存储捷径、决策粒度错位、训练与部署状态分布不一致——然后每个都给了一个对应的、可工程的解法。单个看,每招都有先例(reverse KL on-policy 蒸馏来自 MiniLLM,组内归一化来自 GRPO,过程监督的概念来自 Let's Verify Step by Step),但把它们系统地组装到"外部记忆库写入"这个 MDP 上,并且在三个真实框架加一个 held-out 框架上跑通,这是头一份。
局限性也很实在:归因是基于证据而非反事实的——恢复出 gold fact 不能证明是某次写入导致的;跨 optimizer step 的信用被截断;多调用 chunk 还是可能携带更多 loss 质量;没有消融;没有多种子重复。
如果你在做 Agent 记忆系统,我的建议是:trap 探针和"只训 writer、冻结 reader"这两条,不训模型也值得抄——它们直接可用于评测任何记忆框架的写入质量。如果你在训长周期 Agent RL,chunk 级分组加"每 chunk 一票"的 baseline 设计,是处理"动作改变后续状态、且动作成本不均"这类问题的干净范式。
一个激活 3B 的小模型,在四个记忆框架上打平甚至超过 Opus 5 当写入器,还顺手把服务和隐私成本打了下来——这件事本身的信号比 0.87 个点的分差重要:记忆写入是一种可迁移的模型能力,而不是一堆框架专属 prompt 技巧的合集。接下来值得盯的是消融实验放出来后,这套奖励设计里到底哪几刀真正在出力。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我