给智能体装上"白天记录、夜晚做梦"的记忆:DCPM 把长期记忆从检索问题变成了认知问题
用了一周的 AI 助手,你已经告诉过它三次"我现在不吃辣了",它还是会给你推荐川菜馆。
这不是段子,是现在所有记忆系统的真实处境。Mem0、Zep 这些主流方案把长期记忆当成一个检索问题来解:对话切片、embedding、塞进向量库,查询的时候按相似度捞几条出来。这套 pipeline 在"用户三个月前说过什么"这类问题上确实能打,但换个问法——"这个用户的偏好是怎么一步步变成现在这样的"——它们集体哑火。
腾讯大模型部这篇 DCPM(arXiv:2606.09483)给出了一个让我眼前一亮的回答:问题不在检索不够好,在于你把记忆当成了存储,而不是认知。
核心摘要:DCPM 借用了认知科学里的双过程理论(dual-process theory),把记忆系统拆成两个进程——白天的 System 1 同步写入器负责记录事实和信念修订(用双向链表把"旧的信念被新的取代"这件事显式存下来),夜晚的 System 2 异步引擎负责在事实之上归纳行为图式(schema)、潜在意图(intention),并用一个"双空间碰撞"机制找出跨生活领域的共性模式。在最考验隐式推理的 PersonaMem-v2 上,System 2 带来了 5.20 分的提升(kimi-2.5),而在纯召回类 benchmark 上几乎不涨——这个不对称性恰好是理论预测的结果,也是这篇文章最有说服力的部分。我的判断:这不是底层算法突破,但它提出的"按认知能力分层组织记忆"的视角,以及 supersedes 链这个便宜又有效的设计,值得每个做 agent 记忆的人认真看一遍。
📖 论文信息
- 标题:Memory Beyond Recall: A Dual-Process Cognitive Memory System for Self-Evolving LLM Agents
- 作者:Tianxiang Fei, Mingyang Song, Mao Zheng, Xiang Yu
- 机构:Large Language Model Department, Tencent
- 链接:https://arxiv.org/abs/2606.09483 (2026 年 6 月 8 日提交,cs.CL / cs.AI)
🎯 动机:记忆系统到底在漏掉什么
先铺垫一下背景。2025 年以来 agent 记忆这条线已经很热闹了:MemGPT 把记忆当操作系统的分页缓存来管,Mem0 走生产可用的"记忆即服务"路线(混合向量+图存储),Zep/Graphiti 用时间知识图谱追踪事实变化,A-MEM 搞 Zettelkasten 式的自组织记忆网络,Letta 那边还提出了 sleep-time compute——让 agent 在空闲时段整理记忆。这些系统各有战场,但论文指出了一个它们共有的盲区。
作者把盲区归到一个根源:memory-as-storage 和 memory-as-cognition 被混为一谈了。具体拆开看,现有系统丢了三样东西:
- 信念的中间状态。用户说"我开始健身了",三个月后说"健身房太吵改在家练",再过俩月说"其实我最喜欢的是徒步"。update-in-place 的系统只保留最后一条,前两步的演化轨迹被覆盖了。可"为什么会变成现在这样"恰恰藏在这些中间状态里。
- 因果耦合。修订偏好的那一轮对话,embedding 往往夹在旧话题和新结论之间,最近邻检索很难把它捞上来。状态之间的因果链断了。
- 跨领域抽象。一个人在健身、养花、带团队三件事上表现出同一种"耐心微投入、信任积累"的行为模式——语义上八竿子打不着,行为上同构。没有系统会去主动发现这种东西。
看到第三条的时候我停下来想了想。这确实是我之前做个性化助手时碰到过的天花板:事实召回做得再好,agent 给人的感觉还是"记性好但没悟性"。论文管这个叫从"记忆即召回"到"记忆即认知"的转向,话有点大,但问题定位是准的。
🧠 方法:一座金字塔,两个进程
认知能力金字塔
DCPM 的组织原则不是按存储介质分层(内存/磁盘/向量库),而是按认知能力分层。

图1:认知能力层级金字塔。底层是被动基础(Passive Foundation),存原始输入、原子事实和基本画像;中间是结构化记忆(Structured Memory),有了带版本的事实、跨会话一致性和时序推理能力;顶层是主动认知演化(Proactive Cog-Evolution),装着 schema 和 intention。论文的判断很犀利:现有系统几乎全挤在塔底。
这座金字塔对应五类记忆内容:facts(原子事实)、summaries(会话级摘要)、identity items(稳定的用户属性)、schemas(领域内行为图式 + 跨领域核心图式)、intentions(对未来事件的潜在关切)。注意 intention 和 schema 是平级关系,不是上下级——一个是"观察到的规律",一个是"对将来的预判"。
全景架构:白天写,晚上想

图2:DCPM 双进程架构。左侧黄色区域是 System 1 白天写入器:用户交互产生 raw input,经 Extract 抽取事实、Reconcile 做 ADD/SUPERSEDE/UPDATE 三选一裁决后写入中央 VDB(向量库)。右侧紫色区域是 System 2 夜间清扫器:先把新事实 cluster,经 graph lookup 找到相关图节点,由 Central Agent 调用工具写入新图节点,最后 Dual-space Collision 模块在语义空间和认知空间做双重比较,经 LLM 归纳出新的认知图式。底部图例标了八种节点类型:Fact、Identity、Summary、Schema、Intention 等。
这个"白天/夜晚"的划分借自双过程理论的架构区分——快系统在线编码,慢系统离线抽象。作者自己也坦承只继承了架构划分,没打算模拟心理学细节。这种克制我觉得是对的,比那些硬蹭认知科学名词的论文诚实。
System 1:同步写入器,核心是 supersedes 双向链
System 1 不是每轮对话都触发,而是等显式的 add_memory 请求,在几秒的延迟预算内干四件事:
- Raw persist:原始输入先落向量库,再调任何 LLM。下游挂了也不丢用户数据。这个顺序细节很工程,但很对。
- Extraction:抽取 LLM \(M_e\)(deepseek-v4-flash 或 kimi-2.5,no-think 模式)一次调用产出 identity items 和原子事实,带类型、主题、显著性和时间戳。
- Reconciliation:裁决 LLM \(M_r\) 拿着每条新内容和向量库里 top-\(k\) 近邻对比,三选一:ADD(全新)、SUPERSEDE(矛盾或演进)、UPDATE(补充扩展)。完全重复的静默丢弃。
- Batch upsert + supersedes 链:SUPERSEDE 时写两个指针 \(n_{new}.\text{Supersedes} = n_{old}\) 和 \(n_{old}.\text{SupersededBy} = n_{new}\),旧条目不删,于是在扁平向量库上长出了双向链表。
最后这一步是整个 System 1 的灵魂。和 update-in-place 相比,它几乎不增加写入成本,但保留了完整的信念演化弧。读取时一次命中触发 \(O(\bar{k})\) 的指针遍历,把整条修订链拉出来——包括 embedding 相似度注定会漏掉的"因果中间态"。
说实话这个设计让我想到 Git。commit 不覆盖旧 commit,只是链起来;你随时可以 checkout 任何一个历史状态。记忆的版本控制,就两个指针的事,但之前没人把它当一等公民来做。
System 2:夜间引擎,三阶段离线归纳
System 2 在空闲或夜间窗口跑,预算宽松得多(几十秒),分三个阶段:
Phase 1 预处理(零 LLM 调用)。先挑出没被任何 schema/intention 引用过的新事实,用两阶段 DBSCAN 聚类(第一遍 \(\varepsilon_1 = 0.35\) 粗聚,第二遍 \(\varepsilon_2 = 0.25\) 把过大的簇切细,min_samples=3)。每个簇算质心,双向检索图上下文:既找最近的已有 schema/intention 节点,也找证据边已经指进这个簇的节点。
Phase 2 LLM 归纳。归纳 agent \(M_a\) 每个簇调一次,手里有四个工具:create_schema(建领域内行为规律节点)、create_intention(建潜在关切节点,用于主动关怀)、add_evidence(把簇里的事实 id 挂到已有节点上)、add_edge(连结构边)。所有操作按发出顺序落图,所以图是逐夜增量演化的,不是每晚重建。
Phase 3 跨领域清扫器,这是全文最巧的设计。分三步:(a) 行为抽象——LLM 给每个 schema 生成一段短的行为描述(比如"在沉没成本后反而加码投入"),编码进行为空间 \(E_{beh}\);语义空间 \(E_{sem}\) 则编码原始 schema 文本。(b) 碰撞扫描——枚举跨领域的 schema 对 \((s_i, s_j)\),满足下面这个条件就算碰撞:
说人话:行为上像,语义上不像。两个空间用的是同一个 bge-m3 骨干,只是输入不同。阈值 \(\theta_{beh} = 0.72\)、\(\theta_{sem} = 0.40\),在 PersonaMem-v2 的 held-out split 上调的。碰撞对用并查集聚成簇,两个空间都高的冗余对被过滤掉。(c) 核心归纳——LLM \(M_c\) 对每个碰撞簇归纳出一个更高层的核心 schema 写回图里,作为最抽象的检索目标。
论文给了一个例子我印象很深:一个健康养生领域的 schema 和一个园艺/教学领域的 schema,语义余弦只有 0.18,行为余弦却有 0.81。归纳出的核心 schema 是这样的——"用户持有一种有机培育式心智模型:有意义的结果被视为需要耐心、持续微投入的涌现系统,信任积累胜于强制加速"。这种东西你让向量检索去发现?不可能的,它连这两个 schema 都不会被放在一起比较。
读取路径也值得说一句:推理时完全不调 LLM。查询 embedding 命中事实库和身份库,沿 supersedes 指针遍历,再顺着 evidence_vdb_ref 边浮出相关的 schema/intention/core schema 节点。读延迟和纯检索系统一样,归纳的成本全摊到了夜里。这个"写时重、读时轻"的不对称设计,对线上系统非常友好。
📊 实验:不对称的提升曲线,恰好是理论预测的形状
主实验
三个 benchmark 各有分工:LongMemEval(S 集)测召回、时序推理、知识更新和拒答;PersonaMem(32k)测多会话人设一致性;PersonaMem-v2(32k)考隐式偏好推断——答案从来不显式出现在对话里,前沿 LLM 在原报告里只有 37–48% 的准确率,区分度最高。Baseline 是长上下文 agent(全历史塞上下文)、Mem0(带不带图后端都算)、Zep/Graphiti。
| 系统 | PersonaMem (ds) | PersonaMem (kimi) | LongMemEval (ds) | LongMemEval (kimi) | PersonaMem-v2 (ds) | PersonaMem-v2 (kimi) |
|---|---|---|---|---|---|---|
| B1 长上下文 Agent | 72.07 | 77.59 | 88.43 | 80.61 | 50.82 | 58.46 |
| B2 Mem0 | 69.07 | 65.23 | 56.84 | 48.87 | 42.53 | 41.25 |
| B2 Mem0 + graph | 68.82 | 65.82 | 57.14 | 51.26 | 43.28 | 40.16 |
| B3 Zep / Graphiti | 58.93 | 64.21 | 67.83 | 62.35 | 39.54 | 38.27 |
| DCPM lite(仅 S1) | 69.15 | 74.32 | 84.73 | 85.81 | 46.85 | 54.10 |
| DCPM full(S1+S2) | 70.46 | 76.73 | 85.17 | 86.14 | 49.36 | 59.30 |
表1:三个长期记忆 benchmark 上的准确率(%),ds = deepseek-v4-flash,kimi = kimi-2.5,均为 no-think 模式。
这张表里有几个东西值得展开。
先看 Mem0 和 Zep 的数字,比长上下文 agent 低了一大截——PersonaMem-v2 上 Mem0 只有 42.53/41.25,长上下文有 50.82/58.46。这印证了作者开篇的判断:为表面召回调优的系统,在隐式推理任务上崩得最狠。
再看 System 2 的增益分布,这是全篇最漂亮的一组数字:PersonaMem-v2 上涨了 2.51 / 5.20 分,PersonaMem 上 +1.31 / +2.41,LongMemEval 上只有 +0.44 / +0.33。越依赖隐式跨会话推理的 benchmark,System 2 贡献越大;纯召回几乎不动。作者把这个叫做"可证伪的预测"——如果 System 2 只是调度上的花活,增益应该是三个 benchmark 均匀分布的;现在这种不对称形状,恰好说明它编码了真实的认知功能。这个论证方式我认。
还有一个反直觉的点:kimi-2.5 列上 DCPM full(86.14)反超了长上下文 agent(80.61)5.53 分。失败案例显示长上下文在 Lost-in-the-Middle 上栽跟头——相关证据落在上下文的不利位置就答错。结构化记忆等于给证据开了一个专用检索面,绕过了位置偏见。上下文再长也不如索引建得好,这对"长上下文万能论"是个不错的反例。
消融:4.1 分的碰撞,1.3% 的节点
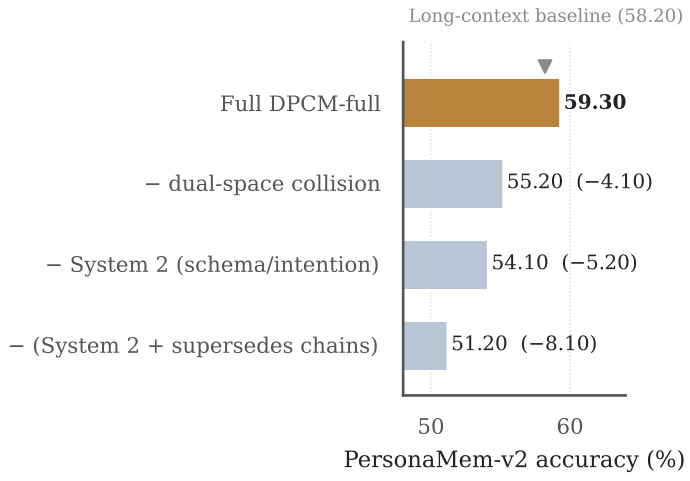
图3:PersonaMem-v2(kimi-2.5)消融。完整 DCPM full 59.30;去掉双空间碰撞掉到 55.20(减 4.10);再去掉 System 2 的 schema/intention 归纳掉到 54.10(累计减 5.20);最后连 supersedes 链也去掉掉到 51.20(累计减 8.10)。顶部三角是同模型对的长上下文基线 58.20。
消融把三个机制的贡献拆得很干净:跨领域碰撞约 4.1 分,supersedes 链约 2.9 分,schema/intention 归纳引擎约 1.1 分。碰撞机制一个就扛了上层结构的绝大部分收益。
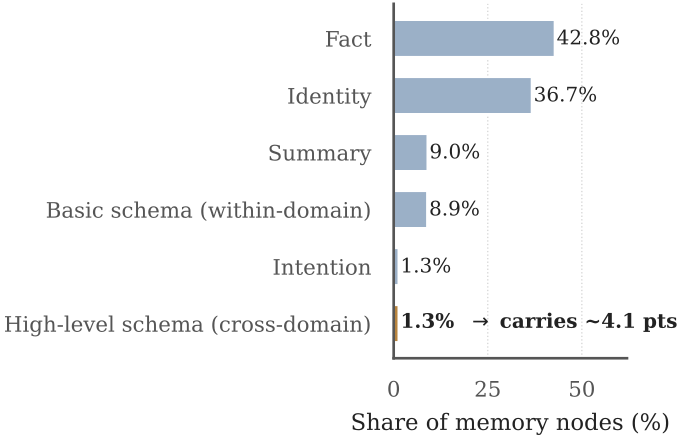
图4:DCPM full 在 PersonaMem-v2 上的记忆节点构成。Fact 占 42.8%,Identity 占 36.7%,Summary 占 9.0%,领域内基础 schema 占 8.9%,Intention 只占 1.3%,跨领域高级 schema 也只占 1.3%——但这 1.3% 扛着约 4.1 个消融点。
图4 回应了一个很自然的质疑:上层认知节点会不会大多是空摆设,收益其实来自检索重排?数据显示不会。事实级条目占大头(逐轮写入器的必然结果),所有 schema 加起来约 10%,而跨领域核心 schema 只占 1.3% 的节点,和 intention 持平。1.3% 的节点扛 4.1 分,这个杠杆率说明它们编码的是高价值的认知结构,不是更多的表面内容。
supersedes 链的统计也挺有意思:PersonaMem-v2 上平均每用户 1.8 条链(0 到 7),平均链长 2.4 次修订,最长 5。在 LongMemEval 的 knowledge-update 子集上,答对的查询里 78% 在读取时碰到了至少一个 supersedes 指针,答错的只有 31%——链遍历和信念恢复成功率强相关,这算是给"保留演化轨迹有用"提供了直接证据。另外 identity 条目极少被取代(不到 3% 带指针),修订集中发生在关于偏好和习惯的事实性声明上——符合设计预期。
分题型看 LongMemEval
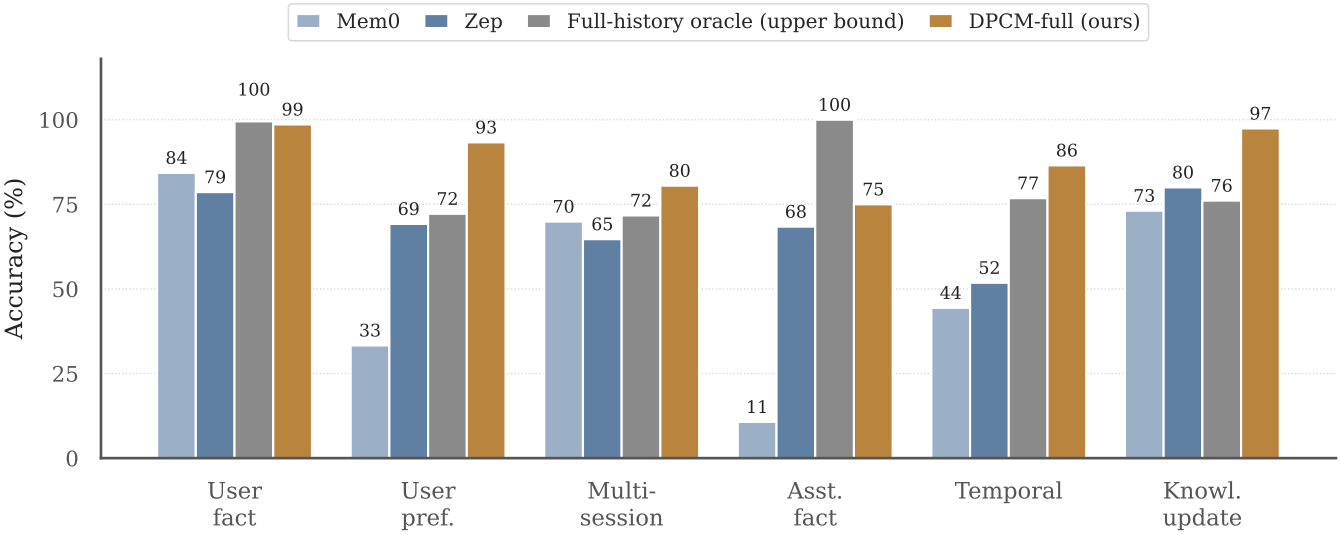
图5:LongMemEval 按题型拆分的准确率。Mem0、Zep 和 full-history oracle 的数字取自公开报告。表面召回类(user fact)接近饱和;整合类(user preference、temporal、knowledge update)差距明显——user pref. 上 Mem0 只有 33,DCPM full 到 93;knowledge update 上 DCPM full 拿到 97,反超 oracle 的 76。
这张图把"为什么需要上层结构"讲得很直观:user fact 这种纯召回题型,Mem0(84)、Zep(79)已经不差了,oracle 100 封顶,没啥油水;真正的缺口在 preference(Mem0 只有 33)、temporal(Mem0 44)、knowledge update 这些需要整合的题型上。DCPM full 在 knowledge update 上拿了 97——比 full-history oracle 的 76 高出 21 个点,这个反超再次说明"把全历史塞进上下文"并不等于"记得好"。
🤔 我的判断:亮点、问题和位置
亮点有三个,按价值排序。
第一,supersedes 双向链。便宜、简单、直接有效,2.9 个消融点,读取零 LLM 成本。任何在做 agent 记忆的团队都可以明天就加上这个机制。这是我眼里全文工程性价比最高的东西。
第二,双空间碰撞的判据。"行为相似 + 语义相异"这个不等式把"跨领域类比发现"从玄学变成了可计算的扫描任务。1.3% 的节点扛 4.1 分,投入产出比惊人。
第三,可证伪的架构预测。"System 2 应该在隐式推理上大涨、在表面召回上不涨"——先把预测立好再看数据,实验设计和论证是咬合的,比事后讲故事的论文高一档。
但问题也不少,说三个我皱眉的地方。
一是长上下文基线仍然很强。PersonaMem-v2 的 deepseek 列上长上下文 50.82 还是压着 DCPM full 的 49.36,PersonaMem 的 kimi 列也是长上下文 77.59 最高。也就是说,在模型够强、上下文放得下的场景里,"全塞进去"依然是难打的对手。DCPM 真正的胜负手是 kimi 列的 LongMemEval 和 PersonaMem-v2——前提是模型存在 lost-in-the-middle。随着模型长上下文能力继续变强,这个窗口会不会收窄?论文没有讨论。
二是阈值的脆弱性。\(\theta_{beh} = 0.72\)、\(\theta_{sem} = 0.40\) 是在 PersonaMem-v2 的 held-out split 上调出来的,作者自己也承认 \(\theta_{beh}\) 对 benchmark 敏感。换一个部署环境,这两个数还灵不灵?很可能不灵。碰撞机制是全文最大的卖点,但它依赖一对手工调的阈值,这个泛化风险是实打实的。
三是成本结构没说透。System 2 的 Phase 3 有 \(O((D\bar{s})^2)\) 的向量比较(\(D\) 是领域数、\(\bar{s}\) 是每领域 schema 数),论文用"\(D \le 20\)、\(\bar{s} \le 30\)"论证可接受——这是个人聊天助手的假设。如果是企业级多租户场景,领域多样性上去之后这个二次项就是瓶颈,论文在 Limitations 里也承认了。另外每簇一次 LLM 归纳、每 schema 一次行为抽象、每碰撞簇一次核心归纳,夜间跑批的 LLM 账单并不便宜,论文没给具体的成本数据,有点遗憾。
还有一个我自己不太确定的点:supersedes 链的触发依赖 reconcile LLM 的判断,论文提到它会 over-fire——把用户的临时状态误判成稳定修订。平均链长 2.4 看着健康,但误判率没有在主实验里量化。这个机制的收益和噪声之间的 trade-off,可能需要更细的错误分析才能下结论。这块我承认我也没完全想清楚怎么评。
放在同期工作里看位置:和 Letta 的 sleep-time compute 比,DCPM 的夜间引擎目标更明确——不是泛泛地"整理记忆",而是有具体产出物(schema、intention、core schema)和具体的发现机制(双空间碰撞);和 A-MEM 的自组织记忆网络比,DCPM 的分层是按认知能力而不是按关联密度组织的;和 Xie 的睡眠启发记忆巩固比,两者共享 wake-sleep 划分,但 DCPM 操作的是已巩固的事实而非原始干扰。整体上我会把它定位成一次方向正确、论证扎实的架构整合,不是某个单点算法的突破——但记忆这个领域现在缺的恰恰不是单点算法,是组织原则。
💡 工程启示与收尾
如果你在做 agent 记忆,三件事可以直接拿走:
- SUPERSEDE 别覆盖,写双向指针。旧版本留着,读取时遍历链。成本几乎为零,知识更新类问题的收益立竿见影——78% 对 31% 的指针命中率对比就是最好的广告。
- 读路径保持 LLM-free。归纳放夜里,白天只做 embedding 查询加指针遍历。延迟和成本都压在离线侧,线上体验和纯检索系统无差别。
- 试试"行为相似、语义相异"的碰撞扫描。哪怕不做完整 System 2,定期对已有记忆做一次双空间扫描,也可能挖出人工标注根本想不到的用户模式。
但有个更根本的问题这篇论文没碰:当 agent 归纳出的核心 schema 是用户自己都没意识到的行为模式时,要不要告诉用户?论文的 Ethics Statement 建议跨领域核心 schema 默认关闭、逐项征得同意后才开启——这个姿态是对的,但也侧面说明了这类系统的能力边界已经摸到了隐私敏感区。记忆越像认知,agent 就越像一面用户没要求过的镜子。这是整个方向接下来绕不开的议题。
回到开头那个川菜馆的问题。DCPM 给的答案不是"检索做得更好",而是"记住她是怎么一步步不吃辣的"——中间态保留下来,推理才有着力点。记忆的目标不是召回过去,是理解变化。这句话我觉得值这篇文章的全部篇幅。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我