记忆能背下来,不代表能接着干活:CMB 给编码智能体的记忆出了一套「实操考卷」
上周碰到一个挺典型的场景:让编码智能体改一个配置项,中途插进去查了另一个不相关的 bug,顺手改了下需求,然后回头让它「继续刚才的活」。结果它把三个小时前已经否决掉的方案又实现了一遍。
做记忆系统的人对这个场景应该不陌生。但问题在于——现有的记忆评测根本考不出这种失败。LongMemEval 考的是「你记不记得用户说过什么」,SWE-bench 考的是「你能不能修好这个 issue」,而真实编码会话里的记忆难题是另一回事:任务被打断、需求改了三版、分支切来切去,最后 agent 要接着上次的地方继续干。这时候它需要的不是「回忆起一段文字」,而是「把活干完」。
核心摘要
这篇论文做了两件事。一是提出 CMB(CodeMemoryBench),一个执行级别的编码记忆基准:在真实仓库里构造交织的长会话,冻结交互历史和仓库快照,让所有记忆机制重放同一份历史,然后用「能不能把代码改对」来打分——216 个可执行任务 + 750 个诊断问答,横跨 9 个仓库、4 种语言、5,595 轮交互。结果相当难看:最强的现有记忆机制(Mem0)在较强的 backbone 下,只有 36.6% 的任务被解决。二是提出 TriLink,一个三层记忆架构,把任务事实、可复用经验、代码 diff 通过溯源和演化关系链接起来,在两个 backbone 上分别达到 43.1% 和 35.6%,比最强 baseline 高 6.5 和 7.4 个点。
我的判断:CMB 的价值大于 TriLink。「记忆评测要落到可执行结果上」这个主张,这篇论文是第一个把它做扎实的——交织会话、版本修订、冻结重放,这套组合拳直接把对话式记忆基准和 issue 级编码基准之间的鸿沟填上了。TriLink 本身更像一个「认真设计的 baseline 上限」,三层架构没有特别惊艳的机理创新,但 diff 链那层确实打到了痛点。
论文信息
- 标题:CMB: A Coding Memory Benchmark for Long-Horizon and Interleaved Coding Agents
- 作者:Jiazheng Kang、Tianxiang Fei、Mao Zheng(* 共同一作)
- 机构:Tencent Hunyuan
- 发布:2026 年 10 月,Hy-Memory 开源仓库(https://github.com/Tencent-Hunyuan/Hy-Memory)
现有评测为什么考不出真问题
先看这张对比表,它把现有基准的盲区摆得很清楚:
| 基准 | 长会话 | 编码 | 任务交织 | 记忆目标 | 仓库测试 |
|---|---|---|---|---|---|
| LoCoMo | × | × | × | ✓ | × |
| LongMemEval | × | × | × | ✓ | × |
| MemoryArena | × | × | × | ✓ | × |
| SWE-bench | × | ✓ | × | × | ✓ |
| CodeIF-Bench | × | ✓ | × | ✓ | ✓ |
| SWE-ContextBench | × | ✓ | × | ✓ | ✓ |
| CMB | ✓ | ✓ | ✓ | ✓ | ✓ |
对话式记忆基准(LoCoMo、LongMemEval 这一系)测的是时序推理、知识更新、跨会话回忆——全是「说出来」。仓库级编码基准(SWE-bench 系)有执行检验,但每个任务独立开局,不考记忆。SWE-ContextBench 考了经验复用,但任务之间靠 issue 依赖关系串联,不是一个被打断又续上的长会话。
CMB 是第一条同时勾上五列的基准。关键在第三列「交织」——真实的开发会话从来不是单线程的,而这恰恰是记忆失效最快的场景。
CMB 是怎么造出来的
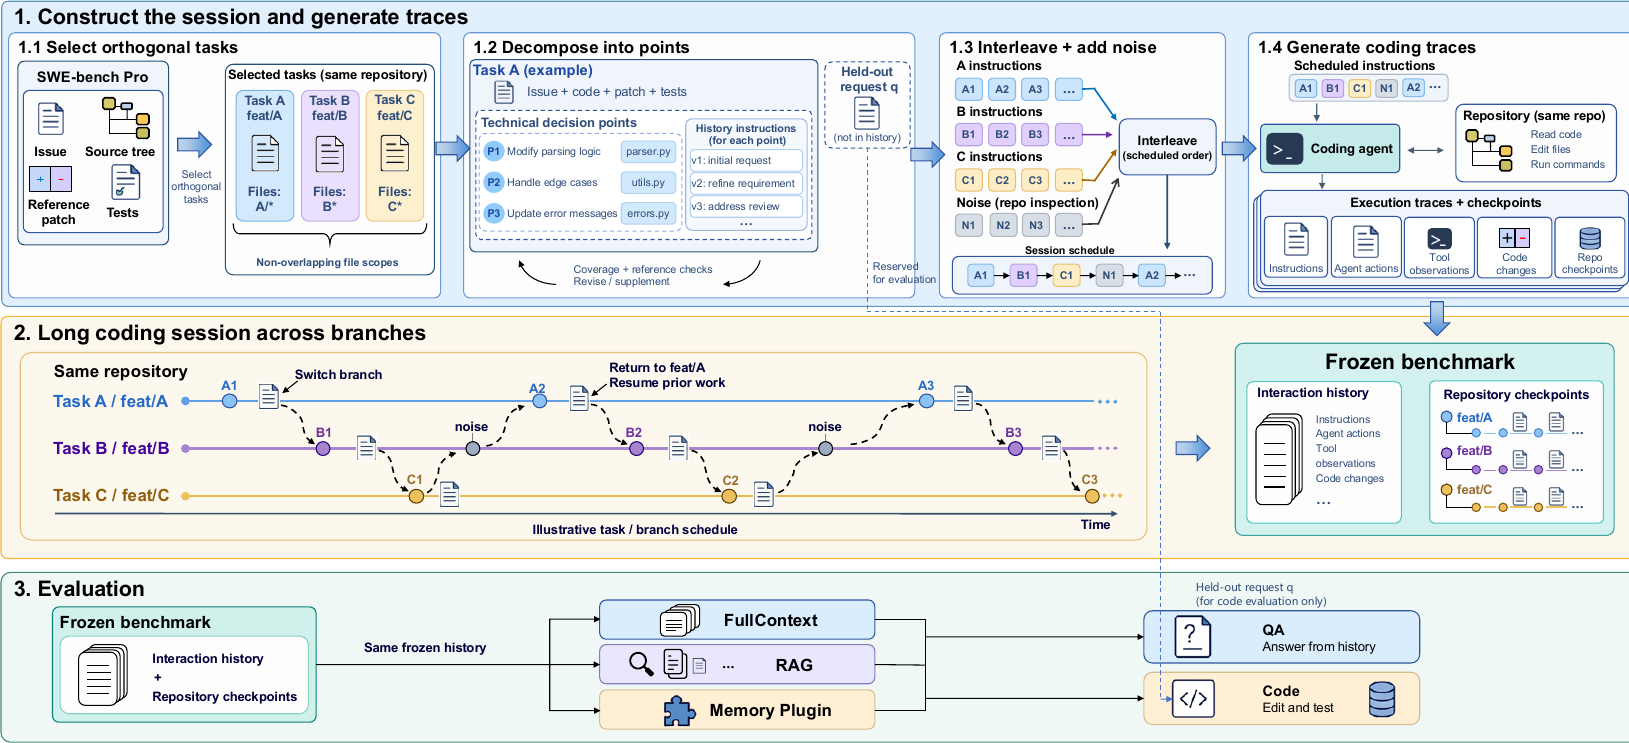
图 1:CMB 的三阶段流水线——选任务并拆解决策点、交织执行长会话并冻结、重放历史分别评测 QA 和代码编辑
构造流程值得细看,因为这里的几个设计选择直接决定了基准的区分度。
任务源是 SWE-bench Pro 的 issue/patch/test 三元组(Scale AI 那个长周期企业级基准,平均参考补丁要动 4.1 个文件、107 行代码,GPT-5 发布时只解了 23.3%,硬度足够)。筛选时要求所选任务的可编辑文件集合互不重叠,防止补丁作用域交叉——作者也诚实标注了,这只保证文件级隔离,不证明语义独立。
每个任务被拆成若干「决策点」(point),每个决策点再展开成 3~5 条实现指令,最后跟一个独立的「最终请求」。关键设计在最后这个请求上:它不重复实现细节,而是用位置、序数、描述、排除四种指代方式之一,指向历史中的某个决策——「用我们第三次讨论的那个方案」「除了被否掉的那两个之外剩下的思路」。这逼着记忆系统必须能在多个相似候选中区分出目标版本。
交织与噪声。各任务的非最终指令按 round-robin 轮流排进同一条会话流,任务块之间插入询问仓库状态的噪声轮次(看 commit、看工作区、看分支)。任务分支只在首次出现时命名,后续请求要求 agent 自己回忆起该切到哪个分支。
冻结与重放。整段会话连同仓库 checkpoint 一起冻结成基准文件,每个记忆机制摄入完全相同的文本流,然后回答依赖历史的请求、或直接从冻结仓库的克隆开始改代码。打分用测试说话:
\(v_i\) 要求补丁非空且测试报告有效,F2P(修复目标行为)和 P2P(不破坏既有行为)两组测试必须全过才算 resolve。这比「参考答案相似度」硬得多。
规模:9 个仓库(Go / TypeScript / JavaScript / Python 四种语言)、每仓库 302~928 轮(中位数 583)、总计 5,595 轮、823 万冻结 token、212 个分支、216 个可执行任务、750 个 QA 问题、1,482 个决策点。
真正狠的是这组数字:1,482 个决策点里有 1,284 个(87%)指向的不是最新一版修订。修订深度分布是 760 个三层、513 个四层、209 个五层。也就是说,「永远拿最新编辑」这条最偷懒的策略在 87% 的点上必错。版本混乱(version confusion)在这里不是边缘 case,而是主考项。
TriLink:事实、经验、diff 三层链接
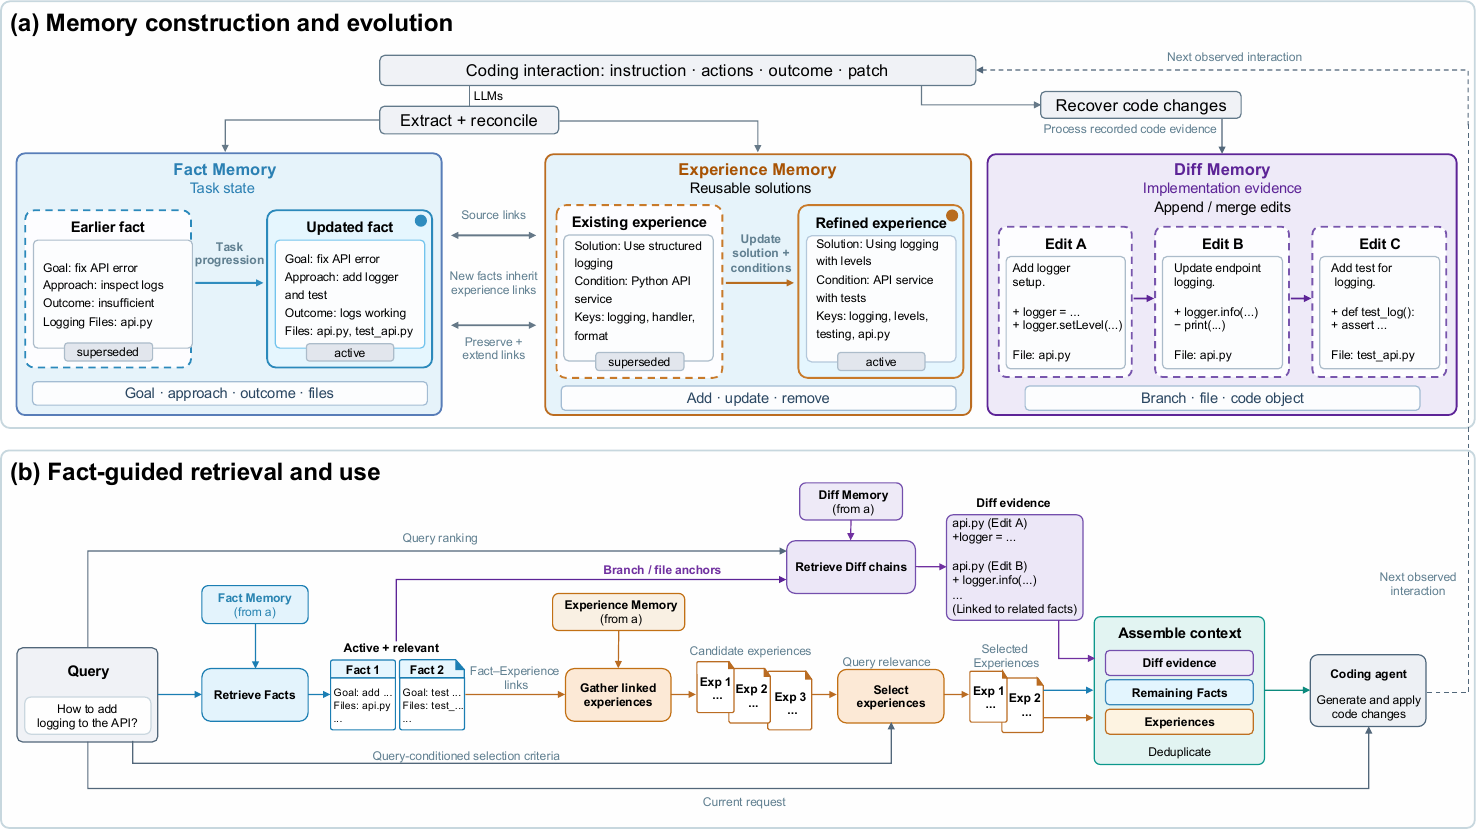
图 2:(a)记忆构建与演化——事实层记任务状态、经验层记可复用方案、diff 层存实现证据,新事实继承旧事实的经验链接;(b)检索路径——查询先命中事实,沿链接带出经验和 diff 链,组装成上下文
TriLink 的想法用一句话说:摘要会丢信息,所以把「发生了什么」「学到了什么」「代码改了什么」分成三层存,再用链接把它们拴在一起。
- Fact Memory:每个任务的目标、当前做法、结果、涉及文件,带 active/superseded 状态。任务推进时新事实 supersede 旧事实,但旧记录保留可回溯。
- Experience Memory:可复用的解决方案——适用任务、步骤、检索关键词、适用条件,外加指回源事实的引用。
- Diff Memory:按分支 + 文件 + 代码对象组织的修订链,每条记录是指令 + 补丁片段 + 时间。这一层不经过 LLM,直接用录下的补丁和 checkpoint 差异构建,零额外模型调用。
链接关系是核心。\(L \subseteq F \times E\) 连接事实与经验,\(S \subseteq F \times F\) 记录事实更替。任务状态推进时,新事实自动继承前任的经验链接:
检索时,一次查询嵌入同时给事实和经验打分;与命中事实链接的经验要过查询相关性门槛才能进上下文,直接匹配的经验排在其后补充;选中的事实再通过分支和文件锚点把对应的 diff 链捞出来。最终上下文按「diff 块 → 其余事实 → 经验」的顺序组装。
说实话,这套设计没有特别反直觉的机理——它更像把工程实践里被验证过的东西(任务状态追踪、经验库、版本历史)显式地结构化、连起来。但这恰恰是它的价值:消融实验会告诉你,少哪一层都不行。
实验:天花板、地板和中间的真实差距
两个 backbone:Claude Sonnet-5 和 DeepSeek v4-flash,同一套 mini-swe-agent 脚手架。五个记忆 baseline:Mem0、MemOS、RAG(对冻结历史做朴素向量检索)、OpenViking、RepoMemory,外加 FullContext(直接喂原始历史)作为参照。
CMB 主结果
| 方法 | Sonnet-5 Code | Sonnet-5 QA | flash Code | flash QA |
|---|---|---|---|---|
| FullContext(参照) | 58.8 | 56.1 | 28.2 | 53.4 |
| RAG | 34.7 | 48.0 | 26.9 | 62.2 |
| Mem0 | 36.6 | 37.8 | 21.8 | 40.0 |
| MemOS | 34.7 | 51.9 | 28.2 | 51.4 |
| OpenViking | 29.2 | 46.8 | 13.0 | 38.6 |
| RepoMemory | 17.6 | 18.7 | 11.6 | 9.6 |
| TriLink | 43.1 | 58.2 | 35.6 | 64.2 |
TriLink 在两个 backbone 上对最强记忆 baseline 分别提升 6.5 和 7.4 个点(Code),QA 提升 6.3 和 2.0 个点。
这张表里藏着几个比排名更有意思的现象。
两条赛道的故事不一样。Sonnet-5 下 Mem0 的 Code 比 RAG 高(36.6 vs 34.7),QA 却低了近 10 个点(37.8 vs 48.0);flash 下 RAG 的 QA(62.2%)几乎追平 TriLink(64.2%),Code 却被甩开 8.7 个点。只测「能不能说出来」或只测「能不能改对」都会误判记忆系统的真实能力——这是 CMB 双轨设计最直接的收获。
FullContext 的两副面孔。同一个原始历史,Sonnet-5 拿 58.8%,flash 只拿 28.2%——差了 30 个点,甚至低于 flash+TriLink 的 35.6%。原始历史有用,但「用得动它」本身是 backbone 能力的一部分。这也意味着:对弱模型,好的记忆系统可以反超直接塞全文。
消融:三层都不可少,但功劳簿不一样
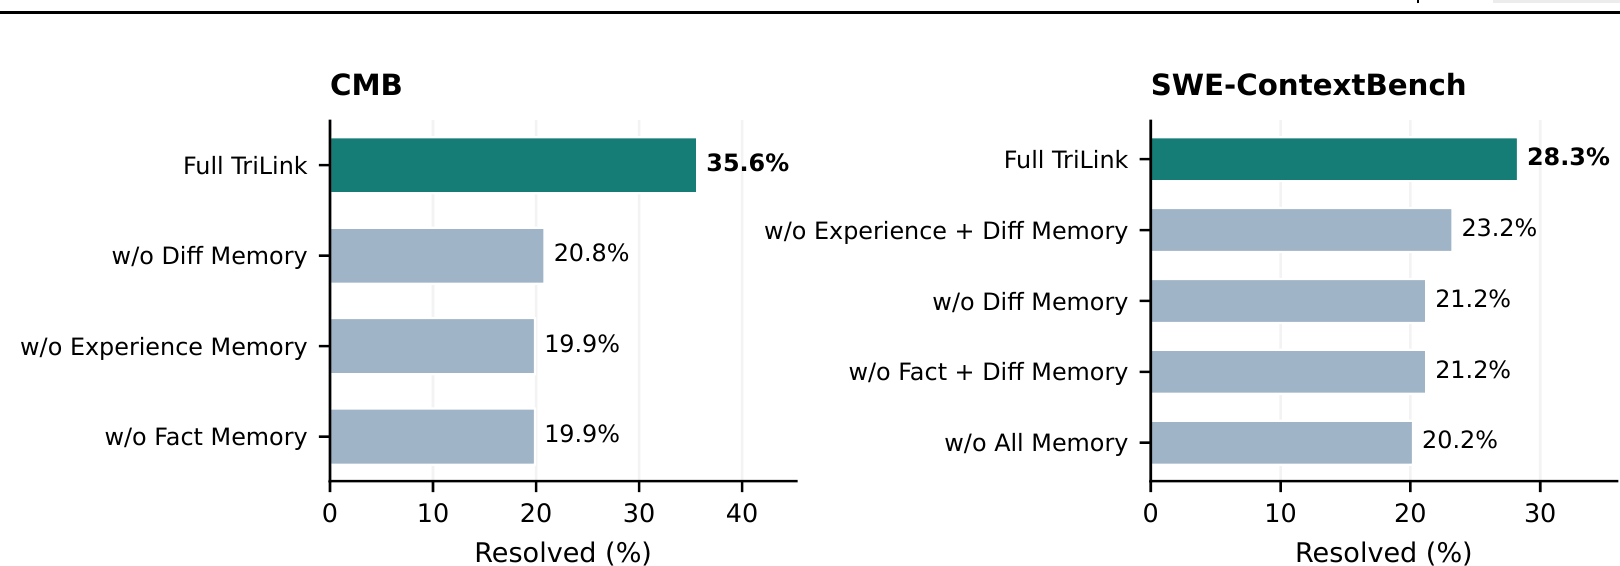
图 3:flash backbone 下逐层移除的结果——CMB 上拿掉任何一层都掉到 20% 上下;SWE-ContextBench 上 diff 层贡献最大
CMB 上移除 Diff、Experience、Fact 任一层,Resolved 从 35.6% 分别掉到 20.8%、19.9%、19.9%——一刀下去都是 15 个点。但分仓库看就精彩了:navidrome 上拿掉经验层从 30.0% 崩到 10.0%,tutanota 上拿掉 diff 层从 35.7% 崩到 7.1%,而聚合数字把这些差异全抹平了。
最扎眼的是 qutebrowser:三个消融变体全部跑赢完整 TriLink,拿掉经验层反而最高。论文没有回避这个反例,只说「部分检索到的材料可能无益」。我的猜测是:qutebrowser 的任务里经验检索带进了误导性内容,相关性门槛没能拦住。这说明 TriLink 的链接先验在部分仓库上是负资产——值得深挖,但论文止步于此。
还有一个诚实的细节:SWE-ContextBench 上「只有事实」(23.2%)高于「事实 + 经验无 diff」(21.2%)。多一层表示不必然带来提升,关键看检索链路怎么用它们。
修订深度:TriLink 的优势在最难处保持
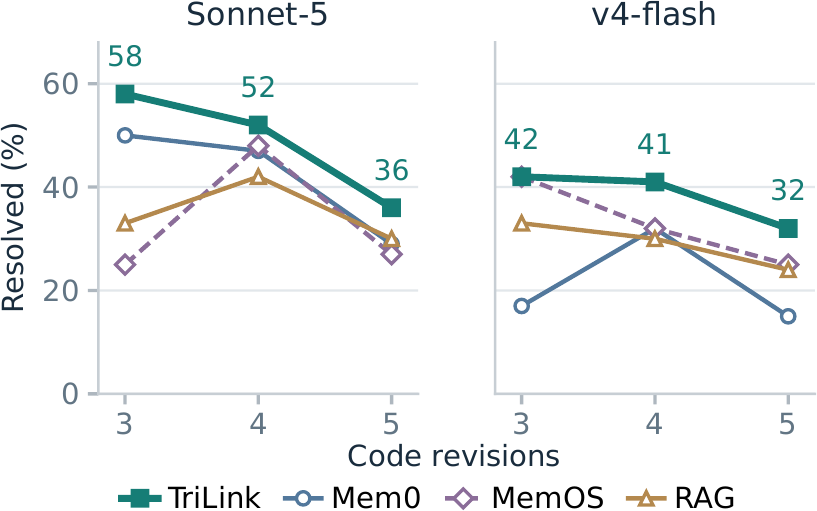
图 4:按任务最大修订数分组——TriLink(绿线)在 3/4/5 层修订下全面领先,5 层修订时优势仍保持
3、4、5 层修订组里,TriLink 在 Sonnet-5 下拿 58%、52%、36%,flash 下拿 42%、41%、32%。5 层修订组里最强 baseline 只有 30%(Sonnet-5 的 RAG)和 25%(flash 的 MemOS)。这正是设计目标命中的地方——历史里同时躺着多个看似合理的实现版本时,光检索到「对的话题」不够,得能区分出「对的版本」。diff 链在这里起的作用肉眼可见。
当然也要泼点冷水:从 4 层到 5 层,TriLink 在 flash 上掉了 9 个点,比 MemOS 的 7 个点掉得还狠。分层之间任务构成不同,不能解读成因果,但「修订越深大家越惨」是共性,离解决还远。
Token 效率:不是塞得越多越好
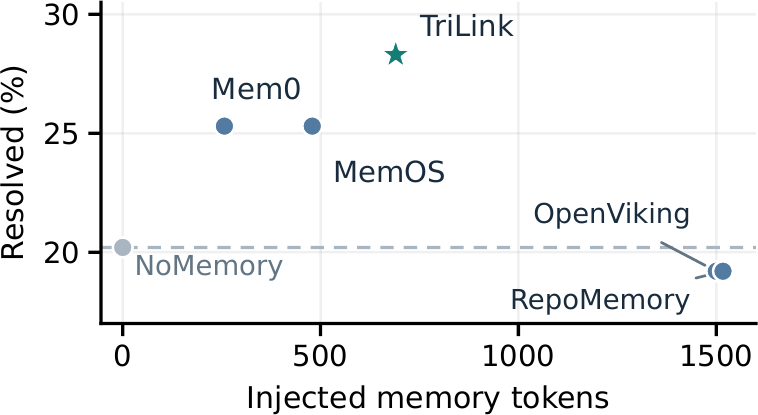
图 5:SWE-ContextBench/flash 上的注入量-效果散点——TriLink(星标)690 token 拿到 28.3%,OpenViking 和 RepoMemory 塞了约 1,500 token 反而低于 NoMemory 基线
这张图我觉得是全文最有工程分量的一张。RepoMemory 和 OpenViking 各注入约 1,500 token,Resolved 只有 19.2%——低于什么都不注入的 NoMemory(20.2%)。检索来的上下文如果帮不到下一步行动,存在本身就是负资产。TriLink 用不到它们一半的注入量(690 token)拿到 28.3%。Mem0 用 257 token、MemOS 用 479 token 拿到相同的 25.3%,多出来的 222 token 一分没多挣——注入量和效果之间没有单调关系,证据质量才是变量。
SWE-ContextBench:跨任务复用的外验
在 SWE-ContextBench Lite Related 的 99 个任务上(这个基准专测「相关 issue 的经验能不能复用」,从真实 GitHub issue/PR 依赖关系挖出来的任务链),TriLink 拿 47.5% 和 28.3%,压过最强对手(RepoMemory 45.5%、Mem0/MemOS 25.3%)。Test 级 F2P 上 Sonnet-5 下 TriLink 80.4% vs 最强 baseline 73.5%,差 6.9 个点。值得注意的是好几个记忆插件在这个基准上也跑不过 NoMemory——和 CMB 上的观察一致。
我的判断
CMB 的Benchmark设计是真功夫。交织会话 + 修订密集 + 冻结重放,这三个选择每个都直击现有评测的盲区,而且互相咬合:交织制造版本歧义,修订制造指代难题,冻结保证所有机制面对完全相同的输入。87% 决策点指向非最新版本这个数字,把「版本混乱」从一句抱怨变成了可测量的主考项。所有记忆机制最高 36.6% 的成绩单,对这个方向的现状是相当冷酷的刻画。
TriLink 是扎实的系统设计,但别把它读成机理突破。三层记忆 + 双向链接,拆开看每层都有先例(MemP 的经验蒸馏、MAGE 的执行状态树、仓库记忆里的 commit 复用),新意在于用 supersede 链和溯源链接把它们在更新时保持同步。消融证明这套组合有效,但 qutebrowser 反例和「层与层之间的链接本身没被单独消融」这两点,论文自己都承认了。
几个局限要放在心上。会话是合成的,由 Sonnet-5 生成——真实开发者会话的混乱程度大概率更高,分布也不一样;重放时提供的代码对象元数据帮了 diff 分组的忙,去掉它 TriLink 还稳不稳,论文明说没测;QA 打分依赖 LLM 裁判。另外 FullContext 在两个 backbone 间 30 个点的落差提醒我们:CMB 上记忆方法的得分,有一部分是 backbone 的「上下文利用能力」在兜底,跨 backbone 比绝对值要小心。
对工程的启发最直接的是 diff 层。如果你在给编码 agent 做记忆,摘要和向量库之外,把「具体改了哪几行、第几版」按分支 + 文件 + 符号结构化存下来、且不走 LLM 免费维护——这条从消融数据看是投入产出比最高的一层(CMB 上值 14.8 个点)。其次是教训:注入更多检索内容可能不如不注入,检索质量的门槛比召回量重要。
最后说句公道话:这个方向(编码记忆的可执行评测)以前一直缺一块硬地基,大家都在拿对话基准的分数讲编码的故事。CMB 把地基打上了。接下来值得盯的是两件事:真实会话(非合成)上这套结论是否成立,以及「层的链接」这个 TriLink 的核心假设被单独消融时的表现。
参考资料
- 论文 PDF:https://github.com/Tencent-Hunyuan/Hy-Memory/blob/main/docs/papers/CMB_A_Coding_Memory_Benchmark_for_Long_Horizon_and_Interleaved_Coding_Agents.pdf
- 开源仓库:https://github.com/Tencent-Hunyuan/Hy-Memory
- SWE-bench Pro:https://scaleapi.github.io/SWE-bench_Pro-os
- SWE-ContextBench:https://arxiv.org/abs/2602.08316
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我