蒸馏时被压下去的概率去了哪?RouteOPD 把 On-Policy 蒸馏重写为概率运输
On-policy 蒸馏(OPD)这套范式今年是真的火。学生自己写轨迹,老师逐 token 打分,既拿到了 RL 的 on-policy 状态覆盖,又拿到了蒸馏的稠密监督——Thinking Machines 那篇博客把这个 recipe 摆上台面之后,社区跟进的速度相当夸张。
但我一直有个拧巴的地方没想清楚:老师的反馈明明是整个词表上的分布,落到 sampled reverse-KL 这种高效实现里,却只剩一个标量——"这个 token 该抬还是该压,压多重"。问题在于,softmax 是归一化的,你压一个 token,释放出来的概率质量必然流向别的地方。流到哪去?标量信用不管这件事,它把这半边的决策权悄悄交给了学生自己的 softmax 几何。
这篇 RouteOPD 论文就是把这被忽略的另一半摆到了台面上。说实话,看到它的诊断数据时我愣了一下:sampled OPD 的"路由保真度"只有 35.4%——也就是说,被老师要求释放的概率质量,六成以上都流到了老师根本不想要的方向。
核心摘要:OPD 里高效的采样式目标把老师分布压缩成了单个 token 上的标量信用,"压多少"有答案,"压下去的质量给谁"没答案,缺的那半边由学生的 softmax 几何随手补上。RouteOPD 把这件事重写成一个显式的概率运输问题:把学生-老师分歧分解成"学生过剩源"和"老师亏缺目的地",配成显式运输对,在成对 log-odds 上向由共享有界势函数导出的、可联合实现的目标优化,预算随老师需求的集中度自适应。四个师生组合 × 四个数学推理基准上,平均提升 2.19 到 3.61 个点,routing fidelity 从 35.4% 拉到 90.4%,背景泄漏从 68.3% 压到 13.8%,而端到端开销只有 2.5%。这不是又一个调 loss 形状的工作,是把 OPD 的"每次更新到底在干什么"这件事讲清楚了。
论文信息 - 标题:Distillation as Probability Transport: Routed On-Policy Distillation - 作者:Tianle Xia、Ming Xu, et al. - 机构:腾讯
🎯 问题:标量信用只说了"压谁",没说"给谁"
先把 OPD 的标准姿势摆清楚。学生行为策略 \(\pi_{\mathrm{old}}\) 自己采样轨迹,在每个访问过的状态 \(s_t\) 上,冻结的老师给出词表分布。高效的 sampled reverse-KL 实现给采样到的 token \(a_t\) 一个 detached 优势:
然后按重要性比率加权做策略梯度。看起来很干净。但论文里的 Proposition 1 把这个更新的真实面目拆了出来——当 \(A_t(a_t) \lt 0\) 时,logit 空间里的负梯度方向是:
读懂这个式子很关键。被采样的 token 确实被压了(\(\mathbf{e}_{a_t}\) 那一项),但释放出来的概率质量去哪了?按学生当前的概率分布,平均摊给所有其他 token。老师想要的那个 token 如果学生当前概率低,它分到的补偿就最少;学生本来就偏爱的那些 token——哪怕老师完全不看好——反而吃得最多。
这就是论文说的 route under-specification:标量信用显式指定了再分配的"源",却把"目的地"留给了学生几何。这个缺失不是中性的,它每次更新都在发生。

图 1 的比喻挺到位:左边的小人把积木从溢出的杯子里拿出来,然后一脸懵地随手撒向其他杯子;右边的小人按清单把积木从"过剩源"搬到"亏缺目的地"。下面两组数字是全文结论的浓缩——四组实验平均 Avg@16 提升 2.19 到 3.61 个点,同时 routing fidelity 35.4% → 90.4%、background leakage 68.3% → 13.8%。
🏗️ 方法:把蒸馏重写成一个局部运输问题
RouteOPD 的核心想法一句话就能说完:老师和学生在一个状态上的分布分歧,是一个守恒的运输问题——从学生过剩的 token 上拿走的质量,应该送到老师亏缺的 token 上去。但把这句话变成一个可优化、可证明、开销可控的算子,需要三层设计。

第一层:稀疏支撑上的过剩/亏缺分解
在每个学生访问状态,先构造一个稀疏共享支撑:学生和老师各自 top-k 的并集 \(\mathcal{U}_t\)(默认 k=32),两个分布分别在这个并集上重新归一化得到 \(p_S\) 和 \(p_T\)。然后定义:
\(e_t\) 是学生过剩的源,\(d_t\) 是老师亏缺的目的地。漂亮的地方在于,因为两个分布都归一化,两边的总质量严格相等:\(M_t = \sum_a e_t(a) = \sum_b d_t(b)\),恰好等于两个分布的 TV 距离。分歧小的状态(\(M_t \le \delta_M\))直接跳过,不施加路由损失。
第二层:最大熵耦合采样显式路由
把 \(e_t\)、\(d_t\) 各自归一化成边际分布 \(q_t^-\)、\(q_t^+\),然后用独立乘积耦合 \(\Gamma_t(a,b) = M_t\, q_t^-(a) q_t^+(b)\) 连接两边。这个选择值得说两句:它没有去做 Sinkhorn 之类的最优运输求解,而是取固定边际下的最大熵耦合——边际精确保持、无需物化 \(k^2\) 的稠密耦合表、采样 m 条路由(默认 m=2)就是无偏估计。说实话我第一反应是"为什么不上 OT",但想了一下,这里运输成本矩阵本身就是要被学出来的东西,没有先验的 ground cost,最大熵耦合反而是最不带额外假设的选择。附录 A.2 把边际守恒和无偏性都证了。
第三层:可联合实现的成对目标
有了路由 \((a, b)\),学习目标是什么?RouteOPD 选择的是成对 log-odds 的变化量:
它的 logit 梯度是 \(\mathbf{e}_b - \mathbf{e}_a\)——log-softmax 的共享背景项正好消掉,无关 token 的直接梯度为零。这就是论文说的 direct-logit locality,和 sampled OPD 那个 \(\pi_{\mathrm{old}} - \mathbf{e}_{a_t}\) 的全词表摊派形成鲜明对照。
但多条采样路由凑在一起会冒出一个微妙的一致性问题:如果每条边的目标独立 clip,四条边 \(D_{11}+D_{22} = D_{12} + D_{21}\) 这种环一致性就可能被破坏——独立 clip 下实验实测有 27.6% 的四环违反率——这些目标根本不存在一组能同时实现它们的 token 分数。RouteOPD 的解法是让所有目标都从同一个有界势函数派生:
其中 \(g_t(v)\) 是老师-学生的对数概率差(带概率下限截断)。所有边共享一个势,环一致性自动成立,目标天然可联合实现。
最后还有一手自适应预算:用老师亏缺需求的归一化 Herfindahl 集中度 \(c_t\) 调节预算 \(B_t = B_{\min} + (B_{\max} - B_{\min}) c_t\)(\(B_{\min}=\log 1.2\),\(B_{\max}=\log 1.5\))。老师的需求越集中,目的地越明确,就允许越大的修正力度;需求发散时保守一点。这个设计直觉上很对——老师自己都犹豫不决的状态,本就不该下重手。
最终 token 级损失就是 Huber 化的残差:\(\mathcal{L} = M_t\, \mathbb{E}_{q^- \times q^+}\left[h_\kappa\left(\Delta_t - \widehat{D}_t\right)\right]\)。工程上它复用已打分的老师 logits,不增加额外的 teacher forward,top-k 之后每个有效 token 的路由开销只有 \(O(k+m)\)。
🧪 实验:四组师生配置全面压过 sampled-RKL
实验配置的覆盖面不错:四个师生对横跨 Qwen3、DeepSeek、Nemotron 三个谱系(Qwen3-4B-GRPO → Qwen3-1.7B、JustRL-DeepSeek → R1-Distill-Qwen-1.5B、JustRL-Nemotron → OpenMath-Nemotron-1.5B、R1-Distill-Qwen-7B → R1-Distill-Qwen-1.5B),基准是 MATH500、AMC23、AIME24、AIME25,统一 Avg@16 精确答案准确率。训练数据统一 DAPO-Math-17K,AdamW(lr 1e-6),BF16 + FSDP,24 张 H20,每 prompt 采 4 条响应、温度 1.0、最长 16384 token。所有可训练 arm 共享 rollout 种子、teacher 调用和更新预算——对比是干净的。
| 方法 | MATH500 | AMC23 | AIME24 | AIME25 | 平均 |
|---|---|---|---|---|---|
| Qwen3-4B-GRPO → Qwen3-1.7B | |||||
| 学生(未蒸馏) | 45.31 | 11.67 | 1.46 | 1.04 | 14.87 |
| Sampled-RKL OPD | 70.18 | 37.65 | 11.25 | 6.67 | 31.44 |
| 全词表 RKL | 70.86 | 39.16 | 12.08 | 7.29 | 32.35 |
| 固定中值路由 | 70.63 | 39.46 | 11.88 | 7.50 | 32.36 |
| RouteOPD | 71.48 | 42.85 | 13.33 | 7.50 | 33.79 |
| JustRL-DeepSeek → R1-Distill-Qwen-1.5B | |||||
| Sampled-RKL OPD | 86.63 | 85.47 | 48.13 | 33.13 | 63.34 |
| 全词表 RKL | 87.51 | 86.14 | 49.38 | 34.58 | 64.40 |
| 固定中值路由 | 87.31 | 86.45 | 50.21 | 33.75 | 64.43 |
| RouteOPD | 88.08 | 86.75 | 52.50 | 34.79 | 65.53 |
| JustRL-Nemotron → OpenMath-Nemotron-1.5B | |||||
| Sampled-RKL OPD | 93.21 | 96.54 | 68.96 | 60.21 | 79.73 |
| 全词表 RKL | 93.13 | 96.23 | 73.54 | 65.63 | 82.13 |
| 固定中值路由 | 93.28 | 96.08 | 74.38 | 65.21 | 82.24 |
| RouteOPD | 93.53 | 96.08 | 75.83 | 67.92 | 83.34 |
| R1-Distill-Qwen-7B → R1-Distill-Qwen-1.5B | |||||
| Sampled-RKL OPD | 88.24 | 70.93 | 30.63 | 24.58 | 53.59 |
| 全词表 RKL | 88.63 | 72.89 | 32.71 | 26.04 | 55.07 |
| 固定中值路由 | 88.81 | 72.67 | 32.50 | 26.25 | 55.06 |
| RouteOPD | 88.93 | 74.62 | 33.96 | 27.50 | 56.25 |
几个点值得拆开看。一是相对 sampled-RKL 的平均提升 2.19 到 3.61 个点(均值 2.70,配对 bootstrap 区间 [2.28, 3.13] 严格为正)。二是它还稳超全词表 reverse KL 平均 1.24 个点——这个对照很重要,说明收益不是"因为拿到了稠密老师分数",稀疏路由版本反而更好。三是提升不是弱学生地板效应:最强的 OpenMath-Nemotron 学生从 79.73 涨到 83.34,高基数上照样涨 3.61 个点,而且涨的主要在 AIME 这种硬基准上。
坦率的讲,2.7 个点的平均增益不算炸裂。但结合后面的机制诊断看,这篇论文的价值本来就不全在刷分上。
🔬 机制验证:目的地身份才是因果变量
这是我觉得全文最值钱的部分。作者没有停留在"我们的方法涨了",而是设计了一组配对干预实验,把"显式路由为什么有用"拆成三个决策逐一验证。
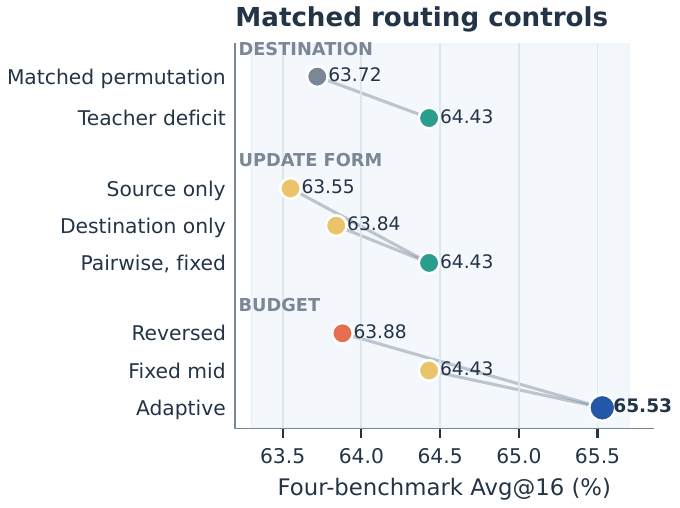
目的地身份是真的重要。把目的地换成排名/频率匹配的置换 token(保持一切其他因素不变:源身份、目标幅度、耦合权重、名义预算),准确率从 64.43 掉到 63.72;换成随机背景 token,进一步掉到 62.72。更新形式也有讲究:只压源 63.55,只抬目的地 63.84,成对更新才是 64.43——两端必须一起修。预算那块,自适应 65.53 对固定中值 64.43,而把集中度规则反过来用(需求越散预算越大)只有 63.88。更有意思的是分层分析:自适应减固定的差值随老师需求集中度从低到高分别是 -0.10、+0.40、+1.30、+2.70 个点——自适应预算的收益几乎全来自需求集中的状态,低集中度下甚至略亏。这个诚实的结果比一句"自适应更好"有信息量得多。
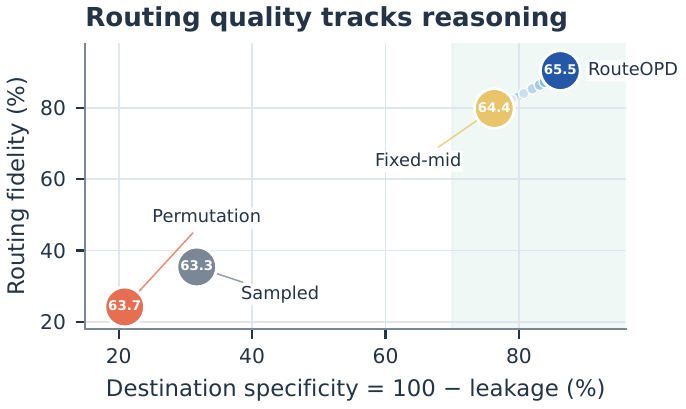
图 4 把同样的干预放进"保真度-特异性"空间,因果链的图景就很完整了:sampled-RKL 的保真度 35.4%、泄漏 68.3%,垫在左下角;置换目的地把指标进一步搞坏(24.2% / 79.1%);固定预算的老师亏缺路由跳到 79.8% / 23.7%;自适应 RouteOPD 到 90.4% / 13.8%。而且这不是少数幸运状态的均值幻觉——1024 个固定诊断状态上,RouteOPD 的中位保真度 92.7%,连十分位数都有 76.5%,sampled-RKL 中位数才 33.1%。
作者还做了一组很硬核的 direct-logit 探针:理想 logit 位移下保真度能到 96.8%(逐对)/ 98.4%(全势),经过真实优化器一个 minibatch 后新鲜 AdamW 还剩 90.4%——softmax 归一化和共享参数确实会磨掉一部分理想几何,但大头保留下来了。
📊 训练动态与成本:Pareto 膝点上的稀疏路由
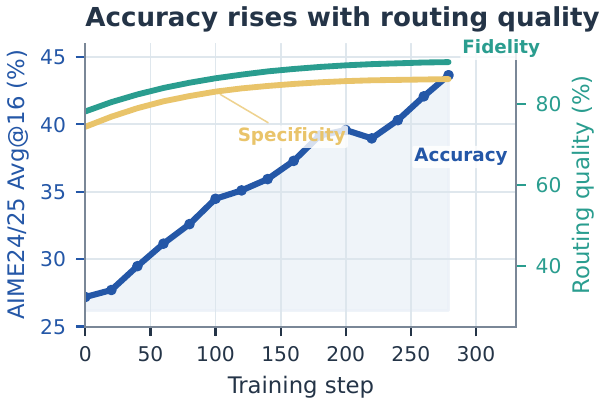
图 5 显示路由签名是随训练全程涌现的:AIME24/25 的 Avg@16 从 27.19 一路爬到 43.65,保真度和特异性同步上升后饱和,不是某个孤立 checkpoint 的运气。附录里还有些让人安心的稳定性指标:梯度范数三种方法收敛到相似水平;可做路由更新的有效 token 比例从 84.1% 升到 93.4%;策略熵朝老师的端点(1.310)移动,而不是像 sampled-RKL 那样往上飘。
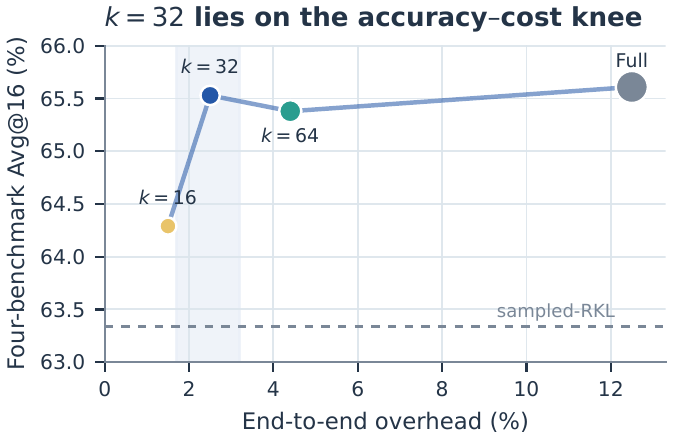
效率这块的数字相当能打。k=32 的稀疏并集保留了学生 97.79%、老师 97.13% 的概率质量(符号一致率 96.38%),端到端开销只有 2.5%,准确率 65.53;全词表路由开销 12.5%,准确率 65.61——多花五倍成本换 0.08 个点,完全不值。路由条数 m 的消融也有意思:m=1 目标覆盖率从 76.8% 掉到 58.4%,m=4/m=8 方差是小了但准确率反而掉到 62.48/61.12——估计器方差和目标覆盖选择性之间存在一个真实的 trade-off,m=2 是甜点。
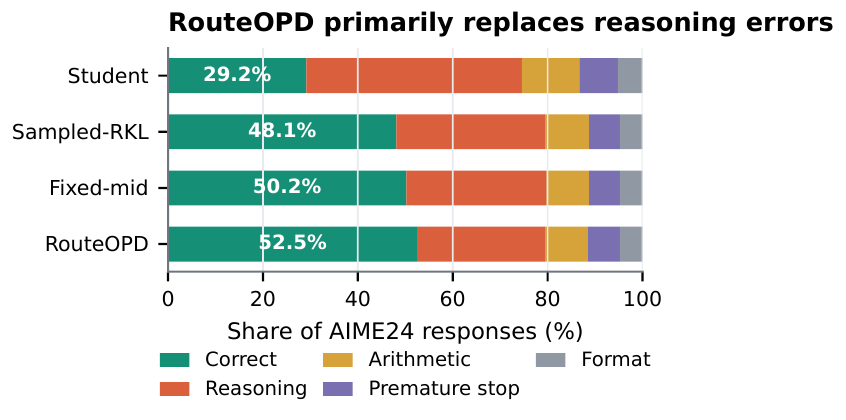
行为层面的收尾分析回答了"涨的分从哪来"。AIME24 上正确回答占比从 sampled-RKL 的 48.1% 升到 52.5%;480 条配对回答里,RouteOPD 把 42 条 sampled-RKL 的错误修复为正确(只损失 21 条原本正确的),而这 42 条里 34 条是推理错误、5 条算术错误、2 条提前停止、1 条格式错误。修的是推理,不是格式。格式有效性保持 95.21%,截断率还从 4.47% 降到 2.34%。错误标注由固定 LLM judge 做两轮盲评,原始一致率 92.4%,Cohen's κ 为 0.864,标注质量本身是可信的。
💡 我的判断
这篇论文的定位要看清楚:它不是又一个"我们的 OPD 变体涨了 X 个点"的工作,而是给 OPD 的每次更新做了一次解剖。标量信用只指定再分配的源、目的地由学生几何随手填充——这个观察本身就值回票价,35.4% 的 routing fidelity 实测数据更是直接把这个隐忧钉死在墙上。
亮点有三个。第一,问题定义干净,概率守恒的运输视角把"蒸馏在一个状态上到底该做什么"说清楚了。第二,机制验证的方法论扎实——配对干预、固定诊断状态库、direct-logit 探针、分层预算分析,每一层都在隔离单个变量,比大多数消融堆砌的论文严谨得多。第三,工程账算得明白:2.5% 开销换几乎全部收益,自适应预算在低集中度状态下略亏也如实报告。
问题也得说。一是增益幅度——平均 2.7 个点是稳定但温和的提升,如果你期待的是数量级变化,这篇给不了。二是所有实验都在数学推理上,师生必须共享分词器,跨模态、agentic 长程任务上的适用性还是未知数——虽然附录讨论了 tokenizer 兼容性检查,但没有实际跑跨词表设置。三是最大熵乘积耦合是个"最不带假设"但也"最不带结构"的选择,源和目的地的配对是纯随机配的,如果引入某种成本矩阵(比如语义距离)做结构化耦合,会不会还有空间?论文没回答。四是 m=2 甜点背后的方差-覆盖 trade-off 只在一个配置上验证过,迁移性待考。
对工程实践的建议很直接:如果你在用 sampled OPD / GKD 式的逐 token 标量信用做蒸馏,值得检查一下你的"概率质量流向"——论文的诊断方法(固定状态库 + 保真度/泄漏测量)本身就可以拿来给自己的训练做体检。然后,如果诊断结果跟这篇论文一样难看,RouteOPD 这套东西实现成本很低(复用老师 logits,\(O(k+m)\) 开销),值得试。
从更大的图景看,今年 OPD 这条线的论文爆发式增长——改目标的、改时机的、改数据选择的都有,RouteOPD 占的是"改目的地"这个正交的生态位。它和 TurnOPD、TIP 这类"在哪儿蒸馏"的工作理论上可以直接组合,这个组合实验如果有人做出来,我会很感兴趣。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我