烧掉 12124.4 卡时后,结论有点扎心:十种自蒸馏新方法,大多打不过 GRPO
你有没有刷到过这种朋友圈式的论文标题——"我们的方法在 XX 基准上超过 GRPO 九个点"?过去半年,智能体强化学习里的自蒸馏方向就是这种画风:新预印本平均每两天冒出一篇,每篇都说自己涨了。但问题是,它们各自的基线分数大多是从别人论文里抄来的,训练预算不一样、评测协议不一样、模型版本也不一样。这些涨分到底有多少是真的,有多少是评测口径差异带来的错觉?
这篇论文(arXiv:2610.19789)干了一件我一直觉得该有人干、但没人愿意花钱干的事:把十个代表性的自蒸馏方法和 GRPO 拉到同一套环境里,用 4 个基准、3 档模型规模、132 次训练、2772 轮训练期验证、1152 轮八随机种子评测,总共烧了 12124.4 小时的 H800 卡时,老老实实地重新跑了一遍。
结论用一句话说:方法更多了,智能体并没有更强。
核心摘要
这是一篇评测基准论文,而不是新方法论文。作者把 2026 年以来智能体 RL 自蒸馏方向的十个代表性方法(SDAR、Skill-SD、PCSD、OCSD 等)与 GRPO 放在统一协议下横评,发现三个相当打脸的结论:其一,十个方法里只有 PCSD(十二配置均值 54.26,高 4.58 分)和 AgentOPSD(51.34,高 1.66 分)的汇总表现超过 GRPO 的 49.68,其余八个全线低于基线;其二,最终分数高不代表训练稳,有方法中途崩到接近零分再爬回来,光看终点根本发现不了;其三,120 组对照里有 112 组新方法比 GRPO 更耗时,其中 58 组还跑得更差。说实话,这个结果比我预期的还要冷。如果你正在考虑给 agent 训练加自蒸馏,这篇值得完整读一遍再动手。
论文信息
- 标题:More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning
- 作者:Linhao Zhong, Bozhen Fang, Xuehao Wang, Duochao Shi, Zekai Luo, Guangming Yao, Yi Yuan, Hao Chen, Jingdong Chen, Chunhua Shen
- 提交时间:2026 年 10 月 14 日
- 链接:https://arxiv.org/abs/2610.19789
- 项目主页:https://aim-uofa.github.io/Self-Distillation-AgentRL/
🎯 问题动机:涨分满天飞的背后,是评测的三种缺失
先交代一下这个领域在做什么。LLM 智能体通过多轮动作和观察跟环境交互,纯 RL(比如 GRPO)只给整条轨迹一个稀疏的结果奖励,对中间每一步决策几乎没有指导。于是出现了同策略自蒸馏(On-Policy Self-Distillation, OPSD)这条路:让一个教师分支在训练时看到学生看不到的特权信息(比如标准答案、检索到的技能总结),对学生的轨迹给出密集的 token 级监督,部署时学生只用普通上下文。
这个思路听起来很合理,论文也确实井喷。但作者做了个小审计,把十个方法的来源论文翻了一遍,检查三个维度——是否做了重复评测、是否分析过训练失败、是否报告实测计算成本。结果是:十个里面只有 1 家报告了重复评测,5 家做过训练失败分析,3 家报告了实测成本。没有一家三个都覆盖。
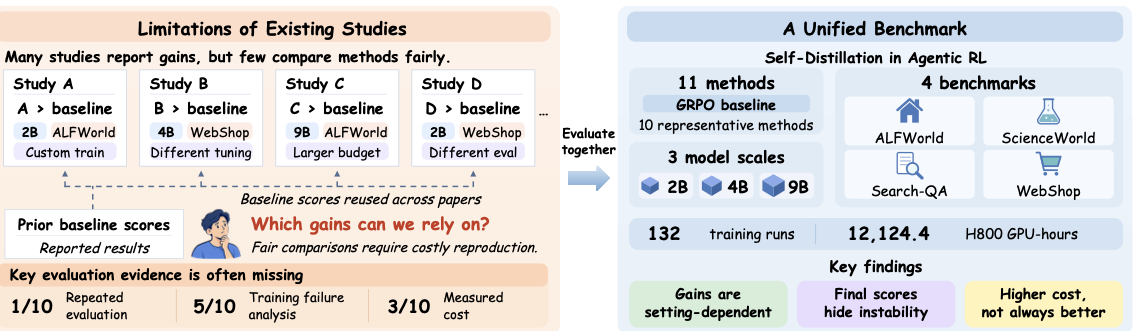
图1:论文概览。左侧是现有研究的三个窟窿——各家基线分数互相复用、重复评测与失败分析普遍缺失;右侧是这篇论文搭的统一基准:11 个方法、4 个基准、3 档模型规模、132 次训练、12124.4 小时 H800 卡时,以及三个核心发现。
你想想看,这个缺口有多要命。A 论文在 2B 模型上训练 ALFWorld 说自己涨了,B 论文在 9B 模型上换个评测集也说自己涨了,两边连训练步数都不一样。把这些结果放在一起看,根本分不清哪些是方法本身的贡献,哪些是训练条件和采样运气。而复现一次 agent 训练又贵得离谱,每篇新方法论文自己搭不起系统对比,于是大家都在引用别人的旧数字——误差就这么一代代传下去。
作者的态度很明确:这个节骨眼上,独立评测比再提一个方法更值钱。当务之急是搞清楚哪些方法值得作为后续研究的地基。
🏗️ 基准设计:同一口锅里重新煮一遍
这次横评的配置可以用一张表说清楚:
| 维度 | 配置 |
|---|---|
| 参照基线 | GRPO(纯结果奖励) |
| 对比方法 | GRPO+OPSD、SDAR、Skill-SD、ICSD、PCSD、RLSD、OCSD、AgentOPSD、ADRS、OVCSD,共 10 个 |
| 基准任务 | ALFWorld(140 局家务任务,成功率)、ScienceWorld(200 个科学实验任务,任务分)、WebShop(128 个购物目标,得分与成功率)、Search-QA(3125 题检索问答,精确匹配) |
| 模型规模 | Qwen3.5-2B / 4B / 9B,组成 12 个模型—任务配置 |
| 训练协议 | 每配置训 100 个全局步,每 5 步验证一次 |
| 评测协议 | 温度 0.4,8 个 rollout 随机种子,报告均值和样本标准差 |
十个方法按机制可以分成四类。这个分类后面看结果的时候有用:
| 机制类别 | 方法 |
|---|---|
| 加辅助蒸馏目标 | Skill-SD、GRPO+OPSD、SDAR、ICSD、PCSD |
| 用教师信号调制优势 | RLSD、OCSD、AgentOPSD |
| 奖励与优势塑形 | ADRS |
| 加入环境验证过的教师续跑轨迹 | OVCSD |
有一点值得肯定:所有方法评测时都不带教师的特权上下文,保证了部署条件公平;各方法的特有超参数参考原论文和公开实现设定,不是故意调残。这个协议设计得相当克制——它要的回答的问题只有一个:同样的锅、同样的灶,谁的菜真的更好吃。
📊 发现一:方法多了,广泛进展没来
主结果两张表一共 12 个配置、12 行方法,数字非常密。我把最关键的 Overall 列抽出来看。
ALFWorld 成功率(%):
| 方法 | 2B | 4B | 9B |
|---|---|---|---|
| GRPO | 28.48 | 82.05 | 62.68 |
| GRPO+OPSD | 22.23 | 1.52 | 71.79 |
| SDAR | 14.46 | 76.16 | 75.62 |
| Skill-SD | 74.29 | 55.27 | 74.55 |
| RLSD | 46.61 | 84.38 | 89.20 |
| OCSD | 42.32 | 52.32 | 86.16 |
| OVCSD | 56.96 | 76.43 | 83.39 |
| AgentOPSD | 47.50 | 75.00 | 78.04 |
| ADRS | 13.04 | 70.71 | 78.93 |
| ICSD | 54.73 | 82.50 | 89.64 |
| PCSD | 72.32 | 79.82 | 72.77 |
Search-QA 精确匹配(%)与 WebShop 成功率(%)的 Overall 数字同样精彩,比如 WebShop 上 GRPO+OPSD 三个规模全部领先(77.05 / 77.15 / 74.90),而 Skill-SD 和 RLSD 在 4B 和 9B 的 WebShop 上直接拿到 0.00%——一个任务都没做成。
把十二个配置等权平均之后,全场排名是这样的:
| 排名 | 方法 | 十二配置均值 | 相对 GRPO |
|---|---|---|---|
| 1 | PCSD | 54.26 | 高 4.58 分 |
| 2 | AgentOPSD | 51.34 | 高 1.66 分 |
| 3 | GRPO | 49.68 | — |
| 4 | OCSD | 49.50 | 低 0.18 分 |
| 5 | RLSD | 46.54 | 低 3.14 分 |
| 6 | SDAR | 46.33 | 低 3.35 分 |
| 7 | OVCSD | 46.17 | 低 3.51 分 |
| 8 | ICSD | 44.75 | 低 4.93 分 |
| 9 | ADRS | 44.61 | 低 5.07 分 |
| 10 | GRPO+OPSD | 43.05 | 低 6.63 分 |
| 11 | Skill-SD | 39.45 | 低 10.23 分 |
说实话看到这个表我愣了一下。十个新方法,每个都在自己的论文里报告过涨点,但拉到统一协议下,只有两个的汇总分超过了纯结果奖励的 GRPO。
更扎心的是胜出次数的误导性。ICSD 在十二个配置里有七个赢了 GRPO,听起来很不错对吧?但它的均值反而低了将近 5 分。为什么?因为它在 4B WebShop 上训出一个 0.00% 成功率的模型——这种崩盘式的失败在"赢了几场"的统计里跟一个点的惜败是等权的。GRPO+OPSD 同理,赢了六个配置,均值却只有 43.05,4B ALFWorld 上成功率 1.52%。按场次计分会把"小输"和"全军覆没"混为一谈,这是只看论文摘要里的 win rate 很容易踩的坑。
还有一个细节:十二配置均值最高的 PCSD,居然没有任何一个单独配置排名第一,对 GRPO 也只是六胜五负一平。各配置的领跑者换来换去——ALFWorld 三个规模的领头羊分别是 Skill-SD、RLSD、ICSD,WebShop 全程被 GRPO+OPSD 占据,ScienceWorld 的 9B 冠军干脆就是 GRPO 自己。选"总均分最高的方法"和"给你的具体场景选方法",完全是两回事。
🔬 发现二:终点分高,不等于路上没翻过车
这是我个人觉得全文最有价值的一节。大多数论文只报最终分数,但训练过程稳不稳,直接决定了你复现时要踩多少坑。
作者对全部 132 次训练每 5 步做一次验证,画了 12 张曲线图,并用验证曲线下面积(AUC)衡量整个训练过程的持续表现。
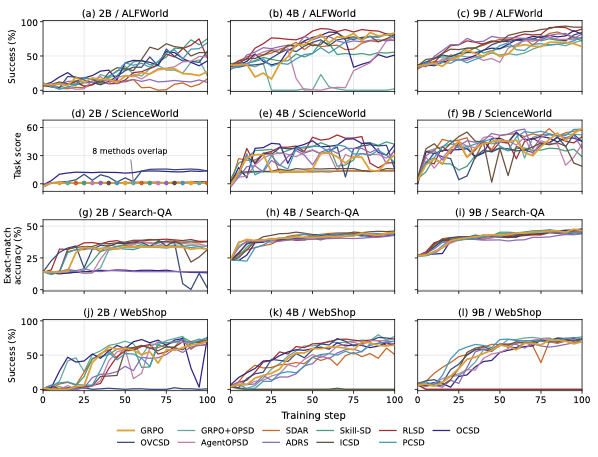
图2:12 个模型—任务配置、132 次训练的验证曲线全集。可以直观看到 2B ScienceWorld 上多数方法挤在同一个低分平台(图中标注 8 methods overlap),以及 WebShop 上多条曲线断崖式跌到零。
把 AUC 排名和最终分排名摆在一起,错位相当明显:
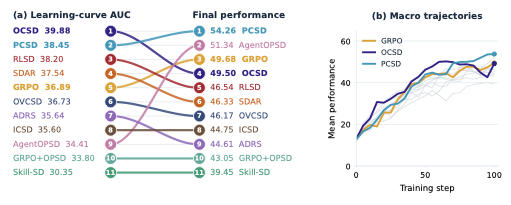
图3:左图是学习曲线 AUC 排名到最终表现排名的流向图。OCSD 以 39.88 的 AUC 排名第一但最终分只排第四;AgentOPSD 最终分第二,AUC 却掉到第九(34.41),连 GRPO 的 36.89 都不如。
AgentOPSD 这个错位特别值得琢磨:最终表现全场第二,训练过程却排在倒数第三。一个终局很强的模型,可能是从一条相当难看的训练轨迹里爬出来的。看两个具体案例:
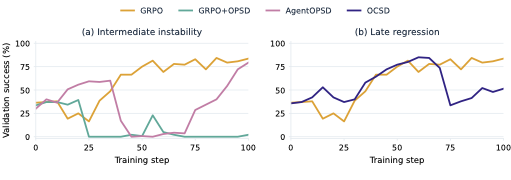
图4:左图是 4B ALFWorld 上的中途不稳定——AgentOPSD 在第 35 步达到 60.0% 验证成功率,第 45 到 70 步的六次评测全部不超过 4.3%,最后又在第 100 步爬回 79.3%;同配置下 GRPO+OPSD 第 20 步摸到 39.3% 后跌到零,再没起来。右图是后期退化——OCSD 在第 60 步到达 85.0% 的峰值后一路回落到 51.4%。
全基准统计下来,有 9 次运行的终点比自己的峰值低了至少 20 分。9B ScienceWorld 上的 ICSD 从 55.23 的峰值掉到 18.77,最后三次验证平均只有 26.99——这不是最后一次测量手气差,是持续的后期退化。
我自己的体会是,做 agent 训练的人多少都撞过这种曲线:reward 还在涨,中间某段突然崩掉,运气好能爬回来,运气不好就躺平了。只看终点分数,你根本不知道自己买的是一个稳定方法还是一张彩票。
💰 发现三:多花的卡时,并没有变成分数
第三个发现直接关系到钱包。相同训练步数不等于相同成本——各方法的 rollout 长度和教师计算量差很多。作者把所有运行的实测耗时记了下来,和最终表现画在同一张图上。
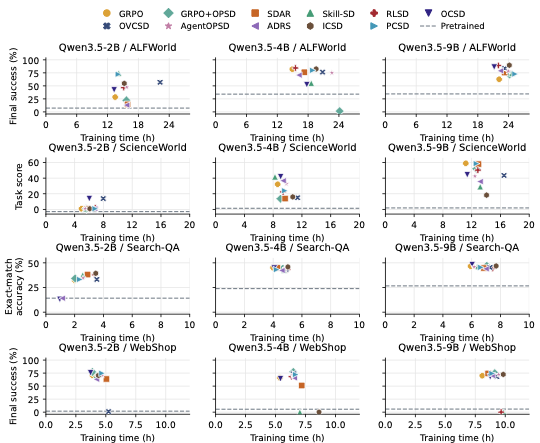
图5:横轴训练时间(小时),纵轴最终表现,虚线是预训练模型。注意大量新方法的点落在 GRPO 的右下方——花更多时间,拿更低分数。
统计数字很冷:120 组与 GRPO 的配对比较里,112 组新方法需要更长的净训练时间;这 112 组里有 58 组表现反而更低,另有 7 组打平。连仅有的两个赢家都不便宜——PCSD 和 AgentOPSD 相对 GRPO 的平均耗时比分别是 1.17 倍和 1.19 倍。
再换一个更苛刻的算法:以每次 GRPO 运行的净训练时间为预算上限,看各方法在这个时间预算内能拿到什么成绩。结果出现了逆转——ALFWorld 上 AgentOPSD 在第 100 步有 68.10% 的平均成功率,但卡进 GRPO 的时间预算后只剩 37.63%,被 GRPO 的 58.10% 反超;WebShop 上 PCSD 从 73.17% 掉到 63.83%,同样输给 GRPO 的 68.20%。
固定步数下的优势,在固定时间预算下可能整个消失。这个视角在论文对比里几乎没人做,但对你的 GPU 账单来说,这才是真实的问题。
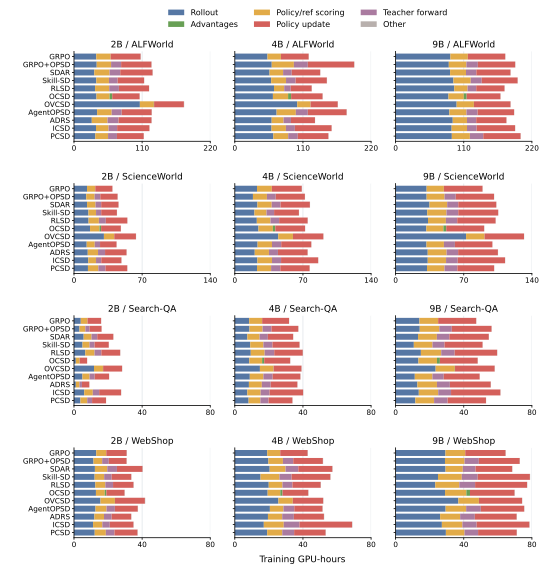
图6:各方法在各配置上的 GPU 卡时拆解——rollout、优势计算、教师打分、策略更新、教师前向等阶段。可以清楚看到带教师分支的方法多出来的开销主要堆在 teacher scoring 和 teacher forward 上,9B ALFWorld 上单次训练普遍超过 200 卡时。
🤔 我的判断:这篇论文到底怎么样
先说它最值钱的地方。它回答了一个被整个社区默契回避的问题:那些各自宣称涨点的方法,放在一起到底谁行?答案是大部分不行。而且它不是简单地说"都不行",而是把失败拆成了三个可操作的维度——汇总一致性、训练稳定性、成本有效性。以后再看任何一篇自蒸馏新方法的论文,你都有了三个追问的角度:重复评测做了吗?训练曲线敢放吗?多花的卡时值吗?
再说一个需要客观看待的点。被横评的方法里,有些在自己的论文里报告过相当漂亮的数字,比如 SDAR 原文宣称在 ALFWorld 上比 GRPO 高 9.4 个点、WebShop 高 10.2 个点,而这次统一评测里 SDAR 的汇总均值反而低于 GRPO。这不等于原论文造假——两边用的模型版本不同(原文是 Qwen2.5/Qwen3 系列,这里是 Qwen3.5)、任务配置不同、训练预算也不同。但这恰恰印证了这篇论文的核心论点:跨论文的数字对比本身就是不可靠的,收益对环境条件的敏感程度远超多数人的直觉。你很难说清原论文的涨分里,多少来自方法,多少来自那个特定的训练配置。
局限也有。三个模型规模都出自同一个 Qwen3.5 系列,结论能否迁移到其他架构的 backbone 没有答案;每个配置只训 100 步,长程训练下方法间的相对排名会不会变化,论文没有覆盖;另外 Search-QA 第 100 步验证与最终重复评测之间存在解码相关的差异,论文把它放进了附录讨论,说明作者自己也意识到评测口径的微妙之处。坦率的讲,这些问题更多是资源约束下的必然取舍,不是方法论缺陷。
对工程实践的直接启发,我提炼三条:
- 先把 GRPO 调到位,再谈自蒸馏。纯结果奖励基线在多数配置里依然是全场最强或接近最强,而且最稳、最便宜。自蒸馏不是免费午餐,是加钱买一个不稳定的期权。
- 看训练曲线,别看终点。选型时要求看完整验证曲线和峰值到终点的落差,终点前 20 分的退化在论文表里是完全隐形的。
- 用时间预算做对比,而不是步数。固定 100 步对比对 rollout 长、教师开销大的方法天然有利。按 wall-clock 或卡时对齐之后,排名可能整个翻转。
📚 收尾
一个领域出方法的速度越快,越需要有人停下来搭秤。这篇论文就是那杆秤——它不酷,没有新 loss、新架构,但它花的 12124.4 卡时买到了整个方向最缺的东西:可比性。我的判断是,它会成为接下来一两年智能体 RL 自蒸馏论文绕不开的基准,而"方法更多≠智能体更强"这个冷冰冰的结论,大概率会逼着下一批新方法把重复评测、训练曲线和成本表当成标配。
如果你也在做 agent 后训练,这篇的附录比正文还值得翻——2772 轮验证和 1152 轮评测的完整记录都在里面。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我