学生走了,老师的话还没听完:R-OPD 给 On-Policy Distillation 重排课程表
核心摘要
On-Policy Distillation(OPD)现在是各家小模型后训练的标配:学生自己采样,老师逐 token 打分,reverse KL 做损失。大家的默认直觉是——rollout 越新鲜越好,数据越多越好,最好每一步都重新采样。这篇论文把这个直觉直接干翻了:在预算严格对齐的条件下,用训练前那版"旧学生"采的 rollout 做训练,在 32K 长预算下反超"新鲜"的 current-policy rollout 4.39 个点,而且这个反转在两个不同老师身上都成立。原因藏在一个被忽视的缝隙里:学生 evolves 之后,早期 prefix 被访问的概率掉到几乎为零(99.15% 的 prefix 变得更不可能),但学生对老师在这些 prefix 上的预测还没学完——分歧还在,只是没人再去看这些状态了。作者的方案 R-OPD 简单到有点朴素:先用 current-policy 训练,用梯度漂移自动判断什么时候"学不动了",然后切回初始 rollout bank 重放。0.6B/1.7B/8B 三个尺寸、八个数学基准上全部涨分,32K 下比固定课程表还多 1.39~1.85 个点。 这是一篇典型的"把被大家忽略的时间维度拎出来"的机制论文,做蒸馏的人都该看看。
论文信息
| 项目 | 内容 |
|---|---|
| 标题 | Teaching a Moving Student: Rethinking the Curriculum of On-Policy Distillation |
| 作者 | Lingxiang Hu, Ming Xu, et al. |
| 机构 | Tencent |
| 链接 | arXiv:2609.25048 |
🎯 从一个所有人都踩过的直觉说起
做蒸馏的同学对这个 pipeline 应该不陌生:学生模型采样一批 response,老师对每个 token 给出 next-token 分布,学生用 reverse KL 去贴老师的分布。Qwen3 全系列、MiMo、GLM-5 都把这条路用进了主流水线——Qwen3 技术报告里给过一组很扎眼的数字:同样从 Qwen3-8B 出发,继续 RL 跑 17,920 GPU·h 拿到 AIME'24 67.6,OPD 只用 1,800 GPU·h 拿到 74.4。
OPD 有个跟 RL、SFT 都不一样的性质,论文开头一句话就点破了:学生不只在学习,它还在决定哪些状态能被教到。state 是(query,response prefix)的组合,rollout 是谁生成的,训练就落在谁的 prefix 分布上。学生一变,采样出的 prefix 就跟着变。
这就埋了一个问题:学生往前走的时候,它真的把它经过的状态都学完了吗?
直觉上说"学完了才走"。但这篇论文的实验告诉你:没有。学生经常是没听完老师讲什么就走了,而且再也不回来。
🧪 第一个实验:加数据、勤采样,居然不总是有用
作者先做了个很"基础"的实验:固定轨迹总量(14,080 条)和优化步数(110 步),去扫 query 数量(8 / 48 / 全量 14,080)和重采样频率(不重采样 / 每 11 步一次 / 每步一次)这两个轴。
结果挺反直觉的:
| 训练 query 数 | 只用初始 rollout | 每 11 步重采样 | 每步重采样 |
|---|---|---|---|
| 8 | 21.16 | 24.09 | 23.61 |
| 48 | 20.18 | 24.40 | 24.22 |
| 全量 14,080 | 19.05 | 24.51 | 25.57 |
看左边一列:只拿训练前学生采的固定 rollout 训练时,query 从 8 个加到全量,准确率从 21.16 掉到 19.05——加数据反而变差。看右边:每步重采样时,加数据才有用(23.61 → 25.57)。两个效应差了 4.07 个点,bootstrap 区间 [2.00, 6.28],不是噪声。
也就是说,"数据广度"这个变量根本不是独立的,它跟"这些数据是谁生成的"深度耦合。这直接把问题引向了下一个实验——
🔄 新鲜 rollout 的优势,会在长预算下反转
作者对比两种 rollout 来源:
- current-policy rollouts:训练中持续从进化中的学生重新采样(大家默认的"新鲜"做法)
- initial-policy rollouts:训练开始前,用初始学生采一批固定下来
固定 48 个 query、4,800 条轨迹、40 步优化,两个条件只有 rollout 来源不同,老师用了两个:Qwen3-4B-Instruct-2507 和 JustRL-DeepSeek-1.5B(后者跨 tokenizer,排除了 shared-tokenizer 的特殊解释)。
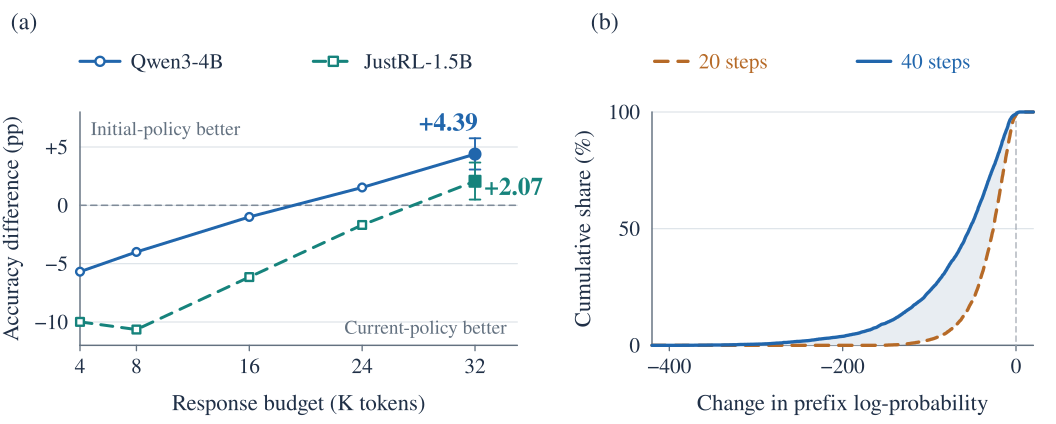
图2:(a) 初始策略减当前策略的准确率差随 response 预算的变化——16K 以内 current-policy 占优,24K 之后反超,32K 时 Qwen3-4B 老师下初始策略领先 +4.39 个点(区间 [3.07, 5.75]),JustRL 下 +2.07。(b) 初始策略 prefix 的 log-probability 变化累积分布——绝大多数 prefix 在学生训练 20/40 步后变得更不可能被采样到(曲线全部堆在负半轴)。
数字拆开看更清楚:
| 老师 | 16K 准确率差 (current 占优) | 16K pass@n 差 | 16K 答案抽取率差 | 32K 准确率差 (initial 占优) |
|---|---|---|---|---|
| Qwen3-4B | +0.99 | +10.38 | +38.87 | 领先 4.39 |
| JustRL-1.5B | +6.15 | +16.09 | +39.52 | 领先 2.07 |
16K 的时候 current-policy 全面更好,尤其 repeated-sampling 覆盖率(pass@n)和答案抽取率优势巨大。但放到 32K 一量,排序反了,而且伴随一个很说明问题的现象:initial-policy 训出来的模型平均回复长度 21,736 token,current-policy 只有 12,011——旧数据训出来的学生反而更敢说。
看到这里我的第一反应是:这不会只是截断效应吧?16K 处 current-policy 抽取率高这么多,会不会 initial-policy 的优势只是"答案出得晚但更完整"?作者显然也意识到了,所以做了下一节的诊断实验,把两件事干净地拆开了。
🔬 机制诊断:走掉 ≠ 学会
作者设计了一个很干净的测量:固定同一批 prefix(初始学生在 48 个 query 上各采 8 条 response,每条抽 32 个位置),然后在学生训练 0 / 20 / 40 步的三个 checkpoint 上分别测两个独立的量:
- 访问概率 \(\pi_\theta(y_{\lt t} \mid x)\)——这个 prefix 还会不会被学生走到
- 条件分歧——学生对老师在这个 prefix 上的 next-token 分布的 reverse KL
结果(对应图2b + 论文 Table 13):
- 40 步之后,99.15% 的非空 prefix 比初始化时更不可能被访问
- 但同一批 prefix 上的 teacher-student KL 只从 0.774 降到 0.548(20 步)、0.448(40 步)——还差一大截没学完
这两个数字放在一起就是论文最核心的洞察:早期状态正在从训练分布里消失,而它们携带的老师监督还没被吸收完。 标题里的"moving student"说的就是这个——学生是个移动的靶子,老师的教学范围跟着它移动,结果就是一路走一路漏。
🔁 重放实验:回去补课真的有用,但讲究顺序
既然早期状态还有监督价值,那就回去重放(replay)。从同一个 R40 checkpoint(40 步 current-policy 训练后)出发,再加 20 步,分别用三种数据源:
| 续训数据源 | 16K | 32K | 平均回复长度 |
|---|---|---|---|
| 继续 current-policy 采样 | 26.41 | 26.52 | 8,254 |
| 冻结一批"新鲜" rollout(R40 学生自己采的) | 26.12 | 26.21 | 7,997 |
| 重放 initial-policy bank | 27.13 | 29.37 | 12,116 |
两个信息量很大的对照:
- 固定 recent bank 不 work(26.21 ≈ 26.52)。所以收益不是"把数据冻住"这么简单,而是回到那些被学生遗忘的旧状态才有用。
- initial bank 的 response 平均才 758.85 token,R40 bank 是 8,171.47——短的旧回复反而带来更高的最终准确率,排除了"长答案堆出高分"的解释。
顺序也很关键。同样的总步数分配(40 步 current + 20 步 replay vs 反过来):
| 顺序 | 16K | 32K |
|---|---|---|
| 先 current 后 initial | 27.77 | 30.55 |
| 先 initial 后 current | 26.16 | 27.24 |
先听新课再回头复习,比先复习再听新课好 3.31 个点(32K)。两种数据源不是可以互换的商品,而是有先后依赖的课程。论文的 KL 矩阵还显示:重放 initial rollouts 主要降低 initial prefix 上的分歧,继续 current 采样主要降低新 prefix 上的分歧——你在哪块数据上训,就对齐哪块状态,不会自动迁移。
这个时序不对称性就是 R-OPD 的出发点。
⚙️ R-OPD:用梯度漂移决定什么时候回头
方案本身非常轻:训练前存一份 initial-policy bank(2,400 条 response),前期正常 current-policy 训练,在合适的时刻切换到纯重放。关键只在"什么时候切"。
作者的判断信号很工程化:每个 iteration 有 m=4 个 minibatch 的 pre-clipping、pre-AdamW 梯度 \(g_{k,1},\dots,g_{k,m}\),定义均值和迭代内方差:
然后比较相邻两个 current-policy iteration:
直觉是:\(D_k\) 是"这轮学到的跟上一轮比变化了多少",\(V_k\) 是"同一轮里 minibatch 之间天然就有的波动幅度"。当迭代间的变化跌进迭代内的噪声水平(\(D_k \leq V_k\)),说明 current-policy 这门课基本学完了——再采新数据也是原地打转。连续两次满足条件,从下一个 iteration 起永久切到 initial-policy 重放。
这套触发器我最欣赏的地方是零超参负担:不需要给每个新模型/新数据集手调切换点,\(V_k\) 是训练自己长出来的比较尺度。触发点会随学生尺寸和数据顺序浮动——三次 shuffle 的实测是 0.6B 触发在 5.67±1.15、1.7B 在 6.67±0.58、8B 在 7.67±0.58——正好说明手调一个全局固定值不现实,自适应是刚需。

图1:(a) current-policy 采样跟着进化中的学生走,replay 则回到初始策略的状态;(b) 早期 prefix 越来越不可能被访问,但师生预测分歧仍在;(c) 在梯度触发的 iteration τ 之后,训练全部使用初始策略 bank。
📊 主结果:三个尺寸全涨,长预算下最明显
八基准(AIME24/25/26、AMC23、HMMT25-Nov、HMMT26-Feb、MATH-500、OlympiadBench),每尺寸三个数据顺序:
| 学生 | 方法 | 16K | 32K | 32K 平均长度 |
|---|---|---|---|---|
| 0.6B | Current policy | 26.37±0.41 | 26.50±0.42 | 8,328 |
| 0.6B | 固定 R40F20 | 27.38±0.22 | 29.56±0.16 | 12,036 |
| 0.6B | R-OPD | 28.62±0.30 | 30.94±0.53 | 12,617 |
| 1.7B | Current policy | 39.07±0.40 | 39.18±0.35 | 6,713 |
| 1.7B | 固定 R40F20 | 41.19±0.09 | 43.67±0.06 | 10,933 |
| 1.7B | R-OPD | 41.88±0.21 | 45.33±0.16 | 11,589 |
| 8B | Current policy | 60.32±0.17 | 61.57±0.08 | 7,866 |
| 8B | 固定 R40F20 | 60.23±0.31 | 63.77±0.25 | 10,419 |
| 8B | R-OPD | 61.10±0.40 | 65.62±0.22 | 11,121 |
三个数字值得圈出来:
- 对继续 current-policy 采样:0.6B 涨 2.25/4.44 个点(16K/32K),1.7B 涨 2.81/6.15,8B(30B-A3B 老师)在 32K 涨 4.05
- 对手调的固定课程表 R40F20:32K 下还多涨 1.39/1.66/1.85——自适应切换本身就有价值,不只是"加个 replay 阶段"
- 预算扫描(onset scan)佐证了触发的位置感:固定 τ=0(纯重放)只有 25.26/30.31,τ=15(纯 current)26.37/26.50,中间的 τ=5 最好(28.46/30.79),R-OPD 触发在 (5,5,7),拿到 28.62/30.94——落在最优区域附近,而且不用逐个设置去扫
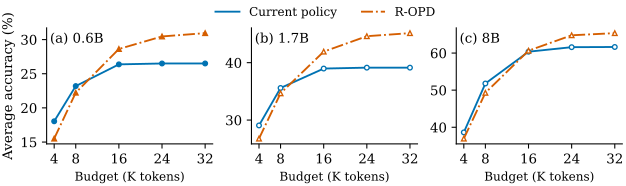
图3:0.6B/1.7B/8B 三个学生上,current-policy 与 R-OPD 在 4K~32K 预算下的八基准平均准确率。短预算(4K/8K)下 current-policy 仍略占优,16K 及以上 R-OPD 拉开差距,32K 差距最大。
还有个现象我觉得比涨分本身更有意思:同样的 32K 生成上限、同样的解码配置,R-OPD 训出的学生平均回复比 current-policy 长 52%/73%/41%。生成预算没变,是学生自己选择把推理写得更长。作者的解释是适时的重访帮学生把剩余的推理容量释放了出来——早期状态里"老师怎么把推理铺开"的那部分监督,恰恰是 current-policy 快速前进时最容易漏掉的。
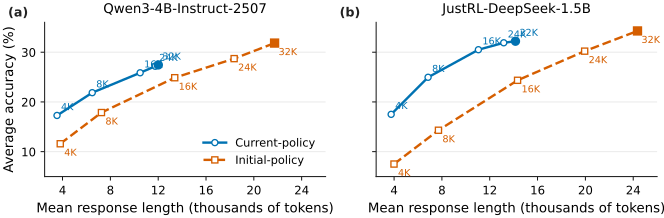
图5:两个老师下,current-policy(蓝)与 initial-policy(橙)在各预算点的"准确率-平均长度"曲线。initial-policy 训练的模型在 32K 处回复更长且准确率更高,说明长回复与高质量是可以同时出现的,代价并非"啰嗦"。
🤔 我的判断
这篇论文好在哪:
- 问题选得准。 OPD 领域 2026 年已经卷出了机制分析(2604.13016 的 thinking-pattern consistency)、稳定化(Veto、EOPD)、效率变体(Prefix OPD、Lightning OPD)好几条线,但"训练状态分布随学生移动"这个时间维度几乎没人系统碰过。同期 f-OPD(freshness-aware control)碰了相邻问题,这篇用"初始 bank 重放 + 梯度触发"给出了一个更简单的课程化答案。
- 实验链路干净得教科书级。 每个反直觉结论都配了排除替代解释的对照:数据量效应做了重采样频率交叉;32K 反转用两个老师(含跨 tokenizer)复现;重放收益用 fixed recent bank 排除"冻结数据"解释;顺序效应用固定总步数分配排除预算差异。99.15% 这个数字配上 KL 矩阵,机制证据是实的。
- 触发器设计克制。 没有引入新模型、新损失、新超参,就用了 minibatch 梯度统计里现成的两个量。这种"能不加东西就不加"的工程品味在当前的研究环境里挺稀缺。
这也要泼点冷水:
- 任务面窄。 全部实验是数学竞赛题(DAPO-Math-17K 训练,八个数学基准评测)。"早期 prefix 上师生分歧未吸收"这个现象在开放生成、代码、Agent 任务上是否同样存在、重放是否同样有益,论文没给证据。数学题答案模式收敛快,可能放大了重放收益。
- 学生都偏小、老师固定在同族。 0.6B/1.7B/8B 的 Qwen3 non-thinking 学生,老师最大 30B-A3B。工业界真正痛的"小模型贴大 MoE 教师"场景里,teacher 打分成本才是大头,重放恰恰能省 teacher 前向——这一点论文其实可以展开但没强调。
- 触发器是启发式。 \(D_k \leq V_k\) 连续两次这个判据没有扫描消融(比如阈值放宽/收紧、连续次数改成一次或三次会怎样)。触发器失败时的兜底行为(一直不触发就全程 current-policy)是安全的,但"什么时候它会不会错"缺少理论刻画。
- 重放只回最早一步。 只重放 initial bank,中间 checkpoint(比如 R10、R20 时刻的分布)被忽略了。理论上多 checkpoint 课程可能更好,但复杂度会上去,作者选择极简方案可以理解,不过这个方向的收益空间还开着。
工程启发:
正在跑 OPD 流水线的话,这篇论文最实用的动作是——训练前花几 GPU·h 存一份 initial rollout bank,成本几乎为零,训练中把梯度漂移判据加进监控,触发就切重放。不用改损失、不用改架构,八基准平均白拿几个点,长生成预算下收益最大。如果你的业务恰好需要长 CoT(代码、复杂规划),这个方法的性价比会更高。
还有一个更泛的启发:OPD 让"课程"这个老概念有了新形态——不是给数据排难度,而是给状态安排 revisit 时机。学生的分布移动到哪、哪里还有没吸收的监督,这两件事的错位就是免费的改进空间。我猜接下来会看到更多"什么时候教什么"的工作,这篇把第一块石头放好了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我