SwarmRSI:让一群科研智能体"越研究越聪明",靠的不是换模型,而是换它们继承的东西
上周读了一篇让我愣了一下的论文。
不知道大家有没有观察过这类现象:让 AI 智能体去做科研——提假设、写代码、跑实验——它跑挂了一次实验之后,你根本分不清是假设本身不行,还是代码写得烂。更憋屈的是另一种情况:某个程序整体分数没涨,直接被判死刑扔进垃圾桶,但里面有一段代码其实是好东西,换个场景就能发光。
这两个问题看着琐碎,其实是"科研智能体自我进化"这条路线上最核心的堵点。这篇叫 SwarmRSI 的论文(arXiv: 2610.20431)就是冲着这两个堵点来的,而且给出的答案挺优雅:别纠结单个智能体怎么改,把整个智能体群体继承的研究状态当成进化对象。
核心摘要
SwarmRSI 是一个面向科研智能体群体(agent swarm)的递归自我改进(RSI)框架。核心思路一句话:每次实验——不管成功、失败还是没涨分——都回流到一张共享研究图里,更新后续智能体出发时继承的假设、程序和证据。具体靠两个机制落地:Feedback-Guided Swarm Mutation 用其他智能体的实验反馈来判断"该改假设还是该修代码";Complementary Swarm Recombination 跨智能体复用被搁置的假设和互补的代码组件。效果上,OpenProblems 平均分 76.2(超过人类专家基线的 57.2),NatureBench 上 44.4% 的任务追平已发表 SOTA,是同骨架模型下所有对比方法里最高的;更打动我的是轨迹分析——最终最优程序里约 77% 的血统来自跨智能体的复用。我的判断:这不是底层突破,是设计得很讲究的工程整合,但"失败经验也要入库、组件粒度复用"这两个想法对做 agent 系统的人有实打实的借鉴价值。
论文信息
- 标题:SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm
- 作者:Qianru Meng, Xi Zhang, Konstantinos Papakostas, Congfeng Cao, Wenxiang Hu, Tianyi Lu, Xiao Zhang, Lun Zhou, Zaiqiao Meng, Zhaochun Ren, Xiaohui Yan, Yougang Lyu(通讯:Xiaohui Yan、Yougang Lyu)
- 机构:Huawei Technologies、Leiden University、University of Groningen
- 发表:2026 年 10 月 14 日,arXiv: 2610.20431(cs.AI)
- 链接:https://arxiv.org/abs/2610.20431
🎯 问题动机:共享了经验,不等于会用经验
先交代下背景。所谓递归自我改进(Recursive Self-Improvement, RSI),就是让智能体用自己积累的实验经验来改进自己的研究能力。Weco 的 AIDE2 前段时间就玩过这个——让 agent 改写自己的代码,8 天跑了七轮自我改进,在当时讨论度很高。而"科研智能体群体"这条路(比如 R&D-Agent 这类多角色协作系统),大家默认的假设是:只要把记忆和历史共享出来,智能体们自然会互相借力。
说实话我之前也默认这个假设成立。但这篇论文一上来就把它戳破了:共享了经验,不代表智能体会用经验做更好的研究决策。
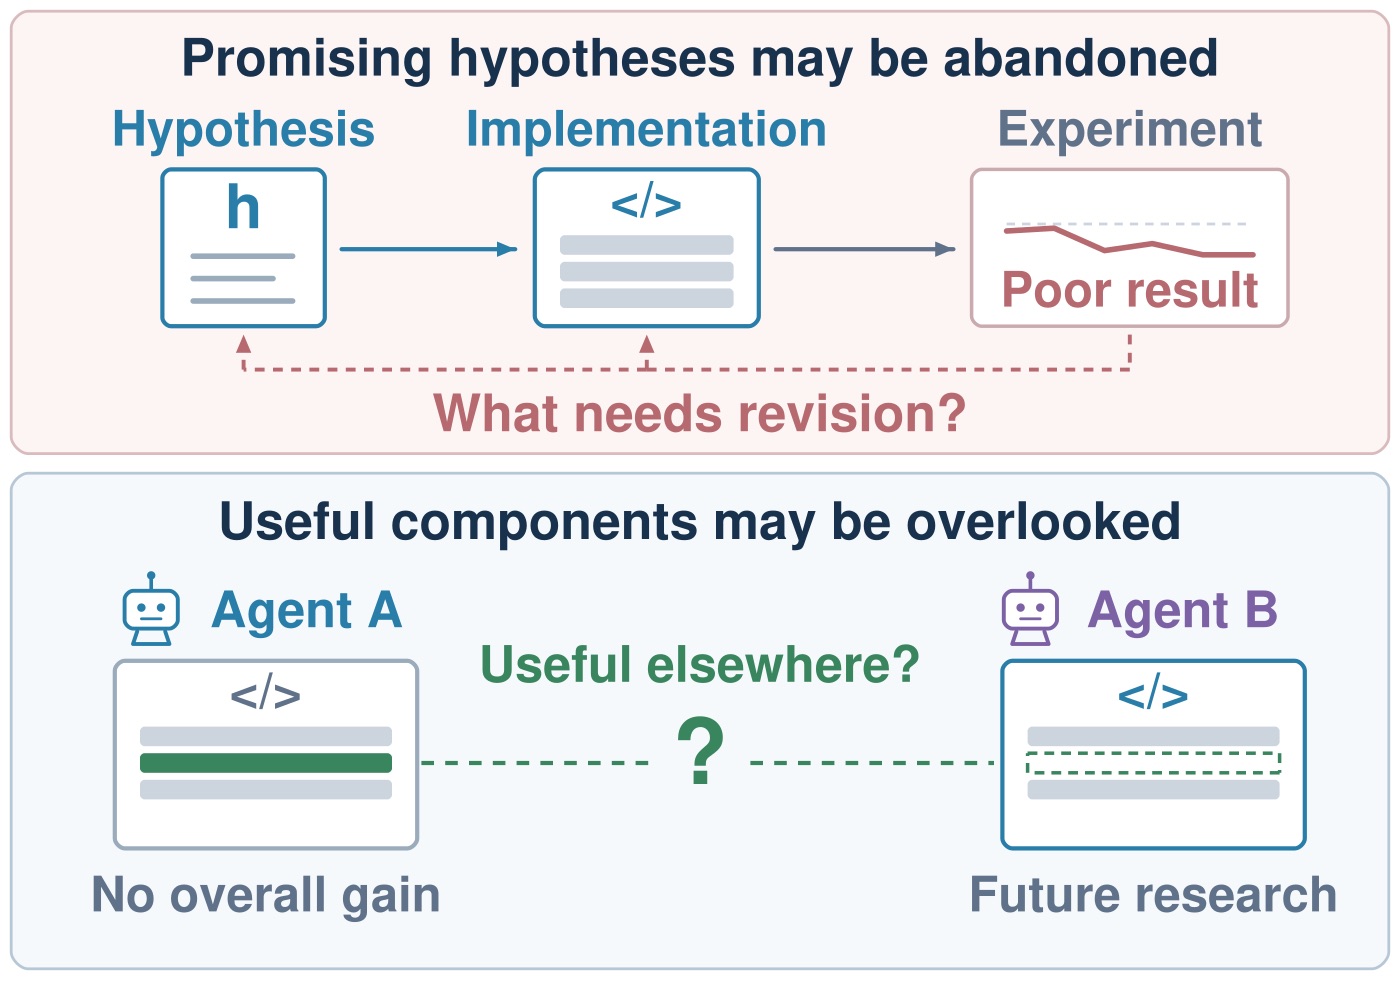
图1:论文点名的两个痛点。上图:假设 h 经过实现、实验后拿到一个差结果,你分不清该改假设还是改实现,于是一个有潜力的方向被直接放弃。下图:Agent A 的程序整体没涨分,但其中一段组件(绿色)可能正是 Agent B 未来研究需要的——整体分数掩盖了局部价值。
这两个痛点可以归约为科研里两个相互纠缠的依赖关系:
第一,一个假设的价值取决于它被怎么实现、被怎么严格地检验。实验失败了,你没法从结果本身判断是方向错了还是代码错了——这是个归因问题。
第二,中间结果的价值取决于它和后续发现的组合。一个程序现在分数不高,不代表它的组件对别人没用——这是个估值问题,当前分数系统性地低估了组件的未来贡献。
你想想看,人类科研其实一直在处理这两个问题:实验室组会上师兄会告诉你"这个方向我觉得没问题,是你那个 baseline 写歪了";一段没发论文的代码会在组里流传,最后被师弟用在完全不同的课题上。这篇论文干的事,就是把这两件人类课题组里靠口口相传解决的事,变成智能体群体里的显式机制。
🏗️ 方法核心:进化对象不是智能体,是它们继承的"研究状态"
先给一句话直觉:SwarmRSI 把进化算法的变异和重组操作,从"程序"这个粒度,扩展到了"假设 + 程序 + 证据 + 未决需求"打包的研究状态上。
形式化一点说,每个智能体在第 \(t\) 步行动时,从共享图 \(\mathcal{G}_t\) 里组装一个研究状态:
四样东西:假设集合、程序集合、实验证据、未决需求。图里的每条记录 \(\xi_i = (H_i, P_i, X_i, E_i)\) 记着被测假设、父程序与结果程序、实验结果、执行与实现证据。关键设计:失败的尝试和没涨分的尝试也全部留在图里,边记录着假设-程序关联和复用关系。这就是后文一切复用的物质基础。
整个框架由三个机制组成,我挨个聊。
机制一:Feedback-Guided Swarm Mutation——改假设还是修代码,让反馈说话
这是最对我胃口的部分。传统的 program evolution(如 AIDE)只在代码层面迭代,hypothesis evolution(如 Arbor)只在想法层面迭代。SwarmRSI 说:别二选一,让群体的实验反馈来决定这一步该动哪一层。
具体分两种变异:
- H-mutation:改了假设。触发信号是"同一假设在不同实例上的表现差异"——说明方向本身需要修正
- P-mutation:假设不动(\(\tilde{h}_t = h_t\)),只修实现。触发信号是"执行失败"或"干预措施没真正落地"——说明是工程问题
过程就是 Propose(提出新假设和修订计划 \(\delta_t\))→ Implement(在父程序上落实)。听起来简单,但这里有个很精细的设计叫双重审计:代码审计查执行状态和产物合法性;科学审计对比父子程序的源码和输出,标记"代码根本没改"、"新增函数没人调用"、"输出和父程序一模一样"这些情况。被标记的尝试不给假设记功劳,只保留程序层面的证据。
这个设计解决了一个真问题。论文失败分析里有个案例:任务 00838 上,智能体提议做一个氨基酸替换,代码跑通了、分数也出来了,但下游代码把那个替换给覆盖了——评测根本没测到它。如果只看分数,这个假设就被冤枉了。说实话,做 agent 系统的人应该都踩过类似的坑:分数涨了以为是想法对,分数没涨以为是想法错,其实全是实现层的噪音。
机制二:Complementary Swarm Recombination——垃圾堆里翻宝贝
第二个机制管"组件级复用",两个操作:
Rebase(换基座):一个假设 \(h_t\) 挂着未解决的实现需求,就去别的智能体那里找一个有效的程序基座 \(b_t\)(按"需求标签和程序机制标签的重合度"来匹配),把假设移植到新基座上重新实现。假设不死,换个身子再活一次。
Crossover(杂交):经典的遗传算法操作搬到了程序组件层面。对每个数据集或子任务 \(k\),找出在某个实例上跑赢父程序的"捐赠者"程序:
按最大优势排序,最多选两个捐赠者。子代程序在捐赠者占优的实例上继承捐赠者的组件,其余地方保留父程序的组件。注意这个分配方案是在实现之前就根据实测反馈定死的,不是让 LLM 自由发挥——这个约束挺重要,防止杂交变成玄学。
这两个操作的共同点是:整体分数不再是唯一的价值度量。一个没涨分的程序,只要某个组件在某个实例上赢过,就有资格当捐赠者。
机制三:Recursive Swarm Evolution——用 UCB 调度"改假设"和"修程序"的预算分配
第三个机制是控制回路:下一步到底改假设还是修程序?SwarmRSI 维护两个前沿——假设前沿 \(\mathcal{F}_H\) 和程序前沿 \(\mathcal{F}_P\),然后用一个带折扣的 UCB 指数来打分选择:
三项分别是:\(\hat{\mu}_f\) 是该前沿近期"每千 token 换来的改进量"(注意,是按成本归一的,很工程);中间项是经典的探索奖励;\(\psi_f\) 是"未决需求压力"——积压的、该前沿能解决的请求越多,分数越高,上限饱和在 \(K=4\)。超参上 \(\beta=0.5\)、\(\gamma=0.25\),假设前沿保 4 个活跃假设、程序前沿保 8 个代表程序。
回路里还有个显式的请求机制:实现失败 → 发"深化"请求(去修程序);跨实例有涨有跌 → 发"拓宽"请求(去改假设);出现新的最优程序 → 给之前搁置的假设发"在新基座上重新实现"的请求。这些请求就是 \(\psi_f\) 的来源,把两个前沿的资源分配耦合在了一起。

图2:SwarmRSI 全景。顶部是三类智能体(假设、程序、证据分析)共享研究状态 \(s_t\)。左下 Feedback-Guided Swarm Mutation:性能反馈触发假设修订(Revise),实现障碍触发程序修复(Repair)。右下 Complementary Swarm Recombination:Rebase 保留假设换基座,Crossover 按实例分数组合两个程序的组件(蓝色和绿色代码行表示杂交来源)。底部是 Recursive Swarm Evolution 主回路:所有候选程序经过执行评估,无论成败都回流到共享研究图,更新下一个智能体的状态 \(s_{t+1}\)。
🧪 实验:三个基准、118 个任务、两种骨架
实验覆盖三个基准共 118 个任务:OpenProblems(6 个单细胞分析任务)、NatureBench(90 个横跨蛋白质、细胞组学、物理建模、分子设计、关系推理、生物医学的科学编程任务)、MLE-Bench Lite(22 个低复杂度 Kaggle 竞赛)。主用骨架是 DeepSeek-V4-Pro,另用 Gemini 3.1 Pro Preview 验证跨骨架稳健性。时间预算分别是 8/4/12 小时,自家方法的结果都是三个随机种子的均值——这个实验规模在 agent 论文里算相当扎实了。
主结果:OpenProblems 和 NatureBench 确实是 SOTA
表1:OpenProblems 主结果(六任务归一化分数 ×100)
| 方法 | 骨架 | Denoise | Label | Batch | SVG | Decomp | Visual | 平均 |
|---|---|---|---|---|---|---|---|---|
| Human Expert | 任务专用 | 28.0 | 85.0 | 71.0 | 66.0 | 49.0 | 44.0 | 57.2 |
| Biomni | Claude 4 Sonnet | 16.0 | 89.0 | 82.0 | 16.0 | 53.0 | 35.0 | 48.5 |
| ChatGPT | GPT-5 | 3.0 | 81.0 | 83.0 | 60.0 | 74.0 | 38.0 | 56.5 |
| AIDE | DeepSeek-V4-Pro | 27.4 | 70.6 | 78.0 | 72.8 | 46.1 | 39.8 | 55.8 |
| TusoAI | DeepSeek-V4-Pro | 31.5 | 58.7 | 79.5 | 79.0 | 84.1 | 69.8 | 67.1 |
| SwarmRSI | DeepSeek-V4-Pro | 33.6 | 74.2 | 82.5 | 83.9 | 86.0 | 84.8 | 74.2 |
| SwarmRSI | Gemini 3.1 Pro Preview | 40.2 | 80.7 | 78.8 | 87.8 | 83.4 | 86.4 | 76.2 |
74.2 对 67.1,比同骨架的领域专用智能体 TusoAI 高了 7.1 个点,也明显超过人类专家基线的 57.2。不过说句实话,OpenProblems 只有 6 个任务,单个任务的波动对平均分影响很大,这个基准上的优势我会打点折扣看。
表2:NatureBench 主结果(90 个任务,S = Surpass-SOTA 率,M = Match-SOTA 率,单位 %)
| 方法 | 骨架 | All-S | All-M |
|---|---|---|---|
| Claude Code | DeepSeek-V4-Pro | 4.4 | 23.3 |
| Claude Code | Qwen 3.8 Max 0902 | 17.8 | 35.6 |
| Codex | GPT-5.4 | 6.7 | 24.4 |
| Gemini CLI | Gemini 3.5 Flash | 10.0 | 25.6 |
| Arbor(假设进化) | DeepSeek-V4-Pro | 12.2 | 36.7 |
| AIDE(程序进化) | DeepSeek-V4-Pro | 10.0 | 27.8 |
| SwarmRSI | DeepSeek-V4-Pro | 15.6 | 44.4 |
| SwarmRSI | Gemini 3.1 Pro Preview | 14.4 | 44.4 |
这张表是全文最硬的结果。同骨架下 Match-SOTA 比 Arbor 高 7.8 个百分点、比 AIDE 高 16.7 个百分点,作者还做了 McNemar 检验确认显著(p<0.05),不是噪声。比同骨架的通用 coding agent Claude Code 高 21.1 个百分点。两个骨架下 Match-SOTA 都是 44.4%,说明框架收益不绑定特定模型。
但也有要泼冷水的地方:分领域看,SwarmRSI 的 Surpass-SOTA 集中在 Physical(53.8%)和 Cellular(22.6%),而 Protein、Molecular、Relational 三个领域的 Surpass 率是 0——追平可以,超越做不到。所以"SOTA"这个结论准确的读法是"追平能力最强",不是"全面碾压"。
表3:MLE-Bench Lite 主结果(22 个竞赛,单位 %)
| 方法 | 骨架 | Above Median | Gold | Any-Medal |
|---|---|---|---|---|
| MLEvolve | DeepSeek-V4-Pro | 81.8 | 36.4 | 72.7 |
| Arbor | DeepSeek-V4-Pro | 86.4 | 40.9 | 77.3 |
| GPT-5.5 | – | 95.5 | 77.3 | 86.4 |
| Famou-Agent 2.0 | Gemini 3 Pro Preview | 93.9 | 50.0 | 80.3 |
| SwarmRSI | DeepSeek-V4-Pro | 90.9 | 45.5 | 81.8 |
| SwarmRSI | Gemini 3.1 Pro Preview | 86.4 | 40.9 | 81.8 |
等等,这张表得仔细看。SwarmRSI 的 81.8% Any-Medal 确实比同骨架的 Arbor(77.3%)和 MLEvolve(72.7%)高,论文摘要里的措辞也很小心——"above hypothesis and program evolution agents with the same backbone"。但 GPT-5.5 的 Any-Medal 是 86.4%、Gold 是 77.3%,全面压过 SwarmRSI。所以这个基准上它不是 SOTA,只是"同骨架对比里赢了"。读这类论文一定要盯住摘要里 "with the same backbone" 这类限定词,差一个限定词结论就完全不一样。
消融:每个组件都在干活,调度器贡献最大
表4:NatureBench 消融(DeepSeek-V4-Pro,90 任务 × 3 种子)
| 变体 | Match | Surpass | 平均 g(×100) |
|---|---|---|---|
| SwarmRSI 完整版 | 44.4 | 15.6 | 12.8 |
| 去掉 H-mutation | 34.4 | 8.9 | 7.2 |
| 去掉 P-mutation | 31.1 | 6.7 | 5.4 |
| 去掉重组(rebase+crossover) | 37.8 | 7.8 | 7.6 |
| 去掉共享图 | 36.7 | 10.0 | 8.1 |
| 去掉 H/P 自适应选择 | 35.6 | 8.9 | 4.6 |
五个变体全部显著掉分(配对 bootstrap 95% CI 都不含零)。几个值得琢磨的点:
去掉 P-mutation 比去掉 H-mutation 掉得更狠(Match-SOTA 掉 13.3 vs 10.0 个百分点)——修代码比改想法贡献更大。这跟直觉相反,大家总觉得科研智能体的瓶颈在"想法够不够聪明",结果数据说瓶颈更多在"实现够不够扎实"。
掉分最多的是去掉 H/P 自适应选择(平均 g 从 12.8 跌到 4.6,Δg 8.2,CI [4.2, 12.4])——哪怕只是退化成固定的 H/P 交替,性能都崩得厉害。说明那个 UCB 调度器不是摆设,预算在"改假设"和"修程序"之间怎么分配,是这套系统里最值钱的设计决策。
轨迹分析:35% 的失败实现被救活了
这是我个人觉得全文最有说服力的部分,比主表更说明问题。
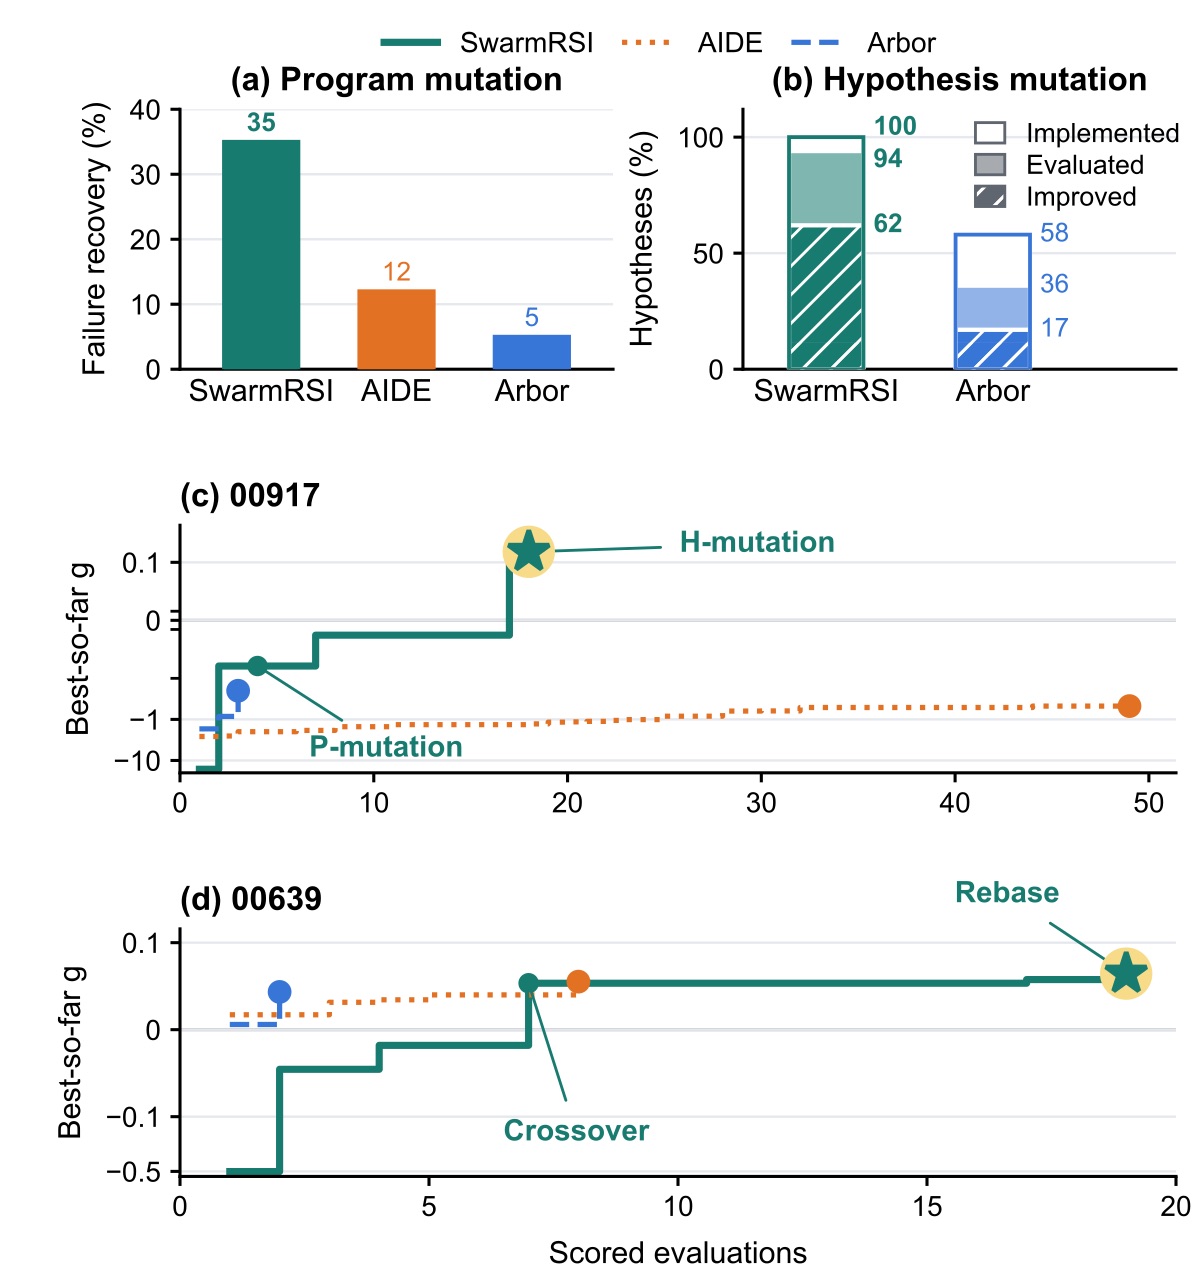
图4:NatureBench 上的搜索行为对比(DeepSeek-V4-Pro)。(a) 失败恢复率:失败实现经后续改进变成新最优的比例,SwarmRSI 35%,AIDE 12%,Arbor 只有 5%。(b) 假设转化漏斗:提出的假设中被实现/被有效评估/带来改进的比例,SwarmRSI 是 100/94/62,Arbor 是 58/36/17。(c)(d) 两个任务上的 best-so-far 曲线(对称对数轴),标注了 H-mutation、P-mutation、Crossover、Rebase 各自起作用的节点。
35% 对 5%。失败恢复率差了 7 倍。AIDE 和 Arbor 的失败尝试基本就是死了,SwarmRSI 超过三分之一的失败实现后来被救活成了新最优——因为失败记录留在图里,还挂着"未决需求"等后来的智能体认领。
62% 的假设最终带来了改进(Arbor 只有 17%)。还有停滞率:SwarmRSI 43% 的已评分候选没有改进,AIDE 是 63%,Arbor 是 70%。
最狠的一个数:在一个 DeepSeek-V4-Pro 种子的全部 90 个任务上,最终最优程序里约 77% 的血统可以追溯到至少一次 rebase、crossover 或反馈触发的更新。你想想看——五分之四的最终答案不是从零进化出来的,是站在别的智能体的半成品肩膀上长出来的。这就是"进化继承状态"这个命题最直接的证据。
跨任务迁移:经验真的可以带走
附录 C.2 的实验我很喜欢。先用 6 个源任务跑三代(每代 2 个任务),把积累的研究状态带到 12 个预先固定、与源任务不相交的新任务上:
| 起点 | Match | Surpass | 平均 g(×100) | 每任务 token(百万) |
|---|---|---|---|---|
| 冷启动 | 41.7 | 33.3 | 12.01 | 12.17 |
| 继承 1 代后 | 58.3 | 41.7 | 16.15 | 11.86 |
| 继承 2 代后 | 86.1 | 44.4 | 20.16 | 11.52 |
| 继承 3 代后 | 86.1 | 58.3 | 21.89 | 10.94 |
Match-SOTA 从 41.7% 涨到 86.1%,翻了一倍多;token 消耗反而降了。经验积累不光提升效果,还省钱——因为新任务不用从零摸索,直接检索机制标签匹配的历史记录开局。这就有"递归"那味了:系统研究得越多,研究新东西越快。
失败分析:93.3% 的失败是"忠实执行但没涨分"
作者人工标注了 644 次失败尝试(35 条未达标的轨迹,双标注员 Cohen's κ=0.92,一致性很高)。结果:93.3% 是忠实执行了干预但确实没涨分,只有 6.7% 是实现或执行层面的问题。
这个分布其实挺健康的,说明系统的工程可靠性已经不是瓶颈。但也暴露了天花板:当大多数失败都是"想法本身不 work"时,剩下的提升空间就得靠更好的假设生成——而这部分恰恰还是靠 LLM 的灵光。
生物案例:演化出的程序被生物学家真的拿去用了

图5:(a–c) 肠细胞任务上,生物学家复现 SwarmRSI 演化程序得到的表征 UMAP,按来源、MHC-II/Cd74 分数和抗菌 RNA 分数着色(绿色和粉色分别是蠕虫第 10 天和沙门氏菌来源)。(d–f) BALBc-1 脾脏的人工解剖标注、SwarmRSI 程序分区、以及专家划分的 B 细胞邻域分组(E1 富含 B 细胞/滤泡树突细胞,E2 富含髓系/红系细胞,E3 富含 T 细胞)。
两个案例的细节挺有意思。肠细胞任务上,演化程序的做法是"从每个被感染细胞里减去它健康邻居的均值,再对残差做降维"——实测 RNA 显示蠕虫第 10 天来源的 MHC-II 分数(1.17)远高于沙门氏菌(0.34),且在这个表征上 MHC-II 分数的局部相干性(校正后 Spearman ρ 0.77/0.69)好于直接用 RNA PCA(0.65/0.40)。
脾脏那个案例更妙,是个"阴性结果也是贡献"的故事:演化程序把 g 从 0.045 提到 0.102,但专家跟进检查发现,边缘区里约 20-21% 的 B 细胞落在髓系/红系富集邻域里,而匹配位置和表型之后,包括 B220 在内的六个标志物在三种图像间没有一致的偏移,B220 的效应甚至变号。也就是说程序发现的空间模式经不起严格的生物学复核。论文把这个如实写出来了,这个态度我尊重——比只报喜不报忧的论文强太多。
成本:性能最高,token 反而更少

图6:三个基准上性能对每任务平均 token 消耗(DeepSeek-V4-Pro)。三个子图里 SwarmRSI 都在左上角——性能最高的同时 token 更少,NatureBench 上 Arbor 用了约 3 倍的 token 还跑不过它。
省 token 的原因也好理解:反馈制导减少了盲目试错,复用减少了从头实现。
🤔 我的判断
这篇论文值钱的不是某个单点技术——变异、重组、UCB 调度,单拎出来都是进化计算里的老朋友,rebase 和 crossover 的概念直接就能追溯到 Holland 的遗传算法。它值钱在把这些操作重新组织在"假设-程序-证据-需求"这个状态抽象上,并且用一组相当扎实的实验(三基准、双骨架、三种子、显著性检验、人工失败标注、真实生物学家复现)证明了这套组织方式的有效性。
亮点我认三个。第一,失败归因机制(双重审计 + H/P 变异分离)直击 agent 系统的真痛点,工程上可直接抄。第二,组件级复用把"没涨分的程序"从垃圾变成资产,77% 的血统占比说明这不是理论摆设。第三,跨任务迁移实验证明了经验积累的复利效应,这是 RSI 命题里最接近"递归"二字的证据。
问题也得说。MLE-Bench Lite 上 GPT-5.5 裸跑就赢了它,说明当骨架模型足够强时,这套框架的边际收益存疑——框架收益和模型能力之间的此消彼长,论文没展开讨论。NatureBench 三个领域 Surpass 率为零,说明它更擅长"把已知好方法组合到位",不擅长真正的原创性超越。另外整个系统有十几个相互耦合的超参(折扣因子、探索权重、前沿容量、停滞耐心……),论文用一套固定参数打三个基准,泛化到新任务类型时调参成本未知。还有个更根本的疑问:共享图随着任务积累会越来越大,检索和组装状态的成本怎么 scaling,论文没给答案。
跟同期工作比,AIDE2 进化的是 agent 自己的代码,Dream-RSI 进化的是探索策略,SwarmRSI 进化的是群体继承的研究状态——粒度不同,但"进化对象从工件转向过程状态"这个趋势是一致的。如果你在做多智能体科研系统,我的建议是:双重审计和失败需求挂单的机制直接拿走用,UCB 调度可以参考但参数得自己调,至于全套框架,先想清楚你的场景里"组件复用"的空间有多大——任务之间越同质,这套东西越值。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我