Player-1:不看人类录像,在16个自建小游戏里练出通用游戏操控
核心摘要:游戏智能体一直被两件事卡脖子——人类示范录像覆盖不了动态多变的游戏状态,而能给交互反馈的训练环境又贵又难造。Player-1 的思路很直接:先拿 6044 条精选游戏轨迹做 SFT 给策略"启蒙",然后自建 16 个围绕通用操控需求(瞄准、战斗、驾驶、导航、UI 交互)的合成 2D/3D 环境,用可编程验证的奖励跑多环境 PPO。结果相当能打:Player-1-9B 在 MineDojo-300 上从 SFT 的 10.54% 直接干到 38.33%,涨了 27.8 个点,而最强外部 baseline 只有 12.63%。更关键的是这些增益泛化到了训练套件之外的 ViZDoom 和浏览器游戏,甚至能开《看门狗2》里的车。这篇论文最值钱的地方不是某个单点技巧,而是证明了一件事——合成经验可以替代在每个目标游戏里做 RL,这对游戏智能体的训练范式是个实打实的路线级贡献。
论文信息 - 标题:Player-1: Learning to Play from Synthetic Experience - 链接:https://arxiv.org/abs/2610.20584 - 作者:Mingyu Ouyang, Yiran Wang, Siyuan Hu, Xingyilang Yin, Huiqiang Sun, Guangzhi Wang, Junfu Pu, Cheng Cheng, Honghao Chen, Ying Shan, Mike Zheng Shou, Hwee Tou Ng - 机构:National University of Singapore、ARC Lab, Tencent IEG、Nanyang Technological University - 代码:https://github.com/TencentARC/Player-1
🎯 为什么游戏智能体卡在"示范学习"这关
先聊背景。Computer-use agent(看截图、动键鼠的那类智能体)最近在办公和网页任务上进展飞快,但一到游戏就拉胯。原因不复杂:游戏画面信息密度高、状态变化快,还要求持续按住、多键并发这类精细操控——你让一个只会点坐标的 GUI 智能体去玩 FPS,它连转身开枪都做不利索。
主流解法是两拨。一拨砸人类示范:录海量玩家录像做行为克隆,比如 Game-TARS、NitroGen 这一路。问题在于示范只覆盖玩家走过的状态,开放式任务里智能体一旦跑偏进入没见过的状态,就彻底不会玩了。另一拨上 RL 自我改进,典型代表是 DeepMind 的 SIMA 2——去年 11 月发布,Gemini 当教练出题打分,智能体在 Genie 3 生成的世界里自我迭代,确实把 ASKA 里初代失败的任务练会了。但 SIMA 2 这套是闭源的,且它依赖真实商业游戏加大模型评分,奖励既不便宜也不严格可验证。
Player-1 卡的位置很微妙:示范要做,但只做启蒙;真正的能力增长交给合成环境里的可验证 RL。论文开篇就把核心问题摆明了——合成经验能不能把游戏操控推到示范之外,并且增益能泛化到 RL 训练套件之外的游戏?
答案是能,而且数字相当硬。
| 管线 | 学习重心 | RL 环境 | 开源 |
|---|---|---|---|
| Game-TARS | 大规模预训练 | 无 | ✗ |
| SIMA 2 | 具身辅助 | 游戏 + 世界模型 | ✗ |
| NitroGen | System-1 通才 | 无 | ✓ |
| Odysseus | 长程 RL | 5 个 Mario 关卡 | ✓ |
| Player-1 | 超越示范 | 16 个合成环境 | ✓ |
表1:代表性游戏智能体学习管线对比。Player-1 是唯一"合成环境 RL + 开源"的组合。
🏗️ 方法:一条共享动作空间串起 SFT 和 RL

图1:Player-1 框架总览。上方是主干流程:computer-use 模型经 SFT 成为游戏操控初始化策略,再在 Player-1-Gym 里做多环境 RL;中间的 Game-Control Action Space 是串起两阶段的关键;下方是四个评估面板的学习曲线。
整套框架有三个部件,我按重要性排序讲。
动作空间扩展:让 CUA 学会"打游戏的手"
这是一切的地基,也是我觉得最被低估的贡献。标准 CUA 的鼠标动作是绝对坐标点选——看到按钮点按钮。但游戏里转视角根本没有指针可点,你得给相对位移。Player-1 对动作空间做了三个扩展:
- 相对指针位移:鼠标动作支持归一化的 \((\Delta x, \Delta y)\),正值向右向下,视野旋转幅度取决于游戏的相机增益。这一下就打通了 FPS 的视角控制。
- 持续输入:按键和鼠标支持按住一整个控制步长,跨步连续按住就是持续移动。没有这个动作,W 键连走都做不到。
- 组合动作:一个控制步内并发执行两个以上兼容输入,形式化写成 \(a_t = (i_1 \parallel i_2 \parallel \cdots \parallel i_k)\)。按住 W 再拍空格是跑跳,转视角加右键瞄准加左键点击是移动射击——人类玩家的肌肉记忆,说到底就是这些并发组合。
监督初始化:6044 条轨迹的"启蒙教育"
SFT 数据来自公开数据集(含 VPT 那一路)加自录,覆盖 Minecraft、GTA V、赛博朋克 2077 等,共 6044 条轨迹、295,097 个交互回合。录制设备千差万别,作者做了两件脏活:把控制信号对齐到统一动作间隔,以及针对来源做鼠标校准,把相对输入归一到像素等效坐标。然后用 VLM 给每个回合补上任务指令和视觉推理——推理标注时模型能看到任务指令、当前和历史观测、以及动作目标,所以写出来的推理是"知道要干嘛"的,不是事后编造。

图2:(a) 示范轨迹的控制类型分布——纯键盘 38.0%、键鼠混合 35.1%,每步 2 个及以上输入的组合动作占比超过六成,指针模式里相对位移占 69.5%;(b) 一条《艾尔登法环》打 Boss 的标注样例,推理明确写到"她的挥砍正在收尾,此刻前压重击能保证命中"。
看 (a) 那个分布你就能理解为什么动作空间扩展是必要的:示范里组合动作占大头,如果动作空间不支持并发,SFT 阶段就把这些行为模式丢掉了。
Player-1-Gym:16 个为"操控需求"而生的合成环境
这是整篇论文的核心资产。作者的观察很朴素:游戏看着千差万别,但操控需求是收敛的——瞄准、战斗、驾驶、导航、UI 交互,五类。于是他们基于自研的 2D/3D 引擎、可复用素材和场景模板,手搓了 16 个环境,每个环境通过不同的机制、视角和空间布局去考这些操控。

图3:(a) 五大任务族及其操控需求——瞄准 2 个环境、战斗 5 个、驾驶 4 个、导航 4 个、UI 交互 1 个;(b) 16 个环境的画面,从 2D 平台跳跃到 3D 追车;(c) 同一个环境施加外观、相机、场景随机化后的效果。
两个设计细节值得单独说。
一是奖励严格可验证:每个环境从游戏状态里定义计分规则,分数增量直接当 step 级奖励,稠密、程序化、不依赖学习型裁判,特权状态还不暴露给策略。这跟 SIMA 2 用 Gemini 打分是完全两种路线——便宜、无噪声、可以无限 rollout。
二是四维随机化:外观(颜色光照素材)、相机(投影方式、机位、初始朝向)、场景(布局、出生点、任务配置)、控制响应(相机转动和移动的增益系数)全都随机。控制增益随机这个很贼——等于逼着策略不能背"鼠标移多少转多少度"的固定映射,必须学会看画面反馈做闭环修正。
训练用标准 PPO,跨 16 个环境联合优化。有个关键工程细节:不同环境奖励尺度差很大,直接混着训会让更新幅度被高奖励环境主导,所以作者对 GAE 优势做了逐环境归一化——每个环境 \(e\) 用自己的优势均值 \(\mu_e\) 和方差 \(\sigma_e^2\) 单独标准化。另外 return-to-go 目标跨回合累积奖励,让后面的结果能反哺前面的操控决策,缓解多步操控里的信用分配问题。
🧪 实验:27.8 个点的提升,而且涨在训练套件之外
训练配置:Qwen3.5-9B 和 Qwen3.5-35B-A3B 两个底座,先两轮 SFT(带动作均衡采样),再在 16 环境套件上跑 200 步 PPO,每步采 256 个 episode、每个 episode 最多 50 个交互回合。
MineDojo-300:主战场
300 个 Minecraft 任务,每任务 8 次尝试。
| 方法 | 战斗 | 采集 | 总体成功率 | ≥4/8 覆盖 |
|---|---|---|---|---|
| JARVIS-VLA | 7.56 | 5.00 | 6.71 | 5/300 |
| UI-TARS-1.5-7B | 0.56 | 0.00 | 0.38 | 0/300 |
| NitroGen | 0.00 | 0.00 | 0.00 | 0/300 |
| GameWAM | 14.00 | 9.88 | 12.63 | 16/300 |
| Qwen3.5-9B | 11.75 | 4.13 | 9.21 | 13/300 |
| Player-1-9B-SFT | 12.50 | 6.63 | 10.54 | 20/300 |
| Player-1-35B-A3B-SFT | 30.31 | 9.50 | 23.38 | 76/300 |
| Player-1-9B | 52.31 | 10.38 | 38.33 | 136/300 |
| Player-1-35B-A3B | 55.56 | 12.00 | 41.04 | 142/300 |
表2:MineDojo-300 任务成功率与覆盖率(8 次尝试/任务)。
几个观察。9B 模型 SFT 只把成功率从 9.21% 抬到 10.54%——示范启蒙基本没教会它玩 Minecraft;但 RL 之后直接到 38.33%,27.8 个点的提升,全部来自合成经验。更要命的是覆盖列:能在 8 次里稳赢至少 4 次的任务从 20 个涨到 136 个,说明这不是运气好蒙出来的,是稳定性本身在涨。
不过也有要泼冷水的:采集类任务只有 10.38%,跟战斗的 52.31% 差出一个数量级。合成环境里练的主要是操控,采集这种长程资源规划任务显然没吃到多少红利。作者没回避这个拆分,这点好评。
泛化到训练套件之外
ViZDoom-10(第一人称射击,10 张图,每图 50 次)上报告归一化回报:
| 方法 | 精确射击 | 目标导航 | 移动 combat | 生存 | 总体 |
|---|---|---|---|---|---|
| GameWAM | 0.1175 | -0.1285 | 1.1860 | 0.1424 | 0.3938 |
| Player-1-9B-SFT | 0.4403 | 0.1839 | 0.5293 | 0.5423 | 0.4361 |
| Player-1-9B | 1.0772 | 0.5974 | 0.3033 | 0.7927 | 0.6922 |
| Player-1-35B-A3B | 1.0423 | 0.2628 | 0.5960 | 0.8979 | 0.7236 |
表3:ViZDoom-10 平均归一化回报。Player-1-35B-A3B 的 0.7236 比最强外部 baseline GameWAM 的 0.3938 高出 83.7%。
GameWorld(170 个浏览器游戏任务、34 款游戏)上,Player-1-35B-A3B 成功率 17.25%、进度 38.79%,对比 SFT 的 15.49% 和 34.60% 也有稳定增益。幅度不大,但考虑到这些是浏览器小游戏——和训练套件的 2D/3D 环境形态差异极大——能涨就已经说明了迁移的存在。
最让我意外的是这个:

图4:Player-1-9B 在完全没见过的商业游戏《看门狗2》里:步行导航、接近车辆、上车、城市驾驶,四段连续行为一镜到底。
一个只在合成 2D/3D 小游戏里做过 RL 的 9B 模型,扔进育碧的 3A 开放世界,能完成"走过去-上车-开车走"这条链。说实话看到这个 case 我愣了一下。当然这只是定性展示,没有定量成功率,别当成"能通关看门狗"——但作为迁移能力的 existence proof,足够了。
📊 分析:三个值得记住的发现
发现一:SFT 启蒙不是可有可无,是生死攸关
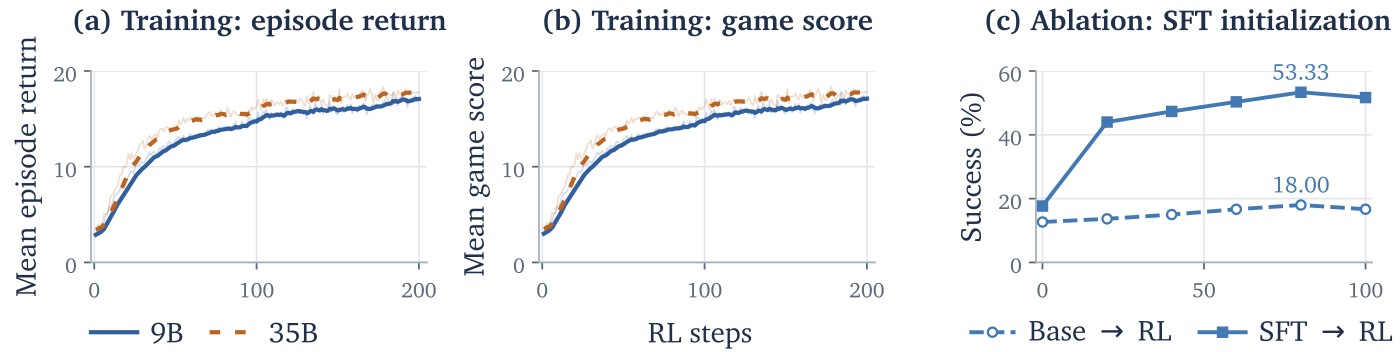
图5:(a,b) 9B 和 35B-A3B 在 200 个 RL 步上的平均回合回报和游戏分数,涨幅前大后小;(c) 消融:同样跑 100 步 RL,SFT 初始化的 Minecraft 成功率从 17.67% 涨到 51.67%,而从 base 模型直接 RL 只从 12.67% 爬到 16.67%——100 步时差了 35 个点。
(c) 这个消融是全文我最想引用的一张图。同样的 PPO、同样的合成环境,有没有 SFT 启蒙,RL 的结局天差地别。道理其实直白:RL 靠探索,而从 base 模型出发的策略连"按住 W 往前走"都采样不出来几次,探索空间里全是垃圾动作,奖励信号稀疏到学不动。SFT 的作用不是教它玩得好,而是把策略推进"偶尔能拿到奖励"的区域,让可验证奖励有机会生效。
这个结论对所有想给智能体上 RLVR 的人都适用:冷启动 RL 前先检查 SFT 策略的奖励通过率,太低就先补示范,别硬跑。
发现二:环境数量越多,迁移越好
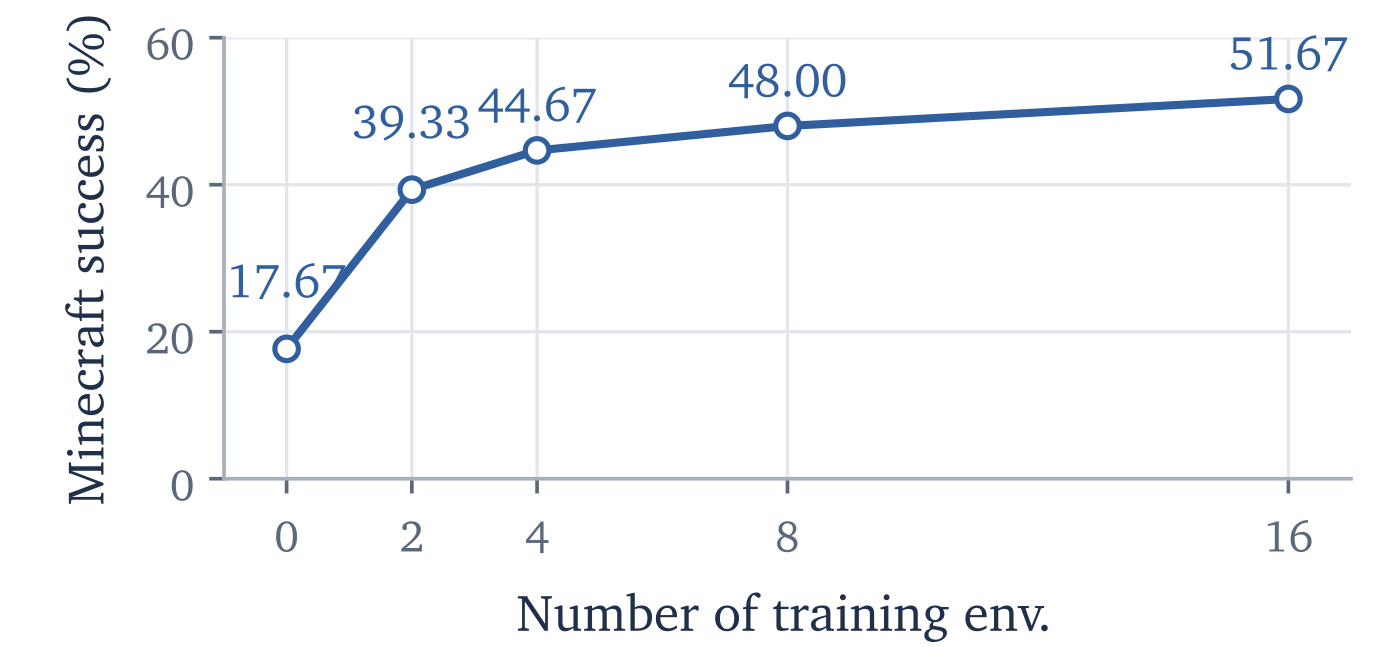
图6:固定 25,600 个 episode 预算,训练环境从 2 个加到 16 个,Minecraft 成功率单调上升:2 个环境 39.33%、4 个 44.67%、8 个 48.00%、16 个 51.67%。
注意这个实验的控制变量做得很干净:总 episode 预算固定,环境多了每个环境分到的样本就少了,但迁移性能还在涨。说明泛化的瓶颈不在单个环境的样本量,而在操控需求的覆盖广度。2 个环境到 16 个环境涨了 12 个多点——合成环境的边际收益远没有枯竭,继续加环境大概率还能涨。
发现三:RL 自己学会了"组合键"
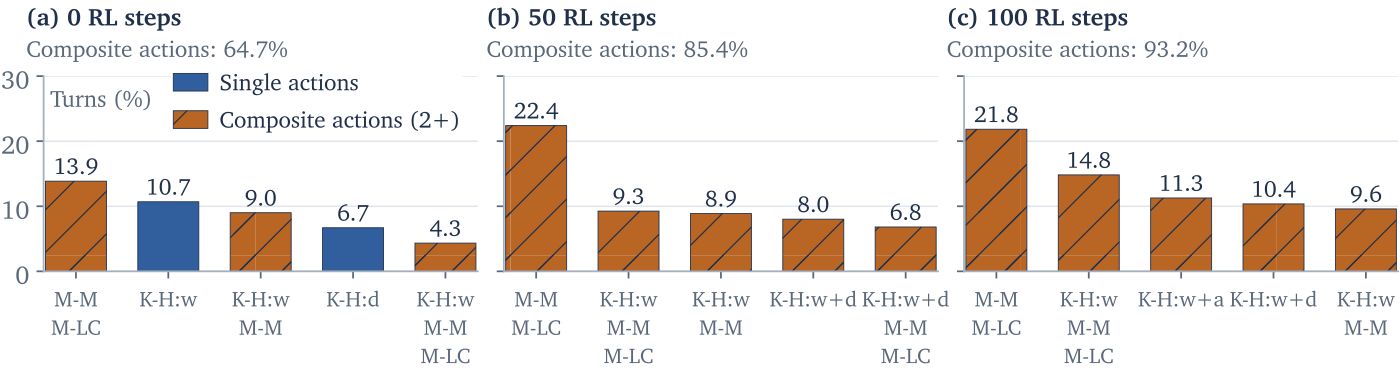
图7:Player-1-9B 在套件内验证轨迹中,组合动作占比从 RL 起点的 64.7% 涨到 50 步的 85.4%、100 步的 93.2%;高频动作几乎全是"鼠标移动+左键""按住W+鼠标移动"这类组合。
没有任何显式奖励鼓励组合动作,纯粹是任务驱动的 RL 把它筛出来了——边移动边转视角、边瞄准边开火,就是打游戏的最优解。这个 emergent behavior 我觉得是全文最漂亮的发现:它说明动作空间设计对了之后,RL 会自己收敛到人类玩家的操控模式。反过来也验证了如果动作空间不支持并发,这些行为根本无从涌现。
🤔 我的判断
这篇论文的定位我会放在"路线验证"而不是"单点突破"。
亮点是实打实的。6044 条轨迹的 SFT 数据规模其实很小——对比 Game-TARS 那种大规模预训练路线,Player-1 证明了与其堆示范,不如把预算挪给合成环境 RL。16 个手搓环境换来 27.8 个点的域内提升和训练套件外的泛化,这个投入产出比相当夸张。而且全链路开源,环境、代码、模型都放出来了,这在游戏智能体这个普遍闭源的领域里很稀有。
但有几个地方要清醒。
第一,合成环境是作者自研引擎手搓的,"五类操控需求覆盖游戏"这个假设对动作类游戏成立,对强策略、强叙事的游戏就不一定了——采集任务那 10% 的成功率就是证据。这条路线的天花板取决于"操控需求分类学"能扩多宽。
第二,MineDojo-300 上 38.33% 听起来碾压 baseline,但 NitroGen 拿 0%、UI-TARS 拿 0.38% 这些数,多半说明这些模型根本没适配这个评测协议(原生预处理和推理流程直接搬过来),而不是真实能力差距。真正的对手是 GameWAM 的 12.63% 和自家 SFT 的 23.38%(35B-A3B),按这个口径,提升仍然扎实,只是没有"三倍吊打"那么夸张。
第三,200 步 PPO、每步 256 episode、50 回合上限——这个训练成本不小,论文没给 wall-clock 和算力明细。想复现的人要有心理预期。
跟 SIMA 2 摆在一起看很有意思:两家都在做"示范启蒙 + 自我经验",但 SIMA 2 用大模型当裁判在生成世界里练,Player-1 用程序化奖励在手搓环境里练。一个弹性大但有噪声,一个严格但需要造环境。我个人的判断是,短期内可验证奖励路线更容易复现和迭代,长期两条线大概率会合流——环境合成器负责出题,程序化规则负责打分,模型规模负责兜底。
如果你在做具身智能或者 GUI 智能体的 RL 训练,这篇有三个可以直接抄的作业:动作空间先支持并发和持续输入再谈 RL、多环境训练必须做逐环境优势归一化、SFT 启蒙的奖励通过率是 RL 能否启动的先决条件。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我