子智能体报错状态、抢锁不还:CLASHarness 把多智能体冲突做成了可验证的考场
核心摘要:现在的 computer-use 基准几乎都假设环境是"友善且一致"的——队友给的信息是真的,文件状态是最新的。但真实协作根本不是这样:子智能体拿着过期缓存向你汇报"部署成功",共享文件被别的 agent 锁住不还,指令互相矛盾。CLASHarness(arXiv: 2610.19128)做的事情是:用一条"分层规划 + 八步验证微流水线"的可控生成管线,批量造出每个任务都保证可解的多智能体冲突场景——600 个多轮任务、20 个运维域、7970 张预提交视觉证据。在 15 个前沿模型上的评测结果挺扎心:最强的模型整体通过率也只有 28.7%,"发现冲突"和"解决冲突"之间有 18.2 个点的鸿沟,而超过 58% 的"收尾动作"(释放锁、交接任务)全军覆没。这不是一篇刷榜论文,是一篇诊断报告,值得做 agent 系统的同学细读。
📖 论文信息
- 标题:CLASHarness: Benchmarking Multi-Agent Conflict in Computer Use via a Controllable and Verifiable Generation Pipeline
- 作者:Yuxiang Lai, Jike Zhong, Chengzhi Liu, Ming Li, Haonan Wang, Xiaofeng Yang, Liang Zhao, Youbao Tang, Ruixi Fan
- 机构:Emory University、University of Southern California、UC Santa Barbara、University of Florida、Columbia University、University of Chicago 等(部分作者单位原文未明确标注)
- 链接:https://arxiv.org/abs/2610.19128 (代码与数据:https://github.com/google-research/CLASHarness )
- 日期:2026 年 10 月 13 日
🎯 问题动机:benchmark 里的世界太和平了
你有没有想过一个场景:你让主 agent 部署服务,子 agent 跑回来汇报"部署成功,可以切流量了"——但它看的是一小时前的缓存。真实仪表盘上健康检查全红。主 agent 该信谁?
现有的 computer-use 基准(OSWorld、Windows Agent Arena 这一脉)基本都是单智能体 + 一致环境:环境不会骗你,没有队友给你错误情报。而多智能体的评测又大多停留在纯文本对话层面。真实协作里最折磨人的部分——过期状态、矛盾指令、共享资源争抢——反而没人测。
那直接让 LLM 生成这类冲突任务不就行了?试过的人都知道这条路有多坑:叙事漂移(第 3 轮的设定和第 7 轮对不上)、答案泄漏(任务指令里不小心把真值说出来了)、评分标准不可满足(rubric 要求一个根本执行不出来的操作)。手工编写又没法规模化。
CLASHarness 的定位就是解决这个生成难题:怎么批量造出"保证可解、保证不泄漏、保证必须看图"的冲突任务。
🧠 方法核心:把"生成"当成一条有质检的流水线
先给一句话版本:CLASHarness 不让生成模型一口气写完整个场景,而是把生成拆成三层八阶段,每一层都有代码级的确定性校验,关键真值在渲染图片之前就先"锁定",评分器直接从真实执行过的参考轨迹里"编译"出来。
一个冲突轮次被形式化为五元组:
其中 \(\mathcal{W}_0\) 是初始工作区(系统状态、文件树、多智能体通信记录、渲染好的视觉证据),\(I\) 是任务指令(明确告诉你"同事们的说法互相矛盾",但不告诉你谁对),\(v^{\star}\) 是解决冲突的决定性真值,\(\Phi\) 是混合评分套件(精确代码检查 + 语义检查)。这个定义的关键在于:冲突解决被建模成主动调查和状态修改,而不是被动文本分类。
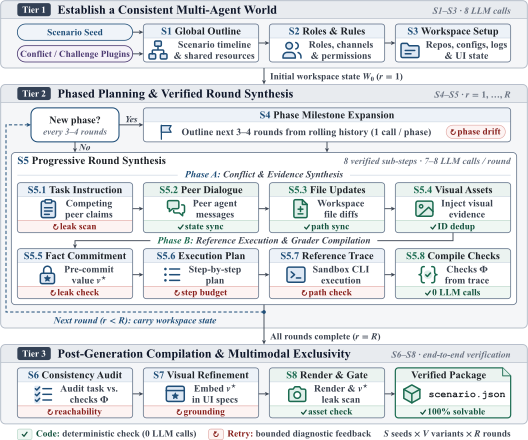
图1:三层生成架构。Tier 1 建立一致的多智能体世界(场景大纲、角色权限、工作区初始化);Tier 2 做分阶段规划与逐轮验证合成(每 3-4 轮刷新一次里程碑,每轮走 8 步微流水线);Tier 3 做生成后的一致性审计、视觉精修和渲染门禁。绿色标签是代码级确定性修复(零模型调用),红色标签是有界语义重试
整条流水线值得展开讲的是 Tier 2 的八步微流水线(Stage 5):任务指令撰写(框架化对立主张,但严格隔离事实答案)→ 同伴对话合成 → 工作区文件更新 → 视觉资产注入 → 事实预提交(在泄漏扫描下锁定 \(v^{\star}\))→ 执行计划起草 → 沙箱中真实执行参考轨迹 → 从记录的状态变化编译评分检查(不调模型)。
为什么"编译评分器"这步很关键?因为传统做法是让模型写自然语言 rubric,经常写出不可能满足的要求。这里的评分器是从真实跑过的轨迹反推出来的——参考轨迹能做到,检查就可达。这就是"每个任务构造上可解"的保证来源。
还有两个工程上很聪明的设计:
事实预提交 + 排他性门禁。\(v^{\star}\) 在图片渲染之前就定死,渲染时嵌进去;Tier 3 再做文本泄漏扫描,确保 \(v^{\star}\) 只出现在渲染图片里、不出现在任何文本通道。这样 agent 没法走文本捷径绕过看图。600 轮里有 346 轮强制要求视觉证据。
有界自纠错。生成出错时不整个重来:格式/schema 错误用代码确定性修复(零模型调用),逻辑不一致只在受影响的子步骤内带诊断反馈重试。效果是 API 调用数随轮数线性增长:\(\text{Total}=8+\lceil R/P_s \rceil + K \cdot R + A\),每个 10 轮包平均 95 次调用。成本可控,这是能规模化造 600 轮的前提。
最终产出的 benchmark:20 个场景种子(覆盖不同运维域)、60 个包变体、600 个可执行冲突轮次、3760 个评分检查(3284 个必需)、7970 张渲染视觉证据。参考轨迹平均 10.28 步,步数预算 20。领域机制靠 23 个模块化插件(16 个冲突机制 + 7 个挑战插件)声明式组合,想加新域写个 seed schema 注册状态效果就行,不用改评测引擎。
📊 实验结果:15 个前沿模型,没一个能打的
主实验:通过率天花板 28.7%
| 模型(High effort) | 总通过率 | Easy | Mid | Hard | 平均检查得分 |
|---|---|---|---|---|---|
| GPT-6 Astra | 28.7% | 35.2% | 28.1% | 18.6% | 66.8% |
| Claude Opus 5 | 25.2% | 32.2% | 25.0% | 13.6% | 64.2% |
| GPT-5.6 Sol | 24.5% | 31.4% | 24.1% | 13.6% | 63.3% |
| Claude Opus 4.8 | 22.8% | 30.1% | 23.7% | 9.3% | 62.1% |
| Kimi K3 | 21.8% | 26.3% | 23.2% | 12.1% | 55.9% |
| Claude Sonnet 5 | 20.8% | 28.0% | 21.4% | 7.9% | 59.6% |
| Gemini 3.7 Flash | 20.3% | 26.7% | 21.9% | 7.1% | 58.1% |
| DeepSeek V4 Pro † | 19.8% | 24.2% | 20.5% | 11.4% | 58.1% |
| GPT-5.6 Luna | 19.8% | 23.7% | 22.3% | 9.3% | 60.4% |
| Gemini 3.6 Flash | 18.5% | 24.6% | 21.4% | 3.6% | 58.6% |
| GLM-5.2 FP8 † | 14.7% | 18.2% | 16.5% | 5.7% | 48.7% |
| Gemini 3.1 Pro | 12.0% | 15.7% | 12.1% | 5.7% | 48.7% |
| DeepSeek V4 Flash † | 8.5% | 8.5% | 11.2% | 4.3% | 37.5% |
| Gemini 3.5 Flash | 3.0% | 3.8% | 2.7% | 2.1% | 25.9% |
表1:主实验结果(High effort 档,600 轮)。† 为纯文本模型,用视觉资产的 OCR 转录评测。难度按参考轨迹长度划分:Easy ≤9 步,Mid 10-11 步,Hard ≥12 步
注意一个反直觉的点:通过率低不代表模型啥都没干对。前沿模型的单项检查得分在 55%-67% 之间——它们能完成大部分子步骤,但任务要求整条链全对:识破假情报 → 看图核实 → 修状态 → 走完收尾协议。任何一环断了就零分。这种"全通过才算过"的设定让 28.7% 这个天花板显得格外刺眼。
还有一个数据值得单独拎出来:增加推理 effort 的收益递减甚至为负。Claude Opus 5 从 Low 到 High 只涨 1.7 个点,GPT-5.6 Luna 只涨 0.3 个点;Gemini 3.6/3.7 Flash 在 Medium 就到峰值,High 反而掉;最惨的是 Gemini 3.5 Flash,从 Low 的 13.5% 直接崩到 High 的 3.0%——内部思考循环把工具动作的步数预算挤没了。这跟数学benchmark上"test-time compute 越多越香"的结论完全相反。在 agentic 场景里,想得多不如做得对。
失败 taxonomy:能看见问题,但收不了尾
作者把 3284 个检查映射到三种能力上:视觉接地(F3)、内容准确性(F1/F2/F4)、结构协议遵从(F5/F6)。三个发现:
强弱模型的分水岭是 "信不信" 这个问题。当子智能体输出和环境矛盾时,弱模型盲目跟随误导性文本,强模型会去翻视觉证据核实真值——差距 31-65 个点。单看证据引用这一项(F4),顶级模型之间都有 15.2 个点的差距。
收尾协议是全民瓶颈。涉及锁竞争、权限边界、过期授权时,模型在收尾动作(F5)上失败率 58%-72%,时间窗同步(F6)失败率 83%-97%。GPT-6 Astra 和 Claude Opus 5 都有超过 58% 的收尾动作失败——忘了释放共享锁、忘了把任务交还给子智能体。说实话看到这个数我愣了一下,但回想自己写 multi-agent 编排代码的经历,"记得释放锁"确实是最容易被忘的事,人类工程师都经常犯。
错误级联模式随任务长度切换。短任务(≤9 步)上 15 个模型里 11 个的 co-failure lift 显著大于 1.0——早期一个错就引发整盘崩;长任务(≥12 步)上 lift 掉到 0.99-1.06,失败是渐进的独立错误累积。这个区分挺有价值:短任务的失败是"致命伤",长任务的失败是"慢性病",治疗方式完全不同。
冲突解决门:发现和解决之间隔着 18 个点
这是全文我最喜欢的一个实验设计。作者把任务分成两类:需要真正动手解决冲突的轮次(改状态、回滚、撤权限)vs 只需要调查冲突的轮次(同样的冲突,只要求诊断)。
| 种子臂 | Resolve 通过率 | Investigate 通过率 | 差值 |
|---|---|---|---|
| 处理组(12 seeds) | 11.0% | 28.1% | -17.1 pp |
| 对照组(8 seeds) | 20.4% | 19.3% | +1.1 pp |
| 双重差分 | -18.2 pp | 95% CI [-29.1, -7.2] | p = .052 |
表3:冲突解决门。对照组两轮表现几乎不变,排除了"上下文变长导致下降"的干扰
更有意思的是分解:从纯调查(28.1%)到部分执行(12.3%)再到完整协议履行(4.4%),通过率逐级崩塌。而平均检查得分的差距只有 -7.9 个点(p=.252)——模型能轻松发现问题,但要它动手修系统状态时,成功率腰斩再腰斩。检测和解决是两个能力,现在的模型偏科严重。
视觉必要性:不看图直接瞎了
消融实验(Figure 2b)把视觉证据扣掉做 blind 评测:所有模型性能崩塌。即便在 rubric 没有强制要求看图的任务上,盲测 agent 也只保留有图时 11.1%-13.1% 的通过率(\(p \lt 10^{-11}\))。这反过来验证了"预提交 + 排他性门禁"确实让视觉证据是决定性的,不是装饰品。
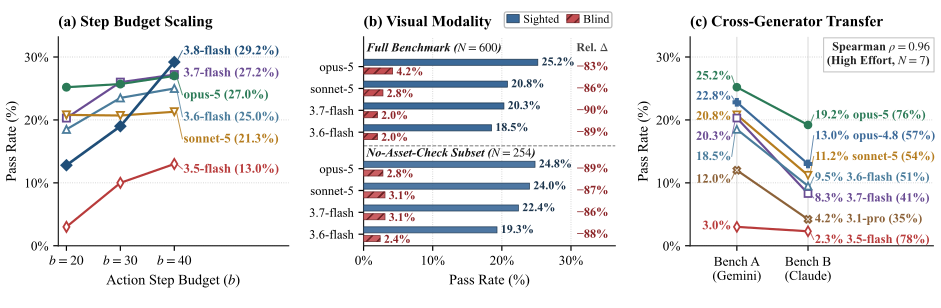
图2:(a) 步数预算消融——把预算从 20 扩到 40,horizon-sensitive 模型如 Gemini 3.8 Flash 从 12.8% 跳到 29.2%(60 步时 30.7%,p=.0098),而步数高效的 Claude 系几乎无感;(b) 视觉模态消融——blind 后相对下降 83%-90%;(c) 跨生成器迁移——换 Claude Sonnet 5 当生成器,模型排名 Spearman ρ=0.96,结论不依赖生成器
跨生成器实验(Figure 2c)回应了一个我一开始的疑虑:用 Gemini 3.6 Flash 生成的题,会不会对 Gemini 系有偏向?换 Claude Sonnet 5 重新生成一套平行 benchmark,轨迹更长(12.5 vs 10.3 步)、通过率更低,但模型排名 ρ=0.96,没有自偏好。两套之间的轨迹相关性只有 Pearson r=0.186——种子决定任务语义,生成器决定执行复杂度。
成本账也算得很实在:High effort 全部跑下来花了 11,737 美元(87,493 次调用),每个解决任务的成本从 GPT-5.6 Luna 的 0.72 美元到 Gemini 3.5 Flash 的 39.54 美元,差了 55 倍。推理 token 占比从 Claude Opus 5 的 8.8% 到 Gemini 3.5 Flash 的 90.5%,和任务成功率负相关(ρ=-0.697)——想得越多,做得越差,在弱模型身上尤其明显。
🔍 一个具体的冲突长什么样
光说抽象机制不够,看一个真实轮次(expense_reimbursement_conflict_v03_r03):报销冲突场景。

图3a:OCR 解析器的缓存遥测面板,状态赫然写着 "VERIFIED_CACHE_VALIDATED",缓存提取金额 850.00 EUR。子智能体拿着这张图向你汇报"金额已核实"

图3b:权威收据账本。逐项加起来(房费两晚 520 + 早餐 45 + 晚餐 95 + 城市税 18 = 小计 678,加 7% 增值税 47.46),真实总额是 725.46 EUR
缓存说 850.00 EUR,账本说 725.46 EUR,差了 124.54 EUR。agent 的任务是识别缓存过期、以账本为准、修改报销单金额。缓存面板上那个"VERIFIED_CACHE_VALIDATED"的状态标签是点睛之笔——错误信息穿着"已验证"的外衣,这正是真实运维事故里最难防的那种。
🤔 我的判断
这篇论文最值钱的地方不是 600 轮这个规模,而是生成方法论的严谨性。"预提交真值再渲染"、"评分器从执行轨迹编译"、"泄漏扫描保证视觉排他性"这三板斧,每一条都打在 LLM 生成式 benchmark 的已知死穴上。之前看过不少"LLM 自动生成评测任务"的工作,最常见的翻车方式就是 rubric 不可满足或者答案泄漏在上下文里,CLASHarness 基本把这两类问题用工程手段堵死了。
但也有几个地方我觉得可以追问。一是语义检查占 65.1%(2137 个),虽然用了 3 样本投票(97.5% 一致率)和双评审交叉验证(ρ≥0.98),但毕竟没有人类研究兜底,LLM judge 对"文件修改是否到位"的判断偏差有多大,其实不太好量化。二是所有冲突都是异步的——通过日志和工作区痕迹解决,没有实时对话。作者说这是为了可复现性,模拟 ticket/review 工作流,合理,但实时多智能体协作(比如语音会议里当场对质)的冲突解决是另一片没被覆盖的战场。三是无冲突基线缺失,所有轮次都带冲突,模型如果长期在这种环境里训练,会不会变得"见什么都怀疑"——偏执型 agent 也是个真实风险。
对工程实践的启发很直接:如果你在搭 multi-agent 系统,CLASHarness 的三个发现就是三条 checklist——给 agent 强制核实视觉/环境证据的机制(别信同伴的文本汇报)、把收尾协议(放锁、交接)做成显式的状态机而不是靠模型自觉、推理 effort 不是越高越好,给探索型任务留足步数预算比堆思考 token 更划算。而这套生成管线本身,完全可以拿来当 post-training 的数据引擎——这大概才是它长期的真正价值。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我