Waypoint-OPD:教师的 RL 训练中途反悔了,蒸馏信号该不该跟着它走?
先把一个场景摆出来:你想把一个 4B 小模型 RL 训练出来的推理能力,蒸馏给一个 30B 的大模型学生。手头最自然的监督信号是什么?是教师 RL 前后的 log 概率差——也就是 Direct-OPD 那套做法:RL 让教师更喜欢哪些 token,就让学生在同样的位置也喜欢它们。
这个信号有个盲区,而且盲区还不小。
同样的"终点位移",可能是两段方向一致的位移叠加出来的,也可能是两段互相打架的位移抵消出来的。 教师 RL 前半程把某个 token 的概率往上推,后半程又把它拽回来——最终端点差可能还是正的,但这真的是你想教给学生的东西吗?光看 Initial 和 Final 两个端点,你根本分辨不出这两种情况。
今天聊的这篇 Waypoint-OPD(arXiv:2610.21601),就是冲着这个盲区来的。思路一句话说完:把教师 RL 训练的中途检查站(Waypoint)也捞出来,看前半程和后半程的位移方向是否一致——一致才加权转移,打架就把这个信号摁掉。 在数学和代码两个域、三个 Qwen3 学生(8B/14B/30B-A3B)上全部拿到对比蒸馏方法里的最高均分,相对最强的 Direct-OPD 基线数学上平均多涨 1.59 到 2.18 个点。而代价只是多跑一次冻结教师的打分前向。
论文信息
- 标题:Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- 作者:Bingxi Hou, Guochao Jiang, Guofeng Quan, Weiqing Li, Wenfeng Feng, Guohua Liu, Yuewei Zhang(通讯作者)
- 机构:Alibaba Cloud Computing
- 链接:https://arxiv.org/abs/2610.21601
- 代码:https://github.com/hhhbxloveai/WaypointOPD
📖 核心摘要
Policy-shift distillation 这条线(代表作是 Direct-OPD)把教师 RL 前后的 log 概率比当作学生轨迹上的稠密隐式奖励,省去了 verifer 调用,是个很优雅的设计。但它只看端点:Initial→Final 的总位移里,哪些局部偏好是 RL 全程稳定强化的,哪些是中途反复甚至反转的,端点差一个字都不会告诉你。Waypoint-OPD 的做法是从同一次教师 RL run 里取一个中间 checkpoint,把端点位移拆成 Initial→Waypoint 和 Waypoint→Final 两段,在学生实际访问的前缀上算两段位移的加权余弦相似度,作为门控系数乘回端点信号上。方向一致的门开到最大,方向打架的直接归零。六个"域×学生"设置全部拿下蒸馏方法最高均分,消融显示去掉门控数学均分掉 2.64 个点、把门打乱掉得更狠——说明增益确实来自"一致性加权"本身而不是别的什么。我的判断:这不是底层突破,是个非常工程化的信号筛选补丁,但补丁打得准、便宜、可复现,做弱到强蒸馏的同学值得抄。
🎯 问题动机:端点位移里的"时间暗雷"
先把背景捋顺。RL 训推理模型现在很贵——反复生成、验证、优化 on-policy 响应。如果能把一个教师的 RL 成果"转移"给别的学生模型,这笔训练开销就可以摊销。问题是:教师策略的哪些局部变化,应该在学生自己生成的轨迹上起监督作用?
这条线上已有几个代表性方案,论文里把它们的关系讲得很清楚:
- OPD(Agarwal et al., 2024):学生在自己生成的前缀上对齐 Final 教师的 token 分布(reverse-KL)。监督绑死在教师的绝对策略上,教师能力上限就是天花板。
- OPD²(Heo et al., 2026):用"推理调优教师 vs 其 base 模型"的变化量,当它和标准蒸馏信号符号一致时才保留 token 级信号。
- Direct-OPD(Feng et al., 2026):直接用 RL 前后教师的 log 概率比 \(\delta_t(a) = \log\pi_1(a|s_t) - \log\pi_0(a|s_t)\) 当学生轨迹上的 token 级即时奖励,转移"策略变化"而非"绝对分布"。
注意到没有——这些方法都是从一对教师模型里提取变化。没有任何一个去检查:教师 RL 训练过程中,连续的两段变化方向是否兼容。
论文给了一个很直观的例子。设端点中心化位移为 \(d\),两种分解都能产生同一个 \(d\):\(u=v=d/2\)(两段同向,各贡献一半),或者 \(u=2d, v=-d\)(前半程推过头、后半程拉回来)。前者是"RL 全程稳定强化的偏好",后者是"教师中途反悔的噪声"。端点信号对这两种情况一视同仁。
这就是我说的暗雷。你想想 RL 训练的实际情况:reward 波动、探索抖动、学习率衰减期的策略收缩——中途反悔的位置恐怕不在少数。把这些信号原样灌给学生,学生被迫去拟合一个"教师自己都没想清楚的偏好"。
🏗️ 方法核心:三检查站 + 余弦门控
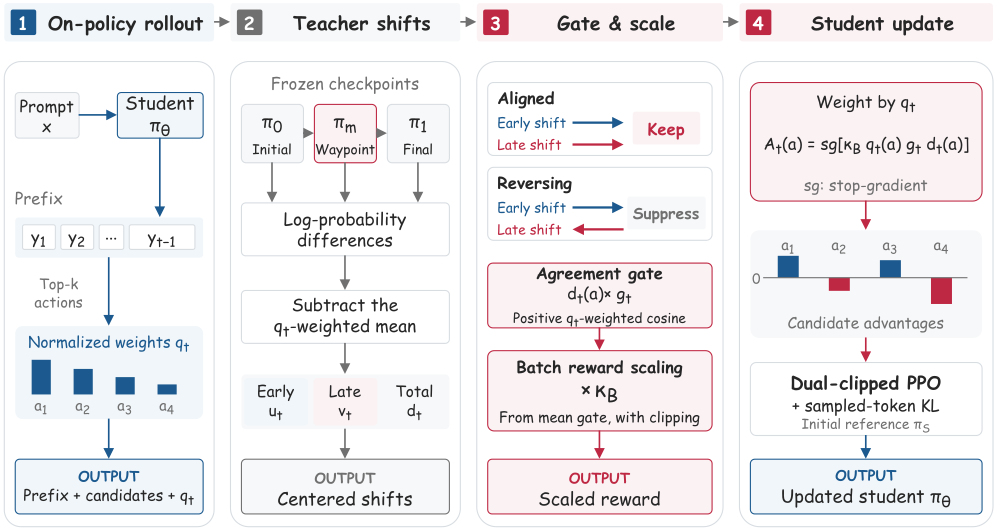
图 2:Waypoint-OPD 的四步流水线。①学生 on-policy rollout 并取 top-k 候选;②三个冻结教师(Initial/Waypoint/Final)对候选打分,拆出早段位移 \(u_t\)、晚段位移 \(v_t\) 和端点位移 \(d_t\);③方向一致(Aligned)就保留,方向反转(Reversing)就抑制,再乘批次缩放系数 \(\kappa_B\);④以 detach 后的候选优势驱动 dual-clipped PPO 更新学生。Waypoint 只负责"测一致性",不是模仿目标。
整个方法可以拆成三层,每层都不复杂,但拼在一起挺精巧。
第一层:学生视角的局部候选
在学生访问的前缀 \(s_t\) 处,不看整个词表,只看学生当前概率最高的 \(k\) 个候选 token:
\(q_t\) 是候选集上的归一化学生分布。这一步的含义是:一致性只在"学生真的会去的位置"和"学生真的会选的候选"上评估,学生概率高的候选权重更大。三个冻结教师对这批候选打分。
第二层:中心化 + 两段位移的一致性
两段位移:
两者 telescoping 相加正好等于端点位移 \(\delta_t = \delta_t^{(1)} + \delta_t^{(2)}\)——这个性质保证了 Waypoint 只影响门控权重,不改变被转移的端点信号本身(附录 A.1 有推导)。
有个细节值得说:如果某个位移对所有候选是均匀加上一个常数,它不改变候选间的相对偏好,但会改变原始向量的夹角。所以作者先用 \(q_t\) 加权均值做中心化:\(C_{q_t}[z](a) = z(a) - \mathbb{E}_{b\sim q_t}[z(b)]\),得到 \(u_t = C_{q_t}[\delta_t^{(1)}]\)、\(v_t = C_{q_t}[\delta_t^{(2)}]\)、\(d_t = C_{q_t}[\delta_t] = u_t + v_t\)。然后算 \(q_t\) 加权内积下的余弦:
第三层:正余弦门 + 批次归一化 + 稠密目标
门控就是正余弦截断:
\(c_t \le 0\) 时整个前缀的端点信号被清零;\(c_t > 0\) 时按一致性程度缩放。有个兜底:当任一段的中心化范数不超过 \(\varepsilon = 10^{-8}\)(位移太小、方向不可靠)时设 \(g_t = 1\),保留端点信号。注意门是前缀级的——同一前缀下所有候选共享一个 \(g_t\)。
门控会降低每批的平均信号强度,而且训练越往后门控越狠(后面诊断图会证实),所以作者加了一个批次级缩放:
把批内平均门拉回到目标值 \(\tau = 0.8\),裁剪区间 \([0.75, 1.5]\)。这个共享正乘子不改变相对权重、不改变零门。
最终候选 \(a\) 的系数:
学生目标是稠密的 on-policy surrogate:\(\sum_t \sum_{a\in\mathcal{K}_t} A_t(a)\log\pi_\theta(a|s_t)\) 减去对学生初始策略 \(\pi_S\) 的 KL 惩罚(\(\beta = 2.5\)),实现上用 candidate-wise dual-clipped PPO。附录 A.2 证明了一个挺漂亮的性质:中心化保证 \(\sum_a A_t(a) = 0\),softmax 公共项被消掉,候选 token 上的 logit 梯度正好就是 \(-A_t(a)\),非候选 token 梯度为零——更新精确打在候选集上。
开销账:相对 Direct-OPD,只多了一个冻结 Waypoint 教师的打分前向。不增加可训练参数,不增加学生 rollout,不需要 verifer。实测训练时间反而更短(8h02m vs 8h21m,省 3.73%)——因为被门控摁掉的信号少了,学生响应更短、截断率更低,后面细说。
🧪 实验:六个设置全部拿下
实验配置:教师是同一次 Qwen3-4B RL run(GRPO,1200 步,non-thinking)的三个 checkpoint——Initial(RL 前)、Waypoint(第 600 步)、Final(第 1200 步)。学生是 Qwen3-8B、Qwen3-14B、Qwen3-30B-A3B,横跨 dense 和 MoE,同族分词器兼容。数学转移用 DAPO-Math-17K,评 AIME 2024/2025/2026、HMMT 2025 Feb/2025 Nov/2026 Feb、AMC 2023 七个基准(mean@32);代码用 Codeforces 衍生提示集,评 MBPP、MBPP+、LiveCodeBench v4/v5/v6(mean@8)。基线是 Base、OPD、OPD²、Direct-OPD。
数学主表(Table 1,mean@32 %)
| 方法 | AIME24 | AIME25 | AIME26 | HMMT25Feb | HMMT25Nov | HMMT26Feb | AMC23 | Avg. |
|---|---|---|---|---|---|---|---|---|
| Teacher-4B Initial | 21.67 | 21.67 | 21.67 | 12.50 | 10.00 | 15.15 | 71.25 | 24.84 |
| Teacher-4B Waypoint | 58.96 | 54.79 | 56.77 | 31.35 | 35.73 | 31.72 | 93.44 | 51.82 |
| Teacher-4B Final | 65.83 | 60.00 | 60.83 | 35.83 | 40.83 | 35.13 | 94.45 | 56.13 |
| 8B Base | 29.17 | 20.83 | 18.33 | 11.67 | 13.33 | 18.94 | 70.00 | 26.04 |
| 8B OPD | 63.65 | 49.69 | 54.90 | 29.06 | 38.65 | 32.58 | 88.75 | 51.04 |
| 8B OPD² | 64.48 | 48.33 | 53.96 | 28.44 | 40.52 | 31.53 | 92.97 | 51.46 |
| 8B Direct-OPD | 67.29 | 55.31 | 57.40 | 31.77 | 40.83 | 33.71 | 91.41 | 53.96 |
| 8B Waypoint-OPD | 68.85 | 57.92 | 60.21 | 34.38 | 42.60 | 36.36 | 92.66 | 56.14 |
| 14B Direct-OPD | 70.10 | 56.46 | 61.98 | 37.92 | 47.60 | 35.13 | 94.06 | 57.61 |
| 14B Waypoint-OPD | 70.21 | 60.52 | 63.75 | 40.21 | 47.08 | 36.55 | 96.09 | 59.20 |
| 30B-A3B Direct-OPD | 69.17 | 54.69 | 61.98 | 38.96 | 41.56 | 33.05 | 92.34 | 55.96 |
| 30B-A3B Waypoint-OPD | 70.94 | 58.44 | 63.65 | 39.90 | 44.69 | 32.77 | 94.53 | 57.85 |
(14B 和 30B 的 OPD/OPD² 行此处从略,均低于 Direct-OPD;完整数据见原文 Table 1。)
几个值得停一秒的数字。8B 学生的 56.14 几乎追平 4B Final 教师的 56.13;14B 和 30B-A3B 学生分别以 3.07 和 1.72 个点反超 Final 教师,14B 在全部七个基准上都超过教师。21 个基准对比里 Waypoint-OPD 赢了 19 个,两处例外(14B 的 HMMT25Nov、30B 的 HMMT26Feb)差距都在 0.5 个点以内。
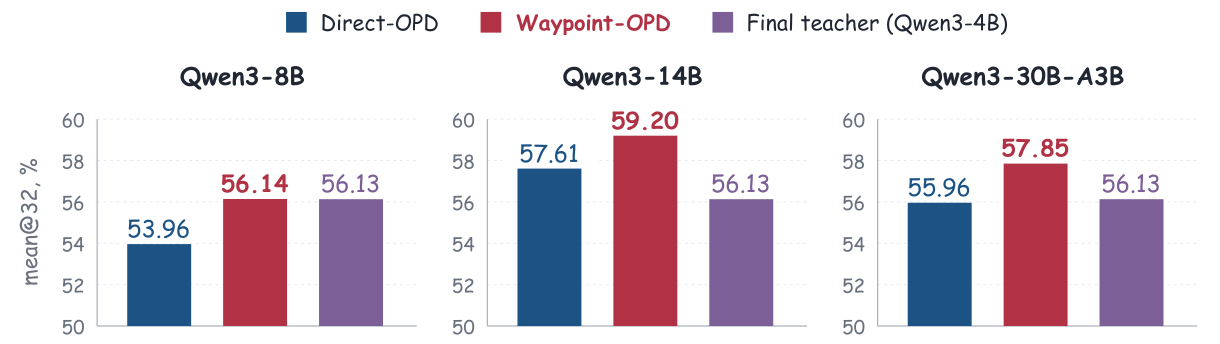
图 1:Direct-OPD、Waypoint-OPD 与 4B Final 教师的数学七基准均分对比。三个学生规模上红柱(Waypoint-OPD)都是最高的,14B 和 30B-A3B 学生反超紫柱(Final 教师)——4B 教师的 RL 位移信号喂出了比教师更强的学生。
代码主表(Table 2,五项评测的 mean@8 平均,%)
| 方法 | Qwen3-8B | Qwen3-14B | Qwen3-30B-A3B |
|---|---|---|---|
| Base | 41.03 | 47.72 | 50.33 |
| OPD | 43.91 | 51.66 | 51.91 |
| OPD² | 51.21 | 55.60 | 55.96 |
| Direct-OPD | 50.59 | 56.30 | 56.35 |
| Waypoint-OPD | 53.25 | 57.82 | 57.54 |
代码教师参考:Initial 37.64、Waypoint 52.22、Final 55.37。Waypoint-OPD 比 Direct-OPD 平均多涨 2.66、1.52、1.19 个点,15 个代码对比全胜。14B 和 30B-A3B 学生同样反超 Final 教师(2.45 和 2.17 个点)。有意思的是 8B 代码上 OPD² 其实压过 Direct-OPD,说明"端点直转"在这档规模上并不总是最强基线——但 Waypoint-OPD 照样把两者都超了。
训练动态:不是选 checkpoint 的运气

图 3:Qwen3-8B 数学训练 100 步内、AIME25/AIME26/HMMT25Nov 上的 mean@32 曲线(0/20/40/60/80/100 步)。红线 Waypoint-OPD 几乎全程压着蓝虚线 Direct-OPD,灰虚线是 4B Final 教师。HMMT25Nov 上第 60 步起学生就反超了教师。
说实话我第一反应是:主表结果会不会是"按 AIME24 验证集选 checkpoint"选出来的运气?这张图部分打消了这个疑虑——15 个"基准×checkpoint"对比里 Waypoint-OPD 赢 13 个,第 60 步之后三个基准全赢,第 100 步分别领先 4.17、3.13、0.10 个点。优势是全程持续的,不是某一步的尖峰。
🔬 消融:门控、门的归属、归一化,一个都不能乱动
Qwen3-8B 数学上的三个消融(Table 3,Avg. 列):
| 变体 | Avg. | 相对完整版 |
|---|---|---|
| No gate(\(g_t \equiv 1\)) | 53.50 | -2.64 |
| Shuffled gate(批内打乱门与前缀的对应) | 51.20 | -4.94 |
| No normalization(\(\kappa_B \equiv 1\)) | 55.22 | -0.92 |
| Direct-OPD | 53.96 | -2.18 |
| Waypoint-OPD 完整版 | 56.14 | — |
这张表有三个信息点,一个比一个有意思。
去掉门控掉到 53.50,比 Direct-OPD 还低 0.46——说明保留 centering 和归一化规则并不能挽回损失,增益确实来自一致性加权本身。
打乱门掉到 51.20,比去门还惨 2.30 个点。这个设计很聪明:打乱后批内门的分布和均值不变(\(\kappa_B\) 也不变),唯一被破坏的是"门与产生它的前缀之间的对应关系"。乱配的门比没有门更有害——等于在往错误的位置随机衰减信号。这基本排除了"门控只是某种随机正则化"的解释。
去掉批次归一化只掉 0.92 个点,但仍比 Direct-OPD 高 1.26——归一化是锦上添花,不是主引擎。
另外附录 F 做了 Waypoint 位置敏感性:第 500/600/700 步分别得 56.18/56.14/56.13,总波动只有 0.05 个点,且三档都全基准赢 Direct-OPD。这个稳定性挺让人安心的——不用纠结中途点到底选哪。
📊 门控诊断与效率彩蛋
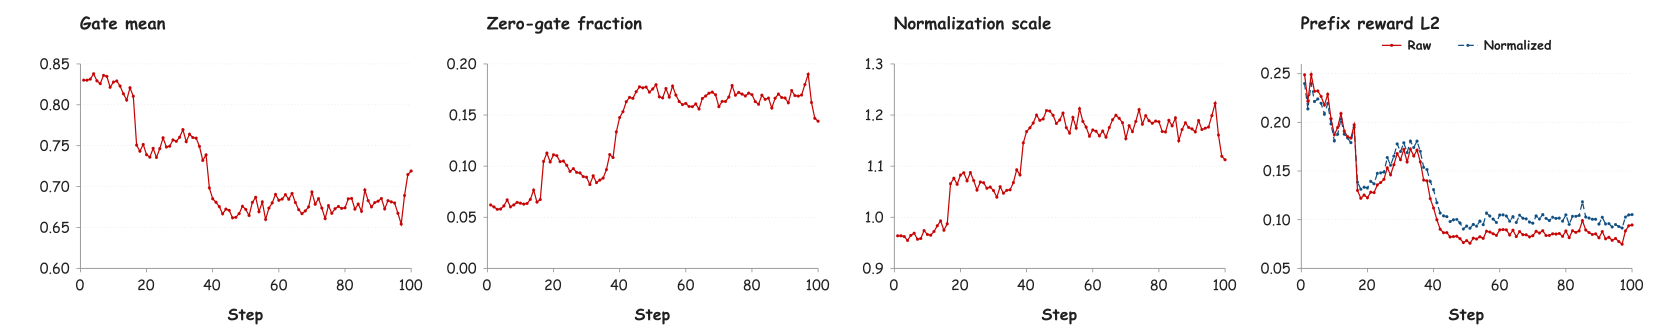
图 4:8B 数学训练 100 步的门控统计。从左到右:平均门 \(g_t\)(从 0.810 降到 0.683)、零门前缀占比(7.26% 升到 16.59%)、批次缩放系数 \(\kappa_B\)(在 [0.955, 1.223] 内波动)、每前缀奖励向量 L2 范数(归一化前后)。
这张诊断图透露了一个没被正文强调的动态:训练越往后,门控越狠——零门比例翻倍还多。学生的候选分布在漂移,教师两段位移在新前缀上打架的情况变多了,门控自动衰减。而 \(\kappa_B\) 同步把平均门拉回 0.8,保证有效学习率不塌。这套"自适应衰减 + 均值补偿"的组合在跑,不需要人工调。
效率上的彩蛋:Waypoint-OPD 训练总时长 8h02m21s,比 Direct-OPD 的 8h21m03s 还快 3.73%,GPU 小时从 66.81 降到 64.31。多了一次教师前向怎么还更快?看下两张图。


图 5:100 步训练中学生 rollout 的平均响应长度(左)与 16,384 token 上限处的截断率(右)。Waypoint-OPD 在 87/100 步上响应更短,平均截断率从 14.83% 降到 11.97%,少了 2.86 个百分点。
被摁掉的噪声信号少了,学生不再被往"教师中途反悔的方向"拉扯,响应更短、更少撞长度上限——rollout 生成开销省下来了,覆盖掉了 Waypoint 打分前向的成本还有富余。等等,一个蒸馏方法因为"信号更干净"而训练更快,这个因果链我还挺买账的。
🤔 我的判断
亮点在哪。 这篇最值钱的是把一个模糊的直觉——"端点差掩盖了过程信息"——变成了一个可计算、可消融验证的门控机制。三段 telescoping 分解保证端点信号本身不变,Waypoint 只当裁判不当教练,这个职责划分很干净。打乱门那个消融设计尤其漂亮,直接证伪了"随机衰减也能涨"的平凡解释。加上 Waypoint 位置 ±100 步不敏感、训练时间还倒省,工程上是真便宜。
问题在哪。 几条。门控只看方向一致性,不看位移本身对不对——两段同向的位移也可能都在往坑里走,论文自己也承认"agreement is a weighting criterion, not a guarantee of correctness"。教师和学生同属 Qwen3 同族、共享分词器,跨族跨分词器时 log 概率比较就没这么直接了,泛化性存疑。Waypoint 只测了一个中间点,如果教师在 RL 中后段发生多次反转,两段划分还是太粗——多路标的一致性度量是自然的下一步。另外数学七基准里 AIME/HMMT 占六席,难度偏高,AMC23 上各方法差距已经很小(90+ 分段),增益主要集中在难题上,换个分布未必同样明显。
跟同期工作的位置。 2026 年 on-policy 蒸馏的"选择性监督"突然卷起来了:OPD² 按优势符号门控,RG-OPD 用 verifer 优势与师生似然差门控轨迹,Prune-OPD 按支持重叠衰减后缀。Waypoint-OPD 的独特之处在于证据来源——教师自己 RL 轨迹上的时序一致性,转移期间完全不需要 verifer。跟 Direct-OPD 的关系是严格超集式改良(去门+固定缩放就退化回去),这类"在已验证强基线上打一个便宜补丁"的工作,我认为比另起炉灶的新框架更容易被实际采用。
工程启发。 如果你在做 RL 能力的跨模型转移,或者更广地说,在用"前后 checkpoint 差"做任何形式的监督(proxy-tuning、WSPO 那类也在这个家族里),这篇论文给了一个几乎零成本的自查手段:把训练中途的 checkpoint 捞出来,量一量前后两段位移的方向一致性。一致性差的位置,信号大概率是噪声。这个诊断本身即使不用于门控,拿来分析 RL 训练稳定性也值回票价。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我