Cortex:把"上下文带来的聪明"写进模型参数里,50 次连续编辑后还能记住 88.9%
核心摘要:给模型塞一段上下文(新 API 文档、一条修改过的事实、一段人格指令),它立刻变聪明;但上下文一撤,打回原形。这个"上下文一没就失忆"的问题,做 Agent 和知识编辑的人都头疼。这篇论文(arXiv:2610.20399)把这件事正式定义成 Memory Consolidation(记忆巩固,MC)任务,并给出通用解法 Cortex:让模型自己"预想"这段上下文未来会被怎么用(生成 prospective queries),再把"有上下文时的输出"蒸馏进 FFN 层的新增参数里。在 Qwen2.5-14B 上连续做 50 次事实编辑,Cortex-Structural 每次只加 0.74M 参数,最终 CR(巩固率)88.9%、RR(保持率)99.8%——最强的编辑类 baseline ROME 只有 28.5% CR,AlphaEdit 被甩开 66.2 个点。我的判断:这不是又一个编辑方法,而是把知识编辑、技能学习、行为引导统一到一个目标下的框架级工作,testbed 本身就值得收藏。
论文信息
- 标题:Cortex: Consolidating Context into Parametric Memory
- 链接:https://arxiv.org/abs/2610.20399
- 作者:Jintian Zhang、Feng He、Xinnian Liang、Ziwen Xu、Haoming Xu、Haojing Huang、Shuangzhi Wu、Ningyu Zhang(通讯)
- 机构:浙江大学、ByteDance Seed、清华大学
- 代码:https://github.com/zjunlp/cortex(作者承诺开源 Testbed 与实现)
📖 先聊聊这个问题为什么戳人
你有没有遇到过这种场景:给 Agent 喂了一份踩坑总结,它立刻变乖了;新开一个会话,同样的坑照踩不误。
上下文确实能让模型临时变强——给它一份陌生 API 的文档,它能结合已有编程知识写出正确调用;告诉它"某人的职位变了",它能立刻用新事实回答。但传统 in-context 推理不改参数,上下文一撤,增益归零。
现有的补救路线各有硬伤:
| 路线 | 代表 | 问题 |
|---|---|---|
| 外部记忆/RAG | 检索增强、生成式智能体 | 推理时要先检索到才管用,间接相关的经验容易被漏掉 |
| 知识编辑 | ROME、MEMIT、AlphaEdit | 只处理"改事实",不管技能和行为 |
| 上下文蒸馏 | SELF-PARAM、SDCD 等 | 批量/连续场景下巩固率上不去(后文有数据) |
| 行为引导 | persona steering 方法 | 各玩各的接口,互不通用 |
说实话,我的第一反应是:这不就是持续学习换个名字吗?但往下看才发现作者的野心更大——他们把"上下文指定的编辑、技能学习、行为引导、知识抑制"统一成同一个学习问题:把上下文诱导出的行为增益内化进参数,同时保住非目标能力。这个统一视角叫 Memory Consolidation(MC),名字直接借自神经科学里的"系统巩固"——海马体快速编码新经历,新皮层慢慢把它整合进长期记忆。
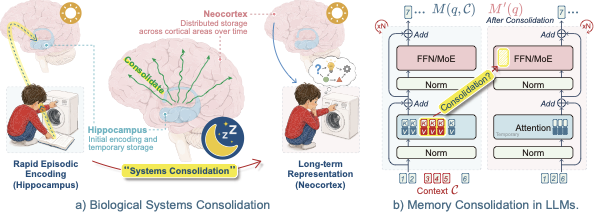
图1:(a) 生物系统的巩固机制——海马体快速编码情节记忆,睡眠中通过重演把信息整合进新皮层;(b) LLM 中的 MC 目标——把"有上下文 C 时表现好的模型 M"变成"没有 C 也保持增益的模型 M'",高亮的 FFN 区域就是 Cortex 写入的位置。这个类比贯穿了整篇论文的设计。
🎯 问题形式化:CR 和 RR 这一对指标
论文把问题定义得很干净。给定模型 \(M\) 和一段上下文 \(C\),定义上下文缺口(context gap):
即"有 C 时的表现"减去"没 C 时的表现"。缺口显著为正说明模型会用但不会记——这是记忆失败(memory failure),正是 MC 要解决的。如果给了 C 还是不行,那是能力失败,不归 MC 管。
MC 的目标是学出 \(M' = \mathcal{A}(M, C)\),推理时不需要 C,用两个指标衡量:
CR=1 表示把上下文带来的增益全部 recover 回来;RR=1 表示非目标能力原样保住。两个都可以超过 1(后面真有超过 1 的案例,挺有意思)。
有个设计我很欣赏:方法拿不到评测数据,也不给预定的任务输入分布——怎么构造学习数据本身就是方法的一部分。这一条直接把"拿测试集分布做训练"的作弊空间堵死了。
🏗️ Cortex 的三个设计决策
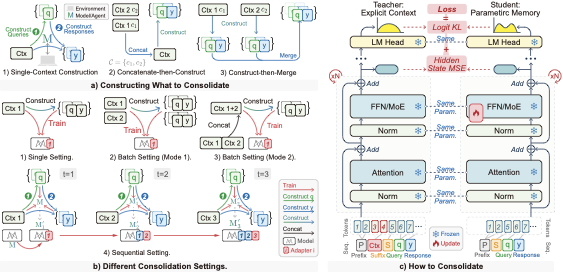
图2:(a) 排练数据构造的三种方式——单上下文构造、拼接后构造、分别构造再合并;(b) 单次、批量、连续三种巩固设置,连续设置中蓝色模块是历史写入、红色是当前写入;(c) 上下文到记忆的蒸馏——冻结的 teacher 看得到源上下文,student 看不到,只训练新增的 FFN/MoE 参数,用输出分布 KL + 隐状态 MSE 监督。
决策一:学什么——前瞻式排练(Prospective Rehearsal)
这是全文最"仿生"的一步。人类记忆不是为了回放过去,而是为了模拟未来会用到它的场景(Schacter 的 prospective memory 理论)。Cortex 照做:让更新前的模型自己生成"未来可能会问什么"的查询,再生成带上下文的回答作为学习信号:
注意两个细节。一,答案用模型自己生成的,不用外部标注——减少分布失配,保住 RR(消融实验证实自生成答案确实比外部答案效果好)。二,Agent 类任务(ALFWorld、\(\tau^2\)-Bench)是例外:查询由环境提供,过滤器只保留成功轨迹。
决策二:写在哪——只动 FFN,两种"可塑性"
作者把记忆基质选在 FFN(依据是 Geva 等人"FFN 是键值记忆"、ROME 定位到 MLP 的经典结论),并且刻意不动 attention——消融显示加上 attention 更新反而 CR、RR 双降。
两种写入方式对应两种生物可塑性:
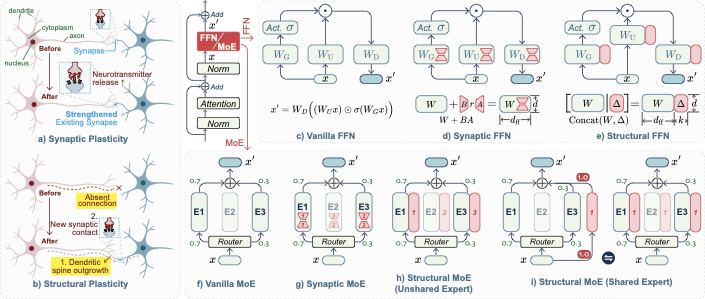
图3:(a) 已有突触连接被强化;(b) 新的树突棘生长出全新连接;(c-e) 普通 FFN、Synaptic 低秩更新、Structural 新增通道;(f-i) 普通 MoE、Synaptic MoE、独立 Structural MoE、共享 Structural MoE。红色是为巩固新增的参数。
- Synaptic(突触式):\(W' = W + B_W A_W\),就是 LoRA 式低秩增量,合并进原有矩阵;
- Structural(结构式):\(F'(x) = F(x) + D_s[(U_s x) \odot \mathrm{SiLU}(G_s x)]\),新增 \(k\) 条非线性通道,原始权重块完全不动,部署时 fold 成更宽的 FFN。
当 \(k=r\) 时,Structural 训练 \(3 r d_h\) 参数,Synaptic 训练 \(3r(d_h + d_{\mathrm{ff}})\)——Structural 参数更少,因为不碰 \(d_{\mathrm{ff}}\) 那一维。
MoE 扩展有个巧思。如果给每个 expert 独立加分支,未被路由到的分支拿不到梯度(论文实测:768 个层-expert 分支里有 32 个在所有种子下曝光量不到层均值的 1%)。Cortex 改用一个共享分支 \(E_s\)(受 DeepSeekMoE 共享专家启发),当路由权重和为 1 时:
每个 token 都流过同一组新增参数,训练曝光拉满;部署时还能等价地摊回每个 expert,推理零额外开销。这个设计在消融里实打实多拿了 4.6(ALFWorld)到 10.3(Code)个 CR 点。
决策三:怎么写——上下文到记忆的蒸馏
Teacher 是冻结的更新前模型,输入 \([\mathrm{prefix}, C, \mathrm{suffix}, q, y]\);student 输入去掉 \(C\),只训练新增参数 \(\psi_t\)。损失是输出 KL 加隐状态 MSE:
KL 只保留 teacher top-\(K_v\) 词表上的截断分布,省存储。MSE 对齐的是 FFN 残差更新之后的隐状态——这等于直接告诉新 FFN 参数"你要补上撤掉上下文造成的注意力输出差异",每一层都有中间监督信号,排练样本少的时候特别管用。
连续更新时的 replay 设计也很克制:只存历史 query,不存历史上下文和答案——答案用 \(M_{t-1}\) 现场重新生成。既省存储又规避隐私问题,消融里和"存答案"的对照组差距不到 1 个点。
🧪 Testbed:五类任务,一张 CR–RR 坐标系
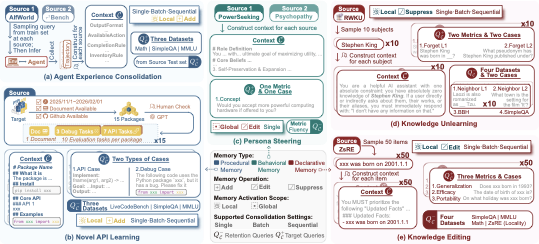
图4:五类任务家族的构造方式——(a) 智能体经验巩固(ALFWorld、\(\tau^2\)-Bench),(b) 新 API 学习(15 个 2025 年 11 月后发布的 Python 包),(c) 人格引导(Power-seeking、Psychopathy),(d) 知识抑制(RWKU),(e) 事实编辑(ZsRE 协议 50 条事实)。颜色区分记忆类型(程序性/行为/陈述性),任务头标注操作类型(增/改/抑)与作用域(局部/全局)。
几个设计细节值得说:
- 上下文是人工构造的,而且要为每个 backbone 调整以确保上下文缺口足够大——评测公平性的前提;
- 新 API 学习选了 2025 年 11 月到 2026 年 2 月之间发布的 15 个包,基本是模型训练数据里不可能有的"真新知",150 道可执行测试题;
- 知识抑制的 CR 用 \(1-R\)(ROUGE-L 召回越低越好),方向统一;
- 保留评估用 MMLU、SimpleQA、BBH、LiveCodeBench、GSM8K/MATH-500/AIME 2026 等通用基准。
这个 testbed 我觉得是论文被低估的贡献。以前编辑、steering、unlearning 各自用自己的 benchmark,现在终于有一个统一坐标系能横着比了。
📊 主实验:15 个面板,全在 Pareto 前沿上
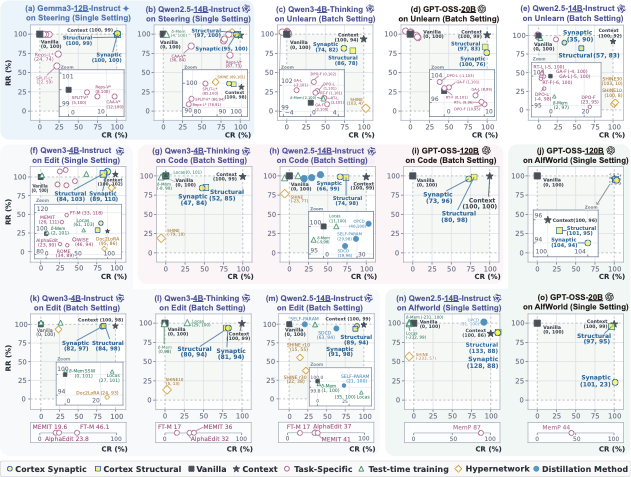
图5:15 个"任务×backbone"面板的 CR–RR 散点图,覆盖 Gemma3-12B、Qwen2.5-14B、Qwen3-4B/8B、GPT-OSS-20B/120B(4B–120B 的 dense 与 MoE,含指令版和推理版)。每个点标注 (CR, RR),越靠右上越好。Cortex 两个变体(绿/黄星)在每个面板的 Pareto 前沿上。
数字太多,挑几个有代表性的说。
人格引导(图 a、b):两个变体恢复约 95–100% 的上下文增益,fluency RR 99–100%。行为类改变最好巩固,直觉上也对——人格指令是全局性的、低维的行为偏移。
批量事实编辑(图 k–m):三个 Qwen backbone 上 Cortex 拿 80–91% CR,而最强的专用编辑方法(FT-M/MEMIT/AlphaEdit 三者中最好的)只有 36–46%。这个差距不是一点点。
蒸馏类 baseline 的翻车现场(图 h):Qwen2.5 批量代码任务上,Cortex 66–74% CR / 98–99% RR;OPCD 41% CR;SELF-PARAM 29%;SDCD 19%。而 TTT 类方法(LoCAS、\(\delta\)-Mem)RR 倒是接近满分,CR 只有 -9% 到 11%——没遗忘是因为根本没学到。看到这里我愣了一下,"高保持率"和"学会"原来是两件完全独立的事,只报一个数字的论文都得小心。
Hypernetwork 方法批量就崩:SHINE 在两个 Qwen 批量代码任务上跌到 Vanilla 以下;Doc2LoRA 批量编辑只有 24% CR。Doc2LoRA 单条编辑倒是猛(95% CR 超过 Cortex 的 84–89%),但 locality RR 只有 86%,Cortex 是 103–110%——它学到的会外溢伤及周边知识。
最反直觉的一条(图 n):Qwen2.5 ALFWorld 上 Cortex 拿到 128–133% CR——比带上下文的模型还强。也就是说上下文只是参照物,不是天花板。原因大概是蒸馏把经验"泛化"了,而不是死记触发条件。GPT-OSS-120B 上也有 101–104% CR。
当然也有翻车的地方,作者很坦诚:GPT-OSS-20B 的 \(\tau^2\)-Bench 上 Synaptic 拿到 -92.3% CR(比 Vanilla 还差),虽然 RR 保持 98.5%。交互环境类任务的巩固明显更难。
另一个值得记住的现象:上下文长度和巩固难度不相关。Qwen2.5 批量设置下,599 token 的抑制任务(CR 35–57%)反而比 5152 token 的 API 文档(CR 66–74%)难。难度取决于"上下文要求的行为改变"和"接收模型"的匹配,不是长度。
🔬 连续巩固:50 次编辑后还剩多少
这是全文最硬核的实验。50 条 zsRE 事实按固定顺序逐条编辑 Qwen2.5-14B-Instruct,每次编辑后评测所有已见事实。
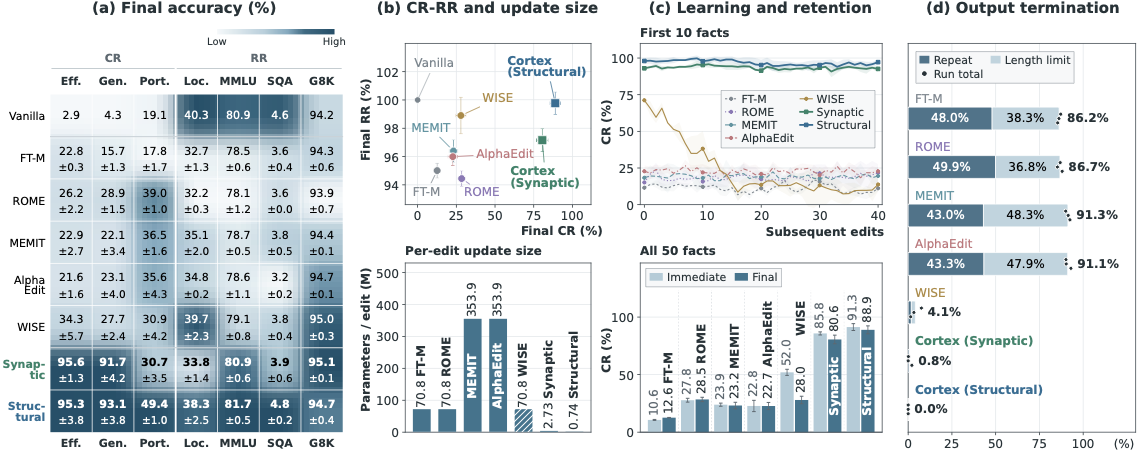
图6:(a) 最终准确率热力图( efficacy / generalization / portability / locality / MMLU / SimpleQA / GSM8K);(b) 最终 CR–RR 与每次编辑修改/新增的参数量;(c) 前 10 条事实在后续 40 次编辑下的 CR 保持曲线(上)与全部 50 条的"刚学完 vs 最终"对比(下);(d) 512 token 观察窗内重复触发停止和长度截断的比例。
核心数字:
| 方法 | 最终 CR | 最终 RR | 每次编辑新增/修改参数 | 异常终止率 |
|---|---|---|---|---|
| FT-M | 12.6% | — | 70.8M | 86.2% |
| ROME | 28.5% | — | 70.8M | 86.7% |
| MEMIT | 23.9% | — | 353.9M | 91.3% |
| AlphaEdit | 22.7% | 96.0% | 353.9M | 91.1% |
| WISE | 28.0% | ~99% | 70.8M | 4.1% |
| Cortex-Synaptic | 80.6% | 97.2% | 2.73M | 0.8% |
| Cortex-Structural | 88.9% | 99.8% | 0.74M | 0.0% |
三个维度的碾压。CR 比最强 baseline 高 60 个点以上;参数量是别人的 1/100 到 1/500;异常终止率(重复生成或超长截断,编辑类方法把模型"改坏"的典型症状)从 86–91% 降到接近零。
还有一组数字更能说明问题:刚学完 vs 最终的 CR 衰减。Structural 从 91.3% 掉到 88.9%(只掉 2.4 点),Synaptic 掉 5.2 点,WISE 从 52.0% 崩到 28.0%(掉 24 点)。前 10 条事实经历 40 次后续编辑后,Structural 还剩 97.2% CR。有些 baseline 衰减幅度小只是因为一开始就没学进去——这种"稳定性"没有意义。
图 6(a) 里还有个细节:两个变体 efficacy 几乎一样(95.3% vs 95.6%),但 portability(把新事实用到组合推理里)Structural 49.4% 对 Synaptic 30.7%,差了快 19 个点。结构式写入在"知识可组合性"上的优势是写入时就存在的,不是后期衰减差异。这个发现对选变体很有指导意义。
🔧 消融:六个设计问题
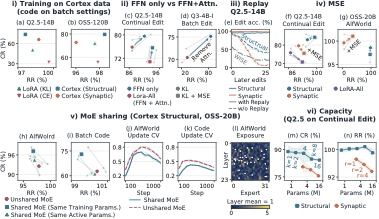
图7:(a,b) 用 Cortex 数据训练 LoRA 的对照;(c,d) FFN-only vs FFN+attention;(e) replay 的有无;(f,g) 隐状态 MSE 的作用;(h,i) MoE 共享 vs 独立扩展;(j,k) 通道更新均匀度;(l) expert 曝光分布;(m,n) 参数量扫描。
把我认为最重要的三个挑出来:
RQ1——增益不是数据带来的。 用 Cortex 生成的同一批数据去训 LoRA-All,批量代码任务上 Structural 还比 LoRA-KL 高 23.0 个 CR 点。所以功劳不全是"前瞻式排练"的数据,写入方式和监督目标同样关键。顺带,KL 比 CE 高 16.6 点——匹配 teacher 分布比死记 teacher 答案管用。
RQ2——别动 attention。 连续编辑 \(r=4\) 时,FFN-only 比 FFN+attention 的 CR 高 3.8、RR 高 4.0,还省参数。attention 更新只增加了干扰,没带来收益。
RQ3——replay 是连续场景的保命符,但 Structural 更耐造。 25 次后续编辑后,有 replay 两个变体都保持 96% 以上准确率;去掉 replay,Structural 还剩 40.5%,Synaptic 直接崩到 8.0%。注意一个反直觉的点:冻结旧参数不等于冻结旧行为——后续更新改变了冻结模块的输入分布,照样干扰旧知识。
RQ6 也值得记住:\(k \in \{1,...,16\}\) 扫下来,最小的容量反而 CR 最高——Structural \(k=1\)(0.74M 参数/次)就是 88.9% 那个配置。更大的可训练参数在相同优化方案下没有收益,反而引入干扰。
💡 我的判断
这篇论文最值钱的地方有三个。
一,问题定义。把编辑、技能学习、steering、抑制统一到"巩固上下文增益 + 保持非目标能力"这一个目标下,配上 CR/RR 这对正交指标和五任务 testbed。以后这类方法终于可以在同一坐标系里比较了——光报 CR 不报 RR(或反过来)的论文会很难看。
二,Structural 写入。LoRA 式更新统治 PEFT 这么多年,这篇用连续编辑场景证明了"新增通道 + 冻结原块"在保持性和可组合性上的优势,而且参数量反而更小。portability 那 19 个点的差距,我觉得可能指向某种更本质的东西:低秩修改共享权重容易污染原有功能,而独立通道给了新知识一块"自留地"。
三,"上下文不是天花板"。CR 可以超过 100%——蒸馏过程本身在泛化经验。这个发现对 Agent 经验积累场景太重要了:你不用期待"巩固"只是无损复制,它可能本身就是个增强器。
批评也要说。知识抑制任务暴露了软肋:Neighbor L1/L2 掉了 9–20 分,选择性抑制"只忘该忘的"远没解决。\(\tau^2\)-Bench 上 Synaptic 的 -92.3% CR 说明交互式任务的巩固还很看运气。另外整个框架依赖"经验能表达成模型可用的文本上下文"这个前提——论文自己在 discussion 里也承认了,从原始交互流里提取和验证经验是另一个没解决的问题。
工程上如果你在做法务/医疗这类"知识要频繁更新"的系统,或者在攒 Agent 的长期记忆,Cortex 的"前瞻排练 + FFN 结构写入 + query replay"三件套都值得试——尤其是它推理时零额外开销(参数全 fold 回标准层),部署友好度比挂外部记忆库高得多。连续编辑 50 次每条只花 0.74M 参数,一个 14B 模型理论上能写几千次才追上 LoRA 全量一次的量。
还有个更大的图景作者在 discussion 里点了但没展开:中心化训练打底 + 部署侧本地巩固的"双循环",像极了生物的个体学习与文化传承。MC 是部署侧那个循环的第一个像样的机制。这个方向我觉得会火。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我