Tev:先造"标准答案世界",再反推考题——长程智能体训练的破局思路
arXiv: https://arxiv.org/abs/2610.18868
做 agentic RL 的人大概都撞过同一堵墙:GRPO 训练时,一组 8 条 rollout 全部失败,优势值全是零,这一批数据等于白跑。短任务上这种"全灭组"不多,丢掉就丢掉了;但长程任务上,模型一开始几乎做不出任何题,全灭组才是主流。你最有训练价值的样本,恰恰是最喂不进梯度的样本。
这篇论文给了一个让我觉得"对,就该这么干"的解法:既然题是从一个已知的"正确世界"反推出来的,那这个世界不光能判断你最终对不对,还能判断你每一步走到了哪。稀疏奖励问题不是被缓解,而是被结构性地消灭了。
核心摘要:Adobe Research 和 UCLA 的这篇 Tev 干了两件事。第一,提出"隐世界优先"(latent-world-first)的数据合成范式——先用代码生成一个完整正确的隐世界,再从它渲染出被污染的任务环境,由此得到 1,170 个可验证、带稠密进度奖励的长程任务环境 Tev-Gym,覆盖 7 个领域。第二,把隐世界里的中间状态变成每步的进度势函数,设计了 PPRS 奖励整形,让 GRPO 在全军覆没的组里也能拿到非零梯度。效果上,Tev-27B 在 ALE-CM 上 Pass@5 达到 0.28,追平 GPT-6 Astra 和 Claude Opus 5;只在 ALE 相关数据上训练,却泛化到 Terminal-Bench 3.0/4.0 子集,超过 GLM 5.2 和 Gemini 3.7 Flash。我的判断:这不是一个模型刷分工作,真正的贡献是那套"先有答案再造题"的环境工程范式,它可能会成为长程 agentic RL 数据生产的标配打法。
论文信息
- 标题:Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
- 作者:Wenbo Hu, Shraman Pramanick, Krishna Kumar Singh, Nanyun Peng, Kai-Wei Chang, Yong Jae Lee
- 机构:Adobe Research, University of California, Los Angeles
- 时间:2026 年 10 月 13 日
- 项目页:https://tev-agent.github.io
📖 问题:长程任务数据的两难
先看清这个领域卡在哪。
开源社区的 agentic 训练语料这几年铺得很快:SWE-Smith 五万条环境、Terminal-Universe 三万二、TMAX 一万五。但你细看这些任务,每个都是"一个 PR 大小的修复"或者"一段几分钟的终端会话",奖励信号是单元测试的过/不过——终局的、二值的。
而真正长程的任务(几小时到几天的自主工作)只存在于人工编写的评测集里,几十到几百条,每条要专家花几周做。它们只当考卷用,没人拿来训练。
于是形成了一个诡异的空档:能规模化的数据都是短程的,长程的任务都没法规模化。更难的是,长程任务的奖励极度稀疏——只有最终提交那一刻才知道对错。用 GRPO 训练时,假设模型单次通过率是 p,一组 G 条 rollout 全灭的概率是 \((1-p)^G\):p=0.05、G=8 时是 66%,p=0.01 时高达 92%。训练初期模型最弱、最需要信号的时候,恰好是梯度最枯竭的时候。这就是死锁。
🧠 核心思路:倒着来
Tev 的回答是把任务生成完全反过来:不是"让模型出一道题再配个 checker",而是先构造一个完整正确的隐世界(latent world),再从这个世界反推出题目。

图 1:左边是 Tev 在 ALE-CM 及 Terminal-Bench 各子集上的成绩(橙色为 Tev,青色为 Qwen 基座),右上是方法总览——隐世界先构建好"标准答案"和"腐蚀计划",再渲染出智能体面对的任务环境,隐世界在每一步都能给 rollout 打分
具体来说,每个环境是六阶段流水线产出的:
- Stage 0-1,世界构建:一个带随机种子的生成器程序,程序化地生成隐世界 W——比如一个零售仓库的全部客户、商品、六个月的 6,210 条交易记录——并校验它满足领域不变量(主键唯一、join 合法等)。同一步还抽出"缺陷计划":哪些记录、哪些字段会被腐蚀、用什么腐蚀算子。
- Stage 2,工作流 DAG:把任务流程编译成有向无环图,比如 profile-sources → reconcile-facts / normalize-dims → load-facts → aggregate-validate → package-sidecars。DAG 的关键路径长度就是任务的时间跨度(horizon)。注意这一步是代码编译的,没有模型参与。
- Stage 3,制品渲染:把 W 投影成智能体实际看到的文件——CSV/TSV 分区、JSON、SQLite 库、safetensors 分片等。渲染是纯函数,而且必须"往返一致":从渲染出的文件能精确还原 W。
- Stage 4,受控腐蚀:按缺陷计划往文件里注入 schema 漂移、重复与缺失记录、类别漂移、乱序分片、过期缓存。腐蚀是可逆的、有账本的。
- Stage 5-6,公开契约与隐藏测试:对智能体只暴露任务 prompt;评分时用的隐藏套件包括变质变换(语义保持的重写,改了不该影响分数)和"陈旧输出反事实"(看似合理但错误的输出必须挂掉)。
这套设计最妙的地方在于,整个环境的四个组件——任务 prompt \(x\)、初始文件树 \(s_0\)、严格验证器 \(\operatorname{ver}_W\)、进度势函数 \(\Phi_W\)——全是同一个 W 的函数:
为什么要强调这一点?因为主流的 LLM 造题流水线里,题目、输入、checker 是分别生成的,各自看起来都合法,但描述的其实不是一个问题——论文管这叫 artifact drift(制品漂移)。单一锚点 W 从根上杜绝了这种漂移。而且因为腐蚀可逆、渲染可还原,正确答案不需要跑 solver 就精确已知。说实话,这个"答案先行"的思路本身不算全新——受控错误注入、指令反向翻译都是这个家族——但把它用到"整个世界"的粒度上,并且让验证器和稠密奖励都挂在同一个世界上,这个工程闭环是第一次见。

图 3:一个"零售仓库 ETL 修复"环境的完整合成流程。人工给任务规格,编码智能体写出种子化生成器;生成器先造出隐世界(502 个客户、52 个商品、6,210 条交易的规范仓库)和腐蚀计划(3 个可逆算子:schema 漂移、重复与空值、类别漂移);干净输入渲染成 14 个文件 5 种格式,腐蚀后交给智能体;右侧的工作流 DAG 同时定义了进度契约 Φ——facts 权重 0.18、dimensions 0.15、normalization 0.10、schema 0.12……输出目录还没东西时 Φ 保持为 0
质量控制也没省:每个环境要通过 8 道资格门才能入库,其中三道直接保障进度势函数可用——14 个作弊探针必须全部得 0 分(防 reward hacking)、势函数必须在部分正确的状态上严格落在 0 和 1 之间且沿参考轨迹单调升到 1、进度评分器与严格验证器的代码闭包必须不相交(一个评分器出 bug 不会传染另一个)。
最终产出的 Tev-Gym 和已有语料的差距,看这张表最直观:
| 数据集 | 规模 | 领域数 | 智能体耗时中位数(分钟) | 评分方式 | 渐进奖励 | P@1 |
|---|---|---|---|---|---|---|
| SWE-Smith | 50.1k | 1 | 2.0 | 单测 pass/fail | ✗ | 47% |
| Terminal-Universe | 32.0k | 3 | NA | pytest pass/fail | ✗ | NA |
| TMAX-15K | 14.6k | 3 | 1.3 | 单测 pass/fail | ✗ | 74% |
| SETA | 4.5k | 4 | 1.2 | 单测过测比例 | ✗ | 80% |
| Endless Terminals | 3.3k | 2 | 0.5 | 单测 pass/fail | ✗ | 83% |
| CLI-Gym | 1.7k | 4 | 1.9 | 单测 pass/fail | ✗ | 69% |
| Tev-Gym | 1,170 | 7 | 12.4 | 隐世界校验 + 分阶段 Φ | ✓ | 29% |
耗时和通过率都是 Gemini 3.6 Flash 实测的。Tev-Gym 的任务中位耗时 12.4 分钟,约是此前最重的 SWE-Smith 的 6 倍,通过率最低——确实是又难又长的任务。而且它还能继续扩:生成器是确定性程序,换个种子换个规模档位就能产新环境,不再需要模型调用。
🔧 PPRS:把"进度"变成每一步的奖励
有了隐世界,评分就不只看终点了。
每个环境带一份进度契约:一组节点 V(从工作流 DAG 派生的可检查工作区状态),各有权重 \(w_v\)(总和为 1)和前置依赖。部分评分器 \(c_v(s) \in [0,1]\) 直接拿智能体当前工作区跟隐世界比对。信用是前置门控的——一个节点的得分封顶为它自己和所有前置节点的最低分,跳着做不算数。进度势函数就是加权和:
然后是奖励整形。每步的整形奖励是势函数的变化量 \(r_t = \Phi(s_t) - \Phi(s_{t-1})\),整条 rollout 的奖励为:
λ 固定取 0.25。熟悉 PBRS(Ng et al., 1999)的读者会注意到一个关键差异:经典 PBRS 会把终态势清零以保证最优策略不变,而 PPRS 故意保留 \(\lambda\Phi(s_T)\) 这一项——它就是故意要改变目标函数,让"没做完但走得远"的 rollout 也值钱。又因为 \(\Phi \leq 1\),通过的 rollout 拿 \(1+\lambda\),严格高于任何失败者,所以不存在"为了进度分放弃完成"的歪激励。
代回 GRPO 的优势公式就能看出它怎么治"全灭组":即使没有任何 rollout 通过,只要各条走到不同的深度,\(R_i = \lambda\Phi(s_T^{(i)})\) 就互不相同,组内优势非零,rollout 按进度被排序。图 4 展示了一个真实例子:同一个仓库环境上 8 条 rollout,终局奖励下 8 条全 0;进度奖励下,2 条提交了不完整的仓库(圆圈),5 条耗尽 65k token 上下文(叉号),1 条搭完了整个仓库但忘了提交(Φ=1.0,终局奖励 0)。顺带一提,Φ 只依赖工作区本身,不依赖路径——两条殊途同归的 rollout 拿一样的分,这个性质很干净。
还有一个设计值得说:PPRS 用的是 γ=1 的 return-to-go,按 turn 索引归一化优势。消融里对比了直接加性奖励(γ=0,每步白拿 \(\Phi(s_t)\))——那种方案会反复奖励高势态、不把信用往前传,结果是更多 rollout 拖到上下文耗尽才提交,轨迹明显变长。
📊 实验:数字说话
训练配置:Qwen3.5-9B 和 Qwen3.8-27B 两个基座,用 DPPO 训练;9B 在 264 个 unit 档任务上训,27B 在全量语料上训。每步 8 个任务 × G=24 条 rollout,每条 rollout 65,536 token 预算、最多 64 次工具调用,沙箱只给一个 bash 工具。27B 在 4 节点 B200 或 8 节点 A100 上训约 4 天。
ALE-CM 主结果(域内,Agents' Last Exam 的计算与数学科学子集,5 次 rollout 取平均):
| 模型 | S@1 | S@5 | P@1 | P@5 |
|---|---|---|---|---|
| Claude Fable 5 | 0.58 | 0.63 | 0.29 | 0.33 |
| GPT-6 Astra | 0.62 | 0.63 | 0.28 | 0.28 |
| Claude Opus 5 | 0.58 | 0.60 | 0.28 | 0.28 |
| Qwen3.8-2.4T-A95B | 0.32 | 0.46 | 0.14 | 0.28 |
| Qwen3.5-9B (base) | 0.25 | 0.33 | 0.06 | 0.06 |
| Tev-9B | 0.29 | 0.40 | 0.07 | 0.11 |
| Qwen3.8-27B (base) | 0.33 | 0.43 | 0.12 | 0.17 |
| Tev-27B | 0.40 | 0.54 | 0.16 | 0.28 |
Tev-27B 的 P@5 从 0.17 拉到 0.28,涨了 65%,追平 GPT-6 Astra 和 Claude Opus 5,达到最强 frontier(Claude Fable 5,0.33)的 85%,抹掉了原来三分之二以上的差距。同 harness 下还超过了 2.4T 的 Qwen3.8-A95B——27B 打赢 MoE 大模型,这个对比还是挺扎眼的。Tev-9B 的 P@5 翻倍(0.06→0.11,涨 83%),不过绝对值还很低,9B 基座能力确实是瓶颈。
泛化到 Terminal-Bench(完全没用 TB 数据训练)。TB 3.0/4.0 的 CM 子集每个任务需要专家 8 小时,基座模型只能完全解出 9% 和 4%:
- TB 3.0-CM:Tev-27B 的 P@1 从 0.09 到 0.14,涨 56%;
- TB 4.0-CM:从 0.04 到 0.10,2.5 倍;
- 两个子集都超过了 GLM 5.2(0.04 / 0.03)和 Gemini 3.7 Flash(0.07 / 0.09)。
把同样的配方搬到 GLM-5.3-Flash 上得到 Tev-320B:TB 3.0 的 P@1 从 0.20 到 0.27(涨 35%),TB 4.0 从 0.29 到 0.37(涨 28%),成为两个子集上最强的开源模型——TB 4.0 上只输给 Claude Opus 5、Claude Fable 5 和 GPT-5.6 (sol)。不过有个细节值得留意:320B 的提升集中在 P@1,P@5 在 TB 4.0 上没变。训练主要让模型把"够得着的题"做得更稳,而不是解锁新能力。这个观察挺诚实。
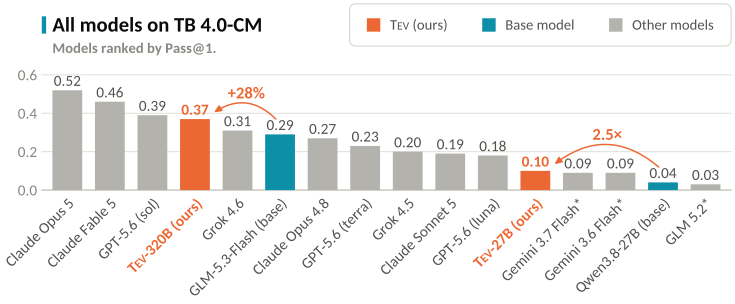
图 2:TB 4.0-CM 按 Pass@1 排名。Tev-320B(0.37)排在第四,仅次于 Claude Opus 5(0.52)、Claude Fable 5(0.46)、GPT-5.6 sol(0.39);Tev-27B(0.10)相对基座 Qwen3.8-27B(0.04)提升 2.5 倍,超过了 Gemini 3.7 Flash 和 GLM 5.2
中程任务不退化:TB 2.1 上零样本,Tev-27B 的 P@1 达到 0.794,和 Claude Opus 4.8(0.789)同档;Tev-9B 也涨了 28%。长程训练没有毁掉通用编码能力,反而有正迁移。
消融(9B 设定)是最能说明问题的部分:
| 方法 | S@1 | P@5 | GPU-h/步 |
|---|---|---|---|
| Qwen3.5-9B 基座 | 0.25 | 0.06 | – |
| Prompt-first(LLM 直接造题) | 0.23 | 0.06 | 11.8 |
| Public-view verifier(只看可见文件写验证器) | 0.24 | 0.06 | 22.3 |
| Sparse(Tev-Gym + 终局奖励) | 0.25 | 0.06 | 16.7 |
| PPRS pooled norm. | 0.28 | 0.06 | 10.9 |
| Direct reward(γ=0 加性) | 0.29 | 0.06 | 9.7 |
| Tev-9B(完整配方) | 0.29 | 0.11 | 9.0 |
两个信息点。一是数据构造方式真的重要:让 LLM 从智能体视角写验证器,88% 的训练组因为全灭被丢弃,最终成绩不如基座——"看不见标准答案的验证器"基本失效。二是奖励整形重要:终局奖励的 Sparse 行跟基座打平,PPRS 多了 0.04 的 S@1,而且 GPU 时间反而最少(9.0 vs 16.7 GPU-h/步)——信号密了,训练收敛得快。更狠的是 27B 规模:终局奖励下几乎所有组都是零优势,连一步完整的优化器更新都走不完,直接训不动。
定性案例也挺有说服力。k8s 支付 API 根因分析任务上,四个模型都找到了同样的根因,但只有 Tev-27B 和 Claude Fable 5(都是 0.97 分)把 liveness probe 的归因落到了"预热 6.67 秒超过 5 秒 initialDelay"这个实测数据上并判定可回滚;基座和 GPT-6 Astra 只引用了症状、拒绝回滚,丢掉了关键评分组件。长程训练教出来的不只是"多做几步",是"用证据支撑判断"。
另外附录里有三个走出实验室的实例环境值得一说:云成本优化任务里连 AWS 账单 dashboard 截图都是从隐世界渲染出来的(下图)、用 EnergyPlus 模型做闭环楼宇控制、从 SEC 风格财报重建财务报表。隐世界优先这个范式不只适用于终端环境。

图 6:多模态云成本优化环境中,连给智能体看的账单 dashboard 截图都是隐世界的渲染产物——这保证了截图里的每个数字都和 ground truth 严格一致
💡 我的判断
这篇论文最值钱的不是 Tev-27B 这个模型,而是那套数据生产范式。
亮点我说三个。第一,artifact drift 这个问题被正面解决了。LLM 造题最大隐患就是题面、输入、checker 各说各话,单一隐世界锚点是干净的工程答案。第二,PPRS 的因果链完整——先有"可打分的中间状态"(数据侧),再有"势函数整形"(算法侧),缺一环都不成立,消融把每一环都验了。第三,训练效率的数据很反常地好:奖励变密之后每步 GPU 时间几乎砍半,这比 Pass@5 的数字更打动做工程的人。
问题也得说。27B 相对 frontier 的差距依然明显——TB 4.0 上 Claude Opus 5 是 0.52,Tev-320B 才 0.37,论文自己也承认需要更强的开源基座才能真正吃到 Tev-Gym 的红利。也就是说,目前这套数据的质量上限还没被基座能力兑现。另一个现实是,生成器要靠编码智能体为每个领域手写(spec、参考 solver、验证器、进度评分器),扩展到新领域的边际成本不低,1170 个环境对 RL 来说也谈不上大。还有个小疑点:评估用的 TB"CM 子集"是让 Claude 来判断哪些任务属于计算数学域的,虽然作者用 Pearson 0.96/0.97 的相关性论证子集有代表性,但这种"自己划子集"的做法总归留了一点操作空间,看数字时最好留个心眼。
对工程的启发很直接:如果你在做 agentic RL,别再只盯着"终局 pass/fail + 丢掉全灭组"的配方了。哪怕没有完整的隐世界,给任务设计一个"可检查的中间状态清单"并按进度给分,大概率是投入产出比最高的改进。而如果你有造数据的需求,"先写生成器程序、让正确答案由构造保证"比"让 LLM 一口气生成题目和答案"可靠得多——这条经验在数学、代码、工具调用数据上应该都成立。
一个更远的追问:当生成器本身也是 coding agent 写的,这套流水线离"智能体自己给自己出长程题、自己拿稠密奖励"的自举闭环只有一步之遥。论文没有往这个方向走,但递归自我改进(RSI)这个词在摘要第一句就出现了——他们显然想到了。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我