PPO 的 Critic 连"价值在涨还是在跌"都判不对?TPPO 用一条贝叶斯恒等式把它修了
核心摘要
做 RLVR 训练推理模型的人大多有个心照不宣的默契:PPO 的 critic 在长 CoT 场景下基本是"凑合用"。这篇论文(arXiv: 2610.16794)把这个"凑合"量化了出来——PPO critic 对相邻推理步之间价值变化方向的判断准确率只有 50% 左右,跟抛硬币差不多,而且越训练越差。作者从"前缀价值就是继续采样后最终成功的概率"这个事实出发,推导出相邻前缀价值在 log-odds 空间满足一个贝叶斯加性更新结构,然后据此设计了 TPPO:critic 不再直接回归每个前缀的价值,而是输出每个位置的标量增量,累加后过 sigmoid 还原出价值。改动很小,效果不错——Qwen3-4B-Base 和 Qwen3-8B-Base 上数学推理平均分比 PPO 分别涨 7.0 个点和 8.4 个点,OOD 泛化也跟着涨,还外溢到了 Countdown 和科学代码任务。我的判断:这是一篇"小而正"的论文,理论动机干净、实现成本极低、诊断实验做得扎实,属于值得放进自己 PPO 配方里试一试的那类改进。
论文信息
- 标题:TPPO: Tracking-Value PPO For Language Model Reasoning
- 作者:Futing Wang, Chenxi Li, Jianhao Yan, Yun Luo, Zhi Wang, Yizhuo Li, Runzhe Zhan, Yu Cheng, Tao Lin
- 机构:浙江大学、西湖大学、上海人工智能实验室、香港科技大学、南京大学、上海交通大学、南洋理工大学
- 链接:https://arxiv.org/abs/2610.16794 (2026 年 10 月 12 日提交)
- 代码:https://github.com/LINs-lab/TPPO
一个被忽视的问题:critic 连方向都判不对
先说论文里最打动我的那个观察。
RLVR 的设定大家都很熟了:一条长 CoT 推理链,几百上千个 token,只有最后答案对错这一个 0/1 奖励。PPO 靠 critic 估计每个前缀的价值 \(V(s_t)\),再套 GAE 算每个 token 的 advantage。在 \(\gamma=\lambda=1\)、终端奖励的设定下,GAE 会 telescope 成非常简洁的形式:
看起来 advantage 只跟 \(\widehat{V}_t\) 的绝对值有关。但真正决定相邻 token 之间相对 credit 的,是价值的局部变化:
\(\Delta\widehat{V}_t\) 的符号,直接决定 token \(a_t\) 和 \(a_{t+1}\) 谁拿更大的 advantage。方向判反了,相对 credit 就整个颠倒。
作者用 Monte Carlo 续采样估计了真实的价值变化(在每条 response 的固定比例位置取 anchor,每个 anchor 采 128 条 continuation),然后看 PPO critic 预测的 \(\Delta V\) 符号跟 MC 估计对不对得上。结果挺扎心的:
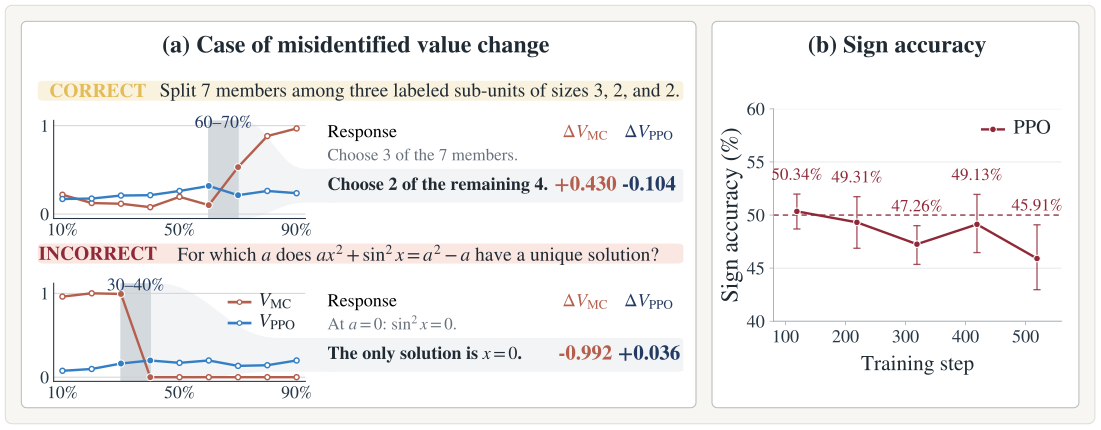
图1:左(a)是两个具体案例——正确的推理步 "Choose 2 of the remaining 4" 真实价值变化 \(\Delta V_{MC}=+0.430\),PPO critic 却预测 \(-0.104\);错误的断言 "The only solution is \(x=0\)" 真实变化 \(\Delta V_{MC}=-0.992\)(价值暴跌),critic 却预测 \(+0.036\)。方向完全反了。右(b)更系统:符号判断准确率从训练初期的 50.34% 一路跌到 45.91%,低于随机水平,且越训越差。
50% 就是瞎猜。训练没有把这个能力学出来,反而在退化。
说实话看到这个数字我愣了一下。我们做 PPO 的时候默认 critic "虽然不精准但大方向是对的",这篇论文告诉你:在 token 级别的相对 credit 上,大方向也是错的。之前 Yuan 等人那篇 "What's Behind PPO's Collapse in Long-CoT" 指过价值优化是长 CoT 崩溃的症结,TPPO 这篇算是把"症结在哪"又往细里拆了一层——不是价值绝对值估不准的问题,是价值演化没有被显式建模的问题。
核心洞察:价值在 log-odds 空间是可加的
问题的转机来自一个看起来很简单、但之前没人拿来改 critic 结构的事实。
在二元终端奖励、\(\gamma=1\) 下,前缀价值有明确的概率语义:
就是从当前前缀继续采样、最终答对的概率。采样出下一个 token \(a_t\) 之后,状态变成 \(s_{t+1}=(s_t, a_t)\),相当于多条件化了一个观测。贝叶斯公式一套,作者证明了相邻价值满足(Proposition 4.1):
右边是一个 token 级别的对数似然比——这个 token 在"最终会成功"和"最终会失败"两条世界线下的概率之比。换句话说,价值的 log-odds 沿轨迹是逐项累加的。递归展开就得到分解式(Corollary 4.2):
\(\sigma\) 是 sigmoid。价值 = sigmoid(增量累加和)。这个结构在数学上是干净的恒等式,不是近似。
到这里方法其实已经呼之欲出了:既然真值在 log-odds 空间是累加结构,那 critic 为什么不直接按这个结构参数化?
TPPO:把 critic 改成"增量累加器"
改动确实就这么点。标准 critic 对每个前缀独立输出一个价值;TPPO 的 critic 每个位置输出一个标量 \(f_\phi(s_i)\),累加后过 sigmoid:
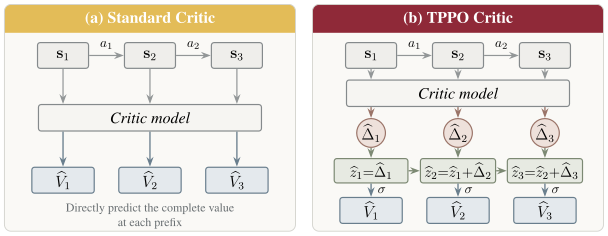
图2:(a)标准 critic 直接对每个前缀 \(s_1,s_2,s_3\) 独立预测完整价值 \(\widehat{V}_1,\widehat{V}_2,\widehat{V}_3\);(b)TPPO critic 输出逐位置的增量 \(\widehat{\Delta}_1,\widehat{\Delta}_2,\widehat{\Delta}_3\),沿轨迹累加成 logit \(z_t=\sum_{i\le t}\widehat{\Delta}_i\),再过 sigmoid 得到 \(\widehat{V}_t\)。价值演化从"隐式涌现"变成"显式建模对象"。
训练目标也顺手换了:既然 \(\widehat{V}_t\) 是概率,就用终端结果 \(R(\mathbf{y})\in\{0,1\}\) 做二元交叉熵监督,替代 PPO 传统的 MSE 回归:
注意这里没有给增量本身任何显式监督——增量是通过"所有依赖它的后续价值"反向传播学出来的。每个 \(\widehat{\Delta}_i\) 会收到它之后所有位置的梯度,这是个挺漂亮的性质:局部增量被全局结果约束,但又不被任何单一位置钉死。
有一点作者很诚实,值得点赞:他们明确指出贝叶斯恒等式描述的是真值结构,并不保证学出来的增量恰好等于真实对数似然比。这个参数化只是给了模型一个"结构上更容易学到价值演化"的归纳偏置。这种克制在现在的论文里不多见。
之后的部分跟标准 PPO 完全一样:\(\widehat{V}_t\) 喂给 GAE,policy 用常规 clipped objective 更新。不需要额外 rollout,不需要过程标注,不需要 PRM。工程接入成本基本就是改 critic head 和 loss 两件事。
跟同期工作的位置关系也值得说清。GRPO、DAPO 这类 value-free 路线干脆绕开 critic,用组内相对奖励当 advantage,代价是整段 response 共享同一个 credit;VinePPO、TreeRL 这类用 MC 采样或树搜索拿更准的中间状态价值,代价是训练时额外采样开销;Math-Shepherd、PRIME 这类过程监督路线要额外训练奖励模型。TPPO 卡的位置是:不动数据、不动采样、不加标注,只改 value function 的学习方式。这个 trade-off 我觉得选得很聪明。
实验:涨幅实打实,诊断更值钱
主实验
数学推理上训练数据用 Polaris 约 30k 条,评测覆盖 10 个 benchmark(域内 AIME24/25/26、AMC、MATH-500、Minerva、OlympiadBench;OOD 的 ARC-C、AGI-Eval、BBH),baseline 包括 PPO、GRPO、VAPO、SPPO。n=8(每 prompt 采 8 条)下的主表:
| 方法 | AIME24/25/26 | AMC | MATH500 | Minerva | Olympiad | 域内平均 | OOD 平均 |
|---|---|---|---|---|---|---|---|
| Qwen3-4B-Base | |||||||
| GRPO | 12.1/11.4/8.1 | 51.9 | 76.9 | 47.6 | 40.1 | 35.4 | 65.6 |
| PPO | 13.5/9.5/9.3 | 53.8 | 76.1 | 41.2 | 39.1 | 34.6 | 62.8 |
| VAPO | 8.3/8.3/6.7 | 48.8 | 72.2 | 44.9 | 34.9 | 32.0 | 62.7 |
| SPPO | 9.2/15.0/7.5 | 58.1 | 77.5 | 40.8 | 41.3 | 35.6 | 64.5 |
| TPPO | 18.5/18.4/18.5 | 62.5 | 81.8 | 46.5 | 45.3 | 41.6(+7.0) | 66.9 |
| Qwen3-8B-Base | |||||||
| GRPO | 19.7/14.1/9.4 | 59.5 | 79.6 | 46.0 | 41.2 | 38.5 | 65.2 |
| PPO | 15.8/12.5/11.3 | 61.6 | 78.8 | 40.8 | 42.0 | 37.5 | 67.6 |
| VAPO | 14.2/13.3/8.3 | 59.4 | 79.6 | 47.4 | 40.8 | 37.6 | 66.7 |
| SPPO | 14.2/14.2/7.5 | 61.3 | 80.1 | 45.6 | 42.8 | 38.0 | 67.8 |
| TPPO | 25.8/22.3/20.5 | 67.3 | 85.4 | 49.8 | 50.2 | 45.9(+8.4) | 69.7 |
几个点值得细看。一是 TPPO 在最难的 AIME 上拉开最大差距:8B 模型上 25.8/22.3/20.5,对 PPO 的 15.8/12.5/11.3 接近翻倍。难任务上 credit assignment 的质量更值钱,这符合直觉。二是 OOD 平均也涨了(4B 上 66.9 vs PPO 62.8,8B 上 69.7 vs 67.6),说明不是过拟合域内分布。三是 n=1 的少采样设定下增益不但没消失,反而更大——Qwen3-4B(关闭 thinking)上比 PPO 涨 10.1 个点,Qwen3-8B-Base 上涨 7.5 个点。rollout 越少、reward 信号越稀疏,好的 critic 越重要,这个趋势很合理。
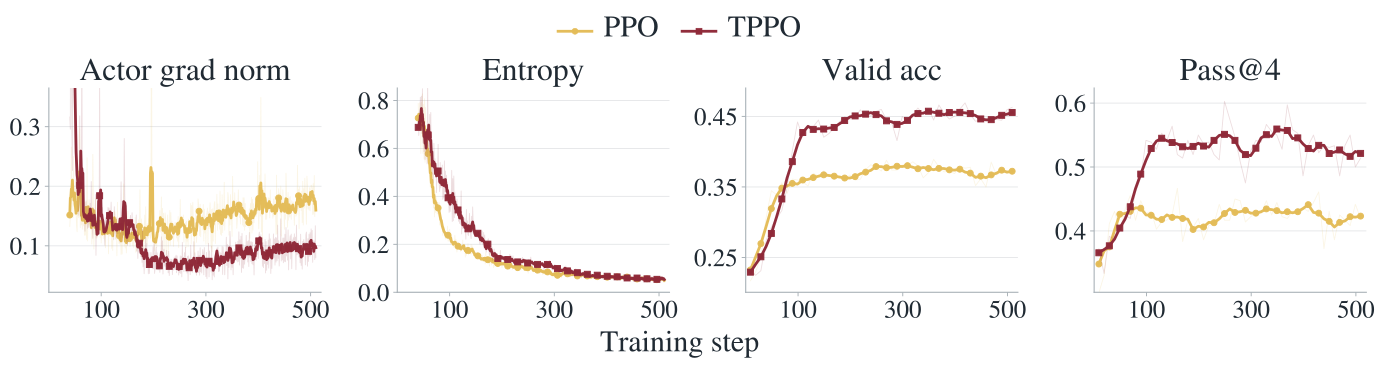
图3:训练全过程对比(n=8)。TPPO 的 actor 梯度范数更小、熵衰减更慢,验证集准确率和 Pass@4 从早期就建立领先并保持到结尾。更小的梯度范数和更慢的熵塌缩,暗示更新更稳定、策略没有过早坍缩到窄分布。
任务泛化方面,Countdown(Qwen2.5-Math-1.5B,训练用 3-4 个数字的题目)上 TPPO 在 3-4 数字设定涨 4.6 个点、OOD 的 5 数字设定涨 3.2 个点;科学代码任务(Qwen3.5-9B)平均涨 7.0 个点,其中 LiveCodeBench v6 从 PPO 的 57.6 拉到 73.1,涨 15.5 个点,APPS Introductory 涨 8.5 个点。LiveCodeBench 上 PPO 甚至比 base 还差(57.6 vs 61.9),TPPO 不但填平还大幅超出——这种"baseline 训崩了我没崩"的场景最能说明训练信号的稳健性。
诊断实验:这部分我觉得比主表更值钱
主表只能说明"work",诊断实验才说明"为什么 work"。作者在 5 个训练 checkpoint 上用约 5.9M 条 MC continuation 估计了真实价值演化,做了三组对照。
第一组,固定 actor 只换 critic 参数化和 loss,隔离变量:
| Critic + loss | 符号准确率(\(\tau=0\)) | 符号准确率(\(\tau=1\)) |
|---|---|---|
| 标准 critic + MSE | 50.51 | 51.19 |
| 标准 critic + BCE | 50.70 | 51.14 |
| TPPO critic + BCE | 52.71 | 53.94 |
换 BCE 单独只带来 0.2 个点,换累加参数化带来 2-2.8 个点。增益主要来自结构,不是 loss。这个消融做得干净。
第二组是训练全程的符号一致性追踪:
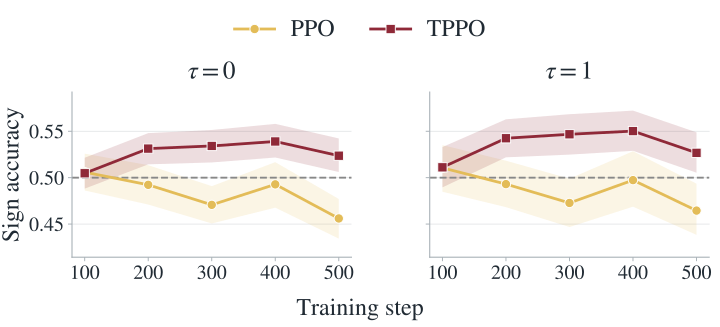
图5:critic 预测的局部价值变化方向与 MC 估计的符号一致率(\(\mathrm{SNR}>\tau\) 过滤掉噪声估计)。两条线从相近的起点出发,PPO 一路下滑到 0.45-0.47,TPPO 一路上升到 0.52-0.55。后四个 checkpoint 上 TPPO 领先 3.9-6.8 个点(\(\tau=0\))和 4.9-7.4 个点(\(\tau=1\)),95% bootstrap 区间均在零以上。
第三组直接看 advantage 质量——把 MC 价值代入 GAE 当参照,比较两边 advantage 的余弦相似度和符号一致率:
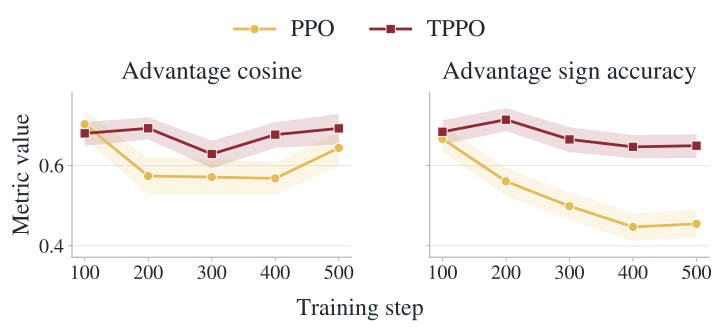
图6:advantage 余弦相似度(左)与符号一致率(右)。PPO 的符号一致率从约 0.70 掉到 0.45 附近,TPPO 稳定在 0.65 以上。后四个 checkpoint,TPPO 的 advantage 符号准确率领先 15.3-19.9 个点。
从"critic 方向判不准"到"advantage 对齐度领先近 20 个点",因果链是闭合的:价值演化追踪更好 → advantage 更可靠 → 策略更新质量更高 → 最终分数更高。这条链每一环都有实验撑着,这是我认可这篇论文的主要原因。
消融
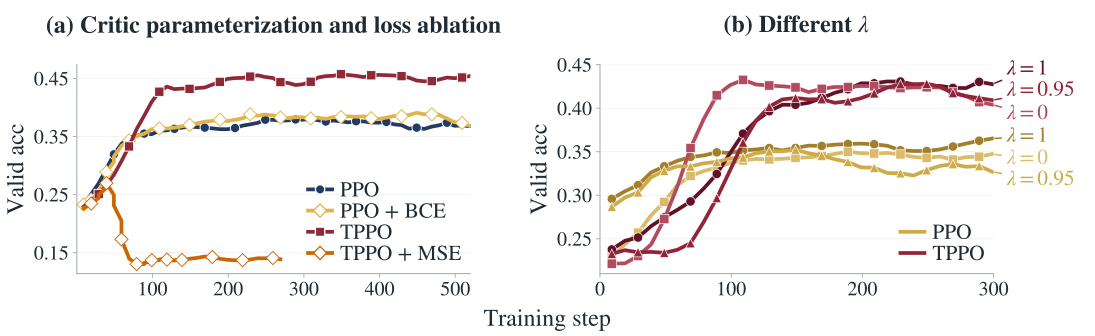
图8:(a)critic 参数化与 loss 的消融:PPO+BCE 比 PPO 略好,但 TPPO 明显更高且保持差距;TPPO+MSE 则早期就崩了——累加结构必须配 BCE,配 MSE 反而更糟。(b)actor 侧 GAE 系数 \(\lambda \in \{1, 0.95, 0\}\) 下 TPPO 全部保持领先,说明增益不依赖特定的 advantage 传播方式。
TPPO+MSE 崩掉这个现象挺有意思。我的理解是:累加结构下每个位置的输出是无界标量,MSE 直接对概率空间施压会造成梯度失衡,而 BCE 在 logit 空间天然平滑。这也反过来印证了"log-odds 是这套方法的正确坐标系"。
我的判断
亮点很清楚。理论动机是一条恒等式而不是一个故事,改动小到一个 head 加一个 loss,诊断实验用 590 万条 MC 采样把"为什么 work"钉死了。这在 RL 论文里是稀缺品质——太多论文只给你看终点分数,不给你看信号质量。
但也有一些要泼冷水的地方。
第一,符号准确率 52-54% 这个数字,离"好"还很远。TPPO 把 critic 从"不如抛硬币"修到"比抛硬币好一点",是相对改善巨大、绝对水平仍然堪忧。长 CoT 的 token 级 credit assignment 离解决还差得远,这篇是往前推了一步,不是终点。
第二,实验规模最大的模型是 9B(Qwen3.5-9B),主战场是 4B/8B。70B+ 规模、以及 reward 非二元(比如部分得分、多维 reward)的设定下这套东西还成不成立,作者自己在 Limitations 里也承认了。贝叶斯分解本身依赖二元终端奖励和 \(\gamma=1\),往 dense reward 扩需要重新推导。
第三,MC 评估协议本身有噪声——在 10%-90% 位置取 9 个 anchor、每个 128 条续采样,anchor 之间的价值波动测不到。作者对此也坦白。所以 Figure 5/6 里那些差距的绝对数值不必太当真,趋势是可信的。
工程上的建议很直接:如果你在用 PPO 系的方法训推理模型,TPPO 值得试——改动小、风险低、代码开源,而且 n=1 这种低预算设定下收益反而更大,对算力紧张的团队尤其友好。如果你在用 GRPO 系,这篇的启示是另一层的:value-free 方法绕开的问题并没有消失,只是被藏起来了,critic 路线修好之后的上限可能比想象中高。
更本质的问题还悬着:贝叶斯恒等式给出了价值演化的"真值结构",但学习出来的增量离真实的对数似然比还有多大差距、这个差距由什么决定,论文没有答案。这大概是下一篇的空间。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我