选项换个顺序,答案就变了?Jeva 从第一性原理重做 System One 决策模型
先说一个让我有点皱眉的实验现象。
System One 模型最近很火——不生成文本,一次前向直接吐出结构化的决策:从候选里选一个(Choice)、打个分(Score)、判断是与否(Noul),每个输出都带概率。听起来是软件自动化的理想零件:没有 JSON 解析失败,没有废话,延迟几十到几百毫秒。
但有人拿这类模型做了个简单测试:把候选选项的顺序打乱,再问一遍同样的问题。结果相当难看——在这篇论文的对照实验里,几个有代表性的开源 System One 模型,17% 到 26% 的样本会因为你只是换了个选项顺序而改变答案。最夸张的一个 baseline,换个顺序后"所有顺序下都答对"的比例从 76.67% 掉到 11.83%。
你想想这有多离谱。工具调用路由的时候,一个工具排在列表第 3 位还是第 7 位,居然能左右模型的选择。这不是模型笨,这是架构有病。
这篇 Jeva 就是冲着这个病根来的。作者没有继续在"把请求和候选拼成一大段文本让 Transformer 读"的范式上打补丁,而是问了一个更根本的问题:**一个决策问题的结构到底长什么样?**然后从答案反推架构。
核心摘要:Jeva 是新加坡国立大学提出的决策原生(decision-native)System One 架构。它把"语义编码"和"集合判断"拆开:请求和每个候选独立编码成向量,一个紧凑的决策堆栈只精炼请求状态、对着只读的候选记忆做注意力,再用一个独立的覆盖门(coverage gate)区分"没有答案"和"候选之间的竞争"。结果相当能打:600 个 Choice 样本在任意候选排列下零决策翻转,BANKING77 空答案检测 AUROC 98.66%,候选集扩到 2048 个时准确率 69.88% 且比递归选择基线快 2 倍以上,跨请求缓存命中时延迟中位数降 27.86 倍——而且决策结果一个比特都不变。这不是又一篇"我的分数比你高"的论文,而是一套关于"决策模型应该满足什么结构性质"的完整论证。值得细读。
论文信息
- 标题:Jeva: System One Models from First Principles
- 作者:Qi Li, Xinchao Wang(National University of Singapore,新加坡国立大学)
- 链接:https://arxiv.org/abs/2610.18773 (arXiv:2610.18773,2026 年 10 月 13 日提交,cs.AI)
- 资源:模型权重 HuggingFace
LIQIIIII/Jeva-4B,代码github.com/LiQiiiii/Jeva
🎯 背景:System One 火了一个月,病根就暴露了
先交代一下赛道背景,因为这篇文章的所有批判都建立在对这个新兴品类的理解上。
2026 年 9 月 15 日,TypeSafe AI 发布了 Jev,把"System One 模型"这个概念推到了台前——名字借自卡尼曼《思考,快与慢》里的系统一:快速、直觉、不啰嗦。创始人是前 OpenAI 研究员 Diogo Almeida,RLHF 的发明者之一。Jev 的定位很清晰:软件里大量判断根本不需要一篇作文,工单路由、工具选择、内容审核,答案集合是提前写死的,模型要做的只是选一个并给出把握。
这个定位打中了真痛点。一个月之内,开源跟进者扎堆出现:Laya、KEV、OpenJev、Strands Decider,还有这篇论文对标的 InternDecision、JevK5、SemIf、ReFlex、CLM、Valen 等。但蜜月期很短。10 月中旬的几篇独立评估接连发现问题:有研究发现这些模型"读懂了状态却做错决策"——Jev 73% 的错误发生在它已经答对所有事实探针之后;另一篇发现选项顺序是个隐藏的超参数, shuffle 一下选项答案就动。
Jeva 的作者把这些问题收拢成一句话:把决策问题序列化成文本再预测答案,这个动作本身没有尊重决策问题的结构。他们列了四条结构要求,我认为这是全文最值钱的框架:
| 性质 | 要求 | 现有做法在哪翻车 |
|---|---|---|
| Null-aware | 区分"没有候选可用"和"候选之间拿不准" | softmax 在候选上归一化,永远假设答案在集合里 |
| Permutation-invariant | 候选重排不改决策 | 无序集合被当成有序序列读,位置编码泄漏 |
| Option-scalable | 候选变多不需要重定义输出空间 | 固定答案符号表,候选上限写死 |
| Cacheable | 请求无关的候选计算可跨请求复用 | 请求和候选联合编码,换个请求全部重算 |
第四条在工程上其实很要命。工具注册表、文档库、标签体系这些东西是跨请求持续存在的,每次请求都把几百个工具描述重新编码一遍,纯粹是浪费。但联合编码架构把这个浪费变成了结构必然——候选内容被焊死在请求相关的计算里,想复用都没处下手。
🏗️ Jeva 架构:编码归编码,决策归决策
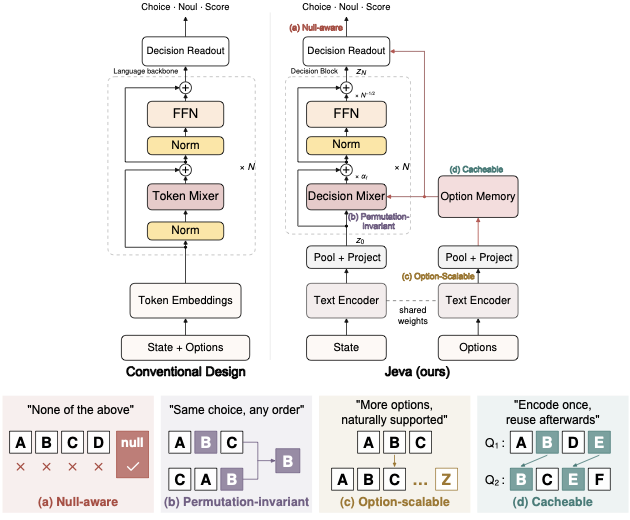
图1:上半部分是传统联合编码设计与 Jeva 的对比——左边把 State+Options 一起喂进完整的语言骨干堆栈;右边 Jeva 让 State 和 Options 各自过共享权重的 Text Encoder,State 经 Pool+Project 得到初始状态 z₀,Options 经 Pool+Project 变成只读的 Option Memory,决策堆栈(Decision Mixer + FFN)只精炼 z,最后由 Decision Readout 统一输出 Choice/Noul/Score。下半部分是四个结构性质的示意:(a) 显式的 null 结局;(b) 任意顺序下同选;(c) 候选数可变;(d) 编码一次、后续复用。
一句话讲清核心思路:候选是数据,不是计算。
具体来说,一个请求由状态 \(x\)、问题 \(\iota\)、决策类型 \(t\) 和候选集 \(\mathcal O=(o_1,\ldots,o_K)\) 组成。Jeva 用两个模板分别格式化:\(T_x(t,\iota,x)\) 装请求侧,\(T_o(t,o_i)\) 只装决策类型和候选文本——注意,\(T_o\) 里没有当前问题、状态、候选序号,也没有其他候选。共享骨干 \(E_\theta\) 加末位非填充 token 池化,再无偏置投影:
候选向量 \(u_i\) 组成矩阵 \(U\),在一次前向里固定不动。这就是"不可变选项记忆"(immutable option memory)的由来——因为 \(T_o\) 不含任何请求信息,\(u_i\) 天然是请求无关的,可以缓存。
然后决策堆栈开始干活。每个 block 里,只有状态 \(z\) 在演化:query 从 \(z\) 投影出来,key 和 value 从 \(U\) 投影出来,做多头注意力聚合候选证据:
状态走两个残差更新:\(\widetilde z_\ell=z_\ell+\alpha_\ell m_\ell\),然后 \(z_{\ell+1}=\widetilde z_\ell+L^{-1/2}F_\ell(\operatorname{RMSNorm}(\widetilde z_\ell))\),其中 \(\alpha_\ell=\tau_\ell\sigma(\gamma_\ell)/\sqrt L\)。这个耦合设计保证了 \(0\lt\alpha_\ell/\tau_\ell\lt 1/\sqrt L\),把混合强度压在温度之下,训练稳定性有保障。
最后读出:最终分数 \(s_i=z_L^\top u_i\),条件概率 \(q=\operatorname{softmax}(s/\tau_{\mathrm{dec}})\)。三个输出类型共用这一套计算——Choice 就是选候选,Noul 取正布尔候选的概率 \(q_{i^+}\),Score 是数值 rubric 的期望 \(\sum_i q_i v_i\)。输出解释由 rubric 值决定,不需要额外的编码器输入。
这个架构有个很漂亮的副作用:mixer 直接形成消息,从不构造 \(K\times K\) 的交互矩阵。在准备好的记忆上,决策成本是 \(O(L(d^2+Kd+df))\),对候选数 \(K\) 是线性的。
🧠 为什么必须精炼状态?一个漂亮的构造性证明
到这里你可能有个疑问:既然候选独立编码了,为什么不干脆每个候选独立打分、最后 softmax 一下?检索里的双塔模型不就这么干的吗,DPR、ColBERT 都是这个思路,工程上成熟得很。
作者用一个命题把这条路堵死了,这是我读这篇论文时最喜欢的一段。
先看独立打分的死穴。设 \(q\) 是"存在可接受候选"条件下候选上的分布,独立分数 \(g(x,\iota,o_i)\) 经温度 \(\tau\) 的 softmax 归一化后,log 几率满足:
共享分母在比值里消掉了。结论很冷:加候选、删候选,能改变概率数值,但永远无法反转两个保留候选之间的偏好。
然后作者给了个构造性反例(论文 Proposition 1):存在固定的 Jeva 参数和两个都包含 \(A\)、\(B\) 的候选集,同一个请求下,一个 block 在集合 \(\{A,B,C_+\}\) 里唯一选 A,在 \(\{A,B,C_-\}\) 里唯一选 B。具体构造用二维单位向量:\(z_0=(1,0)\),\(A=(4,3)/5\),\(B=(4,-3)/5\),\(C_\pm=(3,\pm4)/5\),取 \(\tau=3/20\)、\(\alpha=1/20\),第三个候选分到的注意力权重 \(w=(1+2e^{4/3})^{-1}\),最终分差是 \(\pm 24\alpha w/25\)——符号恰好随 \(C\) 的取号翻转。
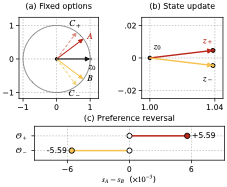
图2:这个构造的可视化。(a) 单位圆上固定的四个选项位置,A 和 B 始终在场,第三个候选是 C₊ 或 C₋;(b) 初始状态 z₀ 经 mixer 后分别更新为 z₊ 和 z₋;(c) 偏好反转——在 𝒪₊ 集合中 A 领先 B 约 5.59×10⁻³ 分,在 𝒪₋ 中 B 反超同样的幅度。空心标记是独立打分器的平局点,它永远跨不过去。
说实话,看到这个构造的时候我停了一下。它证明的不是"注意力很强"这种废话,而是:哪怕只有一个决策 block,只要让状态读一遍候选集再打分,模型就具备了对候选间交互建模的能力——比如"C 的存在让我意识到 A 比 B 更合适"。附录里还把这个二维构造嵌进了实际部署的宽度(\(d=768\)、\(H=8\)),说明它不是玩具假设。可复用的特征不等于独立的决策,这句话值得抄下来。
🚪 覆盖门:竞争归竞争,有没有答案归有没有答案
传统做法怎么处理"以上皆非"?往候选里塞一个 None 选项,一起 softmax。Jeva 说不对,这是把两个不同的问题混在一起。
论文区分得很干净:竞争(competition)是候选之间谁更好,覆盖(coverage)是集合里到底有没有能用的。Jeva 单独估计"至少存在一个可接受候选"的概率:
也就是 \(P(Y=i)=P(Y\ne\bot)\,P(Y=i\mid Y\ne\bot)\),先把"有没有"的概率切出来,再在"有"的条件下分配竞争概率。闭集请求用 \(q\),开放集请求用完整的 \(p\)。
为什么不用 flat softmax 加 null 分数?Proposition 2 给了一个很实在的数值理由:固定最终分数时,往集合里加低于当前最大值的候选,\(\rho\) 不变——直觉对,新来的弱候选不该改变"有没有答案"的判断。而 flat softmax 下,\(K\) 个相同分数 \(s\) 的候选会把 null 概率压成 \(p_\bot^{\mathrm{flat}}=\sigma((b_0-s)/\tau-\log K)\),候选越多、null 概率越低,哪怕每个候选单独看都没变好。集合大小污染了答案存在性的估计,这在检索候选数动态变化的场景里是实打实的 bug。
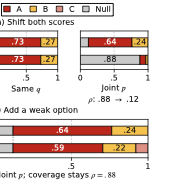
图3:两个受控实验。(a) 把 A、B 两个分数同时平移,条件分布 q 完全不变(Same q),但联合分布 p 里 null 的概率从 0.12 涨到 0.88——相对偏好不能告诉你"有没有候选可接受"。(b) 固定分数下加入弱候选 C(分数 0.4),覆盖度 ρ 保持 0.88 不变,只是 p 在候选间重新分配。
这个设计的训练也很省事。对归一化开放集目标 \((y_\bot,y_1,\ldots,y_K)\),损失就是联合交叉熵:
其中 \(g=\operatorname{logit}(\rho)\)、\(c_y=\sum_i y_i\)。全 null 样本只监督可用性、不强行制造一个虚假的候选排序——附录里还证明了期望损失的超出部分正好分解为覆盖误差加 \(\rho^\star\) 加权的竞争误差,损失函数和决策语义对得上。
♻️ 对称性与缓存:零翻转不是训出来的,是结构保证的
排列不变性这块,很多工作的思路是训一个顺序一致性损失,或者像 ReFlex 那样对多个顺序的预测做平均。Jeva 的姿态更硬:不需要损失,架构本身就是对称的。
Proposition 3:固定权重、确定性精确算术下,排列候选及其元数据只会相应排列候选概率,而 \(z_L\)、null 概率、Noul/Score 输出完全不变。证明就一句话的工夫——重排 key 和 value 只是给注意力里的求和重新索引,归纳穿过状态更新即可。共享打分头对可变大小集合天然适用,参数形状跟 \(K\) 无关。
缓存的数学身份同样干净。原子候选记忆存语义向量和所有层的投影:
因为 \(T_o\) 模板里没有任何请求信息,这些条目跨请求是逐比特相同的,替换成缓存条目不改任何输出。两级缓存:set cache 存整组候选,hybrid cache 还能在新组合的集合里复用单个候选。状态编码和决策精炼永远每次现算——缓存的只是候选侧,答案从不缓存。
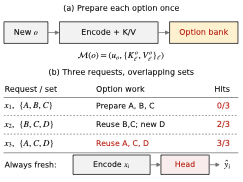
图4:(a) 每个候选只准备一次:编码加 K/V 投影后入候选银行。(b) 三个请求、候选集有重叠的场景——空银行起步,x₁/{A,B,C} 命中 0/3,x₂/{B,C,D} 命中 2/3,x₃/{A,C,D} 命中 3/3;整组集合的查询全部 miss,但逐候选复用照样生效。下方的 Encode + Head 每次请求都是新鲜的。
一个 \(M\) 候选的银行只占 \(O(M(L+1)d)\) 存储,新候选来了编码一次入库即可,不需要加输出参数,也不需要联合 token 窗口。这个设计对"工具注册表持续演化"的真实 agent 场景非常友好。
🔧 训练配置:4B 骨干,13.37M 参数的可训练部分
Jeva-4B 的具体配置:骨干 Qwen3.5-4B,池化宽度 2560,决策宽度 \(d=768\),\(L=1\) 个决策 block,\(H=8\) 个头(头宽 96),SwiGLU 宽度 3072。可训练部分是 rank-64 的 LoRA 加两个投影和决策头,合计 13,370,117 参数——4B 模型只动 1300 万参数,服务时 LoRA 合并进骨干。
数值配置有个细节得说一下:query/key 归一化、兼容性分数、候选 softmax 和覆盖门全在 FP32 下算,骨干是 BF16。温度用 softplus 参数化学习,初始化 \(\tau_{\mathrm{set}}=0.15\)、\(\tau_{\mathrm{dec}}=\tau_{\mathrm{cov}}=0.10\)。三个温度分管证据聚合、竞争、覆盖,各学各的。
训练课程是分阶段的:约 8 万条基础 typed 决策起步,扩展到约 50 万条偏好比较与推理,再到 25 万条反事实与验证(带回放)、6 万条证据决策与开放集、2 万条阅读逻辑、6 万条混合难例(其中 1.5 万条按 7:3 混合原始目标与教师概率,且教师指导只在两个独立 shuffle 顺序下 top 预测一致时才接受)、1 万条定向强化、8 万条长文本大候选池,最后 7 万条打分聚焦收尾。监督信号混合硬标签、软概率、显式 null 和数值 rubric。
📊 实验:四个性质逐条验收
评测套件包括 Typed Decisions(2000 条测试决策:600 Choice + 600 Noul + 800 Score)、BANKING77 和 MASSIVE(\(K\in\{8,16\}\))、Mind2Web 三个 \(K=16\) 切片,延迟在单张 H200 上同步计时。
通用决策质量
| 模型 | Typed Test | BANKING77 K=8 | BANKING77 K=16 | MASSIVE K=8 | MASSIVE K=16 | M2W Task | M2W Website | M2W Domain |
|---|---|---|---|---|---|---|---|---|
| Jev-1.13.0 | 74.10 | 86.14 | 82.50 | 84.63 | 81.61 | 66.26 | 59.97 | 62.47 |
| JevK5 | 62.30 | 78.18 | 69.03 | 80.16 | 69.70 | 51.47 | 43.30 | 45.60 |
| InternDecision-4B | 78.70 | 80.78 | 75.03 | 81.20 | 75.79 | 48.02 | 41.17 | 43.61 |
| KEV-4B (BF16) | 66.00 | 83.47 | 82.47 | 76.60 | 73.54 | 40.32 | 34.17 | 35.62 |
| ReFlex-4B | 58.85 | 78.77 | 74.38 | 76.63 | 71.39 | 52.08 | 45.05 | 47.64 |
| Qwen3.5-4B label LP | 50.85 | 49.84 | 43.12 | 47.31 | 41.63 | 18.14 | 15.30 | 18.34 |
| Jeva-4B | 78.30 | 92.05 | 91.62 | 91.09 | 90.22 | 79.99 | 62.25 | 66.23 |
表1:first-argmax 准确率(%,含 null 结局),加粗为每列最优。完整表格还含 InternDecision-2B/0.8B、SemIf-4B、CLM-8B、Valen-Preview-2B、Laya-English、Qwen3.5-2B label LP 等共 15 个对照。
八个切片里 Jeva 赢了七个,BANKING77 和 MASSIVE 两个候选数下全部过 90%。唯一输的是 Typed Test:78.30% 对 InternDecision-4B 的 78.70%,差 0.4 个点。这个得说清楚,论文自己也如实报了。
Mind2Web 上差距最夸张:cross-task 79.99% 对第二名 Jev 的 66.26%,领先近 14 个点。元素选择这种"候选多且相似"的任务,正好是集合判断能力的试金石。
类型保真度与顺序稳定性
| 模型 | Noul Brier ↓ | Noul MAE ↓ | Score MAE ↓ | Score RMSE ↓ | Flip % ↓ | All-order % ↑ | Mean TV ↓ |
|---|---|---|---|---|---|---|---|
| Jev-1.13.0 | 0.0342 | 0.1456 | 0.3744 | 0.4795 | 17.00 | 66.67 | 0.0858 |
| JevK5 | 0.0987 | 0.2448 | 0.4370 | 0.5935 | 26.17 | 47.83 | 0.116 |
| InternDecision-4B | 0.0340 | 0.1431 | 0.2488 | 0.3208 | 22.67 | 64.50 | 0.106 |
| KEV-4B (FP32) | 0.0887 | 0.2283 | 0.3989 | 0.5675 | 17.17 | 55.83 | 0.0657 |
| Laya-English | 0.1514 | 0.3206 | 0.7083 | 0.8383 | 66.83 | 11.83 | 0.139 |
| Qwen3.5-4B label LP | 0.1623 | 0.3213 | 0.8095 | 1.0235 | 84.50 | 14.17 | 0.414 |
| Jeva-4B | 0.0184 | 0.0939 | 0.2315 | 0.3222 | 0.00 | 76.67 | 3.17e-08 |
表2:600 Noul + 800 Score + 600 Choice 排列测试。Flip 是任一测试顺序改变决策的样本比例;all-order 要求每个测试顺序下都答对;Mean TV 是候选对齐后分布的总变差距离。
这张表是全文最有冲击力的一张。Jeva 在 600 个 Choice 样本上(原始顺序 + 反转 + 最多三个随机种子顺序)翻转率为零,Mean TV 是 \(3.17\times10^{-8}\)——纯浮点噪声级别,跟 Proposition 3 严丝合缝。对照组 17% 到 84.5% 的翻转率摆在那里。我的第一反应是:这才是 System One 该有的样子。一个承诺"相同输入相同输出"的品类,连选项顺序都扛不住,叫什么决策基础设施。
Score RMSE 上 Jeva 是 0.3222,以 0.0014 的微弱差距输给 InternDecision-4B 的 0.3208——同样如实记录。
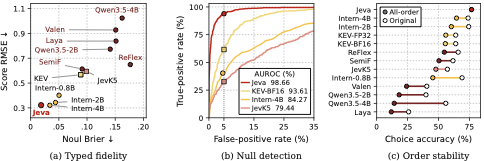
图5:(a) Noul Brier 对 Score RMSE 散点,Jeva 独占左下角;(b) BANKING77 K=16 空答案检测 ROC,Jeva AUROC 98.66%,KEV-BF16 93.61%,Intern-4B 84.27%,JevK5 79.44%,标记点是各模型实测的近 5% FPR 工作点;(c) 原始准确率与全顺序准确率的连线,Jeva 76.67% 纹丝不动,其他模型集体下滑。
空答案检测
3,080 条匹配的 BANKING77 请求(2,492 有答案、588 扣掉答案),\(K=16\)。Jeva 的覆盖门拿到 98.66% AUROC,在 5.02% FPR 的工作点上检出 93.88% 的缺失答案。对照组最好的 KEV-BF16 是 93.61%,InternDecision-4B 84.27%,JevK5 79.44%。
要说句公道话:这个对比不完全对等——baseline 没有原生覆盖门,只能用辅助 Noul 输出或显式 None 候选来凑。但这恰恰印证了论文的论点:null 检测是架构性质,不是后处理能补的。
候选规模扩展
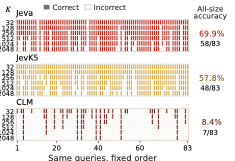
图6:83 个固定 query(列)在候选数从 32 嵌套扩展到 2048(行)时的正确性热力图,有色格子为答对。Jeva 有 58 个 query 在所有规模下全对(all-size 准确率 69.88%),JevK5 是 48 个(57.83%),CLM 只剩 7 个(8.4%)。
候选集膨胀时决策稳不稳?Jeva 的 all-size 准确率比 JevK5 高 12.05 个点。CLM 的 8.4% 说明独立编码加对比学习的路线在集合膨胀时直接崩了——候选一多,独立打分器无法重新校准竞争格局的老毛病全暴露出来。
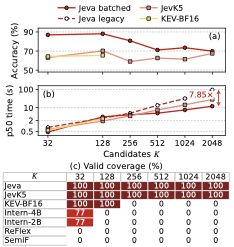
图7:(a) 各候选数下的准确率,Jeva(batched 与 legacy 编码两条线)从 K=32 的 86.90% 缓降到 K=2048 的 69.88%,JevK5 靠递归选择维持在 60% 出头,KEV-BF16 在 50% 附近;(b) p50 延迟,长度感知批处理(256 行/131,072 token)让 Jeva 在 K=2048 时从 94.459 秒压到 12.040 秒(7.85 倍),而 JevK5 递归方案要 28 秒;(c) 有效覆盖率——Jeva、JevK5、KEV 全部 100%,InternDecision 两个变体在 K=32 只支持 65/84 条请求(77%),更大候选数直接超出其注册上限。
几个关键数字:500 条 ToolRet 请求,Jeva 总准确率 78.40%,递归版 JevK5 是 64.00%。K=2048 时 Jeva 一次决策头前向打分整个集合,69.88% 准确率、12 秒;JevK5 递归选择 67.47%、28 秒。准确率更高,还快两倍多。 InternDecision 系列在 K 稍大时干脆不支持——固定输出空间的结构性限制,实战中就是直接不可用。
缓存复用
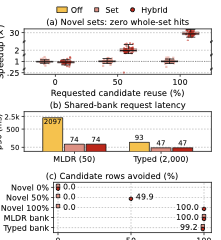
图8:(a) 50 条全新集合请求(整组缓存保证零命中)在不同候选复用比例下的配对加速比箱线图,hybrid 缓存在 100% 复用时中位加速约 28 倍;(b) 共享候选银行的 p50 延迟——MLDR 从 2,097 ms 降到 74 ms,Typed 从 93 ms 降到 47 ms;(c) 被省掉的候选编码行比例:Novel 100% 场景 100%,Typed 银行 99.2%。
MLDR 长文档候选集上:50 条匹配 query,0%、约 50%、100% 复用三档,hybrid 缓存拿到 1.95 倍和 27.98 倍的 p50 加速,全复用时 p50 从 2,102.0 ms 掉到 75.1 ms。共享银行场景 Typed Decisions p50 从 93.1 ms 降到 46.6 ms,99.2% 的候选编码被省掉。
最重要的那句:所有缓存条件下没有一个决策发生变化,最大绝对概率差 0.00736(浮点精度范畴)。效率收益不是拿准确率换的。
最后看四性质总览图,算是全文成果的浓缩:
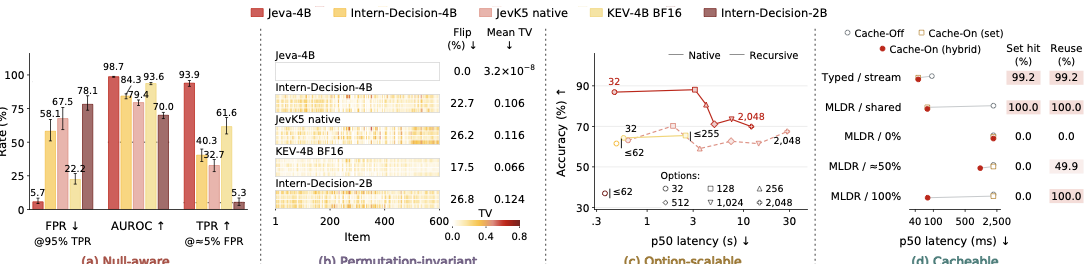
图9:(a) Null-aware 三指标对比:FPR@95%TPR 上 Jeva 仅 5.7%,第二名 KEV 是 22.2%,InternDecision-4B 高达 67.5%;(b) Permutation-invariant:Jeva 翻转率 0.0%、Mean TV 3.2×10⁻⁸,对照组翻转率 17.5% 到 26.8%;(c) Option-scalable:准确率-延迟权衡随候选数增长,Jeva 原生全集合打分(实线)一路走到 2048,递归基线(虚线)又慢又低;(d) Cacheable:Cache-On 相对 Cache-Off 的延迟对比与命中率,MLDR 全复用延迟降约 28 倍。
🤔 我的判断
这篇论文值钱的不是某个数字,而是把"决策模型该满足什么"从玄学变成了可检验的结构清单。四条性质每一条都配了理论命题和实验验收,命题的证明还真不是装饰——单 block 偏好反转那个构造,直接回答了"为什么双塔独立打分不够用"这个检索领域的老问题,这个论证可以独立于 Jeva 本身成立。
几个我被打动的点。零翻转是架构保证而非训练技巧,等于说你不需要为顺序鲁棒性付出任何训练成本或推理时的多顺序平均开销(ReFlex 那种方案推理成本翻倍)。覆盖门把 answerability 从 softmax 的隐含假设里解放出来,98.66% 的 AUROC 是设计红利而不是调参红利。缓存那一节的工程含金量最高——候选记忆逐比特可复用,决策零变化,27.98 倍加速,这对要接几百上千个工具的 agent 系统是实打实的部署成本下降。
但问题也得说。
第一,赛道太新, baseline 全是过去几个月冒出来的工作,评测套件 Typed Decisions 也是 2026 年的新 benchmark。Jeva 赢了七个切片当然好看,但这些对手本身没有经过多轮公开 benchmark 的千锤百炼。这个领域的"第一名"含金量,需要时间来验证。
第二,Jeva 在 Typed Test 上输给了 InternDecision-4B(78.30 对 78.70),Score RMSE 也以毫厘之差落后。论文如实报告了,这点好评,但也说明决策头的能力上限还没到碾压级。\(L=1\) 的单 block 设计是效率优势,也可能在更复杂的集合推理上成为瓶颈——论文的嵌套集合实验里,候选从 32 涨到 2048,准确率还是从 86.90% 滑到 69.88%,集合膨胀时的性能衰减并没有被架构根治。
第三,覆盖门的 \(b_{\mathrm{cov}}\) 是学出来的阈值,分布外表现依赖训练课程的覆盖度。论文用事后温度缩放做补充校准,算是留了后手,但开放世界场景下 null 检测的鲁棒性,一篇论文的 BANKING77 实验说不完。
第四,训练课程的工程量藏在附录里——九个阶段、上百万样本、教师蒸馏加回放的精细配比。13.37M 可训练参数听着很轻,但复现这套课程的成本不低。开源了权重和代码是好事,想在自己的领域重训一套,门槛主要在数据配方。
跟同期工作摆在一起看:当别的论文在用实验证明"System One 模型会读对状态做错决策、会被选项顺序带偏"的时候,Jeva 直接给出了一个从架构上免疫顺序问题的方案,顺带把 null 检测和缓存这两个工程痛点一并解决。它的定位很清晰——不是聊天模型的替代品,而是 agent 系统里决策层的专用零件。这个定位我认为是清醒的。
如果你在做工具路由、检索重排、意图分类这类"候选已知、要快速判断"的系统,这篇论文的两个可以直接抄走的思想是:候选侧独立编码加只读记忆(立刻解锁缓存),以及覆盖与竞争分离的读出头(立刻解锁 null 结局)。哪怕不用 Jeva 本身,这两条也值得塞进你的下一个分类器。
至于"决策原生架构会不会成为 System One 的标配"——我的判断是,四条结构性质里的排列不变和可缓存,会在一年内变成这个品类的准入门槛,而不是加分项。做不到零翻转的决策模型,不敢往生产环境里放。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我