思维惯性:你让大模型"别思考",它偏要思考给你看
核心摘要
现在的推理模型都带"思考开关",关掉它、或者干脆在 prompt 里写"直接给答案别推理",模型就真的不思考了吗?这篇 NeurIPS 2026 论文给出的答案挺扎心:不是。作者把"no-thinking"从一句模糊的指令变成了一套可测量的行为指标(ETR / QRel. / EIR 三级评估),在 6 个模型、6 个 benchmark、6 种干预模式上系统扫了一遍,发现一个反直觉现象——思维惯性(Thinking Inertia):即使把思考模式彻底关掉、用最严格的指令要求只输出答案,模型在开放式题目上仍有接近 100% 的概率在答案前面暴露显式推理痕迹。更麻烦的是,强压它会掉点:开放式任务上严格指令把"纯答案率"从接近 0 拉到 40% 左右,代价是准确率掉约 15 个百分点。我的判断:这篇文章不是新模型也不是新算法,但它戳破了"关掉开关=没有推理"这个行业里心照不宣的假设,对做推理模型评估和部署成本控制的人值得细读。
📖 论文信息
- 标题:Thinking Inertia: LLMs Keep Thinking When Told Not To
- 作者:Dianqiao Lei, Kevin Qinghong Lin, Pan Lu, Philip Torr, James Zou
- 链接:https://arxiv.org/abs/2610.11765 (2026 年 10 月 8 日提交,NeurIPS 2026 接收)
- 项目主页:https://thinking-inertia.github.io ,代码:https://github.com/thinking-inertia/code
🎯 从一个真实场景说起
上周我在给一个线上服务压成本,做法很常规:简单问题走 non-thinking 模式,复杂问题才开思考。Qwen3 那个 enable_thinking=False 一开,心想这下延迟和 token 成本都省了。
等等,真的省了吗?
这篇文章的作者显然也怀疑这件事。他们的观察很直接:现在社区判断"模型没在思考",靠的是三个表面代理(proxy)——prompt 里没让它一步步想、输出里没有 <think> 标签、输出长度很短。问题是,这三个代理个个都有漏。

图2:左边是现有的三种判断方式(prompt 侧控制、思考特殊 token、生成长度),右边是它们各自的翻车现场。同一道 "3x+1=10" 的题:关掉思考模式,输出里照样有"两边减 1 得 3x=9";去掉 <think> 标签,推理只是换到了普通回答通道;输出够短,但 "3x=9, so x=3" 这一句本身就是压缩后的推理步骤。
说实话,看到第三个失败案例的时候我愣了一下——"短输出"几乎是业界最常用的降本指标,token 数一少大家就当任务完成。但这篇文章指出,短不等于没推理,一句紧凑的方程可能就是整个解题的关键中间步。反过来,一句 "Let me think about this. The answer is X" 虽然看起来像推理,其实什么有效信息都没有。
表面合规和真实行为之间有条缝,这篇文章就是把这条缝量化出来。
🏗️ 核心方法:把"没思考"拆成三层可测的东西
作者的切入点很漂亮:不管模型内部在算什么(latent reasoning 没法跨模型公平比较),只看可观测的响应。任何输出都被规整成一个二元组——前导文本 \(T\)(pre-answer trace)和最终答案 \(A\):
其中 \(Q\) 是问题,\(S(\cdot)\) 是干预(比如加一句"直接回答"),\(\pi\) 是模型。\(A\) 是最后一个可解析的答案,\(T\) 是它前面所有可读文本。然后对 \(T\) 做三层由粗到细的评估:

图3:上半部分是推理流程与三级度量(ETR、QRel.、EIR)的位置;下半部分用同一道 "42+79=?" 给出六种真实响应形态——从纯答案(Case 1)、短而显式推理(Case 2)、模板废话(Case 3)、长推理(Case 4)、跑题感慨(Case 5)到相关但无推理的断言(Case 6)。这个分类把"有字"和"在推理"彻底分开了。
Level 1:Empty-Thinking Rate(ETR)。最严格的口径——输出里除了合规的答案包装外没有任何实质文本才算 1:
ETR 干净但粗糙:\(T\) 非空之后,它分不清那是一句废话模板还是真推理。
Level 2:Question–Pre-answer Relevance(QRel.)。用带指令的 Qwen3-Embedding-4B 把 \(Q\) 编码成 query(指令是"检索与回答问题相关的推理文本")、\(T\) 编码成候选段落,算余弦相似度:
注意这里有个设计细节:空 \(T\) 直接记 0 分再进平均,所以 QRel. 不会被"纯答案占比高"灌水。但作者自己也承认,QRel. 测的是相关性不是推理——复述一遍题目也能拿高分,所以它只是中间层的信号。
Level 3:Explicit Inference Rate(EIR)。真正的裁判环节。用一个盲评 LLM judge(GPT-5.5,temperature 0)只看 \((Q, T)\),模型身份、干预模式、最终答案、对错全部隐藏,按五分类 rubric 打标签:generic/off-topic、paraphrase-only、relevant non-inferential、explicit reasoning、unclear。只有判为 explicit reasoning 才计 1:
这套层层递进的设计我觉得是全文最值钱的部分。它解决了一个评估上的老麻烦:"答案前有一段字"这件事本身信息量太低,三段式拆开之后,废话、复述、真推理各归各位。
干预侧,作者设计了一个六模式谱系,按"压制思考的强度"排轴:
| 模式 | 名称 | 思考开关 | 干预内容 | 定位 |
|---|---|---|---|---|
| M1 | Think-On | 开 | 无 | 原生思考参照 |
| M2 | Think-Off | 关 | 无 | 原生 no-think 基线 |
| M3 | CoT | 关 | "Think step by step." | 反向诱导思考 |
| M4 | Soft | 关 | "允许极短引入,但不要解释" | 软压制 |
| M5 | Strict | 关 | "直接给最终答案,不要任何推理" | 强压制 |
| M6 | Prefix | 关 | 预填 "The answer is \boxed{" | 结构性前缀强制 |
模型阵容覆盖了 Qwen3-4B / 32B / 235B-A22B(同家族缩放分析)、DeepSeek-V4-Flash(284B)、GPT-5.4、Gemini-3-Flash。Benchmark 按答案空间分三族:布尔判断(BoolQ、StrategyQA)、多选题(MMLU、MMLU-Pro)、开放式(GSM8K、MATH)。57 万多个输出,规模不小。
🧪 实验:惯性到底有多大
开关关了,推理还在

图1:左边是一道 MMLU 物理题,DeepSeek-V4-Flash 和 Qwen3-235B-A22B 被要求"只输出选项",结果两个模型都先在答案前推了一遍飞行时间公式——人类能遵守的指令,模型做不到。右边是六个 benchmark 上原生 no-think 模式下的 ETR(绿条)和可见长度(橙条):布尔题最接近纯答案,开放式题几乎全军覆没。
最扎眼的数字:DeepSeek-V4-Flash 在关闭思考模式的设置下,开放式题目上 99.9% 的响应仍包含可见显式推理。
这不是小模型的毛病,是前沿模型的通病。
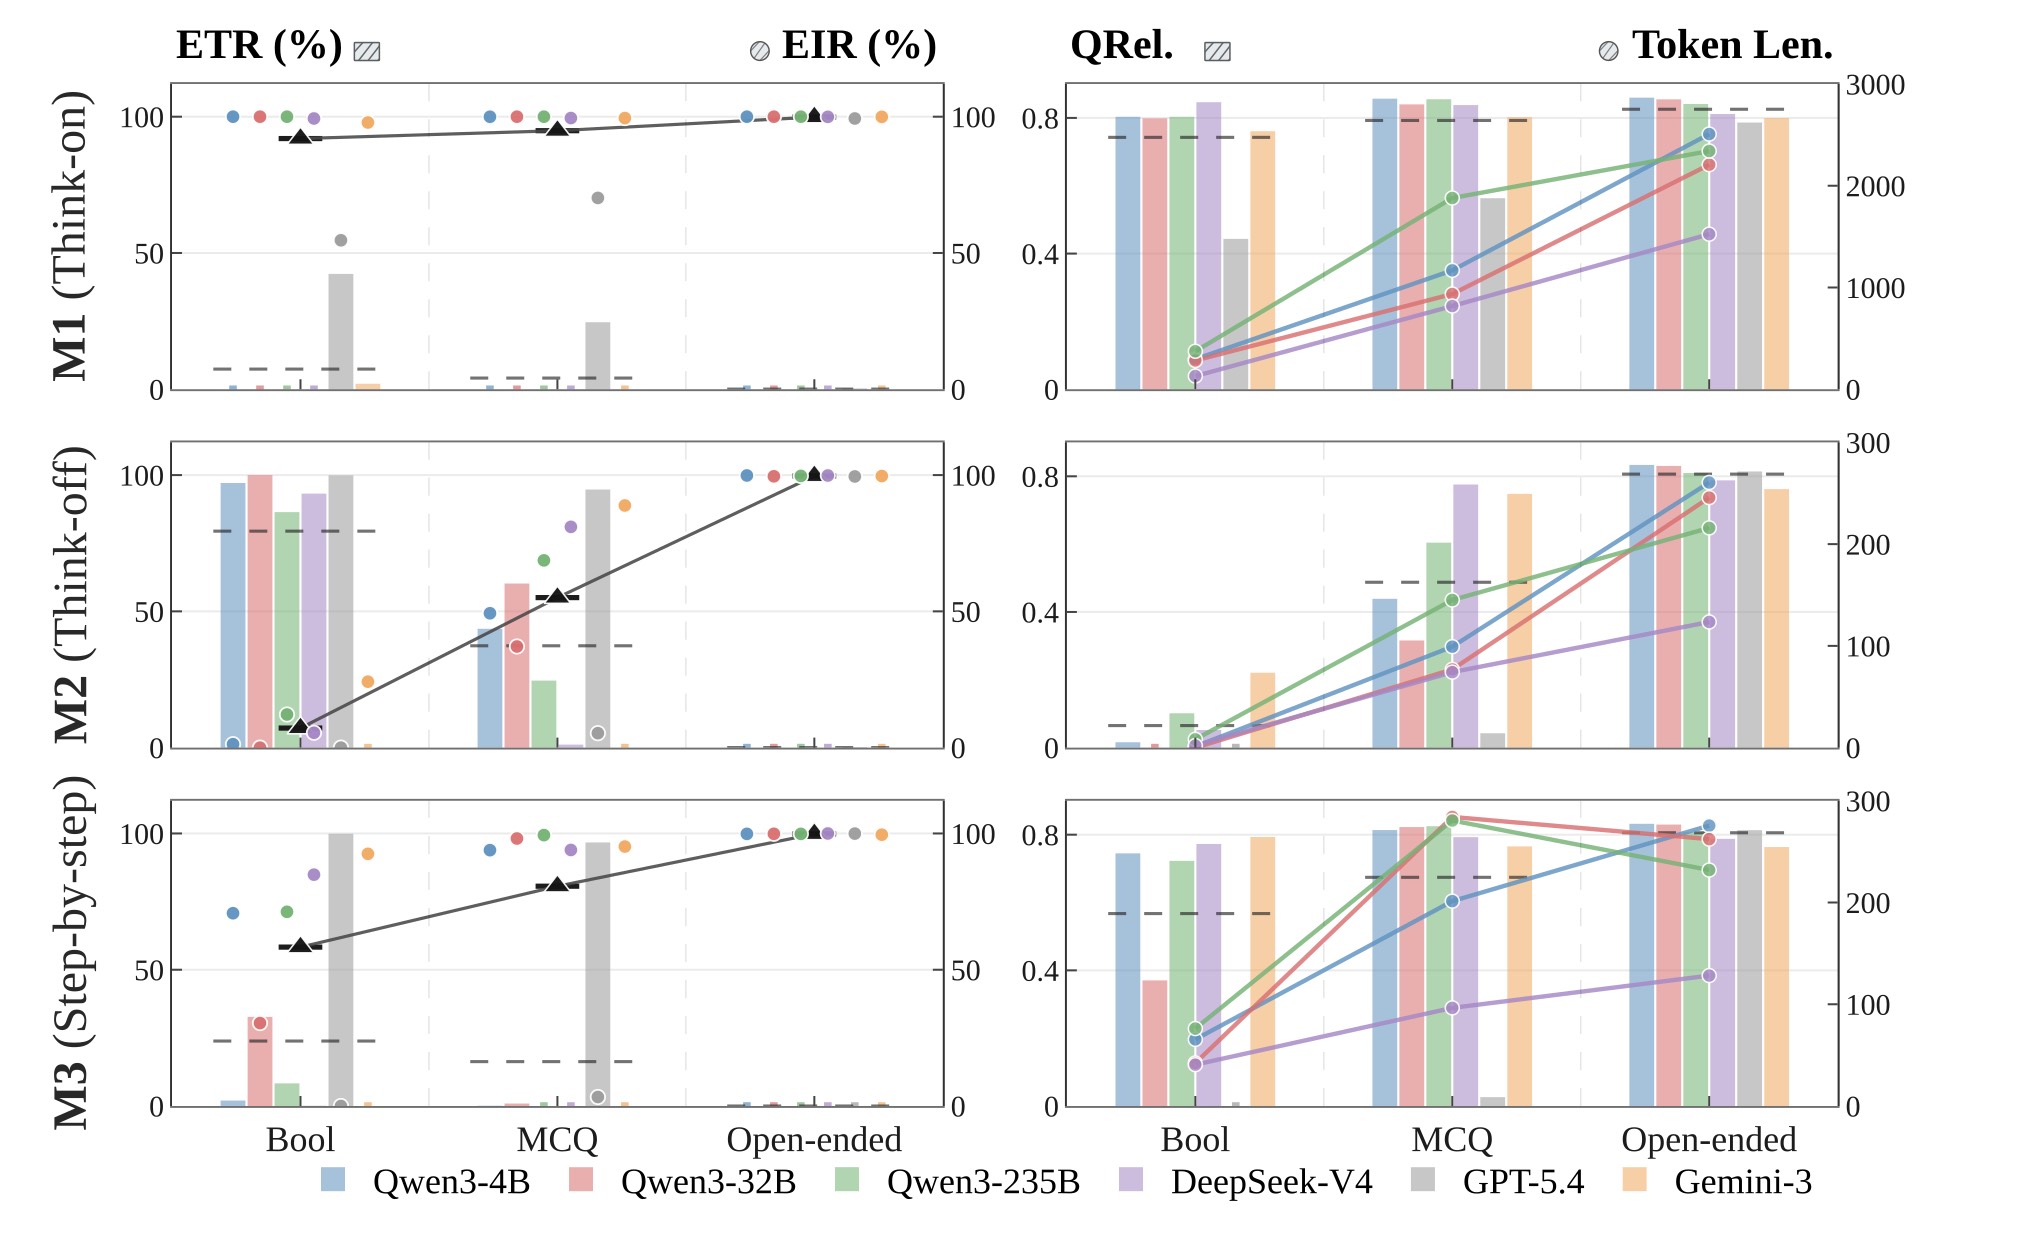
图4:三行分别是 Think-on、Think-off、Step-by-step;左列是 ETR 柱状图配 EIR 散点,右列是 QRel. 配可见前导长度。看 M2(中间行):Bool 上多数模型 ETR 能到 80–100%,MCQ 开始参差不齐(接近 0 到 95% 都有),Open-ended 上 ETR 几乎归零、EIR 高居不下。黑色三角连线的 EIR 均值走出一条清晰的 Bool \(\lt\) MCQ \(\lt\) Open-ended 阶梯。
这个阶梯就是"思维惯性"的核心证据:可见推理的组织方式更多由任务的答案空间决定,而不是由开关决定。开关关不掉它,它跟着题目走。
还有个反向实验挺有意思:M3 在思考开关关闭的情况下只加一句 "Think step by step",QRel. 和 EIR 就涨回接近 M1 的水平——开关关了,一句话就能把推理重新勾出来。GPT-5.4 是唯一的主要例外,在 Bool 和 MCQ 上守住了高 ETR。
强压的代价:no-thinking 与准确率的 trade-off
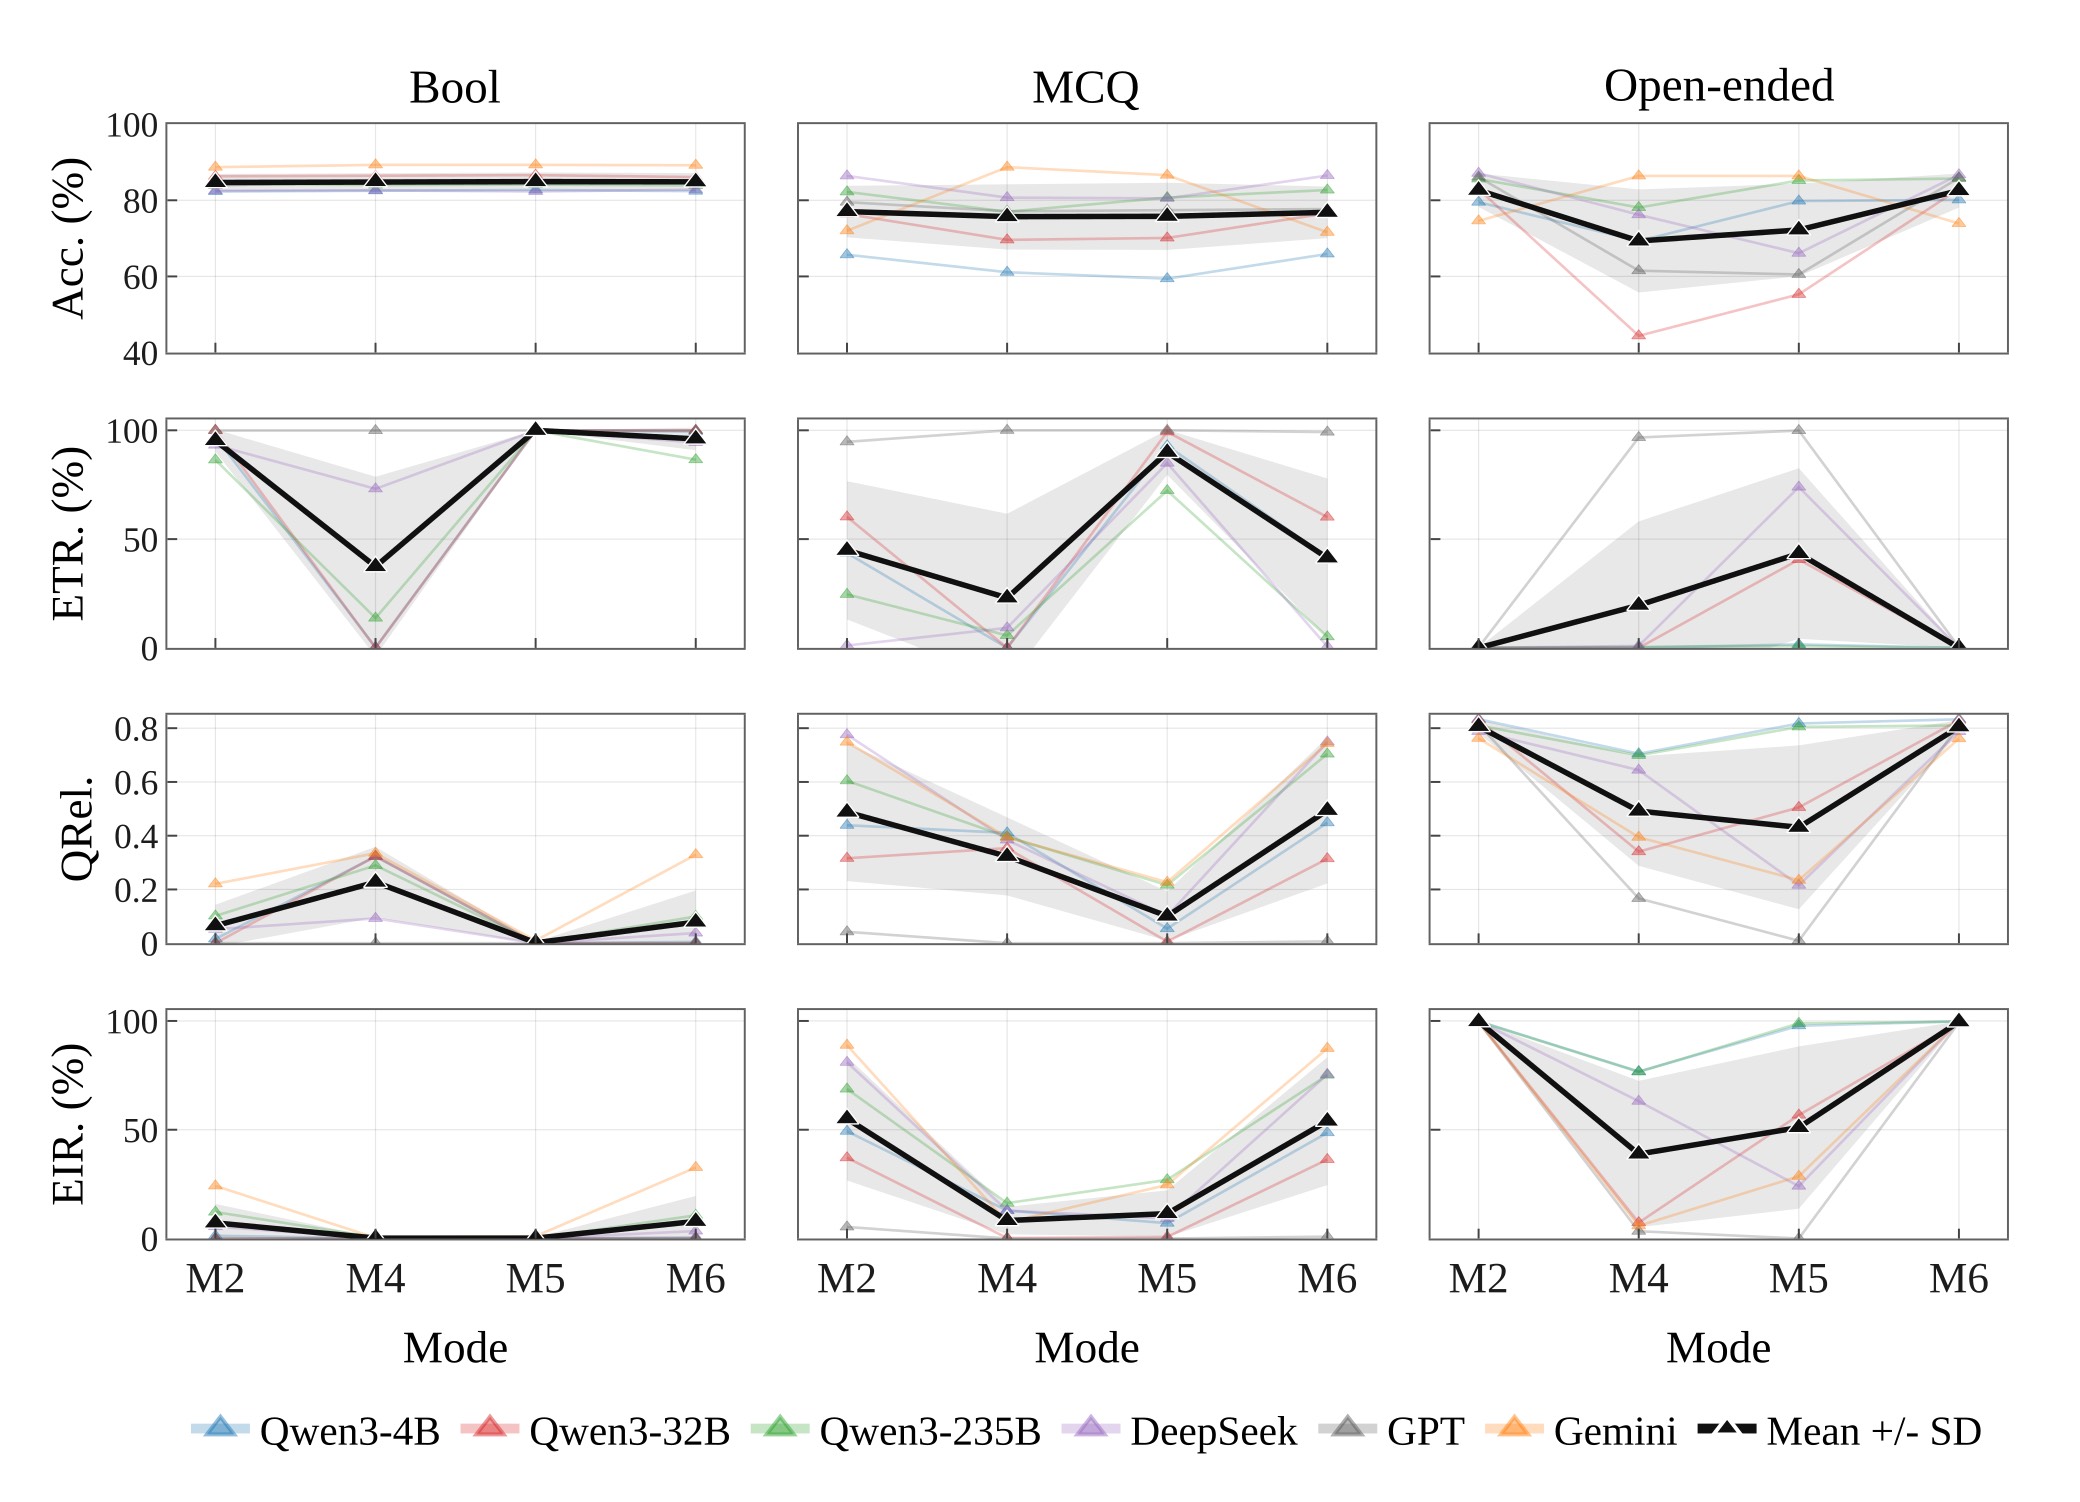
图5:三列是 Bool / MCQ / Open-ended,四行是 Acc. / ETR / QRel. / EIR,横轴是 M2→M4→M5→M6。Bool 行几乎一条平线(准确率稳在 85% 左右);Open-ended 列则剧烈波动——M5 处 ETR 拱起一个峰,同时准确率凹下去一块。
数据很直白。从 M2(原生 no-think)走到 M5(严格指令):
- 开放式任务:平均 ETR 从接近 0 拉到约 40%,平均准确率掉约 15 个百分点;对应 EIR 从 99.69% 降到 62.00%——注意,即便最严的指令压下去,六成多的响应里仍有显式推理。
- 布尔任务:EIR 从 5.15% 降到 0.12%,准确率几乎不动。
- 多选任务:EIR 从 45.57% 降到 25.39%,准确率也基本平稳。
你想想看这个画面:在开放式数学题上,"别思考"这句话模型要么不听(继续推理),要么听了但答不对。压制和正确率在同一根跷跷板的两端。
M6 的前缀强制也推翻了一个直觉猜想。按理说预填了 "The answer is \boxed{",模型应该顺着模板直接吐答案吧?并没有。M5 到 M6,MCQ 和开放式任务上的平均 ETR 反而回落,QRel. 和 EIR 在所有答案空间里反弹——模型会在模板之后接着写推理再填答案。结构性强制并不等于更强的语义压制,它是另一条分支。
换个问法,惯性就变了
我最喜欢的实验是 3.5 节的"答案空间改写":同一批 MMLU/MMLU-Pro 的数字答案题,原封不动拿 Qwen3-32B 在 M2 模式下跑,只是把答题界面改成布尔判断或开放生成。
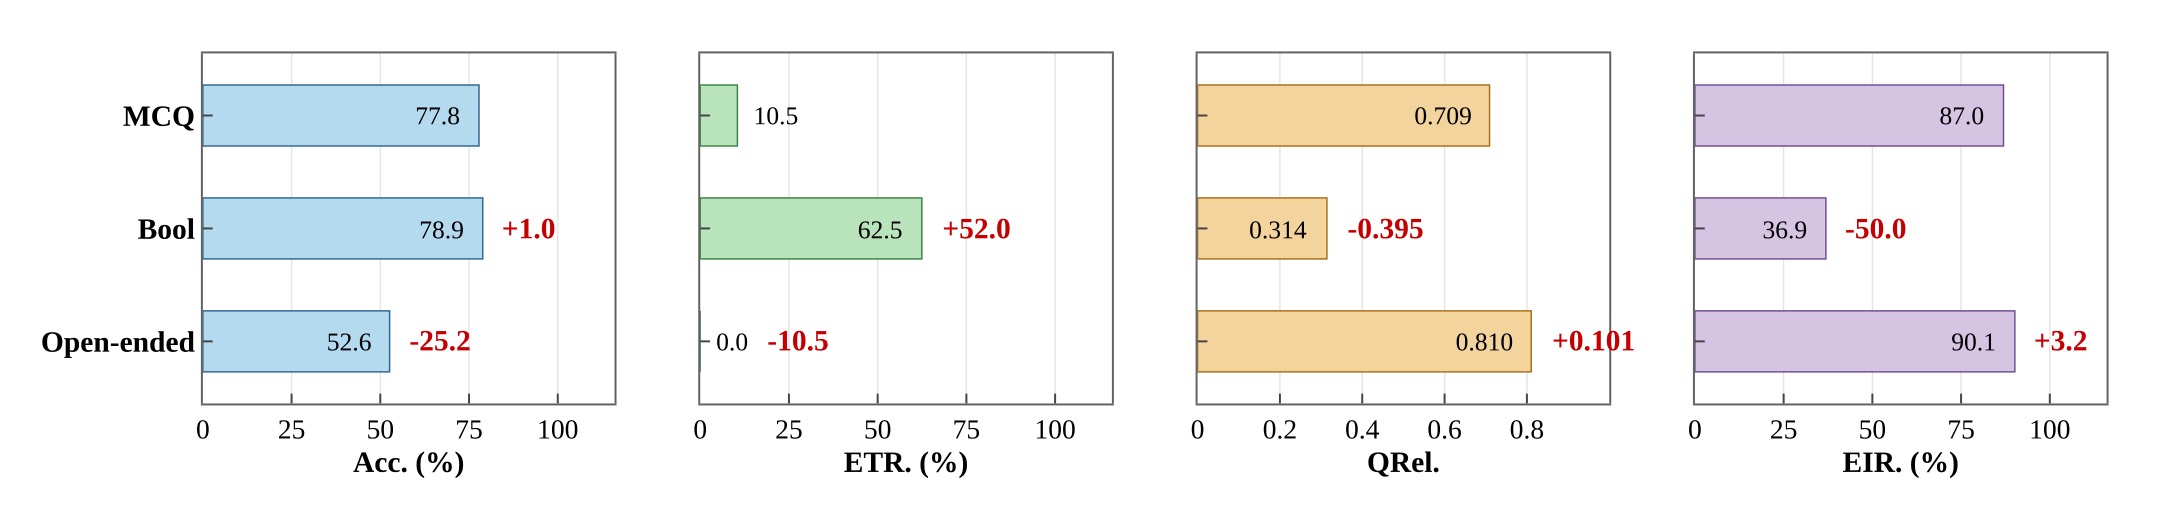
图6:四个面板分别是 Acc. / ETR / QRel. / EIR。MCQ 原版:准确率 77.8%、ETR 10.5%、EIR 87.0%。改成布尔版:准确率几乎不变(78.9%),但 ETR 飙到 62.5%(涨了 52 个点)、EIR 砍到 36.9%(降了 50 个点)。改成开放版:准确率跌到 52.6%,ETR 归零,EIR 升到 90.1%。
这个对照干净利落,直接排除了"benchmark 难度不同"或"答案长短不同"的解释——就是答题界面本身在决定模型敢不敢直接答。给了候选答案,模型就有底气直接勾选;要它自己生成数值,它就忍不住把中间步骤写出来。
顺着这个逻辑,学科实验(Table 4)也有个反常识发现:把界面固定在四选一 MMLU,STEM 学科准确率最高但 ETR 最低(0.3–36.4%),QRel.(0.509–0.784)和 EIR(59.7–85.5%)也是三科最高。答得准不等于答得干脆——STEM 题里中间计算就是刚需,模型"知道"这一点。
人类验证:指标不是自嗨
这套自动度量最怕的就是 judge 自己不准。作者做了 600 条样本的盲评人类研究(5 个标注员),结果:
| 层级 | 验证方式 | 结果 |
|---|---|---|
| ETR | 人工边界审计 | 600 条中 565 条一致,94.2% |
| QRel. | 与标注员相关性打分做 Spearman 相关 | \(\rho = 0.829\)(对比 all-MiniLM-L6-v2 的 0.809) |
| EIR | 与 GPT-5.5 judge 的二值一致率 | 98.8%;与跨家族 Claude Opus 4.8 judge 一致率 96.7% |
更重要的是,人工标注独立复现了核心趋势:M2 下 Bool 4.0% / MCQ 30.4% / Open 100% 的显式推理率阶梯,以及 M5 把开放式从 100% 压到 57.1% 但仍压不干净。结论不是 judge 的幻觉。
🔬 我的判断
亮点:
这套三级度量框架是实打实的贡献。之前"高效推理"这条线(L1、token budget、budget forcing、s1 那批工作)都在优化"想多久",而这篇问的是更基础的问题——"叫它别想,它听吗"。把指令遵循(IFEval 那条线)和推理压缩两条文献缝在一起,视角是新的。57 万输出规模 + 跨家族 judge 复现 + 人类验证三件套,证据链相当扎实,比很多只有单一 LLM judge 的评估论文严谨得多。
我觉得要打个问号的地方:
一是 EIR 毕竟依赖 judge 的 rubric,"一步紧凑推理"和"相关断言"的边界case(比如 "3x=9, so x=3" 这种)标注一致性论文里没有单独拆开报,98.8% 是整体数字。二是整个分析严格限定在"可见文本",作者自己也承认——模型完全可能在隐藏通道里算完再输出个干净答案(Coconut 那种 latent reasoning 就是极端例子),那时 ETR 高也不代表推理真的消失了。所以这套指标测的是"行为合规",不是"计算消失"。三是六模型六 benchmark 全是英文确定性解码,多语言、多轮、agent 场景的泛化还是未知数。
对工程的启发,这条最实际:
如果你在做推理模型的路由和成本控制,别再拿"开关状态"或"输出长度"当 no-thinking 的证据了。这篇论文给出的可操作结论是任务感知路由:答案空间窄、有候选支撑的题目(布尔、多选),直接答既安全又省钱,放心压;开放式生成题,强压大概率掉 15 个点左右的准确率,不如让它想。压缩率不由题目难度或模型规模单独决定,而由问题本身的结构支撑决定——这个判断标准可以直接写进路由策略。
📝 收尾
说到底,这篇论文把"no-thinking"从一个产品开关变成了一个需要系统评估的能力维度。模型什么时候能忍住不展示推理,和它会推理一样,都是值得单独测量、单独训练的行为。作者展望的方向也对:与其全局压制,不如训练"校准过的停止"——联合优化准确率、纯答案率、可见推理和真实 token 成本。
惯性这个东西,物理学里告诉我们它和质量成正比。在 LLM 这里,它和答案空间的开放程度成正比。想让模型停下来,光踩刹车不够,得看路况。
觉得有启发的话,欢迎点赞、在看、转发。跟进最新AI前沿,关注我